30 feuilles de temps, une vue des revenus
Mettez fin au chaos de la facturation de fin de mois
Entre « le temps est suivi » et « le temps est facturé », il y a un tableur que quelqu'un de la comptabilité assemble manuellement chaque mois. Lorsque ce tableur doit absorber 30 feuilles de temps de consultants — PDF, formulaires papier scannés et fichiers Excel, chacun nommant le même client de trois manières différentes — l'assemblage prend plus de temps que la facturation elle-même. Une enquête 2026 auprès de 500 cabinets de services professionnels menée par Unit4 et Pierre Audoin Consultants a révélé que 47 % des cabinets consacrent régulièrement des heures à corriger les feuilles de temps — non pas à suivre le temps, mais à corriger ce qui était déjà suivi. Cet article porte sur la réduction de l'écart entre ces 30 fichiers et le tableau de bord unique dont dépend votre cycle de facturation.
Points clés à retenir
- La facturation de fin de mois repose sur un tableur assemblé manuellement à partir de 30 feuilles de temps de consultants — et l'assemblage prend plus de temps que la facturation elle-même.
- La vraie perte ne réside pas dans les heures passées à saisir — mais dans les erreurs de normalisation qu'aucune correction manuelle ne peut détecter de manière fiable sur 200 lignes provenant de 30 consultants différents.
- Traitez les 30 fichiers en un seul lot et le résultat se présente sous forme de tableau croisé dynamique prêt à l'emploi — noms de clients déjà standardisés, revenus déjà calculés par ligne.
Quand « Suivez juste votre temps » n'est pas le problème
L'étude 2026 Professional Services Maturity Benchmark de SPI Research — basée sur 509 cabinets représentant 63 milliards de dollars de revenus PS — a enregistré un taux d'utilisation facturable de 66,4 % en 2025, le plus bas en 19 ans d'existence de l'enquête et 3,6 points en dessous du seuil minimal de 70 %. Ce chiffre est cité dans presque tous les articles sur les opérations PS publiés cette année, et à juste titre — c'est un voyant d'alarme sur le tableau de bord du secteur.
Mais ouvrez un article typique sur « comment améliorer l'utilisation » et vous trouverez la même prescription : un meilleur logiciel de suivi du temps. Des minuteurs en temps réel. L'intégration au calendrier. Des rappels automatisés. Tout cela concerne l'enregistrement du temps — s'assurer que les consultants notent chaque incrément de 0,1 heure au moment où il se produit. Pour notre guide sur l'extraction des données de feuilles de temps pour le rapprochement de facturation, nous avons parcouru l'ensemble du pipeline de fuite — écart d'enregistrement, écart de transcription, écart de rapprochement — et montré comment l'extraction basée sur l'IA comble la deuxième étape.
Mais il y a une couche sous la transcription que la plupart des guides ignorent car elle n'apparaît que lorsqu'on traite du volume : le problème du traitement par lots. Extraire une seule feuille de temps est simple. Extraire 30 feuilles de temps de 30 consultants différents, chacune utilisant un format légèrement différent, des abréviations de clients différentes et des structures tarifaires différentes — et avoir besoin que le résultat soit un tableau de bord de revenus unique trié par client, projet et consultant — c'est une opération entièrement différente.
La différence entre traiter une feuille de temps et en traiter trente n'est pas un effort 30 fois supérieur. C'est un changement qualitatif : l'extraction d'un seul fichier relève de la vitesse de saisie des données. L'extraction par lots relève de la normalisation des données — la réconciliation d'entrées incohérentes en une structure de sortie unifiée, sans étape de nettoyage manuel.
Les trois coûts cachés du traitement par lots que les guides sur fichiers uniques ne mentionnent jamais
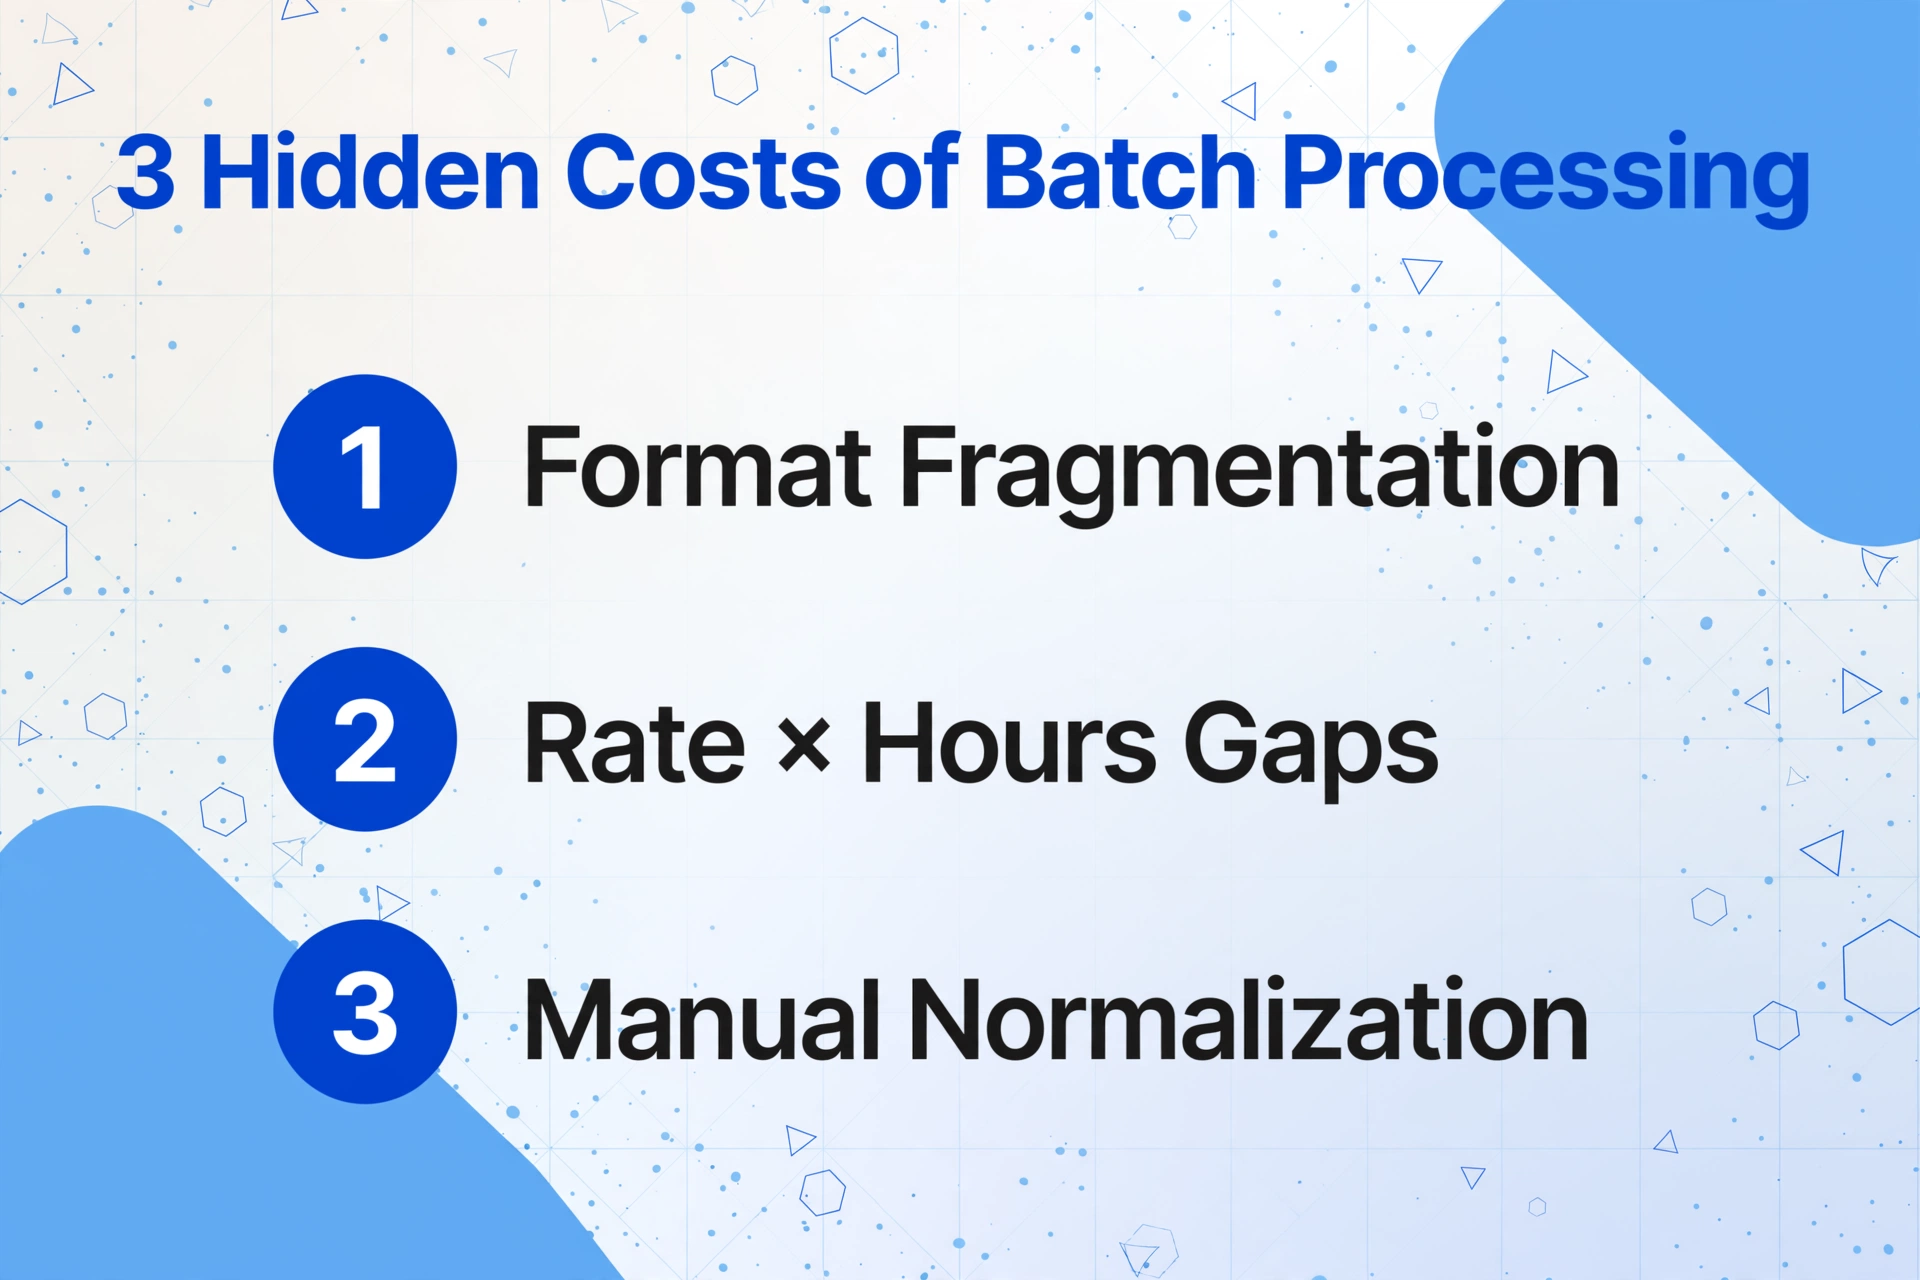
Lorsque vous traitez les feuilles de temps une par une, vous résolvez un problème de transcription. Lorsque vous les traitez par lots de 30, vous résolvez trois problèmes qui n'existent pas dans le monde des fichiers uniques :
1. Fragmentation des formats et incohérence de dénomination
Le consultant A utilise la feuille de temps PDF standard du cabinet. Le consultant B envoie une photo d'un formulaire manuscrit depuis un site client. Le consultant C ouvre un modèle Excel personnel qu'il utilise depuis 2022. Le consultant D a imprimé le formulaire, l'a rempli à la main et l'a scanné — à l'envers. Chaque consultant nomme également le même client différemment : « Acme Corp - Phase 2 », « AC2 - Stratégie », « Acme Corp (Phase II) ».
Lorsque vous traitez ces fichiers un par un, le coordinateur de facturation normalise mentalement chaque entrée en la saisissant — « ah, c'est Acme Corp Phase 2 » — et entre le bon code. Mais avec 30 fichiers, la normalisation mentale ne fonctionne plus. À la 12e feuille de temps, le coordinateur ne vérifie plus ; il transcrit caractère par caractère. Le résultat : le même client apparaît sous trois noms différents dans la sortie, et le tableau croisé dynamique qui devrait afficher « Acme Corp — 47 250 $ facturés » affiche à la place trois lignes distinctes totalisant le même montant — si le coordinateur le remarque et les consolide manuellement plus tard.
Ce n'est pas un problème de suivi du temps. C'est un problème de normalisation des données qui n'apparaît qu'à l'échelle du traitement par lots.
2. Écarts taux × heures à grande échelle
Une feuille de temps unique avec un seul taux est facile à vérifier : 7,5 heures × 275 $/heure = 2 062,50 $. Mais un cabinet de conseil a généralement plusieurs taux : différents clients négocient des taux différents, les consultants seniors facturent à des taux plus élevés que les associés juniors, et certains projets ont des taux mixtes tandis que d'autres facturent par rôle. Un lot de 30 consultants peut contenir plus de 200 lignes réparties sur 8 taux effectifs différents.
La vérification manuelle à cette échelle devient probabiliste. Un coordonnateur de facturation peut contrôler quelques entrées, mais effectuer un audit complet des taux sur 200 lignes — en vérifiant chacune par rapport à la lettre d'engagement — prendrait des heures. Le coût de ces erreurs manquées est concret : un cabinet de 50 personnes facturant 200 $/heure perd environ 780 000 $ à 1,3 million $ par an à cause des fuites de suivi du temps. Une partie se situe dans l'écart d'enregistrement (heures jamais saisies) ; une autre partie se trouve ici, dans l'écart de transcription (heures saisies mais mal tarifées).
3. Entrées manquantes et la chasse au « Qui a oublié jeudi ? »
Dans un lot de 30 feuilles de temps couvrant un mois, il y aura des lacunes. Un consultant était malade le 14 et a laissé ce jour vide — intentionnel. Un autre consultant a travaillé une journée complète le 19 mais a oublié de remplir la ligne — non intentionnel. Depuis le bureau du coordonnateur de facturation, les deux semblent identiques : une ligne manquante dans une mer de données.
Le traitement de fichiers individuels rend ces lacunes visibles car vous regardez le mois complet d'une seule personne à la fois. Le traitement par lots — où vous regardez 30 feuilles de temps fusionnées — les masque. Vous recherchez l'exhaustivité des colonnes sur tout le mois, et non la couverture par consultant. La lacune ne remonte à la surface que lorsqu'un client conteste sa facture et que quelqu'un retourne dans les fichiers d'origine.
Les données WorkPuls sur la précision du suivi du temps confirment ce point : 80 % des entreprises utilisant des feuilles de temps papier ont signalé devoir corriger 80 % des feuilles de temps reçues. Lorsque vous multipliez ces corrections sur un lot de 30 consultants, vous ne traitez pas des feuilles de temps — vous menez une opération d'assurance qualité en parallèle.
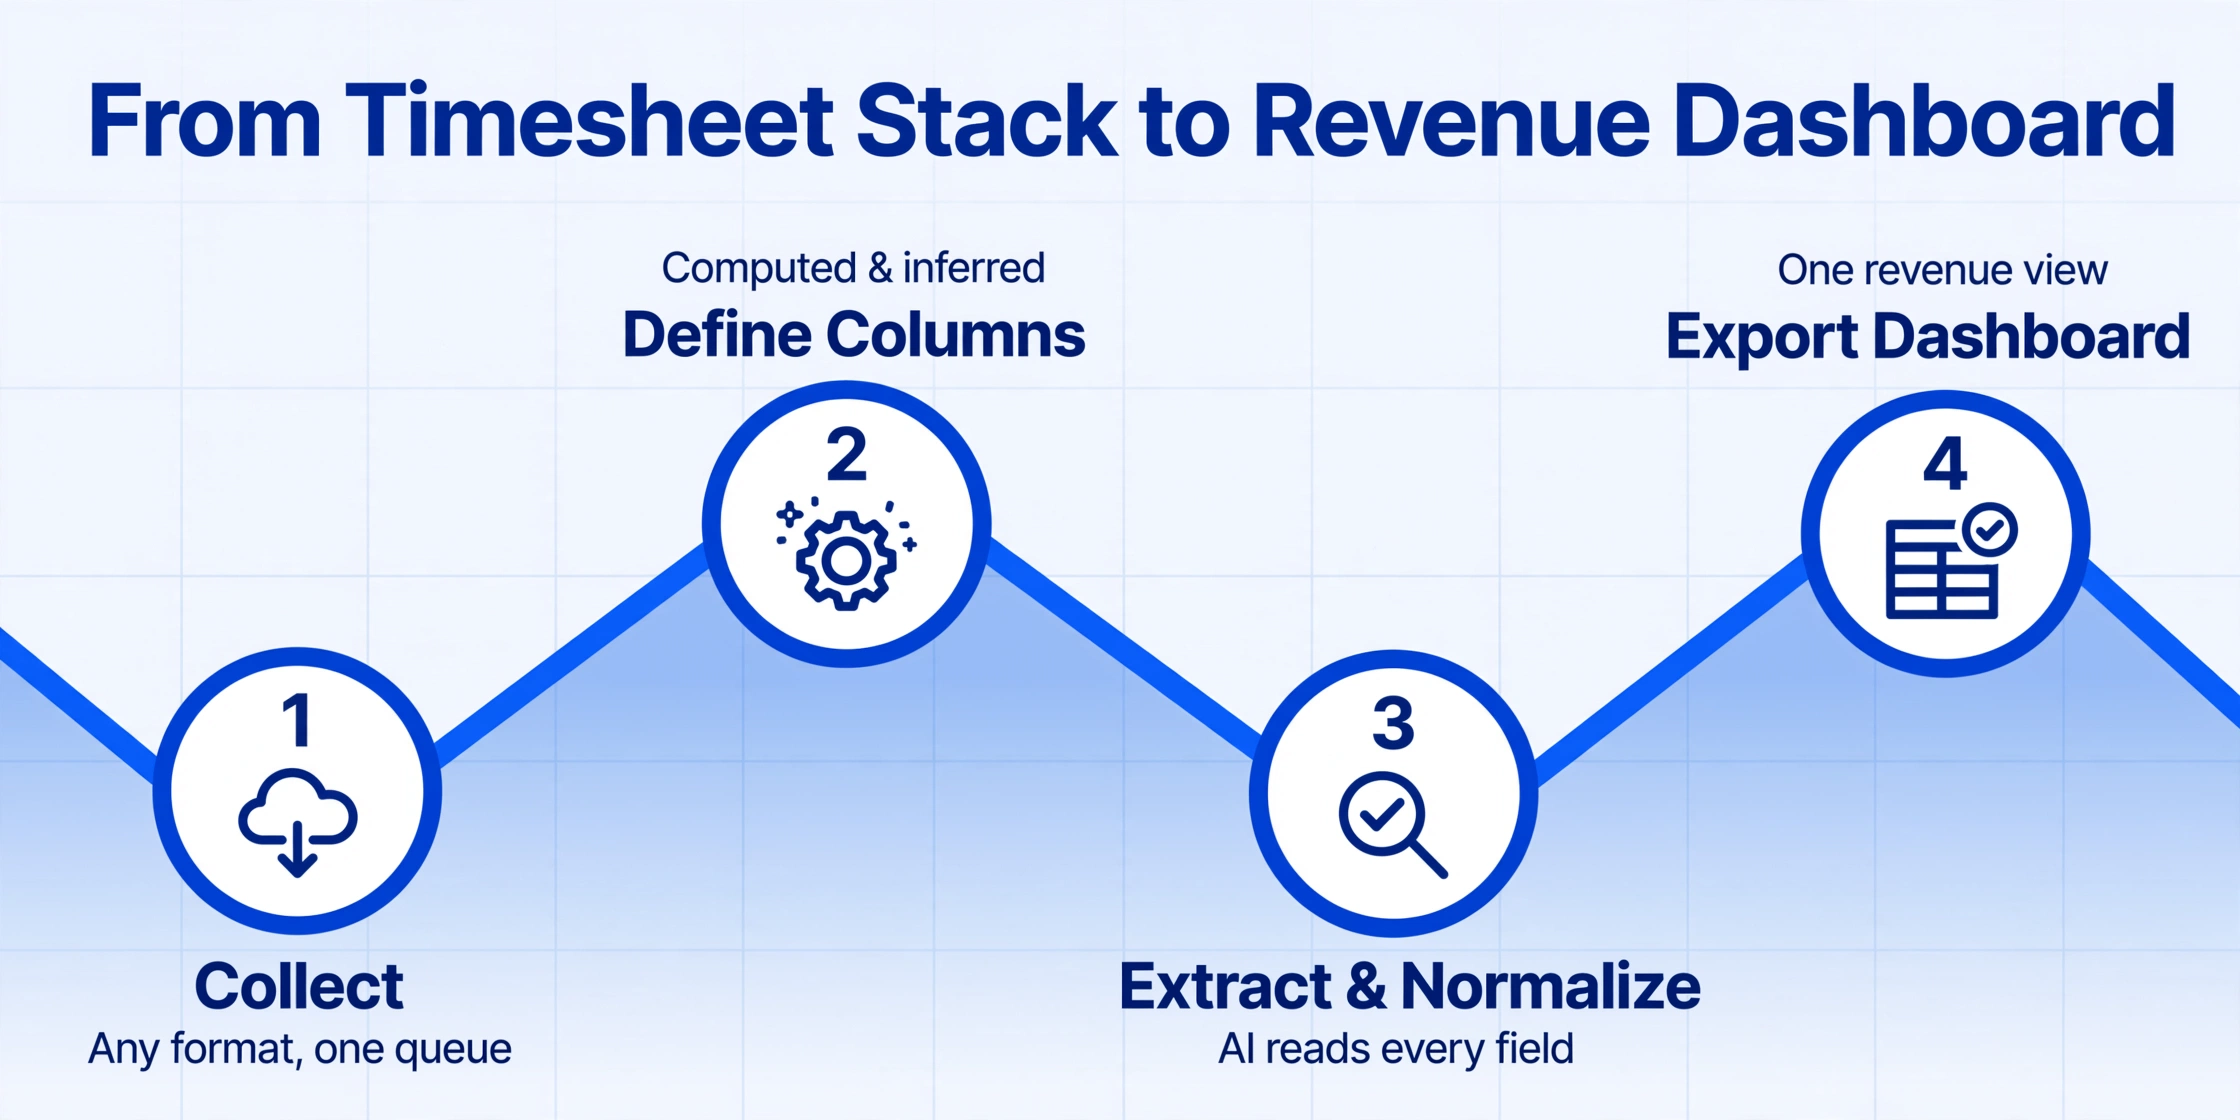
De la pile de feuilles de temps au tableau de bord des revenus : le flux de traitement par lots
C'est là que la conception de l'outil d'extraction compte. Les outils conçus pour le traitement de documents uniques traitent le lot comme une réflexion après coup — vous traitez un fichier, téléchargez le résultat, traitez le suivant. Un outil d'extraction conçu pour le traitement par lots en priorité — conçu dès le départ pour accepter plusieurs fichiers et fusionner les résultats en une seule sortie — gère les trois défis ci-dessus dans l'étape de traitement elle-même, plutôt que de les laisser au coordonnateur de facturation pour les résoudre dans Excel ensuite.
Voici le flux de travail de 30 feuilles de temps de consultants à un tableau de bord des revenus client, chaque étape étant conçue pour neutraliser l'un des trois coûts du traitement par lots :
Collectez les feuilles de temps au même endroit — quel que soit le format.
Rassemblez les PDF, JPG, PNG ou scans de chaque consultant. Pas besoin de normaliser les formats au préalable. Pour les cabinets qui souhaitent automatiser la collecte, un Lien de collecte — une page de dépôt partageable où chaque consultant dépose directement sa feuille de temps dans votre file de traitement, sans connexion requise pour le déposant — élimine complètement l'étape « courir après 30 personnes pour obtenir les fichiers ».
Définissez les colonnes de votre tableau de bord — y compris le calcul.
Saisissez les noms de champs à extraire : Client Name, Project Code, Consultant Name, Date, Hours, Rate. Ajoutez une colonne calculée — par exemple, Revenue (Hours × Rate) — et l'IA calcule le montant facturable pour chaque ligne lors de l'extraction. Ajoutez une colonne inférée comme Standardized Client (infer from Client Name) pour normaliser les variations de noms. Ces colonnes deviennent la matière première de votre tableau de bord.
Téléversez et traitez les 30 fichiers en une seule fois.
Sélectionnez tous les fichiers de feuilles de temps et traitez-les en un seul lot. L'IA lit chaque document grâce à l'extraction sémantique — elle comprend que « 7,25 » à côté de « Hours » sous une ligne mentionnant « Acme Corp » signifie 7,25 heures facturables pour ce client, quelle que soit la position de ces champs sur la page. Les 30 fichiers fusionnent en un seul tableau Excel, la colonne calculée déterminant le revenu par ligne et la colonne inférée normalisant les noms de clients. C'est le changement qualitatif : ce qui représentait 30 sessions de transcription distinctes devient un jeu de données structuré en environ 5 minutes.
Transformez en tableau croisé dynamique pour votre tableau de bord des revenus.
À partir du tableau Excel fusionné, créez un tableau croisé dynamique : lignes par Standardized Client et Project Code, valeurs en SOMME de Hours et SOMME de Revenue, avec Consultant Name comme filtre. En moins d'une minute, vous passez des lignes de feuilles de temps brutes à : le total des heures par client, le revenu total par projet, le taux d'utilisation facturable par consultant (heures facturables ÷ heures disponibles), et une comparaison rapide entre le revenu facturé et le revenu attendu. Aucune écriture manuelle de formules. Le tableau de bord est un tableau croisé dynamique du résultat d'extraction, pas un rapport séparé que vous construisez de zéro.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Normaliser les conventions de nommage des consultants sans passe de nettoyage manuel
Le problème d'incohérence de nommage — « Acme Corp - Phase 2 » vs « AC2 - Strategy » vs « Acme Corp (Phase II) » — est le défi le plus spécifique au traitement par lots dans les feuilles de temps. En extraction de fichier unique, ce problème n'existe pas, car vous examinez les saisies d'un seul consultant à la fois, et la variation de nommage ne compte que lorsque les saisies sont combinées.
Les approches traditionnelles de ce problème sont toutes manuelles : tenir une table de correspondance et faire un RECHERCHEV sur chaque cellule, envoyer un e-mail de « politique de standardisation des noms » que la moitié des consultants ignorent, ou (le plus courant) accepter trois lignes distinctes dans le tableau croisé dynamique et les consolider manuellement après chaque exécution mensuelle du lot.
L'extraction de colonnes personnalisées résout ce problème directement à l'étape de traitement. Vous définissez une colonne comme Client standardisé (déduire du champ Nom du client — options : Acme Corp, Beta Industries, Gamma Consulting, Autre). L'IA lit la saisie « Nom du client » de chaque consultant — quelle que soit la façon dont il l'a écrite — et la fait correspondre au nom standardisé que vous avez défini, en produisant la version normalisée dans une colonne distincte. Cela diffère d'une table de correspondance, car l'IA comprend la similarité sémantique : « AC2 » et « Acme Corp Phase 2 » sont reconnus comme la même entité sans que vous ayez à définir chaque variante possible.
L'avantage en aval est immédiat : votre tableau croisé dynamique regroupe par la colonne Client standardisé et affiche une ligne par client — le tableau de bord des revenus dont vous avez réellement besoin — sans session de nettoyage manuel de 45 minutes avant chaque exécution de facturation.
Ce que le tableau de bord révèle vraiment et que les feuilles de temps brutes ne peuvent pas montrer
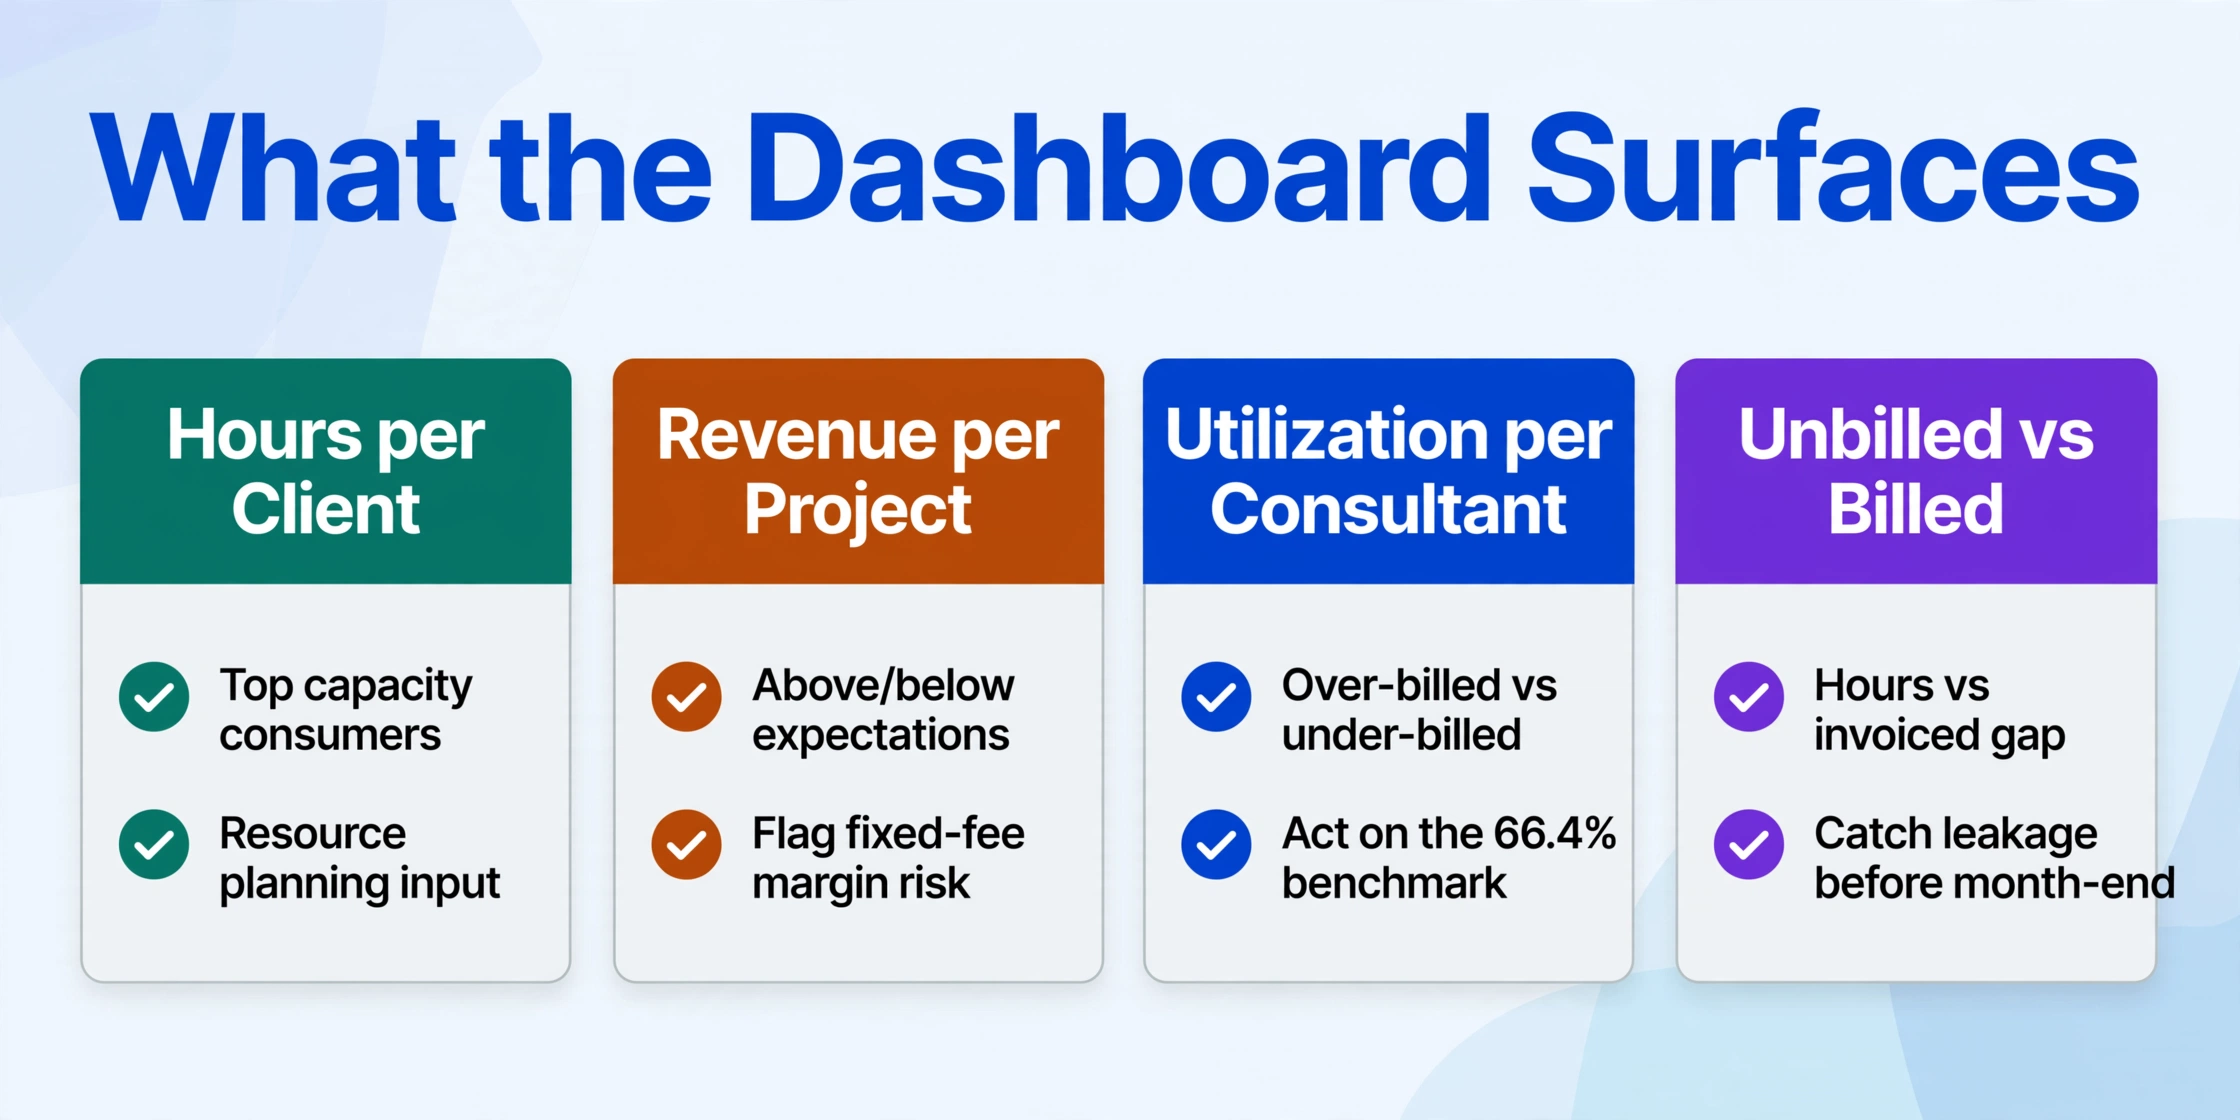
Une fois les 30 feuilles de temps fusionnées et normalisées dans un seul tableau, le tableau croisé dynamique devient une lentille que les feuilles de temps brutes ne peuvent pas offrir. Voici ce qui ressort lorsque vous organisez les données par client, projet et consultant :
| Vue du tableau de bord | Configuration du tableau croisé dynamique | Ce qu'elle révèle |
|---|---|---|
| Heures par client | Lignes : Client normalisé | Valeurs : SOMME des heures | Quels clients consomment le plus de capacité facturable — essentiel pour la planification des ressources et la tarification des renouvellements |
| Revenus par projet | Lignes : Client normalisé, Code projet | Valeurs : SOMME des revenus | Quels projets génèrent des revenus au-dessus ou en dessous des attentes ; repérer les projets à honoraires fixes où les heures réelles grignotent la marge |
| Taux d'utilisation par consultant | Lignes : Nom du consultant | Valeurs : SOMME des heures ÷ heures disponibles | Qui est sur-facturé (risque d'épuisement) et qui est sous-facturé (écart de revenus). Le taux d'utilisation sectoriel de 66,4 % de SPI devient une mesure par consultant sur laquelle vous pouvez agir |
| Comparaison non facturé vs facturé | SOMME des revenus par rapport aux totaux attendus des factures clients | L'écart entre les heures travaillées et les heures facturées — la mesure derrière la statistique de fuite de 15 à 25 %. Comblez l'écart avant la fin du mois, pas après que le client conteste la facture |
Ce n'est pas un tableau de bord que vous construisez de zéro chaque mois. C'est un tableau croisé dynamique du résultat d'extraction — le même fichier Excel qui contient chaque ligne extraite. Configurez le tableau croisé dynamique une fois, et chaque traitement par lots mensuel l'actualise avec de nouvelles données. L'objectif de référence de 75 % d'utilisation de SPI Research cesse d'être un chiffre sectoriel abstrait et devient une mesure par consultant que vous pouvez suivre, discuter et améliorer.
Le taux d'utilisation n'est pas seulement une mesure de rentabilité — c'est un indicateur avancé de fuite de revenus. Lorsque le taux d'utilisation moyen d'un cabinet tombe sous 70 %, l'écart entre les heures disponibles et les heures facturables commence à grignoter la marge à un rythme que la plupart des cabinets ne détectent qu'à la revue trimestrielle. Un tableau de bord mensuel qui montre le taux d'utilisation par consultant boucle la boucle de rétroaction avant la fin du trimestre.
Relier le tableau de bord à votre cycle de facturation
Le résultat de l'extraction est un tableau Excel. L'étape de facturation consiste à émettre des factures aux clients à partir de ce tableau. La plupart des plateformes de facturation de services professionnels acceptent les importations CSV pour les saisies de temps — ce qui signifie que l'écart entre « le tableau de bord affiche le chiffre d'affaires » et « la facture est envoyée au client » est une étape d'importation, et non une étape de ressaisie :
| Plateforme | Chemin d'importation CSV | Temps d'importation typique (200 saisies) |
|---|---|---|
| QuickBooks Online | Importation CSV via Engrenage → Importer des données → Activités de temps | Moins de 2 minutes |
| Clio | Importation groupée de saisies de temps via CSV ; correspond à Affaire, Activité, Heures, Taux | Moins de 3 minutes |
| Harvest | Importation CSV avec les champs Client, Projet, Tâche, Heures, Date | Moins de 2 minutes |
| BQE Core | Importation de saisies de temps via CSV ; correspond à Projet, Phase, Employé, Heures | Moins de 3 minutes |
| BigTime | Importation CSV et intégrée à QuickBooks ; prend en charge Staff, Projet, Date, Heures, Taux | Moins de 2 minutes |
Le flux de travail est : extraction → tableau de bord → exportation CSV → importation dans la plateforme de facturation. L'étape du tableau de bord sert de registre de rapprochement — c'est là que vous vérifiez que ce que vous allez facturer correspond à ce qui a été travaillé avant l'envoi de la facture. Les cabinets qui sautent cette étape et importent directement parient sur l'exactitude de l'extraction sans vérification, ce qui explique pourquoi la fuite de 15 % persiste même après l'adoption d'outils d'extraction.
Pour les cabinets qui doivent aller plus loin — notamment la facturation multi-devises, la conformité DCAA pour les entrepreneurs gouvernementaux, ou le format LEDES pour les cabinets d'avocats — le guide complet de l'extraction au rapprochement couvre ces aspects en détail. Pour les acheteurs comparant le paysage actuel, notre tour d'horizon des outils d'extraction de feuilles de temps en 2026 présente les prix, la précision et l'adéquation des flux de travail sur le marché. Si vos feuilles de temps arrivent sur papier de la part de consultants terrain, de la fiche de travail papier aux montants facturables traite spécifiquement du passage du papier au numérique. Et le traitement des feuilles de temps de fin de mois pour la clôture de paie étend la même approche au volet paie du cycle mensuel.
FAQ
Combien de feuilles de temps puis-je traiter en un seul lot ?
Il n'y a pas de limite stricte — le traitement par lot accepte un nombre quelconque de fichiers en un seul téléchargement. Le temps de traitement augmente à peu près linéairement avec le nombre de pages. À titre indicatif, 30 feuilles de temps d'une page sont traitées en environ 5 minutes, du téléchargement à la sortie Excel fusionnée. Chaque page individuelle est traitée en 5 à 10 secondes — soit environ 18 fois plus vite que la saisie manuelle, qui prend en moyenne 3 minutes par page pour des formulaires structurés.
Que faire si les consultants utilisent des formats de feuille de temps complètement différents ?
La diversité des formats est le problème central que résout le traitement par lot. L'extraction par IA identifie les données par leur sens sémantique plutôt que par leur position sur la page — elle comprend que « 7,25 » à côté de « Heures » fait référence aux heures facturables, que ce champ apparaisse dans le coin supérieur droit d'un PDF, dans la troisième colonne d'un tableur Excel, ou écrit à la main à côté d'une date griffonnée sur un formulaire scanné. L'IA lit chaque format indépendamment et normalise tous les résultats dans une même sortie structurée. Pour une explication plus détaillée de la différence entre l'extraction sémantique et l'OCR basée sur des modèles, consultez le guide complet de l'extraction des feuilles de temps.
L'IA peut-elle gérer différents taux de facturation pour un même consultant selon les clients ?
Oui, de deux manières. Si la feuille de temps comprend une colonne Taux, l'IA l'extrait par ligne — les différents taux pour différentes saisies sont donc gérés automatiquement. Si les taux ne figurent pas sur la feuille de temps elle-même, utilisez une Colonne calculée pour intégrer la logique de taux. Pour les scénarios à taux fixe, définissez Revenu (Heures × 275) pour un taux standard, ou utilisez des colonnes distinctes pour différents clients. Pour les missions à taux multiples, utilisez le Format de règle (accessible aux utilisateurs connectés) pour définir une logique de taux conditionnelle — par exemple, appliquer 350 $/heure pour les consultants seniors et 200 $/heure pour les juniors, en fonction du Nom du consultant extrait de chaque feuille de temps.
Que se passe-t-il si un consultant oublie de déclarer une journée — l'IA le détecte-t-elle ?
L'IA extrait ce qui figure sur le document — elle n'invente pas d'entrées manquantes. Cependant, le tableau de bord révèle des écarts qu'une simple vérification individuelle des feuilles de temps pourrait manquer. Lorsque vous croisez les données fusionnées par Nom du consultant et Date, tout consultant ayant moins de jours que prévu dans le mois ressort immédiatement dans le tableau croisé — un écart difficile à repérer en parcourant 30 fichiers séparés. Le tableau de bord devient le mécanisme de détection, et non l'étape d'extraction elle-même.
Le traitement par lots fonctionne-t-il à la fois pour les feuilles de temps imprimées et manuscrites dans un même envoi ?
Oui. L'IA lit le texte imprimé, l'écriture manuscrite et les documents mixtes imprimés/manuscrits dans un même lot. La précision est plus élevée pour le texte imprimé, mais l'écriture manuscrite courante sur des formulaires structurés (avec des champs étiquetés et des entrées dans des zones définies) est extraite de manière fiable. Pour les cas où la lisibilité est cruciale — comme les fiches de chantier manuscrites de consultants terrain sur des sites de construction — l'utilisation d'un modèle structuré avec des champs clairement étiquetés améliore la régularité de l'extraction.
Puis-je exporter directement vers mon logiciel de facturation au lieu d'Excel ?
Le format standard est Excel et CSV. Comme toutes les principales plateformes de facturation — QuickBooks, Clio, Harvest, BQE Core, BigTime — acceptent les importations CSV pour les saisies de temps, vous pouvez exporter en CSV et importer directement sans passer par Excel. Cependant, la plupart des cabinets préfèrent conserver le fichier Excel comme registre de rapprochement — il fournit la piste d'audit à trois niveaux (feuille de temps originale → données extraites → facture) qui soutient les litiges de facturation et les exigences de conformité.
SPI Research a estimé le taux d'utilisation facturable moyen du secteur à 66,4 % — le plus bas jamais enregistré. Chaque point de pourcentage récupéré sur l'écart de transcription et de rapprochement rapproche ce chiffre du seuil de 75 %. Testez l'extraction par lots sur votre prochaine série mensuelle de feuilles de temps et constatez la différence.
Traitez vos feuilles de temps par lots