船社別の船荷証券をバッチ処理して
1つのスプレッドシートにまとめる
中規模のフォワーダーは、毎月約500件の船荷証券を10〜20社の異なる海運会社から扱っています。1ドキュメントあたり10〜15分の読み取り・入力・確認作業 — CSA Softwareがフォワーディング業界の手動データ入力に関する分析で示したベンチマーク — を考慮すると、毎月83〜125時間の労働が転記作業だけで費やされていることになります。例外処理や船社へのフォローアップ、貨物を動かす判断業務は含まれていません。単にPDFからスプレッドシートへのデータ移行だけです。そして根本原因は量ではありません。各船社が同じ情報を異なる形式で印刷していることです。
B/L 1件と500件の差:単一書類のチュートリアルでは扱わない効率ギャップ
AI抽出による船荷証券1件のExcel変換は5〜10秒で完了し、手入力の約18倍の速さです。これは書類レベルの自動化の標準的なベンチマークであり、B/LのExcel変換を1件ずつ行う場合でも確実に達成できます。
しかし、運用規模で見た場合、単一書類の処理速度はボトルネックではありません。ボトルネックは書類と書類の間にあります。マースクのB/L、MSCのB/L、COSCOのテンプレート、ハパックロイドのフォーマット、ONEのレイアウト——それぞれフィールドの配置、命名規則、テーブル構造が異なり、それらを切り替えながら、B/L番号が全行で同じ意味を持つ統一されたスプレッドシートを作成するまでの累積的な摩擦が問題なのです。
フォワーダー業務に関するExpedockの分析によると、オペレーション担当者は輸送管理システムへのデータ入力と監査だけで1日2〜4時間を費やしています。月300件の貨物を処理するチームの場合、データ入力だけで150時間が消費され、運賃交渉、例外処理、カスタマーサービスに充てる時間がなくなります。コストは1件あたりの分数ではなく、船社ごとに月単位で積み重なる時間にあるのです。
B/L 1件の抽出は数秒で完了します。しかし、15社の異なる船社からの500件のB/Lは、単純にその数値を掛け算しただけでは済みません。テンプレートベースのツールでは解決できないフォーマット管理の問題になるのです。
複数船社のB/Lがテンプレートベースの抽出を破綻させる理由
海運業界はマースク、MSC、CMA CGM、COSCO、ハパックロイド、ONE、エバーグリーン、HMM、ヤンミン、ZIMといった少数の主要船社によって動いており、各社が独自のテンプレートで船荷証券を発行しています。その違いを見てみましょう:
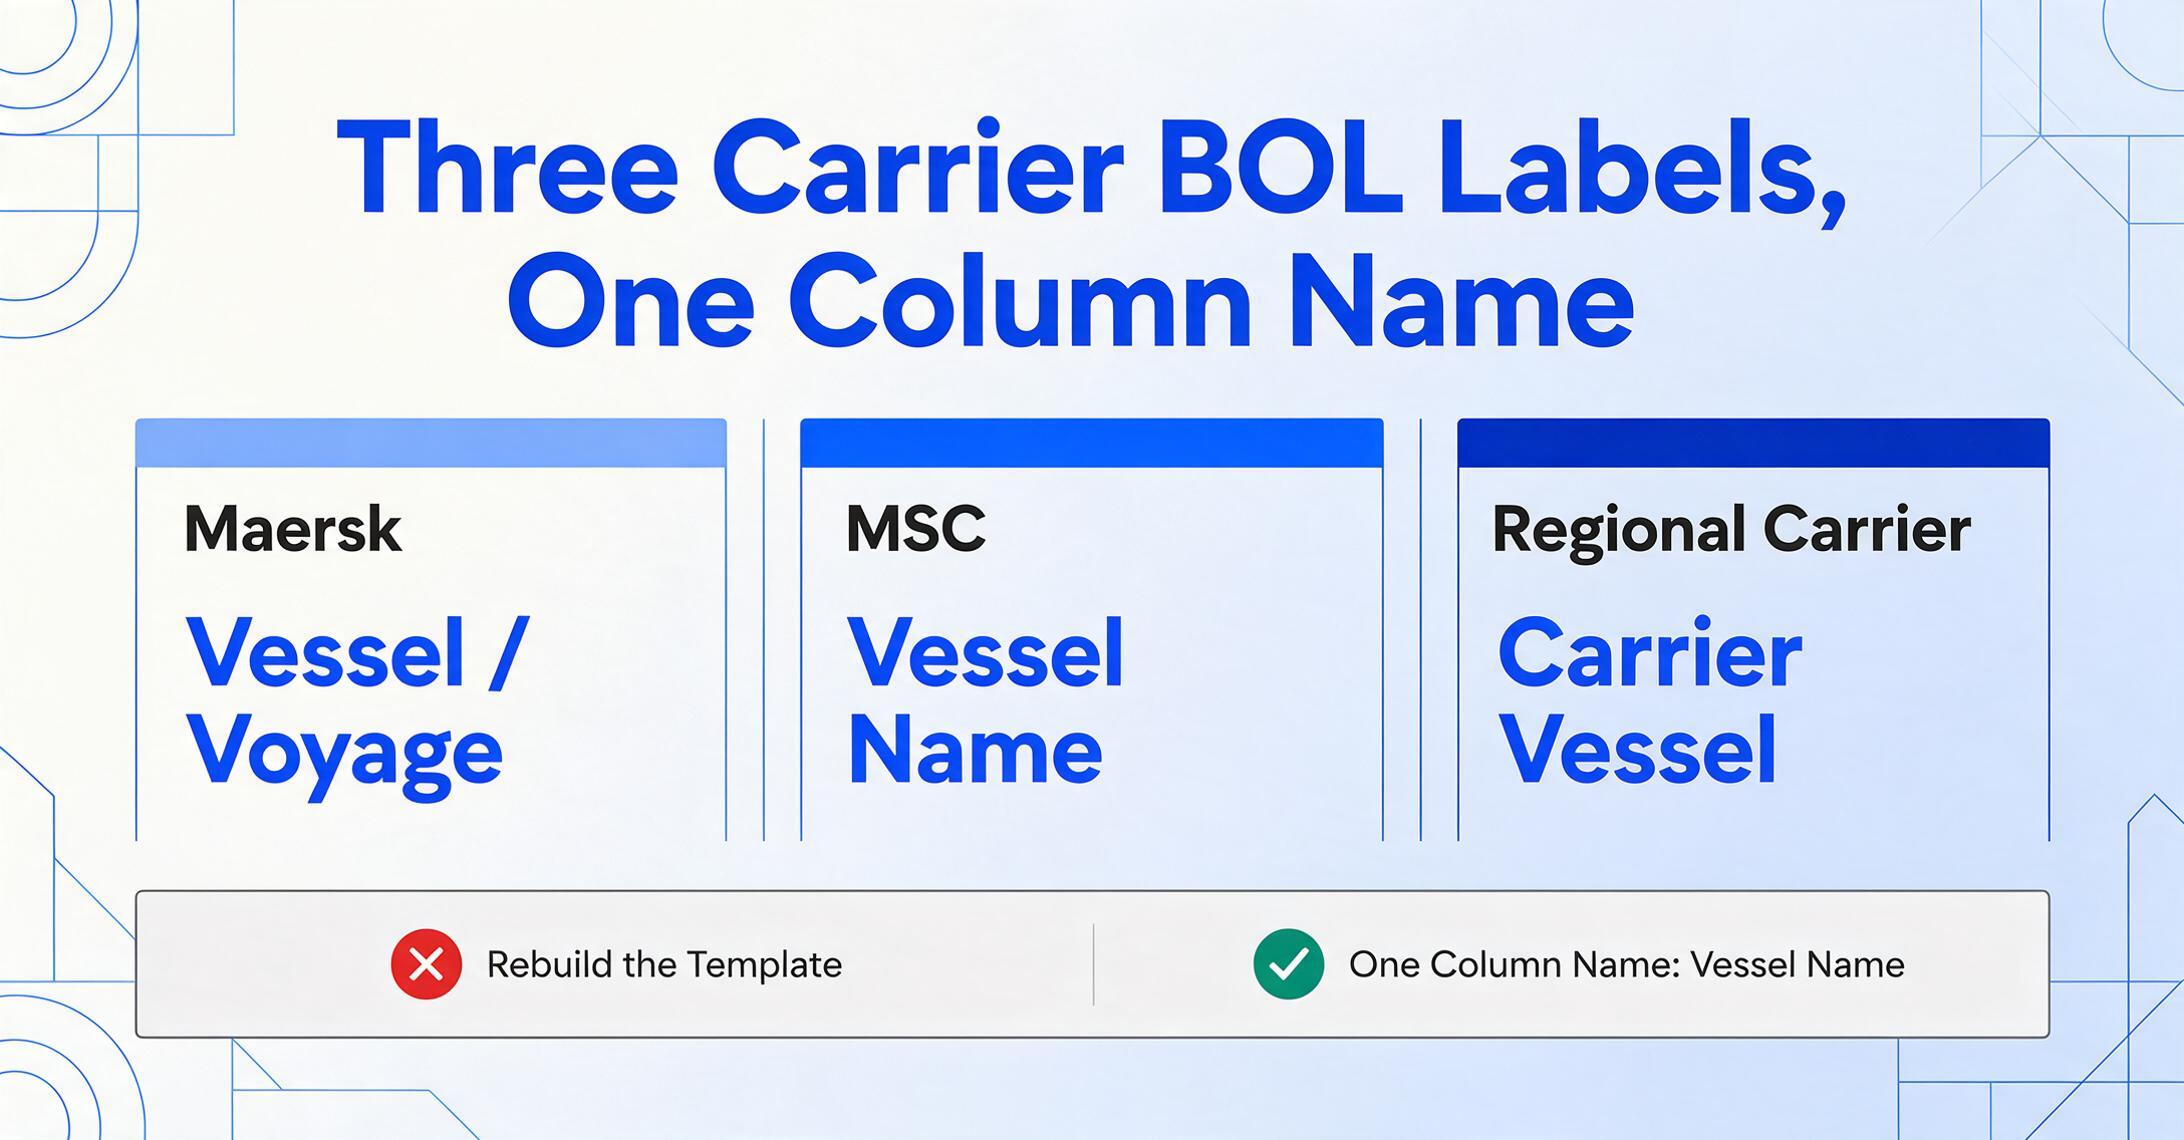
- フィールド名。マースクが「Vessel / Voyage」と表記するものを、MSCはサイドバーパネルで「Vessel Name」と表記し、地域船社は本文中で「Carrier Vessel」と呼びます。3つの異なるラベル、同じ情報です。
- 配置。B/L番号はある船社のテンプレートでは右上隅、別の船社では左下に配置されることがあります。コンテナ番号はヘッダーテーブル、複数行のリスト、貨物説明とインラインのいずれかに表示される場合があります。
- データ形式。ある船社は日付をDD/MM/YYYY形式で、別の船社はMM-DD-YYYY形式で記載します。重量は貿易ルートと船社の慣習に応じて、キログラム、ポンド、メトリックトンのいずれかで表記されます。
- ページ構成。単一コンテナのB/Lは1ページです。同じ船社の複数コンテナのB/Lは5ページに及ぶことがあり、さらに別の船社は複数コンテナの貨物をまったく異なる形式で構成します。
全米通関ブローカー・フォワーダー協会(NCBFAA)は、国際貿易において1,500社以上の会員企業と110,000人の従業員を代表しており、その会員には、米国の輸入申告の97%以上を扱うフォワーダーが含まれています。これらのフォワーダーは、営業日の毎時間、船社ごとのフォーマットの多様性に対応しています。
テンプレートベースの抽出ツールは、船社ごとのレイアウトに個別のテンプレートを必要とすることで、この多様性に対応しています。15社の船社と取引する場合、15個のテンプレートを作成することになります。船社がBOLのデザインを更新すると(ブランド変更、規制順守、システム移行など、理由はさまざまですが、実際に更新は行われます)、テンプレートは静かに壊れます。手入力をなくすはずのツールが、新たなメンテナンス負担、つまりテンプレート管理を生み出してしまったのです。この問題は船社の数に比例して拡大し、テンプレートを更新するきっかけは、常に誰かがデータの流れが止まったことに気づいたときです。
国際フォワーダー連盟(FIATA)は、電子FBLデータ標準(UN/CEFACT複合一貫輸送参照データモデルにマッピングされた、交渉可能な複合一貫輸送船荷証券(FBL)のオープンソース版デジタル形式)により、フォーマット断片化の問題に標準レベルで取り組んでいます。しかし、eFBLの船社への普及は緩やかで、現在フォワーダーの受信箱に届く紙やPDFのBOLは、標準の収束を待ってはくれません。フォワーダーは、届いたものからデータを抽出する必要があるのです。
1つの列リストで全船社対応:セマンティック抽出がBOLフォーマットを横断して機能する仕組み
船社別テンプレートに代わる方法がカラム名抽出です。特定の船社のページ上のどこに値があるかを定義する代わりに、探している情報カテゴリを定義します。AIは文書をセマンティックに読み取り、各データの意味を理解し(座標ではなく)、値がどこに現れるかではなく、何であるかによって値を特定します。
具体的な例を示します。「B/L番号」という列を定義します。AIがヘッダーに「Bill of Lading No. MAEU123456789」とあるMaerskのBOLに遭遇すると、パターンを認識して「MAEU123456789」を抽出します。サイドバーのボックスに「MEDU987654321」とラベル付けされたB/L番号が異なるフォーマットで記載されたMSCのBOLに遭遇した場合も、「MEDU987654321」を抽出します。これは、AIが両方を船荷証券の識別子として理解するからであり、両方が同じピクセル座標にあるからではありません。定義した列名が対象となる概念です。AIは、どの船社のフォーマットでも対応する値を見つけ出します。
典型的なフォワーダーのBOL抽出ワークフローに必要なフィールドリストは以下のとおりで、修正なしで全船社に対応できます:
B/L番号  |  予約番号  |  荷送人名  |  荷受人名  |  通知先
船名  |  航海番号  |  積込港  |  揚荷港
コンテナ番号  |  シール番号  |  HSコード  |  梱包数
総重量  |  貨物記述  |  運賃条件
受取地  |  配送地  |  船社名
これらの列名は一度だけ定義すればよく、ドキュメントごとの作業は不要です。定義した列名は、出力されるスプレッドシートのヘッダーになります。処理するすべての船荷証券(BOL)は、送信元ドキュメントのレイアウト、ラベル、ページ数に関係なく、同じ列が同じ順序で並ぶ行として生成されます。12社の船社から届いた50件のBOLを一括処理すれば、手作業での結合が必要な12個のテーブルではなく、1つのテーブルが生成されます。
このアプローチは、外見がまったく異なるBOLタイプにも対応します。船社がフォワーダーに発行する海洋マスター船荷証券 (MBL)、フォワーダーが荷主に発行する海洋ハウス船荷証券 (HBL)、そして航空運送状 — 視覚的なレイアウト、フィールド名、データモデルが異なる3種類のドキュメントでも、同一の列構造を持つ行が生成されます。AIは位置情報ではなくセマンティックに読み取るため、ドキュメントタイプに自動的に適応します。
核となる洞察: 船荷証券に含まれる情報は普遍的です — 荷送人、荷受人、船、貨物、重量、コンテナ。変わるのは、各船社がそれをどのように表示するかだけです。セマンティック抽出は情報をその表示から切り離すため、船社のフォーマットは無関係な変数になります。
バッチワークフロー: 船社の受信トレイから管理スプレッドシートへ
フォワーダーの月曜日の朝は、通常、週末に出航した船社から届いたBOLのPDFから始まります。それらはメールの添付ファイル、船社のポータルからのダウンロード、または仕向地代理店からの転送ドキュメントとして届きます。優先事項は、1件のBOLを素早く抽出することではなく、顧客が配送状況の問い合わせを始める前に、すべてのBOLを追跡スプレッドシートに入力することです。そのような問い合わせは、通常、各BOLの追跡番号から船社の追跡スクリーンショットを取得することから始まります。
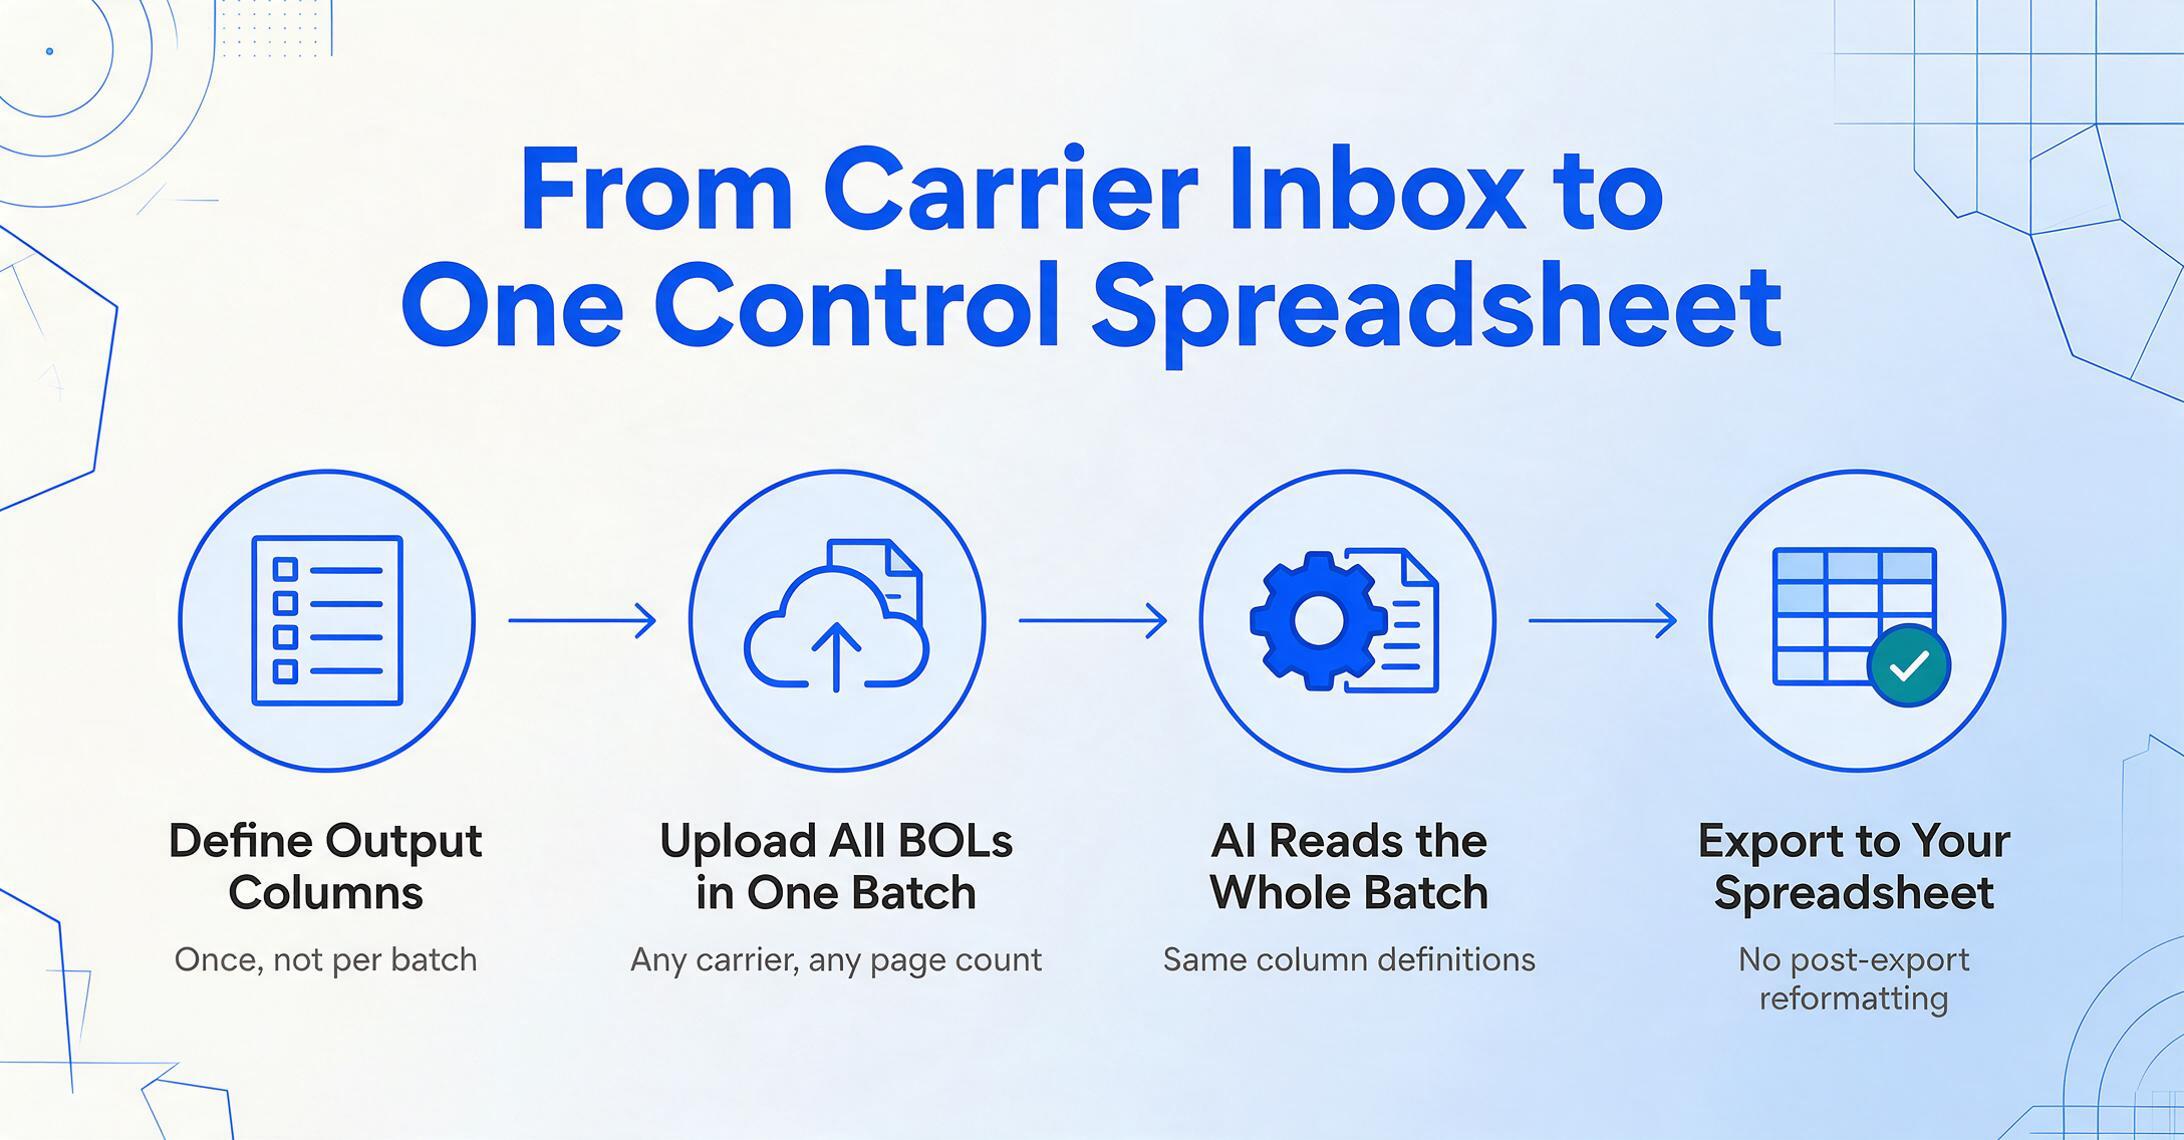
ここで、バッチ処理ワークフロー — 複数のファイルを一度にアップロードし、AIが同じ列定義を使用してすべてを処理し、1つの統合された出力を生成する方法 — が、その朝のルーティンをどのように変革するかを説明します:
出力列を一度だけ定義します。抽出するフィールド名(B/L番号、荷主、荷受人、船名、積港、コンテナ番号、総重量など)を入力します。これらが、今後処理するすべてのB/Lにわたってスプレッドシートの列ヘッダーになります。この設定は一度きりのステップであり、バッチごとや船社ごとの操作ではありません。下流のTMSや追跡用スプレッドシートが特定のヘッダー名を期待している場合は、その正確な名前をここで使用します(システムが読み取る名前が「Container Number」ではなく「ContainerNo」であれば、その名前を使用します)。これにより、エクスポート後の再フォーマット作業を排除できます。
すべてのB/Lを単一のバッチでアップロードします。船社、ドキュメントの種類、ページ数を問わず、PDF、スキャン文書、またはB/Lの写真をドラッグ&ドロップします。MaerskのPDF、MSCのスキャン、COSCOのマルチページドキュメント、地域船社のB/Lのスクリーンショットも、すべて同じアップロードに含まれます。AIはこれらをグループとして処理し、すべてのドキュメントに同じフィールド定義を使用します。ドキュメントの仕分け、船社ごとのグループ化、事前処理は一切不要です。
すべてのフィールドではなく、フラグが付いた抽出結果を確認します。AIは信頼度の低い結果(元ドキュメントのスキャン品質が低い、フォーマットが曖昧、予期しないデータパターンがあるフィールド)にマークを付けます。まずフラグが付いた項目を確認します。信頼度スコアが高い残りの項目は、通常、手動での介入は不要です。月500件のB/Lを処理し、フィールドレベルの信頼度が95%以上の場合、確認ステップの対象となるのは約25件分のドキュメントのエッジケースであり、500件のドキュメントを1行ずつ検証する必要はありません。
統合されたスプレッドシートを1つエクスポートします。出力は単一のExcelファイルで、各行が1つのB/Lに対応します。すべての船社で列は同じです。XLSXまたはCSVでエクスポートしてTMSに直接インポートするか、Google Sheetsで作業している場合は、Google Sheetsアドオンを使用して、Sheetsを離れることなく抽出データをアクティブなスプレッドシートに直接書き込むことができます。構造は一貫しています。行1はMaerskのB/L、行2はMSCのB/L、行3はCOSCOのB/Lで、3行すべての列レイアウトは同一です。
B/L1ページあたりの処理時間は5〜10秒の範囲です。単一ページのB/L50件のバッチは数分で完了します。制限要因はフォーマットの多様性ではなく、総ページ数です。ワークフローに16社目の船社を追加しても追加のセットアップ時間はかかりません。セマンティック抽出は扱う船社の数に関係しないためです。
あらゆる船社フォーマットに対応した船荷証券データ抽出の詳細については、専用のコンバーターツールをご覧ください。
問題が発生した場合の対応:大規模な例外処理
単一ドキュメントの抽出では、例外は一時的な障害に過ぎません。修正して次に進むだけです。しかし、15社の船社を対象にしたバッチ処理では、例外を効率的に解決できるかどうかで、勤務時間が15:00に終わるか19:00までかかるかが決まります。この規模での例外処理の実践は、正常な処理経路よりも重要です。
複数船社のB/Lバッチ処理で最も一般的な3つの障害モード:
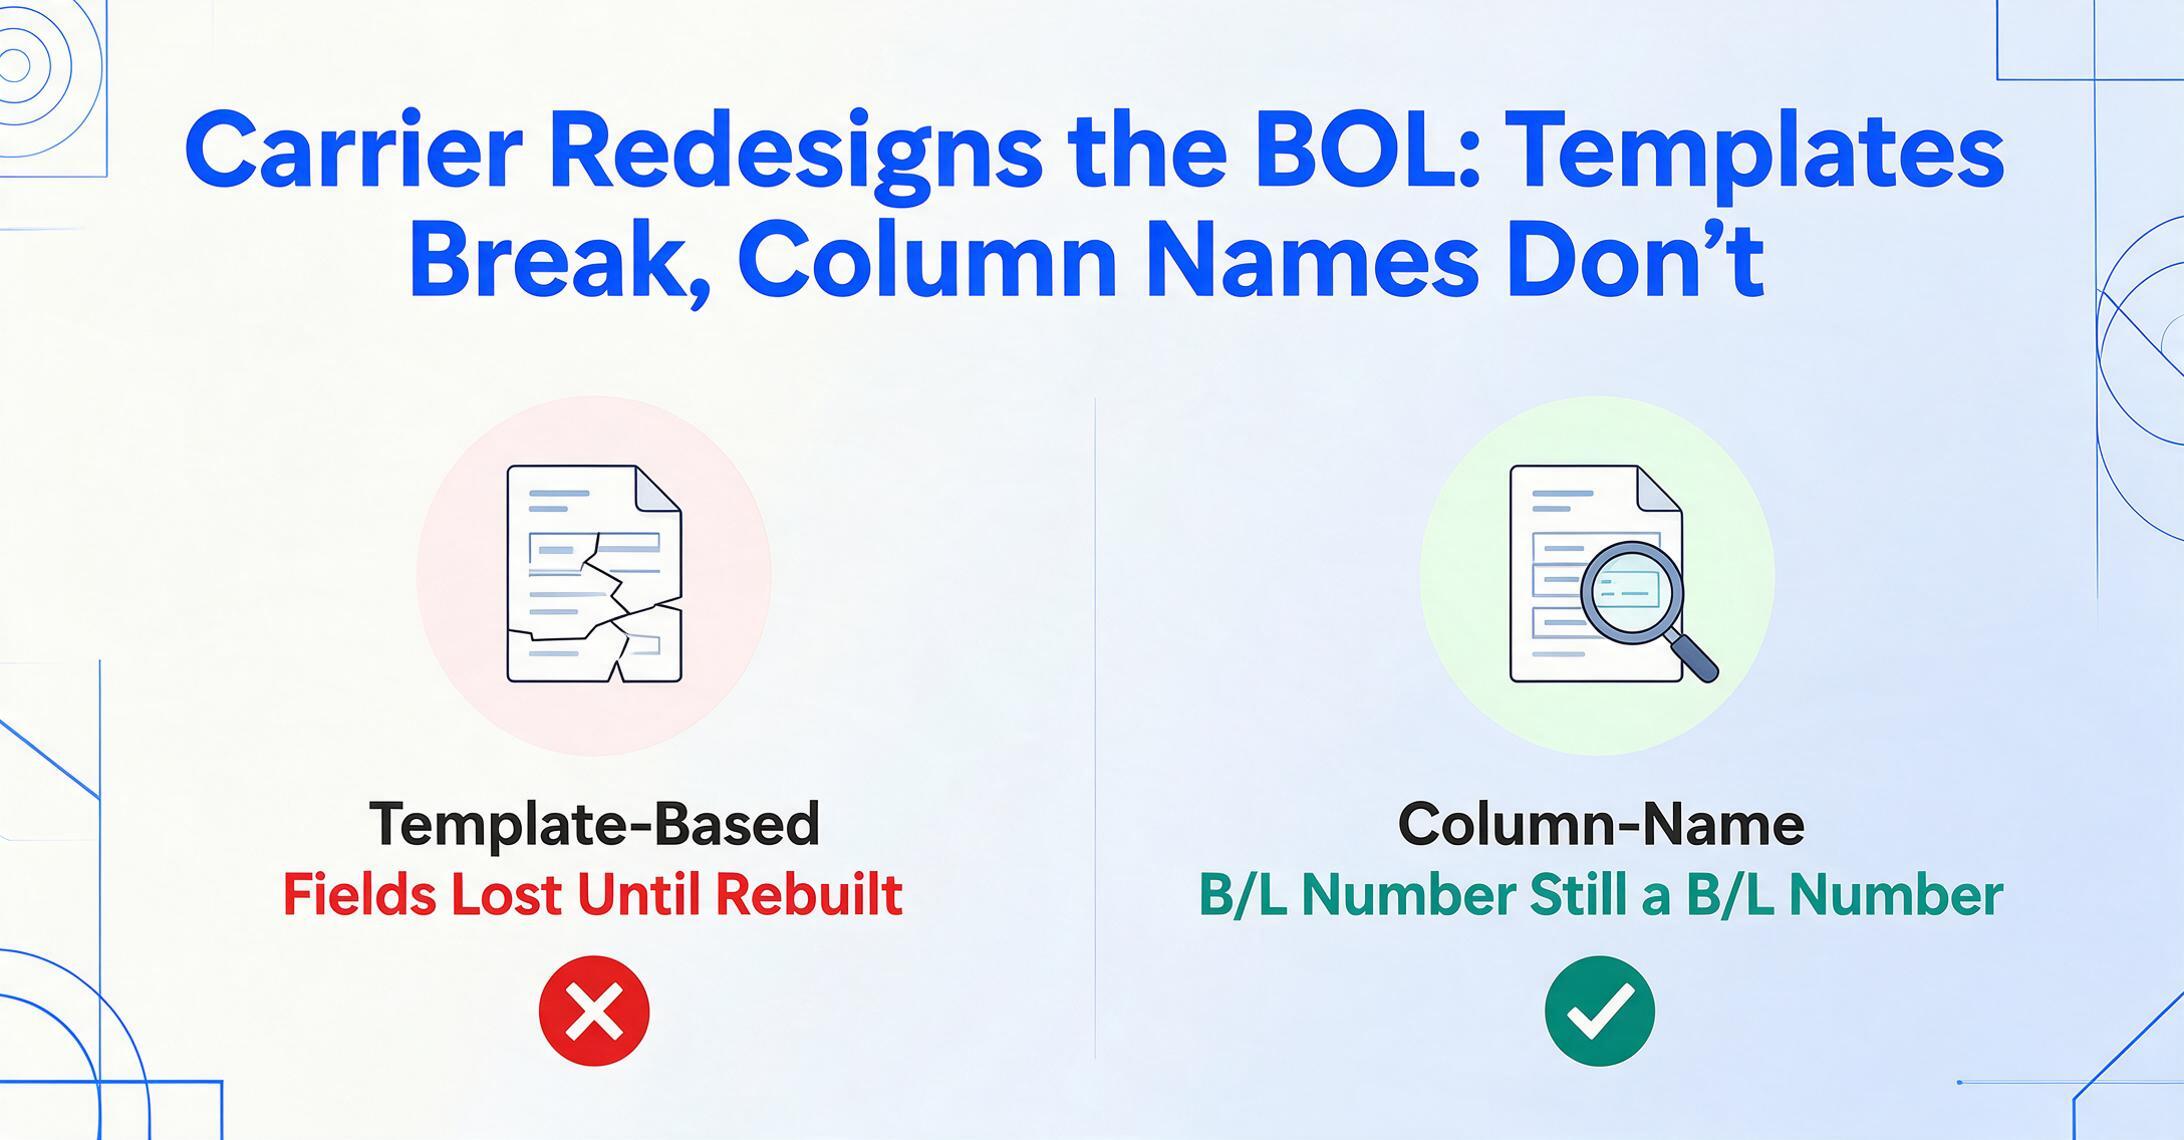
船社のテンプレート更新。MaerskがB/Lのレイアウトを再設計した際(特定のフィールドの移動、表の再構成、ページ構造の調整)、テンプレートベースの抽出ツールは、誰かがテンプレートを再構築するまで、これらのフィールドを追跡できなくなりました。カラム名抽出はこれとは異なる方法で対応します。AIがピクセル位置に依存していないため、情報の内容が同じであれば、レイアウトが変更されても抽出が中断されることはありません。B/L番号は、再設計されたページのどこに表示されても、B/L番号のままです。
スキャン品質のばらつき。Maerskのシステムから届いた鮮明なPDFのB/Lと、倉庫の蛍光灯の下で撮影され、元代理店から転送されたB/Lは、同等の入力ではありません。ぼやけたコンテナ番号、汚れた重量フィールド、傾いたページの向きは、抽出の信頼性を低下させます。AIはこれらを確認用にフラグ付けします。オペレーターは、正しく抽出されたデータの行を探し回ることなく、どのフィールドに注意が必要かを確認できます。B/Lの重要な手書き修正(重量の調整、ハンドによるシール番号の変更)については、完全自動抽出を期待するのではなく、迅速な確認パスを計画してください。
欠落および曖昧なフィールド。すべての船社がすべてのB/Lにすべてのフィールドを含めるわけではありません。地域の船社がHSコードを省略する場合があります。LCL混載B/Lでは、シール番号が空白のままの場合があります。テンプレートベースのツールは、欠落したフィールドを抽出失敗として扱うことがよくあります。セマンティック抽出はこれとは異なる方法で対応します。フィールドは単に空で返され、オペレーターは別のドキュメント(梱包明細書、商業送り状)から欠落データを調達するか、なしで進めるかを決定します。梱包明細書とB/Lを同じバッチで処理し、ドキュメントタイプ間で重複するフィールドを扱うことは、このワークフローの自然な拡張です。
実際の結果:カラム名抽出で処理された50件のB/Lのバッチでは、確認ステップは、フラグが付けられたフィールドを持つ約2〜5件のドキュメントに焦点を当てることになり、50件すべてのドキュメントを1行ずつ検証する必要はありません。抽出ツールを比較検討している場合、9つの物流ドキュメント抽出ツールの直接比較テストで、この種の複数船社のフォーマット差異を正確に取り上げています。
あらゆる港からB/Lが届く場合:コレクションリンク
フォワーダーの書類フローは、その定義上、地理的に分散しています。上海の積出港で物理的なB/Lを担当する人と、ロッテルダムやシカゴの本社で管理用スプレッドシートを管理する人は異なります。データ入力デスクに届ける必要がある物理書類はすべて、メール転送、ポータルダウンロード、WhatsApp写真といった受け渡しの回数が増えることを意味し、その受け渡しのたびに遅延や誤送のリスクが生じます。
Collection Linkは、この配布の問題を直接解決します。Collection Linkは、発行元で書類を扱う担当者(倉庫スタッフ、船会社代理店、提携フォワーダー、集荷ドライバー)に配布して共有できる、固有のアップロードページ(/c/xxxxのようなURL)です。受け取った担当者はリンクを開き、短い確認コードを入力して、B/Lを直接アップロードします。アカウント作成もログインもトレーニングも不要です。書類は処理キューに登録され、ダッシュボードから確認・エクスポートできます。
これにより、中間の手順が完全に省かれます。「発送元エージェントがB/LのPDFを業務デスクにメール送信 → 業務担当が添付ファイルをダウンロード → フォルダに保存 → 抽出ツールにアップロード」という流れではなく、「発送元エージェントがCollection Linkを開く → B/Lをアップロード → 書類が確認・エクスポート用のキューに表示される」という流れになります。3つの受け渡しがなくなり、書類は発行から数分以内に処理可能になります。船が積出港を出発する前の場合もあります。
複数の貿易ルートとタイムゾーンにまたがってB/Lを管理し、世界中から24時間体制で書類が届くフォワーダーにとって、Collection Linkは、順次的なメール依存の受け渡しチェーンを、並行的な直接アップロードのパイプラインに変えます。すべての港のすべてのエージェントが、同じ宛先にアップロードします。
よくある質問
1回のバッチで処理できるB/Lの数はいくつですか?
上限はありません。1回のバッチで必要なだけファイルをアップロードできます。実際には、複数の船社からの50〜100件のB/Lのバッチは数分で処理されます。AIは同じ列定義を使用して各書類を個別に読み取るため、総処理時間はフォーマットの多様性ではなくページ数に応じてスケールします。
同じバッチで海上貨物と航空貨物の両方の書類を処理できますか?
はい。海上B/L、航空運送状(AWB)、パッキングリストは、同じ列定義を使用して同じバッチで処理できます。指定したフィールド(荷主、荷受人、貨物内容、重量)がそれらの書類タイプに存在する限り可能です。AIは書類タイプを自動的に判別し、読み取りを適応させます。1つの書類タイプに固有のフィールド(AWBの空港コード、海上B/Lのコンテナ番号)については、データが存在する列には値が入力され、存在しない列は空白のままになります。
手書きやスタンプのあるB/Lはどうなりますか?
はっきりとしたブロック体の手書きとスタンプされたテキストは確実に抽出されます。読みやすい手書きの重量修正、ドライバーの注記、シール番号の変更は正確に処理されます。強い筆記体、かすれたカーボンコピー、にじんだインクスタンプは信頼性が低下し、これらのフィールドは手動レビュー用にフラグが付けられます。劣化したソースからの完全自動処理を期待するのではなく、手書きフィールドの簡単なレビューパスを推奨します。
TMSに組み込まれている文書認識機能とはどう違うのですか?
CargoWise、Descartes、Magayaなど、OCRを内蔵したほとんどのTMSプラットフォームが提供する文書認識は、テンプレートベース(キャリアごとの設定が必要)であるか、TMSベンダーが設定した固定の定義済みフィールドに限定されています。カラム名抽出を使用すると、一般的なB/L OCRモデルがカバーしないキャリア固有または内部参照フィールドを含め、どのフィールドを抽出するかを制御できます。Excel/CSV出力はファイルアップロードを受け付ける任意のTMSにインポートできるため、既存のシステムを置き換えるのではなく、併用して機能します。
中国語、日本語、その他の言語のB/Lを処理するためにこれを使用できますか?
はい。AIは複数の言語のB/Lを処理します。中国語のCOSCO B/Lと英語のMaersk B/Lを同じバッチで処理できます。英語で定義した列名が抽出ターゲットとして機能し、AIはドキュメントの言語に関係なく対応する値を見つけます。異なる貿易ルートにわたる輸送を扱う国際物流チームは、単一のワークフローで作業できます。
より広範な物流ドキュメント処理ワークフローを扱うチーム向けに、パッキングリストと納品書のバッチ抽出およびサプライヤー間での発注書のバッチ処理に関するガイドをご覧ください。手動データ入力の継続コストを評価している場合は、手動データ入力の隠れたコストについてお読みください。
このワークフローの単一ドキュメント版(フィールドごとの抽出、キャリアフォーマットの処理、ステップバイステップのセットアップ)については、APIやIT設定なしで船荷証券データをExcelに抽出する方法をご覧ください。