Processe Conhecimentos de Embarque de Várias
Transportadoras em Uma Única Planilha
Um despachante aduaneiro de médio porte lida com cerca de 500 conhecimentos de embarque por mês, de 10 a 20 transportadoras marítimas diferentes. Com 10 a 15 minutos por documento para leitura, digitação e verificação — o benchmark documentado pela análise da CSA Software sobre inserção manual de dados em fretamento — isso representa 83 a 125 horas de trabalho todos os meses, gastas apenas na etapa de transcrição. Sem contar a resolução de exceções. Sem contar o acompanhamento com transportadoras. Sem contar o trabalho de decisão que movimenta a carga. Apenas transferir dados de PDF para planilha. E a causa raiz não é o volume. É que cada transportadora imprime as mesmas informações de forma diferente.
Um BOL vs. 500: A Lacuna de Eficiência que os Tutoriais de Documento Único Não Abordam
Um único conhecimento de embarque extraído para o Excel leva de 5 a 10 segundos com extração por IA — aproximadamente 18 vezes mais rápido que a entrada manual. Esse é o benchmark padrão para automação em nível de documento, e extrair um BOL para o Excel um por vez entrega isso de forma confiável.
Mas a velocidade de documento único não é o gargalo em escala operacional. O gargalo é o espaço entre os documentos. É o atrito cumulativo de alternar entre um BOL da Maersk, um BOL da MSC, um modelo da COSCO, um formato da Hapag-Lloyd, um layout da ONE — cada um com posicionamento de campos diferente, convenções de nomenclatura diferentes, estruturas de tabela diferentes — e produzir uma planilha unificada onde Número B/L significa a mesma coisa em cada linha.
De acordo com uma análise da Expedock sobre operações de despachantes aduaneiros, a equipe operacional gasta de 2 a 4 horas por dia apenas inserindo e auditando dados em sistemas de gerenciamento de transporte. Para uma equipe que processa 300 remessas mensalmente, isso representa 150 horas consumidas apenas com entrada de dados — tempo que não está disponível para negociação de tarifas, tratamento de exceções ou atendimento ao cliente. O custo não está nos minutos por documento. Está nas horas por mês que se acumulam entre transportadoras.
Um único BOL é extraído em segundos. Quinhentos BOLs de 15 transportadoras diferentes não se tornam uma multiplicação direta desse número — eles se tornam um problema de gerenciamento de formato que as ferramentas baseadas em modelos não foram projetadas para resolver.
Por que BOLs de Múltiplas Transportadoras Quebram a Extração Baseada em Modelos
A indústria de frete marítimo opera com um punhado de transportadoras dominantes — Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen, HMM, Yang Ming, ZIM — e cada uma emite conhecimentos de embarque em seu próprio modelo proprietário. Veja as diferenças:
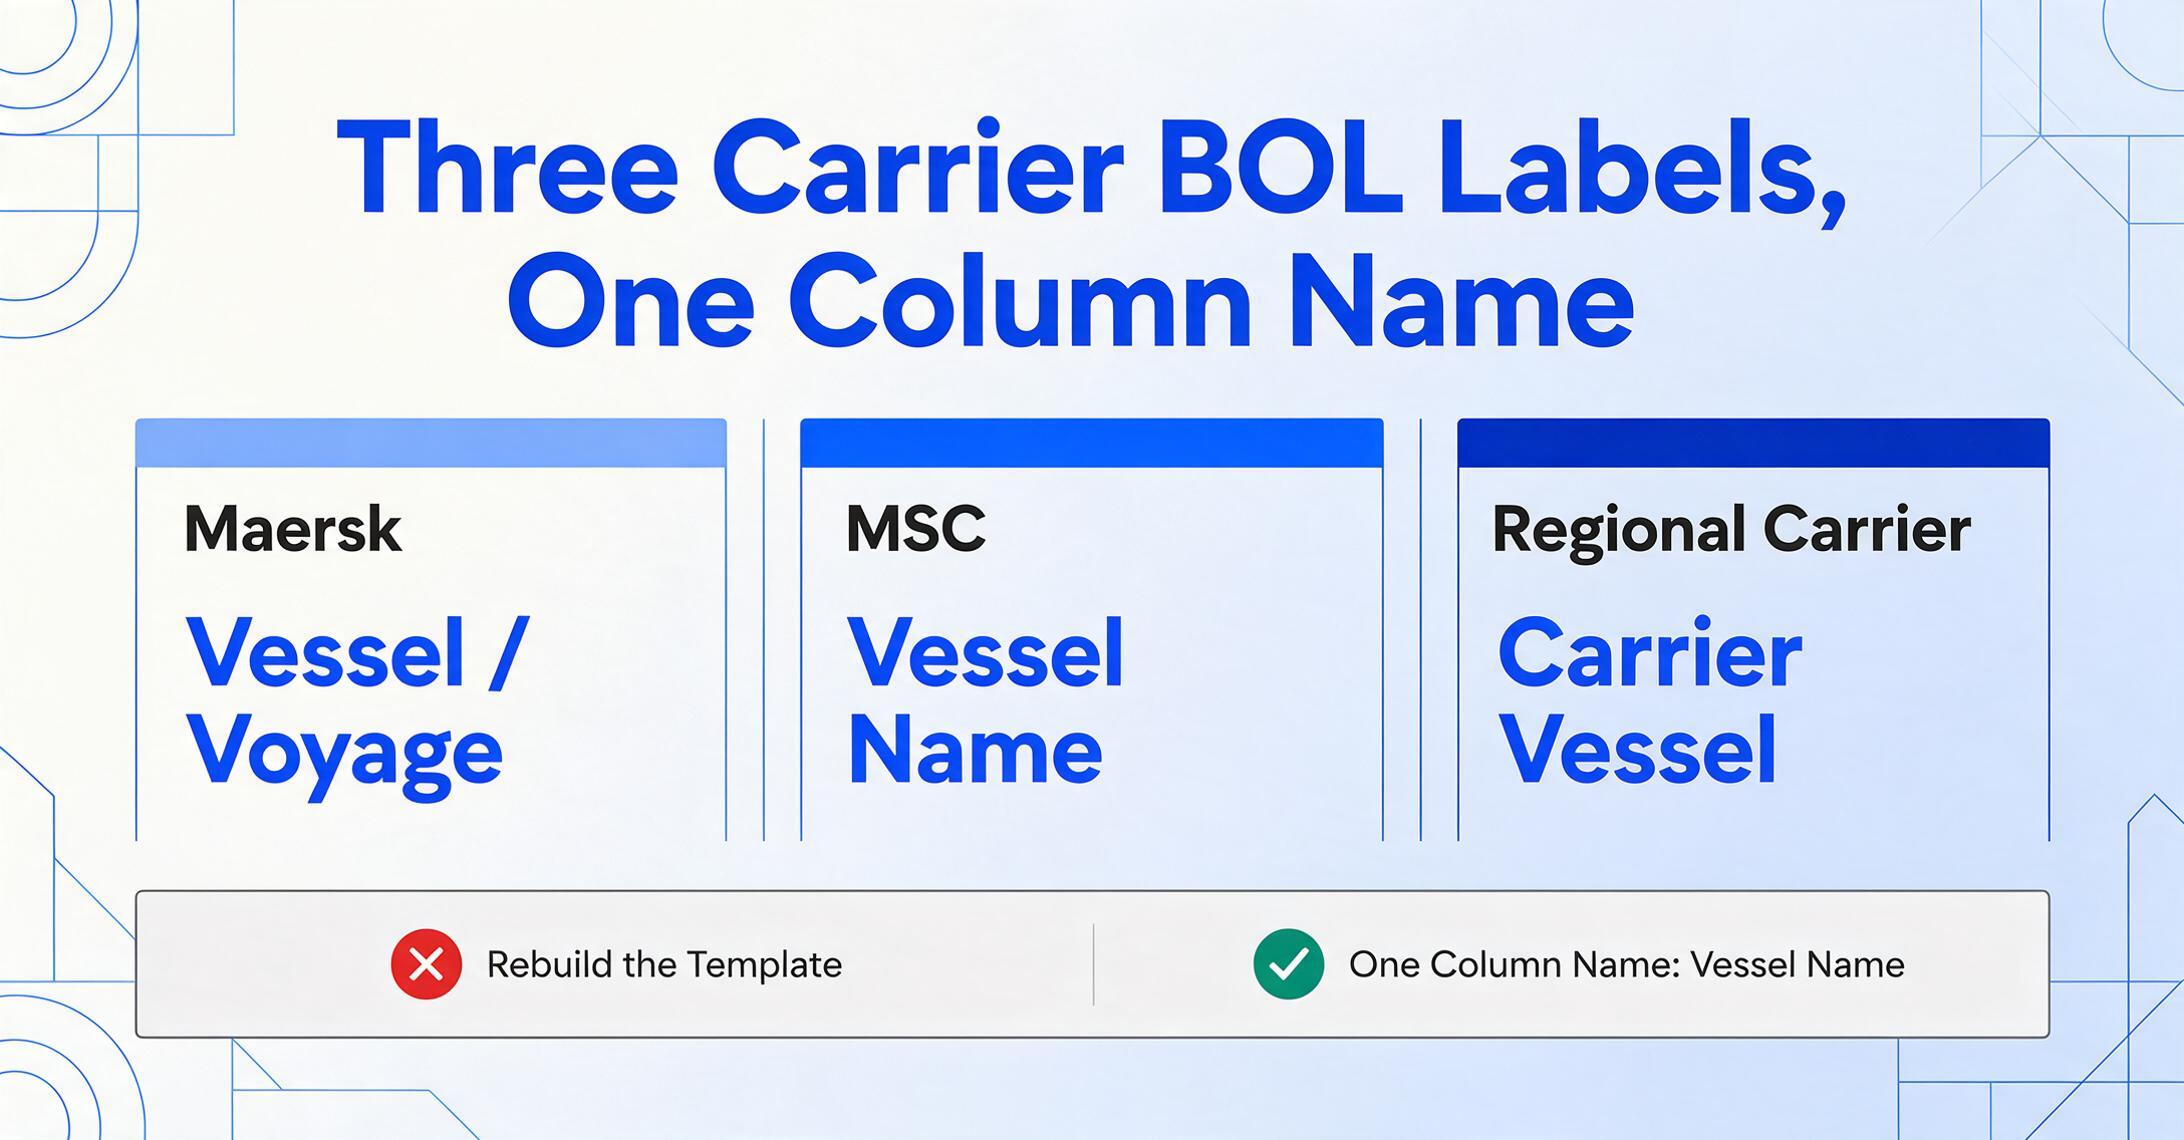
- Nomenclatura de campos. O que a Maersk rotula como "Vessel / Voyage", a MSC rotula como "Vessel Name" em um painel lateral, e uma transportadora regional chama de "Carrier Vessel" no corpo do texto. Três rótulos diferentes, a mesma informação.
- Posicionamento. O Número B/L pode ficar no canto superior direito do modelo de uma transportadora e no canto inferior esquerdo de outra. Os números de contêiner podem aparecer em uma tabela de cabeçalho, em uma lista de várias linhas ou inline com as descrições da carga.
- Formatação de dados. Uma transportadora escreve datas como DD/MM/AAAA, outra como MM-DD-AAAA. Os pesos podem estar em quilogramas, libras ou toneladas métricas, dependendo da rota comercial e da convenção da transportadora.
- Estrutura de página. Um BOL de contêiner único tem uma página. Um BOL de múltiplos contêineres da mesma transportadora pode se estender por cinco páginas — e uma transportadora diferente formata carga de múltiplos contêineres de forma completamente diferente.
A National Customs Brokers and Forwarders Association of America (NCBFAA), que representa mais de 1.500 empresas associadas e 110.000 colaboradores no comércio internacional, conta entre seus membros despachantes aduaneiros cujas operações manejam mais de 97% de todas as declarações de importação dos EUA. Estes despachantes lidam com a diversidade de formatos das transportadoras a cada hora de cada dia útil.
As ferramentas de extração baseadas em modelos respondem a esta diversidade exigendo um modelo separado para cada layout de transportadora. Se você trabalha com 15 transportadoras, você cria 15 modelos. Quando uma transportadora atualiza o design do seu conhecimento de embarque — e elas o fazem, seja por rebranding, conformidade regulamentar ou migração de sistemas — seu modelo se rompe silenciosamente. A ferramenta que devia eliminar a digitação manual criou uma nova carga de manutenção: a curadoria de modelos. O problema escala linearmente com o número de transportadoras, e o gatillo para atualizar um modelo é sempre alguien notando que os dados deixaram de fluir.
FIATA, a Federación Internacional de Asociaciones de Despachantes Aduaneiros, abordou o problema da fragmentação de formatos a nível de normas com seu padrão de dados eletrónico FBL — uma versão digital de código aberto de seu Conhecimento de Embarque Multimodal Negociable (FBL) mapeado ao Modelo de Dados de Referência de Transporte Multimodal UN/CEFACT. Mas a adoção do eFBL entre transportadoras é gradual, e os BOL em papel e PDF que chegam às caixas de entrada dos despachantes hoje não esperan pela convergencia de normas. O despachante precisa extraer dados do que chega.
Uma Lista de Colunas, Toda Transportadora: Como Funciona a Extração Semântica Entre Formatos de BOL
A alternativa aos modelos por transportadora é a extração por nome de columna: em vez de definir onde cada valor se encontra na página de uma transportadora específica, você define que categoria de informação procura. A IA lê o documento semanticamente — entendendo o significado de cada dato, não suas coordenadas — e localiza valores pelo que são, não por onde aparecem.
Um exemplo concreto. Defina uma columna chamada "Número B/L". Quando a IA encontra um BOL de Maersk com "Bill of Lading No. MAEU123456789" no cabeçalho, reconhece o padrão e extrae "MAEU123456789". Quando encontra um BOL de MSC onde o número B/L está rotulado como "MEDU987654321" numa caixa lateral com formato diferente, extrae "MEDU987654321" — porque a IA entende que ambos são identificadores de conhecimento de embarque, não porque ambos estão nas mesmas coordenadas de píxeles. O nome de columna que você definiu é o conceito alvo. A IA encontra o valor correspondente em qualquer formato de transportadora.
Esta é a lista de campos que um fluxo de trabalho típico de extração de BOL para despachantes aduaneiros precisa, e funciona em todas as transportadoras sem modificação:
Número B/L  |  Número de Reserva  |  Nome do Remitente  |  Nome do Consignatário  |  Parte Notificada
Nome do Navio  |  Número de Viagem  |  Porto de Carga  |  Porto de Descarga
Número de Contenedor  |  Número de Sello  |  Código SH  |  Contagem de Pacotes
Peso Bruto  |  Descripção da Carga  |  Condiciones de Frete
Lugar de Recepção  |  Lugar de Entrega  |  Nome da Transportadora
Defina esses nomes de colunas uma única vez — uma configuração pontual, não uma operação por documento. Eles se tornam os cabeçalhos da sua planilha de saída. Cada BOL processado de cada transportadora gera uma linha com as mesmas colunas na mesma ordem, independentemente do layout, da rotulagem ou do número de páginas do documento de origem. Um lote de 50 BOLs de 12 transportadoras produz uma tabela, não 12 tabelas que precisam de união manual.
Essa abordagem também lida com tipos de BOL que não se parecem em nada. Um Conhecimento de embarque master (MBL) marítimo emitido pela transportadora ao despachante, um Conhecimento de embarque house (HBL) marítimo emitido pelo despachante ao embarcador e um conhecimento de embarque aéreo — três documentos com layouts visuais diferentes, nomes de campos diferentes, modelos de dados diferentes — produzem linhas com estrutura de colunas idêntica. A IA se adapta ao tipo de documento automaticamente porque lê semanticamente, não posicionalmente.
O ponto central: a informação em um conhecimento de embarque é universal — embarcador, consignatário, navio, carga, peso, contêiner. O que varia é como cada transportadora escolhe exibi-la. A extração semântica desvincula a informação de sua exibição, tornando o formato da transportadora uma variável irrelevante.
O Fluxo de Trabalho em Lote: Da Caixa de Entrada da Transportadora à Planilha de Controle
A manhã de segunda-feira de um despachante aduaneiro normalmente começa com PDFs de BOL chegando de transportadoras que navegaram no fim de semana. Eles vêm como anexos de e-mail, downloads do portal da transportadora ou documentos encaminhados de agentes de origem. A prioridade não é extrair um único BOL rapidamente — é colocar todos eles na planilha de rastreamento antes que os clientes comecem a perguntar sobre atualizações de status das remessas. Essas atualizações geralmente começam com alguém puxando um print de rastreamento da transportadora do número de rastreamento em cada BOL.
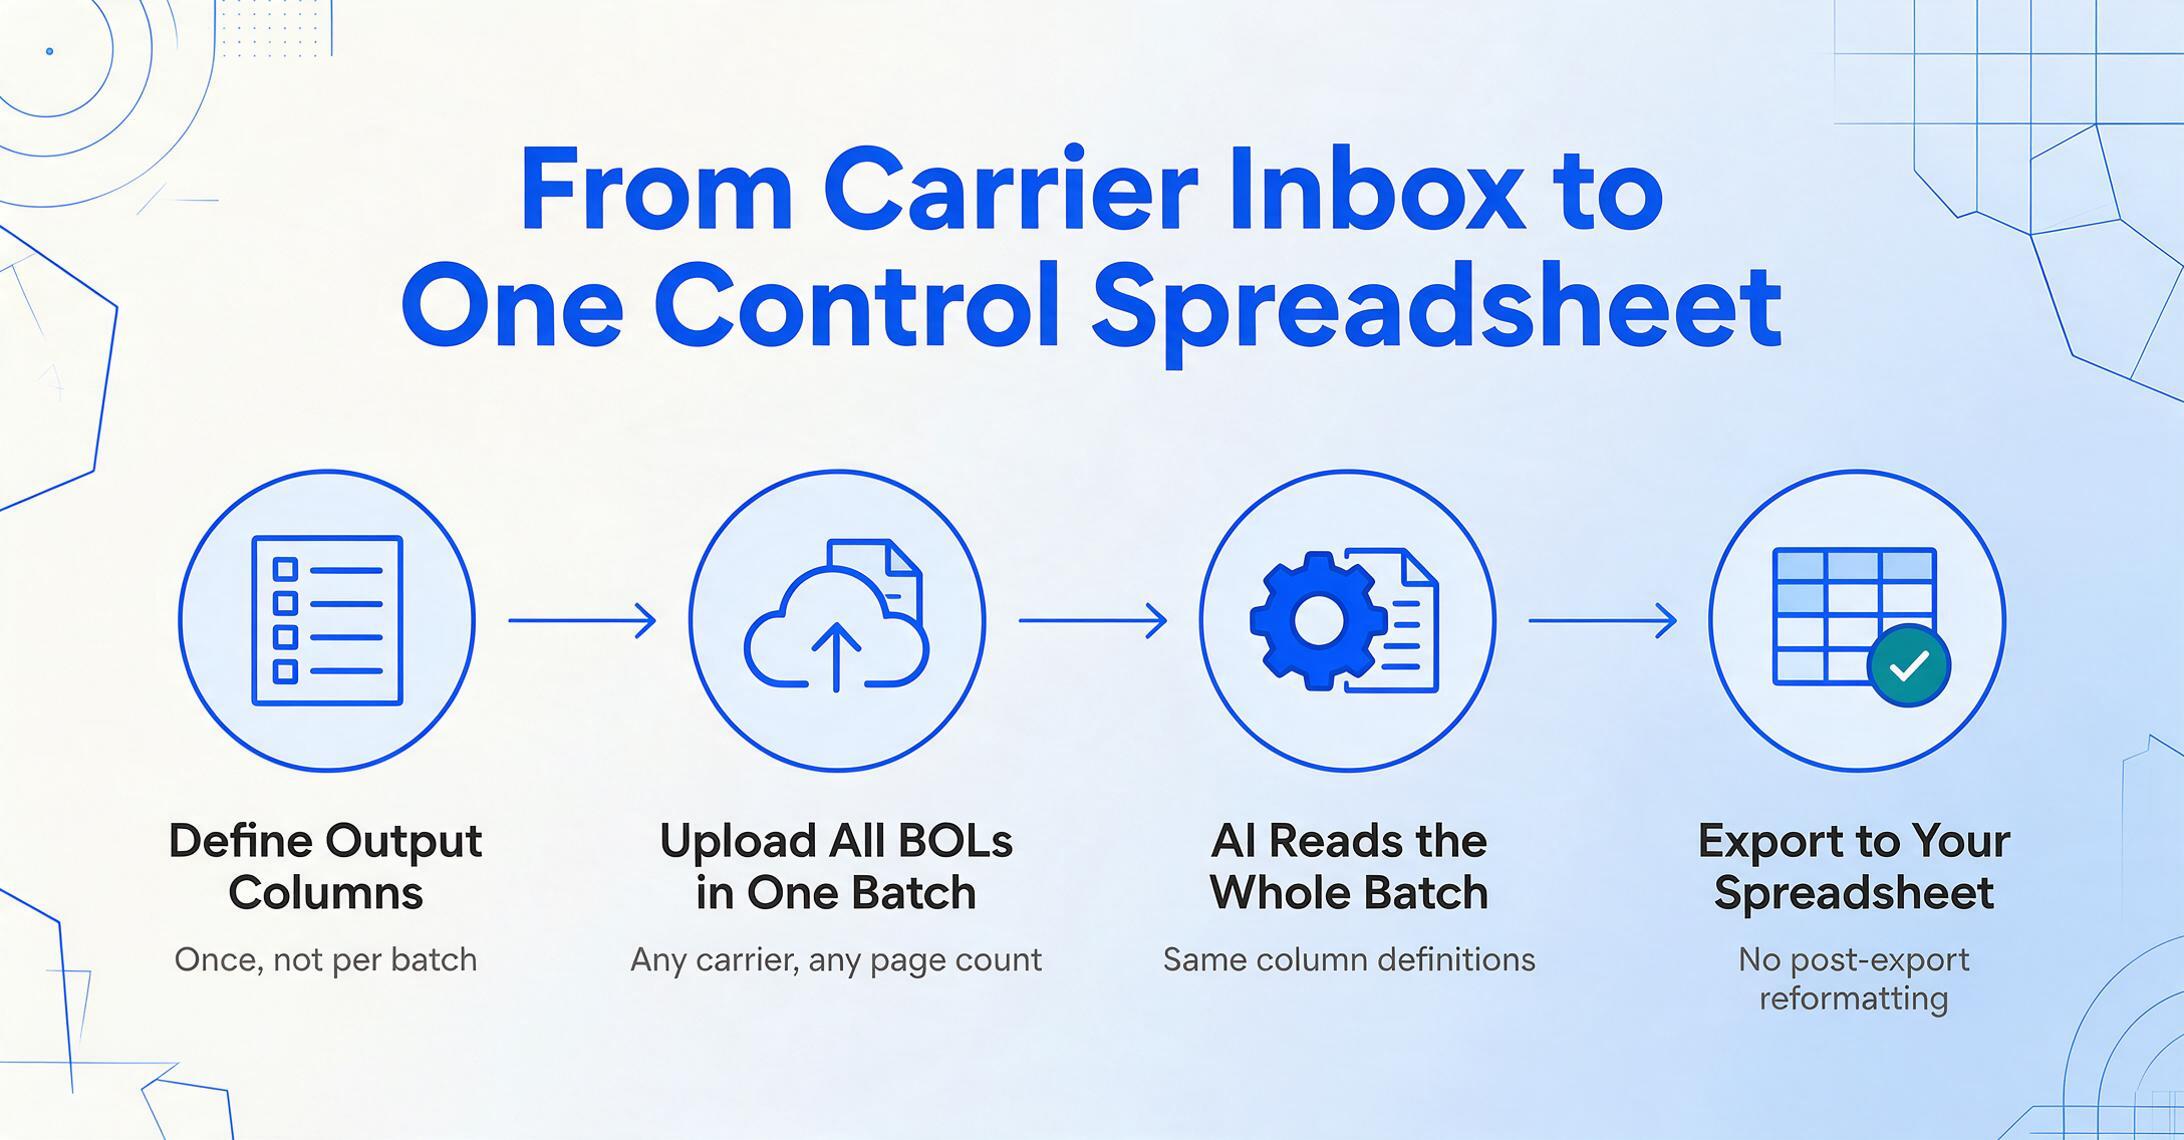
Veja como um fluxo de trabalho de processamento em lote — onde você envia vários arquivos de uma vez e a IA processa todos usando as mesmas definições de colunas para produzir uma saída consolidada — transforma essa rotina matinal:
Defina suas colunas de saída uma única vez. Insira os nomes dos campos que você precisa extraer — Número B/L, Expedidor, Consignatário, Navio, Porto de Carga, Número de Contêiner, Peso Bruto e assim por diante. Estes se tornam os cabeçalhos das colunas da sua planilha em todos os BOLs que você processará. A configuração é uma etapa única, não uma operação por lote ou por transportadora. Se seu TMS ou planilha de rastreamento espera nomes de cabeçalho específicos, use exatamente esses nomes aqui — "ContainerNo" em vez de "Número de Contêiner", se é o que seu sistema lê — e elimine a etapa de reformatting pós-exportación.
Carregue todos os BOLs em um único lote. Arrastre PDFs, documentos escaneados ou fotos de BOLs — independentemente da transportadora, tipo de documento ou número de páginas. Um PDF da Maersk, um escaneo da MSC, um documento de várias páginas da COSCO e uma captura de tela do BOL de uma transportadora regional entram todos no mesmo upload. A IA os processa como um grupo, usando as mesmas definições de campo em todos os documentos. Sem ordenação de documentos, sem agrupamento por transportadora, sem pré-processamento.
Revise as extrações marcadas, não todos os campos. A IA marca resultados de baixa confianza — campos onde o documento de origem tinha má qualidade de escaneo, formato ambíguo ou padrões de dados inesperados. Examine primeiro os itens marcados. O restante, com altas pontuações de confianza, normalmente não requer intervenção manual. Com 500 BOLs por mês e uma taxa de confianza de campo superior a 95%, a etapa de revisión se concentra em aproximadamente 25 documentos de casos límite, não em 500 documentos de verificación línea por línea.
Exporte uma planilha consolidada. A saída é um único arquivo Excel onde cada BOL é uma fila. Cada columna é a mesma em todas las transportadoras. Exporte a XLSX ou CSV, importe diretamente em seu TMS ou — se você trabalha em Google Sheets — use o complemento do Google Sheets para escrever os dados extraídos diretamente em sua planilha ativa sem sair do Sheets. A estrutura é consistente: a Fila 1 é um BOL da Maersk, a Fila 2 é um BOL da MSC, a Fila 3 é um BOL da COSCO — e todas as três filas têm o mesmo layout de colunas.
O tempo de processamento para uma única página de BOL fica no intervalo de 5 a 10 segundos. Um lote de 50 BOLs de uma página é concluído em poucos minutos — o factor limitante é o número total de páginas, não a diversidade de formatos. Adicionar a transportadora nº 16 ao fluxo de trabalho não custa tempo de configuração adicional porque a extração semântica não se preocupa com quantas transportadoras você trabalaja.
Para mais informações sobre extração de dados de conhecimento de embarque em qualquer formato de transportadora, consulte nossa herramienta dedicada de conversión.
O que acontece quando algo dá errado: tratamento de exceções em escala
Na extração de um único documento, uma exceção é um inconveniente — você corrige e segue em frente. No processamento em lote com 15 transportadoras, resolver exceções com eficiência é o que determina se o dia de trabalho termina às 15h ou às 19h. A prática de tratamento de exceções nessa escala importa mais do que o caminho feliz.
Os três modos de falha mais comuns no processamento em lote de BOL de múltiplas transportadoras:
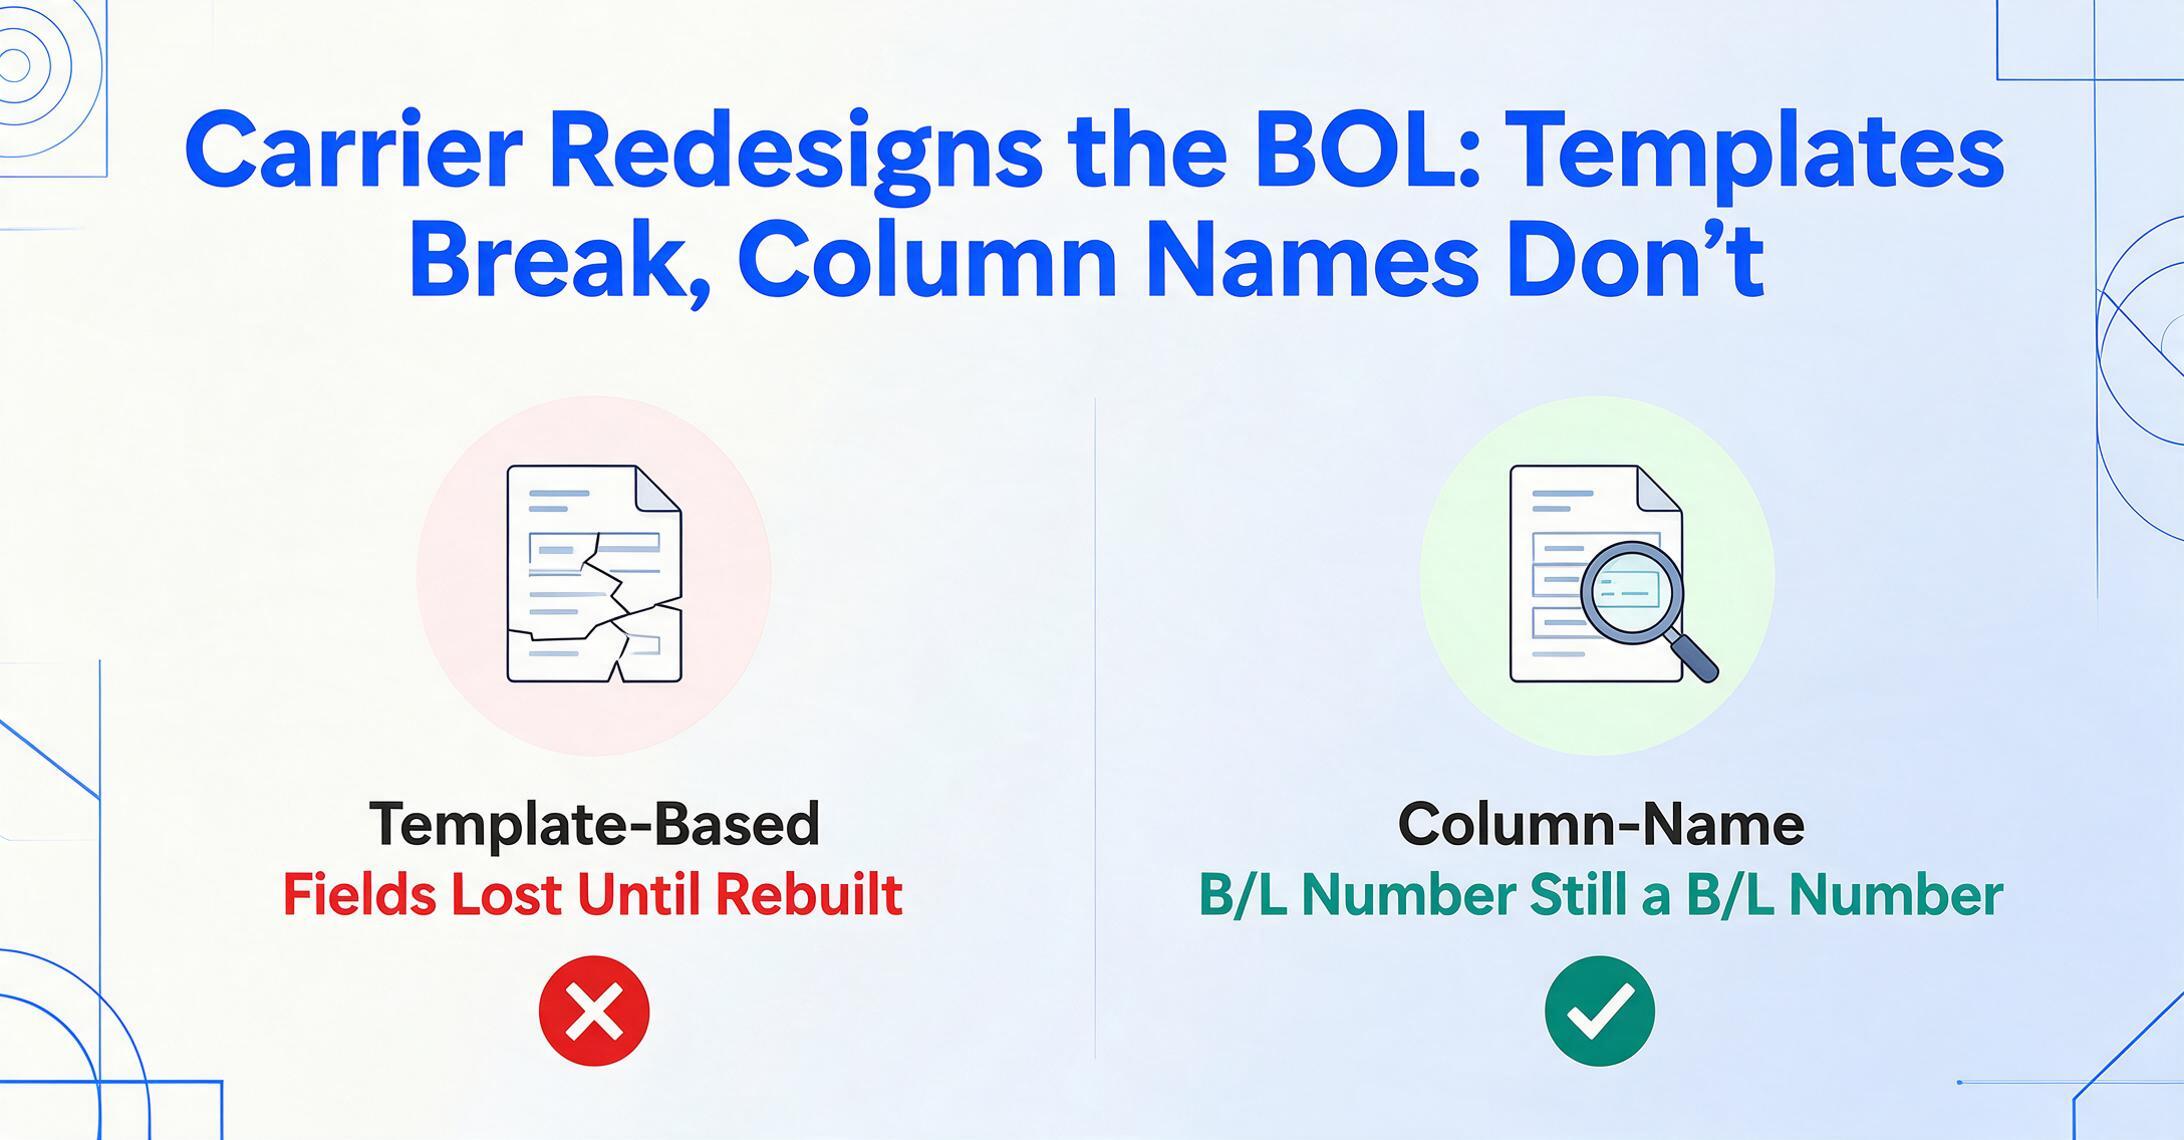
Atualizações de modelo da transportadora. Quando a Maersk redesenhou o layout do seu BOL — movendo determinados campos, reorganizando tabelas, ajustando a estrutura das páginas — as ferramentas de extração baseadas em modelos perderam o rastro desses campos até que alguém reconstruísse o modelo. A extração por nome de coluna lida com isso de forma diferente. Como a IA não está ancorada em posições de pixels, uma mudança de layout não quebra a extração, desde que o conteúdo da informação permaneça o mesmo. O Número B/L continua sendo um Número B/L, independentemente de onde apareça na página redesenhada.
Variação na qualidade do escaneamento. Um BOL que chegou como um PDF nítido do sistema da Maersk e um BOL que foi fotografado sob iluminação fluorescente de armazém e encaminhado por um agente de origem não são entradas iguais. Números de contêiner borrados, campos de peso manchados e orientações de página inclinadas reduzem a confiança da extração. A IA sinaliza esses casos para revisão — o operador vê quais campos precisam de atenção sem procurar em linhas de dados extraídos corretamente. Para correções manuscritas críticas em BOLs (ajustes de peso, alterações de número de lacre feitas à mão), planeje uma passagem rápida de revisão em vez de esperar extração totalmente automatizada de escaneamentos degradados.
Campos ausentes e ambíguos. Nem toda transportadora inclui todos os campos em todos os BOLs. Uma transportadora regional pode omitir o Código SH. Um BOL de consolidação LCL pode deixar o número de lacre em branco. Ferramentas baseadas em modelos geralmente tratam um campo ausente como uma falha de extração. A extração semântica lida com isso de forma diferente — o campo simplesmente retorna vazio, e o operador decide se busca os dados ausentes em outro documento (uma lista de embalagem, uma fatura comercial) ou prossegue sem eles. Processar listas de embalagem e BOLs juntos no mesmo lote, com campos que se sobrepõem entre os tipos de documento, é uma extensão natural desse fluxo de trabalho.
O resultado prático: para um lote de 50 BOLs processados com extração por nome de coluna, a etapa de revisão se concentra em cerca de 2 a 5 documentos com campos sinalizados, não em 50 documentos com verificação linha por linha. Se você ainda está comparando ferramentas de extração antes de se comprometer com uma, nosso teste comparativo de nove ferramentas de extração de documentos logísticos cobre exatamente esse tipo de variação de formato entre múltiplas transportadoras.
Quando Seus Conhecimentos de Embarque Chegam de Todos os Portos: Collection Links
O fluxo de documentos de um despachante aduaneiro é geograficamente distribuído por definição. A pessoa que lida com os conhecimentos de embarque físicos no porto de embarque em Xangai não é a mesma que gerencia a planilha de controle na sede em Roterdã ou Chicago. Cada documento físico que precisa chegar à mesa de entrada de dados é mais uma transferência — encaminhamentos de e-mail, downloads do portal, fotos de WhatsApp — e cada transferência é um possível atraso ou erro de roteamento.
Collection Links resolvem o problema de distribuição diretamente. Um Collection Link é uma página de upload única e compartilhável (uma URL como /c/xxxx) que você gera e distribui para quem lida com documentos na origem — funcionários do armazém, agentes de navegação, despachantes parceiros, motoristas de coleta. O destinatário abre o link, insere um código de verificação curto e envia o conhecimento de embarque diretamente. Sem criação de conta, sem login, sem treinamento. O documento chega à sua fila de processamento, e você revisa e exporta pelo seu painel.
Isso elimina completamente as etapas intermediárias. Em vez de "agente na origem envia o PDF do conhecimento de embarque por e-mail para a mesa de operações → operações baixa o anexo → salva na pasta → envia para a ferramenta de extração", o fluxo se torna "agente na origem abre o Collection Link → envia o conhecimento de embarque → o documento aparece na sua fila para revisão e exportação". Três transferências eliminadas, e o documento fica disponível para processamento em minutos após a emissão — às vezes antes de o navio sequer ter saído do porto de embarque.
Para despachantes aduaneiros que gerenciam conhecimentos de embarque em várias rotas comerciais e fusos horários, onde os documentos chegam 24 horas por dia de diferentes partes do mundo, os Collection Links transformam uma cadeia de transferências sequencial e dependente de e-mail em um pipeline paralelo de upload direto. Cada agente, em cada porto, envia para o mesmo destino.
Perguntas Frequentes
Quantos conhecimentos de embarque podem ser processados em um único lote?
Não há limite definido — você pode enviar quantos arquivos forem necessários em um lote. Na prática, um lote de 50 a 100 conhecimentos de embarque de várias transportadoras é processado em poucos minutos. O tempo total de processamento varia com o número de páginas, não com a diversidade de formatos, porque a IA lê cada documento de forma independente usando as mesmas definições de colunas.
É possível lidar com documentos de frete marítimo e aéreo no mesmo lote?
Sim. Um conhecimento de embarque marítimo, um conhecimento de embarque aéreo (AWB) e uma lista de embalagem podem ser processados no mesmo lote usando as mesmas definições de colunas — desde que os campos especificados (Remetente, Consignatário, Descrição da Carga, Peso) existam nesses tipos de documento. A IA distingue os tipos de documento automaticamente e adapta sua leitura. Para campos exclusivos de um tipo de documento (códigos de aeroporto em AWBs, números de contêiner em conhecimentos de embarque marítimos), essas colunas serão preenchidas onde os dados existirem e permanecerão em branco onde não existirem.
O que acontece com conhecimentos de embarque com caligrafia ou carimbos?
Caligrafia clara em bloco e texto carimbado são extraídos de forma confiável. Correções de peso manuscritas, anotações do motorista e alterações no número de lacre que estejam legíveis serão processadas com precisão. Escrita altamente cursiva, cópias carbono desbotadas e carimbos borrados reduzem a confiança — esses campos serão sinalizados para revisão manual. Recomendamos uma revisão rápida dos campos manuscritos em vez de esperar processamento totalmente automatizado de fontes degradadas.
Como isso se compara ao reconhecimento de documentos integrado do meu TMS?
A maioria das plataformas TMS com OCR integrado — incluindo CargoWise, Descartes e Magaya — oferecem reconhecimento de documentos que é baseado em modelos (exigindo configuração por transportadora) ou limitado a um conjunto fixo de campos predefinidos pelo fornecedor do TMS. A extração por nome de coluna dá a você controle sobre quais campos são extraídos, incluindo campos específicos da transportadora ou de referência interna que os modelos genéricos de OCR de conhecimentos de embarque não cobrem. A saída em Excel/CSV é importada para qualquer TMS que aceite uploads de arquivos, funcionando junto com seu sistema atual, sem substituí-lo.
Posso usar isso para lidar com conhecimentos de embarque em chinês, japonês ou outros idiomas?
Sim. A IA processa conhecimentos de embarque em vários idiomas. Um conhecimento de embarque COSCO em chinês e um conhecimento de embarque Maersk em inglês podem ser processados no mesmo lote — os nomes de colunas que você define em inglês funcionam como alvos de extração, e a IA localiza os valores correspondentes independentemente do idioma do documento. Equipes de frete internacional que lidam com remessas em diferentes rotas comerciais trabalham em um único fluxo de trabalho.
Para equipes que lidam com fluxos de trabalho mais amplos de documentação logística, consulte nossos guias sobre extração em lote de remessas e notas de entrega e processamento em lote de pedidos de compra de fornecedores. Se você está avaliando o custo de continuar com a entrada manual de dados, leia sobre o custo oculto da entrada manual de dados.
Para o equivalente deste fluxo de trabalho para um único documento — cobrindo extração campo por campo, tratamento de formatos de transportadora e configuração passo a passo — consulte como extrair dados de conhecimentos de embarque para Excel sem API ou configuração de TI.