Konnossemente verschiedener Reedereien
in einer Tabelle stapelweise verarbeiten
Ein mittelgroßer Spediteur bearbeitet monatlich rund 500 Konnossemente von 10 bis 20 verschiedenen Seereedereien. Bei 10 bis 15 Minuten pro Dokument für Lesen, Erfassen und Prüfen – der von CSA Software in ihrer Analyse der manuellen Dateneingabe in der Speditionsbranche dokumentierte Richtwert – sind das 83 bis 125 Arbeitsstunden pro Monat, die allein für den Übertragungsschritt anfallen. Nicht für die Bearbeitung von Ausnahmen. Nicht für die Nachverfolgung bei Reedereien. Nicht für die Entscheidungsarbeit, die Fracht bewegt. Sondern nur für das Übertragen von Daten aus PDF in eine Tabelle. Und die eigentliche Ursache ist nicht das Volumen. Es ist die Tatsache, dass jede Reederei dieselben Informationen anders darstellt.
Ein Konnossement vs. 500: Die Effizienzlücke, die Einzeldokument-Tutorials nicht abdecken
Ein einzelnes Konnossement, das mit KI-gestützter Extraktion in Excel übertragen wird, dauert 5 bis 10 Sekunden – etwa 18-mal schneller als die manuelle Eingabe. Das ist der Standard-Benchmark für Dokumentautomatisierung, und ein Konnossement in Excel extrahieren liefert dies bei Einzeldokumenten zuverlässig.
Doch die Geschwindigkeit einzelner Dokumente ist im operativen Maßstab nicht der Engpass. Der Engpass ist der Raum zwischen den Dokumenten. Es ist die kumulative Reibung beim Wechsel zwischen einem Maersk-Konnossement, einem MSC-Konnossement, einer COSCO-Vorlage, einem Hapag-Lloyd-Format, einem ONE-Layout – jedes mit unterschiedlicher Feldplatzierung, unterschiedlichen Benennungskonventionen, unterschiedlichen Tabellenstrukturen – und der Erstellung einer einheitlichen Tabelle, in der B/L-Nummer in jeder Zeile dasselbe bedeutet.
Laut einer Expedock-Analyse der Speditionsabläufe verbringen operative Mitarbeiter täglich 2 bis 4 Stunden nur mit der Eingabe und Prüfung von Daten in Transportmanagementsysteme. Für ein Team, das monatlich 300 Sendungen verarbeitet, sind das 150 Stunden, die allein für die Dateneingabe aufgewendet werden – Zeit, die nicht für Tarifverhandlungen, Ausnahmebehandlung oder Kundenservice zur Verfügung steht. Die Kosten liegen nicht in den Minuten pro Dokument. Sie liegen in den Stunden pro Monat, die sich über alle Reedereien hinweg ansammeln.
Ein einzelnes Konnossement wird in Sekunden extrahiert. Fünfhundert Konnossemente von 15 verschiedenen Reedereien werden nicht zu einer einfachen Multiplikation dieser Zahl – sie werden zu einem Formatverwaltungsproblem, für dessen Lösung vorlagenbasierte Tools nicht entwickelt wurden.
Warum Multi-Reederei-Konnossemente die vorlagenbasierte Extraktion sprengen
Die Seefrachtbranche wird von einer Handvoll dominanter Reedereien geprägt – Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen, HMM, Yang Ming, ZIM – und jede gibt Konnossemente auf ihrer eigenen proprietären Vorlage aus. Gehen wir die Unterschiede durch:
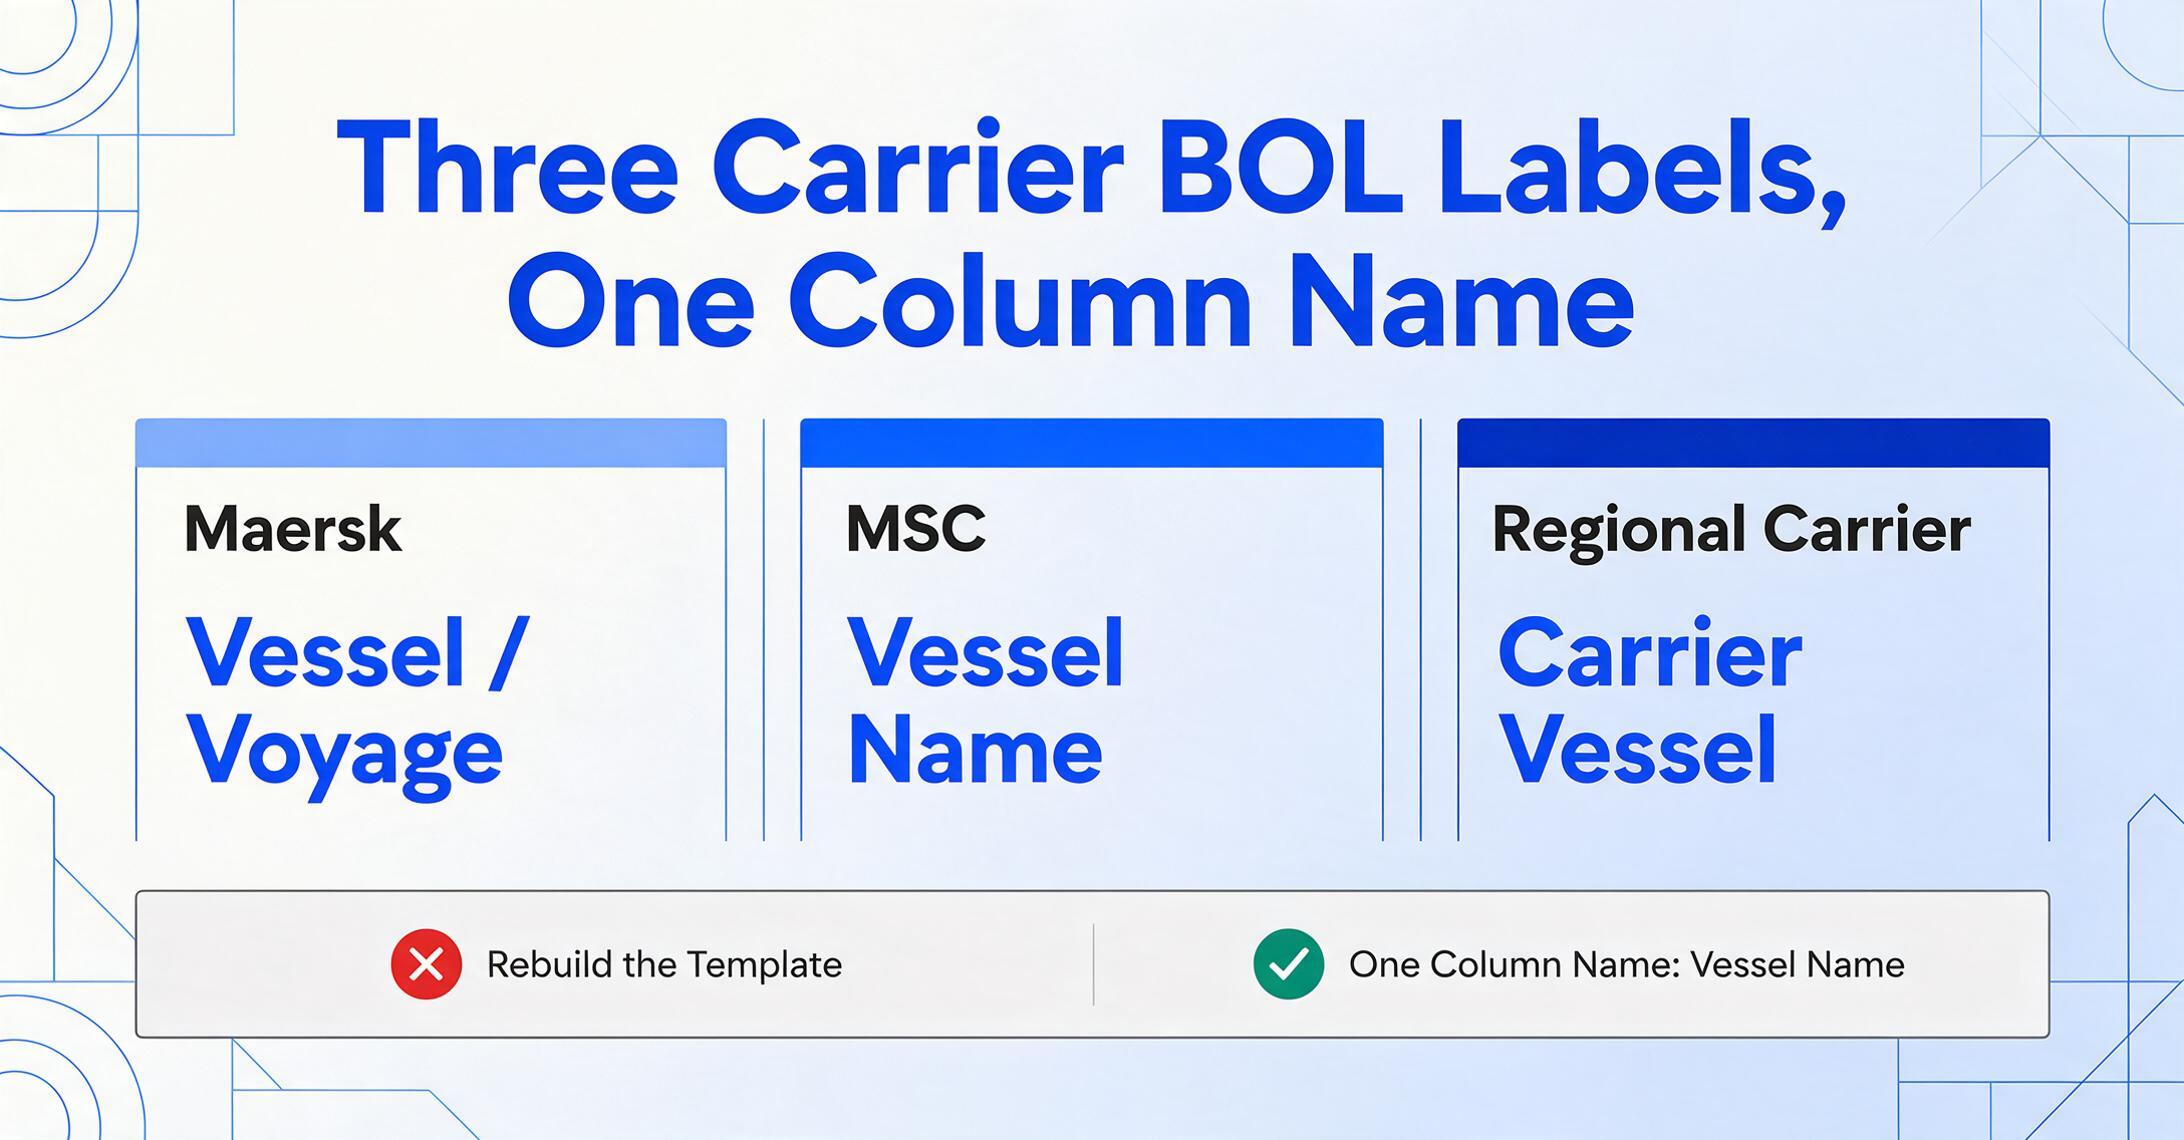
- Feldbenennung. Was Maersk als „Vessel / Voyage" bezeichnet, nennt MSC „Vessel Name" in einem Seitenbereich, und eine regionale Reederei nennt es „Carrier Vessel" im Fließtext. Drei verschiedene Bezeichnungen, dieselbe Information.
- Positionierung. Die B/L-Nummer kann in der oberen rechten Ecke der Vorlage einer Reederei und unten links bei einer anderen stehen. Containernummern können in einer Kopfzeilentabelle, einer mehrzeiligen Liste oder inline mit den Frachtbeschreibungen erscheinen.
- Datenformatierung. Eine Reederei schreibt Daten als TT/MM/JJJJ, eine andere als MM-TT-JJJJ. Gewichte können je nach Handelsroute und Reedereikonvention in Kilogramm, Pfund oder metrischen Tonnen angegeben sein.
- Seitenstruktur. Ein Konnossement für einen einzelnen Container umfasst eine Seite. Ein Konnossement für mehrere Container derselben Reederei kann sich auf fünf Seiten erstrecken – und eine andere Reederei formatiert Mehrcontainer-Fracht völlig anders.
Die National Customs Brokers and Forwarders Association of America (NCBFAA), die über 1.500 Mitgliedsunternehmen und 110.000 Beschäftigte im internationalen Handel vertritt, zählt zu ihren Mitgliedern Spediteure, deren Betriebe mehr als 97 % aller US-Importanmeldungen abwickeln. Diese Spediteure sind stündlich mit der Formatanbieter-Vielfalt konfrontiert.
Vorlagenbasierte Extraktionstools reagieren auf diese Vielfalt, indem sie für jedes Layout einer Reederei eine separate Vorlage erfordern. Wenn Sie mit 15 Reedereien arbeiten, erstellen Sie 15 Vorlagen. Wenn eine Reederei ihr Konnossement-Design aktualisiert – und das tun sie, sei es aus Gründen des Rebrandings, der regulatorischen Compliance oder der Systemmigration – bricht Ihre Vorlage stillschweigend. Das Tool, das die manuelle Eingabe überflüssig machen sollte, hat eine neue Wartungslast geschaffen: die Vorlagenpflege. Das Problem skaliert linear mit der Anzahl der Reedereien, und der Auslöser für eine Vorlagenaktualisierung ist immer, dass jemand bemerkt, dass keine Daten mehr fließen.
Die FIATA, der Internationale Dachverband der Spediteure, hat das Problem der Formatfragmentierung auf Standards-Ebene mit ihrem elektronischen FBL-Datenstandard angegangen – einer Open-Source-Digitalversion ihres handelbaren multimodalen Konnossements (FBL), abgebildet auf das UN/CEFACT-Multimodal-Transport-Referenzdatenmodell. Aber die eFBL-Einführung bei den Reedereien verläuft schrittweise, und die Papier- und PDF-Konnossemente, die heute in den Postfächern der Spediteure eintreffen, warten nicht auf eine Standardkonvergenz. Der Spediteur muss Daten aus dem extrahieren, was auch immer eintrifft.
Eine Spaltenliste für jede Reederei: Wie semantische Extraktion über BOL-Formate hinweg funktioniert
Die Alternative zu reedereispezifischen Vorlagen ist die Spaltennamen-Extraktion: Statt zu definieren, wo jeder Wert auf der Seite einer bestimmten Reederei sitzt, definieren Sie, welche Informationskategorie Sie suchen. Die KI liest das Dokument semantisch – sie versteht die Bedeutung jedes Datenelements, nicht seine Koordinaten – und findet Werte danach, was sie sind, nicht danach, wo sie erscheinen.
Ein konkretes Beispiel. Definieren Sie eine Spalte namens „B/L-Nummer“. Wenn die KI auf ein Maersk-Konnossement mit „Bill of Lading No. MAEU123456789“ im Kopfbereich stößt, erkennt sie das Muster und extrahiert „MAEU123456789“. Wenn sie auf ein MSC-Konnossement stößt, bei dem die B/L-Nummer in einem Seitenfeld mit anderer Formatierung als „MEDU987654321“ beschriftet ist, extrahiert sie „MEDU987654321“ – weil die KI versteht, dass beides Konnossementskennungen sind, nicht weil beide an denselben Pixelkoordinaten stehen. Der von Ihnen definierte Spaltenname ist das Zielkonzept. Die KI findet den entsprechenden Wert in jedem Format einer Reederei.
Hier ist die Feldliste, die ein typischer BOL-Extraktionsworkflow eines Spediteurs benötigt – und sie funktioniert ohne Änderung bei jeder Reederei:
B/L-Nummer  |  Buchungsnummer  |  Name des Versenders  |  Name des Empfängers  |  Benachrichtigungspartei
Schiffsname  |  Reisenummer  |  Verladehafen  |  Löschhafen
Containernummer  |  Siegelnnummer  |  HS-Code  |  Paketanzahl
Bruttogewicht  |  Frachtbeschreibung  |  Frachtbedingungen
Übernahmeort  |  Lieferort  |  Name der Reederei
Definieren Sie diese Spaltennamen einmalig — eine einmalige Einrichtung, kein Vorgang pro Dokument. Sie werden zu den Kopfzeilen Ihrer Ausgabetabelle. Jedes verarbeitete Konnossement von jeder Reederei erzeugt eine Zeile mit denselben Spalten in derselben Reihenfolge, unabhängig vom Layout, der Beschriftung oder der Seitenanzahl des Quelldokuments. Ein Batch von 50 Konnossementen von 12 Reedereien erzeugt eine Tabelle, nicht 12 Tabellen, die manuell zusammengefügt werden müssen.
Dieser Ansatz verarbeitet auch Konnossementstypen, die sich völlig unterscheiden. Ein ozeanisches Master-Konnossement (MBL), das von der Reederei an den Spediteur ausgestellt wird, ein ozeanisches House-Konnossement (HBL), das vom Spediteur an den Versender ausgestellt wird, und ein Luftfrachtbrief — drei Dokumente mit unterschiedlichen visuellen Layouts, unterschiedlichen Feldnamen, unterschiedlichen Datenmodellen — erzeugen Zeilen mit identischer Spaltenstruktur. Die KI passt sich automatisch an den Dokumenttyp an, da sie semantisch und nicht positionsbasiert liest.
Die Kernaussage: Die Informationen in einem Konnossement sind universell — Versender, Empfänger, Schiff, Fracht, Gewicht, Container. Was variiert, ist, wie jede Reederei sie darstellt. Semantische Extraktion entkoppelt die Informationen von ihrer Darstellung und macht das Reederei-Format zu einer irrelevanten Variable.
Der Batch-Workflow: Vom Reederei-Posteingang zur Kontrolltabelle
Der Montagmorgen eines Spediteurs beginnt typischerweise mit Konnossement-PDFs, die von Reedereien eintreffen, die über das Wochenende abgefahren sind. Sie kommen als E-Mail-Anhänge, Downloads aus Reederei-Portalen oder weitergeleitete Dokumente von Ursprungsagenten. Die Priorität liegt nicht darin, ein einzelnes Konnossement schnell zu extrahieren — sondern darin, alle in die Tracking-Tabelle zu bekommen, bevor Kunden nach Sendungsstatus fragen. Diese Updates beginnen meist damit, dass jemand einen Reederei-Tracking-Screenshot anhand der Tracking-Nummer auf jedem Konnossement zieht.
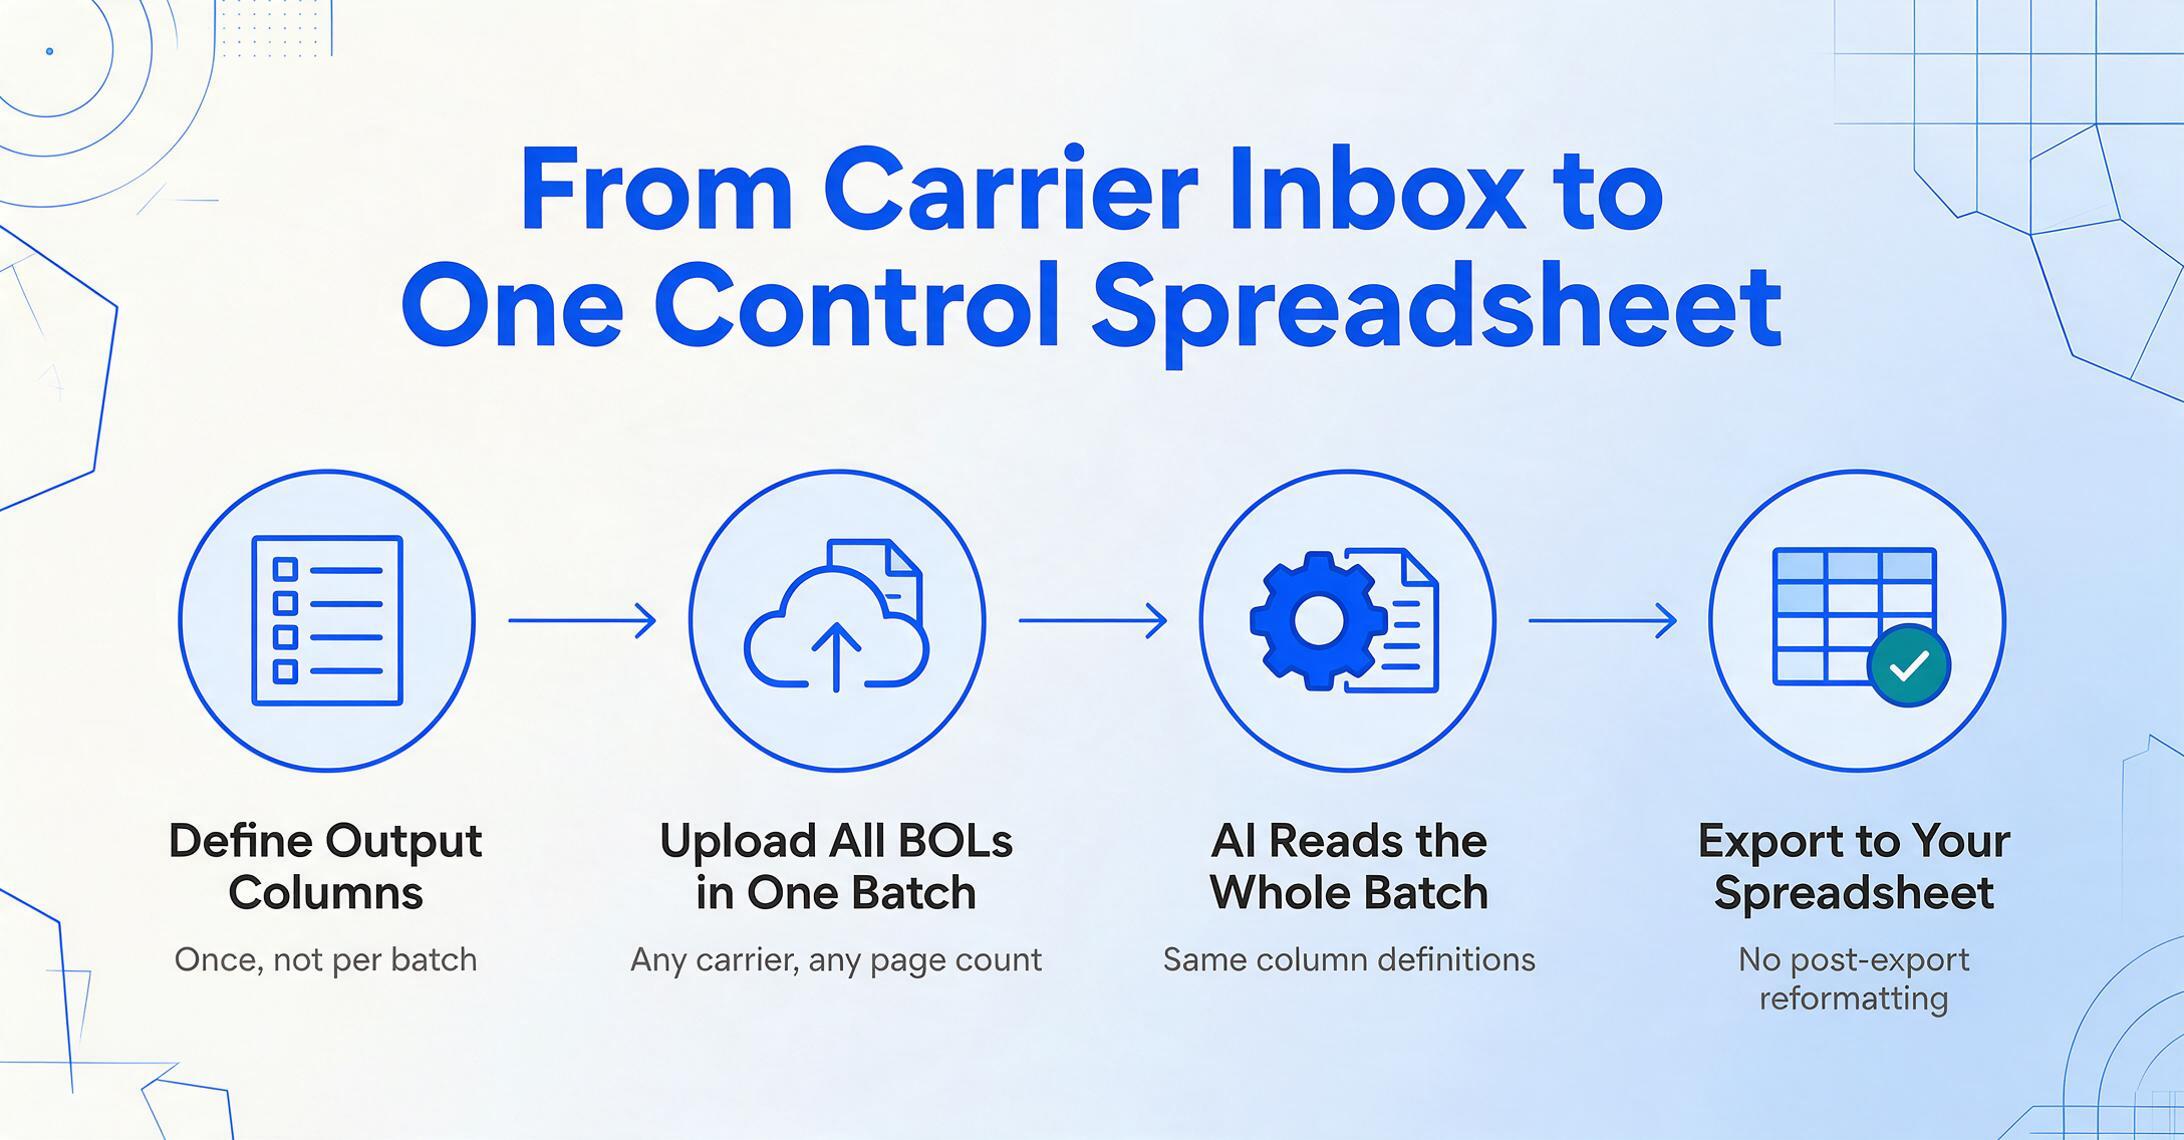
So funktioniert ein Stapelverarbeitungs-Workflow — bei dem Sie mehrere Dateien gleichzeitig hochladen und die KI alle mit denselben Spaltendefinitionen verarbeitet, um eine konsolidierte Ausgabe zu erzeugen — transformiert diese Morgenroutine:
Definieren Sie Ihre Ausgabespalten einmal. Geben Sie die Feldnamen ein, die extrahiert werden sollen — B/L-Nummer, Versender, Empfänger, Schiff, Verladehafen, Containernummer, Bruttogewicht usw. Diese werden zu den Spaltenüberschriften Ihrer Tabelle für jedes Konnossement, das Sie jemals verarbeiten. Die Einrichtung ist ein einmaliger Schritt, keine Operation pro Batch oder pro Reederei. Wenn Ihr nachgelagertes TMS oder Ihre Tracking-Tabelle bestimmte Spaltennamen erwartet, verwenden Sie hier genau diese Namen — „ContainerNo" statt „Container Number", wenn Ihr System das liest — und eliminieren Sie den Schritt der Nachbearbeitung nach dem Export.
Laden Sie alle Konnossemente in einem einzigen Batch hoch. Ziehen Sie PDFs, gescannte Dokumente oder Fotos von Konnossementen hinein — unabhängig von Reederei, Dokumenttyp oder Seitenzahl. Ein Maersk-PDF, ein MSC-Scan, ein mehrseitiges COSCO-Dokument und ein Screenshot eines Konnossements einer regionalen Reederei landen alle im selben Upload. Die KI verarbeitet sie als Gruppe und verwendet dieselben Felddefinitionen für jedes Dokument. Kein Sortieren der Dokumente, keine Gruppierung nach Reederei, keine Vorverarbeitung.
Prüfen Sie markierte Extraktionen, nicht jedes Feld. Die KI kennzeichnet Ergebnisse mit geringer Konfidenz — Felder, bei denen das Quelldokument eine schlechte Scanqualität, mehrdeutige Formatierung oder unerwartete Datenmuster aufwies. Prüfen Sie zuerst die markierten Elemente. Der Rest mit hohen Konfidenzwerten benötigt in der Regel keine manuelle Bearbeitung. Bei 500 Konnossementen pro Monat mit einer Feld-Konfidenzrate von über 95 % konzentriert sich der Prüfschritt auf etwa 25 Dokumente mit Randfällen, nicht auf 500 Dokumente mit zeilenweiser Verifizierung.
Exportieren Sie eine konsolidierte Tabelle. Die Ausgabe ist eine einzige Excel-Datei, in der jedes Konnossement eine Zeile ist. Jede Spalte ist über alle Reedereien hinweg identisch. Exportieren Sie als XLSX oder CSV, importieren Sie direkt in Ihr TMS, oder — wenn Sie mit Google Sheets arbeiten — nutzen Sie das Google Sheets-Add-on, um extrahierte Daten direkt in Ihre aktive Tabelle zu schreiben, ohne Sheets zu verlassen. Die Struktur ist konsistent: Zeile 1 ist ein Maersk-Konnossement, Zeile 2 ist ein MSC-Konnossement, Zeile 3 ist ein COSCO-Konnossement — und alle drei Zeilen haben ein identisches Spaltenlayout.
Die Verarbeitungszeit für eine einzelne Konnossementsseite liegt im Bereich von 5 bis 10 Sekunden. Ein Batch von 50 einseitigen Konnossementen ist in wenigen Minuten fertig — der limitierende Faktor ist die Gesamtseitenzahl, nicht die Formatvielfalt. Das Hinzufügen einer 16. Reederei zum Workflow kostet keine zusätzliche Einrichtungszeit, da die Semantische Extraktion nicht davon abhängt, mit wie vielen Reedereien Sie arbeiten.
Weitere Informationen zur Konnossement-Datenextraktion über jedes Reederei-Format hinweg finden Sie in unserem speziellen Konverter-Tool.
Was passiert, wenn etwas schiefgeht: Ausnahmebehandlung im großen Maßstab
Bei der Einzel-Dokumentenextraktion ist eine Ausnahme eine Unannehmlichkeit – Sie beheben sie und arbeiten weiter. Bei der Stapelverarbeitung über 15 Reedereien entscheidet die effiziente Lösung von Ausnahmen darüber, ob der Arbeitstag um 15:00 Uhr oder um 19:00 Uhr endet. Die Praxis der Ausnahmebehandlung in diesem Maßstab ist wichtiger als der Idealfall.
Die drei häufigsten Fehlerquellen bei der Stapelverarbeitung von Konnossementen mehrerer Reedereien:
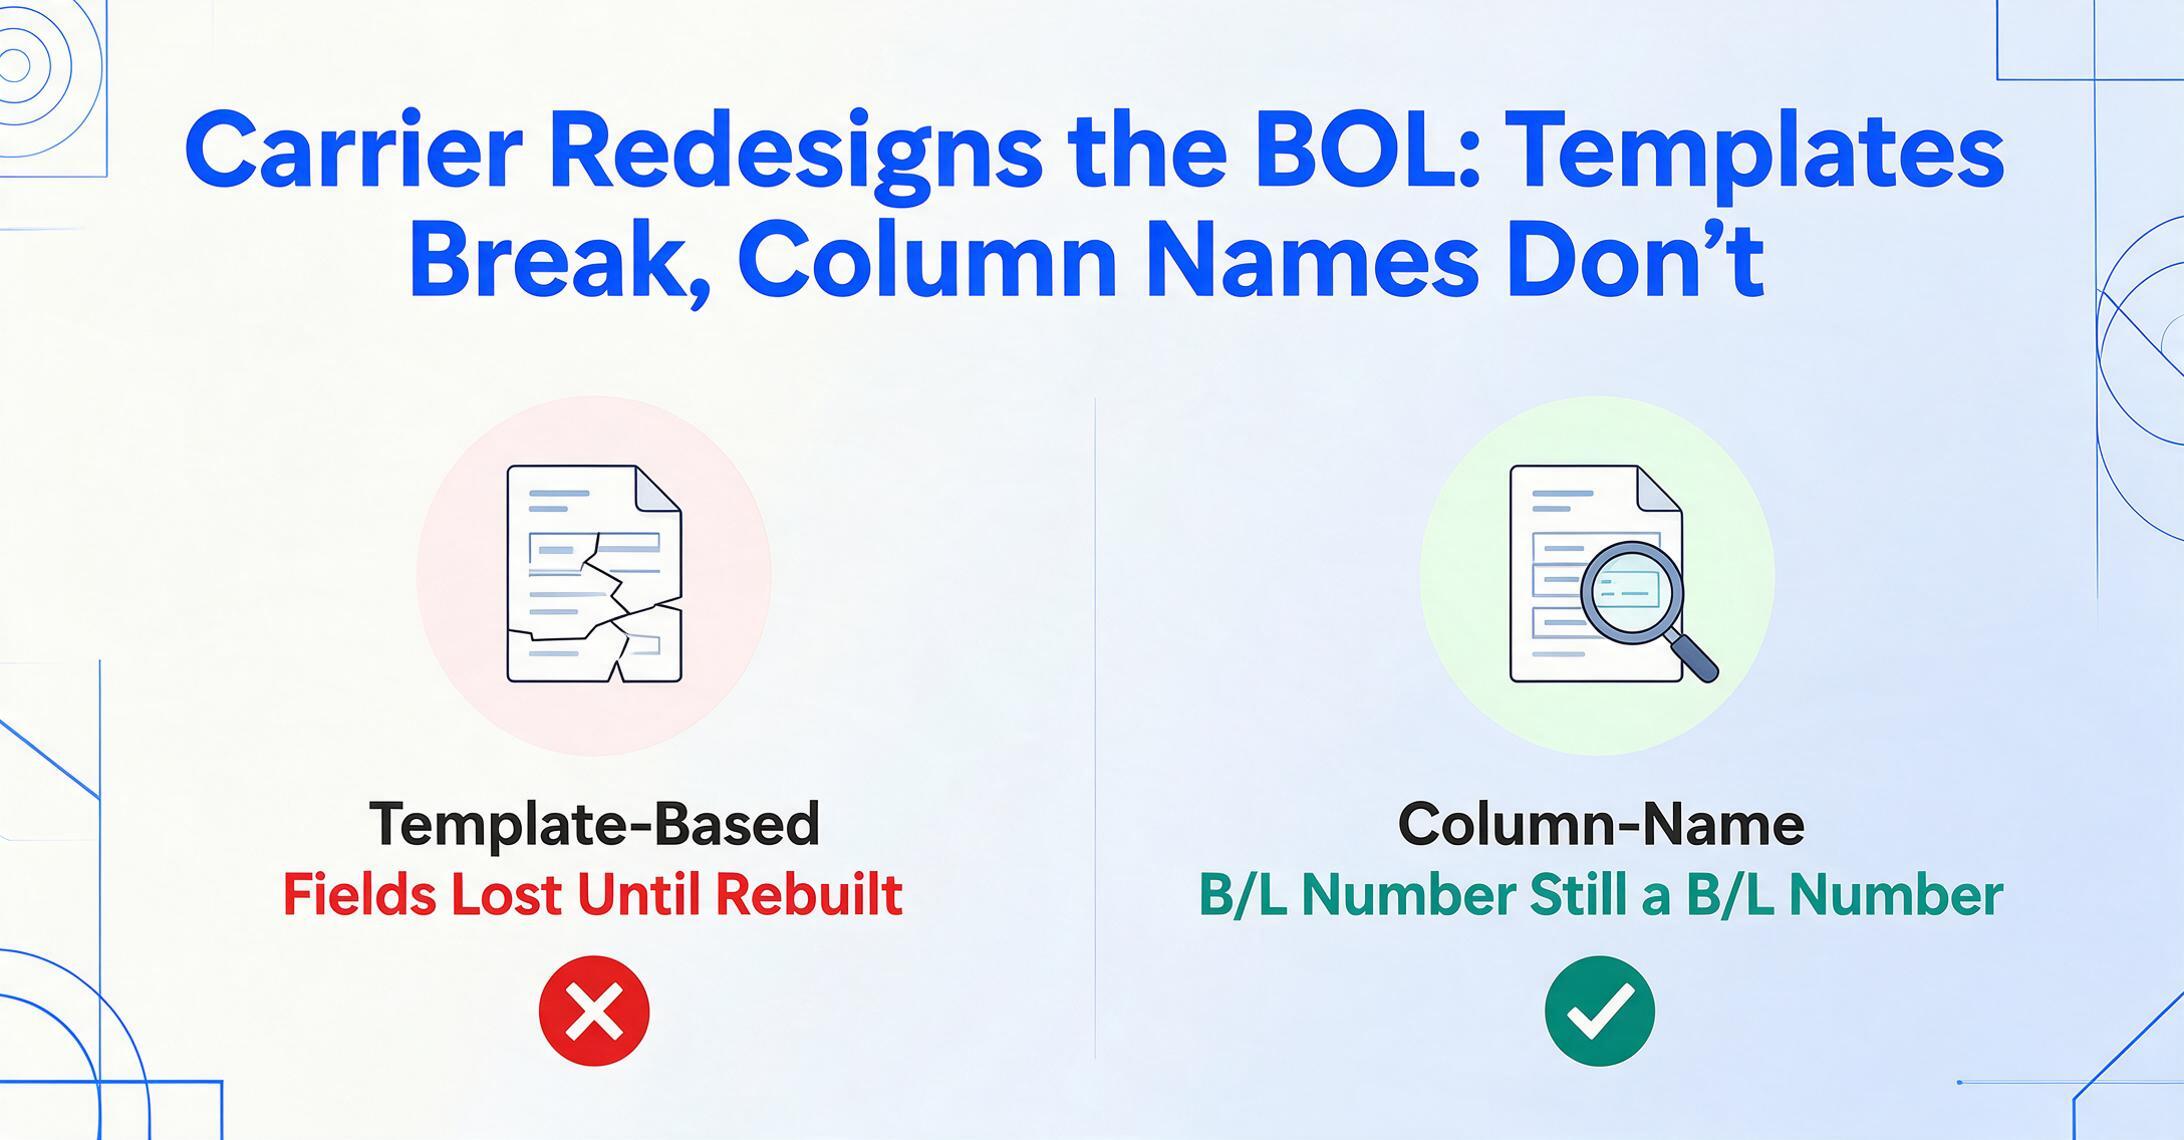
Vorlagenupdates der Reedereien. Als Maersk sein Konnossement-Layout neu gestaltete – Felder verschob, Tabellen neu organisierte, die Seitenstruktur anpasste – verloren vorlagenbasierte Extraktionstools den Überblick über diese Felder, bis jemand die Vorlage neu aufbaute. Die Spaltennamen-Extraktion geht damit anders um. Da die KI nicht an Pixelpositionen verankert ist, führt eine Layoutänderung nicht zum Scheitern der Extraktion, solange der Informationsgehalt derselbe bleibt. Die B/L-Nummer bleibt eine B/L-Nummer, unabhängig davon, wo sie auf der neu gestalteten Seite erscheint.
Schwankungen in der Scanqualität. Ein Konnossement, das als gestochen scharfes PDF aus Maersks System kam, und ein Konnossement, das unter fluoreszierender Lagerhausbeleuchtung fotografiert und von einem Ursprungsagenten weitergeleitet wurde, sind keine gleichwertigen Eingaben. Unscharfe Containernummern, verschmierte Gewichtsfelder und schräg gescannte Seiten reduzieren die Extraktionssicherheit. Die KI markiert diese Felder zur Überprüfung – der Bediener sieht, welche Felder Aufmerksamkeit benötigen, ohne Zeilen korrekt extrahierter Daten durchsuchen zu müssen. Für kritische handschriftliche Korrekturen auf Konnossementen (Gewichtsanpassungen, handschriftlich ergänzte Siegelnnummern) sollten Sie einen kurzen Prüfdurchlauf einplanen, anstatt vollständig automatisierte Extraktion von minderwertigen Scans zu erwarten.
Fehlende und mehrdeutige Felder. Nicht jede Reederei nimmt jedes Feld in jedes Konnossement auf. Eine regionale Reederei lässt möglicherweise den HS-Code weg. Ein LCL-Konsolidierungskonnossement lässt die Siegelnnummer möglicherweise leer. Vorlagenbasierte Tools behandeln ein fehlendes Feld oft als Extraktionsfehler. Die Semantische Extraktion geht anders damit um – das Feld bleibt einfach leer, und der Bediener entscheidet, ob die fehlenden Daten aus einem anderen Dokument (Packliste, Handelsrechnung) beschafft werden oder ob er ohne sie fortfährt. Die Verarbeitung von Packlisten und Konnossementen im selben Batch, mit Feldern, die sich zwischen Dokumenttypen überschneiden, ist eine natürliche Erweiterung dieses Workflows.
Das praktische Ergebnis: Bei einem Batch von 50 Konnossementen, die mit Spaltennamen-Extraktion verarbeitet werden, konzentriert sich der Prüfschritt auf etwa 2 bis 5 Dokumente mit markierten Feldern, nicht auf 50 Dokumente mit zeilenweiser Verifikation. Wenn Sie Extraktionstools noch vergleichen, bevor Sie sich festlegen, deckt unser Kopf-an-Kopf-Test von neun Logistikdokument-Extraktionstools genau diese Art von Formatvarianz bei mehreren Reedereien ab.
Wenn Ihre Konnossemente aus jedem Hafen kommen: Collection Links
Der Dokumentenfluss eines Spediteurs ist per Definition geografisch verteilt. Die Person, die physische Konnossemente im Verladehafen in Shanghai bearbeitet, ist nicht dieselbe Person, die die Kontrolltabelle am Hauptsitz in Rotterdam oder Chicago verwaltet. Jedes physische Dokument, das den Weg zum Datenerfassungsarbeitsplatz finden muss, ist eine weitere Übergabe – E-Mail-Weiterleitungen, Portal-Downloads, WhatsApp-Fotos – und jede Übergabe ist eine potenzielle Verzögerung oder Fehlleitung.
Collection Links lösen das Verteilungsproblem direkt. Ein Collection Link ist eine eindeutige, teilbare Upload-Seite (eine URL wie /c/xxxx), die Sie generieren und an diejenigen verteilen, die Dokumente am Ursprungsort bearbeiten – Lagerpersonal, Schiffsagenten, Partner-Spediteure, Abholfahrer. Der Empfänger öffnet den Link, gibt einen kurzen Verifizierungscode ein und lädt das Konnossement direkt hoch. Keine Kontoerstellung, kein Login, keine Schulung. Das Dokument landet in Ihrer Verarbeitungswarteschlange, und Sie prüfen und exportieren es über Ihr Dashboard.
Das eliminiert die Zwischenschritte vollständig. Statt „Ursprungsagent sendet Konnossement-PDF per E-Mail an die Betriebszentrale → Betriebszentrale lädt Anhang herunter → speichert in Ordner → lädt in Extraktionstool hoch" wird der Ablauf zu „Ursprungsagent öffnet Collection Link → lädt Konnossement hoch → Dokument erscheint in Ihrer Warteschlange zur Prüfung und zum Export." Drei Übergaben entfallen, und das Dokument ist innerhalb von Minuten nach Ausstellung zur Verarbeitung verfügbar – manchmal bevor das Schiff den Verladehafen überhaupt verlassen hat.
Für Spediteure, die Konnossemente über mehrere Handelsrouten und Zeitzonen hinweg verwalten, wo Dokumente rund um die Uhr aus verschiedenen Teilen der Welt eintreffen, verwandeln Collection Links eine sequenzielle, E-Mail-abhängige Übergabekette in eine parallele Direkt-Upload-Pipeline. Jeder Agent an jedem Hafen lädt an dasselbe Ziel hoch.
Häufig gestellte Fragen
Wie viele Konnossemente können in einem einzigen Batch verarbeitet werden?
Es gibt keine harte Obergrenze – Sie können beliebig viele Dateien in einem Batch hochladen. Realistisch betrachtet wird ein Batch von 50 bis 100 Konnossementen verschiedener Reedereien in wenigen Minuten verarbeitet. Die Gesamtverarbeitungszeit skaliert mit der Seitenanzahl, nicht mit der Formatvielfalt, da die KI jedes Dokument unabhängig mit denselben Spaltendefinitionen liest.
Kann dies See- und Luftfrachtdokumente im selben Batch verarbeiten?
Ja. Ein See-Konnossement, ein Luftfrachtbrief (AWB) und eine Packliste können im selben Batch mit denselben Spaltendefinitionen verarbeitet werden – solange die von Ihnen angegebenen Felder (Versender, Empfänger, Frachtbeschreibung, Gewicht) in diesen Dokumenttypen vorhanden sind. Die KI unterscheidet Dokumenttypen automatisch und passt ihre Leseart an. Für Felder, die nur in einem Dokumenttyp vorkommen (Flughafencodes auf AWBs, Containernummern auf See-Konnossementen), werden diese Spalten dort befüllt, wo die Daten vorhanden sind, und bleiben leer, wo sie fehlen.
Was passiert mit Konnossementen mit Handschrift oder Stempeln?
Klare Blockschrift und gestempelte Texte werden zuverlässig extrahiert. Handschriftliche Gewichtskorrekturen, Fahreranmerkungen und Änderungen der Plombennummer werden korrekt verarbeitet, sofern sie lesbar sind. Stark kursiv geschriebene Texte, verblasste Durchschläge und verschmierte Tintenstempel verringern die Erkennungssicherheit — diese Felder werden zur manuellen Überprüfung markiert. Wir empfehlen eine kurze Prüfung der handschriftlichen Felder, anstatt bei minderwertigen Quellen eine vollständig automatisierte Verarbeitung zu erwarten.
Wie schneidet dies im Vergleich zur integrierten Dokumenterkennung in meinem TMS ab?
Die meisten TMS-Plattformen mit integrierter OCR — einschließlich CargoWise, Descartes und Magaya — bieten eine Dokumenterkennung, die entweder vorlagenbasiert ist (mit Konfiguration pro Reederei) oder auf einen festen Satz vom TMS-Anbieter definierter Felder beschränkt ist. Die Spaltennamen-Extraktion gibt Ihnen die Kontrolle darüber, welche Felder extrahiert werden, einschließlich reedereispezifischer oder interner Referenzfelder, die generische BOL-OCR-Modelle nicht abdecken. Die Excel/CSV-Ausgabe kann in jedes TMS importiert werden, das Datei-Uploads akzeptiert, sodass die Lösung parallel zu Ihrem bestehenden System funktioniert, anstatt es zu ersetzen.
Kann ich dies zur Verarbeitung von Konnossementen auf Chinesisch, Japanisch oder anderen Sprachen verwenden?
Ja. Die KI verarbeitet Konnossemente in mehreren Sprachen. Ein chinesischsprachiges COSCO-Konnossement und ein englischsprachiges Maersk-Konnossement können im selben Batch verarbeitet werden — die von Ihnen auf Englisch definierten Spaltennamen dienen als Extraktionsziele, und die KI lokalisiert die entsprechenden Werte unabhängig von der Dokumentensprache. Internationale Frachtteams, die Sendungen über verschiedene Handelsrouten abwickeln, arbeiten in einem einzigen Workflow.
Für Teams, die umfassendere Logistikdokumentations-Workflows verwalten, finden Sie in unseren Leitfäden Informationen zum Batch-Extrahieren von Lieferscheinen und Versandnotizen und zur Batch-Verarbeitung von Bestellungen über Lieferanten hinweg. Wenn Sie die Kosten der manuellen Dateneingabe bewerten, lesen Sie über die versteckten Kosten der manuellen Dateneingabe.
Für das Einzeldokument-Pendant zu diesem Workflow — mit feldweiser Extraktion, Handhabung von Reedereiformaten und Schritt-für-Schritt-Einrichtung — siehe So extrahieren Sie Konnossementdaten ohne API oder IT-Einrichtung nach Excel.