Procese por lotes conocimientos de embarque de varias
navieras en una sola hoja de cálculo
Un transitario de tamaño mediano gestiona aproximadamente 500 conocimientos de embarque al mes de entre 10 y 20 navieras oceánicas distintas. A 10 o 15 minutos por documento para leer, escribir y verificar —el punto de referencia documentado por el análisis de CSA Software sobre la entrada manual de datos en el transporte de mercancías—, eso supone de 83 a 125 horas de trabajo cada mes, dedicadas solo al paso de transcripción. Sin contar la resolución de excepciones, el seguimiento con las navieras ni el trabajo de decisiones que mueve la carga. Solo mover datos del PDF a la hoja de cálculo. Y la causa raíz no es el volumen. Es que cada naviera imprime la misma información de forma diferente.
Un BOL frente a 500: la brecha de eficiencia que los tutoriales de documentos individuales no cubren
Un solo conocimiento de embarque extraído a Excel tarda de 5 a 10 segundos con extracción impulsada por IA, aproximadamente 18 veces más rápido que la entrada manual. Ese es el estándar de referencia para la automatización a nivel de documento, y extraer un BOL a Excel uno a la vez lo logra de forma fiable.
Pero la velocidad de un solo documento no es el cuello de botella a escala operativa. El cuello de botella es el espacio entre documentos. Es la fricción acumulada de alternar entre un BOL de Maersk, un BOL de MSC, una plantilla de COSCO, un formato de Hapag-Lloyd, un diseño de ONE — cada uno con diferente ubicación de campos, diferentes convenciones de nomenclatura, diferentes estructuras de tablas — y producir una hoja de cálculo unificada donde Número B/L signifique lo mismo en cada fila.
Según un análisis de Expedock sobre operaciones de transitarios, el personal de operaciones dedica de 2 a 4 horas diarias solo a ingresar y auditar datos en sistemas de gestión de transporte. Para un equipo que procesa 300 envíos mensuales, eso son 150 horas consumidas solo en entrada de datos — tiempo que no está disponible para negociación de tarifas, gestión de excepciones o atención al cliente. El costo no está en los minutos por documento. Está en las horas mensuales que se acumulan entre navieras.
Un solo BOL se extrae en segundos. Quinientos BOL de 15 navieras diferentes no se convierten en una simple multiplicación de esa cifra — se convierten en un problema de gestión de formatos que las herramientas basadas en plantillas no fueron diseñadas para resolver.
Por qué los BOL de múltiples navieras rompen la extracción basada en plantillas
La industria del transporte marítimo opera con un puñado de navieras dominantes — Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen, HMM, Yang Ming, ZIM — y cada una emite conocimientos de embarque en su propia plantilla propietaria. Veamos las diferencias:
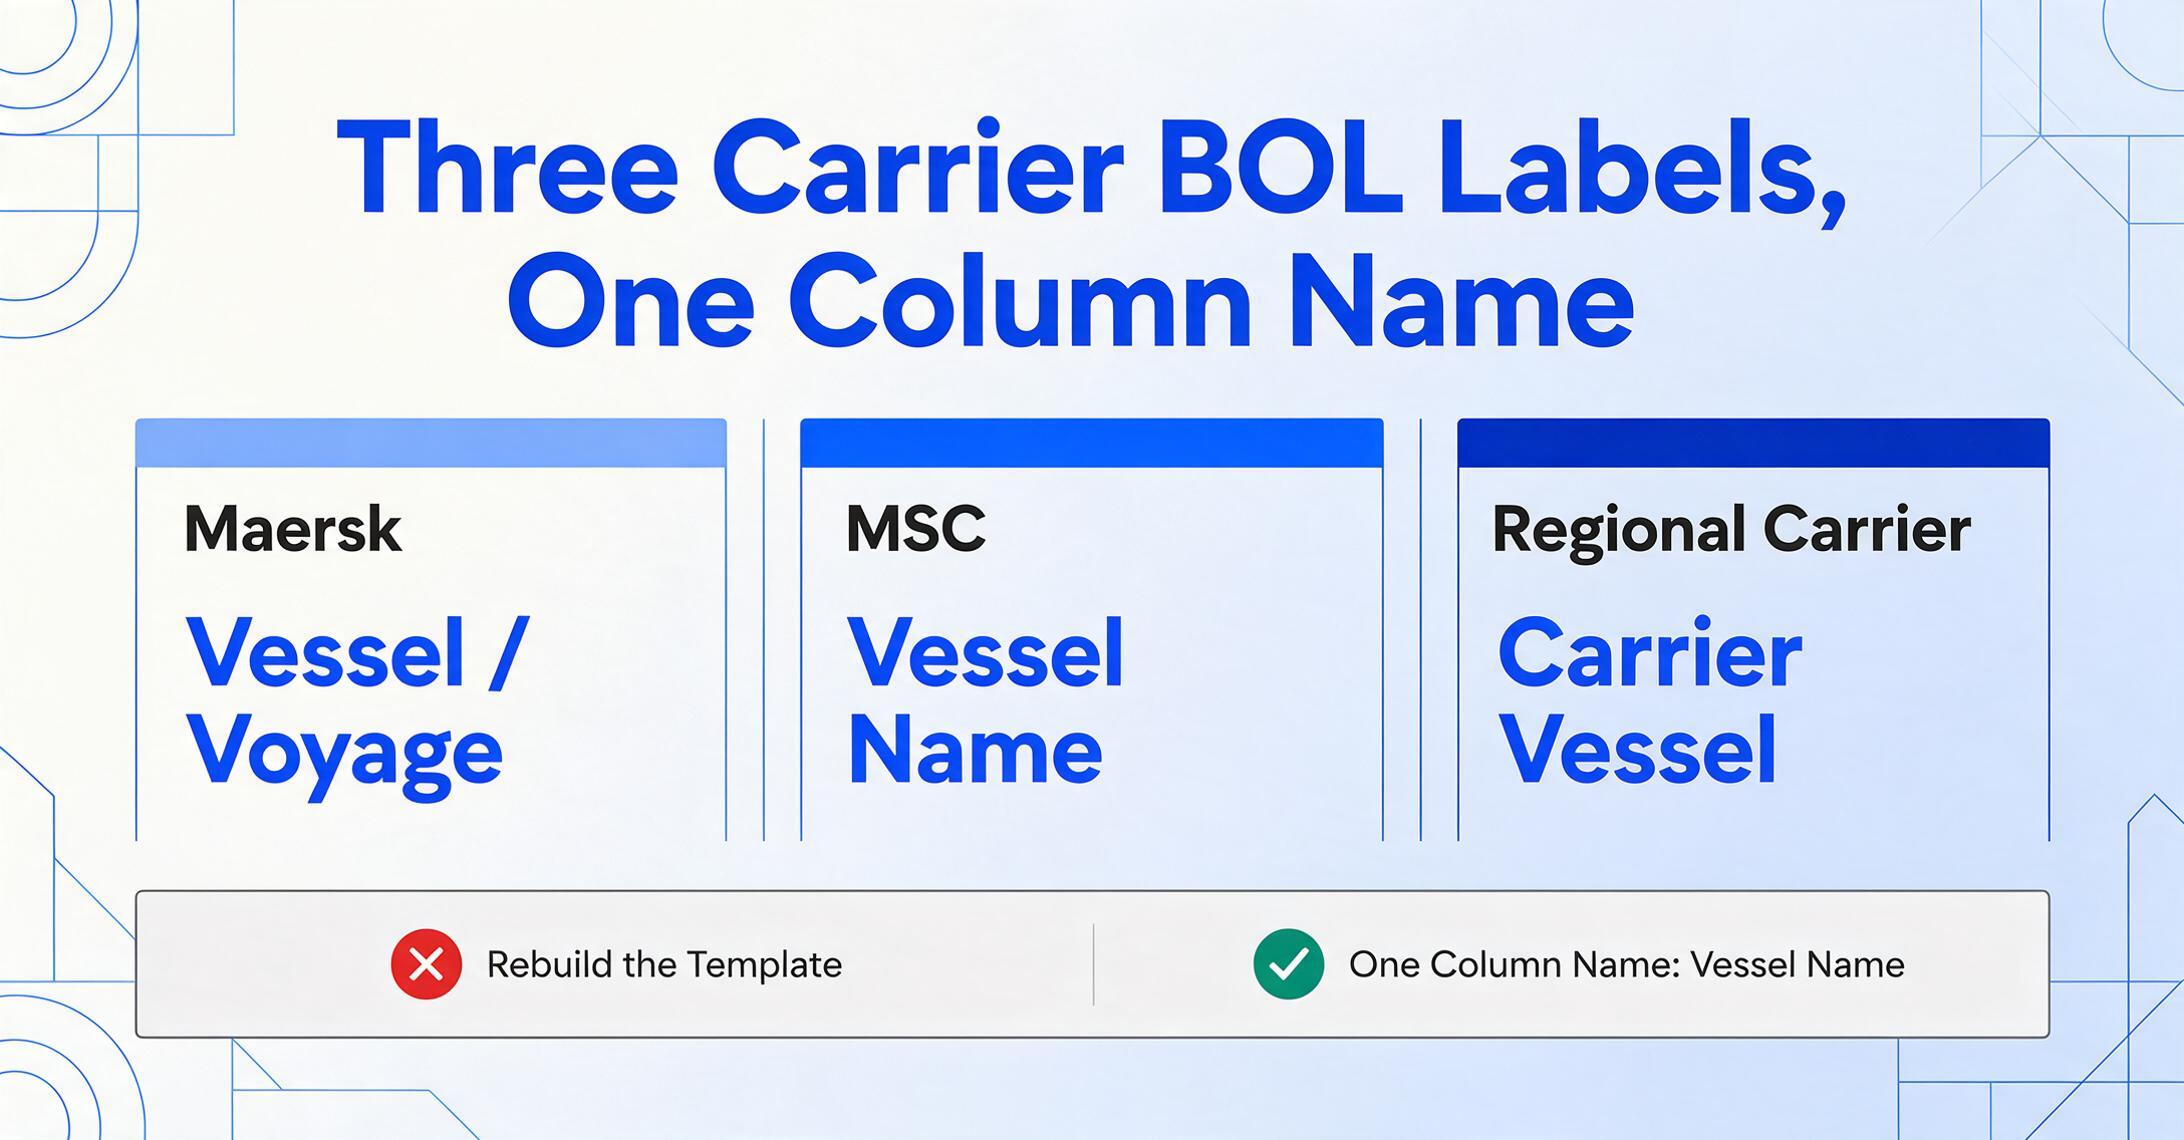
- Nomenclatura de campos. Lo que Maersk etiqueta como "Vessel / Voyage", MSC lo etiqueta como "Vessel Name" en un panel lateral, y una naviera regional lo llama "Carrier Vessel" en el texto del cuerpo. Tres etiquetas diferentes, misma información.
- Posicionamiento. El Número B/L puede estar en la esquina superior derecha de la plantilla de una naviera y en la inferior izquierda de otra. Los números de contenedor pueden aparecer en una tabla de encabezado, en una lista de varias líneas o junto a las descripciones de carga.
- Formato de datos. Una naviera escribe las fechas como DD/MM/AAAA, otra como MM-DD-AAAA. Los pesos pueden estar en kilogramos, libras o toneladas métricas según la ruta comercial y la convención de la naviera.
- Estructura de página. Un BOL de un solo contenedor ocupa una página. Un BOL de varios contenedores de la misma naviera puede extenderse a cinco páginas — y una naviera diferente formatea la carga de varios contenedores de forma completamente distinta.
La Asociación Nacional de Corredores de Aduanas y Transitarios de Estados Unidos (NCBFAA), que representa a más de 1,500 empresas miembro y 110,000 empleados en el comercio internacional, cuenta entre sus miembros con transitarios cuyas operaciones gestionan más del 97% de todas las declaraciones de importación de EE. UU. Estos transitarios lidian con la diversidad de formatos de las navieras cada hora de cada día laborable.
Las herramientas de extracción basadas en plantillas responden a esta diversidad exigiendo una plantilla separada para el diseño de cada naviera. Si trabaja con 15 navieras, crea 15 plantillas. Cuando una naviera actualiza su diseño de conocimiento de embarque — y lo hacen, ya sea por cambio de marca, cumplimiento normativo o migración de sistemas — su plantilla se rompe silenciosamente. La herramienta que debía eliminar el tecleo manual ha creado una nueva carga de mantenimiento: la curación de plantillas. El problema crece linealmente con el número de navieras, y el detonante para actualizar una plantilla es siempre que alguien note que los datos dejaron de fluir.
FIATA, la Federación Internacional de Asociaciones de Transitarios, ha abordado el problema de la fragmentación de formatos a nivel de estándares con su estándar de datos electrónico FBL — una versión digital de código abierto de su Conocimiento de embarque multimodal negociable (FBL) mapeado al Modelo de Datos de Referencia de Transporte Multimodal de UN/CEFACT. Pero la adopción del eFBL entre las navieras es gradual, y los conocimientos de embarque en papel y PDF que llegan hoy a las bandejas de entrada de los transitarios no esperan a que los estándares converjan. El transitario necesita extraer datos de lo que llegue.
Una Lista de Columnas, Todas las Navieras: Cómo Funciona la Extracción Semántica en los Formatos de Conocimiento de Embarque
La alternativa a las plantillas por naviera es la extracción por nombre de columna: en lugar de definir dónde se sitúa cada valor en la página de una naviera concreta, define qué categoría de información busca. La IA lee el documento semánticamente — comprendiendo el significado de cada dato, no sus coordenadas — y localiza los valores por lo que son, no por dónde aparecen.
Un ejemplo concreto. Defina una columna llamada "Número B/L". Cuando la IA encuentra un conocimiento de embarque de Maersk con "Bill of Lading No. MAEU123456789" en el encabezado, reconoce el patrón y extrae "MAEU123456789". Cuando encuentra un conocimiento de embarque de MSC donde el número B/L está etiquetado como "MEDU987654321" en un recuadro lateral con formato diferente, extrae "MEDU987654321" — porque la IA entiende que ambos son identificadores de conocimiento de embarque, no porque ambos estén en las mismas coordenadas de píxeles. El nombre de columna que definió es el concepto objetivo. La IA encuentra el valor correspondiente en cualquier formato de naviera.
Esta es la lista de campos que necesita un flujo de trabajo típico de extracción de conocimientos de embarque para transitarios, y funciona con todas las navieras sin modificación:
Número B/L  |  Número de Reserva  |  Nombre del Cargador  |  Nombre del Consignatario  |  Parte Notificada
Nombre del Buque  |  Número de Viaje  |  Puerto de Carga  |  Puerto de Descarga
Número de Contenedor  |  Número de Sello  |  Código SA  |  Cantidad de Bultos
Peso Bruto  |  Descripción de la Carga  |  Términos de Flete
Lugar de Recepción  |  Lugar de Entrega  |  Nombre de la Naviera
Define estos nombres de columnas una sola vez — una configuración inicial, no una operación por documento. Se convierten en los encabezados de tu hoja de cálculo de salida. Cada BOL que proceses de cada naviera genera una fila con las mismas columnas en el mismo orden, independientemente del diseño, etiquetado o número de páginas del documento de origen. Un lote de 50 BOLs de 12 navieras produce una tabla, no 12 tablas que necesiten unión manual.
Este enfoque también maneja tipos de BOL que no se parecen en nada. Un conocimiento de embarque maestro (MBL) marítimo emitido por la naviera al transitario, un conocimiento de embarque de transitario (HBL) marítimo emitido por el transitario al cargador, y una guía aérea — tres documentos con diseños visuales diferentes, nombres de campos diferentes, modelos de datos diferentes — producen filas con estructura de columnas idéntica. La IA se adapta al tipo de documento automáticamente porque lee semánticamente, no posicionalmente.
La idea clave: la información en un conocimiento de embarque es universal — cargador, consignatario, buque, carga, peso, contenedor. Lo que varía es cómo cada naviera elige mostrarla. La extracción semántica desvincula la información de su presentación, haciendo que el formato de la naviera sea una variable irrelevante.
El Flujo de Trabajo por Lotes: De la Bandeja de Entrada de la Naviera a la Hoja de Control
El lunes por la mañana de un transitario normalmente comienza con PDFs de BOL que llegan de navieras que zarparon durante el fin de semana. Llegan como archivos adjuntos de correo electrónico, descargas del portal de la naviera o documentos reenviados desde agentes de origen. La prioridad no es extraer un BOL rápidamente — es meterlos todos en la hoja de seguimiento antes de que los clientes empiecen a preguntar por el estado de sus envíos. Esas actualizaciones suelen comenzar con alguien obteniendo una captura de seguimiento de la naviera desde el número de seguimiento de cada BOL.
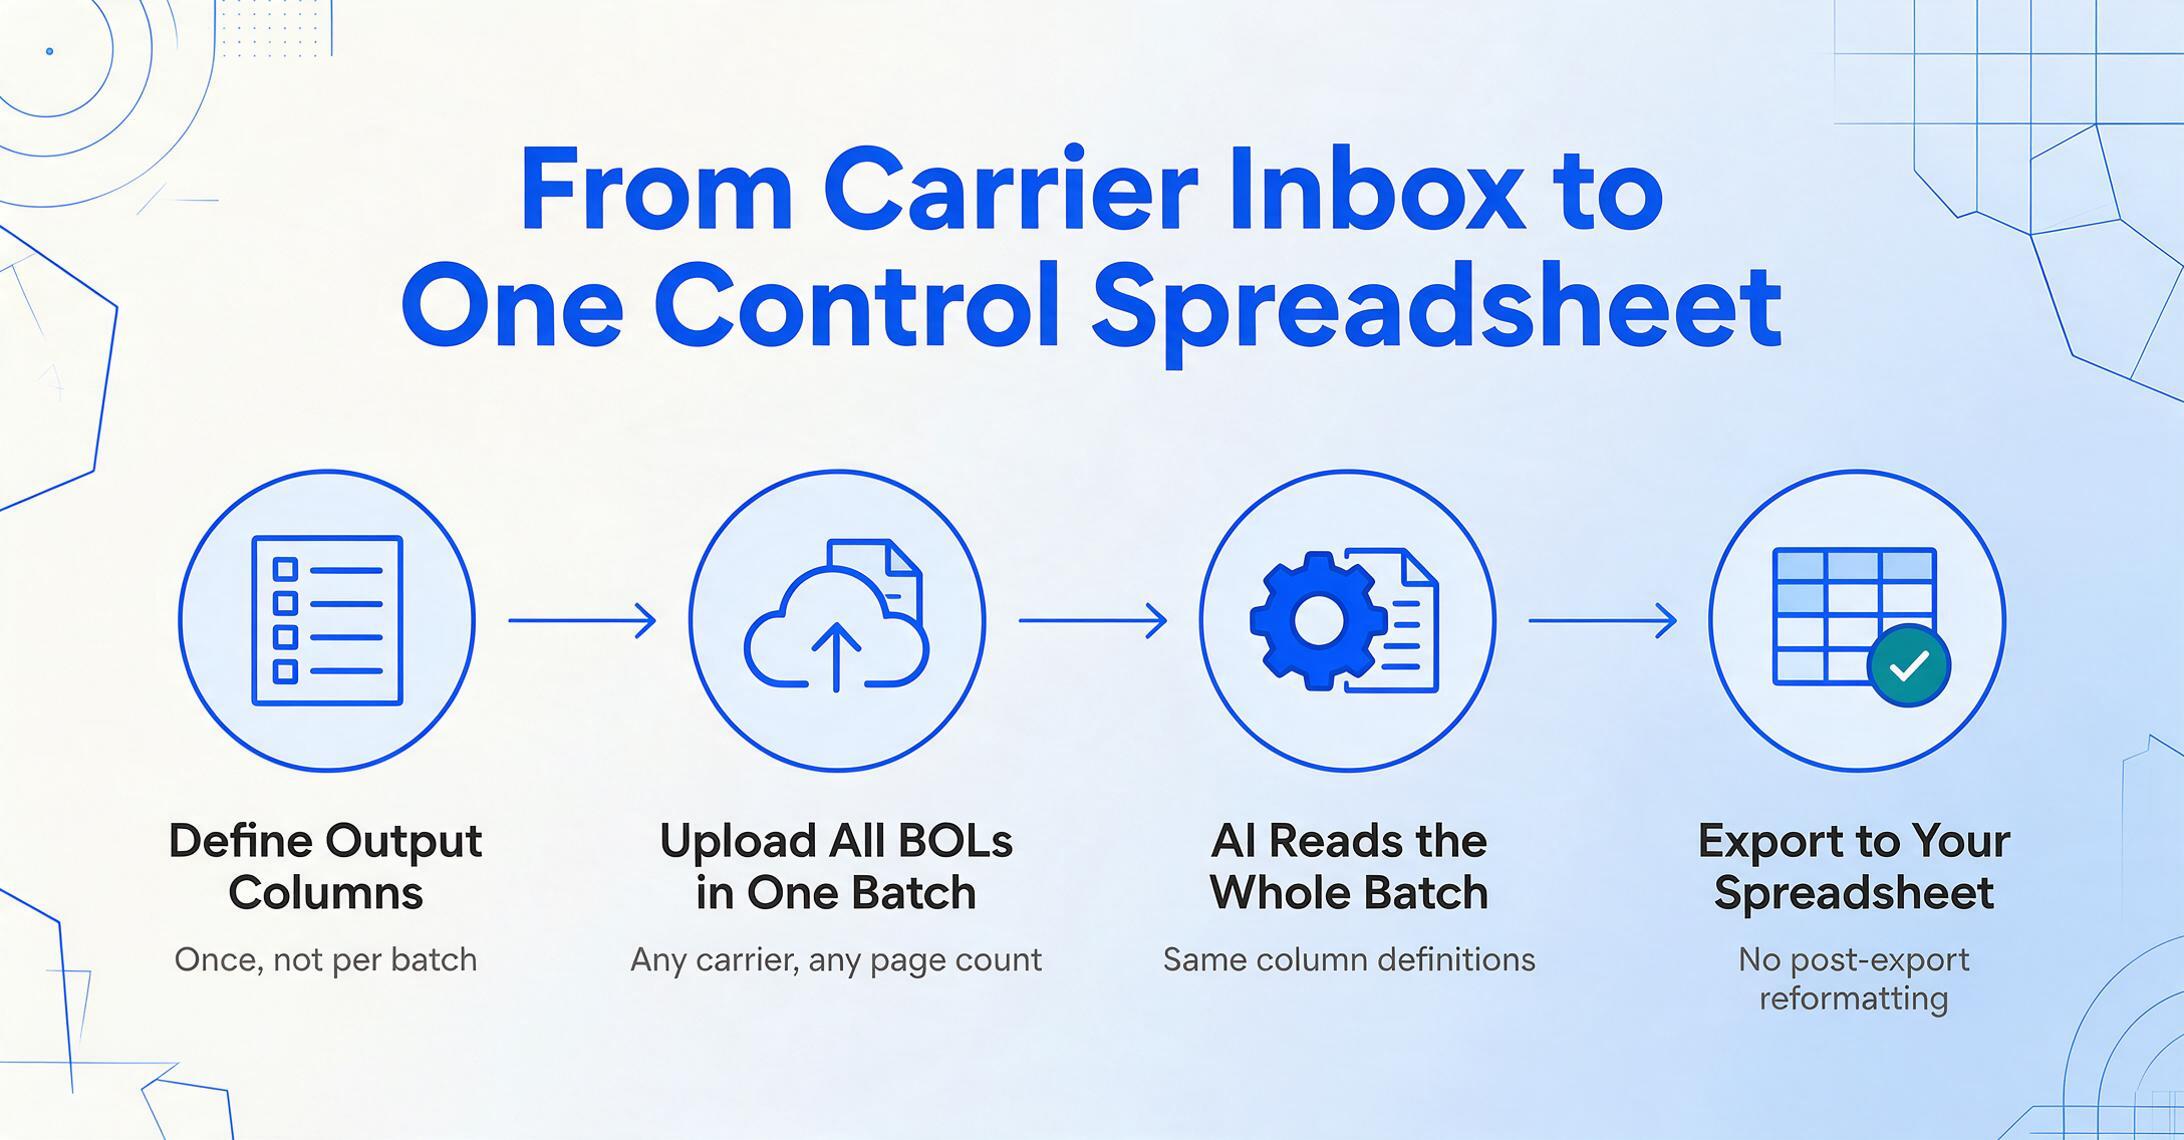
Así es como un flujo de trabajo de procesamiento por lotes — donde subes varios archivos a la vez y la IA procesa todos ellos usando las mismas definiciones de columnas para producir una salida consolidada — transforma esa rutina matutina:
Defina sus columnas de salida una sola vez. Ingrese los nombres de los campos que necesita extraer — Número B/L, Remitente, Consignatario, Buque, Puerto de carga, Número de contenedor, Peso bruto, entre otros. Estos se convierten en los encabezados de columna de su hoja de cálculo en cada Conocimiento de embarque que procese. La configuración es un paso único, no una operación por lote o por naviera. Si su TMS o su hoja de cálculo de seguimiento espera nombres de encabezado específicos, use esos nombres exactos aquí — "ContainerNo" en lugar de "Número de contenedor", si es lo que su sistema lee — y elimine el paso de reformateo posterior a la exportación.
Sube todos los Conocimientos de embarque en un solo lote. Arrastre PDF, documentos escaneados o fotos de Conocimientos de embarque — sin importar la naviera, el tipo de documento o la cantidad de páginas. Un PDF de Maersk, un escaneo de MSC, un documento de varias páginas de COSCO y una captura de pantalla del Conocimiento de embarque de una naviera regional van todos a la misma carga. La IA los procesa como un grupo, usando las mismas definiciones de campos en cada documento. Sin clasificación de documentos, sin agrupación por naviera, sin preprocesamiento.
Revise las extracciones marcadas, no todos los campos. La IA marca los resultados de baja confianza — campos donde el documento fuente tenía mala calidad de escaneo, formato ambiguo o patrones de datos inesperados. Revise primero los elementos marcados. El resto, con puntuaciones de confianza altas, normalmente no requiere intervención manual. Con 500 Conocimientos de embarque al mes y una tasa de confianza a nivel de campo superior al 95 %, el paso de revisión se centra en aproximadamente 25 documentos con casos límite, no en 500 documentos de verificación línea por línea.
Exporte una hoja de cálculo consolidada. La salida es un único archivo de Excel donde cada Conocimiento de embarque es una fila. Cada columna es la misma en todas las navieras. Exporte a XLSX o CSV, importe directamente a su TMS o — si trabaja en Google Sheets — use el complemento de Google Sheets para escribir los datos extraídos directamente en su hoja de cálculo activa sin salir de Sheets. La estructura es consistente: la fila 1 es un Conocimiento de embarque de Maersk, la fila 2 es uno de MSC, la fila 3 es uno de COSCO — y las tres filas tienen un diseño de columnas idéntico.
El tiempo de procesamiento de una sola página de Conocimiento de embarque está en el rango de 5 a 10 segundos. Un lote de 50 Conocimientos de embarque de una página se completa en unos minutos — el factor limitante es el número total de páginas, no la diversidad de formatos. Añadir la naviera n.º 16 al flujo de trabajo no cuesta tiempo adicional de configuración porque la extracción semántica no le importa con cuántas navieras trabaje.
Para más información sobre la extracción de datos de conocimientos de embarque en cualquier formato de naviera, consulte nuestra herramienta de conversión dedicada.
Qué sucede cuando las cosas salen mal: gestión de excepciones a escala
En la extracción de un solo documento, una excepción es un inconveniente: la corrige y continúa. En el procesamiento por lotes de 15 navieras, resolver excepciones de manera eficiente es lo que determina si la jornada laboral termina a las 3:00 p. m. o a las 7:00 p. m. La práctica de la gestión de excepciones a esta escala importa más que el camino feliz.
Los tres modos de fallo más comunes en el procesamiento por lotes de BOL de varias navieras:
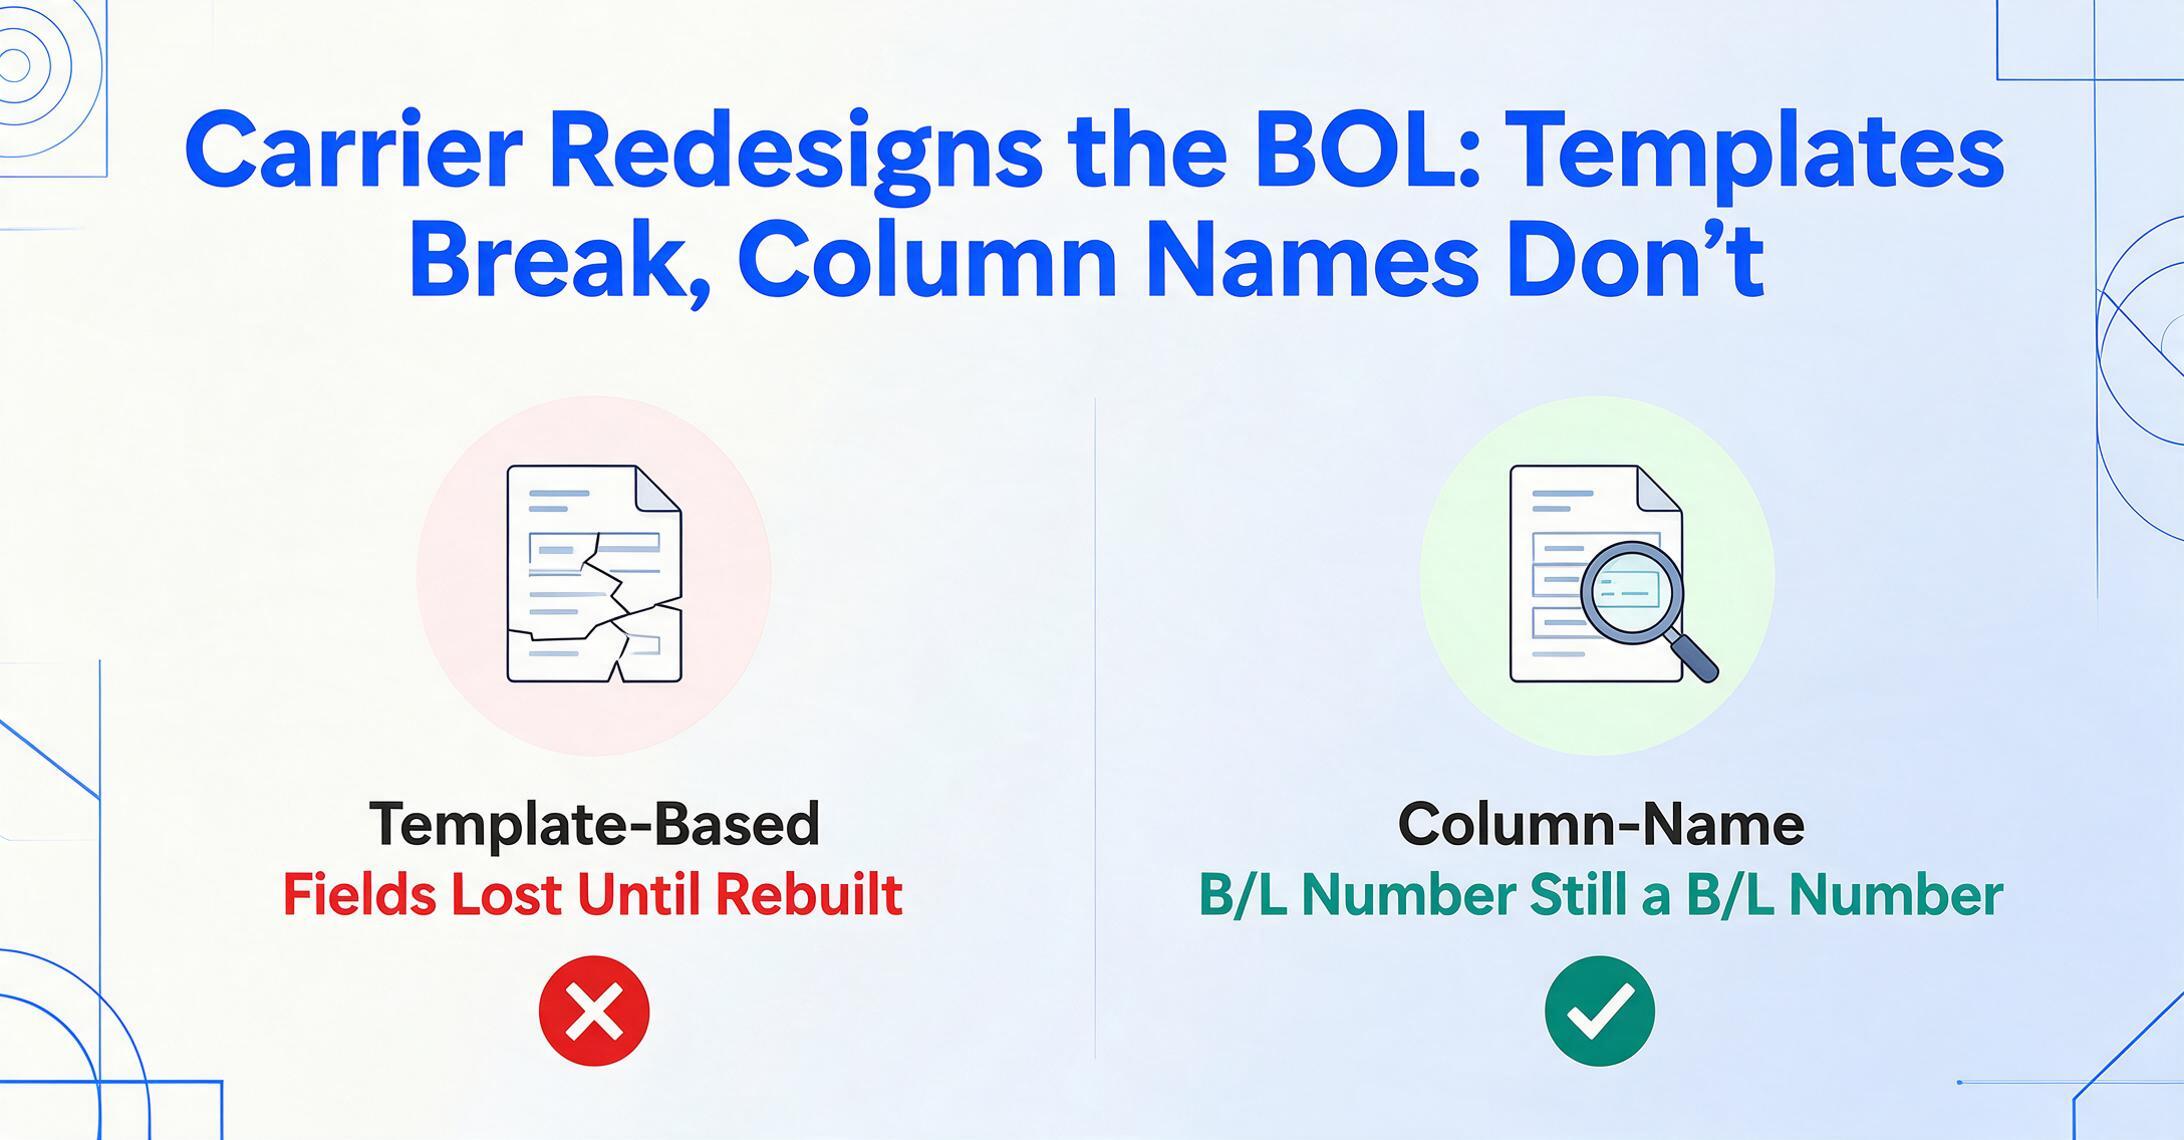
Actualizaciones de plantillas de las navieras. Cuando Maersk rediseñó su formato de BOL (moviendo ciertos campos, reorganizando tablas, ajustando la estructura de la página), las herramientas de extracción basadas en plantillas perdieron el rastro de esos campos hasta que alguien reconstruyó la plantilla. La extracción por nombre de columna maneja esto de manera diferente. Dado que la IA no está anclada a posiciones de píxeles, un cambio de diseño no interrumpe la extracción siempre que el contenido de la información siga siendo el mismo. El número B/L sigue siendo un número B/L, independientemente de dónde aparezca en la página rediseñada.
Variación en la calidad del escaneo. Un BOL que llegó como un PDF nítido desde el sistema de Maersk y un BOL que fue fotografiado bajo la iluminación fluorescente de un almacén y reenviado por un agente de origen no son entradas iguales. Los números de contenedor borrosos, los campos de peso manchados y las orientaciones de página sesgadas reducen la confianza de la extracción. La IA los marca para revisión: el operador ve qué campos necesitan atención sin buscar entre filas de datos extraídos correctamente. Para correcciones manuscritas críticas en los BOL (ajustes de peso, cambios de número de sello añadidos a mano), planifique una pasada de revisión rápida en lugar de esperar una extracción totalmente automatizada de escaneos degradados.
Campos faltantes y ambiguos. No todas las navieras incluyen todos los campos en cada BOL. Una naviera regional podría omitir el código SA. Un BOL de consolidación LCL podría dejar el número de sello en blanco. Las herramientas basadas en plantillas a menudo tratan un campo faltante como un fallo de extracción. La extracción semántica lo maneja de manera diferente: el campo simplemente devuelve un valor vacío, y el operador decide si obtener los datos faltantes de otro documento (una lista de empaque, una factura comercial) o continuar sin ellos. Procesar listas de empaque y BOL juntos en el mismo lote, con campos que se superponen entre tipos de documentos, es una extensión natural de este flujo de trabajo.
El resultado práctico: para un lote de 50 BOL procesados con extracción por nombre de columna, el paso de revisión se centra en aproximadamente 2 a 5 documentos con campos marcados, no en 50 documentos con verificación línea por línea. Si todavía está comparando herramientas de extracción antes de comprometerse con una, nuestra prueba comparativa de nueve herramientas de extracción de documentos logísticos cubre exactamente este tipo de variación de formato entre varias navieras.
Cuando sus B/L llegan desde todos los puertos: Enlaces de Recopilación
El flujo de documentos de un transitario está distribuido geográficamente por definición. La persona que maneja los B/L físicos en el puerto de carga en Shanghái no es la que gestiona la hoja de cálculo de control en la sede central en Róterdam o Chicago. Cada documento físico que necesita llegar al escritorio de entrada de datos es una transferencia más — reenvíos de correo electrónico, descargas del portal, fotos de WhatsApp — y cada transferencia es un posible retraso o error de enrutamiento.
Collection Links resuelven el problema de distribución directamente. Un Collection Link es una página de carga única y compartible (una URL como /c/xxxx) que usted genera y distribuye a quien maneja los documentos en origen — personal del almacén, agentes de carga, transitarios asociados, conductores de recogida. El destinatario abre el enlace, ingresa un código de verificación corto,y sube el B/L directamente. Sin creación de cuenta, sin inicio de sesión, sin capacitación. El documento llega a su cola de procesamiento,y usted lo revisa y exporta desde su panel de control.
Esto elimina los pasos intermedios por completo. En lugar de "el agente de origen envía por correo el PDF del B/L al escritorio de operaciones → operaciones descarga el adjunto → lo guarda en una carpeta → lo sube a la herramienta de extracción," el flujo se convierte en "el agente de origen abre el Collection Link → sube el B/L → el documento aparece en su cola para revisión y exportación." Se eliminan tres transferencias,y el documento está disponible para procesamiento en cuestión de minutos después de su emisión — a veces antes de que el buque haya salido del puerto de carga.
Para transitarios que gestionan B/L en múltiples rutas comerciales y zonas horarias, donde los documentos llegan las 24 horas desde diferentes partes del mundo, los Collection Links convierten una cadena de transferencias secuencial y dependiente del correo electrónico en un pipeline paralelo de carga directa. Cada agente, en cada puerto, sube al mismo destino.
Preguntas Frecuentes
¿Cuántos B/L se pueden procesar en un solo lote?
No hay un límite estricto — usted puede subir tantos archivos como necesite en un lote. En la práctica, un lote de 50 a 100 B/L de múltiples navieras se procesa en unos minutos. El tiempo total de procesamiento escala con el número de páginas, no con la diversidad de formatos, porque la IA lee cada documento de forma independiente usando las mismas definiciones de columnas.
¿Puede manejar documentos de carga marítima y aérea en el mismo lote?
Sí. Un B/L marítimo, una guía aérea(AWB,)y una lista de empaque se pueden procesar en el mismo lote usando las mismas definiciones de columnas — siempre que los campos que haya especificado(Remitente, Consignatario, Descripción de la Carga, Peso)existan en esos tipos de documentos. La IA distingue los tipos de documentos automáticamente y adapta su lectura. Para campos exclusivos de un tipo de documento(códigos de aeropuerto en AWBs, números de contenedor en B/L marítimos),, esas columnas se completarán donde existan los datos y permanecerán en blanco donde no existan.
¿Qué sucede con los conocimientos de embarque con escritura a mano o sellos?
La escritura a mano clara en bloques y el texto estampado se extraen de manera confiable. Las correcciones de peso escritas a mano, las anotaciones del conductor y los cambios de número de sello legibles se procesarán con precisión. La escritura muy cursiva, las copias carbón desvanecidas y los sellos de tinta manchados reducen la confianza; estos campos se marcarán para revisión manual. Recomendamos una revisión rápida de los campos escritos a mano en lugar de esperar un procesamiento totalmente automatizado de fuentes degradadas.
¿Cómo se compara esto con el reconocimiento de documentos integrado en mi TMS?
La mayoría de las plataformas TMS con OCR integrado, incluidas CargoWise, Descartes y Magaya, ofrecen reconocimiento de documentos que es extracción basada en plantillas (que requiere configuración por naviera) o está limitado a un conjunto fijo de campos predefinidos establecidos por el proveedor del TMS. La extracción por nombre de columna le da control sobre qué campos se extraen, incluidos campos específicos de la naviera o de referencia interna que los modelos genéricos de OCR de BOL no cubren. La salida en Excel/CSV se importa en cualquier TMS que acepte cargas de archivos, por lo que funciona junto con su sistema existente en lugar de reemplazarlo.
¿Puedo usar esto para manejar conocimientos de embarque en chino, japonés u otros idiomas?
Sí. La IA procesa conocimientos de embarque en varios idiomas. Un conocimiento de embarque de COSCO en chino y uno de Maersk en inglés pueden procesarse en el mismo lote: los nombres de columna que defina en inglés actúan como objetivos de extracción, y la IA localiza los valores correspondientes independientemente del idioma del documento. Los equipos de carga internacional que manejan envíos en diferentes rutas comerciales trabajan en un solo flujo de trabajo.
Para equipos que manejan flujos de documentación logística más amplios, consulte nuestras guías sobre extracción por lotes de albaranes y notas de entrega y procesamiento por lotes de órdenes de compra entre proveedores. Si está evaluando el costo de continuar con la entrada manual de datos, lea sobre el costo oculto de la entrada manual de datos.
Para el equivalente de este flujo de trabajo para un solo documento, que cubre la extracción campo por campo, el manejo de formatos de naviera y la configuración paso a paso, consulte cómo extraer datos de conocimientos de embarque a Excel sin API ni configuración de TI.