Traiter par lots les connaissements de tous les
transporteurs dans une seule feuille de calcul
Un transitaire de taille moyenne traite environ 500 connaissements par mois auprès de 10 à 20 transporteurs maritimes différents. À raison de 10 à 15 minutes par document pour la lecture, la saisie et la vérification — le benchmark documenté par l'analyse de CSA Software sur la saisie manuelle de données dans le fret — cela représente 83 à 125 heures de travail chaque mois, consacrées uniquement à l'étape de transcription. Sans compter la résolution des exceptions, le suivi des transporteurs ou le travail de décision qui fait avancer la cargaison. Il s'agit simplement de transférer des données d'un PDF vers une feuille de calcul. Et la cause profonde n'est pas le volume. C'est que chaque transporteur imprime les mêmes informations différemment.
Un connaissement contre 500 : l'écart d'efficacité que les tutoriels sur document unique ne couvrent pas
Un connaissement extrait vers Excel prend 5 à 10 secondes avec une extraction assistée par IA — environ 18 fois plus vite que la saisie manuelle. C'est la référence standard de l'automatisation au niveau du document, et extraire un connaissement vers Excel un par un y parvient de manière fiable.
Mais la vitesse sur document unique n'est pas le goulot d'étranglement à l'échelle opérationnelle. Le goulot d'étranglement, c'est l'espace entre les documents. C'est la friction cumulative du passage d'un connaissement Maersk à un connaissement MSC, d'un modèle COSCO, d'un format Hapag-Lloyd, d'une maquette ONE — chacun avec un placement des champs différent, des conventions de dénomination différentes, des structures de tableau différentes — et de la production d'un tableur unifié où le numéro B/L signifie la même chose dans chaque ligne.
Selon une analyse d'Expedock sur les opérations des transitaires, les équipes opérationnelles consacrent 2 à 4 heures par jour à saisir et à vérifier des données dans les systèmes de gestion du transport. Pour une équipe traitant 300 expéditions par mois, cela représente 150 heures uniquement consacrées à la saisie de données — du temps non disponible pour la négociation des tarifs, le traitement des exceptions ou le service client. Le coût ne réside pas dans les minutes par document, mais dans les heures par mois qui s'accumulent d'un transporteur à l'autre.
Un connaissement s'extrait en quelques secondes. Cinq cents connaissements provenant de 15 transporteurs différents ne sont pas une simple multiplication de ce chiffre — ils deviennent un problème de gestion des formats que les outils basés sur des modèles n'ont pas été conçus pour résoudre.
Pourquoi les connaissements multi-transporteurs mettent en échec l'extraction basée sur des modèles
L'industrie du fret maritime repose sur une poignée de transporteurs dominants — Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen, HMM, Yang Ming, ZIM — et chacun émet des connaissements sur son propre modèle propriétaire. Voici les différences :
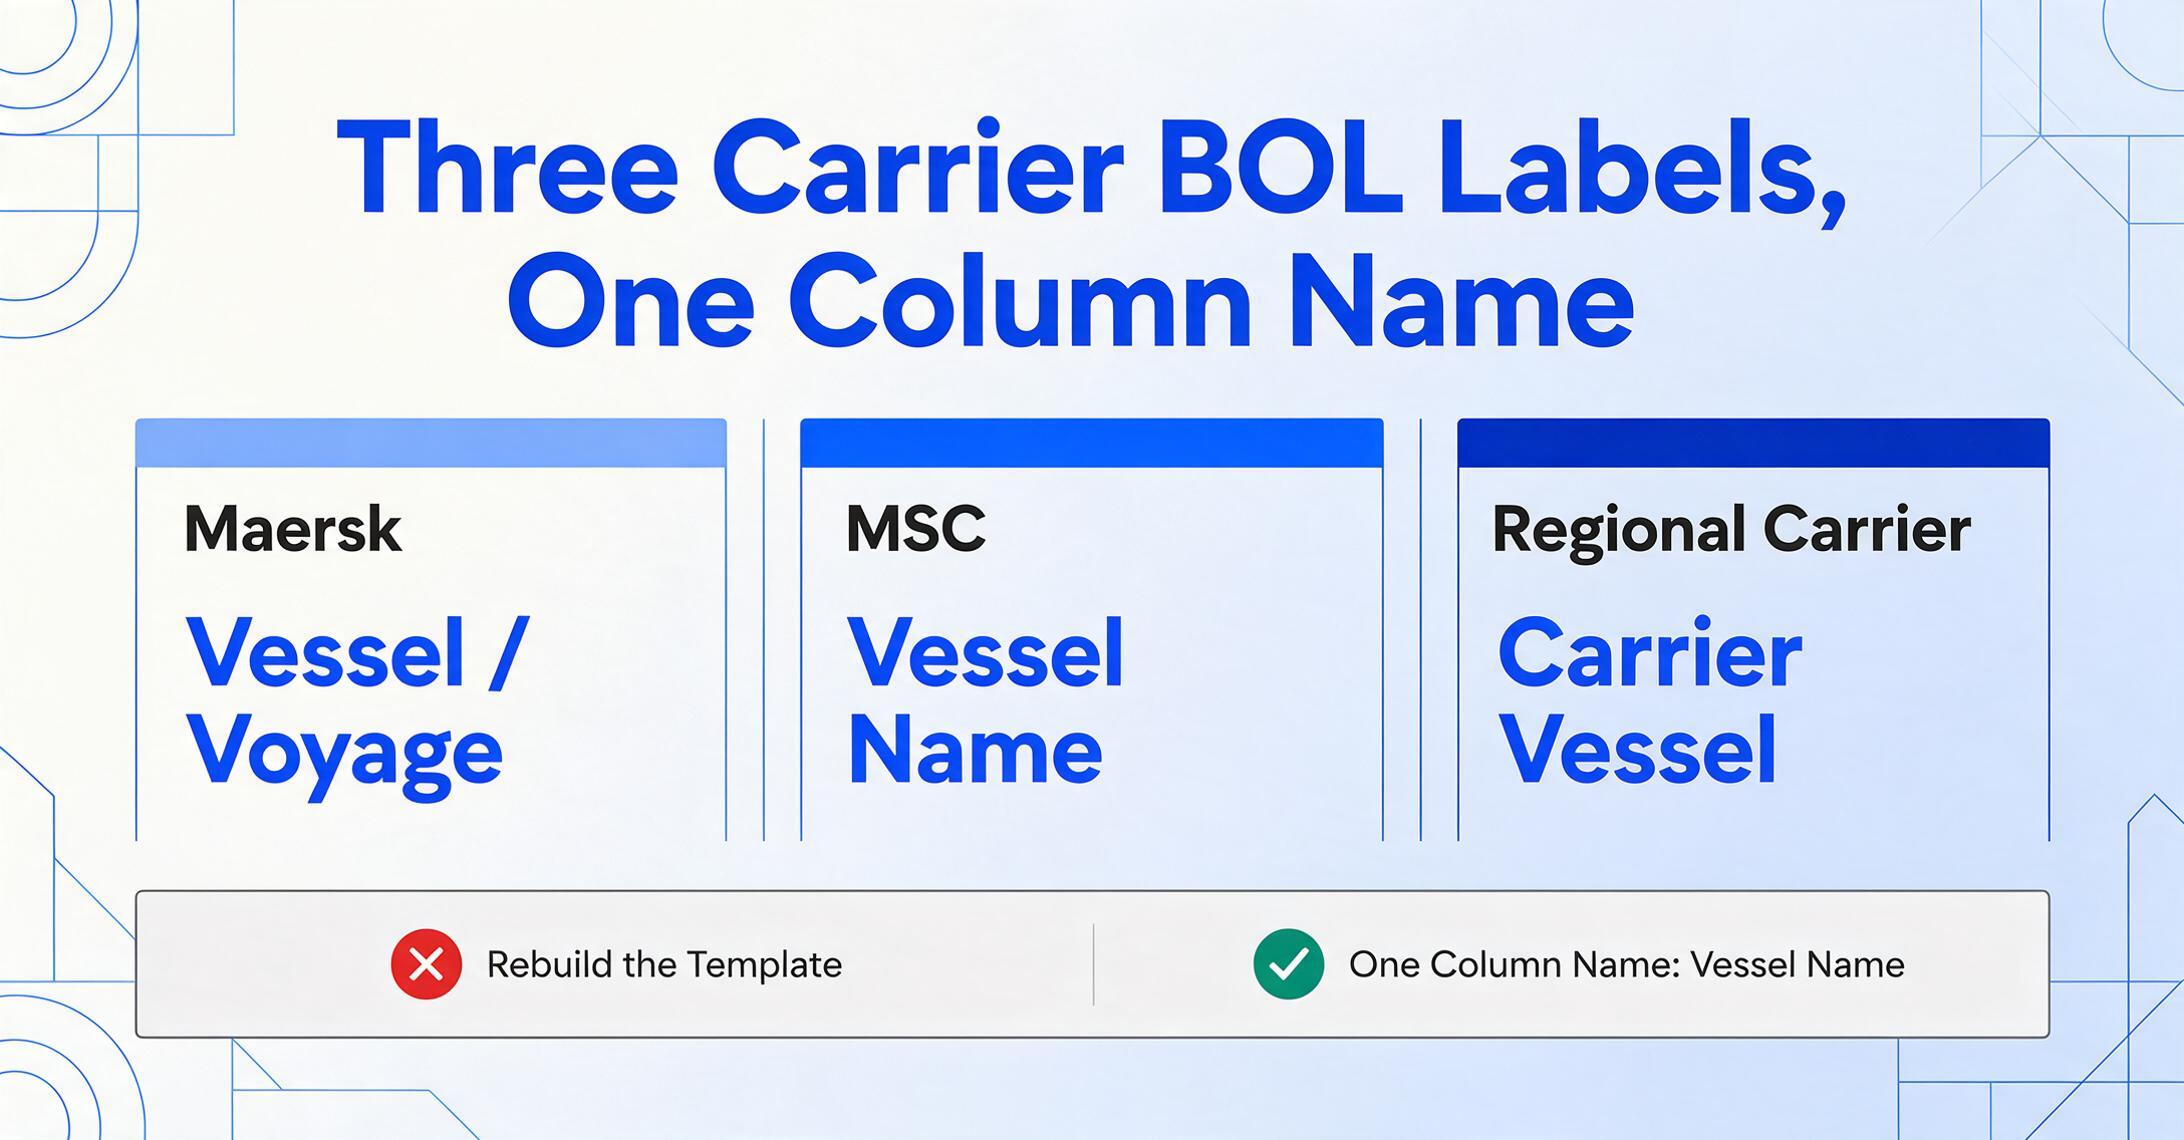
- Dénomination des champs. Ce que Maersk appelle « Vessel / Voyage », MSC appelle « Vessel Name » dans un panneau latéral, et un transporteur régional appelle « Carrier Vessel » dans le corps du texte. Trois intitulés différents, une même information.
- Positionnement. Le numéro B/L peut se trouver dans le coin supérieur droit du modèle d'un transporteur et dans le coin inférieur gauche chez un autre. Les numéros de conteneur peuvent apparaître dans un tableau d'en-tête, une liste multiligne ou en ligne avec les descriptions de marchandises.
- Format des données. Un transporteur écrit les dates au format DD/MM/YYYY, un autre au format MM-DD-YYYY. Les poids peuvent être en kilogrammes, en livres ou en tonnes métriques selon la route commerciale et les conventions du transporteur.
- Structure de page. Un connaissement à conteneur unique tient sur une page. Un connaissement multi-conteneurs du même transporteur peut s'étendre sur cinq pages — et un autre transporteur formate une cargaison multi-conteneurs de façon complètement différente.
La National Customs Brokers and Forwarders Association of America (NCBFAA), qui représente plus de 1 500 entreprises membres et 110 000 employés dans le commerce international, compte parmi ses membres des transitaires dont les opérations traitent plus de 97 % de toutes les déclarations d'importation américaines. Ces transitaires sont confrontés à la diversité des formats des transporteurs à chaque heure de chaque jour ouvré.
Les outils d'extraction basés sur des modèles répondent à cette diversité en exigeant un modèle distinct pour la mise en page de chaque transporteur. Si vous travaillez avec 15 transporteurs, vous créez 15 modèles. Lorsqu'un transporteur met à jour la conception de son connaissement — et c'est le cas, que ce soit pour un changement de marque, une conformité réglementaire ou une migration de système — votre modèle se brise silencieusement. L'outil censé éliminer la saisie manuelle a créé une nouvelle charge de maintenance : la gestion des modèles. Le problème s'accroît linéairement avec le nombre de transporteurs, et le déclencheur pour mettre à jour un modèle est toujours le fait que quelqu'un remarque que les données ont cessé de circuler.
La FIATA, la Fédération internationale des associations de transitaires et assimilés, a abordé le problème de la fragmentation des formats au niveau des normes avec sa norme de données électroniques FBL — une version numérique open source de son Connaissement de transport multimodal négociable (FBL) mappée au modèle de données de référence du transport multimodal UN/CEFACT. Mais l'adoption de l'eFBL parmi les transporteurs est progressive, et les connaissements papier et PDF qui arrivent dans les boîtes mail des transitaires aujourd'hui n'attendent pas la convergence des normes. Le transitaire doit extraire les données de tout ce qui arrive.
Une liste de colonnes, tous les transporteurs : comment fonctionne l'extraction sémantique sur les formats de connaissement
L'alternative aux modèles par transporteur est l'extraction par nom de colonne : au lieu de définir où chaque valeur se trouve sur la page d'un transporteur spécifique, vous définissez quelle catégorie d'information vous recherchez. L'IA lit le document sémantiquement — en comprenant la signification de chaque donnée, et non ses coordonnées — et localise les valeurs par ce qu'elles sont plutôt que par l'endroit où elles apparaissent.
Un exemple concret. Définissez une colonne appelée « Numéro B/L ». Lorsque l'IA rencontre un connaissement Maersk avec « Bill of Lading No. MAEU123456789 » dans l'en-tête, elle reconnaît le motif et extrait « MAEU123456789 ». Lorsqu'elle rencontre un connaissement MSC où le numéro B/L est étiqueté « MEDU987654321 » dans un encadré latéral avec un formatage différent, elle extrait « MEDU987654321 » — parce que l'IA comprend que les deux sont des identifiants de connaissement, et non parce que les deux se trouvent aux mêmes coordonnées de pixels. Le nom de colonne que vous avez défini est le concept cible. L'IA trouve la valeur correspondante dans le format de n'importe quel transporteur.
Voici la liste de champs dont un flux de travail typique d'extraction de connaissement de transitaire a besoin, et elle fonctionne avec tous les transporteurs sans modification :
Numéro B/L  |  Numéro de réservation  |  Nom de l'expéditeur  |  Nom du destinataire  |  Partie notifiée
Nom du navire  |  Numéro de voyage  |  Port de chargement  |  Port de déchargement
Numéro de conteneur  |  Numéro de scellé  |  Code SH  |  Nombre de colis
Poids brut  |  Description de la cargaison  |  Conditions de fret
Lieu de réception  |  Lieu de livraison  |  Nom du transporteur
Définissez ces noms de colonnes une seule fois — une configuration ponctuelle, pas une opération par document. Ils deviennent les en-têtes de votre feuille de calcul de sortie. Chaque connaissement que vous traitez, quel que soit le transporteur, génère une ligne avec les mêmes colonnes dans le même ordre, indépendamment de la mise en page, de l'étiquetage ou du nombre de pages du document source. Un lot de 50 connaissements provenant de 12 transporteurs produit un seul tableau, et non 12 tableaux nécessitant un assemblage manuel.
Cette approche gère également des types de connaissements qui ne se ressemblent pas du tout. Un connaissement maritime maître (MBL) émis par le transporteur au transitaire, un connaissement maritime de transitaire (HBL) émis par le transitaire à l'expéditeur, et une lettre de transport aérien — trois documents avec des mises en page visuelles différentes, des noms de champs différents, des modèles de données différents — produisent des lignes avec une structure de colonnes identique. L'IA s'adapte automatiquement au type de document car elle lit de manière sémantique, et non positionnelle.
L'idée clé : les informations contenues dans un connaissement sont universelles — expéditeur, destinataire, navire, cargaison, poids, conteneur. Ce qui varie, c'est la manière dont chaque transporteur choisit de les afficher. L'extraction sémantique dissocie l'information de son affichage, faisant du format du transporteur une variable sans importance.
Le flux de travail par lots : de la boîte de réception du transporteur à la feuille de calcul de suivi
Le lundi matin d'un transitaire commence généralement par la réception de PDF de connaissements provenant de transporteurs ayant navigué pendant le week-end. Ils arrivent sous forme de pièces jointes par e-mail, de téléchargements depuis les portails des transporteurs ou de documents transférés par les agents d'origine. La priorité n'est pas d'extraire un seul connaissement rapidement — c'est de tous les intégrer dans la feuille de calcul de suivi avant que les clients ne commencent à demander des mises à jour sur l'état des expéditions. Ces mises à jour commencent généralement par quelqu'un qui récupère une capture d'écran de suivi du transporteur à partir du numéro de suivi sur chaque connaissement.
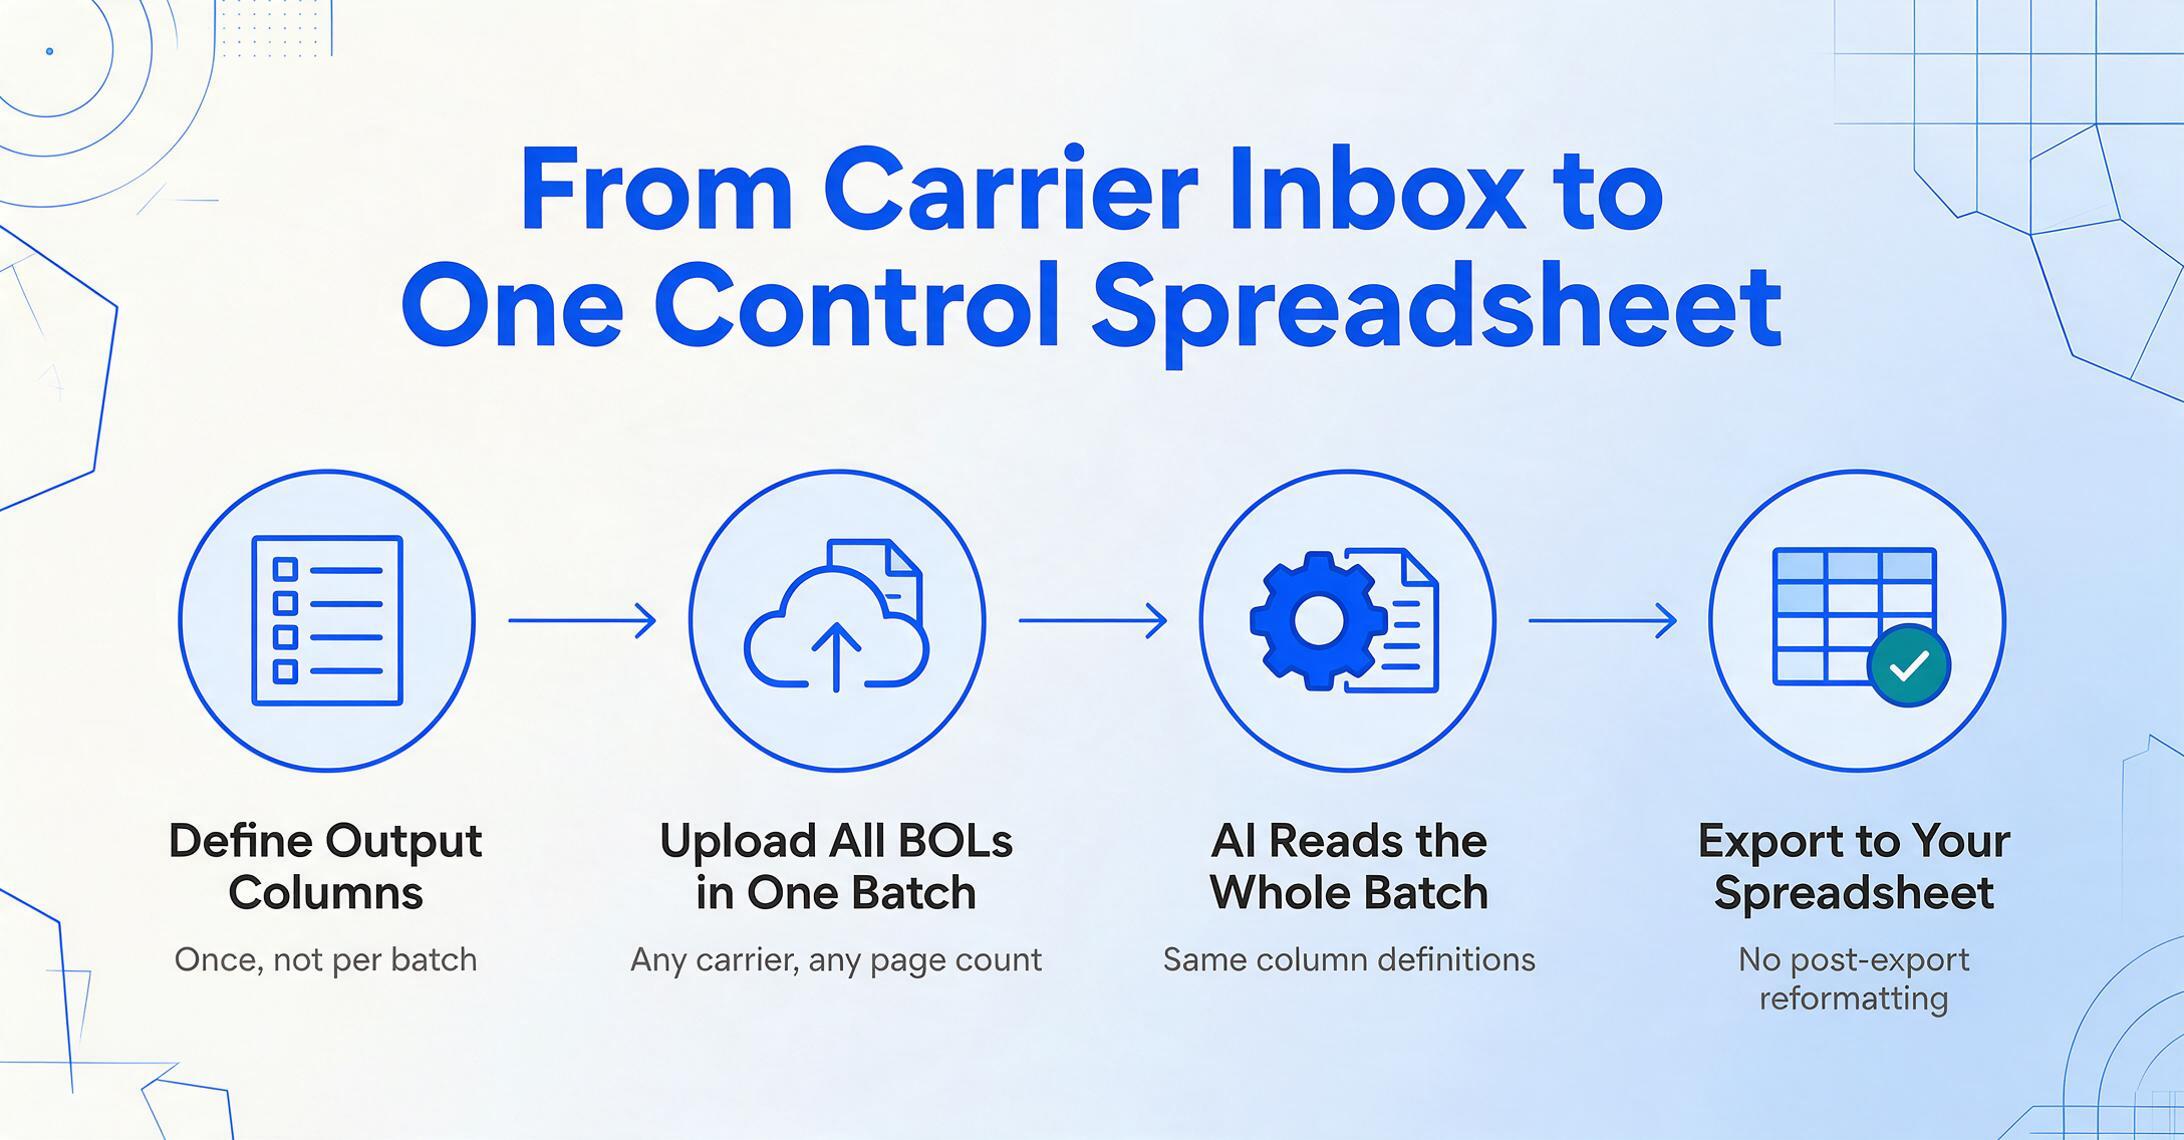
Voici comment un flux de travail de traitement par lots — où vous téléchargez plusieurs fichiers à la fois et l'IA traite tous les fichiers en utilisant les mêmes définitions de colonnes pour produire une sortie consolidée — transforme cette routine matinale :
Définissez vos colonnes de sortie une seule fois. Saisissez les noms de champs à extraire — Numéro B/L, Expéditeur, Destinataire, Navire, Port de chargement, Numéro de conteneur, Poids brut, etc. Ceux-ci deviennent les en-têtes de colonnes de votre feuille de calcul pour chaque Connaissement que vous traiterez. La configuration est une étape unique, pas une opération par lot ou par transporteur. Si votre TMS ou votre feuille de suivi en aval attend des noms d'en-têtes spécifiques, utilisez ces noms exacts ici — « ContainerNo » au lieu de « Container Number », si c'est ce que votre système lit — et éliminez l'étape de reformatage après l'exportation.
Téléversez tous les Connaissements en un seul lot. Glissez des PDF, des documents scannés ou des photos de Connaissements — quel que soit le transporteur, le type de document ou le nombre de pages. Un PDF Maersk, un scan MSC, un document multipage COSCO et une capture d'écran du Connaissement d'un transporteur régional vont tous dans le même téléversement. L'IA les traite comme un groupe, en utilisant les mêmes définitions de champs pour chaque document. Aucun tri de documents, aucun regroupement par transporteur, aucun pré-traitement.
Vérifiez les extractions signalées, pas chaque champ. L'IA marque les résultats à faible confiance — les champs où le document source présentait une mauvaise qualité de scan, un format ambigu ou des schémas de données inattendus. Examinez d'abord les éléments signalés. Le reste, avec des scores de confiance élevés, ne nécessite généralement aucune intervention manuelle. À raison de 500 Connaissements par mois avec un taux de confiance au niveau des champs supérieur à 95 %, l'étape de vérification se concentre sur environ 25 documents de cas limites, et non sur 500 documents de vérification ligne par ligne.
Exportez une feuille de calcul consolidée. Le résultat est un fichier Excel unique où chaque Connaissement est une ligne. Chaque colonne est identique pour tous les transporteurs. Exportez en XLSX ou CSV, importez directement dans votre TMS, ou — si vous travaillez dans Google Sheets — utilisez le module complémentaire Google Sheets pour écrire les données extraites directement dans votre feuille active sans quitter Sheets. La structure est cohérente : la ligne 1 est un Connaissement Maersk, la ligne 2 est un Connaissement MSC, la ligne 3 est un Connaissement COSCO — et les trois lignes ont une disposition de colonnes identique.
Le temps de traitement d'une page de Connaissement se situe entre 5 et 10 secondes. Un lot de 50 Connaissements d'une page est terminé en quelques minutes — le facteur limitant est le nombre total de pages, pas la diversité des formats. Ajouter le transporteur n°16 au flux de travail ne coûte aucun temps de configuration supplémentaire, car l'extraction sémantique ne se soucie pas du nombre de transporteurs avec lesquels vous travaillez.
Pour en savoir plus sur l'extraction de données de connaissement quel que soit le format du transporteur, consultez notre outil de conversion dédié.
Que se passe-t-il en cas de problème : gestion des exceptions à grande échelle
Dans l'extraction de documents individuels, une exception est un inconvénient — on la corrige et on passe à autre chose. Dans le traitement par lots portant sur 15 transporteurs, résoudre efficacement les exceptions détermine si la journée de travail se termine à 15 h 00 ou à 19 h 00. La pratique de la gestion des exceptions à cette échelle importe davantage que le chemin nominal.
Les trois modes de défaillance les plus courants dans le traitement par lots multi-transporteurs de BOL :
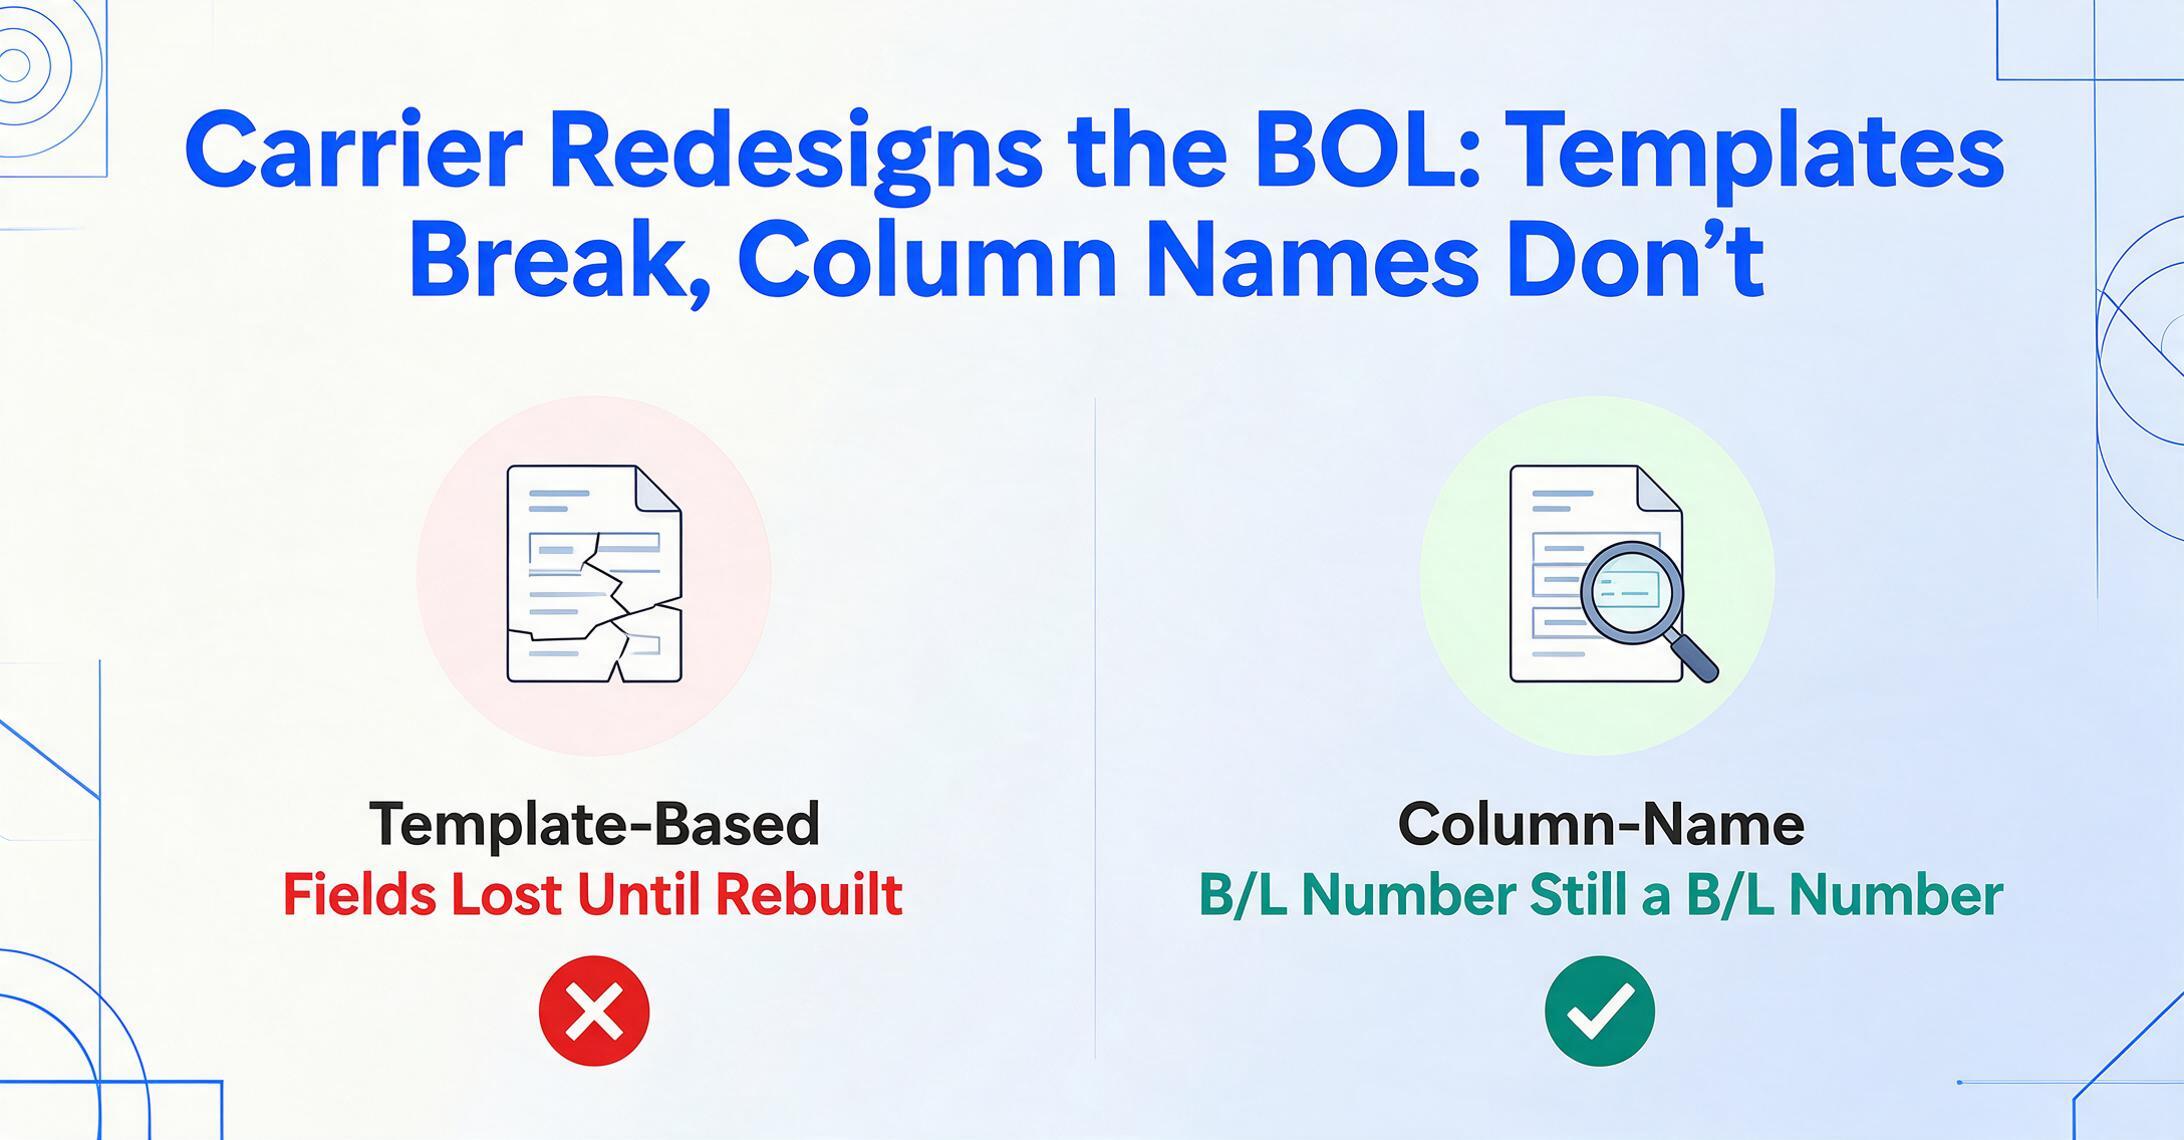
Mises à jour des modèles de transporteurs. Lorsque Maersk a redessiné sa mise en page BOL — déplaçant certains champs, réorganisant des tableaux, ajustant la structure des pages — les outils d'extraction basés sur des modèles ont perdu la trace de ces champs jusqu'à ce que quelqu'un reconstruise le modèle. L'extraction par nom de colonne gère cela différemment. Comme l'IA n'est pas ancrée sur des positions de pixels, un changement de mise en page ne casse pas l'extraction tant que le contenu informationnel reste le même. Le numéro B/L reste un numéro B/L, quel que soit l'endroit où il apparaît sur la page redessinée.
Variabilité de la qualité de numérisation. Un BOL arrivé sous forme de PDF net depuis le système de Maersk et un BOL photographié sous un éclairage fluorescent d'entrepôt puis transmis par un agent d'origine ne sont pas des entrées équivalentes. Les numéros de conteneur flous, les champs de poids maculés et les orientations de page inclinées réduisent la confiance d'extraction. L'IA les signale pour examen — l'opérateur voit quels champs nécessitent une attention particulière sans parcourir des lignes de données correctement extraites. Pour les corrections manuscrites critiques sur les BOL (ajustements de poids, changements de numéro de scellé ajoutés à la main), prévoyez une passe de vérification rapide plutôt que d'attendre une extraction entièrement automatisée de numérisations dégradées.
Champs manquants et ambigus. Tous les transporteurs n'incluent pas tous les champs sur chaque BOL. Un transporteur régional pourrait omettre le code SH. Un BOL de consolidation LCL pourrait laisser le numéro de scellé vide. Les outils basés sur des modèles traitent souvent un champ manquant comme un échec d'extraction. L'extraction sémantique gère cela différemment — le champ revient simplement vide, et l'opérateur décide s'il doit obtenir les données manquantes d'un autre document (une liste de colisage, une facture commerciale) ou continuer sans elles. Traiter les listes de colisage et les BOL ensemble dans le même lot, avec des champs qui se chevauchent entre les types de documents, est une extension naturelle de ce flux de travail.
Le résultat pratique : pour un lot de 50 BOL traités avec l'extraction par nom de colonne, l'étape de vérification se concentre sur environ 2 à 5 documents avec des champs signalés, et non sur 50 documents avec une vérification ligne par ligne. Si vous comparez encore les outils d'extraction avant de vous engager, notre test comparatif de neuf outils d'extraction de documents logistiques couvre précisément ce type de variance de format multi-transporteurs.
Lorsque vos B/L arrivent de tous les ports : Collection Links
Le flux documentaire d'un transitaire est géographiquement distribué par définition. La personne qui gère les B/L physiques au port de chargement à Shanghai n'est pas celle qui gère le tableur de contrôle au siège à Rotterdam ou à Chicago. Chaque document physique qui doit atteindre le poste de saisie représente une transmission de plus — envois par e-mail, téléchargements depuis un portail, photos WhatsApp — et chaque transmission est une source potentielle de retard ou d'erreur d'acheminement.
Collection Links résolvent directement le problème de distribution. Un Collection Link est une page de téléversement unique et partageable (une URL comme /c/xxxx) que vous générez et distribuez aux personnes qui gèrent les documents à l'origine — personnel d'entrepôt, agents maritimes, transitaires partenaires, chauffeurs de ramassage. Le destinataire ouvre le lien, saisit un code de vérification court et téléverse directement le B/L. Pas de création de compte, pas de connexion, pas de formation. Le document arrive dans votre file de traitement, et vous le révisez et l'exportez depuis votre tableau de bord.
Cela élimine entièrement les étapes intermédiaires. Au lieu de « l'agent à l'origine envoie le PDF du B/L par e-mail au bureau des opérations → les opérations téléchargent la pièce jointe → la sauvegardent dans un dossier → la téléversent dans l'outil d'extraction », le flux devient « l'agent à l'origine ouvre le Collection Link → téléverse le B/L → le document apparaît dans votre file pour révision et exportation ». Trois transmissions supprimées, et le document est disponible pour traitement en quelques minutes après son émission — parfois avant même que le navire n'ait quitté le port de chargement.
Pour les transitaires qui gèrent des B/L sur plusieurs routes commerciales et fuseaux horaires, où les documents arrivent en continu depuis différentes parties du monde, les Collection Links transforment une chaîne de transmission séquentielle dépendante des e-mails en un pipeline de téléversement direct et parallèle. Chaque agent, dans chaque port, téléverse vers la même destination.
Questions fréquemment posées
Combien de B/L peuvent être traités en un seul lot ?
Il n'y a pas de limite stricte — vous pouvez téléverser autant de fichiers que nécessaire en un seul lot. En pratique, un lot de 50 à 100 B/L provenant de plusieurs transporteurs est traité en quelques minutes. Le temps de traitement total dépend du nombre de pages, et non de la diversité des formats, car l'IA lit chaque document indépendamment en utilisant les mêmes définitions de colonnes.
Peut-on traiter des documents de fret maritime et aérien dans le même lot ?
Oui. Un B/L maritime, une lettre de transport aérien (LTA) et une liste de colisage peuvent être traités dans le même lot en utilisant les mêmes définitions de colonnes — à condition que les champs que vous avez spécifiés (Expéditeur, Destinataire, Description de la marchandise, Poids) existent dans ces types de documents. L'IA distingue automatiquement les types de documents et adapte sa lecture. Pour les champs propres à un type de document (codes d'aéroport sur les LTA, numéros de conteneur sur les B/L maritimes), ces colonnes se remplissent là où les données existent et restent vides ailleurs.
Que se passe-t-il pour les connaissements avec écriture manuscrite ou tampons ?
Une écriture manuscrite claire en caractères d'imprimerie et un texte tamponné s'extraient de manière fiable. Les corrections manuscrites de poids, les annotations du conducteur et les changements de numéro de scellé lisibles seront traités avec précision. Une écriture très cursive, des copies carbone délavées et des tampons d'encre maculés réduisent la confiance — ces champs seront signalés pour une vérification manuelle. Nous recommandons une vérification rapide des champs manuscrits plutôt que d'attendre un traitement entièrement automatisé de sources dégradées.
Comment cela se compare-t-il à la reconnaissance documentaire intégrée de mon TMS ?
La plupart des plateformes TMS avec OCR intégré — notamment CargoWise, Descartes et Magaya — offrent une reconnaissance documentaire soit basée sur des modèles (nécessitant une configuration par transporteur), soit limitée à un ensemble fixe de champs prédéfinis par le fournisseur du TMS. L'extraction par nom de colonne vous donne le contrôle sur quels champs sont extraits, y compris les champs spécifiques au transporteur ou les champs de référence internes que les modèles OCR génériques de connaissement ne couvrent pas. La sortie Excel/CSV s'importe dans tout TMS acceptant les téléchargements de fichiers, elle fonctionne donc en complément de votre système existant plutôt qu'en remplacement.
Puis-je utiliser cela pour traiter des connaissements en chinois, japonais ou d'autres langues ?
Oui. L'IA traite les connaissements dans plusieurs langues. Un connaissement COSCO en chinois et un connaissement Maersk en anglais peuvent être traités dans le même lot — les noms de colonnes que vous définissez en anglais servent de cibles d'extraction, et l'IA localise les valeurs correspondantes quelle que soit la langue du document. Les équipes de fret international gérant des expéditions sur différentes routes commerciales travaillent dans un flux unique.
Pour les équipes gérant des flux de documentation logistique plus larges, consultez nos guides sur l'extraction par lots de bordereaux de livraison et de bons de livraison et le traitement par lots de bons de commande auprès de fournisseurs. Si vous évaluez le coût de la saisie manuelle continue, lisez à propos du coût caché de la saisie manuelle des données.
Pour l'équivalent mono-document de ce flux — couvrant l'extraction champ par champ, la gestion des formats transporteur et la configuration étape par étape — voir comment extraire les données de connaissement vers Excel sans API ni configuration informatique.