Amazonの複数商品注文
スクリーンショットから各商品名・数量・価格を読み取る
1件のAmazon注文に5つの商品が含まれることがあります。それぞれに商品名、数量、価格があり、同じページに縦に並び、細いグレーの線で区切られているだけです。データを見つけることは難しくありません。難しいのは、それを正しく対応づけることです。2つ目の商品の価格が1つ目の商品の合計に紐づいてしまわないようにし、長い商品名が折り返された2行目が別の項目として読み取られないようにする必要があります。
重要なポイント
- OCRツールはテーブル抽出を謳っています。しかし、商品同士がエンジンには検出しにくい薄いグレーの線だけで区切られた複数商品の注文画面に遭遇すると、その約束は果たされません。
- 商品名が2行目に折り返されると、その位置は次の商品の価格とまったく同じ画面上の位置になります。座標ベースの読み取りでは、その価格が毎回誤った行に割り当てられてしまいます。
- セマンティック抽出はグリッド線をまったく探しません。各商品を「商品名・数量・価格」のまとまりとして読み取るため、商品が5つでも50個でも、データの帰属を正しく判定できます。
複数商品注文が従来の抽出ツールにとって難しい理由
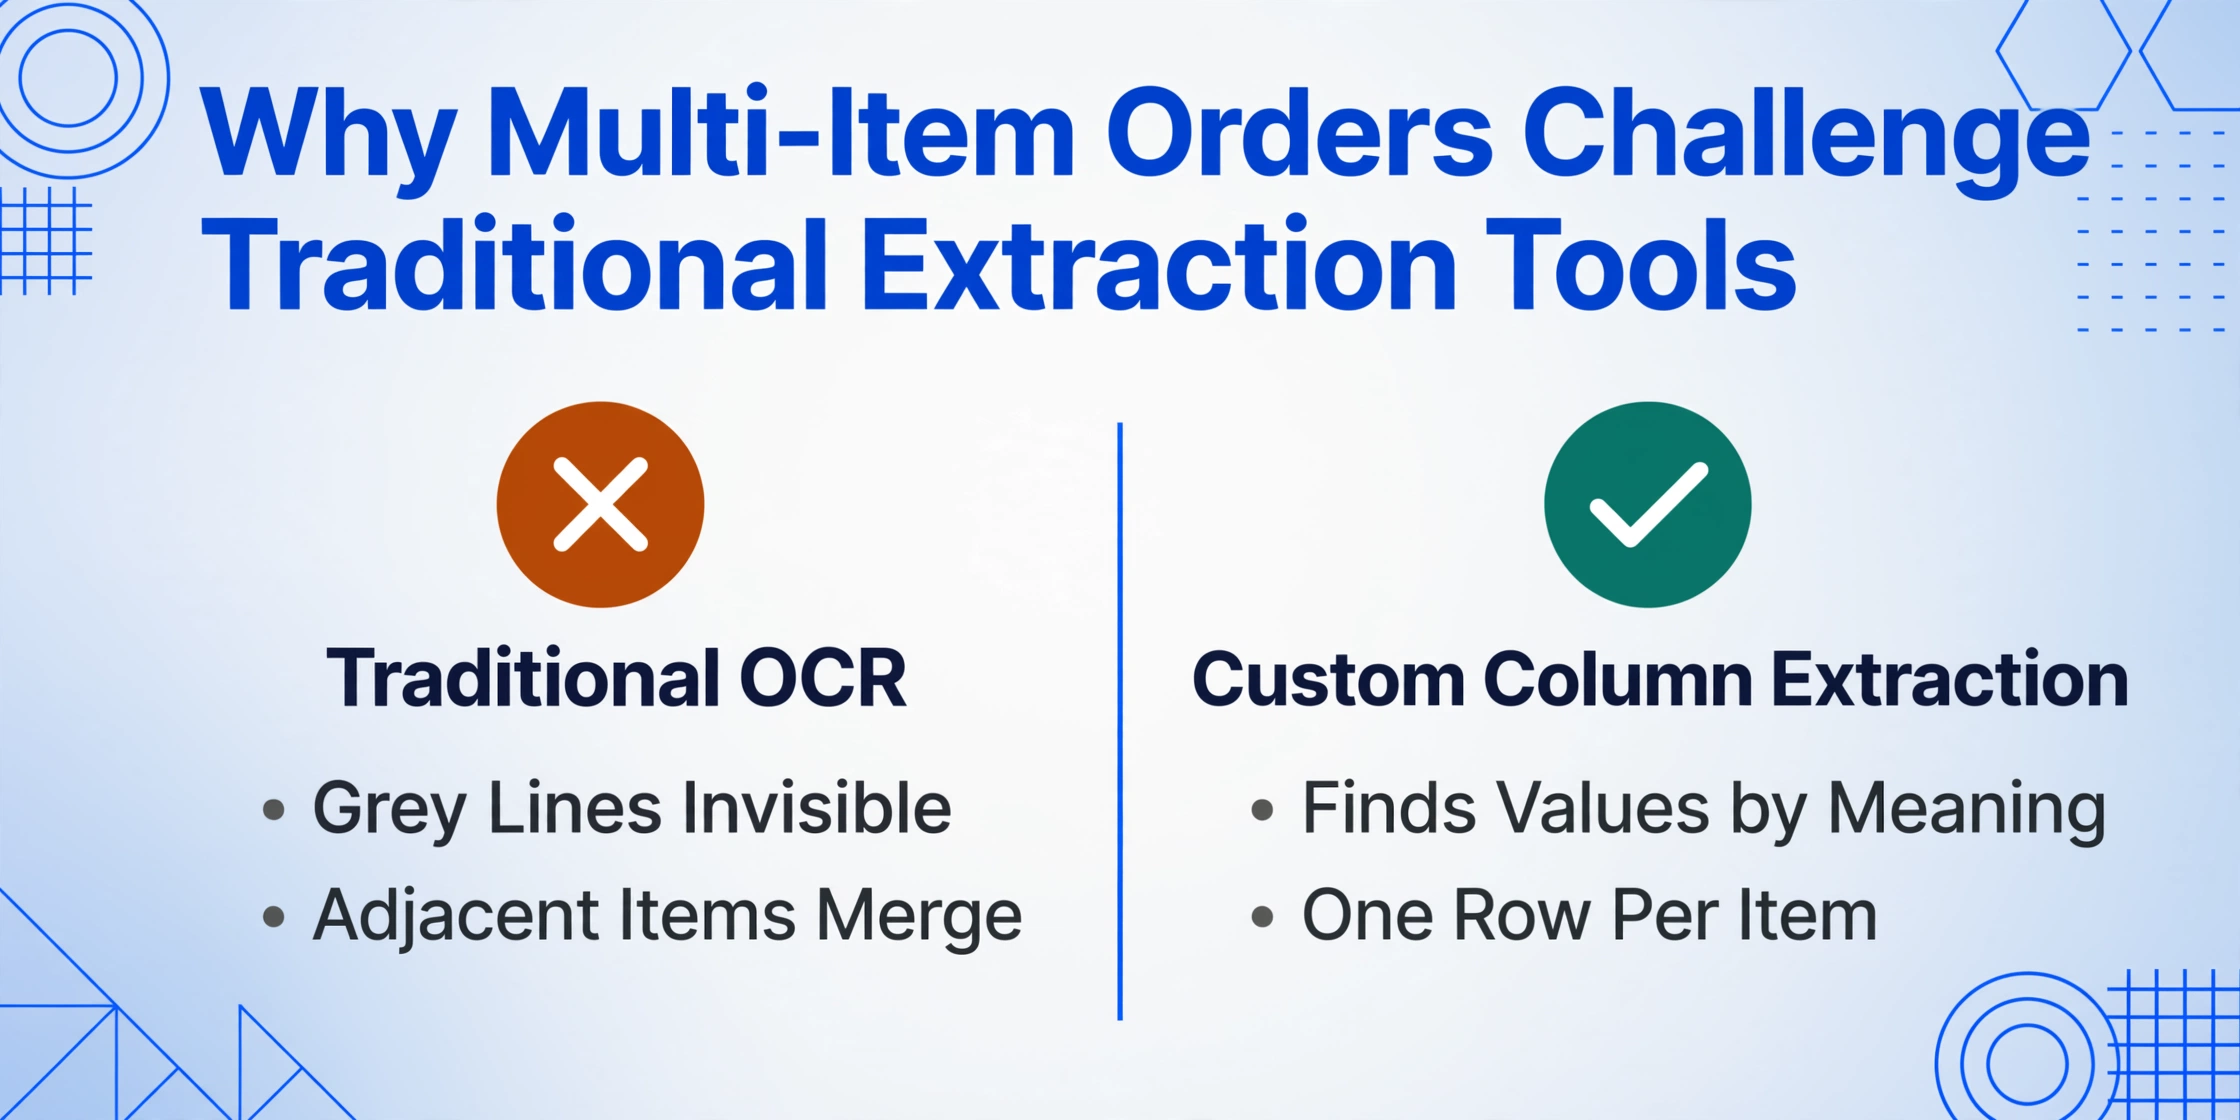
単一商品の注文スクリーンショットは、単純な読み取りタスクです。商品名が1つ、数量が1つ、価格が1つ。一方、複数商品の注文では、ほとんどの従来のOCRツールでは解決できない構造上の問題が発生します。問題はフィールドの数が多いことではなく、商品が密集して並ぶとフィールド間の視覚的な関係が崩れてしまうことです。
グレーの線の問題。 Amazonは注文詳細ページで商品を薄い水平なグレーの罫線で区切っています。人間の目には、これらの線は明確な区切りに見えます。線の上が商品1、線の下が商品2です。しかし従来のOCRエンジンにとって、グレーの線は見えない(薄すぎて検出できない)か、意味を持たない単なる視覚要素のいずれかです。エンジンはテキストの連続ブロックとして認識し、ある商品がどこで終わり、次の商品がどこから始まるのかを判断できません。その結果、商品の境界が消え、隣接する商品のデータが単一の構造化されていない塊に結合されてしまいます。
折り返しテキストが読み取り順序を崩す。 Amazonの商品名は長いことがよくあります。「Bissell Pet Stain Eraser Cordless Carpet Cleaner, 2454, Gray」は注文サマリーの1行に収まらず、2行目、場合によっては3行目に折り返されます。この折り返されたテキストは、次の商品の価格と同じ垂直位置に配置されます。従来のOCRは左から右、上から下へと読み取るため、商品1の名前の2行目を取得して、商品2の価格と組み合わせてしまうことが簡単に起こります。その結果、商品と価格が1行ずつずれたテーブルが生成されます。
「再度注文」ボタンが視覚的な流れを乱す。 注文ページの各商品の下に、Amazonは「もう一度購入」または「再度注文」ボタンを配置します。これらのボタンは商品間に視覚的な重みを加え、ページの垂直方向のリズムを変えます。均一な間隔や行の検出に依存する従来の抽出ツールは、これらのボタンを上の商品に属するテキストとして誤解釈したり、新しいセクションの始まりとして誤解釈したりする可能性があります。どちらの場合でも、抽出結果の構造的整合性が失われます。
核心的な問題は行の帰属です。 従来のOCRツールはテキストを読み取ります。商品名、その数量、価格が単一の論理ユニットを形成することを理解していません。視覚的な境界が微妙な場合(細い線、折り返された名前、ボタン)、帰属が崩壊します。
各明細行の実際の内容
抽出方法を検討する前に、Amazonの複数商品注文のスクリーンショットに、商品ごとにどのようなフィールドが表示されるかを正確に把握しておくと役立ちます。表示内容は出品者の種類や注文設定によって異なりますが、コアとなるフィールドは一貫しています。
商品名(省略表示)。Amazonには商品タイトルが表示されますが、注文サマリーページではほとんどの場合、2行で省略され、末尾に「...」が付きます。完全な名称は商品ページで確認できますが、スクリーンショットには省略版のみが写ります。抽出の目的においては、通常、この省略された名称で識別は十分です。
数量。「Qty: 1」「Qty: 2」などと表示されます。フォントサイズは商品名よりも小さく、数量ラベルは商品画像の横または下に配置されます。モバイルアプリのスクリーンショットでは、数量が折りたたまれて非表示になり、タップして展開しないと見えない場合があります。
単価と行合計。各商品には個別の単価が表示され、複数数量の商品には行合計(数量×単価)が表示されます。下部の注文サマリーには「商品小計」も表示されますが、これはすべての行合計の合計であり、商品ごとの値とは別です。従来のOCRは、この小計を最後の商品の価格と誤認することがあります。これは空間的な近接性が原因です。
出品者とフルフィルメント情報。商品名の下に、出品者の種類に応じて追加の行が表示される場合があります。
- 出品者(サードパーティ): 商品名の下に「出品者: [出品者名]」と表示され、ページ上で確認できる場合は出品者の評価も表示されます。
- FBA(Amazonフルフィルメント): これらの商品は、通常、注文サマリーに出品者の記載はなく、商品名、数量、価格のみが表示されます。
- Subscribe & Save: Subscribe & Saveに登録されている商品には、割引率(例:「Subscribe & Saveで5%オフ」)と、割引後の価格が通常価格と併せて表示されます。1つの商品に2つの価格値があると、単一の価格フィールドを想定しているツールが混乱する可能性があります。
商品ごとの配送状況。Amazonは異なるフルフィルメントセンターから商品を発送する場合があり、その場合、1つの注文が複数の荷物で届くことがあります。注文画面の各商品には、異なる配送状況が表示される場合があります。商品1は「明日お届け予定」、商品2は「発送済み」、商品3は「準備中」などです。これらのステータスラベルは商品価格の下に表示され、抽出対象にノイズを加えます。
これらの複雑さがない単一商品のシナリオとの簡単な比較については、 基本的なAmazon注文スクリーンショットから注文番号と商品詳細を抽出するガイドをご覧ください。 複数商品のケースでは、分離すべき「商品詳細」ブロックが複数存在するため、異なるアプローチが必要です。
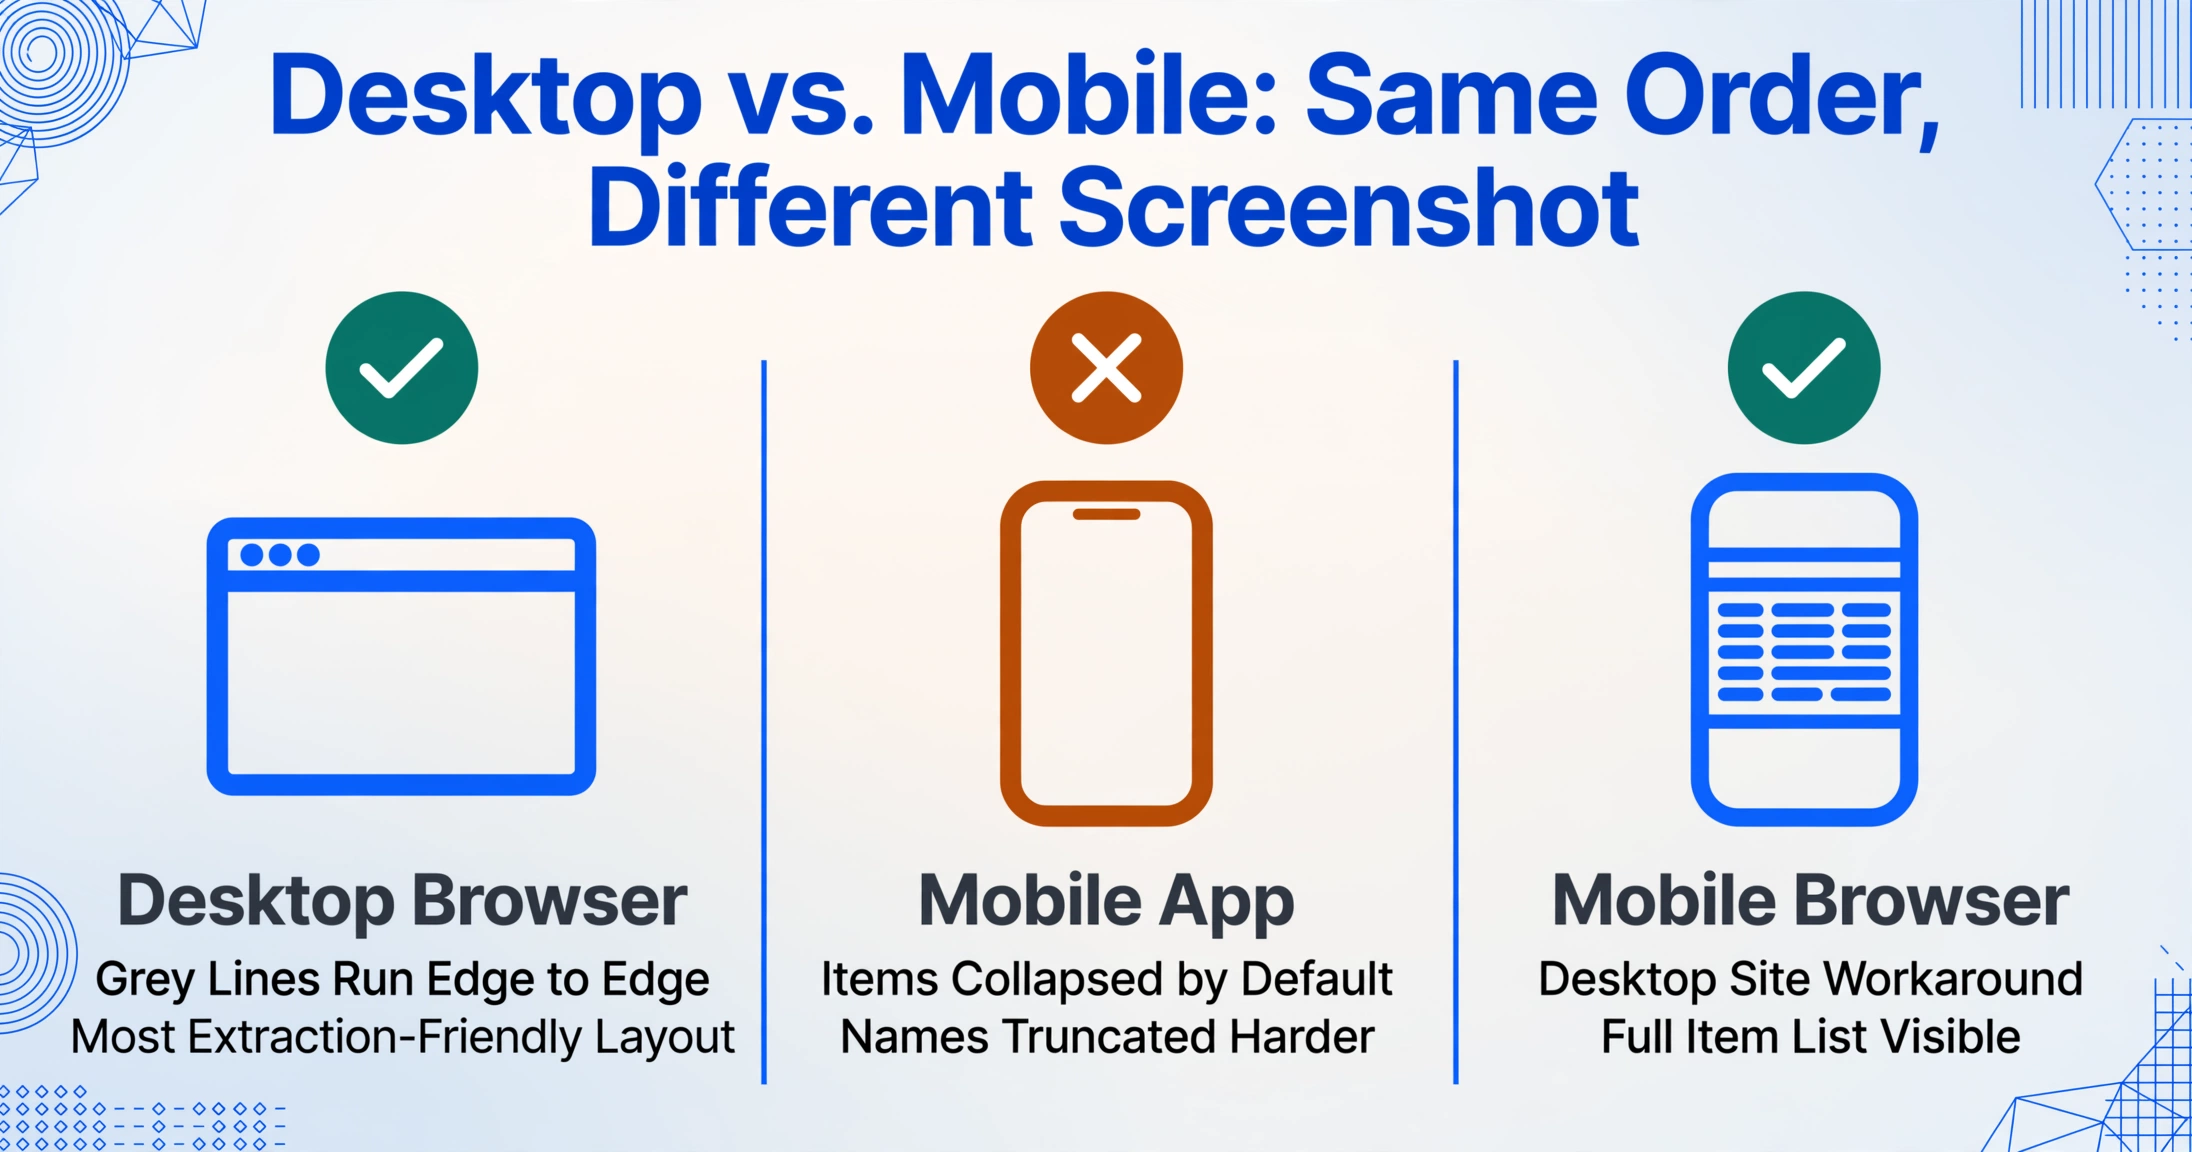
デスクトップ vs. モバイル — 同じ注文、異なるスクリーンショット
Amazonの注文ページはデスクトップとモバイルで表示が異なり、スクリーンショットの形式が明細行の読み取りやすさに直接影響します。
デスクトップ(Webブラウザ)。 デスクトップブラウザでの「注文」ページ全体は、商品が縦に積み重なったリストで表示され、各項目は左に商品画像、中央に商品詳細、右に価格が配置されます。灰色の区切り線が端から端まで引かれています。商品名は部分的に表示されますが、折り返される場合もあります。「もう一度注文」ボタンは明確に識別できます。このレイアウトは、視覚的な構造が一貫しており情報量が多いため、最も抽出に適しています。
モバイルアプリ。 Amazonモバイルアプリは異なるアプローチを取ります。注文リストはデフォルトで折りたたまれており、合計金額と配送状況が表示されたサマリーカードのみが見え、個々の商品を確認するには各注文をタップする必要があります。注文詳細ビュー内でも、商品名は小さな画面に合わせてより積極的に切り詰められ、価格は単価なしの行合計のみで表示される場合があり、出品者情報はさらにタップしないと表示されない場合があります。さらに重要なのは、 r/amazonprime の一部ユーザーが、Amazonアプリが特定のデバイスでスクリーンショットを制限していると報告していることです — ユーザーは別のデバイスで画面を撮影するか、モバイルブラウザでデスクトップサイトを開いてそこからスクリーンショットを撮ることを余儀なくされます。
モバイルブラウザ(デスクトップサイト)。 一般的な回避策は、モバイルブラウザでAmazonウェブサイトを読み込み、ページのデスクトップ版をリクエストして、そのスクリーンショットを撮ることです。結果は、小さな画面に縮小されたデスクトップレイアウトで、テキストは小さくなりますが、折りたたまれることなく完全な商品リストが表示されます。これは多くの場合、モバイルでの最良の抽出シナリオです。
これらの形式間のレイアウトの違いは、テンプレートベースの抽出ツールでは各形式に個別のテンプレートが必要になることを意味します — そしてAmazonがUIを更新するたびに(これは定期的に発生し、 セラー向けフォーラムの苦情 に記録されています)、さらに多くのテンプレートが必要になります。テンプレート不要のセマンティック抽出は、これを完全に回避します。
最初の商品、中間の商品、最後の商品 — 系列位置の罠
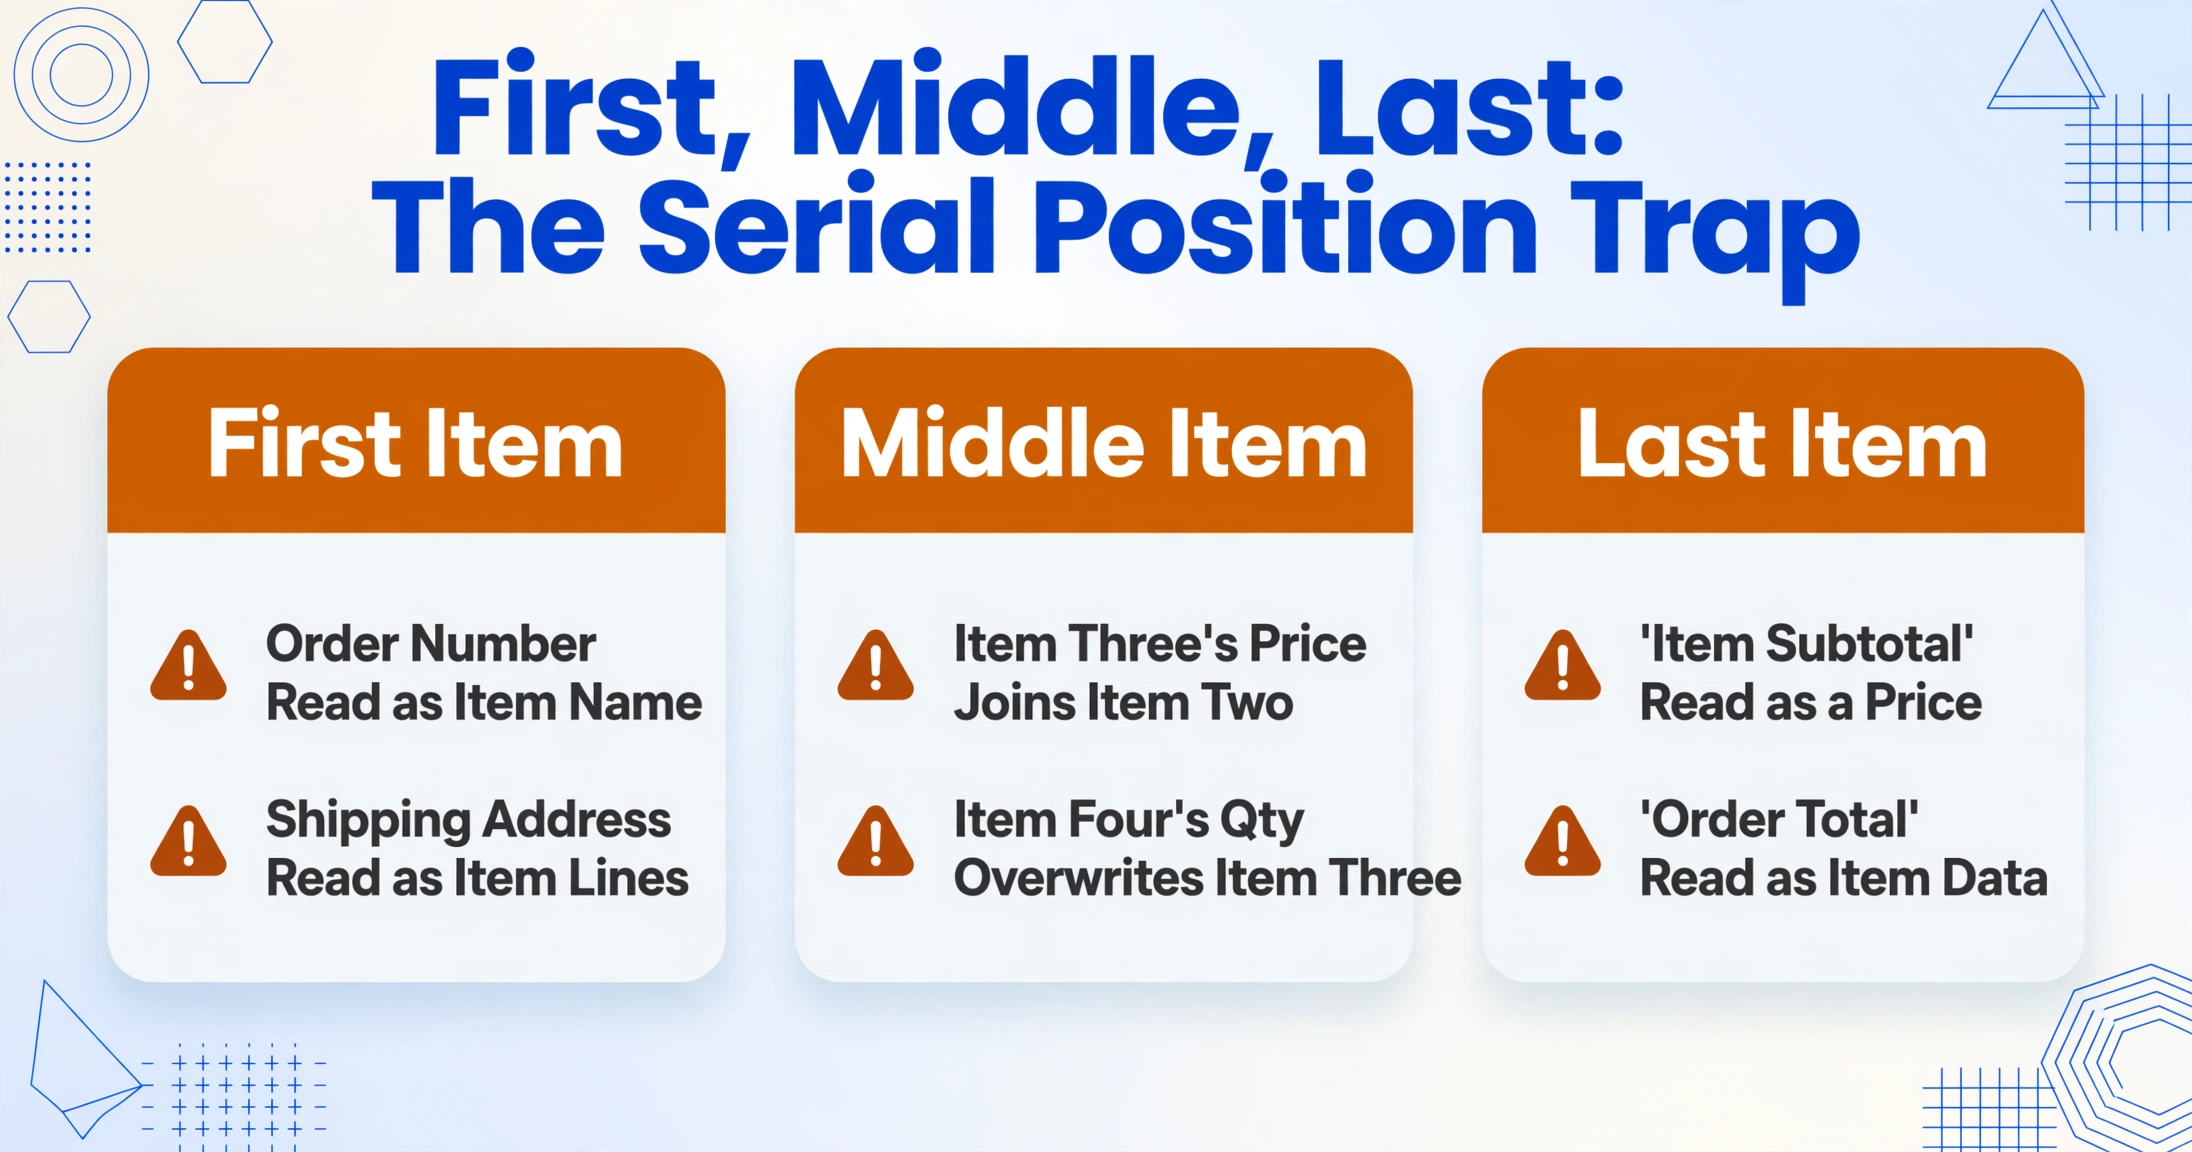
リスト内での商品の位置によって、最初・中間・最後の行でそれぞれ異なる抽出リスクが発生します。
最初の商品は、注文ヘッダー(注文番号、注文日、配送先住所)の直下に位置します。従来のOCRツールが上から下へ読み取ると、注文番号を商品名として、配送先住所の行を商品説明として解釈する可能性があります。最初の商品のデータをこのヘッダー文脈から分離するには、ヘッダー情報がどの商品行にも属さないことを理解する必要があります。
中間の商品は、隣接する商品の間に挟まれ、境界は灰色の線だけです。ここで系列位置効果が最も顕著になります。ある商品の詳細の終わりと次の商品の始まりが視覚的に近接しているためです。商品名が複数行に折り返されると、商品間の属性誤帰属の可能性がここで最も高くなります。3番目の商品の価格が2番目の商品の説明の続きとして読み取られたり、4番目の商品の数量が3番目の数量を上書きしたりします。それぞれのずれがリストの下へ連鎖していきます。
最後の商品は、注文サマリーセクション(「商品小計」「配送料・手数料」「税込前合計」「推定税額」、そして最終的な「注文合計」)に近接しています。最後の商品の価格はこのブロックのすぐ上にあり、サマリーの数値が追加の商品データと誤認される可能性があります。特に「商品小計」は、最後の商品の価格に近い大きな金額であるため、古典的なOCRの誤読パターンです。
これらの位置的なリスクは理論上の話ではありません。2025年の文書抽出エラーに関する業界分析では、データ入力ミスの60%以上がヘッダーフィールドではなく明細行レベルで発生しています。複数商品の注文では、最初と最後を除くすべての明細行が両側を類似データに囲まれているため、このリスクが集中します。
セマンティック抽出が複数商品の注文をどのように異なる方法で読み取るか
明細行の抽出問題に対する標準的な対応は、行検出を改善することです。つまり、より鮮明な線の検出、より良い列の整列、より多くのトレーニングデータです。 ImageToTable.aiは根本的に異なるアプローチを採用しており、視覚的な境界を検出することに依存しません。
カスタム列抽出は、各フィールドがどこにあるかではなく、何を意味するかを理解することで機能します。抽出したい列(「商品名」「数量」「単価」「行合計」)を定義すると、AIはセマンティックな理解に基づいて、スクリーンショット上のどこでも対応する値を見つけ出します。列定義が位置ではなく意味に基づいているため、このアプローチは、デスクトップ、モバイルブラウザ、または折りたたまれたモバイルアプリビューのいずれでスクリーンショットを撮った場合でも、同じように機能します。
複数商品の注文は、このアプローチから直接恩恵を受けます。AIは、商品1がどこで終わり、商品2がどこから始まるかを知るために、灰色の区切り線を検出する必要はありません。各商品エントリ全体をセマンティックな単位(名前、数量、価格で構成されるまとまり)として識別し、それらを別々の行として抽出します。長い商品名の折り返された2行目も、視覚的に別々のテキストブロックとしてではなく、同じセマンティックな単位の一部としてAIが理解するため、正しい商品に付随します。
単一商品のAmazon注文抽出にすでに慣れている場合、複数商品の注文でもワークフローは同じです。出力に行が増えるだけです。同じ 追跡・配送情報 も、購入詳細と物流ステータスの両方を1つのテーブルで必要な場合に、商品データと一緒に抽出できます。
複数の注文のバッチ処理。セマンティック抽出の実用的な利点の1つは、複数のスクリーンショットに拡張できることです。10枚の複数商品のAmazon注文スクリーンショットがある場合(おそらくAmazon Businessでの1か月分の購入分)、それらをすべて一度にアップロードし、列を一度定義するだけで、すべての注文のすべての商品を含む単一の統合テーブルを取得できます。各行にはソース識別子が含まれているため、商品を元の注文まで追跡できます。これにより、1時間以上かかる手動のコピー&ペースト作業が、数分のセットアップに変わります。
複数商品の注文スクリーンショットの視覚的な複雑さが、クリーンな抽出を妨げない理由についてのより深い議論は、関連記事 混雑したAmazon注文スクリーンショットが実際にはそれほど複雑に見えない理由 をご覧ください。
よくある質問
モバイルアプリのスクリーンショットで、折りたたまれた明細項目を抽出できますか?
はい、ただしスクリーンショットに明細の詳細が表示されている場合に限ります。各注文をタップして開かずに注文一覧を撮影した場合、個別の商品は表示されない可能性があります。ベストプラクティスは、注文詳細画面(全商品リストが表示される画面)を開いてからスクリーンショットを撮ることです。Amazonアプリでスクリーンショットがブロックされる場合は、モバイルブラウザでサイトのデスクトップ版を表示し、その画面を撮影してください。
スクリーンショットで商品名が「...」で省略されている場合はどうなりますか?
抽出処理は、スクリーンショットから読み取れる情報を取得します。省略された名前(通常は最初の60~80文字)でも、商品を特定するには十分な場合がほとんどです。完全な商品タイトルが必要な場合は、注文IDや商品説明をAmazonアカウントと照合してください。抽出結果には、スクリーンショットに表示されているテキストが、省略されているかどうかに関わらず含まれます。
Subscribe & Saveの割引情報は正しく抽出されますか?
はい。Subscribe & Saveの割引がある商品の場合、スクリーンショットには割引価格と通常価格の両方、および割引率が表示されます。「単価」列を定義して実際に支払った価格を取得したり、「通常価格」と「割引額」の列を別々に定義して割引額を追跡することも可能です。抽出処理は、これら2つの価格を異なるセマンティックラベルを持つ価格値として認識し、別々のフィールドとして扱います。
複数の商品を含む注文のスクリーンショットを、一度にまとめて処理できますか?
はい。本ツールはバッチファースト処理に対応しており、Amazonの注文スクリーンショット(単一商品・複数商品の両方)を何枚でもアップロードして、まとめて処理できます。出力は1つのスプレッドシートで、各行が1つの注文に含まれる1つの商品を表し、定義した列(商品名、数量、価格、および注文番号や配送状況などの追加フィールド)が含まれます。これにより、スクリーンショットの山が構造化された購入記録に変換されます。
注文に異なる出品者(FBAと第三者出品者)の商品が混在している場合はどうなりますか?
出品者の種類に関わらず、抽出処理は同じように機能します。FBAの商品は注文ページに出品者の表示がなく、第三者出品者の商品には「[出品者名] 出品」と表示されます。記録管理のためにこの情報が必要な場合は、「出品者」列を追加して取得できます。AIは、出品者情報の表示方法に関わらず、各商品を独立した行として扱います。
抽出時の数量の扱いについて — 1行が1商品ですか、それとも1単位ですか?
デフォルトでは、ツールは明細行ごとに1行を出力します。注文に同じ商品が「数量: 3」と含まれている場合、3行に分割されるのではなく、数量=3の1行として出力されます。在庫管理や原価配分のために、各単位を個別の行として必要な場合は、計算列を定義するか、エクスポート後に数量を分割してください。抽出処理は、注文ページの表示ロジックをそのまま保持します。