Pedidos de Amazon con varios artículos
Lea el nombre, la cantidad y el precio de cada artículo desde una captura de pantalla
Un solo pedido de Amazon puede contener cinco artículos, cada uno con su propio nombre, cantidad y precio, todos apilados verticalmente en la misma página, separados por nada más que una fina línea gris. Encontrar los datos no es lo difícil. Mantenerlos ordenados sí lo es: asegurarse de que el precio del segundo artículo no termine vinculado al total del primero, y que la segunda línea envuelta de un nombre de producto largo no se lea como una entrada independiente.
Conclusiones clave
- Las herramientas de OCR prometen extracción de tablas, hasta que se enfrentan a una pantalla de pedido con varios artículos donde estos se dividen solo por una línea gris demasiado tenue para que el motor la detecte.
- Un nombre de producto que se envuelve a una segunda línea se sitúa exactamente en la misma posición de pantalla que el precio del siguiente artículo, y un lector basado en coordenadas asigna ese precio a la fila equivocada cada vez.
- La extracción semántica no busca líneas de cuadrícula en absoluto: lee cada artículo como una unidad agrupada de nombre, cantidad y precio, logrando la atribución correcta haya cinco artículos o cincuenta.
Por qué los pedidos con varios artículos suponen un reto para las herramientas de extracción tradicionales
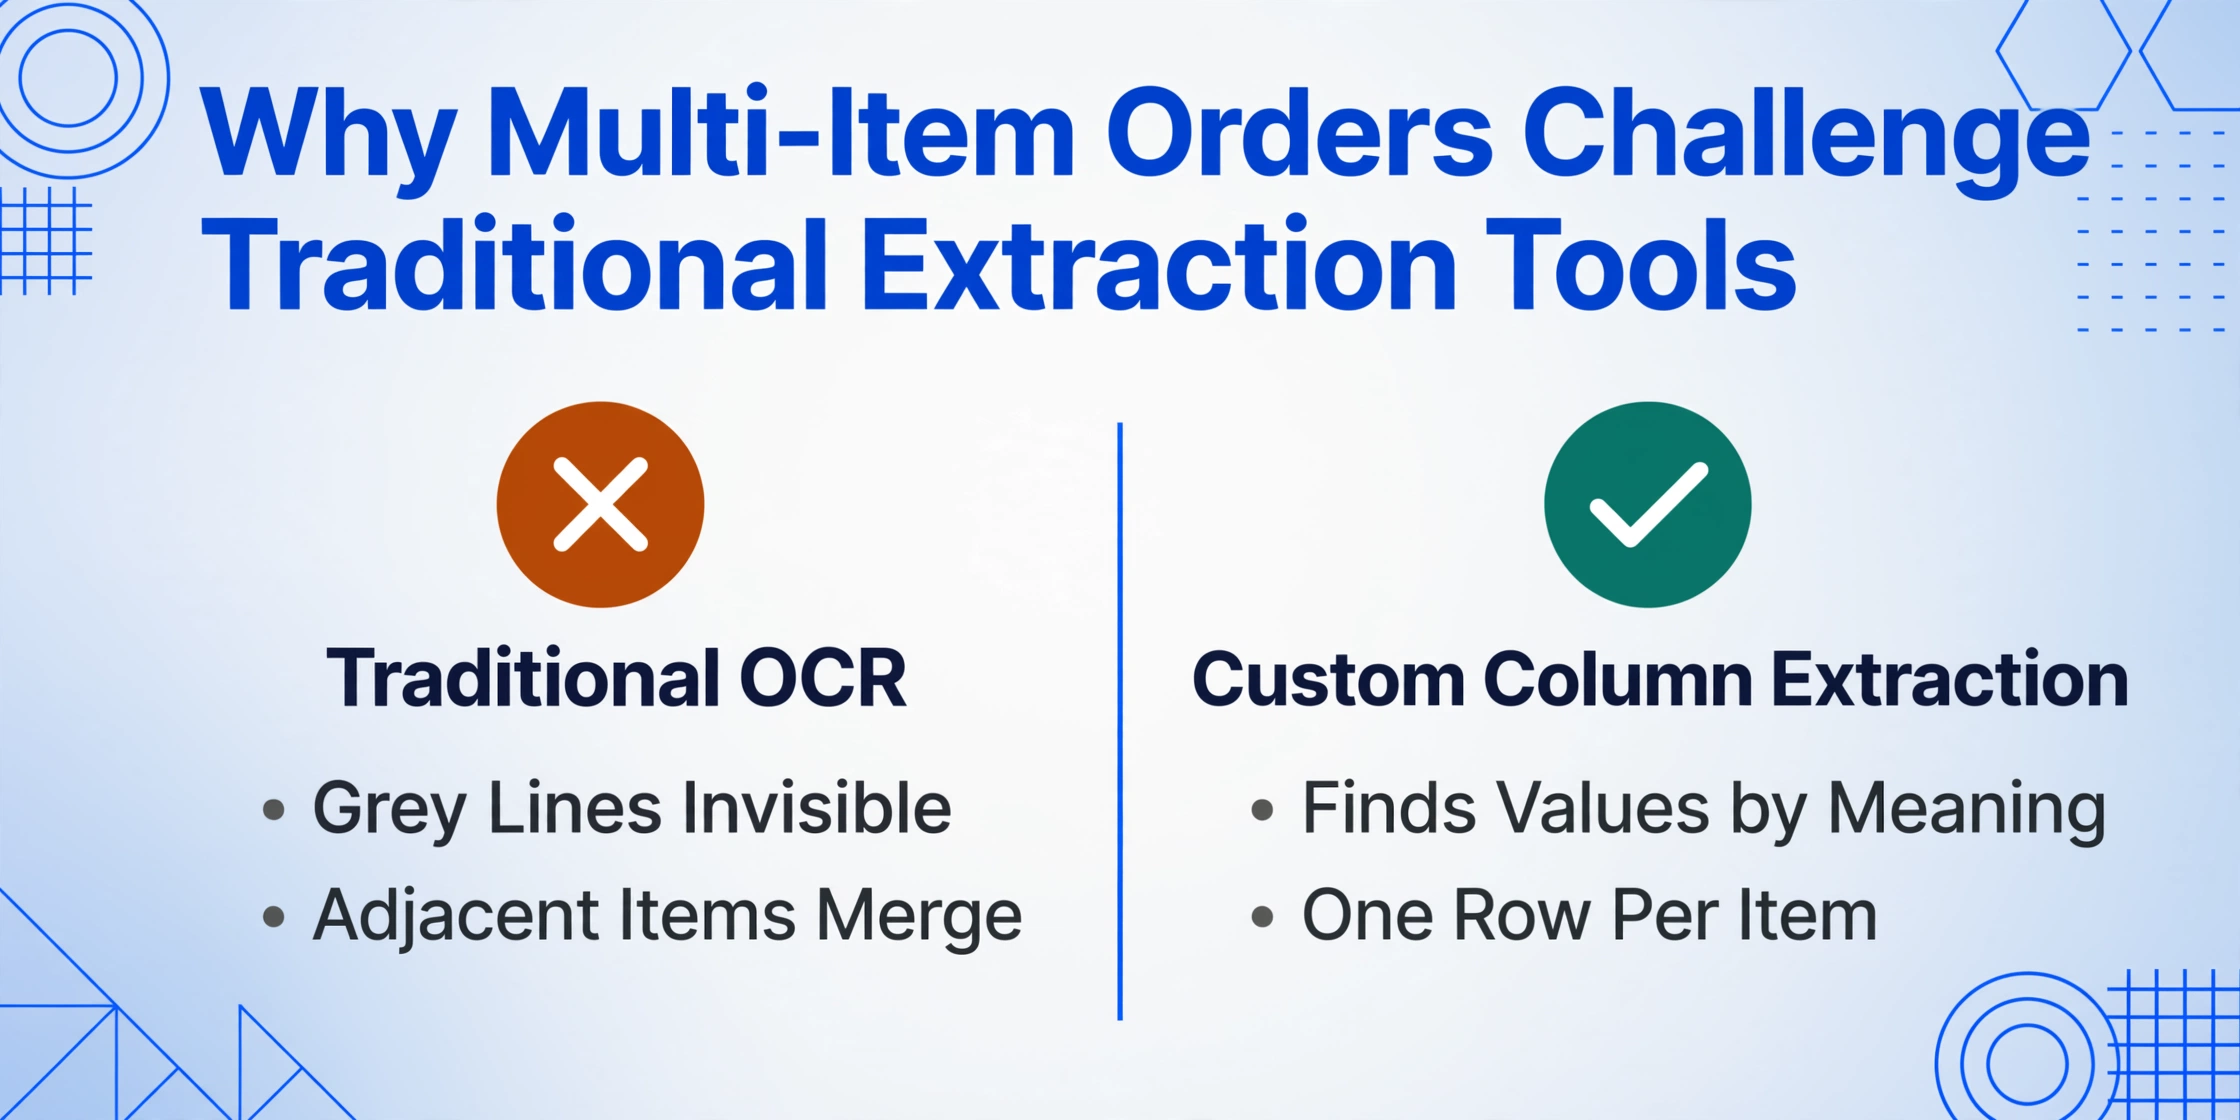
Una captura de pantalla de un pedido de un solo artículo presenta una tarea de lectura sencilla: un nombre de producto, una cantidad, un precio. Un pedido con varios artículos introduce un problema estructural que la mayoría de las herramientas OCR tradicionales no pueden resolver. El problema no es que haya más campos — es que la relación visual entre los campos se rompe cuando los artículos se apilan muy juntos.
El problema de la línea gris. Amazon separa los artículos en la página de detalles del pedido con finas reglas grises horizontales. Para el ojo humano, estas líneas son divisores obvios: todo lo que está por encima de la línea pertenece al artículo uno, todo lo que está por debajo al artículo dos. Para un motor OCR tradicional, una línea gris es invisible (demasiado tenue para detectarla) o simplemente otro elemento visual sin significado semántico. El motor ve un bloque continuo de texto y no sabe dónde termina un artículo y comienza el siguiente. El resultado: los límites de los artículos desaparecen y los datos de artículos adyacentes se fusionan en un único bloque no estructurado.
El texto envuelto rompe el orden de lectura. Los nombres de productos de Amazon suelen ser largos. "Bissell Pet Stain Eraser Cordless Carpet Cleaner, 2454, Gray" no cabe en una línea en el resumen del pedido — se envuelve a una segunda o incluso tercera línea. Ese texto envuelto se sitúa en la misma posición vertical que el precio del siguiente artículo. El OCR tradicional lee de izquierda a derecha, de arriba a abajo, por lo que puede capturar fácilmente la segunda línea del nombre del artículo uno y emparejarla con el precio del artículo dos. El lector obtiene una tabla donde los artículos y los precios están desalineados por una fila.
Los botones "Pedir de nuevo" interrumpen el flujo visual. Debajo de cada artículo en la página del pedido, Amazon coloca un botón "Comprar de nuevo" o "Pedir de nuevo". Estos botones añaden peso visual entre los artículos y cambian el ritmo vertical de la página. Una herramienta de extracción tradicional que depende de un espaciado uniforme o de la detección de líneas puede interpretar erróneamente estos botones como texto perteneciente al artículo anterior o como el comienzo de una nueva sección. En cualquier caso, el resultado de la extracción pierde integridad estructural.
El problema central es la atribución de filas. Las herramientas OCR tradicionales leen texto. No entienden que un nombre de producto, su cantidad y su precio forman una única unidad lógica. Cuando los límites visuales son sutiles — una línea fina, un nombre envuelto, un botón — la atribución se rompe.
Qué Contiene Realmente Cada Artículo
Antes de abordar el método de extracción, es útil saber exactamente qué campos aparecen por artículo en una captura de pantalla de un pedido de Amazon con varios artículos. La composición varía según el tipo de vendedor y la configuración del pedido, pero los campos principales son consistentes.
Nombre del artículo (truncado). Amazon muestra el título del producto, pero en la página de resumen del pedido casi siempre está truncado — comúnmente después de dos líneas con puntos suspensivos ("..."). El nombre completo está disponible en la página del producto, pero la captura de pantalla solo captura la versión abreviada. Para fines de extracción, el nombre truncado suele ser suficiente para la identificación.
Cantidad. Se muestra como "Cant: 1", "Cant: 2", etc. El tamaño de fuente suele ser más pequeño que el del nombre del artículo, y la etiqueta de cantidad se encuentra al lado o debajo de la imagen del producto. En las capturas de pantalla de la aplicación móvil, la cantidad puede estar oculta detrás de un estado contraído y solo es visible después de tocar para expandir.
Precio unitario y total de línea. Cada artículo muestra su precio unitario individual y, para artículos con cantidad múltiple, un total de línea (cant × precio unitario). El resumen del pedido en la parte inferior también muestra un "Subtotal de artículos" — la suma de todos los totales de línea — que es independiente de los valores por artículo. El OCR tradicional puede confundir este subtotal con el precio del último artículo debido a la proximidad espacial.
Información del vendedor y la logística. Debajo del nombre del artículo, Amazon puede mostrar líneas adicionales dependiendo del tipo de vendedor:
- Vendedores externos: "Vendido por [Nombre del vendedor]" aparece debajo del nombre del artículo, junto con la calificación del vendedor si es visible en la página.
- FBA (Gestionado por Amazon): Estos artículos normalmente no muestran atribución del vendedor en el resumen del pedido — solo el nombre del producto, la cantidad y el precio.
- Suscríbete y Ahorra: Los artículos inscritos en Suscríbete y Ahorra muestran un porcentaje de descuento (p. ej., "5 % de descuento con Suscríbete y Ahorra") y el precio con descuento junto al precio regular. Dos valores de precio por artículo pueden confundir a las herramientas que esperan un único campo de precio.
Estado de envío y entrega por artículo. Amazon puede enviar artículos desde diferentes centros logísticos, lo que significa que un pedido puede llegar en múltiples paquetes. Cada artículo en la pantalla del pedido puede mostrar un estado de entrega diferente: "Llega mañana" para el artículo uno, "Enviado" para el artículo dos, "Preparando" para el artículo tres. Estas etiquetas de estado se encuentran debajo del precio del artículo y añaden ruido al objetivo de extracción.
Para una comparación rápida del escenario de un solo artículo (que carece de estas complejidades), consulte nuestra guía sobre extracción del número de pedido y los detalles del artículo a partir de una captura de pantalla básica de un pedido de Amazon. El caso de varios artículos requiere un enfoque diferente porque hay más de un bloque de "detalles del artículo" que aislar.
Escritorio vs. Móvil: el mismo pedido, una captura diferente
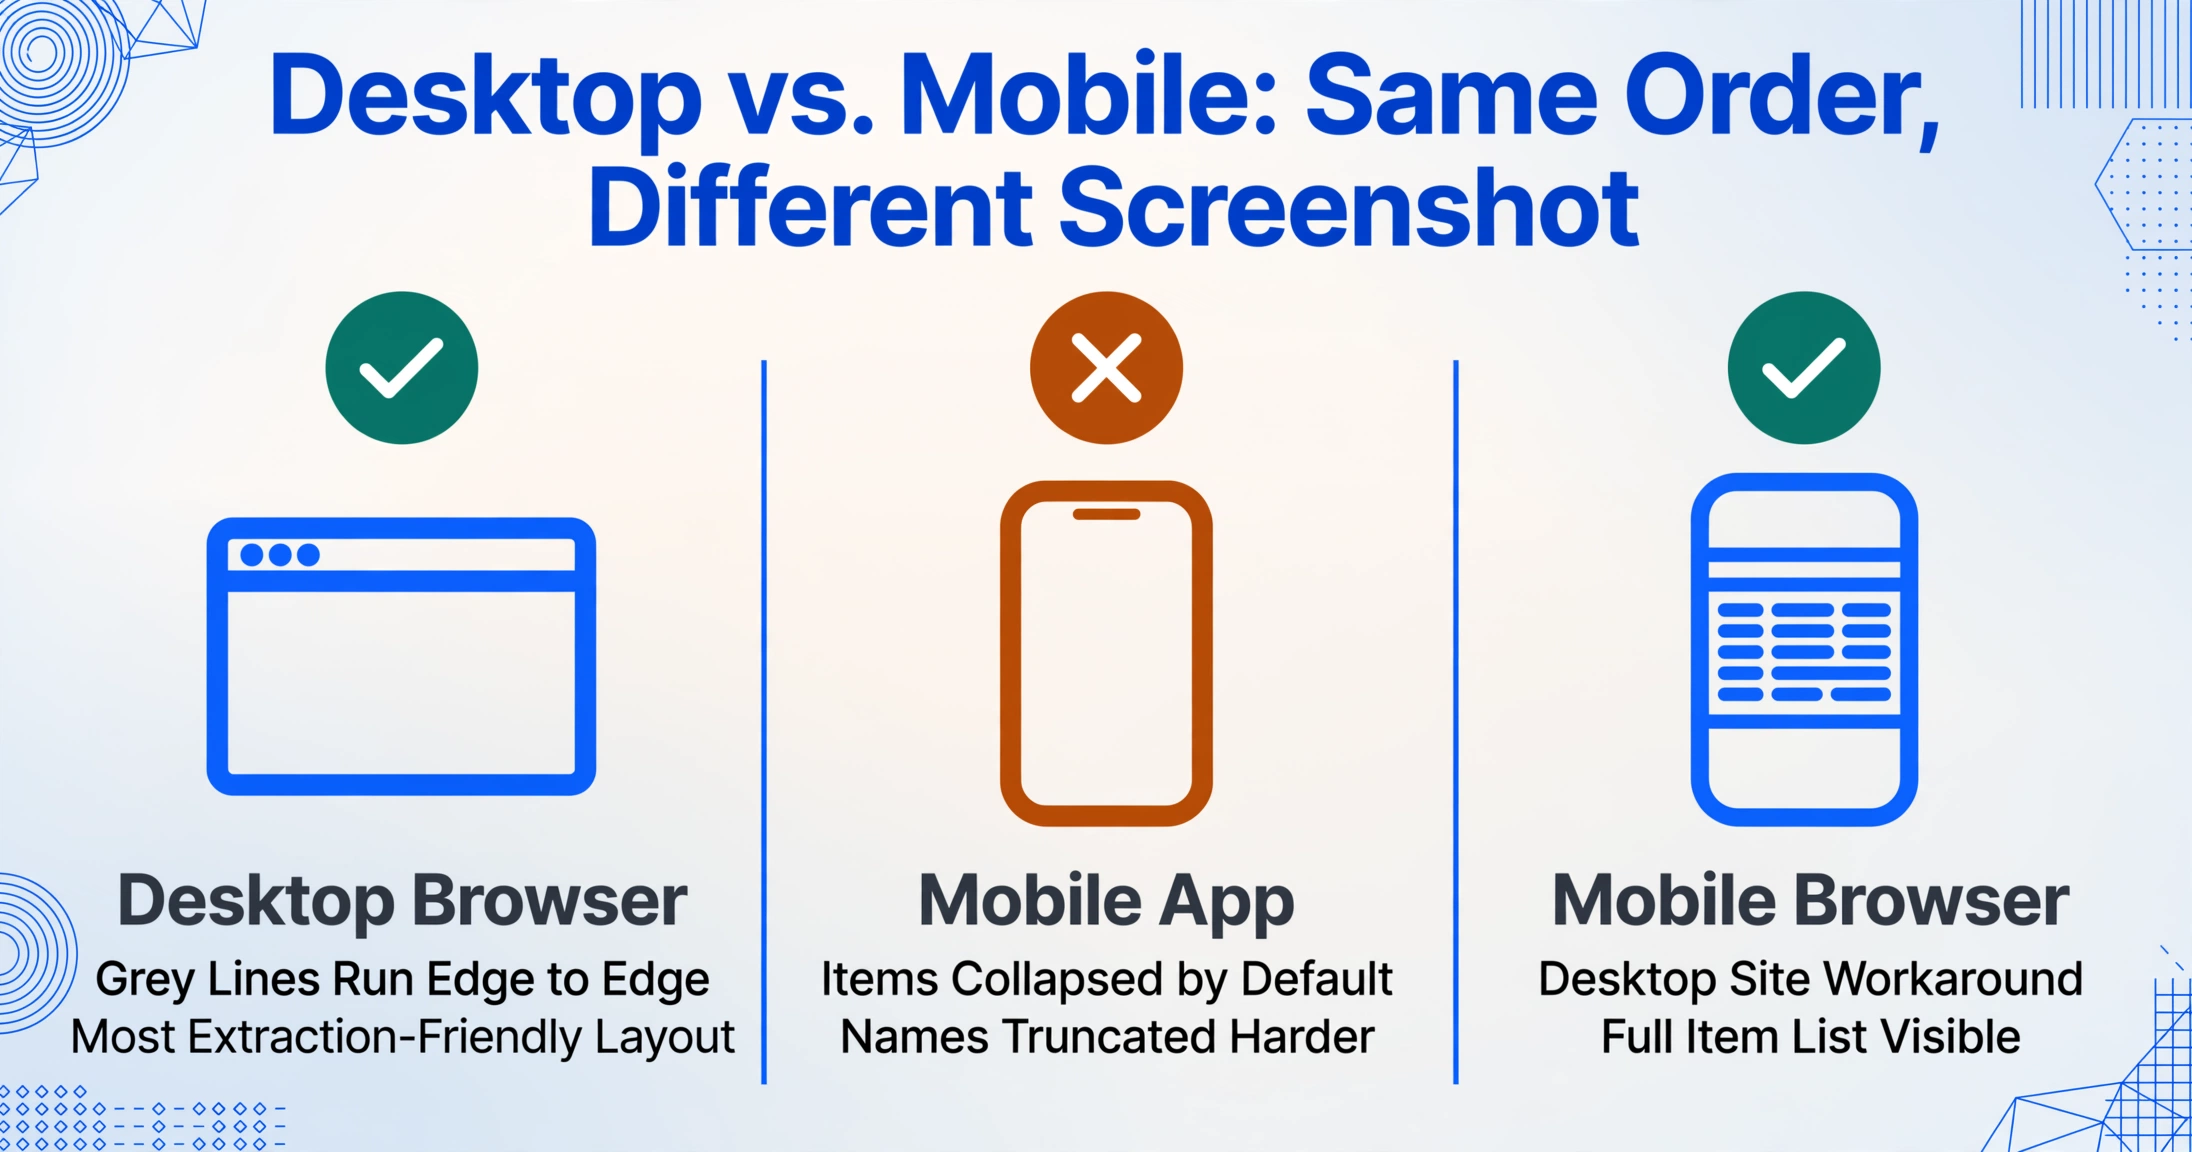
La página de pedidos de Amazon se muestra de forma distinta en escritorio y en móvil, y el formato de la captura afecta directamente a cómo se pueden leer los artículos de la línea.
Escritorio (navegador web). La página completa de «Sus pedidos» en un navegador de escritorio muestra los artículos en una lista apilada verticalmente, cada uno con la imagen del producto a la izquierda, los detalles del artículo en el centro y el precio a la derecha. Las líneas separadoras grises van de borde a borde. Los nombres de los artículos son parcialmente visibles, pero pueden ocupar varias líneas. Los botones de «Pedir de nuevo» se distinguen claramente. Este diseño es el más favorable para la extracción porque la estructura visual es coherente y densa en información.
Aplicación móvil. La aplicación móvil de Amazon adopta un enfoque diferente. La lista de pedidos está contraída de forma predeterminada: se ve una tarjeta de resumen con el total y el estado de entrega, y es necesario tocar cada pedido para ver los artículos individuales. Incluso dentro de la vista de detalle del pedido, los nombres de los artículos se truncan de forma más agresiva para adaptarse a pantallas más pequeñas, los precios pueden mostrarse solo como totales de línea sin precios unitarios, y la información del vendedor puede estar oculta tras un toque adicional. Más importante aún, algunos usuarios en r/amazonprime han informado de que la aplicación de Amazon restringe las capturas de pantalla en ciertos dispositivos, lo que obliga al usuario a hacer una foto de la pantalla con otro dispositivo o a abrir el sitio de escritorio en un navegador móvil y hacer la captura desde allí.
Navegador móvil (sitio de escritorio). Una solución habitual es cargar el sitio web de Amazon en un navegador móvil y solicitar la versión de escritorio de la página, y luego hacer la captura. El resultado es un diseño de escritorio reducido en una pantalla pequeña: el texto es más pequeño, pero la lista completa de artículos es visible sin contraerse. Este suele ser el mejor escenario de extracción en móvil.
La variación de diseño entre estos formatos significa que una herramienta de extracción basada en plantillas necesitaría una plantilla separada para cada formato, y aún más cuando Amazon actualiza su interfaz (algo que ocurre con regularidad, como documentan las quejas en el foro de vendedores). La extracción semántica sin plantilla evita esto por completo.
Primer artículo, artículo intermedio, último artículo: la trampa de la posición serial
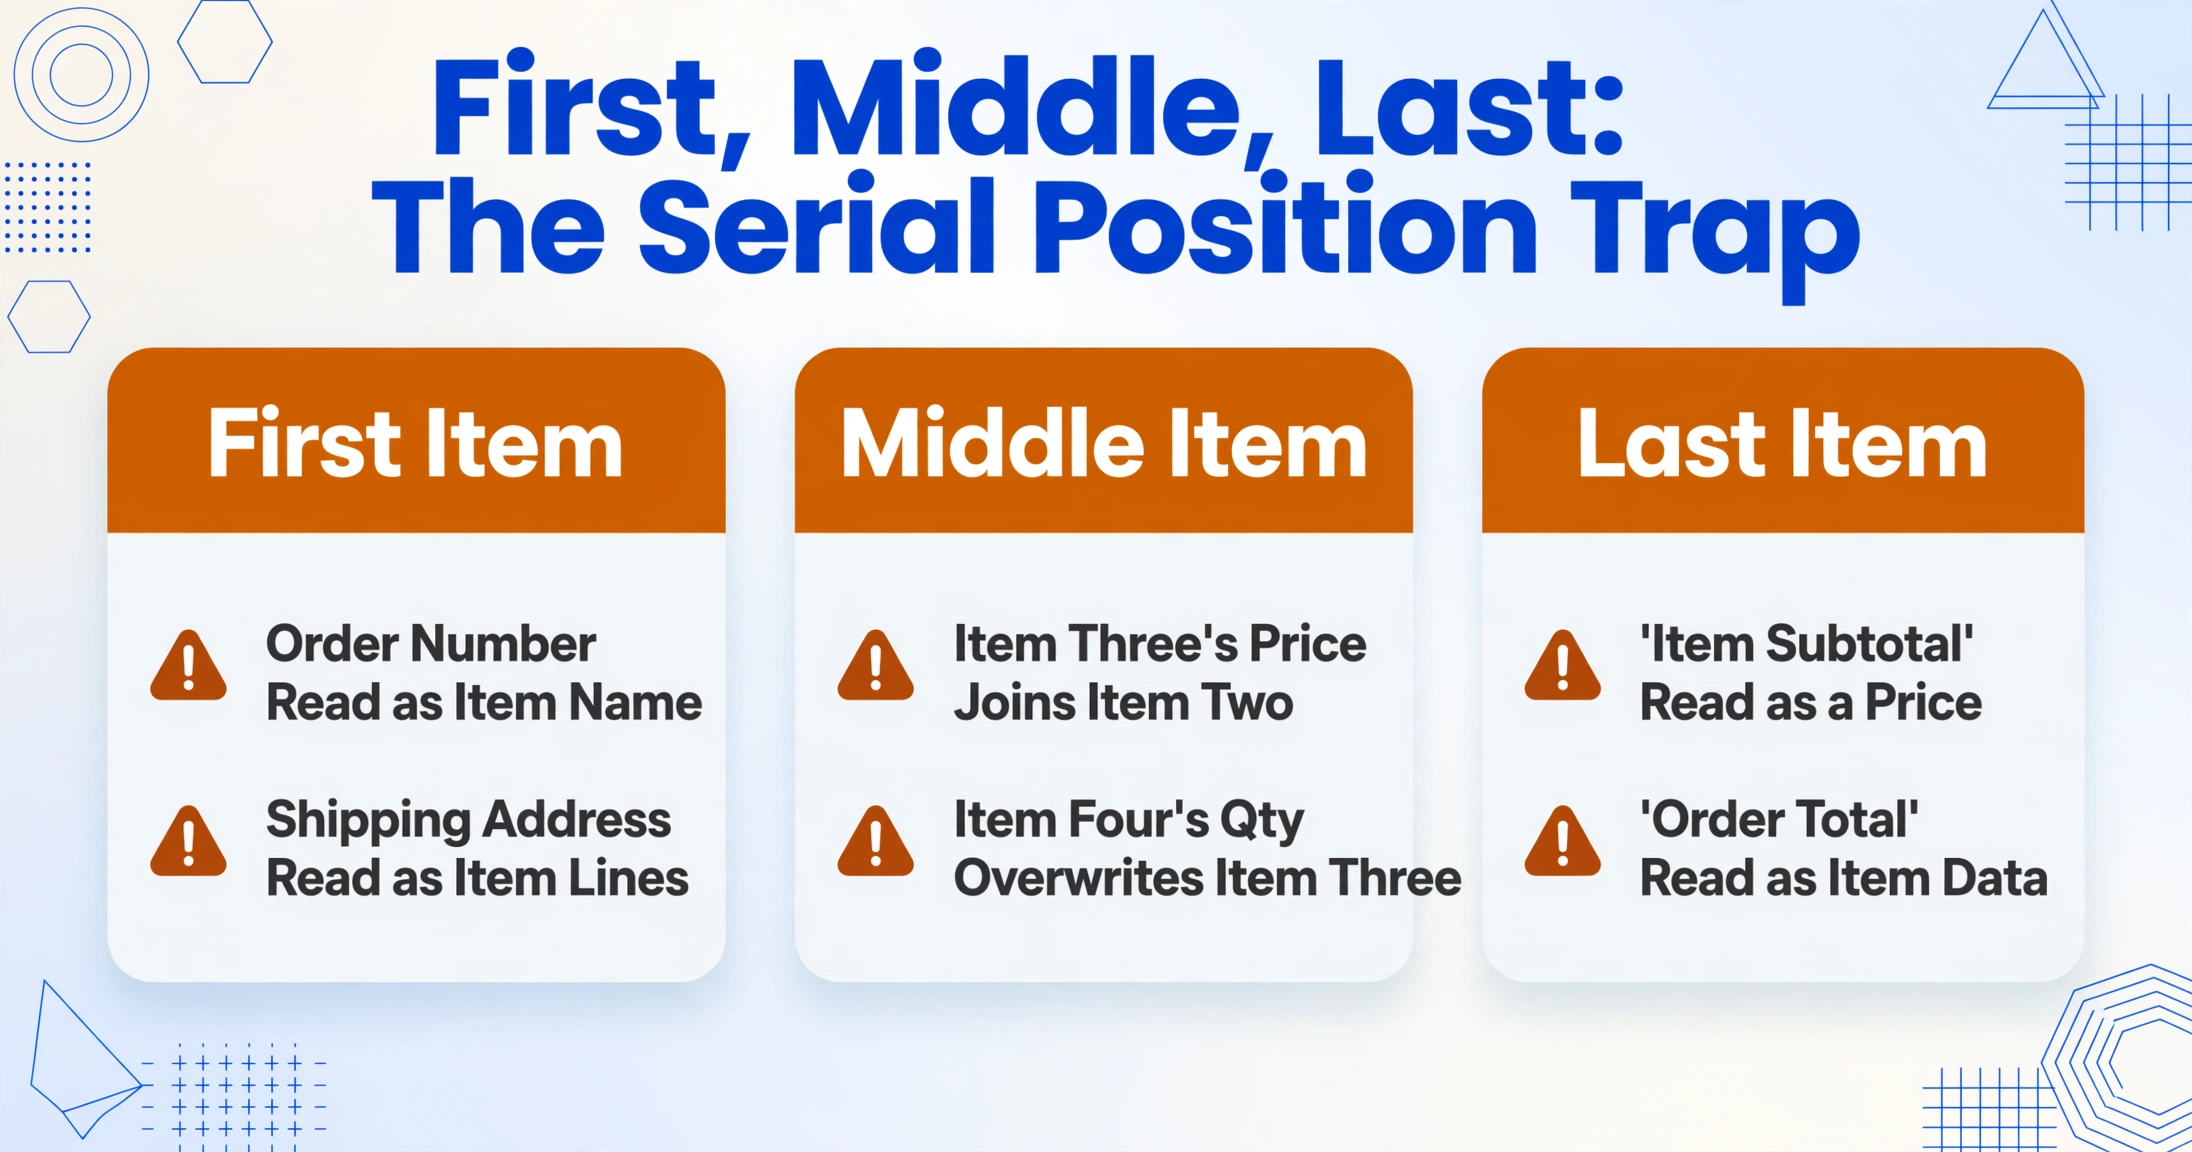
La posición de un artículo dentro de la lista genera riesgos de extracción distintos, que son diferentes para la primera, la intermedia y la última fila.
El primer artículo se encuentra directamente debajo del encabezado del pedido: el número de pedido, la fecha del pedido y la dirección de envío. Una herramienta de OCR tradicional que lea de arriba hacia abajo puede interpretar el número de pedido como nombre del artículo y las líneas de la dirección de envío como descripciones del artículo. Los datos del primer artículo deben aislarse de este contexto de encabezado, lo que requiere comprender que la información del encabezado no forma parte de ninguna fila de producto.
Los artículos intermedios quedan intercalados entre sus vecinos con solo líneas grises como límites. Aquí es donde los efectos de la posición serial son más agudos: el final de los detalles de un artículo y el comienzo del siguiente están visualmente cerca. Cuando los nombres de los artículos se extienden a varias líneas, el potencial de atribución errónea entre artículos es máximo aquí. El precio del artículo tres se lee como la continuación de la descripción del artículo dos. La cantidad del artículo cuatro sobrescribe la del artículo tres. Cada desalineación se propaga en cascada por la lista.
El último artículo enfrenta la proximidad a la sección de resumen del pedido: «Subtotal del artículo», «Envío y manipulación», «Total antes de impuestos», «Impuesto estimado» y el «Total del pedido» final. El precio del último artículo se encuentra justo encima de este bloque, y las cifras del resumen pueden confundirse con datos adicionales del artículo. «Subtotal del artículo» especialmente —es un monto en dólares grande cercano al precio del último artículo— es un error de lectura clásico del OCR.
Estos riesgos posicionales no son teóricos. En un análisis de la industria de 2025 sobre errores de extracción de documentos, más del 60 % de los errores de ingreso de datos se originaron a nivel de artículo de línea, no en los campos de encabezado. Los pedidos de varios artículos concentran este riesgo porque cada artículo de línea, excepto el primero y el último, está rodeado por ambos lados de datos similares.
Cómo la Extracción Semántica Lee Pedidos de Varios Artículos de Forma Diferente
La respuesta estándar a los problemas de extracción de artículos de línea es crear una mejor detección de filas: un trazado de líneas más preciso, una mejor alineación de columnas, más datos de entrenamiento. ImageToTable.ai adopta un enfoque fundamentalmente diferente, uno que no depende de detectar límites visuales en absoluto.
Extracción de Columnas Personalizadas funciona comprendiendo qué significa cada campo, no dónde se encuentra. Usted define las columnas que desea — "Nombre del artículo", "Cantidad", "Precio unitario", "Total de línea" — y la IA localiza los valores correspondientes en cualquier parte de la captura de pantalla mediante comprensión semántica. Dado que las definiciones de columnas se basan en el significado y no en la posición, el enfoque funciona de manera idéntica tanto si la captura se tomó en escritorio, navegador móvil o la vista colapsada de la aplicación móvil.
Los pedidos de varios artículos se benefician directamente de este enfoque. La IA no necesita detectar las líneas grises de separación para saber dónde termina el artículo uno y comienza el artículo dos. Identifica cada entrada de producto completa como una unidad semántica — un conjunto que consta de un nombre, una cantidad y un precio — y las extrae como filas separadas. La segunda línea envuelta de un nombre de producto largo permanece con el artículo correcto porque la IA la entiende como parte de la misma unidad semántica, no como un bloque de texto visualmente separado.
Si ya está familiarizado con la extracción de pedidos de un solo artículo de Amazon, el flujo de trabajo es idéntico para pedidos de varios artículos — solo obtiene más filas en la salida. La misma información de seguimiento y envío se puede extraer junto con los datos de los artículos cuando necesita tanto los detalles de compra como el estado logístico en una sola tabla.
Procesamiento por lotes de varios pedidos. Una de las ventajas prácticas de la extracción semántica es que se escala a múltiples capturas de pantalla. Si tiene diez capturas de pantalla de pedidos de Amazon con varios artículos — quizás de un mes de compras de Amazon Business — puede subirlas todas a la vez, definir sus columnas una vez y obtener una única tabla consolidada con cada artículo de cada pedido. Cada fila incluye su identificador de origen para que pueda rastrear los artículos hasta el pedido original. Esto convierte una sesión manual de copiar y pegar de una hora o más en unos pocos minutos de configuración.
Para una discusión más profunda sobre por qué la complejidad visual de una captura de pantalla de pedido de varios artículos no impide una extracción limpia, consulte nuestro artículo complementario sobre por qué una captura de pantalla de pedido de Amazon abarrotada no es tan desordenada como parece.
Preguntas Frecuentes
¿Puedo extraer líneas de artículos de una captura de pantalla de una aplicación móvil donde los artículos están colapsados?
Sí, pero solo si los detalles del artículo son visibles en la captura. Si capturó la lista de pedidos sin entrar en cada uno, es posible que los artículos individuales no aparezcan. La mejor práctica es entrar en la vista de detalle del pedido, que muestra la lista completa de artículos, y tomar la captura desde allí. Si la aplicación de Amazon bloquea las capturas de pantalla en su dispositivo, use un navegador móvil para cargar la versión de escritorio del sitio y capture la pantalla desde allí.
¿Qué sucede si los nombres de los artículos aparecen truncados con "..." en la captura de pantalla?
La extracción captura lo que puede leer de la captura. El nombre truncado — normalmente los primeros 60 a 80 caracteres — suele ser suficiente para identificar el producto. Si necesita el título completo del producto, puede cotejar el ID del pedido o la descripción del artículo con su cuenta de Amazon. El resultado de la extracción incluirá todo el texto visible en la captura, esté truncado o no.
¿La información del descuento de Suscríbete y Ahorra se extrae correctamente?
Sí. Cuando un artículo tiene un descuento de Suscríbete y Ahorra, la captura muestra tanto el precio con descuento como el precio normal, junto con el porcentaje de descuento. Puede definir una columna "Precio unitario" para capturar el precio que realmente pagó, o definir columnas separadas para "Precio normal" y "Descuento" si desea realizar un seguimiento del ahorro. La extracción maneja ambos precios como campos distintos porque los reconoce como valores de precio con etiquetas semánticas diferentes.
¿Puedo procesar varias capturas de pantalla de pedidos con varios artículos en un solo lote?
Sí. La herramienta admite el procesamiento por lotes prioritario, lo que significa que puede cargar cualquier cantidad de capturas de pantalla de pedidos de Amazon — de uno o varios artículos — y procesarlas juntas. El resultado es una única hoja de cálculo donde cada fila representa un artículo de un pedido, con las columnas que usted definió (nombre del artículo, cantidad, precio, además de cualquier campo adicional como número de pedido o estado de entrega). Esto transforma un conjunto de capturas de pantalla en un registro de compras estructurado.
¿Qué sucede si un pedido tiene artículos de diferentes vendedores (FBA (Gestionado por Amazon) frente a terceros)?
La extracción funciona igual independientemente del tipo de vendedor. Los artículos FBA aparecen sin atribución de vendedor en la página del pedido; los artículos de terceros muestran "Vendido por [nombre del vendedor]". Puede agregar una columna "Vendedor" para capturar esta información si la necesita para su registro. La IA trata cada artículo como una fila independiente, independientemente de cómo se muestre la información del vendedor.
¿Cómo funciona la cantidad de artículos en la extracción: una fila por artículo o una fila por unidad?
De forma predeterminada, la herramienta genera una fila por artículo de línea. Si un pedido contiene "Cantidad: 3" del mismo producto, obtendrá una fila con Cantidad=3, no tres filas separadas. Si necesita cada unidad individual como una fila separada (para seguimiento de inventario o asignación de costos), puede definir una columna calculada o dividir las cantidades después de la exportación. La extracción conserva la lógica de visualización de la página del pedido.