ABBYY FineReaderと最新AI OCRの比較:
従来の精度と新たな柔軟性
ABBYY FineReaderは、クリーンな印刷文書向けにこれまで作られた中で最も正確な光学文字認識エンジンです。 一方、文字照合アルゴリズムではなくビジョン言語モデルを基盤とする最新AI OCRは、今日利用可能な最も柔軟な文書データ抽出技術です。どちらの主張も矛盾しません。これらは同じ問題を解決する競合製品ではなく、異なる文書処理タスクのための異なるツールだからです。どちらを選ぶかは、実際に扱う文書の種類を理解することから始まります。
重要なポイント
- ABBYYの99.8%の文字精度は本物であり、他を凌駕しています。しかし、Capterraのレビュアーは「明らかな表が多数検出されない」と指摘しています。すべての文字を正しく読んでも、どの数字がどのスプレッドシートの列に属するかは分からないからです。
- すべてのOCRベンダーが競う精度ベンチマークには、永続的なコストが隠れています。サプライヤーが請求書を再設計するたびに誰かがテンプレートを再構築する必要があり、ABBYY自身のG2レビューでも「簡単な変更にもITサポートが必要」とされています。
- 重要なのは3つの質問だけです。処理するレイアウトのバリエーション数、文書がスキャナーとスマホのどちらで届くか、検索可能なPDFと構造化されたスプレッドシートのどちらが必要か。ABBYYとAI OCRは、それぞれの質問に対して正反対の答えで優位に立ちます。
クイック比較
以下の表は、ABBYY FineReaderと最新のAI OCRツールを、文書抽出アプローチを選ぶ際に最も重要な5つの観点で比較したものです。各観点の詳細は、以降のセクションで解説します。
| 観点 | ABBYY FineReader | 最新のAI OCR |
|---|---|---|
| 固定フォーマット文書の精度 | クリーンなスキャン文書で99.8% — 業界トップクラスの文字レベル精度 | 印刷テキストで約99% — 文字精度では追いつき、表構造では優位 |
| 多様なフォーマットへの柔軟性 | テンプレート/ゾーンOCR — レイアウトごとに設定が必要。フォーマット変更でテンプレートが破綻 | テンプレート不要 — ピクセル位置ではなく意味を理解して、あらゆるレイアウトに適応 |
| セットアップ・設定時間 | デスクトップインストール+フォーマット別テンプレート学習。エンタープライズ導入は数週間かかる | ブラウザベースでセットアップ不要 — ファイルをアップロードし、列名を指定すれば数秒で結果を確認 |
| スマホ撮影 vs フラットベッドスキャン対応 | フラットベッドスキャナ出力向け — 遠近、影、低照度に弱い | モバイル撮影向け — 歪み、不均一な照明、複合背景に対応 |
| 料金体系 | デスクトップ版は1席あたり年間$99〜$165。エンタープライズ版は年間$40K〜$300K以上 | 無料ゲスト枠あり。有料プランは月額$9〜$59。従量課金は50ページあたり$6〜 |
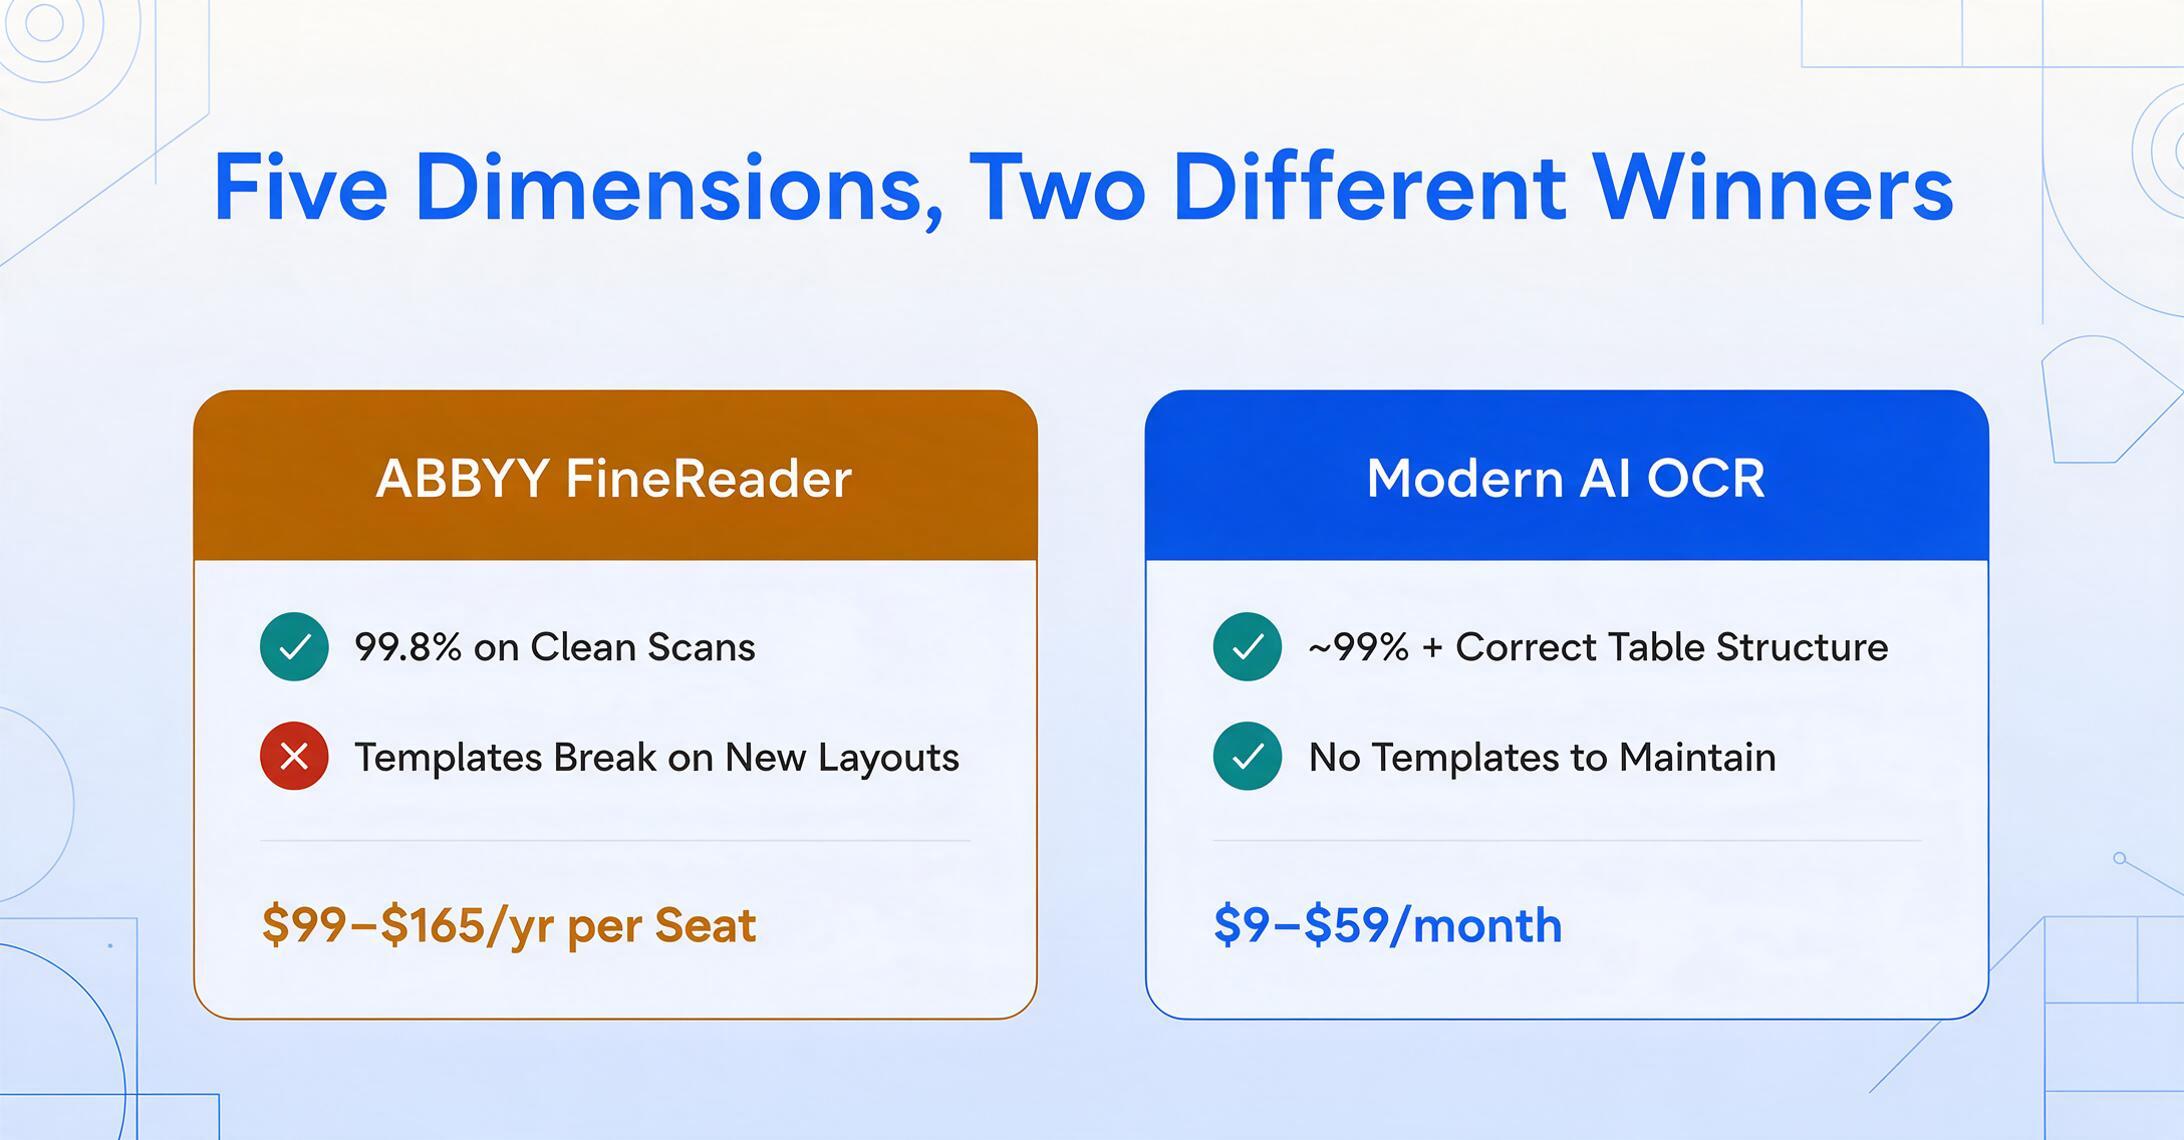
これらの観点はそれぞれ異なる側面を語っています。最も重要な観点は、日々処理する文書によってまったく異なります。
次元1:固定フォーマット文書の精度
ABBYY FineReaderは、クリーンで構造化された固定フォーマット文書の文字レベル精度において依然としてゴールドスタンダードであり、その優位性は想像上のものではありません。独立したテストでは、良好にスキャンされた文書の印刷テキストに対して99.8%の精度が一貫して報告されています。文字の誤読が重大な結果をもたらす場面 — 法務文書のデジタル化、アーカイブ保存、政府フォーム — では、その差が重要になります。
ABBYYは、長年にわたって磨かれてきた成熟した認識パイプライン(傾き補正、コントラスト最適化、マルチエンジン照合)によってこれを実現しています。キリル文字、アラビア文字、CJK文字、歴史的書体を含む201言語への対応は、デスクトップOCR市場で比類のないものです。PCMag Editors' Choiceのレビューは、FineReaderが「これまでテストした中で最も正確なOCRツールであり続けている」と指摘しています — これは継続的な改良によって獲得された評判です。
しかし、重要なニュアンスがあります。ABBYYの精度は文字レベルです。つまり、正しい文字と数字を読み取ります。しかし、それらの文字が形成する構造を常に理解するわけではありません。Capterraのレビューはこれを捉えています:「自動変換時に、特に罫線のないテーブルはABBYYでは検出されないことが多い」。文字は正しい。テーブル構造は間違っている。ユーザーはデータを手動で再構成しなければなりません。
最新のAI OCRは、文書画像全体を総合的に解析するビジョン言語モデルを使用します — 文字と、文字間の空間的関係の両方を読み取ります。クリーンな印刷テキストでは、ABBYYとの文字レベル精度の差はわずかです(約99%対99.8%)。しかし、AI OCRは構造精度に優れています:どの数字がどの列に属するかを正しく識別し、罫線のないテーブルや結合セルでも、請求書の合計と小計を区別します。
まとめ:クリーンなスキャン文書の文字レベル精度では、ABBYYが依然としてわずかに優位です。データを正しい列に配置する構造精度では、特に明示的な罫線のない文書では、AI OCRが優れることがよくあります。
次元2:多様なフォーマットへの柔軟性
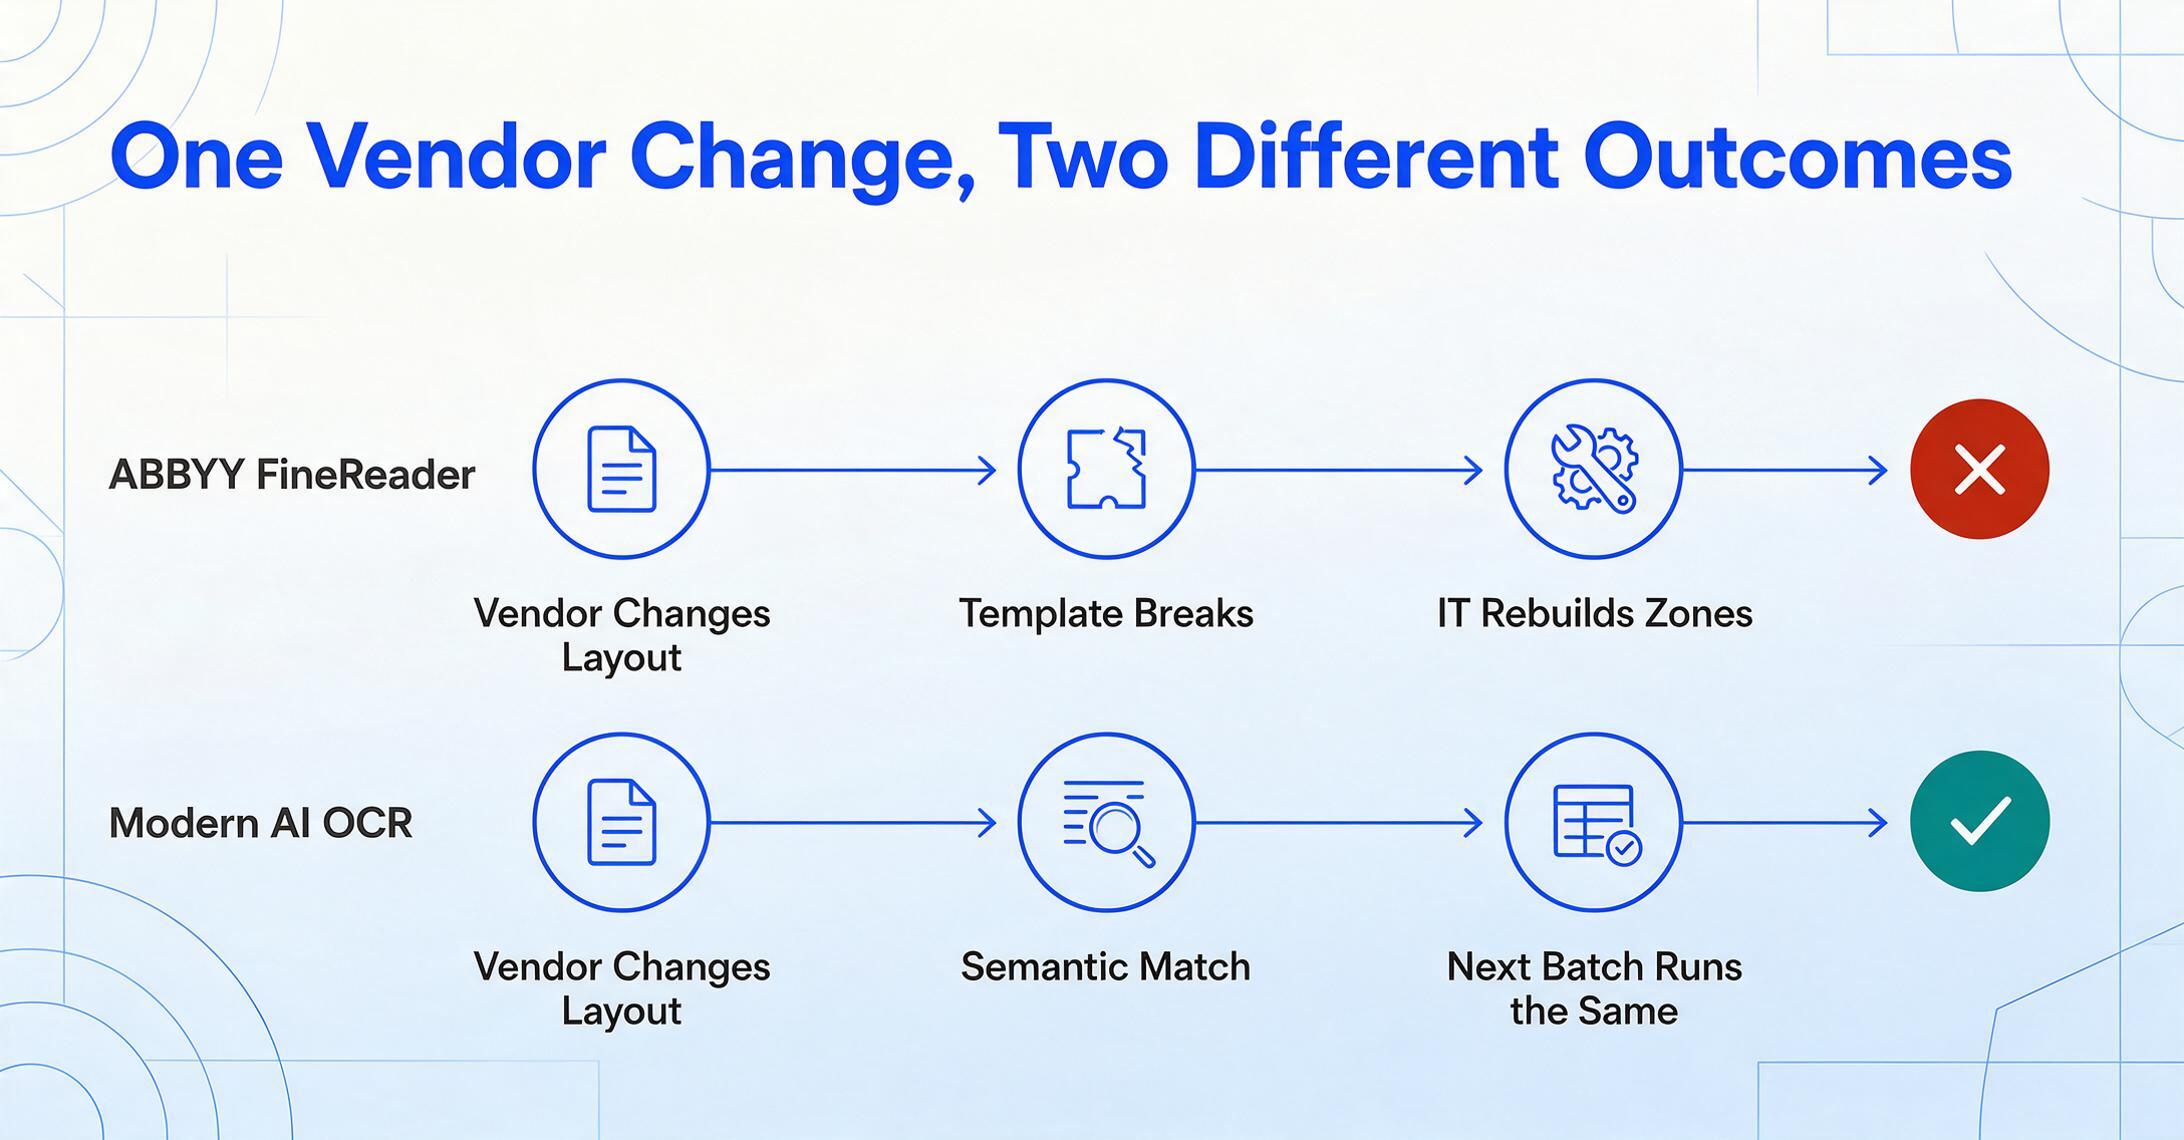
ここで2つのパラダイムは最も明確に分かれます。ABBYYのテンプレート依存は、複数ベンダー・複数フォーマットの世界における最大の制約です。AI OCRのセマンティックアプローチは、まさにこの問題を解決するためにゼロから構築されました。
ABBYYの抽出エンジン(FlexiCaptureおよびVantage)はFlexiLayoutテンプレートに依存しています。各レイアウトごとにゾーン、アンカー、フィールド座標、抽出ルールを定義する必要があります。ベンダーが請求書のデザインを変更したり、列ヘッダーを改名したりすると、テンプレートは破損します。技術的な専門知識を持つ誰かがFlexiLayout Studioを開いてゾーン定義を調整しなければなりません。数十のベンダーから文書を処理するチームにとって、これは恒久的なメンテナンスの負担を生み出します。ABBYYのG2レビューもこれを裏付けています:「簡単な変更にもITサポートが必要」
最新のAI OCRはこの問題を完全に排除します。セマンティック抽出を使用するのです。抽出したい列名(請求書番号、日付、合計)を入力するだけで、AIはページ上の用語の意味を理解して対応する値を特定します。事前定義されたテンプレートのピクセル座標を照合するのではありません。入力した列名が出力スプレッドシートのヘッダーになります。これは、文書が請求書であれ、発注書であれ、銀行明細書であれ、同じように機能します。
実際の結果として、ベンダーがフォーマットを変更しても抽出は機能し続けます。テンプレートの再構築も、ゾーンの再描画も、ITチケットの提出も不要です。次のバッチは前回と同じように処理されます。
次元3:セットアップと設定にかかる時間
意思決定から最初の抽出結果を得るまでの時間は桁違いに異なります。その差は、2つのアプローチがどのように構築されているかという構造的な違いを反映しています。
ABBYY FineReaderデスクトップ版:ダウンロードとインストール(約30分)。テンプレートを使ったバッチ処理(CorporateまたはFlexiCapture)の場合:文書形式ごとにテンプレートの作成と検証に少なくとも半日かかります。VantageやFlexiCaptureのエンタープライズ展開の場合:導入パートナーとともに2〜12週間、さらにサービス費用として$20,000〜$150,000がかかります。
最新のAI OCR:ブラウザを開く。ファイルをアップロードする。必要な列を入力する。抽出されたデータを確認する。合計所要時間:30秒未満。インストール不要、テンプレート学習不要、コンサルタント不要。このツールは、データを必要とする人向けに設計されています。プラットフォームを設定するIT管理者向けではありません。
このコスト差は次の次元に直接つながります。処理する文書の種類によって、デスクトップ級の前処理が必要か、モバイルで撮影した画像をそのまま扱えるかが決まるからです。
次元4:スマホ写真とフラットベッドスキャン
従来のOCRと最新のAI OCRの間で最も議論されていない違いは、画像ソースへの対応方法です。そして、これが実際にどちらのツールが実務で使えるかを左右することがよくあります。
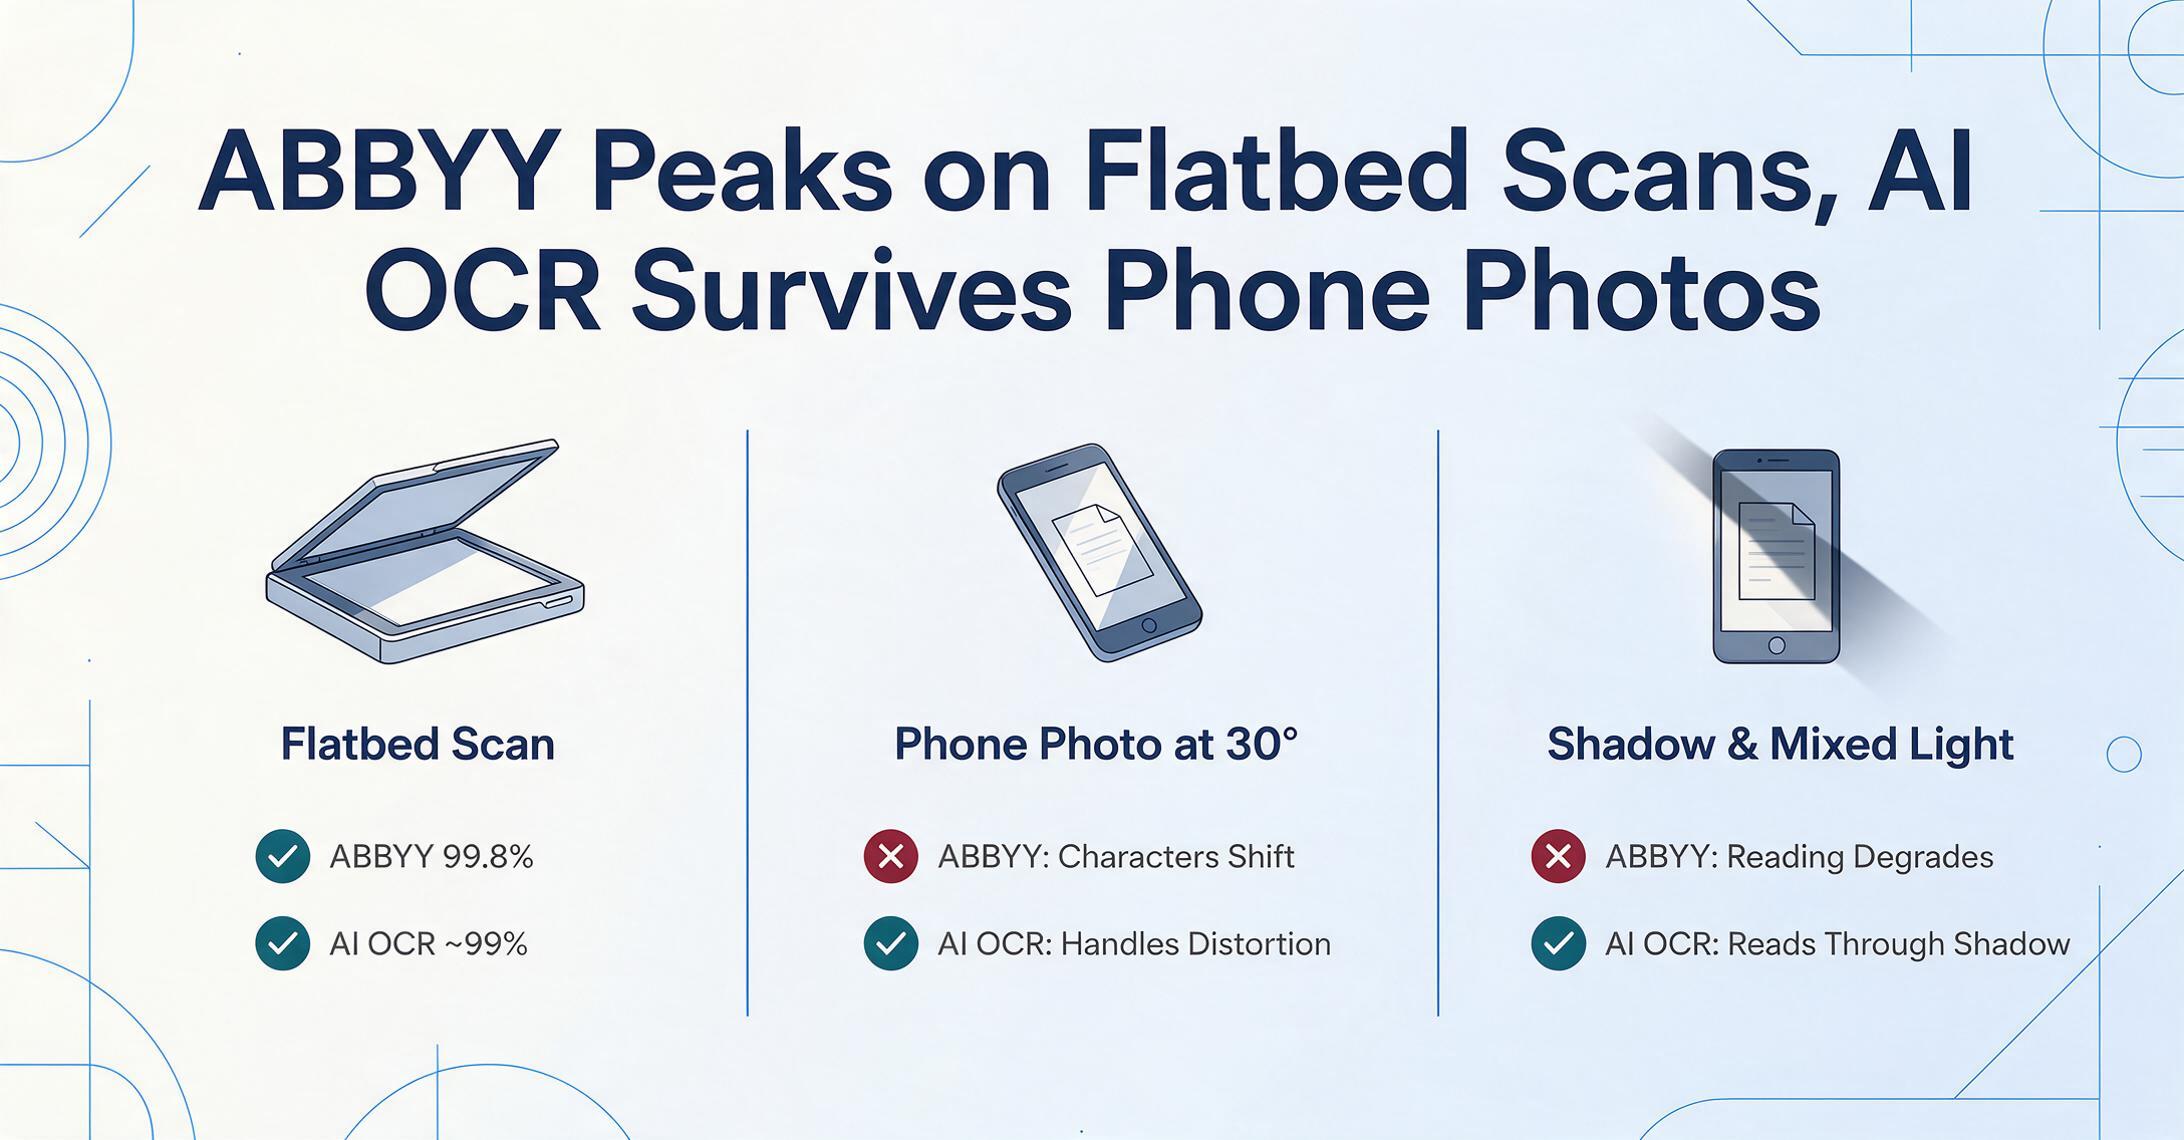
ABBYY FineReaderはフラットベッドスキャナ時代向けに設計されました。スキャナの出力は平坦で、照明が均一で、歪みがありません。文字パターンのマッチングに理想的です。前処理パイプラインはこれらの条件を前提としています。オフィス照明の下で30度の角度から撮影したスマホ写真をFineReaderに読み込ませると、結果は著しく低下します。透視歪みが文字の形状を変えます。不均一な照明が影のグラデーションを作り出します。これはABBYYに限ったことではありません。従来のOCRエンジンはすべてこの制限を共有しています。スキャナ品質の入力が、設計時の前提条件だったからです。
最新のAI OCRは、多様な画像品質でトレーニングされた視覚言語モデルを使用します。スマホ写真、ウェブカメラのキャプチャ、コピー、スクリーンショット、フラットスキャンなどです。これらのモデルは、3次元空間で物体を理解するため、透視歪みを処理できます。トレーニング中に何千もの影付き文書を見てきたため、影を通して読み取ることもできます。モバイルキャプチャで文書が届くチームにとって、この違いは決定的です。現場監督が現場ログを撮影し、従業員が経費の領収書を提出し、営業担当者がクライアント先で契約書をスキャンする。スキャナ品質の入力を必要とするツールは、フラットスキャンでどれほど正確でも、モバイルファーストのワークフローをサポートできません。
次元5:価格モデルの比較
正直な価格比較には、ABBYYのデスクトップ製品とエンタープライズプラットフォームを分けて考える必要があります。両者はまったく異なる規模の運用に対応しているからです。
ABBYY FineReaderデスクトップ版:Windows版は年間99ドル(Standard)または年間165ドル(Corporate)、Mac版は年間69ドル。PDF編集・OCRスイートのシングルシートライセンスです。抽出は手動で、各ファイルを開いてOCRを実行し、テーブル検出を確認してエクスポートする作業を繰り返します。
ABBYYエンタープライズ版(Vantage、FlexiCapture):価格はカスタム設定です。サードパーティの調達データによると、ミッドマーケット導入は年間40,000〜100,000ドル、エンタープライズ契約は年間100,000〜300,000ドルの範囲です。導入サービスは20,000〜150,000ドル追加されます。オンプレミス導入の年間保守費はライセンス費用の18〜22%です。
最新のAI OCR:無料ゲストティアあり。有料プランは月額9ドル(150ページ)から月額59ドル(1,500ページ)まで。従量課金は50ページで6ドルから。導入費用も年間保守費もありません。AI OCRプランには自動バッチ処理、セマンティック抽出、Excelマージが含まれており、ABBYYエコシステムではCorporateティアまたはエンタープライズ製品が必要な機能です。
本当の問いは「どちらが安いか」ではなく、「どの価格モデルがあなたの文書量と多様性に合うか」です。単一フォーマットで大量処理する運用なら、ABBYYのシート単位モデルの方が経済的かもしれません。複数ベンダー・中程度のボリュームのチームなら、AI OCRのページ単位モデルの方が直接コスト・運用負担の両面でほぼ確実に安くなります。
5つの次元をすべて見たところで、問いは「どちらが優れているか」ではなく「どちらがあなたの具体的な文書処理の現実に合うか」になります。
ABBYYが適しているケース
ABBYYは、文字レベルの精度とレイアウト忠実度が絶対条件となる特定のシナリオでは、依然として正しい選択肢です。
- 紙文書アーカイブのデジタル化。何千もの歴史的文書を、視覚的に正確に再現した検索可能なPDFに変換する作業。FineReaderのレイアウト保持と前処理は、まさにこの用途のために設計されています。
- 固定フォーマット・単一ベンダー処理。既知のベンダーからの安定した文書フォーマットであれば、初期のテンプレート投資に見合う価値があります。
- 多言語アーカイブ。ABBYYの201言語対応(CJK、アラビア語、キリル文字を含む)は、本当に他に類を見ません。
- オンプレミスのセキュリティ要件。防衛関連企業、政府機関、規制対象の金融機関は、FlexiCaptureまたはFineReader Serverをオンプレミスで展開できます。
- PDFライフサイクル管理。文書比較、墨消し、電子署名、PDF/AアーカイブをOCRと併用。FineReaderは完全なPDFスイートです。
最新のAI OCRが適している場合
「紙のデジタル化」から「多様なソースからの構造化データ抽出」へと文書処理のニーズが移行したチームの大半にとって、AI OCRはより良い選択肢です。
- 複数ベンダー・複数フォーマットの処理。 それぞれ独自のレイアウトを持つ数十のベンダーから文書を受け取る場合、AI OCRのテンプレート不要のアプローチは根本的により信頼性が高いです。ABBYYのテンプレートを壊すようなフォーマット変更も、セマンティック抽出には影響しません。
- スマホ撮影・モバイルキャプチャのワークフロー。 フィールドチーム、経費報告、現場検査など、AI OCRはモバイルで撮影されたデータでトレーニングされているため、これらの画像を確実に処理できます。レガシーOCRとAI OCRの技術格差が最も大きいのがこの領域です。
- セルフサービス型のデータ抽出。 インストール不要、テンプレート設定不要、トレーニングコース不要。このツールは、IT管理者ではなく、データを必要とする人向けに設計されています。
- 構造化出力へのバッチ抽出。 複数の文書をアップロードすると、整列された1つのスプレッドシートが得られます。すべてのファイルが、ユーザーが定義した列名と同じ構造に入力されます。この機能はAI OCRでは標準ですが、ABBYYの製品ラインではCorporateティアまたはエンタープライズ製品が必要です。
- 1つのバッチ内での複数文書タイプの混在。 請求書、発注書、銀行取引明細書をまとめて処理できます。個別のテンプレートや実行は不要です。AIが各文書のタイプを識別し、関連するフィールドを統合テーブルに抽出します。
結論
正直な答えは、単一の推奨ではなく、文書構成に基づく判断フレームワークです。 ABBYYと最新のAI OCRは、異なる処理環境向けに最適化された並行技術です。適切な選択は、次の3つの質問によって決まります。
1. 処理する文書レイアウトは何種類ありますか?
安定したフォーマットが1〜2種類で高ボリュームの場合 → ABBYYのテンプレートアプローチが有効です。多種多様なフォーマットが数十〜数百種類ある場合 → AI OCRのテンプレート不要のアプローチの方が信頼性が高く、メンテナンスコストも抑えられます。
2. 文書はどこから届きますか?
照明が管理されたフラットベッドスキャン → ABBYYが最大のパフォーマンスを発揮します。スマホ撮影、照明が不安定な環境での撮影、スクリーンショット → AI OCRが自然に処理します。
3. 抽出したデータから何が必要ですか?
視覚的な再現性が正確な検索可能なPDF → ABBYYが優れています。1つのテーブルに統合された構造化スプレッドシートデータ → AI OCR(当初からこの目的で設計されています)が正しいツールです。
多くの組織にとって、最適な構成はハイブリッドです。レイアウトの忠実性が重要なアーカイブ品質のデジタル化にはABBYY FineReaderを使用し、請求書、フォーム、領収書からの日常的なデータ抽出には最新のAI OCRを使用します。特に、それらの文書が複数のソースからスマホ経由で届く場合はなおさらです。主要なAI OCRツールを相互に比較する準備ができたら、最高のAI OCRソフトウェアまとめで、価格、精度、適合性の観点から8つのツールを紹介しています。
「すべてをスキャンする」から「必要なデータを抽出する」への移行は、ビジネスにおける文書の使い方における根本的な変化です。ABBYYは前者の世界に非常に優れています。現代のAI OCRは後者に特化して設計されています。正しい問いはどちらのツールが優れているかではなく、実際に必要な文書処理の種類です。
よくある質問
AI OCRは、クリーンな印刷文書においてABBYYの精度に匹敵できますか?
標準的なフォントのクリーンなスキャン文書では、最新のAI OCRは約99%の精度を達成し、ABBYYの約99.8%と比較して、その差は存在するものの僅かです。AI OCRがABBYYを上回ることが多いのは、構造的な精度、つまり罫線のない複雑なレイアウトにおけるテーブル構造、列の関係性、フィールドの意味を正しく識別する点です。スマホでの撮影、低品質のスキャン、または複数のフォントが混在する文書では、AI OCRは多様な画質でトレーニングされたビジョンモデルにより、一般的にABBYYを上回る性能を発揮します。
ABBYY FineReaderにはAI搭載機能は含まれていますか?
ABBYYは、文字認識とレイアウト解析に機械学習を使用しているため、そのOCRエンジンをAIベースと説明しています。しかし、これは最新のAI OCRとは異なります。ABBYYのAIは、文字マッチングと前処理パイプラインの改善に適用されており、意味理解、テンプレート不要の抽出、または文脈に基づくデータ解釈を提供するものではありません。この違いについては、OCRとAI抽出の比較で詳しく解説しています。
エンタープライズ向け文書処理において、ABBYY FlexiCaptureをAI OCRに置き換えることはできますか?
ご要件によります。請求書、領収書、発注書などのビジネス文書、特に多様なソースからのデータ抽出には、最新のAI OCRプラットフォームが、コストとセットアップ時間を大幅に抑えてFlexiCaptureを置き換えることができます。ただし、ワークフローにネイティブなSAP/Oracle統合、文書分類ワークフロー、または厳格なデータ所在地管理を伴うオンプレミス専用処理が必要な場合は、ABBYYのエンタープライズ製品が引き続き適切な選択肢です。
ABBYY FineReaderは手書き文字認識に対応していますか?
ABBYY FineReaderは限定的な手書き文字認識機能を備えており、良好な条件下での整った孤立した手書き文字では約95%の精度と報告されています。筆記体の手書き文字では、精度は約91.7%に低下します。ABBYYはまた、エンタープライズ製品を通じてICR(Intelligent Character Recognition)もサポートしています。しかし、印刷と手書きが混在する文書や乱雑な手書き文字の場合、最新のAI OCRツールはビジョン言語モデルを使用して文字レベルのパターンマッチングではなく文脈的に解釈するため、一般的に高く一貫した精度を達成します。
ABBYY FineReaderはクラウドサービスとして利用できますか?
ABBYY FineReader PDFはデスクトップアプリケーションであり、クラウド版やブラウザ版は存在しません。ABBYYは、クラウドOCR機能を別のエンタープライズ製品(APIベースで別途料金のABBYY Cloud OCR SDK、カスタムエンタープライズ価格のクラウドベースIDPプラットフォームであるABBYY Vantage)を通じて提供しています。デスクトップ版のFineReaderにはブラウザインターフェースもREST APIもありません。対照的に、最新のAI OCRツールは設計上クラウドネイティブであり、インストール不要でどのブラウザ、どのデバイスでも動作し、有料プランではREST APIも含まれます。
AI OCRを自社のドキュメントで試す
ABBYYとAI OCRのどちらを選ぶかを決める最も確実な方法は、比較記事を読むことではなく、実際のドキュメントで両方のアプローチをテストすることです。実際のドキュメント構成を反映した請求書、領収書、フォームのバッチをアップロードしてください。最新のセマンティック抽出が、罫線のないテーブル、スマホ撮影の写真、複数形式のバッチにどう対応するかを確認できます。出力構造を、現在ABBYYで得ている結果と比較してみてください。精度だけでなく、チームがまだ行わなければならない後処理の量も比較の対象です。
無料ゲストモード — アカウント不要、クレジットカードも不要です。