ABBYY FineReader vs OCR de IA moderno:
Precisão legada vs nova flexibilidade
O ABBYY FineReader é o motor de reconhecimento óptico de caracteres mais preciso já criado para documentos impressos e limpos. O OCR de IA moderno — construído sobre modelos de visão-linguagem em vez de algoritmos de correspondência de caracteres — é a tecnologia de extração de dados de documentos mais flexível disponível hoje. Nenhuma das afirmações contradiz a outra, porque não se trata de produtos concorrentes voltados para o mesmo problema. São ferramentas diferentes para tarefas diferentes de processamento de documentos, e escolher entre elas começa por entender o tipo de documento que se lida de fato.
Principais conclusões
- A precisão de 99,8% de caracteres do ABBYY é real e incomparável — mas um avaliador do Capterra encontrou “muitas tabelas óbvias não detectadas”, porque ler cada letra corretamente ainda não diz quais números pertencem a qual coluna da planilha.
- O benchmark de precisão pelo qual todo fornecedor de OCR compete esconde um custo permanente: alguém precisa reconstruir modelos toda vez que um fornecedor redesenha a fatura, e nas próprias avaliações do ABBYY no G2, “mudanças simples exigem suporte de TI”.
- Apenas três perguntas importam — quantas variantes de layout você processa, se os documentos chegam por scanner ou celular, e se você precisa de PDFs pesquisáveis ou de uma planilha estruturada — e o ABBYY e o OCR de IA vencem em respostas opostas para cada uma.
Comparação Rápida
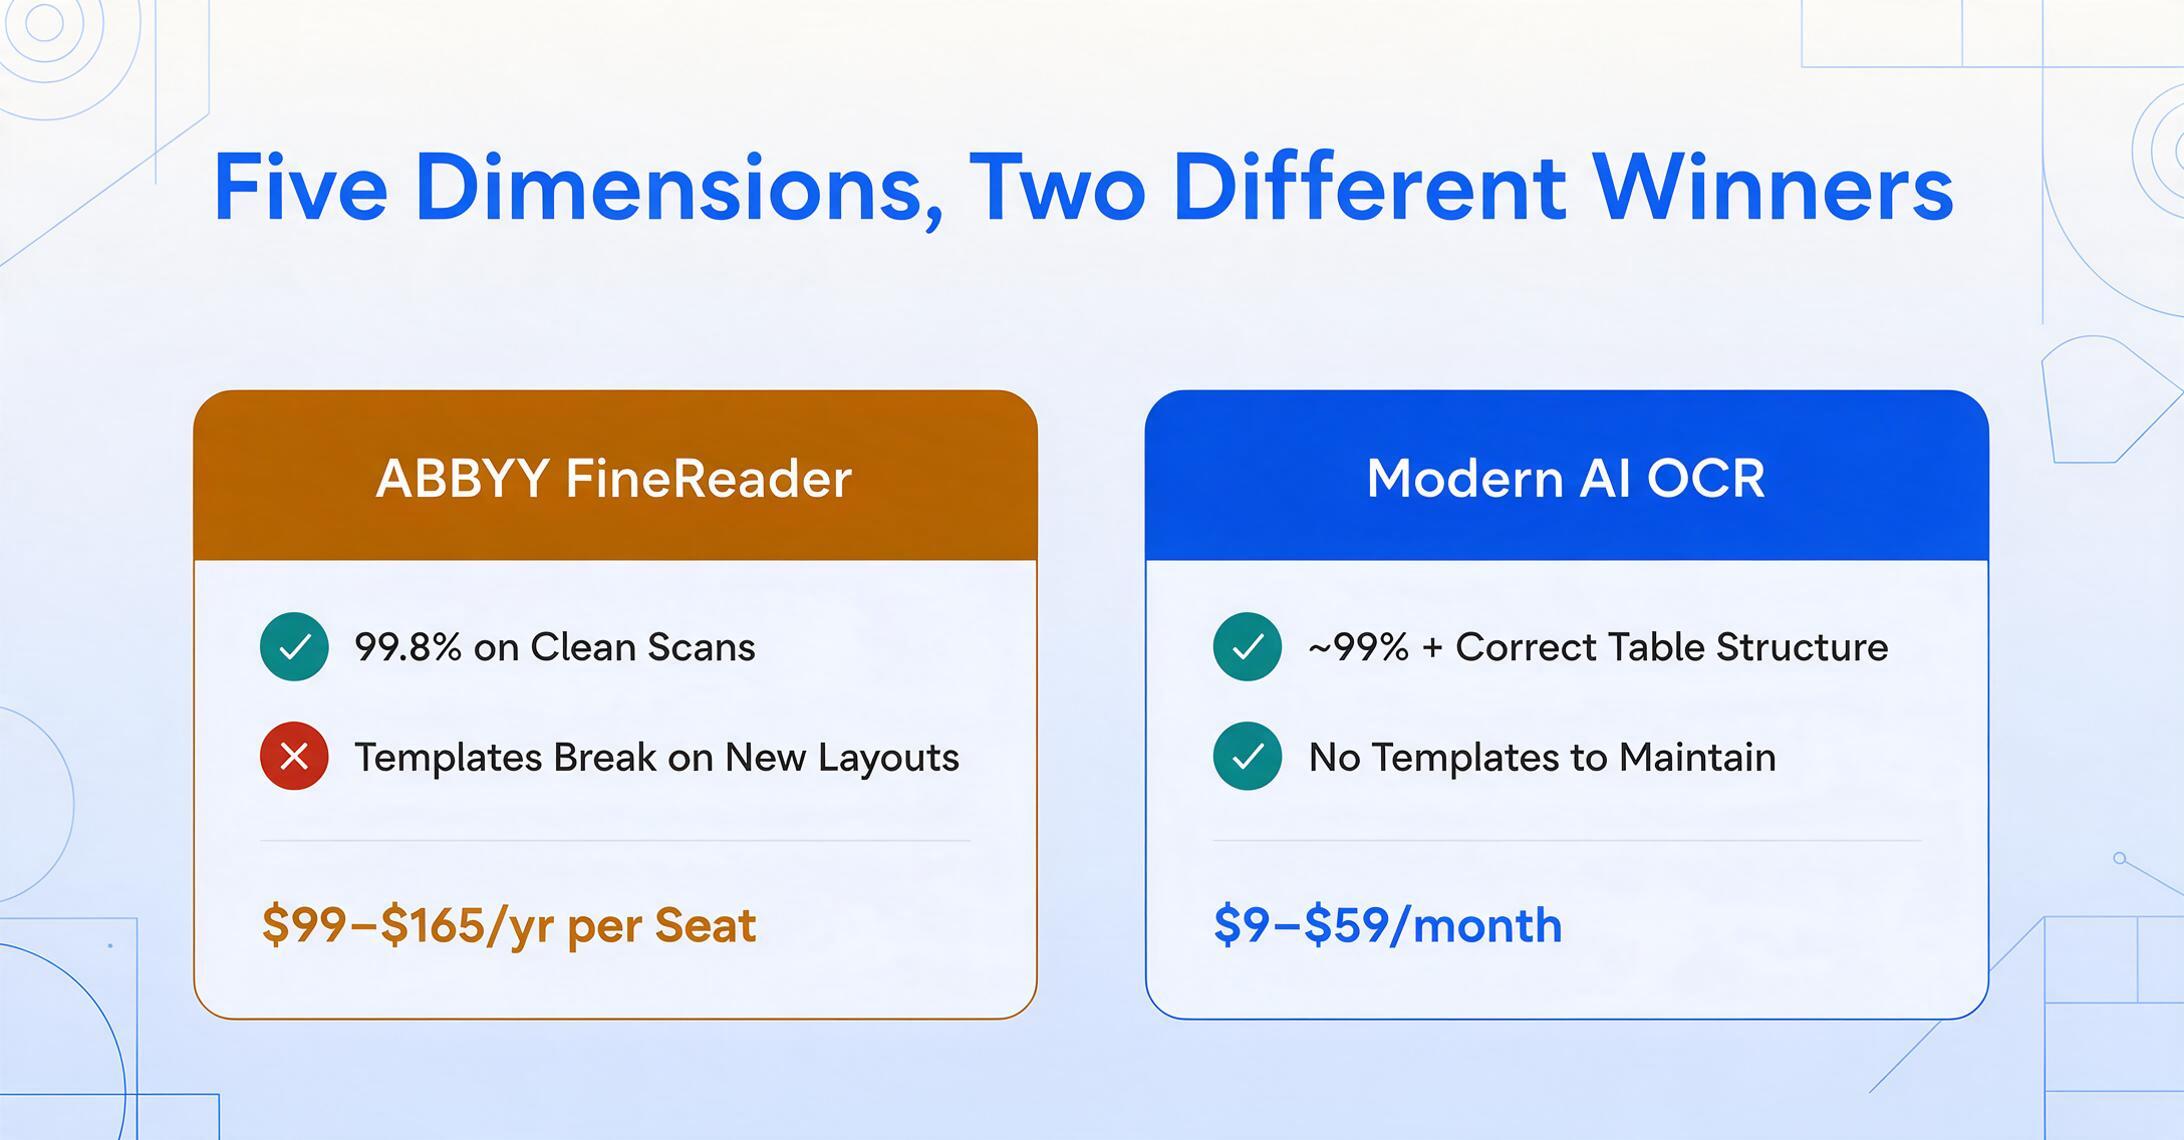
A tabela abaixo resume como o ABBYY FineReader e as ferramentas modernas de OCR com IA se comparam nas cinco dimensões mais importantes ao escolher uma abordagem de extração de documentos. Cada dimensão é detalhada nas seções a seguir.
| Dimensão | ABBYY FineReader | OCR com IA Moderno |
|---|---|---|
| Precisão em documentos de formato fixo | 99,8% em documentos digitalizados limpos — precisão em nível de caractere líder do setor | ~99% em texto impresso — alcança a precisão de caracteres, supera na estrutura de tabelas |
| Flexibilidade com formatos variados | OCR por modelo/zona — cada layout exige configuração; mudanças de formato quebram o modelo | Sem modelos — adapta-se a qualquer layout entendendo o significado, não as posições dos pixels |
| Tempo de configuração e ajuste | Instalação desktop + treinamento de modelo por formato; implantações corporativas levam semanas | Baseado em navegador, configuração zero — envie um arquivo, nomeie suas colunas, veja os resultados em segundos |
| Tratamento de foto de celular vs digitalização em mesa | Projetado para saída de scanner de mesa — tem dificuldades com perspectiva, sombra, pouca luz | Projetado para captura móvel — lida com distorção, iluminação irregular, fundos variados |
| Modelo de preços | $99–$165/ano por licença (desktop); $40K–$300K+/ano para plataformas corporativas | Nível gratuito para convidados; planos pagos $9–$59/mês; pagamento conforme o uso a partir de $6/50 páginas |
Cada uma dessas dimensões conta uma parte diferente da história. A que mais importa depende inteiramente dos documentos que você processa todos os dias.
Dimensão 1: Precisão em Documentos de Formato Fixo
O ABBYY FineReader continua sendo o padrão ouro para precisão em nível de caractere em documentos limpos, estruturados e de formato fixo, e essa liderança não é imaginária. Testes independentes relatam consistentemente 99,8% de precisão em texto impresso em documentos bem digitalizados. Para contextos em que um único caractere lido incorretamente tem consequências — digitalização de documentos jurídicos, preservação de arquivos, formulários governamentais — essa margem importa.
O ABBYY alcança isso por meio de um pipeline de reconhecimento maduro — correção de inclinação, otimização de contraste, referência cruzada entre múltiplos mecanismos — refinado ao longo de décadas. Seu suporte a 201 idiomas, incluindo caracteres cirílicos, árabes, CJK e escritas históricas, é incomparável no mercado de OCR para desktop. A análise do PCMag Editors' Choice observa que o FineReader "continua sendo a ferramenta de OCR mais precisa que já testamos" — uma reputação conquistada por meio de refinamento contínuo.
Mas há uma nuance importante. A precisão do ABBYY é em nível de caractere: ele lê as letras e os números corretos. Nem sempre compreende a estrutura que esses caracteres formam. Uma análise do Capterra captura isso: "Muitas tabelas óbvias não são detectadas pelo ABBYY na conversão automática, especialmente aquelas sem linhas visíveis." Os caracteres estão corretos. A estrutura da tabela está errada. O utilizador ainda precisa remontar os dados manualmente.
O OCR com IA moderno usa modelos de visão e linguagem que analisam a imagem completa do documento de forma holística — lendo tanto os caracteres quanto as relações espaciais entre eles. Em texto impresso limpo, a diferença de precisão em nível de caractere em relação ao ABBYY é pequena (aproximadamente 99% vs 99,8%). Mas o OCR com IA se destaca na precisão estrutural: identifica corretamente quais números pertencem a qual coluna e distingue totais de faturas de subtotais, mesmo em tabelas sem bordas ou com células mescladas.
Conclusão: Em precisão de nível de caractere para documentos digitalizados limpos, o ABBYY ainda mantém uma pequena vantagem. Em precisão estrutural — colocar os dados nas colunas corretas — o OCR com IA frequentemente se sai melhor, especialmente em documentos sem bordas explícitas.
Dimensão 2: Flexibilidade com Formatos Variados
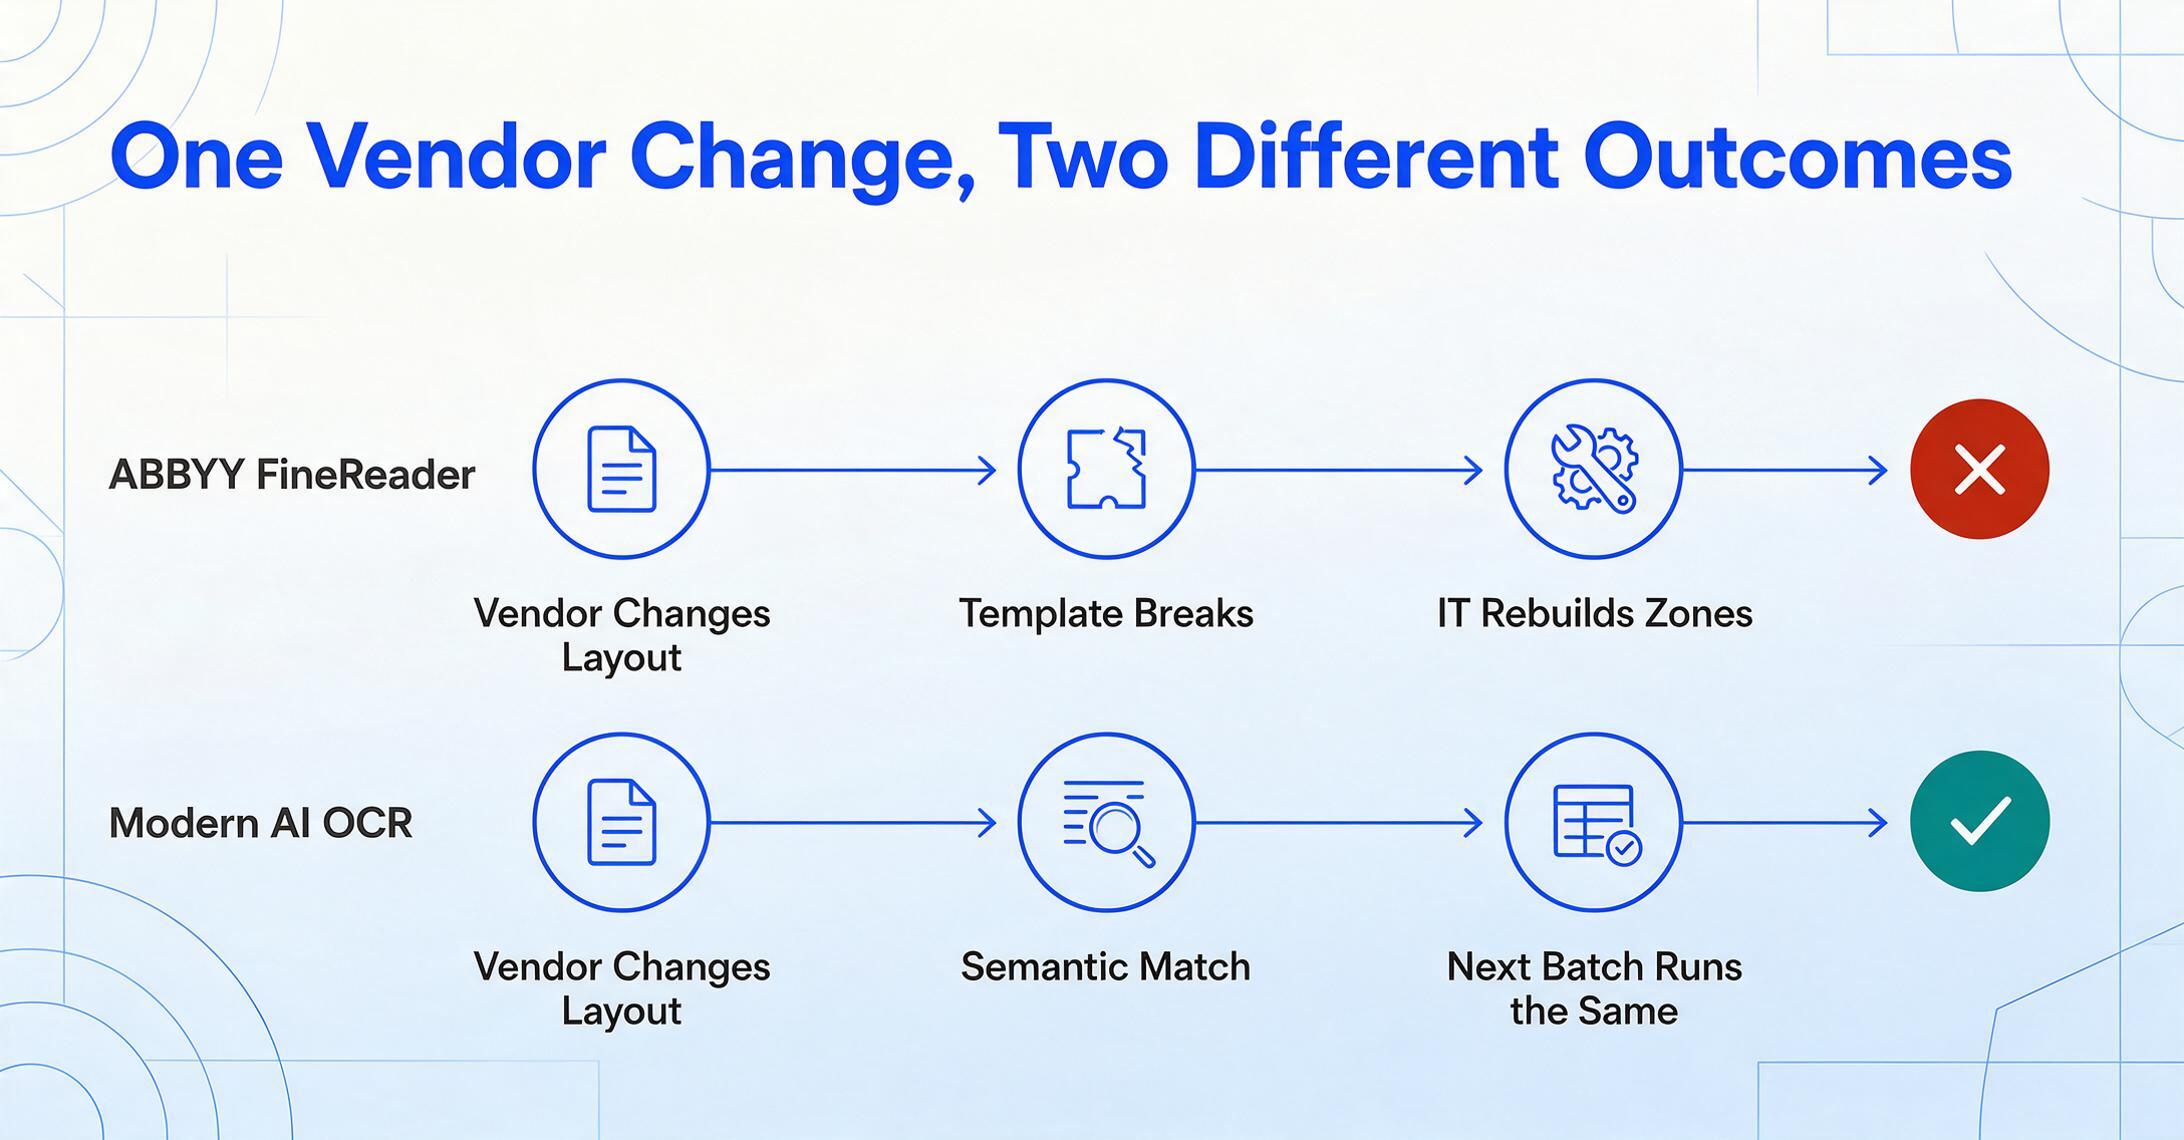
É aqui que os dois paradigmas divergem com mais nitidez. A dependência de modelos do ABBYY é sua maior limitação em um mundo com múltiplos fornecedores e múltiplos formatos. A abordagem semântica do AI OCR foi construída desde o início para lidar exatamente com esse problema.
O mecanismo de extração do ABBYY (FlexiCapture e Vantage) depende de modelos FlexiLayout: é preciso definir zonas, âncoras, coordenadas de campos e regras de extração para cada layout único. Quando um fornecedor atualiza o design da fatura ou renomeia os cabeçalhos das colunas, o modelo quebra. Alguém com conhecimento técnico precisa abrir o FlexiLayout Studio e ajustar as definições de zona. Para equipes que processam documentos de dezenas de fornecedores, isso cria uma rotina permanente de manutenção. As avaliações do ABBYY no G2 confirmam isso: "Mudanças simples exigem suporte de TI."
O AI OCR moderno elimina esse problema por completo. Ele usa extração semântica: você digita os nomes das colunas desejadas (Invoice Number, Date, Total), e a IA encontra os valores correspondentes entendendo o que esses termos significam na página — não combinando coordenadas de pixels de um modelo predefinido. Os nomes das colunas que você insere se tornam os cabeçalhos da sua planilha de saída. Isso funciona de forma idêntica, seja o documento uma fatura, um pedido de compra ou um extrato bancário.
A consequência prática: quando um fornecedor altera o formato, sua extração continua funcionando. Nenhum modelo para reconstruir, nenhuma zona para redesenhar, nenhum chamado de TI para abrir. O próximo lote é processado da mesma forma que o anterior.
Dimensão 3: Tempo de configuração e instalação
O tempo entre a decisão e o primeiro resultado de extração difere em ordens de magnitude — e essa diferença reflete uma diferença estrutural na forma como as duas abordagens são construídas.
ABBYY FineReader desktop: download e instalação (~30 minutos). Para processamento em lote com modelos (Corporate ou FlexiCapture): pelo menos meio dia por formato de documento para criar e validar modelos. Para implantações empresariais do Vantage ou FlexiCapture: 2 a 12 semanas com parceiros de implementação, mais $20,000–$150,000 em serviços.
OCR com IA moderno: abra um navegador. Envie um arquivo. Digite as colunas desejadas. Veja os dados extraídos. Tempo total decorrido: menos de 30 segundos. Sem instalação, sem treinamento de modelo, sem consultor. A ferramenta foi projetada para quem precisa dos dados — não para um administrador de TI configurando uma plataforma.
Essa diferença de custo se conecta diretamente à próxima dimensão, porque o tipo de documento processado determina se é necessário pré-processamento de nível desktop ou se é possível trabalhar diretamente com imagens capturadas por celular.
Dimensão 4: Fotos de celular vs digitalizações em mesa
A diferença menos discutida entre OCR legado e OCR com IA moderno é como eles lidam com a origem da imagem — e isso frequentemente determina qual ferramenta realmente funciona na prática.
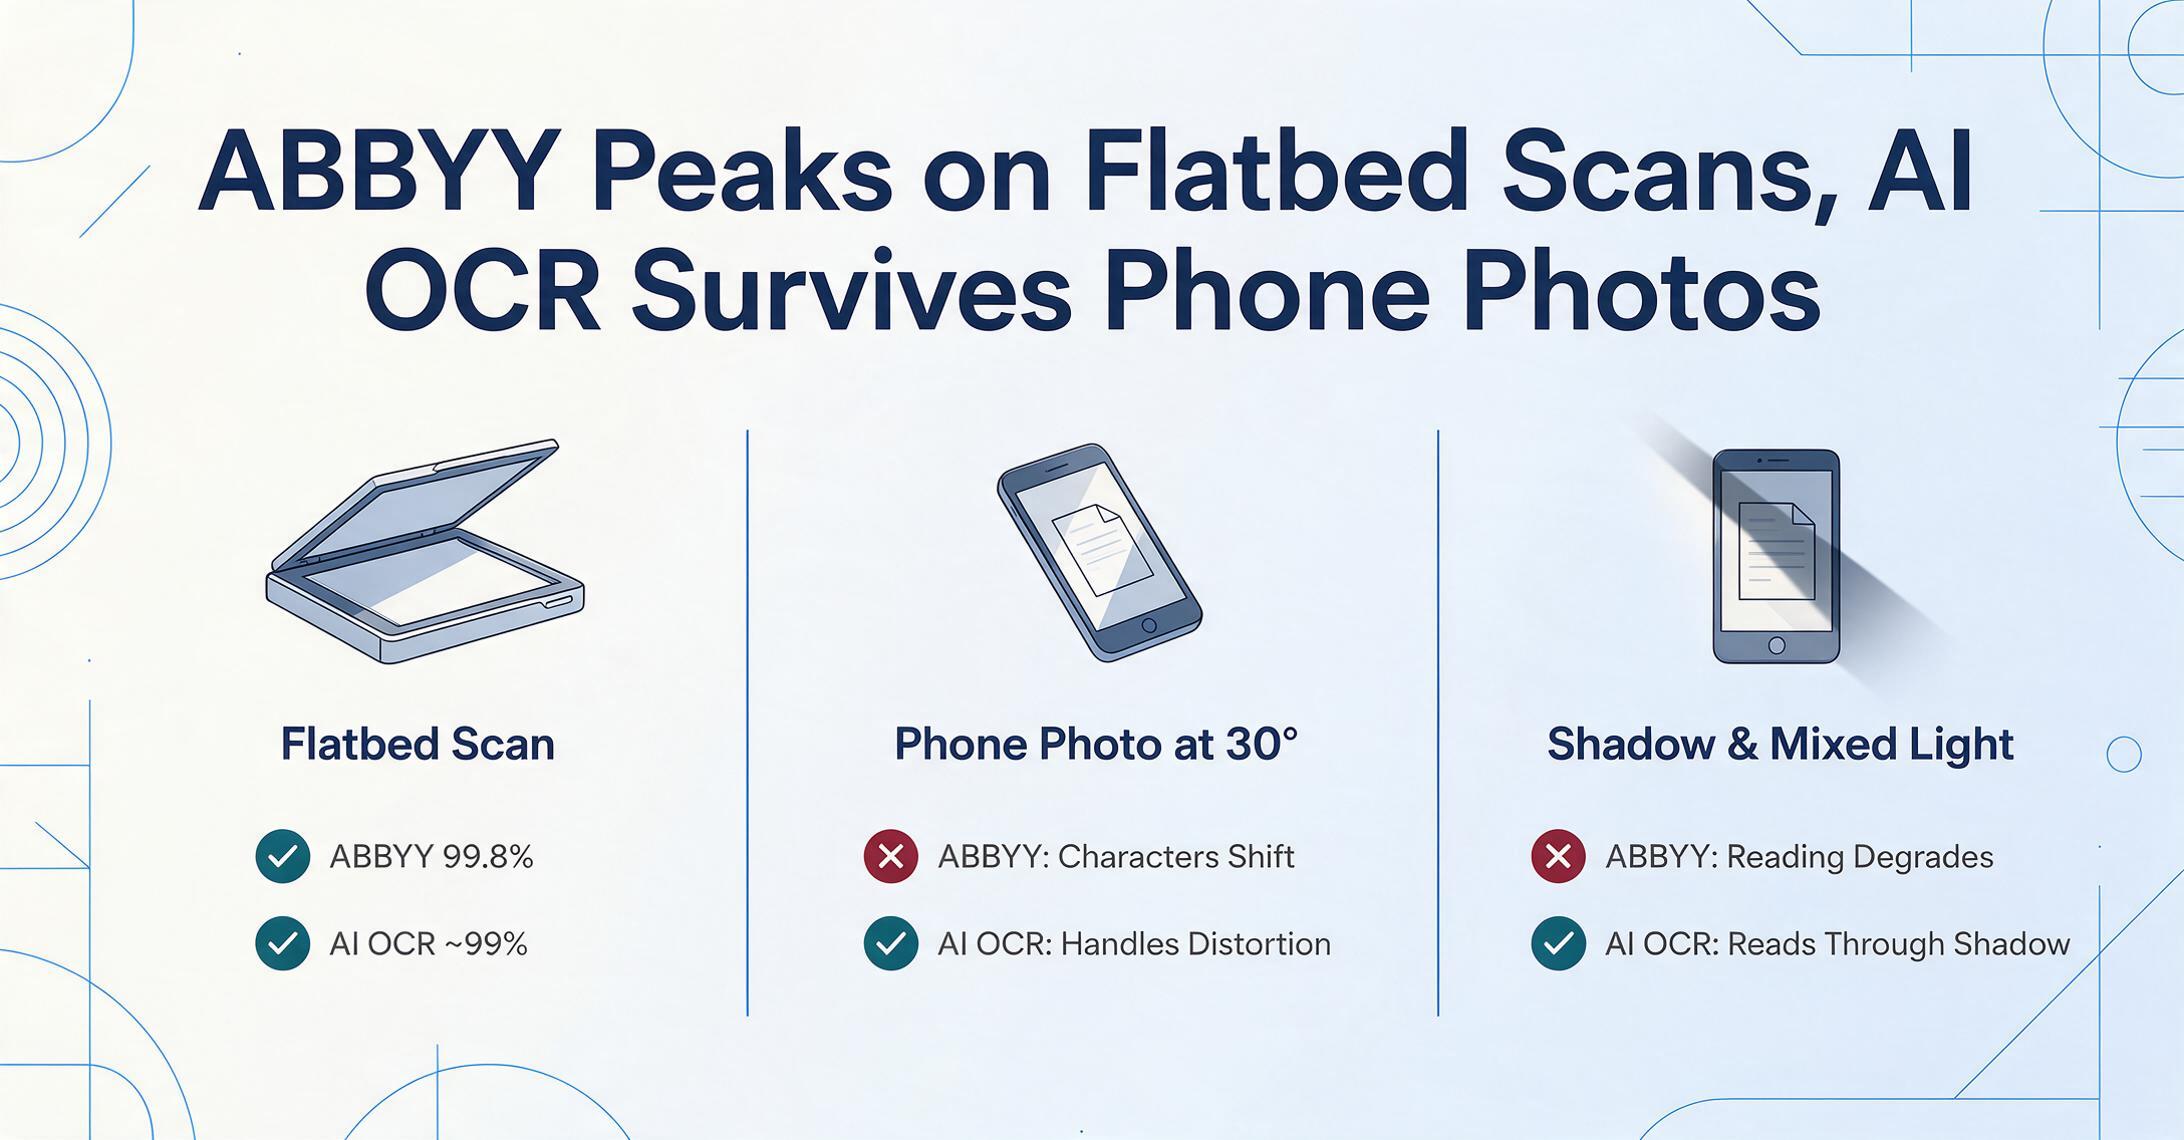
O ABBYY FineReader foi projetado para a era dos scanners de mesa. A saída do scanner é plana, uniformemente iluminada e sem distorção — ideal para correspondência de padrões de caracteres. O pipeline de pré-processamento assume essas condições. Alimente o FineReader com uma foto de celular tirada a um ângulo de 30 graus sob iluminação de escritório, e os resultados se degradam visivelmente. A distorção de perspectiva altera as formas dos caracteres. A iluminação irregular cria gradientes de sombra. Isso não é exclusivo do ABBYY — todo motor de OCR tradicional compartilha essa limitação porque a entrada com qualidade de scanner era a premissa básica quando foram arquitetados.
O OCR com IA moderno usa modelos de visão-linguagem treinados com diversas qualidades de imagem: fotos de celular, capturas de webcam, fotocópias e capturas de tela, além de digitalizações planas. Esses modelos lidam com distorção de perspectiva porque compreendem objetos no espaço tridimensional. Eles leem através de sombras porque viram milhares de documentos sombreados durante o treinamento. Para equipes cujos documentos chegam via captura móvel — inspetores de campo fotografando registros de obra, funcionários enviando recibos de despesas, representantes de vendas digitalizando contratos em locais de clientes — essa diferença é decisiva. Uma ferramenta que exige entrada com qualidade de scanner não pode dar suporte a um fluxo de trabalho mobile-first, independentemente de sua precisão em digitalizações planas.
Dimensão 5: Comparação de Modelos de Preços
Uma comparação honesta de preços exige separar os produtos desktop da ABBYY de suas plataformas empresariais — eles atendem escalas de operação completamente diferentes.
ABBYY FineReader desktop: $99/ano (Standard) ou $165/ano (Corporate) para Windows, $69/ano para Mac. Licenças por assento para um pacote de edição de PDF e OCR. A extração é manual: abrir cada arquivo, executar OCR, verificar a detecção de tabelas, exportar, repetir.
ABBYY empresarial (Vantage, FlexiCapture): preços personalizados. Dados de compras de terceiros indicam implantações de médio porte em $40.000–$100.000 por ano, com negócios empresariais variando de $100.000 a $300.000 por ano. Serviços de implementação acrescentam $20.000–$150.000. A manutenção anual para implantações on-premise fica entre 18–22% do custo da licença.
OCR com IA moderno: nível gratuito para convidados; planos pagos de $9/mês (150 páginas) a $59/mês (1.500 páginas); pagamento conforme o uso a partir de $6 por 50 páginas. Sem taxas de implementação, sem manutenção anual. O plano de OCR com IA inclui processamento em lote automatizado, extração semântica e mesclagem no Excel — recursos que exigem o nível Corporate ou produtos empresariais no ecossistema da ABBYY.
A verdadeira questão não é "qual custa menos", mas "qual modelo de preços corresponde ao seu volume e variedade de documentos". Uma operação de formato único e alto volume pode considerar o modelo por assento da ABBYY mais econômico. Uma equipe com vários fornecedores e volume moderado quase certamente achará o modelo por página do OCR com IA mais barato tanto em custo direto quanto em sobrecarga operacional.
Com todas as cinco dimensões apresentadas, a questão deixa de ser "qual é melhor" e passa a ser "qual se encaixa na sua realidade específica de processamento de documentos".
Quando a ABBYY Faz Mais Sentido
A ABBYY continua sendo a escolha certa para cenários específicos em que a precisão em nível de caractere e a fidelidade de layout são inegociáveis.
- Digitalização de arquivos em papel. Converter milhares de documentos históricos em PDFs pesquisáveis com reprodução visual exata — a preservação de layout e o pré-processamento do FineReader são feitos sob medida para isso.
- Processamento de formato fixo e fornecedor único. Formatos de documentos estáveis de fornecedores conhecidos tornam o investimento inicial em modelos vantajoso.
- Arquivos multilíngues. O suporte a 201 idiomas da ABBYY, incluindo CJK, árabe e cirílico, é genuinamente incomparável.
- Requisitos de segurança on-premise. Empreiteiras de defesa, agências governamentais e instituições financeiras reguladas podem implantar o FlexiCapture ou o FineReader Server on-premise.
- Gerenciamento do ciclo de vida de PDF. Comparação de documentos, redação, assinaturas digitais e arquivamento em PDF/A junto com OCR — o FineReader é um pacote completo de PDF.
Quando o OCR com IA Moderno Faz Mais Sentido
O OCR com IA é a melhor escolha para a maioria das equipes cujas necessidades de processamento de documentos mudaram de "digitalizar papel" para "extrair dados estruturados de fontes variadas".
- Processamento multivendor e multiformato. Quando você recebe documentos de dezenas de fornecedores, cada um com seu próprio layout, a abordagem sem modelo do OCR com IA é fundamentalmente mais confiável. Mudanças de formato que quebrariam um modelo do ABBYY são invisíveis para a extração semântica.
- Fluxos de captura por foto de celular e dispositivos móveis. Equipes de campo, relatórios de despesas, inspeções em locais — o OCR com IA lida com essas imagens de forma confiável porque foi treinado com dados capturados por dispositivos móveis. Esta é a dimensão em que a lacuna tecnológica entre OCR legado e OCR com IA é mais ampla.
- Extração de dados autônoma. Sem instalação, sem configuração de modelo, sem cursos de treinamento. A ferramenta foi projetada para quem precisa dos dados, não para administradores de TI.
- Extração em lote para saída estruturada. Envie vários documentos e obtenha uma planilha alinhada. Cada arquivo preenche a mesma estrutura definida pelos nomes das colunas do usuário. Esse recurso é padrão no OCR com IA, mas exige o nível Corporate ou um produto empresarial na linha da ABBYY.
- Tipos de documentos mistos em um único lote. Faturas, pedidos de compra e extratos bancários juntos — sem necessidade de modelos ou execuções separadas. A IA identifica o tipo de cada documento e extrai os campos relevantes para uma tabela unificada.
O Veredito
A resposta honesta é uma estrutura de decisão baseada no seu mix de documentos, não uma recomendação única. ABBYY e o OCR com IA moderno são tecnologias paralelas otimizadas para realidades de processamento diferentes. A escolha certa depende de três perguntas:
1. Quantos layouts de documentos diferentes você processa?
Um ou dois formatos estáveis com alto volume → a abordagem de modelo do ABBYY funciona bem. Dezenas ou centenas de formatos variados → a abordagem sem modelo do OCR com IA é mais confiável e mais barata de manter.
2. De onde vêm seus documentos?
Digitalizações em mesa plana com iluminação controlada → o ABBYY atinge seu melhor desempenho. Fotos de celular, capturas com iluminação mista e capturas de tela → o OCR com IA lida com isso naturalmente.
3. O que você precisa dos dados extraídos?
PDFs pesquisáveis com reprodução visual exata → o ABBYY se destaca. Dados estruturados de planilha mesclados em uma única tabela → o OCR com IA (projetado para isso desde o início) é a ferramenta correta.
Para muitas organizações, a configuração ideal é híbrida: use o ABBYY FineReader para digitalização com qualidade de arquivo, onde a fidelidade do layout importa, e use o OCR com IA moderno para a extração diária de dados de faturas, formulários e recibos — especialmente quando esses documentos chegam por celular de várias fontes. Se você está pronto para comparar as principais ferramentas de OCR com IA entre si, nossa seleção das melhores ferramentas de OCR com IA cobre oito delas por preço, precisão e adequação.
A mudança de "digitalizar tudo" para "extrair os dados de que você precisa" é uma transformação fundamental na forma como os documentos são usados nos negócios. O ABBYY atende excepcionalmente bem o primeiro mundo. O OCR com IA moderno foi criado especificamente para o segundo. A pergunta certa não é qual ferramenta é melhor — é qual tipo de processamento de documentos você realmente precisa.
Perguntas Frequentes
O OCR com IA consegue igualar a precisão do ABBYY em documentos impressos e limpos?
Em documentos digitalizados limpos com fontes padrão, o OCR moderno com IA alcança cerca de 99% de precisão, em comparação com os ~99,8% do ABBYY — a diferença existe, mas é pequena. Onde o OCR com IA frequentemente supera o ABBYY é na precisão estrutural: identificar corretamente a estrutura de tabelas, as relações entre colunas e a semântica dos campos em layouts sem bordas ou complexos. Em fotos de celular, digitalizações de baixa qualidade ou documentos com fontes mistas, o OCR com IA geralmente supera o ABBYY porque seus modelos de visão foram treinados com imagens de qualidades diversas.
O ABBYY FineReader inclui recursos com IA?
A ABBYY descreve seu mecanismo de OCR como baseado em IA porque utiliza aprendizado de máquina para reconhecimento de caracteres e análise de layout. No entanto, isso não é o mesmo que o OCR moderno com IA. A IA da ABBYY é aplicada para melhorar o pipeline de correspondência de caracteres e pré-processamento — ela não oferece compreensão semântica, extração sem modelo nem interpretação contextual de dados. A distinção é discutida em profundidade na nossa comparação entre OCR e extração com IA.
Posso substituir o ABBYY FlexiCapture por OCR com IA no processamento de documentos corporativos?
Depende dos seus requisitos. Para extração de dados de faturas, recibos, pedidos de compra e documentos comerciais semelhantes — especialmente de fontes variadas — plataformas modernas de OCR com IA podem substituir o FlexiCapture por uma fração do custo e do tempo de configuração. No entanto, se o seu fluxo de trabalho exigir integração nativa com SAP/Oracle, fluxos de classificação de documentos ou processamento exclusivamente local com controles rigorosos de residência de dados, os produtos corporativos da ABBYY continuam sendo a escolha adequada.
O ABBYY FineReader reconhece escrita à mão?
O ABBYY FineReader tem capacidades limitadas de reconhecimento de escrita à mão, relatando cerca de 95% de precisão em escrita à mão isolada e bem feita, em boas condições. Em escrita cursiva, a precisão cai para aproximadamente 91,7%. A ABBYY também oferece suporte a ICR (Intelligent Character Recognition) por meio de seus produtos corporativos. No entanto, para documentos com escrita impressa e manuscrita misturadas ou escrita à mão difícil de ler, as ferramentas modernas de OCR com IA que usam modelos de visão-linguagem geralmente alcançam precisão maior e mais consistente, porque interpretam a escrita à mão de forma contextual, em vez de por correspondência de padrões em nível de caractere.
O ABBYY FineReader está disponível como serviço em nuvem?
O ABBYY FineReader PDF é um aplicativo para desktop — não há versão em nuvem nem para navegador. A ABBYY oferece recursos de OCR em nuvem por meio de produtos corporativos separados: o ABBYY Cloud OCR SDK (baseado em API, com preço separado) e o ABBYY Vantage (plataforma IDP baseada em nuvem, com preços corporativos personalizados). O FineReader para desktop não tem interface de navegador nem API REST. As ferramentas modernas de OCR com IA, em contrapartida, são nativas da nuvem por concepção — funcionam em qualquer navegador, em qualquer dispositivo, sem instalação, e incluem APIs REST nos planos pagos.
Experimente o OCR com IA nos Seus Próprios Documentos
A maneira mais confiável de decidir entre o ABBYY e o OCR com IA não é ler comparações — é testar as duas abordagens nos seus documentos reais. Envie um lote de faturas, recibos ou formulários que representem a sua mistura real de documentos. Veja como a extração semântica moderna lida com tabelas sem bordas, fotos de celular e lotes em vários formatos. Compare a estrutura de saída com o que você obtém atualmente do ABBYY — não apenas a precisão, mas quanto pós-processamento a sua equipe ainda precisa fazer.
Modo visitante gratuito — sem conta, sem cartão de crédito.