ABBYY FineReader vs OCR de IA moderno:
precisión heredada frente a nueva flexibilidad
ABBYY FineReader es el motor de reconocimiento óptico de caracteres más preciso jamás creado para documentos impresos limpios. El OCR de IA moderno — basado en modelos de visión y lenguaje en lugar de algoritmos de coincidencia de caracteres — es la tecnología de extracción de datos de documentos más flexible disponible hoy. Ninguna afirmación contradice a la otra, porque no son productos competidores orientados al mismo problema. Son herramientas distintas para tareas de procesamiento de documentos diferentes, y elegir entre ellas comienza por entender qué tipo de documentos maneja realmente.
Conclusiones clave
- La precisión de caracteres del 99,8 % de ABBYY es real e inigualable — pero un revisor de Capterra encontró «muchas tablas obvias no detectadas» porque leer cada letra correctamente no le dice qué números pertenecen a qué columna de hoja de cálculo.
- El punto de referencia de precisión en el que compite cada proveedor de OCR oculta un costo permanente: alguien debe reconstruir plantillas cada vez que un proveedor rediseña su factura, y en las propias reseñas de ABBYY en G2, «los cambios simples requieren soporte de TI».
- Solo tres preguntas importan — cuántas variantes de diseño procesa, si los documentos llegan por escáner o teléfono, y si necesita PDFs buscables o una hoja de cálculo estructurada — y ABBYY y el OCR de IA ganan respuestas opuestas para cada una.
Comparación rápida
La siguiente tabla resume cómo se comparan ABBYY FineReader y las herramientas modernas de OCR con IA en las cinco dimensiones que más importan al elegir un enfoque de extracción de documentos. Cada dimensión se analiza en detalle en las secciones siguientes.
| Dimensión | ABBYY FineReader | OCR moderno con IA |
|---|---|---|
| Precisión en documentos de formato fijo | 99,8 % en documentos escaneados limpios: precisión a nivel de carácter líder en la industria | ~99 % en texto impreso: alcanza la precisión de caracteres, gana en estructura de tablas |
| Flexibilidad con formatos variados | OCR por plantillas/zonas: cada diseño necesita configuración; los cambios de formato rompen la plantilla | Sin plantillas: se adapta a cualquier diseño al comprender el significado, no las posiciones de píxeles |
| Tiempo de configuración y ajuste | Instalación de escritorio + entrenamiento de plantillas por formato; las implementaciones empresariales tardan semanas | Basado en navegador, sin configuración: suba un archivo, nombre sus columnas y vea los resultados en segundos |
| Manejo de fotos de teléfono vs. escaneos planos | Diseñado para escáneres planos: tiene dificultades con perspectiva, sombras y poca luz | Diseñado para captura móvil: maneja distorsión, iluminación desigual y fondos mixtos |
| Modelo de precios | $99–$165/año por usuario; $40K–$300K+/año para plataformas empresariales | Nivel de invitado gratuito; planes de pago de $9–$59/mes; pago por uso desde $6/50 páginas |
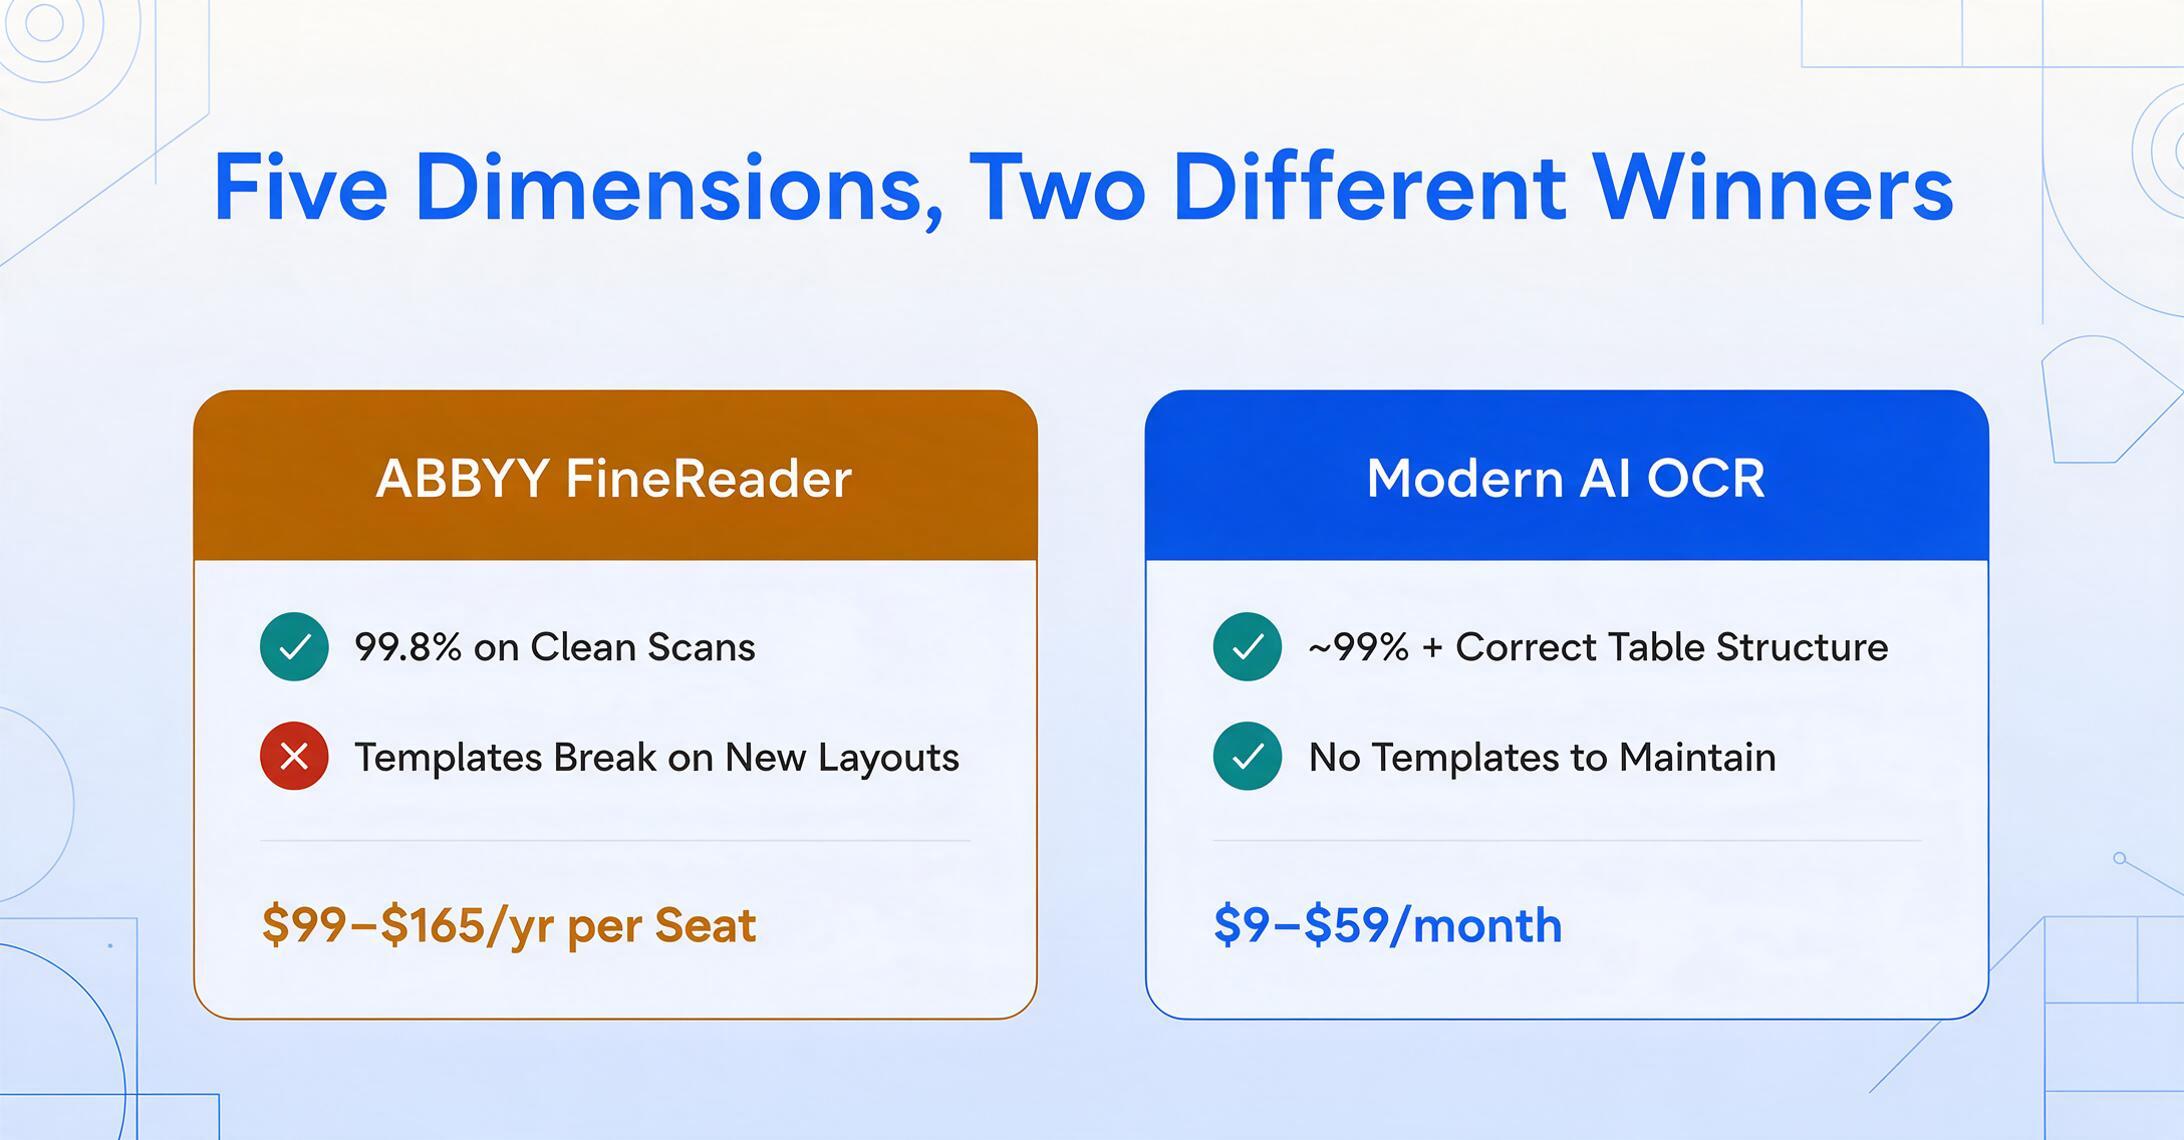
Cada una de estas dimensiones cuenta una parte diferente de la historia. La que más importa depende por completo de los documentos que procesa a diario.
Dimensión 1: Precisión en documentos de formato fijo
ABBYY FineReader sigue siendo el estándar de oro en precisión a nivel de caracteres en documentos limpios, estructurados y de formato fijo, y esa ventaja no es imaginaria. Las pruebas independientes reportan de forma consistente un 99.8% de precisión en texto impreso de documentos bien escaneados. En contextos donde un solo carácter mal leído tiene consecuencias — digitalización de documentos legales, preservación de archivos, formularios gubernamentales — ese margen importa.
ABBYY logra esto mediante un pipeline de reconocimiento maduro — enderezado, optimización de contraste, referencias cruzadas entre múltiples motores — refinado durante décadas. Su soporte para 201 idiomas, incluidos cirílico, árabe, caracteres CJK y escrituras históricas, no tiene igual en el mercado de OCR de escritorio. La reseña de PCMag Editors' Choice señala que FineReader "sigue siendo la herramienta de OCR más precisa que hemos probado" — una reputación ganada mediante un refinamiento continuo.
Pero hay un matiz importante. La precisión de ABBYY es a nivel de caracteres: lee las letras y números correctos. No siempre comprende la estructura que forman esos caracteres. Una reseña de Capterra lo captura: "Muchas tablas obvias no son detectadas por ABBYY al convertir automáticamente, especialmente aquellas sin líneas visibles." Los caracteres son correctos. La estructura de la tabla es incorrecta. El usuario aún tiene que reensamblar los datos manualmente.
El OCR moderno con IA utiliza modelos de visión-lenguaje que analizan la imagen completa del documento de manera holística — leyendo tanto los caracteres como las relaciones espaciales entre ellos. En texto impreso limpio, la brecha de precisión a nivel de caracteres con ABBYY es estrecha (aproximadamente 99% frente a 99.8%). Pero el OCR con IA sobresale en precisión estructural: identifica correctamente qué números pertenecen a qué columna y distingue totales de factura de subtotales, incluso en tablas sin bordes o con celdas combinadas.
La conclusión: En precisión a nivel de caracteres para documentos escaneados limpios, ABBYY aún mantiene una ventaja estrecha. En precisión estructural — colocar los datos en las columnas correctas — el OCR con IA a menudo supera, especialmente en documentos sin bordes explícitos.
Dimensión 2: Flexibilidad con formatos variados
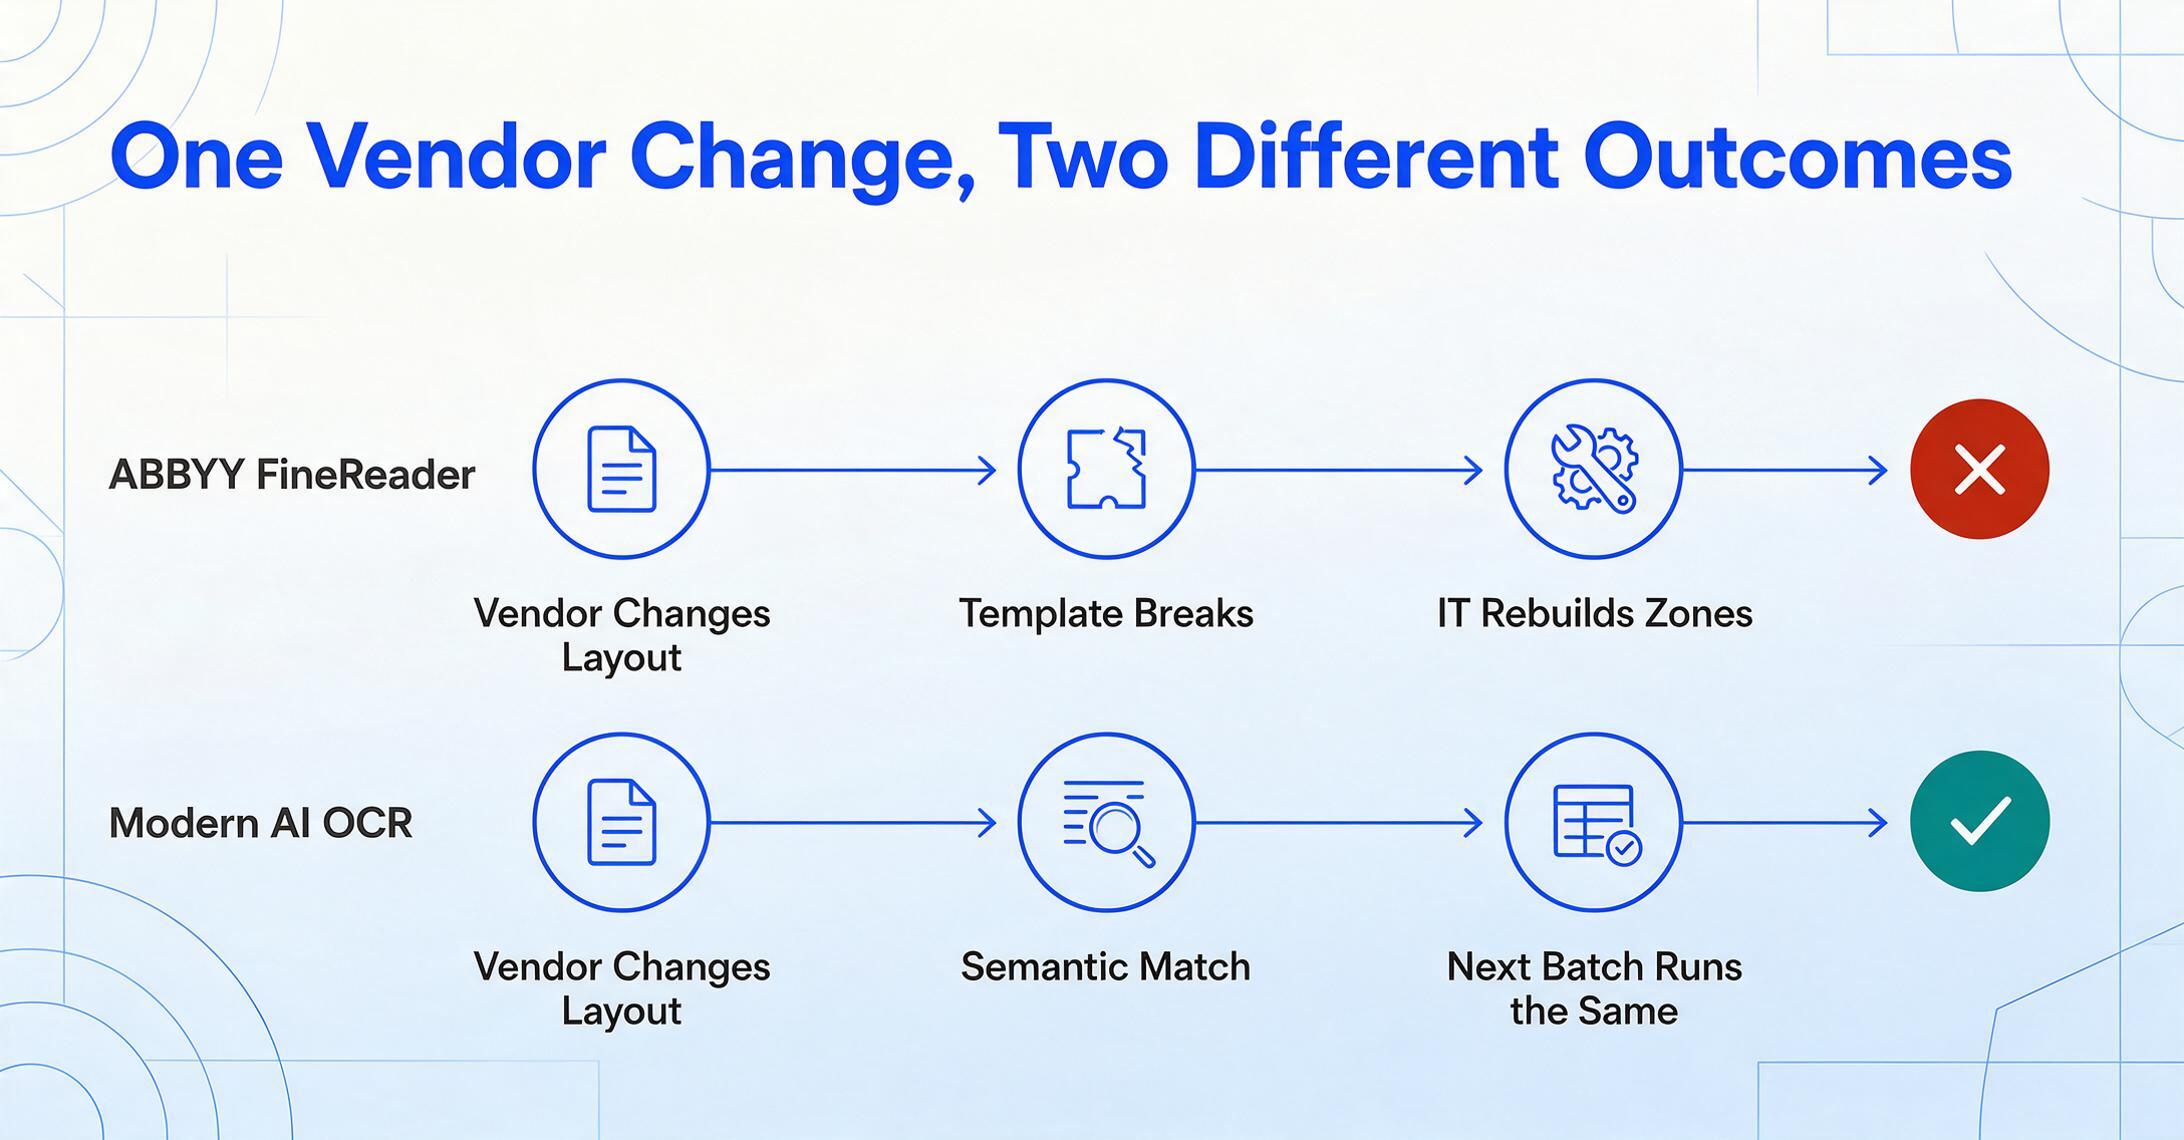
Aquí es donde los dos paradigmas divergen más drásticamente. La dependencia de plantillas de ABBYY es su mayor limitación en un mundo multi-proveedor y multi-formato. El enfoque semántico de la IA OCR se construyó desde cero para manejar exactamente este problema.
El motor de extracción de ABBYY (FlexiCapture y Vantage) se basa en plantillas FlexiLayout: usted define zonas, anclas, coordenadas de campos y reglas de extracción para cada diseño único. Cuando un proveedor actualiza el diseño de su factura o renombra los encabezados de columna, la plantilla se rompe. Alguien con experiencia técnica debe abrir FlexiLayout Studio y ajustar las definiciones de zona. Para equipos que procesan documentos de docenas de proveedores, esto crea una cinta de correr de mantenimiento permanente. Las reseñas de ABBYY en G2 lo confirman: "Los cambios simples requieren soporte de TI."
La IA OCR moderna elimina este problema por completo. Utiliza extracción semántica: usted escribe los nombres de columna que desea (Número de Factura, Fecha, Total), y la IA encuentra los valores correspondientes al comprender qué significan esos términos en la página, no al comparar coordenadas de píxeles de una plantilla predefinida. Los nombres de columna que ingresa se convierten en los encabezados de su hoja de cálculo de salida. Esto funciona de manera idéntica ya sea que el documento sea una factura, una orden de compra o un extracto bancario.
La consecuencia práctica: cuando un proveedor cambia su formato, su extracción sigue funcionando. Sin plantilla que reconstruir, sin zona que redibujar, sin ticket de TI que presentar. El siguiente lote se procesa de la misma manera que el anterior.
Dimensión 3: Tiempo de Configuración e Implementación
El tiempo desde la decisión hasta el primer resultado de extracción difiere por órdenes de magnitud — y esa brecha refleja una diferencia estructural en cómo están construidos los dos enfoques.
ABBYY FineReader de escritorio: descargar e instalar (~30 minutos). Para procesamiento por lotes con plantillas (Corporate o FlexiCapture): al menos medio día por formato de documento para crear y validar plantillas. Para implementaciones empresariales de Vantage o FlexiCapture: de 2 a 12 semanas con socios de implementación, más $20,000–$150,000 en servicios.
OCR de IA moderno: abra un navegador. Suba un archivo. Escriba las columnas que desea. Vea los datos extraídos. Tiempo total transcurrido: menos de 30 segundos. Sin instalación, sin entrenamiento de plantillas, sin consultor. La herramienta está diseñada para la persona que necesita los datos — no para un administrador de TI que configura una plataforma.
Esta diferencia de costo se conecta directamente con la siguiente dimensión, porque el tipo de documentos que procesa determina si necesita preprocesamiento de nivel profesional o puede trabajar directamente con imágenes capturadas con el móvil.
Dimensión 4: Fotos del Teléfono vs Escaneos Planos
La diferencia menos discutida entre el OCR tradicional y el OCR de IA moderno es cómo manejan la fuente de la imagen — y esto a menudo determina qué herramienta funciona realmente en la práctica.
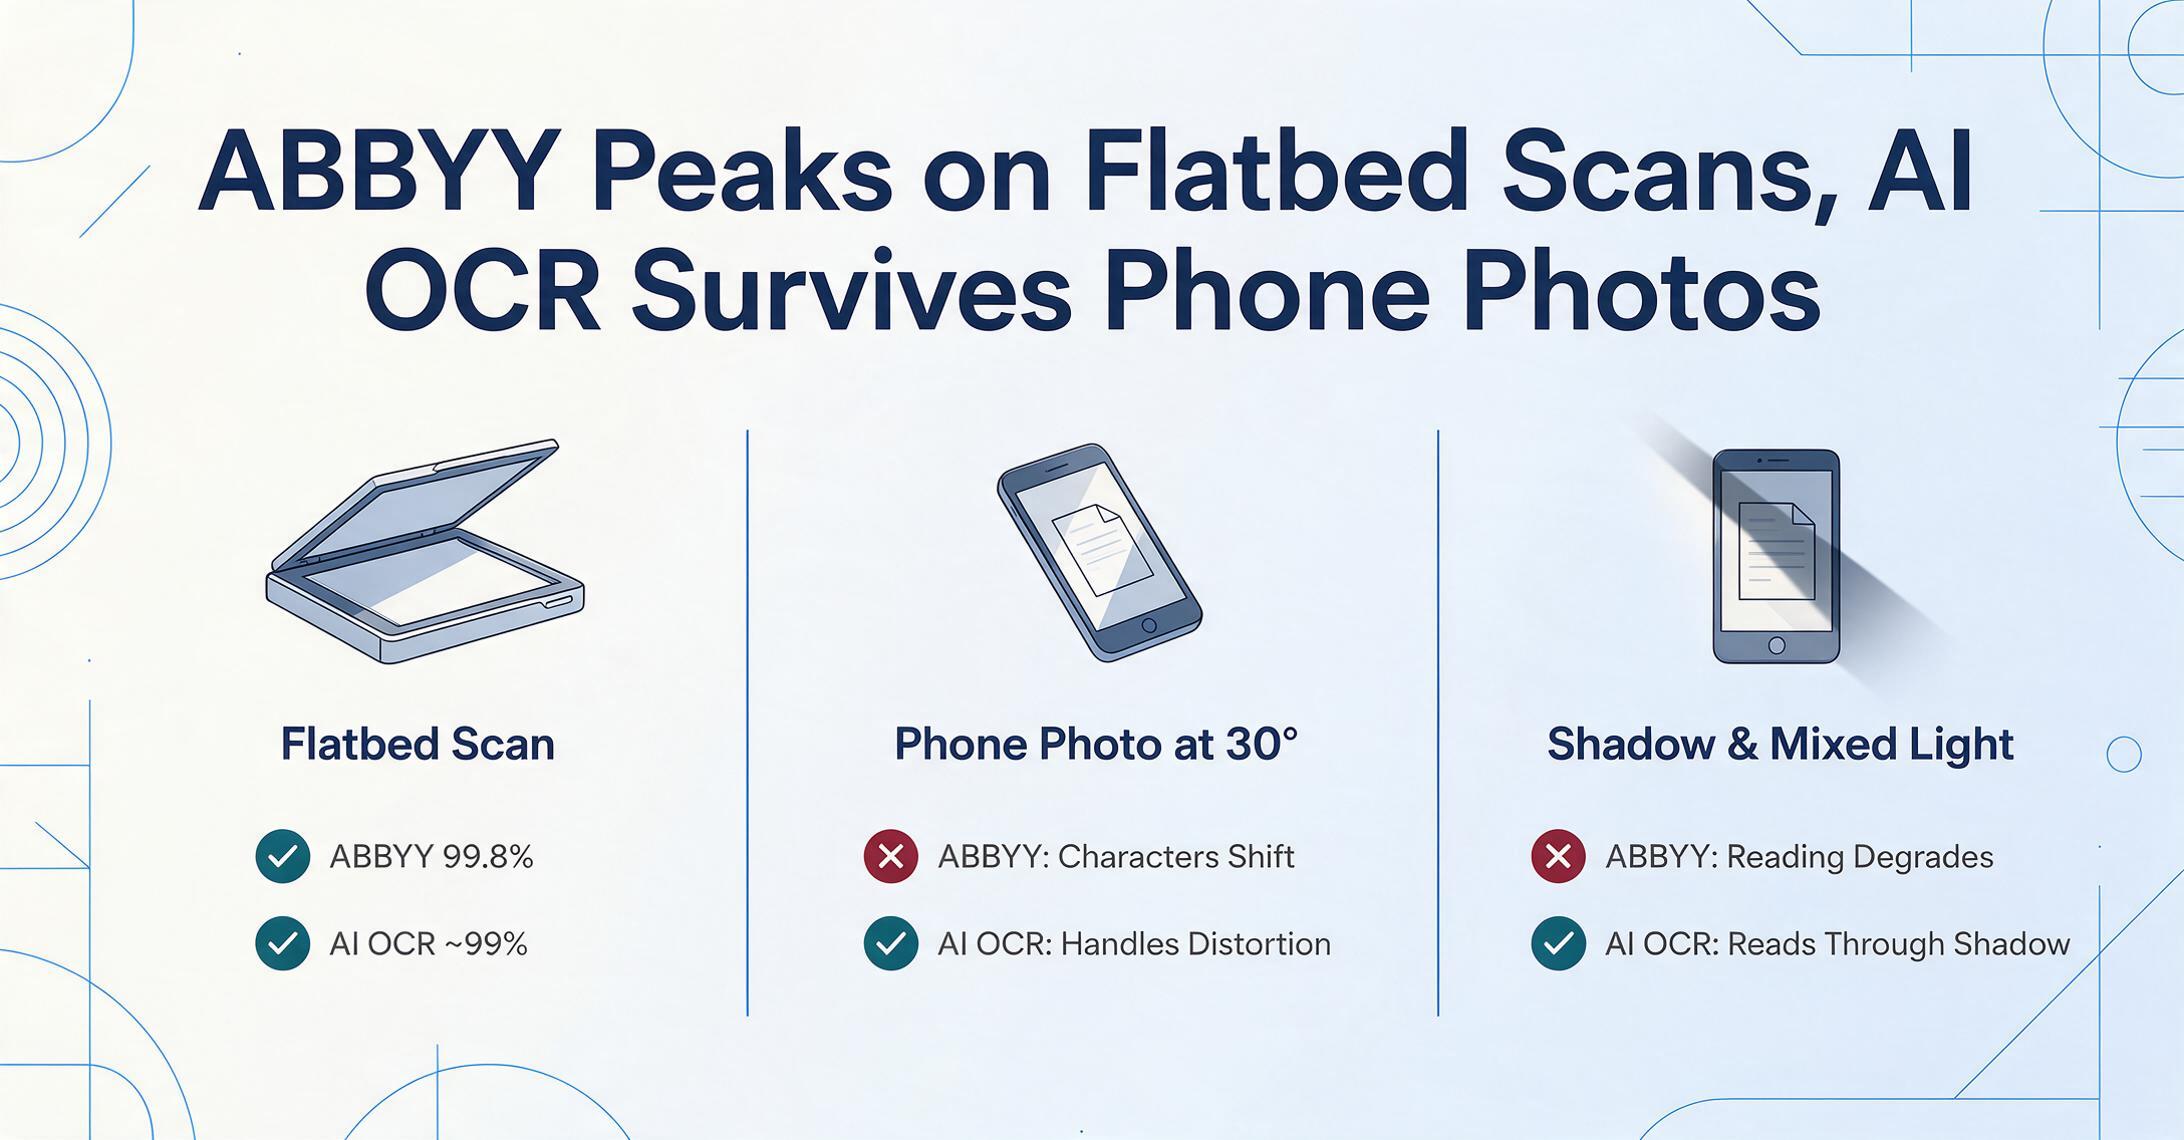
ABBYY FineReader fue diseñado para la era del escáner plano. La salida del escáner es plana, uniformemente iluminada y sin distorsión — ideal para el emparejamiento de patrones de caracteres. El pipeline de preprocesamiento asume estas condiciones. Alimente a FineReader con una foto de teléfono tomada en un ángulo de 30 grados bajo iluminación de oficina, y los resultados se degradan notablemente. La distorsión de perspectiva desplaza las formas de los caracteres. La iluminación desigual crea gradientes de sombra. Esto no es exclusivo de ABBYY — todo motor OCR tradicional comparte esta limitación porque la entrada de calidad de escáner era la suposición base cuando fueron diseñados.
El OCR de IA moderno utiliza modelos de visión-lenguaje entrenados con diversas calidades de imagen: fotos de teléfono, capturas de cámara web, fotocopias y capturas de pantalla junto con escaneos planos. Estos modelos manejan la distorsión de perspectiva porque entienden objetos en un espacio tridimensional. Leen a través de las sombras porque han visto miles de documentos sombreados durante el entrenamiento. Para equipos cuyos documentos llegan mediante captura móvil — inspectores de campo fotografiando registros de obra, empleados enviando recibos de gastos, representantes de ventas escaneando contratos en sitios de clientes — esta diferencia es decisiva. Una herramienta que requiere entrada de calidad de escáner no puede soportar un flujo de trabajo móvil primero, independientemente de cuán precisa sea en escaneos planos.
Dimensión 5: Comparación de modelos de precios
Una comparación honesta de precios requiere separar los productos de escritorio de ABBYY de sus plataformas empresariales: atienden escalas de operación completamente diferentes.
ABBYY FineReader de escritorio: $99/año (Standard) o $165/año (Corporate) para Windows, $69/año para Mac. Licencias de un solo usuario para un paquete de edición de PDF y OCR. La extracción es manual: abra cada archivo, ejecute el OCR, verifique la detección de tablas, exporte y repita.
ABBYY empresarial (Vantage, FlexiCapture): precios personalizados. Datos de adquisición de terceros sitúan las implementaciones de mercado medio en $40,000–$100,000 por año, con acuerdos empresariales que van de $100,000 a $300,000 por año. Los servicios de implementación añaden $20,000–$150,000. El mantenimiento anual para implementaciones locales equivale al 18–22% del costo de la licencia.
OCR de IA moderno: nivel de invitado gratuito; planes de pago desde $9/mes (150 páginas) hasta $59/mes (1,500 páginas); pago por uso desde $6 por 50 páginas. Sin cargos de implementación ni mantenimiento anual. El plan de OCR de IA incluye procesamiento por lotes automatizado, extracción semántica y fusión de Excel, capacidades que requieren el nivel Corporate o los productos empresariales en el ecosistema de ABBYY.
La pregunta real no es «cuál cuesta menos», sino «qué modelo de precios se ajusta a su volumen y variedad de documentos». Una operación de formato único y alto volumen podría encontrar más económico el modelo por asiento de ABBYY. Un equipo de volumen moderado y múltiples proveedores casi con certeza encontrará el modelo por página del OCR de IA más barato tanto en costo directo como en gastos operativos.
Con las cinco dimensiones expuestas, la pregunta deja de ser «cuál es mejor» y pasa a ser «cuál se ajusta a su realidad específica de procesamiento de documentos».
Cuándo ABBYY tiene más sentido
ABBYY sigue siendo la opción correcta para escenarios específicos donde la precisión a nivel de carácter y la fidelidad del diseño no son negociables.
- Digitalización de archivos en papel. Convertir miles de documentos históricos en PDFs buscables con reproducción visual exacta: la preservación del diseño y el preprocesamiento de FineReader están diseñados específicamente para esto.
- Procesamiento de formato fijo y proveedor único. Los formatos de documento estables de proveedores conocidos hacen que valga la pena la inversión inicial en plantillas.
- Archivos multilingües. El soporte de ABBYY para 201 idiomas, incluidos CJK, árabe y cirílico, es genuinamente inigualable.
- Requisitos de seguridad locales. Contratistas de defensa, agencias gubernamentales e instituciones financieras reguladas pueden implementar FlexiCapture o FineReader Server localmente.
- Gestión del ciclo de vida de PDF. Comparación de documentos, redacción, firmas digitales y archivado PDF/A junto con OCR: FineReader es un paquete completo de PDF.
Cuándo el OCR con IA moderna tiene más sentido
El OCR con IA es la mejor opción para la mayoría de los equipos cuyas necesidades de procesamiento de documentos han pasado de «digitalizar papel» a «extraer datos estructurados de fuentes variadas».
- Procesamiento multi-proveedor y multi-formato. Cuando recibe documentos de docenas de proveedores, cada uno con su propio diseño, el enfoque sin plantilla del OCR con IA es fundamentalmente más fiable. Los cambios de formato que romperían una plantilla de ABBYY son invisibles para la extracción semántica.
- Flujos de trabajo con fotos de teléfono y captura móvil. Equipos de campo, informes de gastos, inspecciones de obra: el OCR con IA maneja estas imágenes de forma fiable porque fue entrenado con datos capturados desde móviles. Esta es la dimensión donde la brecha tecnológica entre el OCR heredado y el OCR con IA es más amplia.
- Extracción de datos autogestionada. Sin instalación, sin configuración de plantillas, sin cursos de formación. La herramienta está diseñada para la persona que necesita los datos, no para administradores de TI.
- Extracción por lotes a salida estructurada. Suba varios documentos y obtenga una hoja de cálculo alineada. Cada archivo rellena la misma estructura definida por los nombres de columna del usuario. Esta capacidad es estándar en el OCR con IA, pero requiere el nivel Corporate o un producto empresarial en la línea de ABBYY.
- Tipos de documentos mixtos en un solo lote. Facturas, órdenes de compra y extractos bancarios juntos, sin necesidad de plantillas o ejecuciones separadas. La IA identifica el tipo de cada documento y extrae los campos relevantes en una tabla unificada.
El veredicto
La respuesta honesta es un marco de decisión basado en su combinación de documentos, no una recomendación única. ABBYY y el OCR con IA moderna son tecnologías paralelas optimizadas para diferentes realidades de procesamiento. La elección correcta depende de tres preguntas:
1. ¿Cuántos diseños de documentos diferentes procesa?
Uno o dos formatos estables con alto volumen → el enfoque de plantillas de ABBYY funciona bien. Docenas o cientos de formatos variados → el enfoque sin plantilla del OCR con IA es más fiable y más barato de mantener.
2. ¿De dónde provienen sus documentos?
Escaneos de superficie plana con iluminación controlada → ABBYY rinde al máximo. Fotos de teléfono, capturas con luz mixta y capturas de pantalla → el OCR con IA las maneja de forma natural.
3. ¿Qué necesita de los datos extraídos?
PDFs buscables con reproducción visual exacta → ABBYY sobresale. Datos estructurados en hoja de cálculo fusionados en una sola tabla → el OCR con IA (diseñado para esto desde el primer día) es la herramienta correcta.
Para muchas organizaciones, la configuración óptima es híbrida: use ABBYY FineReader para la digitalización de calidad de archivo donde la fidelidad del diseño importa, y use OCR con IA moderno para la extracción diaria de datos de facturas, formularios y recibos, especialmente cuando esos documentos llegan por teléfono desde múltiples fuentes. Si está listo para comparar las principales herramientas de OCR con IA entre sí, nuestro resumen del mejor software de OCR con IA cubre ocho de ellas por precio, precisión y adecuación.
El cambio de «escanear todo» a «extraer los datos que necesita» es un cambio fundamental en cómo se utilizan los documentos en los negocios. ABBYY atiende excepcionalmente bien el primer mundo. El OCR moderno con IA está diseñado específicamente para el segundo. La pregunta correcta no es qué herramienta es mejor, sino qué tipo de procesamiento de documentos necesita realmente.
Preguntas Frecuentes
¿Puede la OCR con IA igualar la precisión de ABBYY en documentos impresos limpios?
En documentos escaneados limpios con fuentes estándar, la OCR moderna con IA alcanza aproximadamente un 99% de precisión frente al ~99,8% de ABBYY: la diferencia existe, pero es reducida. Donde la OCR con IA suele superar a ABBYY es en la precisión estructural: identificar correctamente la estructura de tablas, las relaciones entre columnas y la semántica de los campos en diseños sin bordes o complejos. En fotos tomadas con el teléfono, escaneos de baja calidad o documentos con fuentes mixtas, la OCR con IA generalmente supera a ABBYY porque sus modelos de visión se entrenaron con calidades de imagen diversas.
¿ABBYY FineReader incluye funciones impulsadas por IA?
ABBYY describe su motor de OCR como basado en IA porque utiliza aprendizaje automático para el reconocimiento de caracteres y el análisis de diseño. Sin embargo, esto no es lo mismo que la OCR moderna con IA. La IA de ABBYY se aplica a mejorar el proceso de coincidencia de caracteres y preprocesamiento; no proporciona comprensión semántica, extracción sin plantilla ni interpretación contextual de datos. La diferencia se analiza en profundidad en nuestra comparativa de OCR frente a extracción con IA.
¿Puedo sustituir ABBYY FlexiCapture por OCR con IA para el procesamiento de documentos empresariales?
Depende de sus requisitos. Para la extracción de datos de facturas, recibos, órdenes de compra y documentos comerciales similares —especialmente de fuentes variadas—, las plataformas modernas de OCR con IA pueden sustituir a FlexiCapture a una fracción del coste y del tiempo de configuración. Sin embargo, si su flujo de trabajo requiere integración nativa con SAP/Oracle, flujos de clasificación de documentos o procesamiento exclusivamente local con controles estrictos de residencia de datos, los productos empresariales de ABBYY siguen siendo la opción adecuada.
¿ABBYY FineReader reconoce escritura manuscrita?
ABBYY FineReader tiene capacidades limitadas de reconocimiento de escritura manuscrita, con una precisión de aproximadamente el 95% en escritura clara y aislada en buenas condiciones. En escritura cursiva, la precisión desciende a aproximadamente el 91,7%. ABBYY también admite ICR (Intelligent Character Recognition) a través de sus productos empresariales. Sin embargo, para documentos mixtos impresos y manuscritos o escritura desordenada, las herramientas modernas de OCR con IA que utilizan modelos de visión y lenguaje suelen alcanzar una precisión mayor y más constante porque interpretan la escritura de forma contextual, no mediante la comparación de patrones a nivel de carácter.
¿ABBYY FineReader está disponible como servicio en la nube?
ABBYY FineReader PDF es una aplicación de escritorio: no existe versión en la nube ni para navegador. ABBYY ofrece capacidades de OCR en la nube a través de productos empresariales independientes: el ABBYY Cloud OCR SDK (basado en API, con precio independiente) y ABBYY Vantage (plataforma IDP en la nube con precios empresariales personalizados). El FineReader de escritorio no tiene interfaz de navegador ni API REST. Las herramientas modernas de OCR con IA, en cambio, son nativas de la nube por diseño: funcionan en cualquier navegador y en cualquier dispositivo sin instalación e incluyen API REST en los planes de pago.
Pruebe el OCR con IA en sus propios documentos
La forma más fiable de decidir entre ABBYY y el OCR con IA no es leer comparaciones, sino probar ambos enfoques con sus documentos reales. Suba un lote de facturas, recibos o formularios que representen su mezcla documental real. Vea cómo la extracción semántica moderna maneja tablas sin bordes, fotos tomadas con el teléfono y lotes de múltiples formatos. Compare la estructura de salida con lo que obtiene actualmente de ABBYY — no solo la precisión, sino cuánto posprocesamiento debe hacer aún su equipo.
Modo invitado gratuito — sin cuenta, sin tarjeta de crédito.