ABBYY FineReader vs. moderne KI-OCR:
Präzision der alten Schule vs. neue Flexibilität
ABBYY FineReader ist die genaueste Texterkennungs-Engine, die je für saubere, gedruckte Dokumente gebaut wurde. Moderne KI-OCR – basierend auf Vision-Language-Modellen statt auf Zeichenabgleich-Algorithmen – ist die flexibelste Technologie zur Datenextraktion aus Dokumenten, die heute verfügbar ist. Keine dieser Aussagen widerspricht der anderen, denn es handelt sich nicht um konkurrierende Produkte für dasselbe Problem. Es sind unterschiedliche Werkzeuge für unterschiedliche Dokumentverarbeitungsaufgaben, und die Wahl zwischen ihnen beginnt damit, die Art von Dokumenten zu verstehen, die Sie tatsächlich verarbeiten.
Die wichtigsten Erkenntnisse
- ABBYYs 99,8% Zeichengenauigkeit ist real und unübertroffen – aber ein Capterra-Rezensent fand „viele offensichtliche Tabellen nicht erkannt“, weil das korrekte Lesen jedes Buchstabens immer noch nicht verrät, welche Zahlen in welche Tabellenspalte gehören.
- Der Genauigkeits-Benchmark, um den alle OCR-Anbieter konkurrieren, verbirgt dauerhafte Kosten: Jemand muss Vorlagen jedes Mal neu erstellen, wenn ein Lieferant seine Rechnung neu gestaltet, und in ABBYYs eigenen G2-Bewertungen heißt es: „Einfache Änderungen erfordern IT-Support.“
- Nur drei Fragen sind entscheidend – wie viele Layoutvarianten Sie verarbeiten, ob Dokumente per Scanner oder Handy ankommen und ob Sie durchsuchbare PDFs oder eine strukturierte Tabelle benötigen – und ABBYY und KI-OCR gewinnen bei jeweils gegensätzlichen Antworten.
Schnellvergleich
Die folgende Tabelle fasst zusammen, wie sich ABBYY FineReader und moderne KI-OCR-Tools in den fünf Dimensionen unterscheiden, die bei der Wahl eines Ansatzes zur Dokumentextraktion am wichtigsten sind. Jede Dimension wird in den folgenden Abschnitten ausführlich erläutert.
| Dimension | ABBYY FineReader | Moderne KI-OCR |
|---|---|---|
| Genauigkeit bei Dokumenten mit festem Format | 99,8 % bei sauberen gescannten Dokumenten – branchenführende Zeichengenauigkeit | ~99 % bei gedrucktem Text – holt bei der Zeichengenauigkeit auf, punktet bei der Tabellenstruktur |
| Flexibilität bei unterschiedlichen Formaten | Template-/Zonen-OCR – jedes Layout muss konfiguriert werden; Formatänderungen brechen die Vorlage | Ohne Vorlagen – passt sich jedem Layout an, indem es die Bedeutung versteht, nicht die Pixelpositionen |
| Einrichtungs- & Konfigurationszeit | Desktop-Installation + Template-Training pro Format; Unternehmensbereitstellungen dauern Wochen | Browserbasiert, keine Einrichtung – Datei hochladen, Spalten benennen, Ergebnisse in Sekunden sehen |
| Handyfoto vs. Flachbettscan-Verarbeitung | Für Flachbettscanner-Ausgabe entwickelt – Probleme mit Perspektive, Schatten, schwachem Licht | Für mobile Erfassung entwickelt – verarbeitet Verzerrungen, ungleichmäßige Beleuchtung, gemischte Hintergründe |
| Preismodell | 99–165 $/Jahr pro Arbeitsplatz (Desktop); 40.000–300.000+ $/Jahr für Unternehmensplattformen | Kostenlose Gast-Stufe; kostenpflichtige Pläne 9–59 $/Monat; nutzungsbasiert ab 6 $/50 Seiten |
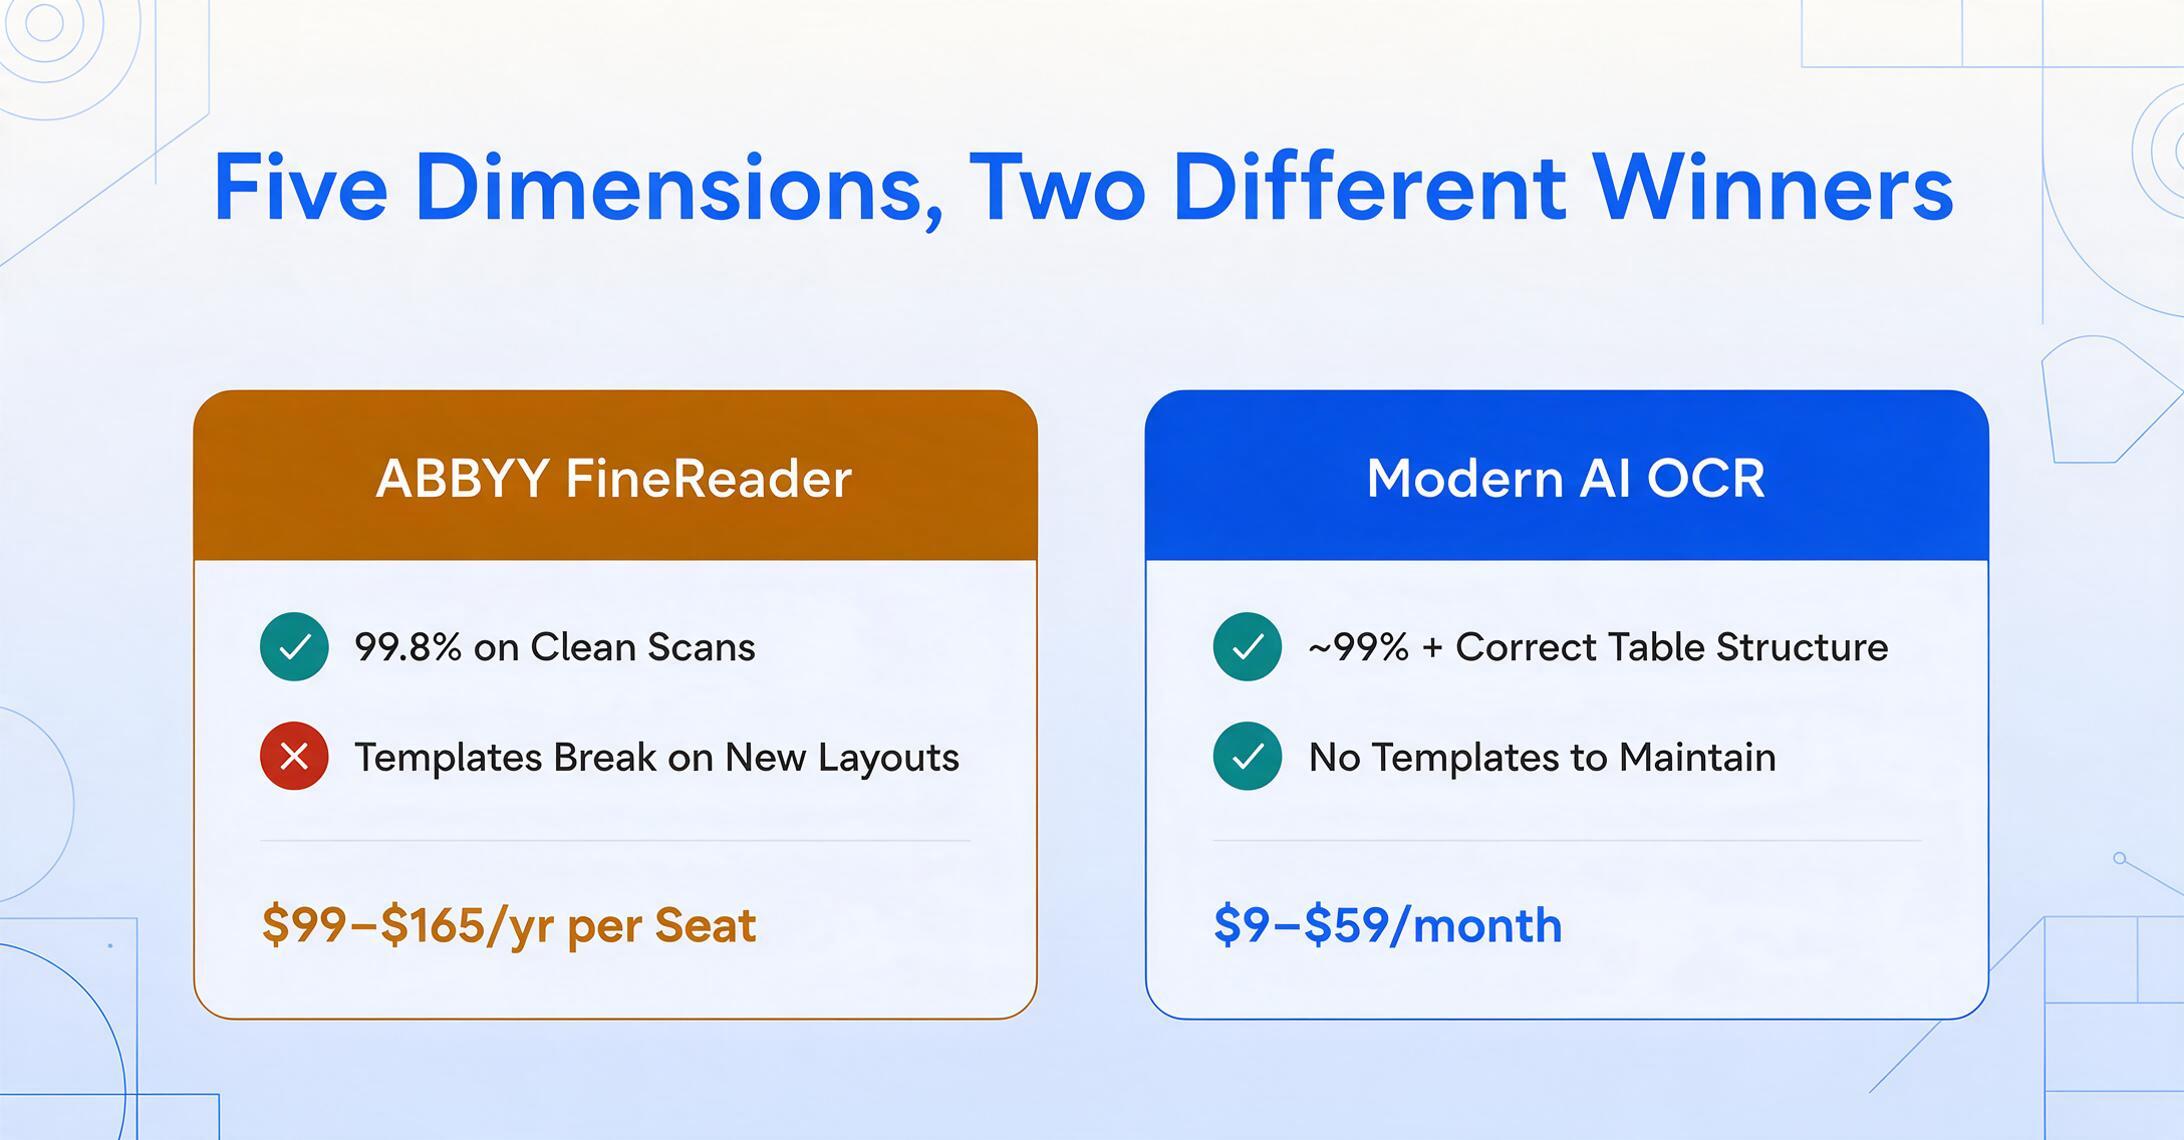
Jede dieser Dimensionen erzählt einen anderen Teil der Geschichte. Welche am wichtigsten ist, hängt ganz von den Dokumenten ab, die Sie täglich verarbeiten.
Dimension 1: Genauigkeit bei Dokumenten mit festem Format
ABBYY FineReader bleibt der Goldstandard für zeichengenaue Erkennung bei sauberen, strukturierten Dokumenten mit festem Format – und dieser Vorsprung ist nicht eingebildet. Unabhängige Tests berichten durchgängig von 99,8 % Genauigkeit bei gedrucktem Text in gut gescannten Dokumenten. In Kontexten, in denen ein einziges falsch gelesenes Zeichen Konsequenzen hat – Digitalisierung von Rechtsdokumenten, Archivierung, behördliche Formulare –, zählt dieser Unterschied.
ABBYY erreicht dies durch eine ausgereifte Erkennungspipeline – Schräglagenkorrektur, Kontrastoptimierung, Multi-Engine-Kreuzvalidierung –, die über Jahrzehnte verfeinert wurde. Die Unterstützung von 201 Sprachen, darunter Kyrillisch, Arabisch, CJK-Zeichen und historische Schriften, ist im Desktop-OCR-Markt unübertroffen. Die PCMag Editors' Choice-Rezension stellt fest, dass FineReader „das genaueste OCR-Tool bleibt, das wir getestet haben" – ein Ruf, der durch kontinuierliche Verbesserung erworben wurde.
Aber es gibt eine wichtige Nuance. Die Genauigkeit von ABBYY ist zeichenbasiert: Es liest die richtigen Buchstaben und Zahlen. Es versteht jedoch nicht immer die Struktur, die diese Zeichen bilden. Eine Capterra-Rezension bringt es auf den Punkt: „Viele offensichtliche Tabellen werden von ABBYY bei der automatischen Konvertierung nicht erkannt, insbesondere solche ohne sichtbare Linien." Die Zeichen stimmen. Die Tabellenstruktur ist falsch. Der Benutzer muss die Daten weiterhin manuell wieder zusammensetzen.
Moderne KI-OCR verwendet Vision-Language-Modelle, die das gesamte Dokumentbild ganzheitlich analysieren – sowohl die Zeichen als auch die räumlichen Beziehungen zwischen ihnen. Bei sauberem gedrucktem Text ist der Unterschied bei der Zeichengenauigkeit zu ABBYY gering (ca. 99 % gegenüber 99,8 %). Aber KI-OCR zeichnet sich durch strukturelle Genauigkeit aus: Sie erkennt korrekt, welche Zahlen zu welcher Spalte gehören, und unterscheidet Rechnungssummen von Zwischensummen – auch bei tabellen ohne Linien oder mit zusammengeführten Zellen.
Das Fazit: Bei der Zeichengenauigkeit für sauber gescannte Dokumente hat ABBYY weiterhin einen knappen Vorsprung. Bei der strukturellen Genauigkeit – also der korrekten Zuordnung der Daten in die richtigen Spalten – ist KI-OCR oft überlegen, insbesondere bei Dokumenten ohne explizite Linien.
Dimension 2: Flexibilität bei unterschiedlichen Formaten
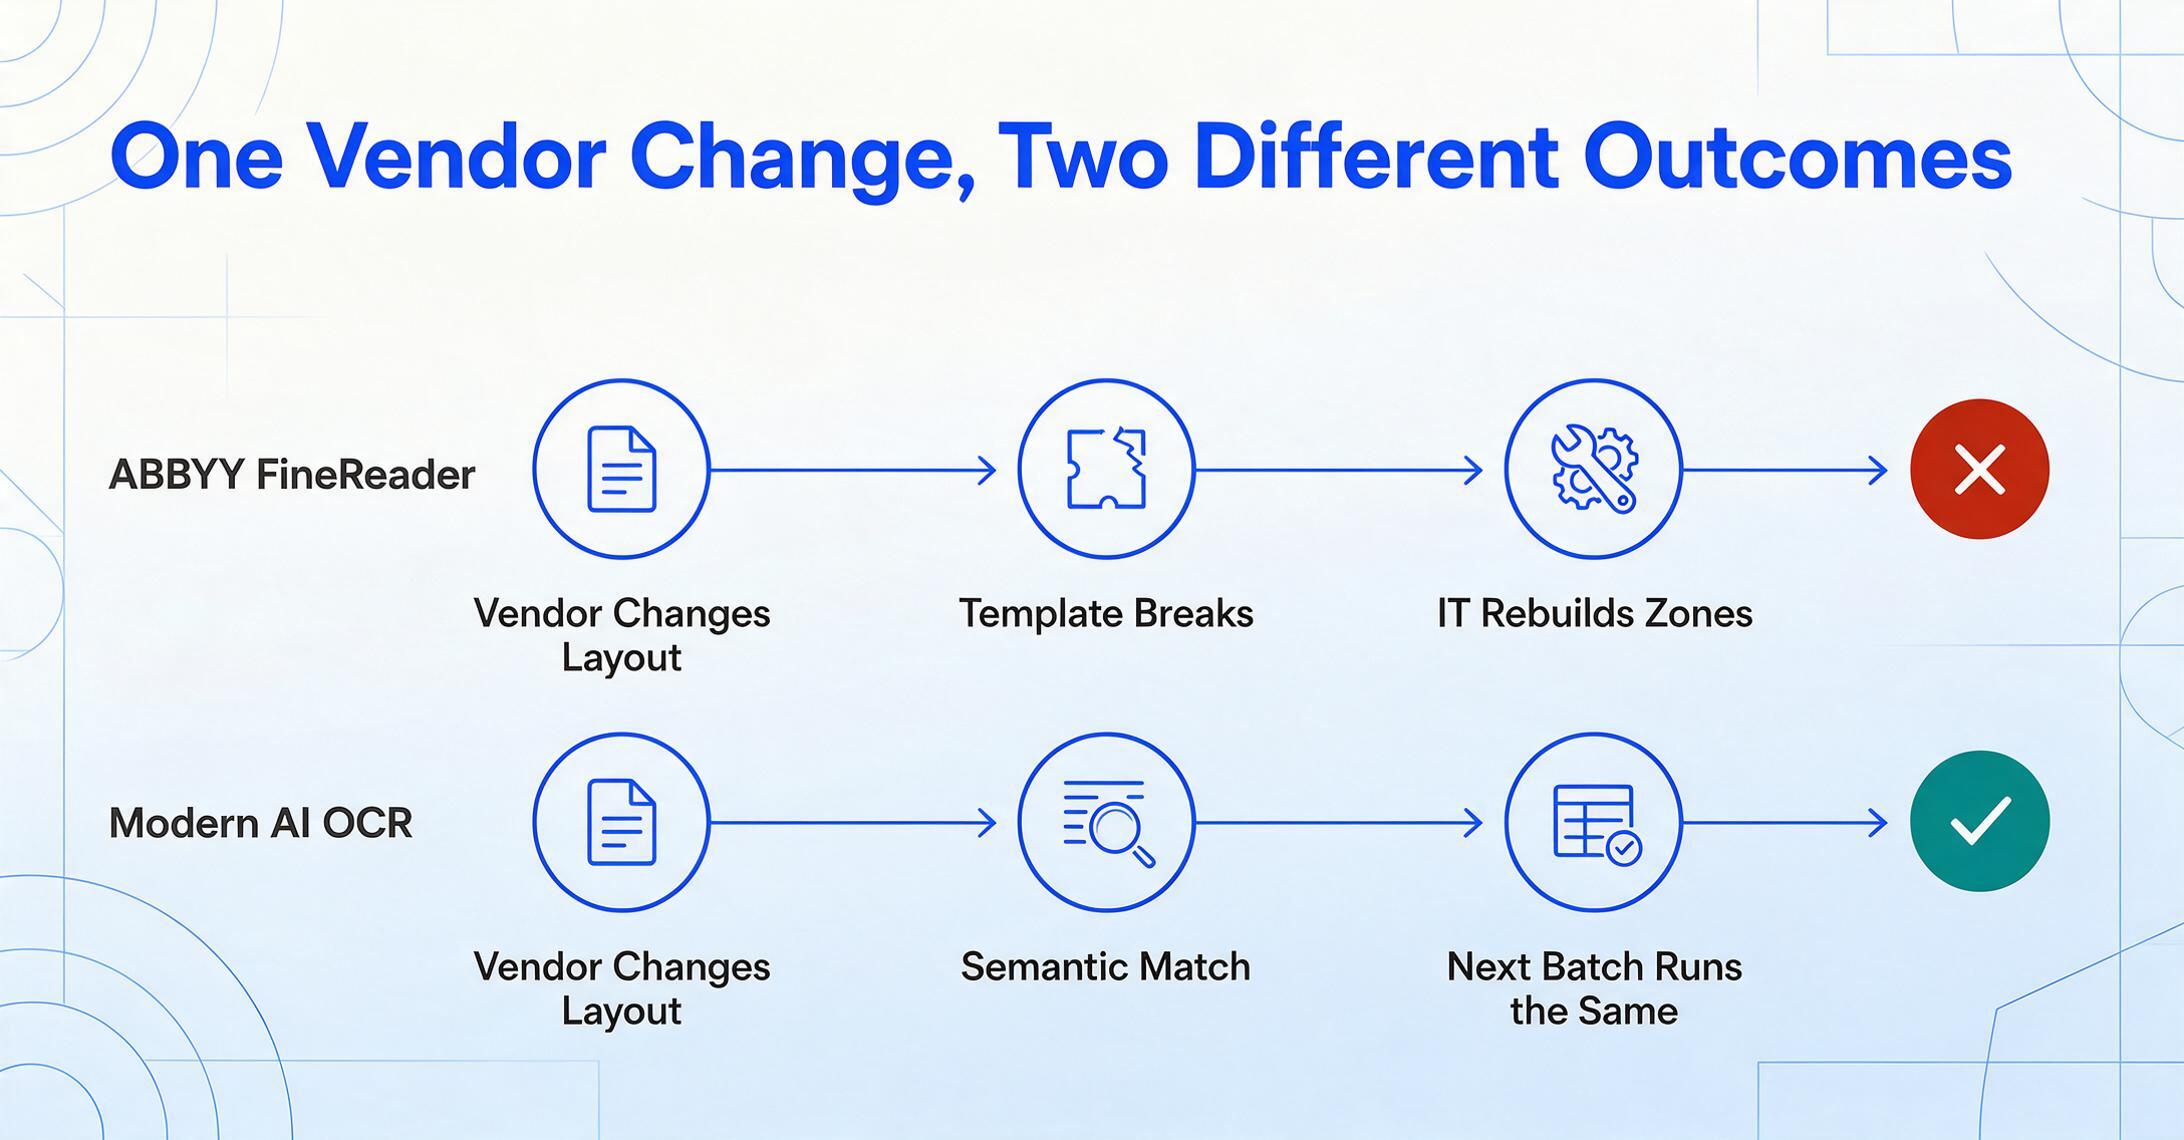
Hier trennen sich die beiden Paradigmen am deutlichsten. ABBYYs Vorlagenabhängigkeit ist seine größte Einschränkung in einer Welt mit vielen Anbietern und Formaten. Der semantische Ansatz von AI OCR wurde von Grund auf genau für dieses Problem entwickelt.
ABBYYs Extraktionsengine (FlexiCapture und Vantage) basiert auf FlexiLayout-Vorlagen: Sie definieren Zonen, Anker, Feldkoordinaten und Extraktionsregeln für jedes einzelne Layout. Wenn ein Anbieter sein Rechnungsdesign ändert oder Spaltenüberschriften umbenennt, bricht die Vorlage. Jemand mit technischem Fachwissen muss FlexiLayout Studio öffnen und die Zonendefinitionen anpassen. Für Teams, die Dokumente von Dutzenden Anbietern verarbeiten, entsteht so ein permanenter Wartungsaufwand. ABBYYs G2-Bewertungen bestätigen das: „Einfache Änderungen erfordern IT-Support."
Moderne AI OCR eliminiert dieses Problem vollständig. Sie verwendet semantische Extraktion: Sie geben die gewünschten Spaltennamen ein (Rechnungsnummer, Datum, Gesamtsumme), und die KI findet die entsprechenden Werte, indem sie versteht, was diese Begriffe auf der Seite bedeuten – nicht durch Abgleich von Pixelkoordinaten aus einer vordefinierten Vorlage. Die von Ihnen eingegebenen Spaltennamen werden zu den Überschriften Ihrer Ausgabetabelle. Dies funktioniert identisch, ob das Dokument eine Rechnung, ein Auftrag oder ein Kontoauszug ist.
Die praktische Konsequenz: Wenn ein Anbieter sein Format ändert, funktioniert Ihre Extraktion weiter. Keine Vorlage zum Neuaufbauen, keine Zone zum Neuzeichnen, kein IT-Ticket zum Einreichen. Der nächste Batch wird genauso verarbeitet wie der vorherige.
Dimension 3: Einrichtungs- und Konfigurationszeit
Die Zeit von der Entscheidung bis zum ersten Extraktionsergebnis unterscheidet sich um Größenordnungen – und diese Lücke spiegelt einen strukturellen Unterschied in der Architektur der beiden Ansätze wider.
ABBYY FineReader Desktop: Download und Installation (~30 Minuten). Für die Stapelverarbeitung mit Vorlagen (Corporate oder FlexiCapture): mindestens ein halber Tag pro Dokumentformat für die Erstellung und Validierung von Vorlagen. Für Unternehmensbereitstellungen von Vantage oder FlexiCapture: 2 bis 12 Wochen mit Implementierungspartnern, plus 20.000–150.000 $ für Dienstleistungen.
Moderne KI-OCR: Öffnen Sie einen Browser. Laden Sie eine Datei hoch. Geben Sie die gewünschten Spalten ein. Sehen Sie die extrahierten Daten. Gesamtzeit: unter 30 Sekunden. Keine Installation, kein Vorlagen-Training, kein Berater. Das Tool ist für die Person konzipiert, die die Daten benötigt – nicht für einen IT-Administrator, der eine Plattform konfiguriert.
Dieser Kostenvorteil führt direkt zur nächsten Dimension, denn die Art der Dokumente, die Sie verarbeiten, bestimmt, ob Sie eine Desktop-Qualität der Vorverarbeitung benötigen oder direkt mit mobil aufgenommenen Bildern arbeiten können.
Dimension 4: Handyfotos vs. Flachbettscans
Der am wenigsten diskutierte Unterschied zwischen herkömmlicher OCR und moderner KI-OCR ist der Umgang mit der Bildquelle – und genau das entscheidet oft darüber, welches Tool in der Praxis tatsächlich funktioniert.
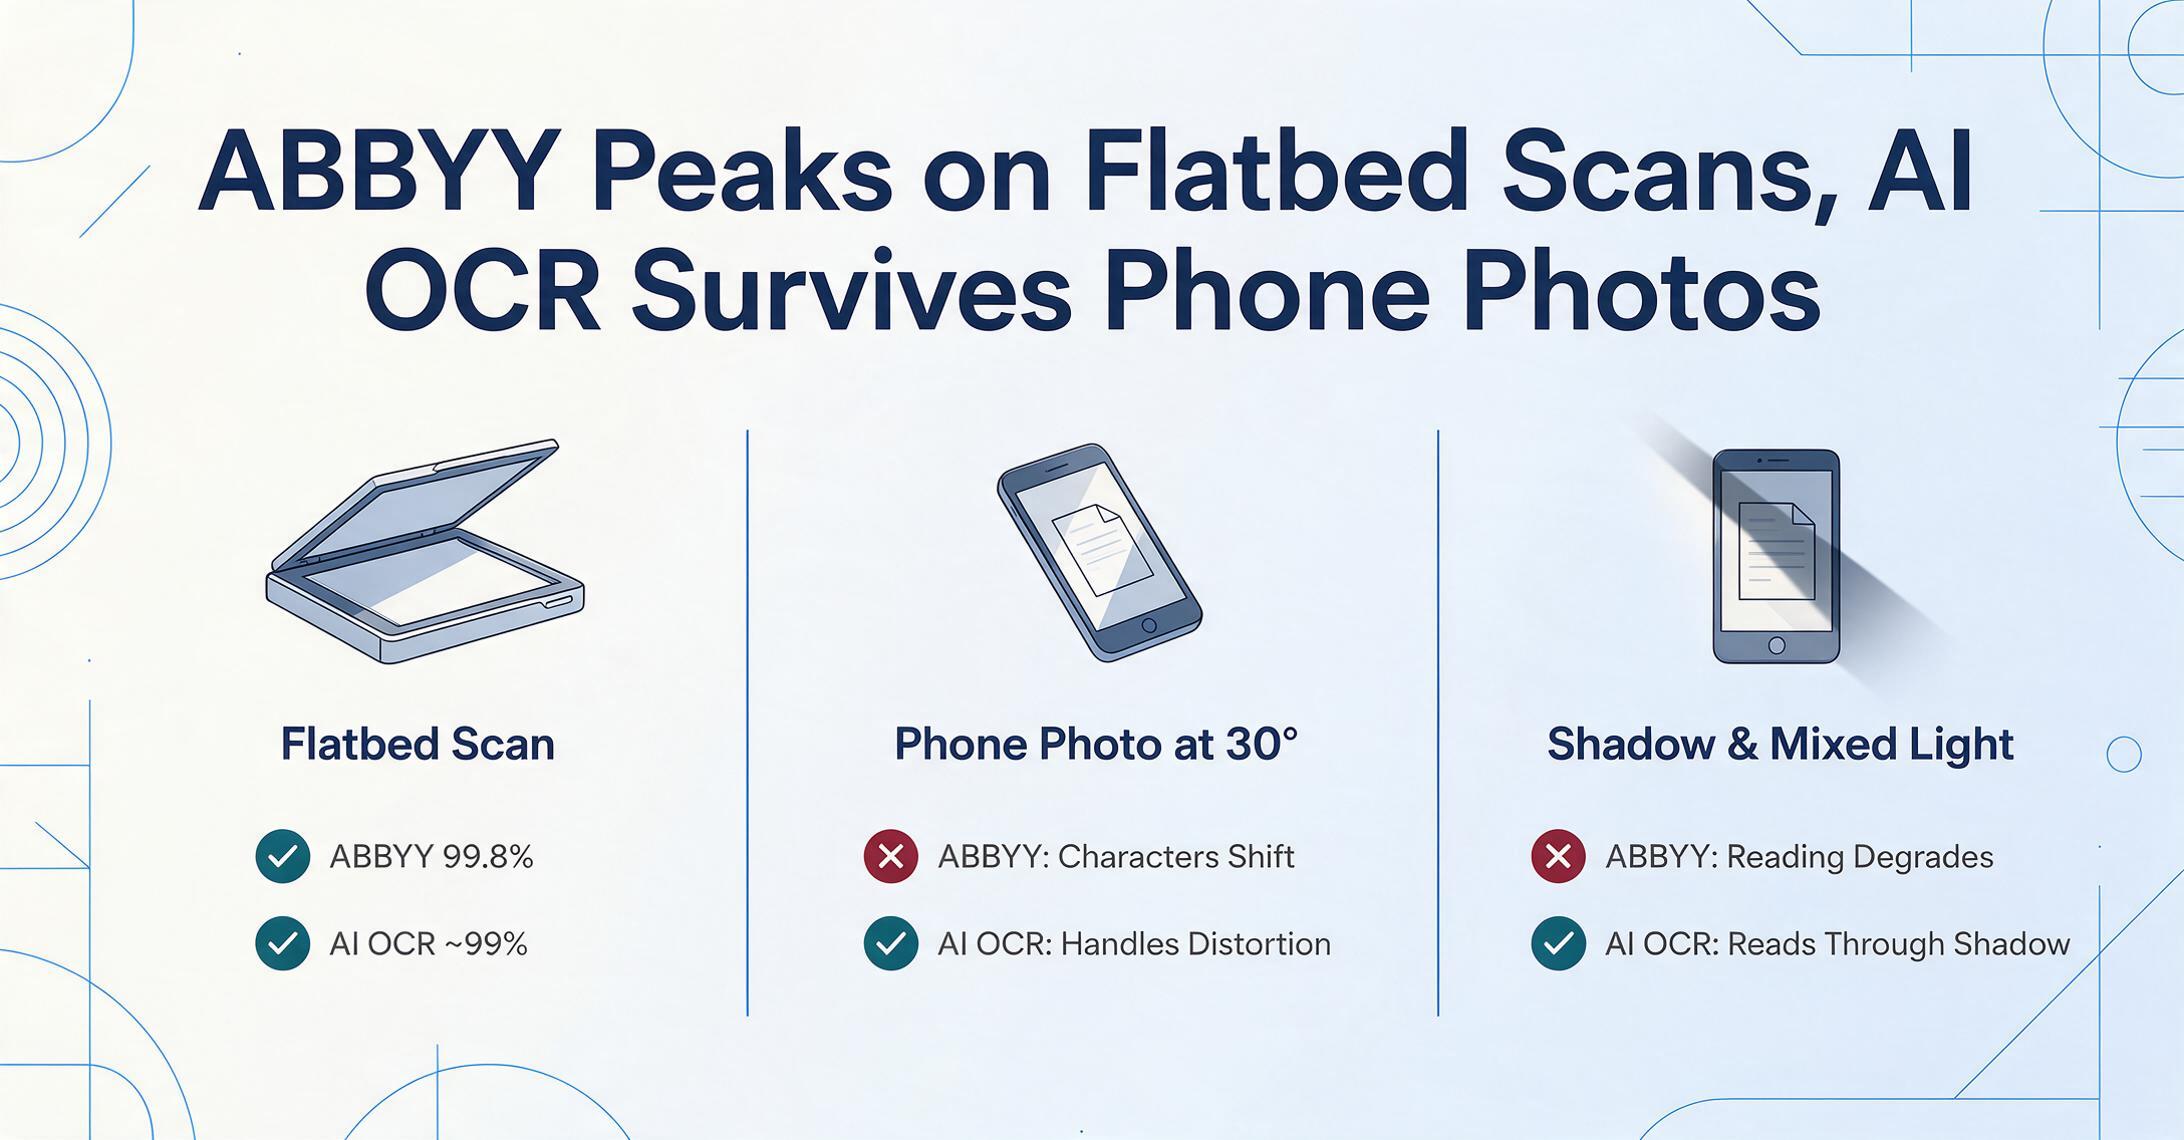
ABBYY FineReader wurde für die Ära der Flachbettscanner entwickelt. Scannerausgaben sind flach, gleichmäßig beleuchtet und verzerrungsfrei – ideal für den Abgleich von Zeichenmustern. Die Vorverarbeitungspipeline setzt diese Bedingungen voraus. Geben Sie FineReader ein Handyfoto, das in einem 30-Grad-Winkel unter Bürobeleuchtung aufgenommen wurde, und die Ergebnisse verschlechtern sich spürbar. Perspektivische Verzerrung verändert die Zeichenformen. Ungleichmäßige Beleuchtung erzeugt Schattenverläufe. Das ist kein Alleinstellungsmerkmal von ABBYY – jede herkömmliche OCR-Engine teilt diese Einschränkung, weil Scannerqualität die Grundannahme bei ihrer Architektur war.
Moderne KI-OCR verwendet Vision-Language-Modelle, die auf unterschiedlichen Bildqualitäten trainiert wurden: Handyfotos, Webcam-Aufnahmen, Fotokopien und Screenshots neben Flachbettscans. Diese Modelle bewältigen perspektivische Verzerrung, weil sie Objekte im dreidimensionalen Raum verstehen. Sie lesen durch Schatten hindurch, weil sie während des Trainings tausende schattiger Dokumente gesehen haben. Für Teams, deren Dokumente per mobiler Erfassung eintreffen – Außendienstmitarbeiter fotografieren Standortprotokolle, Mitarbeiter reichen Spesenbelege ein, Vertriebsmitarbeiter scannen Verträge beim Kunden – ist dieser Unterschied entscheidend. Ein Tool, das Scannerqualität voraussetzt, kann einen Mobile-First-Workflow nicht unterstützen, egal wie genau es bei Flachbettscans ist.
Dimension 5: Preisvergleich der Modelle
Ein ehrlicher Preisvergleich erfordert, ABBYYs Desktop-Produkte von seinen Enterprise-Plattformen zu trennen – sie bedienen völlig unterschiedliche Betriebsgrößen.
ABBYY FineReader Desktop: 99 $/Jahr (Standard) oder 165 $/Jahr (Corporate) für Windows, 69 $/Jahr für Mac. Einzelplatzlizenzen für eine PDF-Bearbeitungs- und OCR-Suite. Die Extraktion ist manuell: Öffnen Sie jede Datei, führen Sie die OCR aus, prüfen Sie die Tabellenerkennung, exportieren Sie, wiederholen Sie den Vorgang.
ABBYY Enterprise (Vantage, FlexiCapture): Individuelle Preisgestaltung. Daten von Drittanbietern zur Beschaffung beziffern Mid-Market-Bereitstellungen auf 40.000–100.000 $ pro Jahr, während Enterprise-Deals zwischen 100.000 und 300.000 $ pro Jahr liegen. Implementierungsdienste kosten zusätzlich 20.000–150.000 $. Die jährliche Wartung für On-Premise-Bereitstellungen beträgt 18–22 % der Lizenzkosten.
Moderne KI-OCR: Kostenlose Testversion; kostenpflichtige Tarife ab 9 $/Monat (150 Seiten) bis 59 $/Monat (1.000 Seiten); nutzungsbasierte Abrechnung ab 6 $ für 50 Seiten. Keine Implementierungsgebühren, keine jährliche Wartung. Der KI-OCR-Tarif umfasst Batch-Verarbeitung, semantische Extraktion und Zusammenführung von Ergebnissen – Funktionen, die in ABBYYs Ökosystem die Corporate-Stufe oder Enterprise-Produkte erfordern.
Die eigentliche Frage ist nicht „welches kostet weniger“, sondern „welches Preismodell passt zu Ihrem Dokumentvolumen und Ihrer Dokumentvielfalt“. Für ein einzelnes Format und hohe Volumina könnte ABBYYs Pro-Sitz-Modell wirtschaftlicher sein. Ein Team mit mehreren Formaten und moderatem Volumen wird bei KI-OCR mit Sicherheit das günstigere Modell pro Seite finden – sowohl bei den direkten Kosten als auch beim Betriebsaufwand.
Nachdem alle fünf Dimensionen dargelegt sind, lautet die Frage nicht mehr „was ist besser“, sondern „was passt zu Ihrer spezifischen Dokumentenverarbeitungs-Realität“.
Wann ABBYY die bessere Wahl ist
ABBYY bleibt die richtige Wahl für spezifische Szenarien, in denen zeichengenaue Präzision und Layout-Treue nicht verhandelbar sind.
- Digitalisierung von Papierarchiven. Die Umwandlung Tausender historischer Dokumente in durchsuchbare PDFs mit exakter visueller Wiedergabe – FineReaders Layout-Erhalt und Vorverarbeitung sind genau dafür konzipiert.
- Festes Format, ein Anbieter. Stabile Dokumentformate bekannter Anbieter machen die anfängliche Vorlageninvestition lohnenswert.
- Mehrsprachige Archive. ABBYYs Unterstützung von 201 Sprachen, einschließlich CJK, Arabisch und Kyrillisch, ist wirklich unübertroffen.
- On-Premise-Sicherheitsanforderungen. Rüstungsunternehmen, Regierungsbehörden und regulierte Finanzinstitute können FlexiCapture oder FineReader Server on-premise bereitstellen.
- PDF-Lebenszyklus-Management. Dokumentenvergleich, Schwärzung, digitale Signaturen und PDF/A-Archivierung neben OCR – FineReader ist eine vollständige PDF-Suite.
Wann moderne KI-OCR mehr Sinn ergibt
KI-OCR ist die bessere Wahl für die meisten Teams, deren Anforderungen an die Dokumentenverarbeitung sich von „Papier digitalisieren“ zu „strukturierte Daten aus verschiedenen Quellen extrahieren“ verschoben haben.
- Verarbeitung mehrerer Anbieter und Formate. Wenn Sie Dokumente von Dutzenden Anbietern erhalten, jeder mit eigenem Layout, ist der Ansatz der KI-OCR ohne Vorlage grundlegend zuverlässiger. Formatänderungen, die eine ABBYY-Vorlage brechen würden, sind für die semantische Extraktion unsichtbar.
- Handyfotos und mobile Erfassungsworkflows. Außendienstteams, Spesenabrechnungen, Baustelleninspektionen – KI-OCR verarbeitet diese Bilder zuverlässig, da sie mit mobil erfassten Daten trainiert wurde. Hier ist die Technologielücke zwischen herkömmlicher OCR und KI-OCR am größten.
- Self-Service-Datenextraktion. Keine Installation, keine Vorlagenkonfiguration, keine Schulungen. Das Tool ist für die Person entwickelt, die die Daten benötigt, nicht für IT-Administratoren.
- Batch-Extraktion in strukturierte Ausgabe. Mehrere Dokumente hochladen, eine ausgerichtete Tabelle erhalten. Jede Datei befüllt dieselbe Struktur, die durch die Spaltennamen des Benutzers definiert ist. Diese Funktion ist bei KI-OCR Standard, erfordert bei ABBYY jedoch die Corporate-Stufe oder ein Enterprise-Produkt.
- Gemischte Dokumenttypen in einem Batch. Rechnungen, Bestellungen und Kontoauszüge zusammen – keine separaten Vorlagen oder Durchläufe nötig. Die KI identifiziert den Typ jedes Dokuments und extrahiert relevante Felder in eine einheitliche Tabelle.
Das Fazit
Die ehrliche Antwort ist ein Entscheidungsrahmen, der auf Ihrer Dokumentmischung basiert, nicht eine einzelne Empfehlung. ABBYY und moderne KI-OCR sind parallele Technologien, die für unterschiedliche Verarbeitungsrealitäten optimiert sind. Die richtige Wahl hängt von drei Fragen ab:
1. Wie viele verschiedene Dokumentlayouts verarbeiten Sie?
Ein oder zwei stabile Formate mit hohem Volumen → ABBYYs Vorlagenansatz funktioniert gut. Dutzende oder Hunderte verschiedener Formate → der Ansatz der KI-OCR ohne Vorlage ist zuverlässiger und günstiger zu warten.
2. Woher stammen Ihre Dokumente?
Flachbettscans mit kontrollierter Beleuchtung → ABBYY arbeitet auf seinem Höchstniveau. Handyfotos, Aufnahmen bei gemischtem Licht und Screenshots → KI-OCR verarbeitet diese natürlich.
3. Was benötigen Sie aus den extrahierten Daten?
Durchsuchbare PDFs mit exakter visueller Wiedergabe → ABBYY glänzt. Strukturierte Tabellendaten, in einer Tabelle zusammengeführt → KI-OCR (von Anfang an dafür entwickelt) ist das richtige Werkzeug.
Für viele Organisationen ist die optimale Einrichtung ein Hybrid: Nutzen Sie ABBYY FineReader für die Digitalisierung in Archivqualität, bei der Layouttreue entscheidend ist, und moderne KI-OCR für die tägliche Datenextraktion aus Rechnungen, Formularen und Belegen – besonders wenn diese Dokumente per Handy aus mehreren Quellen eintreffen. Wenn Sie bereit sind, die führenden KI-OCR-Tools miteinander zu vergleichen, deckt unser Überblick über die besten KI-OCR-Software acht davon nach Preis, Genauigkeit und Eignung ab.
Der Wandel von „alles scannen“ zu „die benötigten Daten extrahieren“ ist eine grundlegende Veränderung in der Nutzung von Dokumenten in Unternehmen. ABBYY bedient die erste Welt außergewöhnlich gut. Moderne KI-OCR ist gezielt für die zweite entwickelt. Die richtige Frage ist nicht, welches Werkzeug besser ist – sondern welche Art der Dokumentenverarbeitung Sie tatsächlich benötigen.
Häufig gestellte Fragen
Kann KI-OCR bei sauberen, gedruckten Dokumenten die Genauigkeit von ABBYY erreichen?
Bei sauber gescannten Dokumenten mit Standard-Schriftarten erreicht moderne KI-OCR eine Genauigkeit von etwa 99 % im Vergleich zu ABBYYs ~99,8 % – die Lücke existiert, ist aber schmal. Wo KI-OCR ABBYY oft übertrifft, ist die strukturelle Genauigkeit: das korrekte Erkennen von Tabellenstrukturen, Spaltenbeziehungen und Feld-Semantik in randlosen oder komplexen Layouts. Bei Handyfotos, schlecht gescannten Dokumenten oder Dokumenten mit gemischten Schriftarten übertrifft KI-OCR ABBYY in der Regel, da seine Vision-Modelle auf unterschiedlichsten Bildqualitäten trainiert wurden.
Verfügt ABBYY FineReader über KI-gestützte Funktionen?
ABBYY bezeichnet seine OCR-Engine als KI-basiert, da maschinelles Lernen für Zeichenerkennung und Layout-Analyse eingesetzt wird. Dies ist jedoch nicht dasselbe wie moderne KI-OCR. Die KI von ABBYY wird zur Verbesserung der Zeichenerkennung und der Vorverarbeitungspipeline eingesetzt – sie bietet kein semantisches Verständnis, keine Extraktion ohne Vorlage und keine kontextbezogene Dateninterpretation. Der Unterschied wird ausführlich in unserem Vergleich von OCR und KI-Extraktion erläutert.
Kann ich ABBYY FlexiCapture für die Dokumentenverarbeitung im Unternehmen durch KI-OCR ersetzen?
Das hängt von Ihren Anforderungen ab. Für die Datenextraktion aus Rechnungen, Belegen, Bestellungen und ähnlichen Geschäftsdokumenten – insbesondere aus unterschiedlichen Quellen – können moderne KI-OCR-Plattformen FlexiCapture zu einem Bruchteil der Kosten und Einrichtungszeit ersetzen. Wenn Ihr Workflow jedoch native SAP/Oracle-Integration, Dokumentenklassifizierung oder reine On-Premise-Verarbeitung mit strengen Datenresidenz-Kontrollen erfordert, bleiben die Enterprise-Produkte von ABBYY die richtige Wahl.
Kann ABBYY FineReader Handschrift erkennen?
ABBYY FineReader bietet begrenzte Handschrifterkennung und erreicht bei sauberer, isolierter Handschrift unter guten Bedingungen eine Genauigkeit von etwa 95 %. Bei Schreibschrift sinkt die Genauigkeit auf etwa 91,7 %. ABBYY unterstützt außerdem ICR (Intelligent Character Recognition) über seine Enterprise-Produkte. Bei gemischten Dokumenten mit Druck- und Handschrift oder unleserlicher Handschrift erzielen moderne KI-OCR-Tools mit Vision-Language-Modellen in der Regel höhere und konsistentere Genauigkeit, da sie Handschrift kontextuell interpretieren statt durch zeichenbasiertes Mustervergleichen.
Ist ABBYY FineReader als Cloud-Dienst verfügbar?
ABBYY FineReader PDF ist eine Desktop-Anwendung – es gibt keine Cloud- oder Browserversion. ABBYY bietet Cloud-OCR über separate Enterprise-Produkte an: das ABBYY Cloud OCR SDK (API-basiert, separat bepreist) und ABBYY Vantage (cloudbasierte IDP-Plattform mit individuellem Enterprise-Preis). Der Desktop-FineReader hat keine Browser-Oberfläche und keine REST API. Moderne KI-OCR-Tools sind dagegen von Natur aus cloud-nativ – sie funktionieren in jedem Browser auf jedem Gerät ohne Installation und enthalten REST-APIs in kostenpflichtigen Tarifen.
Testen Sie AI-OCR mit Ihren eigenen Dokumenten
Der zuverlässigste Weg, sich zwischen ABBYY und AI-OCR zu entscheiden, ist nicht das Lesen von Vergleichen – sondern das Testen beider Ansätze mit Ihren tatsächlichen Dokumenten. Laden Sie einen Batch mit Rechnungen, Belegen oder Formularen hoch, der Ihre reale Dokumentmischung repräsentiert. Sehen Sie, wie moderne semantische Extraktion mit randlosen Tabellen, Handyfotos und Multi-Format-Batches umgeht. Vergleichen Sie die Ausgabestruktur mit dem, was Sie derzeit von ABBYY erhalten – nicht nur die Genauigkeit, sondern auch, wie viel Nachbearbeitung Ihr Team noch leisten muss.
Kostenloser Gastmodus — kein Konto, keine Kreditkarte erforderlich.