ABBYY FineReader vs OCR IA moderne :
Précision héritée vs nouvelle flexibilité
ABBYY FineReader est le moteur de reconnaissance optique de caractères le plus précis jamais conçu pour les documents imprimés propres. L'OCR IA moderne — basée sur des modèles vision-langage plutôt que sur des algorithmes de correspondance de caractères — est la technologie d'extraction de données documentaires la plus flexible disponible aujourd'hui. Aucune de ces affirmations ne contredit l'autre, car ce ne sont pas des produits concurrents visant le même problème. Ce sont des outils différents pour des tâches de traitement de documents différentes, et le choix entre eux commence par la compréhension des types de documents que vous traitez réellement.
Points clés à retenir
- La précision de caractères de 99,8 % d'ABBYY est réelle et inégalée — mais un utilisateur de Capterra a constaté « de nombreux tableaux évidents non détectés », car lire correctement chaque lettre ne vous dit toujours pas quels chiffres appartiennent à quelle colonne de feuille de calcul.
- Le critère de précision sur lequel tous les fournisseurs d'OCR rivalisent cache un coût permanent : quelqu'un doit reconstruire les modèles à chaque fois qu'un fournisseur redessine sa facture, et dans les propres avis G2 d'ABBYY, « des changements simples nécessitent le support informatique ».
- Seules trois questions comptent — combien de variantes de mise en page vous traitez, si les documents arrivent par scanner ou par téléphone, et si vous avez besoin de PDF consultables ou d'une feuille de calcul structurée — et ABBYY et l'OCR IA remportent des réponses opposées à chacune.
Comparaison rapide
Le tableau ci-dessous résume comment ABBYY FineReader et les outils OCR IA modernes se comparent sur les cinq dimensions les plus importantes lors du choix d'une approche d'extraction de documents. Chaque dimension est détaillée dans les sections suivantes.
| Dimension | ABBYY FineReader | OCR IA moderne |
|---|---|---|
| Précision sur les documents à format fixe | 99,8 % sur des documents numérisés propres — précision au niveau des caractères, leader du secteur | ~99 % sur du texte imprimé — rattrape son retard sur la précision des caractères, gagne sur la structure des tableaux |
| Flexibilité avec des formats variés | OCR par modèle/zone — chaque mise en page nécessite une configuration ; un changement de format casse le modèle | Sans modèle — s'adapte à toute mise en page en comprenant le sens, pas les positions des pixels |
| Temps de configuration et de paramétrage | Installation sur poste de travail + formation d'un modèle par format ; les déploiements en entreprise prennent des semaines | Basé sur navigateur, zéro configuration — téléversez un fichier, nommez vos colonnes, voyez les résultats en quelques secondes |
| Gestion des photos de téléphone vs numérisation à plat | Conçu pour la sortie de scanner à plat — a du mal avec la perspective, les ombres, la faible luminosité | Conçu pour la capture mobile — gère la distorsion, l'éclairage inégal, les arrière-plans mixtes |
| Modèle tarifaire | 99 $–165 $/an par poste (bureau) ; 40 000 $–300 000 $+/an pour les plateformes d'entreprise | Niveau invité gratuit ; forfaits payants de 9 $ à 59 $/mois ; paiement à l'utilisation à partir de 6 $/50 pages |
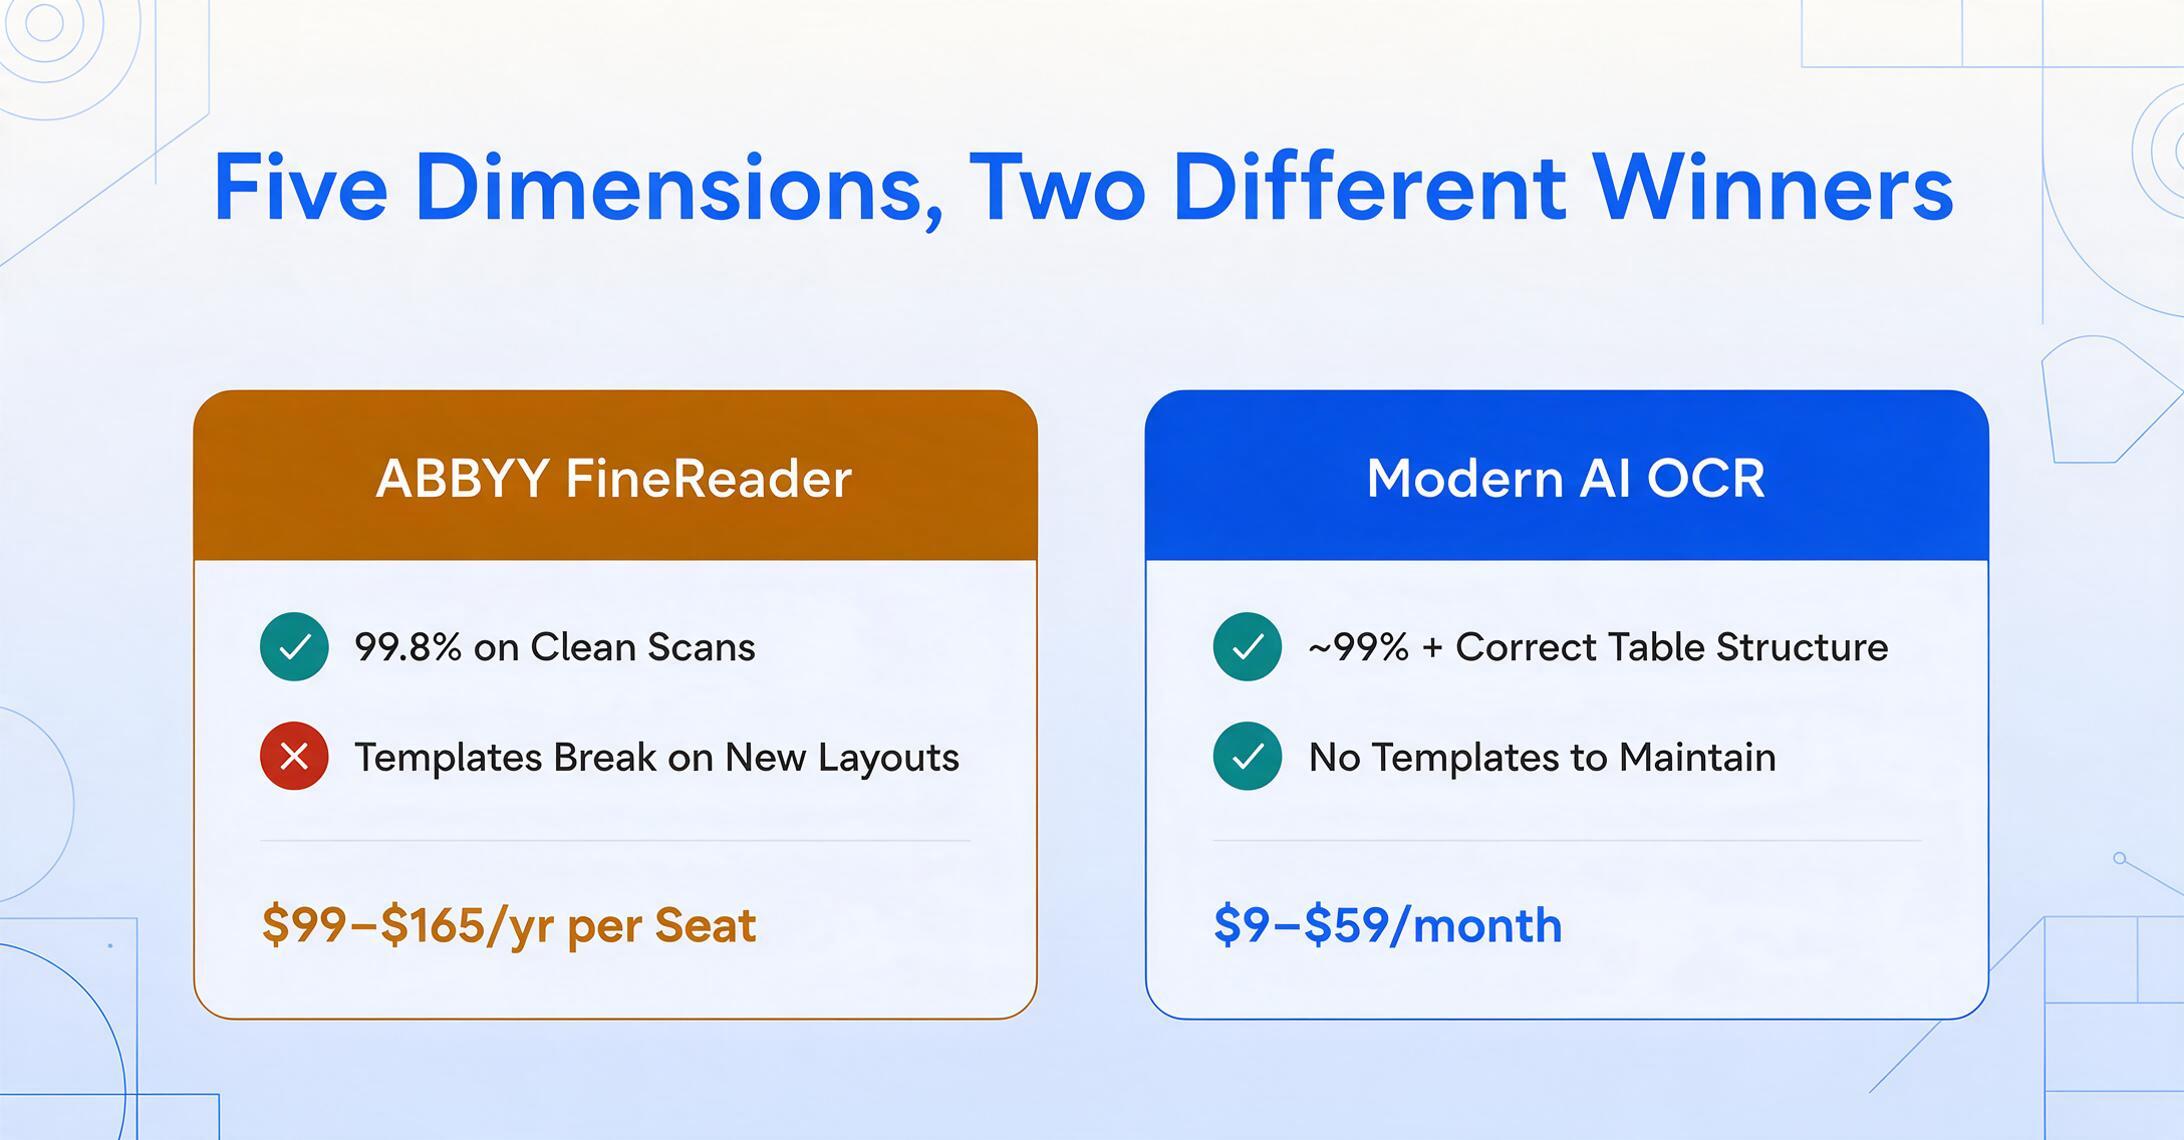
Chacune de ces dimensions raconte une partie différente de l'histoire. Celle qui compte le plus dépend entièrement des documents que vous traitez au quotidien.
Dimension 1 : Précision sur les documents à format fixe
ABBYY FineReader reste la référence absolue en matière de précision au niveau des caractères sur les documents propres, structurés et à format fixe, et cet avantage n'est pas imaginaire. Des tests indépendants font état de manière constante d'une précision de 99,8 % sur du texte imprimé dans des documents bien numérisés. Pour les contextes où une seule erreur de lecture a des conséquences — numérisation de documents juridiques, préservation d'archives, formulaires gouvernementaux — cette marge compte.
ABBYY y parvient grâce à un pipeline de reconnaissance mature — redressement, optimisation du contraste, recoupement multi-moteurs — affiné pendant des décennies. Sa prise en charge de 201 langues, dont le cyrillique, l'arabe, les caractères CJK et les écritures historiques, est inégalée sur le marché de l'OCR de bureau. La critique PCMag Editors' Choice note que FineReader « reste l'outil OCR le plus précis que nous ayons testé » — une réputation acquise grâce à un perfectionnement continu.
Mais il y a une nuance importante. La précision d'ABBYY se situe au niveau des caractères : il lit les bonnes lettres et les bons chiffres. Il ne comprend pas toujours la structure que ces caractères forment. Un avis Capterra le résume bien : « De nombreux tableaux évidents ne sont pas détectés par ABBYY lors de la conversion automatique, en particulier ceux sans lignes visibles. » Les caractères sont corrects. La structure du tableau est fausse. L'utilisateur doit encore réassembler les données manuellement.
L'OCR IA moderne utilise des modèles de vision-langage qui analysent l'image du document dans son ensemble — en lisant à la fois les caractères et les relations spatiales entre eux. Sur du texte imprimé propre, l'écart de précision au niveau des caractères avec ABBYY est faible (environ 99 % contre 99,8 %). Mais l'OCR IA excelle en matière de précision structurelle : il identifie correctement quels chiffres appartiennent à quelle colonne et distingue les totaux de facture des sous-totaux, même dans des tableaux sans bordures ou avec des cellules fusionnées.
À retenir : Sur la précision au niveau des caractères pour les documents numérisés propres, ABBYY conserve un léger avantage. Sur la précision structurelle — placer les données dans les bonnes colonnes — l'OCR IA surpasse souvent, en particulier sur les documents sans bordures explicites.
Dimension 2 : Flexibilité avec les formats variés
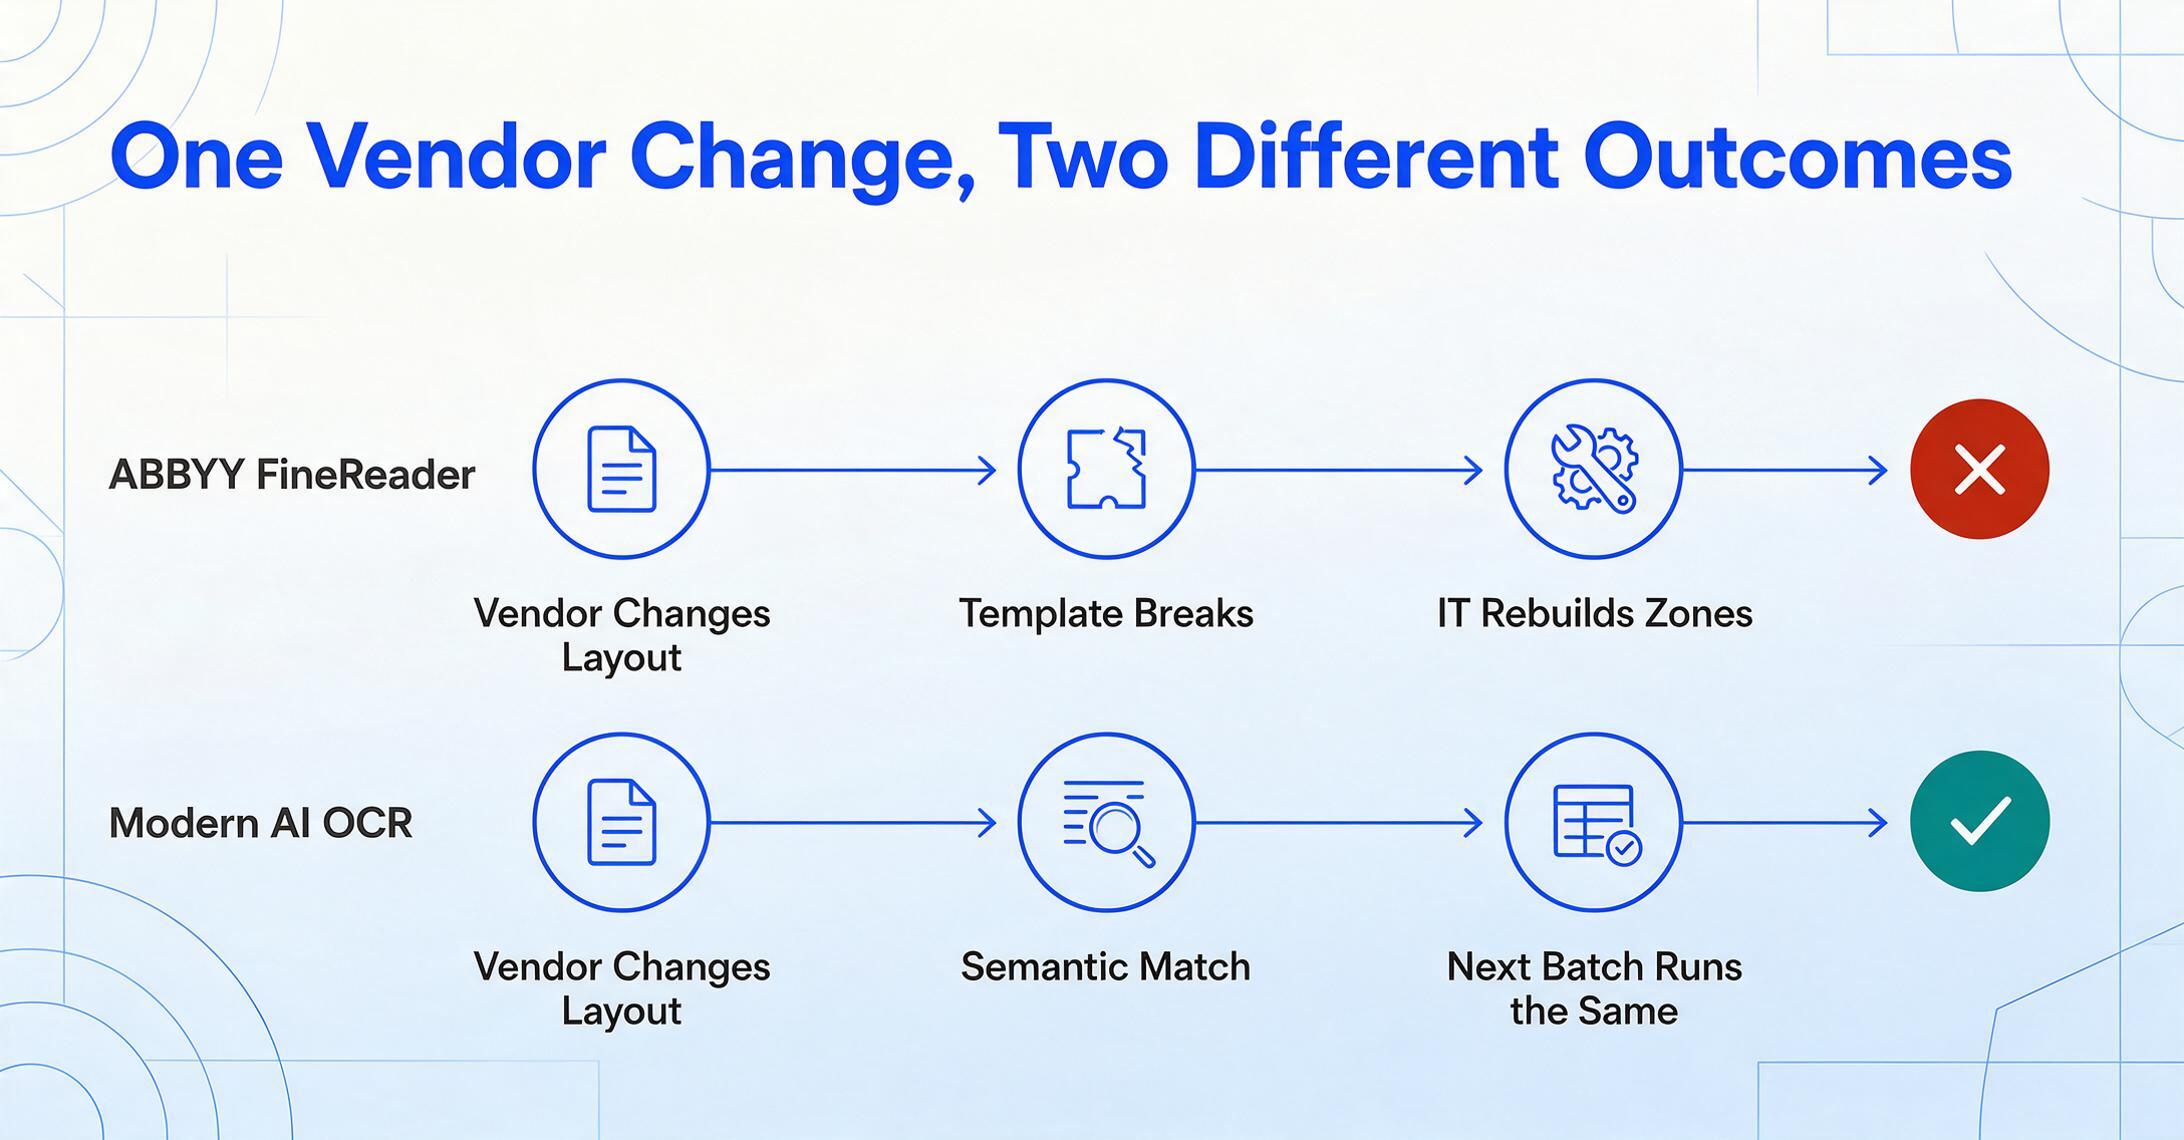
C’est ici que les deux paradigmes divergent le plus nettement. La dépendance aux modèles d’ABBYY est sa plus grande limite dans un monde multi-fournisseurs et multi-formats. L’approche sémantique de l’IA OCR a été conçue dès le départ pour gérer exactement ce problème.
Le moteur d’extraction d’ABBYY (FlexiCapture et Vantage) repose sur des modèles FlexiLayout : vous définissez des zones, des ancres, des coordonnées de champs et des règles d’extraction pour chaque mise en page unique. Lorsqu’un fournisseur met à jour la conception de sa facture ou renomme les en-têtes de colonnes, le modèle se brise. Une personne ayant une expertise technique doit ouvrir FlexiLayout Studio et ajuster les définitions de zones. Pour les équipes qui traitent des documents provenant de dizaines de fournisseurs, cela crée un tapis roulant de maintenance permanent. Les avis G2 d’ABBYY le confirment : « Les changements simples nécessitent le support informatique. »
L’IA OCR moderne élimine complètement ce problème. Elle utilise l’extraction sémantique : vous saisissez les noms de colonnes souhaités (Numéro de facture, Date, Total), et l’IA trouve les valeurs correspondantes en comprenant ce que ces termes signifient sur la page — et non en faisant correspondre des coordonnées de pixels à partir d’un modèle prédéfini. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre feuille de calcul de sortie. Cela fonctionne de manière identique, que le document soit une facture, un bon de commande ou un relevé bancaire.
La conséquence pratique : lorsqu’un fournisseur modifie son format, votre extraction continue de fonctionner. Pas de modèle à reconstruire, pas de zone à redessiner, pas de ticket informatique à soumettre. Le lot suivant est traité de la même manière que le précédent.
Dimension 3 : Temps de configuration et de mise en place
Le temps entre la décision et le premier résultat d'extraction varie d'un ordre de grandeur à l'autre — et cet écart reflète une différence structurelle dans la façon dont les deux approches sont conçues.
ABBYY FineReader sur ordinateur : téléchargement et installation (~30 minutes). Pour le traitement par lots avec modèles (Corporate ou FlexiCapture) : au moins une demi-journée par format de document pour créer et valider les modèles. Pour les déploiements en entreprise de Vantage ou FlexiCapture : 2 à 12 semaines avec des partenaires d'implémentation, plus 20 000 à 150 000 $ de services.
OCR IA moderne : ouvrez un navigateur. Téléversez un fichier. Saisissez les colonnes souhaitées. Consultez les données extraites. Temps total écoulé : moins de 30 secondes. Aucune installation, aucun entraînement de modèle, aucun consultant. L'outil est conçu pour la personne qui a besoin des données — pas pour un administrateur informatique configurant une plateforme.
Cette différence de coût est directement liée à la dimension suivante, car le type de documents que vous traitez détermine si vous avez besoin d'un prétraitement de niveau bureau ou si vous pouvez travailler directement avec des images capturées sur mobile.
Dimension 4 : Photos de téléphone vs numérisations à plat
La différence la moins discutée entre l'OCR traditionnel et l'OCR IA moderne réside dans la gestion de la source d'image — et c'est souvent ce qui détermine quel outil fonctionne réellement en pratique.
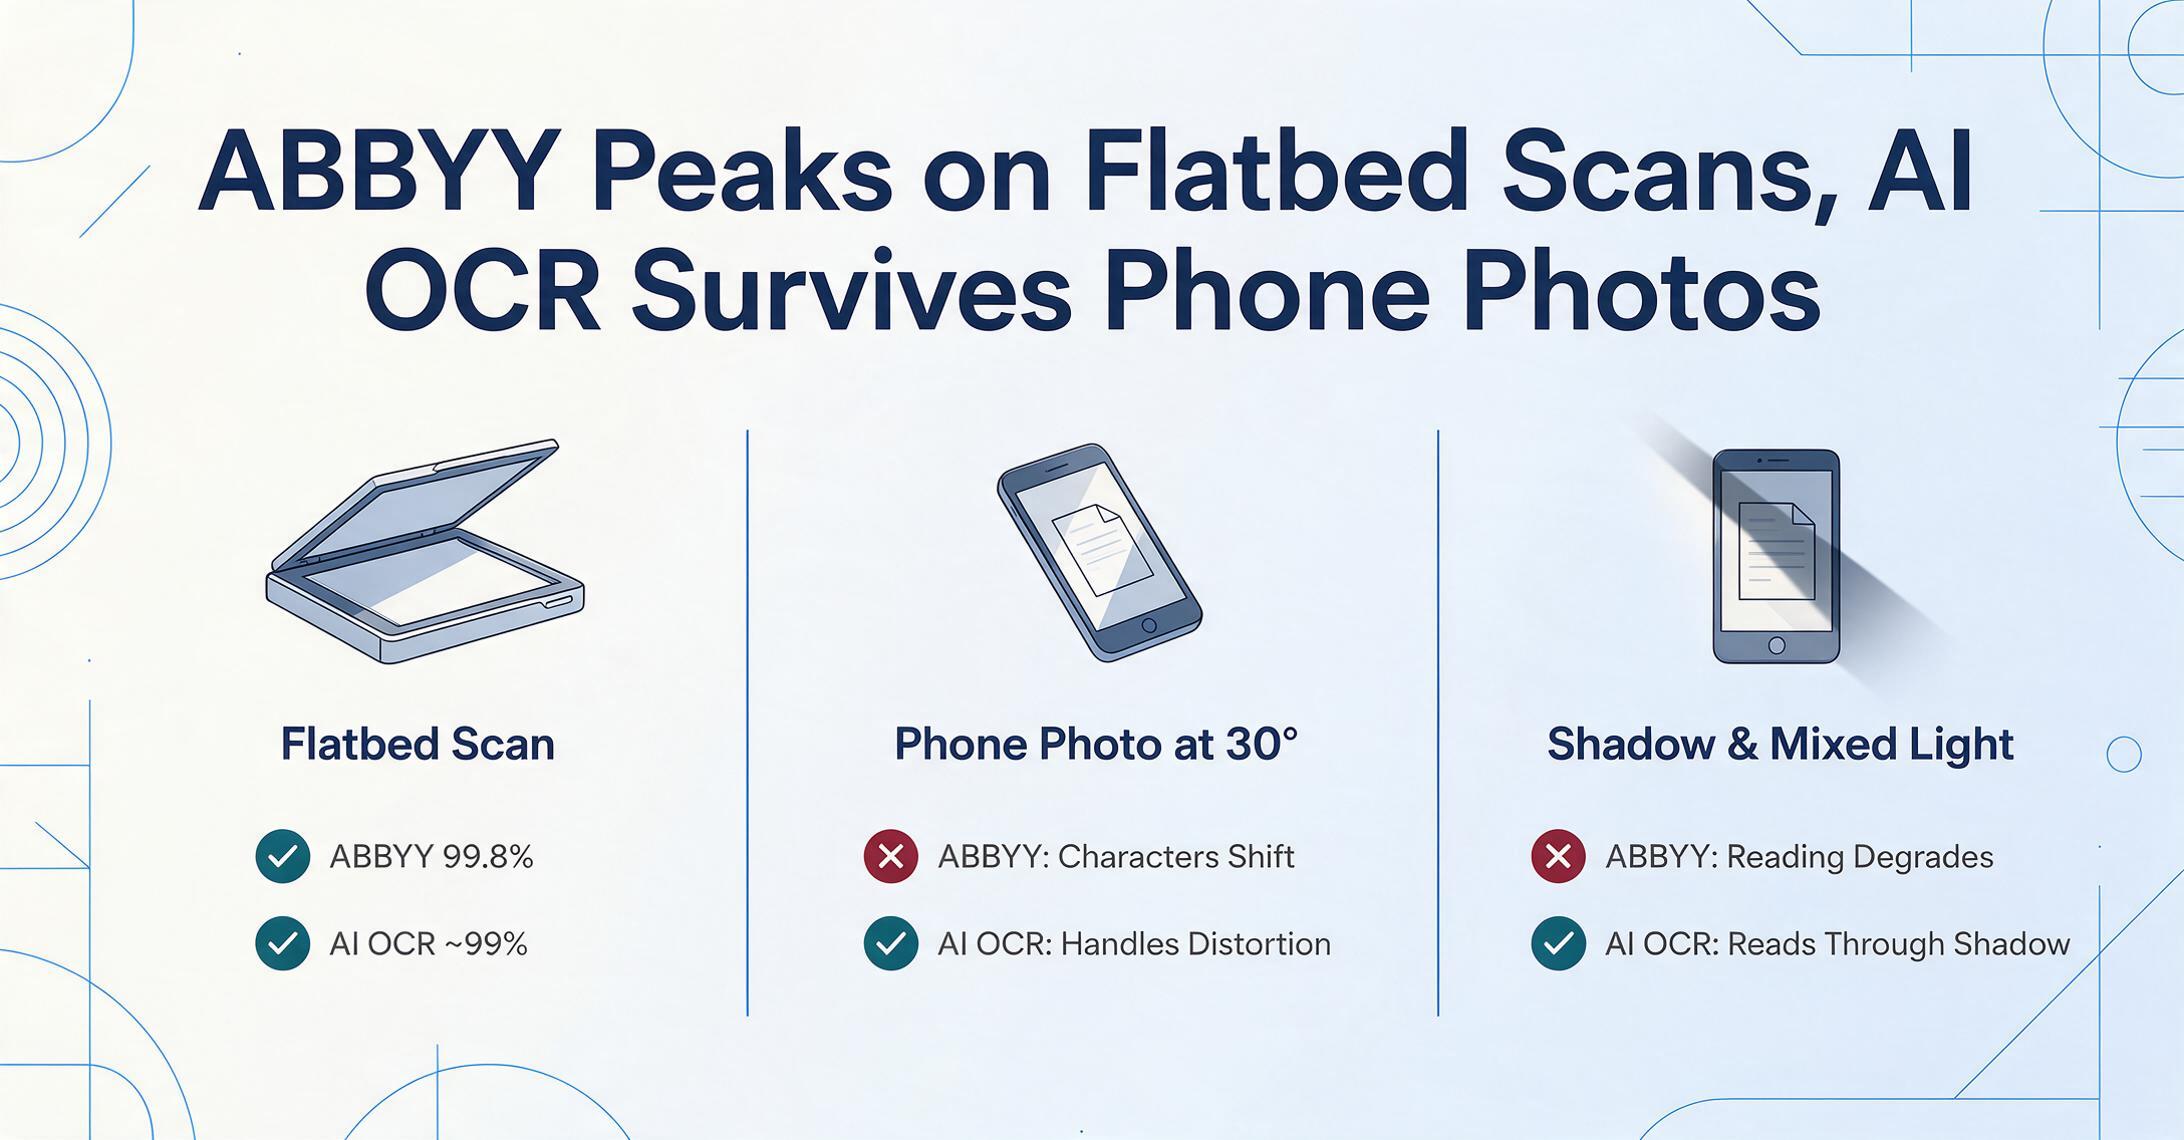
ABBYY FineReader a été conçu pour l'ère du scanner à plat. La sortie du scanner est plate, uniformément éclairée et sans distorsion — idéale pour la correspondance de motifs de caractères. Le pipeline de prétraitement suppose ces conditions. Donnez à FineReader une photo de téléphone prise à un angle de 30 degrés sous un éclairage de bureau, et les résultats se dégradent sensiblement. La distorsion de perspective modifie les formes des caractères. Un éclairage inégal crée des dégradés d'ombres. Ce n'est pas propre à ABBYY — tous les moteurs OCR traditionnels partagent cette limitation, car une entrée de qualité scanner était l'hypothèse de base lors de leur conception.
L'OCR IA moderne utilise des modèles vision-langage entraînés sur diverses qualités d'image : photos de téléphone, captures de webcam, photocopies et captures d'écran, en plus des numérisations à plat. Ces modèles gèrent la distorsion de perspective car ils comprennent les objets dans un espace tridimensionnel. Ils lisent à travers les ombres car ils ont vu des milliers de documents ombragés pendant l'entraînement. Pour les équipes dont les documents arrivent via capture mobile — inspecteurs de terrain photographiant des journaux de chantier, employés soumettant des reçus de dépenses, représentants commerciaux numérisant des contrats chez les clients — cette différence est décisive. Un outil qui exige une entrée de qualité scanner ne peut pas soutenir un flux de travail mobile-first, quelle que soit sa précision sur les numérisations à plat.
Dimension 5 : Comparaison des modèles tarifaires
Une comparaison honnête des prix nécessite de séparer les produits de bureau d'ABBYY de ses plateformes d'entreprise — ils servent des échelles d'exploitation complètement différentes.
ABBYY FineReader de bureau : 99 $/an (Standard) ou 165 $/an (Corporate) pour Windows, 69 $/an pour Mac. Licences mono-poste pour une suite d'édition PDF et d'OCR. L'extraction est manuelle : ouvrir chaque fichier, exécuter l'OCR, vérifier la détection des tableaux, exporter, répéter.
ABBYY entreprise (Vantage, FlexiCapture) : tarification personnalisée. Les données d'approvisionnement tierces situent les déploiements de milieu de gamme entre 40 000 $ et 100 000 $ par an, avec des contrats d'entreprise allant de 100 000 $ à 300 000 $ par an. Les services d'implémentation ajoutent 20 000 $ à 150 000 $. La maintenance annuelle pour les déploiements sur site représente 18 à 22 % du coût de la licence.
OCR IA moderne : niveau invité gratuit ; forfaits payants à partir de 9 $/mois (150 pages) jusqu'à 59 $/mois (1 500 pages) ; paiement à l'utilisation à partir de 6 $ pour 50 pages. Pas de frais d'implémentation, pas de maintenance annuelle. Le forfait OCR IA inclut le traitement par lots automatisé, l'extraction sémantique et la fusion Excel — des capacités qui nécessitent le niveau Corporate ou les produits d'entreprise dans l'écosystème d'ABBYY.
La vraie question n'est pas « lequel coûte moins cher » mais « quel modèle tarifaire correspond à votre volume et à votre variété de documents ». Une opération à format unique et à volume élevé pourrait trouver le modèle par poste d'ABBYY plus économique. Une équipe multi-fournisseurs à volume modéré trouvera presque certainement le modèle par page de l'OCR IA moins cher, tant en coût direct qu'en frais opérationnels.
Les cinq dimensions étant exposées, la question devient non pas « lequel est meilleur » mais « lequel correspond à votre réalité de traitement documentaire spécifique ».
Quand ABBYY a plus de sens
ABBYY reste le bon choix pour des scénarios spécifiques où la précision au niveau des caractères et la fidélité de la mise en page sont non négociables.
- Numérisation d'archives papier. Convertir des milliers de documents historiques en PDF consultables avec une reproduction visuelle exacte — la préservation de la mise en page et le prétraitement de FineReader sont conçus précisément pour cela.
- Traitement à format fixe et mono-fournisseur. Des formats de documents stables provenant de fournisseurs connus rendent l'investissement initial dans le modèle rentable.
- Archives multilingues. Le support de 201 langues d'ABBYY, y compris le CJK, l'arabe et le cyrillique, est véritablement inégalé.
- Exigences de sécurité sur site. Les entrepreneurs de la défense, les agences gouvernementales et les institutions financières réglementées peuvent déployer FlexiCapture ou FineReader Server sur site.
- Gestion du cycle de vie des PDF. Comparaison de documents, rédaction, signatures numériques et archivage PDF/A en plus de l'OCR — FineReader est une suite PDF complète.
Quand l’OCR IA moderne a plus de sens
L’OCR IA est le meilleur choix pour la plupart des équipes dont les besoins de traitement documentaire sont passés de « numériser du papier » à « extraire des données structurées de sources variées ».
- Traitement multi-fournisseurs et multi-formats. Lorsque vous recevez des documents de dizaines de fournisseurs, chacun avec sa propre mise en page, l’approche sans modèle de l’OCR IA est fondamentalement plus fiable. Les changements de format qui casseraient un modèle ABBYY sont invisibles pour l’extraction sémantique.
- Photos prises au téléphone et flux de capture mobile. Équipes terrain, rapports de frais, inspections sur site — l’OCR IA gère ces images de manière fiable car elle a été entraînée sur des données capturées sur mobile. C’est la dimension où l’écart technologique entre l’OCR hérité et l’OCR IA est le plus large.
- Extraction de données en libre-service. Pas d’installation, pas de configuration de modèle, pas de cours de formation. L’outil est conçu pour la personne qui a besoin des données, pas pour les administrateurs informatiques.
- Extraction par lots vers une sortie structurée. Téléchargez plusieurs documents, obtenez une feuille de calcul alignée. Chaque fichier remplit la même structure définie par les noms de colonnes de l’utilisateur. Cette capacité est standard dans l’OCR IA mais nécessite le niveau Corporate ou un produit entreprise dans la gamme ABBYY.
- Types de documents mixtes dans un même lot. Factures, bons de commande et relevés bancaires ensemble — aucun modèle ni exécution séparée requis. L’IA identifie le type de chaque document et extrait les champs pertinents dans un tableau unifié.
Le verdict
La réponse honnête est un cadre de décision basé sur votre mix de documents, pas une recommandation unique. ABBYY et l’OCR IA moderne sont des technologies parallèles optimisées pour différentes réalités de traitement. Le bon choix dépend de trois questions :
1. Combien de mises en page de documents différentes traitez-vous ?
Un ou deux formats stables avec un volume élevé → l’approche par modèle d’ABBYY fonctionne bien. Des dizaines ou des centaines de formats variés → l’approche sans modèle de l’OCR IA est plus fiable et moins coûteuse à maintenir.
2. D’où viennent vos documents ?
Numérisations à plat avec éclairage contrôlé → ABBYY fonctionne à son meilleur niveau. Photos de téléphone, captures en lumière mixte et captures d’écran → l’OCR IA les gère naturellement.
3. Que retirez-vous des données extraites ?
PDF consultables avec reproduction visuelle exacte → ABBYY excelle. Données structurées en feuille de calcul fusionnées dans un seul tableau → l’OCR IA (conçue pour cela dès le départ) est l’outil approprié.
Pour de nombreuses organisations, la configuration optimale est hybride : utilisez ABBYY FineReader pour la numérisation de qualité archivistique où la fidélité de la mise en page compte, et utilisez l’OCR IA moderne pour l’extraction quotidienne de données à partir de factures, de formulaires et de reçus — surtout lorsque ces documents arrivent par téléphone depuis plusieurs sources. Si vous êtes prêt à comparer les principaux outils d’OCR IA entre eux, notre tour d’horizon des meilleurs logiciels d’OCR IA en couvre huit par prix, précision et adéquation.
Le passage de « tout numériser » à « extraire les données dont vous avez besoin » est un changement fondamental dans la manière dont les documents sont utilisés en entreprise. ABBYY sert exceptionnellement bien le premier monde. L'OCR IA moderne est spécialement conçue pour le second. La bonne question n'est pas de savoir quel outil est meilleur — c'est de savoir quel type de traitement de documents vous avez réellement besoin.
Questions fréquemment posées
L'OCR IA peut-il égaler la précision d'ABBYY sur des documents imprimés propres ?
Sur des documents numérisés propres avec des polices standard, l'OCR IA moderne atteint environ 99 % de précision, contre ~99,8 % pour ABBYY — l'écart existe mais reste mince. Là où l'OCR IA dépasse souvent ABBYY, c'est en précision structurelle : identification correcte de la structure des tableaux, des relations entre colonnes et de la sémantique des champs dans des mises en page sans bordures ou complexes. Sur les photos de téléphone, les numérisations de mauvaise qualité ou les documents avec des polices mixtes, l'OCR IA surpasse généralement ABBYY, car ses modèles de vision ont été entraînés sur des qualités d'image variées.
ABBYY FineReader comprend-il des fonctionnalités basées sur l'IA ?
ABBYY décrit son moteur OCR comme basé sur l'IA, car il utilise l'apprentissage automatique pour la reconnaissance de caractères et l'analyse de mise en page. Cependant, cela ne correspond pas à l'OCR IA moderne. L'IA d'ABBYY est appliquée à l'amélioration du pipeline de correspondance des caractères et de prétraitement — elle n'offre pas de compréhension sémantique, d'extraction sans modèle ni d'interprétation contextuelle des données. Cette distinction est abordée en détail dans notre comparaison OCR vs extraction IA.
Puis-je remplacer ABBYY FlexiCapture par l'OCR IA pour le traitement documentaire en entreprise ?
Cela dépend de vos besoins. Pour l'extraction de données à partir de factures, reçus, bons de commande et documents commerciaux similaires — surtout provenant de sources variées — les plateformes OCR IA modernes peuvent remplacer FlexiCapture à une fraction du coût et du temps de mise en place. Cependant, si votre flux de travail nécessite une intégration native SAP/Oracle, des flux de classification de documents ou un traitement uniquement sur site avec des contrôles stricts de résidence des données, les produits d'entreprise d'ABBYY restent le choix approprié.
ABBYY FineReader gère-t-il la reconnaissance de l'écriture manuscrite ?
ABBYY FineReader dispose de capacités limitées de reconnaissance de l'écriture manuscrite, avec une précision d'environ 95 % sur une écriture soignée et isolée dans de bonnes conditions. Sur l'écriture cursive, la précision chute à environ 91,7 %. ABBYY prend également en charge l'ICR (Intelligent Character Recognition) via ses produits d'entreprise. Cependant, pour les documents mixtes imprimés-manuscrits ou une écriture difficile, les outils OCR IA modernes utilisant des modèles vision-langage atteignent généralement une précision plus élevée et plus constante, car ils interprètent l'écriture de manière contextuelle plutôt que par correspondance de motifs au niveau des caractères.
ABBYY FineReader est-il disponible en tant que service cloud ?
ABBYY FineReader PDF est une application de bureau — il n'existe pas de version cloud ou navigateur. ABBYY propose des capacités OCR cloud via des produits d'entreprise distincts : ABBYY Cloud OCR SDK (basé sur API, facturé séparément) et ABBYY Vantage (plateforme IDP cloud avec tarification d'entreprise personnalisée). Le FineReader de bureau n'a ni interface navigateur ni API REST. Les outils OCR IA modernes, en revanche, sont conçus cloud-native — ils fonctionnent dans n'importe quel navigateur sur n'importe quel appareil sans installation, et incluent des API REST dans les formules payantes.
Essayez l'OCR IA sur vos propres documents
La façon la plus fiable de choisir entre ABBYY et l'OCR IA n'est pas de lire des comparatifs — c'est de tester les deux approches sur vos documents réels. Importez un lot de factures, reçus ou formulaires représentatifs de votre mix documentaire. Découvrez comment l'extraction sémantique moderne gère les tableaux sans bordures, les photos prises au téléphone et les lots multi-formats. Comparez la structure des résultats avec ce que vous obtenez actuellement d'ABBYY — non seulement la précision, mais aussi le temps de post-traitement que votre équipe doit encore y consacrer.
Mode invité gratuit — sans compte, sans carte de crédit.