Capturez le fabricant, le modèle et le numéro de série dans les PDF scannés et numériques
Le registre d'équipements alimenté par ce flux de travail n'est aussi fiable que ses colonnes de fabricant, de modèle et de numéro de série, et ces colonnes ne sont aussi fiables que la personne qui recopie le PDF. Sur les documents que vos clients et fournisseurs vous envoient, la chaîne du modèle se trouve généralement sous un en-tête imprimé au-dessus : le mot « Modèle » en haut d'une bande étroite, la valeur en dessous, « N° de série » faisant de même dans la bande suivante. Quiconque a déjà ouvert un tel document sait ce que sont ces champs. Le problème d'extraction est que la page ne donne rien à parcourir à un lecteur de tableaux basé sur les lignes, car il n'y a pas de structure de lignes à suivre.
Points clés à retenir
- Si votre registre continue de se tromper, l'instinct est de blâmer l'OCR (le lecteur de caractères), mais un tableau vertical ne donne rien à parcourir à un lecteur basé sur les lignes.
- La ressaisie d'une valeur à partir d'un document source présente un taux d'erreur de 6,57 pour cent, contre 0,29 pour cent pour la saisie avec la source directement sous les yeux.
- Nommez les colonnes une fois et ImageToTable.ai localise chaque valeur par son sens, de sorte que la disposition du prochain fournisseur n'est qu'une page de plus.
Le mode de défaillance est décrit avec précision par quelqu'un qui fait ce travail. Dans r/pdf, un utilisateur qui ouvre 10 à 100 PDF clients par jour a écrit : « Je traite entre 10 et 100 pages PDF par jour provenant de clients, où je dois extraire manuellement le fabricant, le modèle et le numéro de série dans un tableau. » Les pages, ajoute-t-il, « sont à la fois numérisées et classiques, et les PDF n'ont pas toujours le même format, ce qui peut compliquer les choses. Ils ont la plupart du temps des tableaux verticaux où le titre de la colonne est "serial" et les valeurs sont listées en dessous. » Un deuxième commentateur dans le même fil a répondu avant qu'aucune solution n'arrive : « Les tableaux verticaux sont toujours un casse-tête pour l'OCR standard. J'ai déjà eu affaire à des mises en page PDF désordonnées similaires » (r/pdf).
Le fabricant, le modèle et le numéro de série ne sont pas difficiles à repérer à l'œil nu. Ils sont difficiles à intégrer dans un registre sans étape de saisie, et les mises en page qui font échouer cette étape sont assez courantes pour être nommées.
Le lecteur concerné par ce problème est toute équipe qui doit tenir un registre et qui reçoit quotidiennement une pile de documents fournisseurs ou clients : fiches techniques d'équipement, photos de plaques signalétiques, catalogues, dossiers de maintenance et d'étalonnage. Les opérations, les achats, la gestion des actifs et le personnel financier qui réévalue les équipements touchent tous aux trois mêmes champs. Les noms varient, les formats ne correspondent jamais, et un registre n'accepte pas plus un numéro de série à moitié erroné qu'un numéro vide. Cet article examine où ce flux de travail se bloque réellement et ce qu'un passage d'extraction indépendant de la mise en page change.
Qui Fait Ce Travail, et Ce Qu'un Registre Exige de Lui
Le travail retombe sur un seul bureau même lorsque trois rôles touchent au résultat. Un coordonnateur de réception, un administrateur de service ou d'actifs, ou un gestionnaire de compte ouvre chaque PDF, lit les trois valeurs et les saisit dans une feuille qui devient le registre. Le registre lui-même est généralement un classeur Excel, qui est à un moment donné importé dans un GMAO ou interrogé pour des décisions de garantie, d'étalonnage et de remplacement. Les outils sur lesquels les praticiens exécutent réellement cette partie en aval incluent IBM Maximo, UpKeep, Fiix, Limble et eMaint, et chacun d'eux importe des lignes plutôt que des documents.
| Rôle | Ce qu'ils font concrètement | Où les données peuvent commencer à dériver |
|---|---|---|
| Coordonnateur de réception | Ouvre chaque PDF, lit le fabricant, le modèle et le numéro de série à l'œil nu, les saisit dans la feuille du registre | Saute une ligne, inverse des chiffres, copie depuis un scan basse résolution, lit l'en-tête comme une valeur |
| Responsable des actifs ou administrateur | Possède le registre, fait correspondre chaque ligne à une étiquette et un emplacement, prépare l'importation dans un GMAO | Se fie à la ligne saisie ; une discordance avec l'étiquette physique ne se révèle qu'à la vérification ou à l'audit |
| Finance et achats | Utilisent les enregistrements liés au numéro de série pour les réclamations de garantie, l'amortissement, la réapprovisionnement des pièces de rechange et les mises au rebut | Un mauvais numéro de série est un actif différent pour chaque système en aval, donc les recherches ne renvoient rien ou la mauvaise machine |
La pratique de l'enregistrement converge vers un petit ensemble de champs : fabricant, modèle, numéro de série, étiquette ou identifiant d'actif, emplacement et date d'installation. Un registre construit sur ces champs soutient les décisions de maintenance couvertes dans la transformation des journaux de maintenance en calendrier de maintenance préventive, et les mécanismes d'importation comptent, car une feuille pleine de valeurs presque correctes échoue encore à la frontière ERP, l'échec que notre guide sur pourquoi les feuilles de calcul propres sont rejetées par l'ERP détaille.
Un tableau vertical ne donne rien à parcourir à un lecteur basé sur les lignes
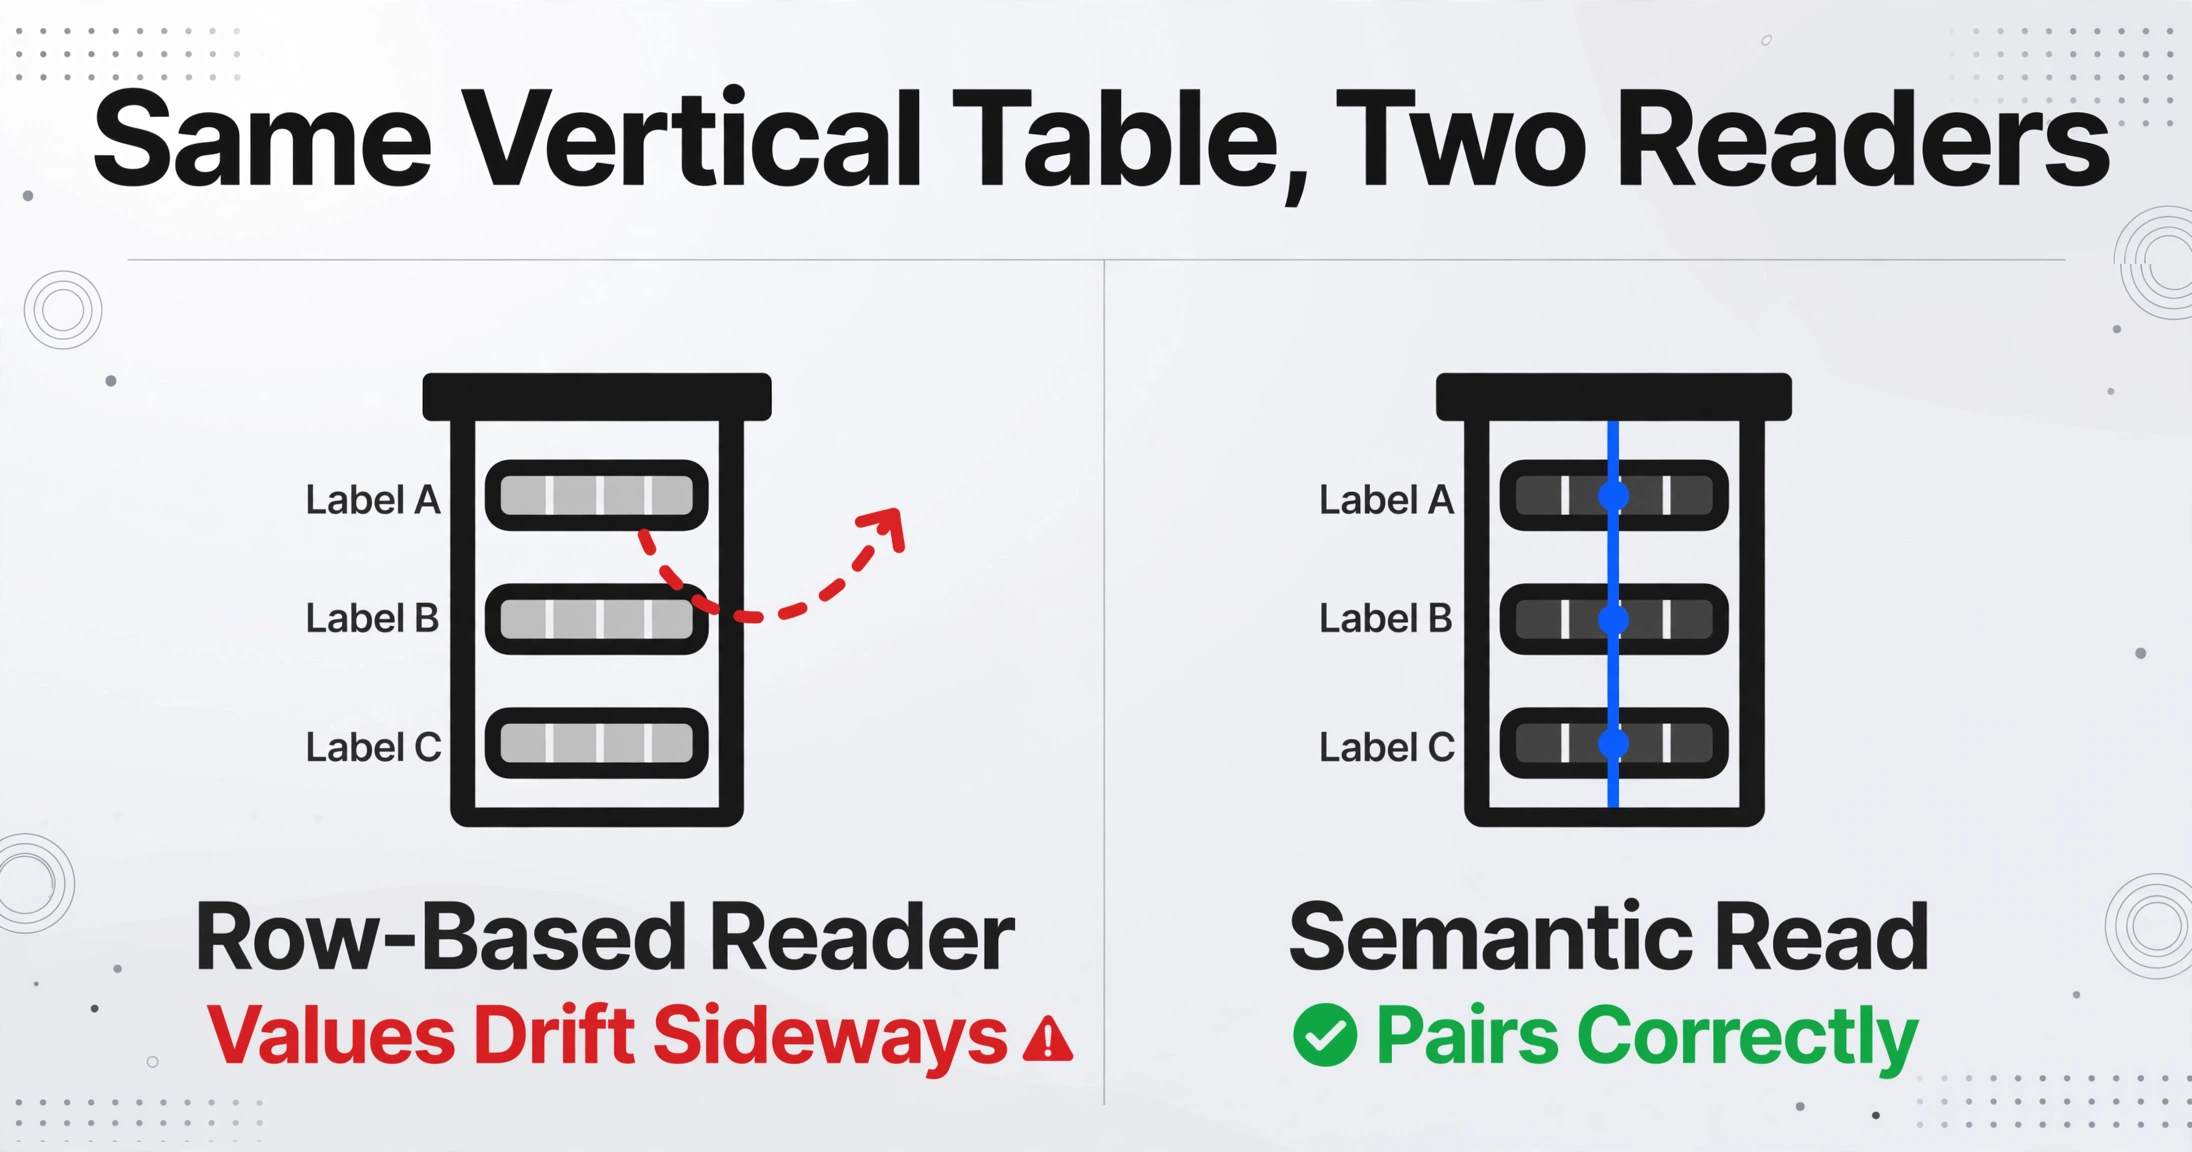
Un tableau vertical n'a pas de ligne par machine, donc un extracteur basé sur les lignes invente des lignes qui n'existent pas. La disposition décrite par l'affiche r/pdf, un en-tête imprimé au-dessus de ses valeurs avec plusieurs bandes de ce type côte à côte, est exactement la structure qui défait la reconstruction du tableau. Une personne lit la colonne des numéros de série sous l'en-tête N° de série et la colonne des chaînes de modèle sous Modèle. Un outil qui suppose une grille de gauche à droite associe plutôt chaque modèle au numéro de série qui le suit dans l'ordre de lecture, de sorte que les valeurs dérivent latéralement sur la page.
Les personnes qui construisent ce logiciel pour vivre disent la même chose sur leurs propres forums. Un développeur travaillant sur l'extraction de tableaux a résumé le paysage sur r/MachineLearning : « table transformer, paddleOCR, google doc AI, GOT OCR, GraphOCR, et beaucoup sont bons avec les structures de tableaux simples mais échouent à détecter et extraire les tableaux à structure complexe. » Un autre praticien dans le même fil a été plus direct : « C'est aussi mon expérience que tous les modèles publiés publiquement échouent complètement sur les tableaux complexes du monde réel » (r/MachineLearning). La raison pour laquelle l'échec est structurel et non un problème de précision OCR est énoncée clairement dans un fil sur l'extraction de tableaux : « L'OCR est bon pour les caractères, mais les tableaux concernent les relations (signification ligne/colonne/en-tête). La plupart des échecs sont structurels, pas un "mauvais OCR" » (r/founderledsales).
Une page peut contenir une machine ou une centaine. L'affiche r/pdf a noté 1 à 100 ensembles fabricant/modèle/numéro de série par page, ce qui signifie que l'extracteur ne peut pas supposer « une page, un actif ». Chaque ensemble de valeurs doit être localisé par rapport à sa propre étiquette, c'est là que l'échec devient coûteux : une ligne de registre construite à partir de deux colonnes qui ont dérivé a un modèle d'une machine et un numéro de série d'une autre, et rien dans la ligne ne semble anormal jusqu'à ce qu'une recherche échoue.
La numérisation ajoute une deuxième source d'erreur : les caractères eux-mêmes
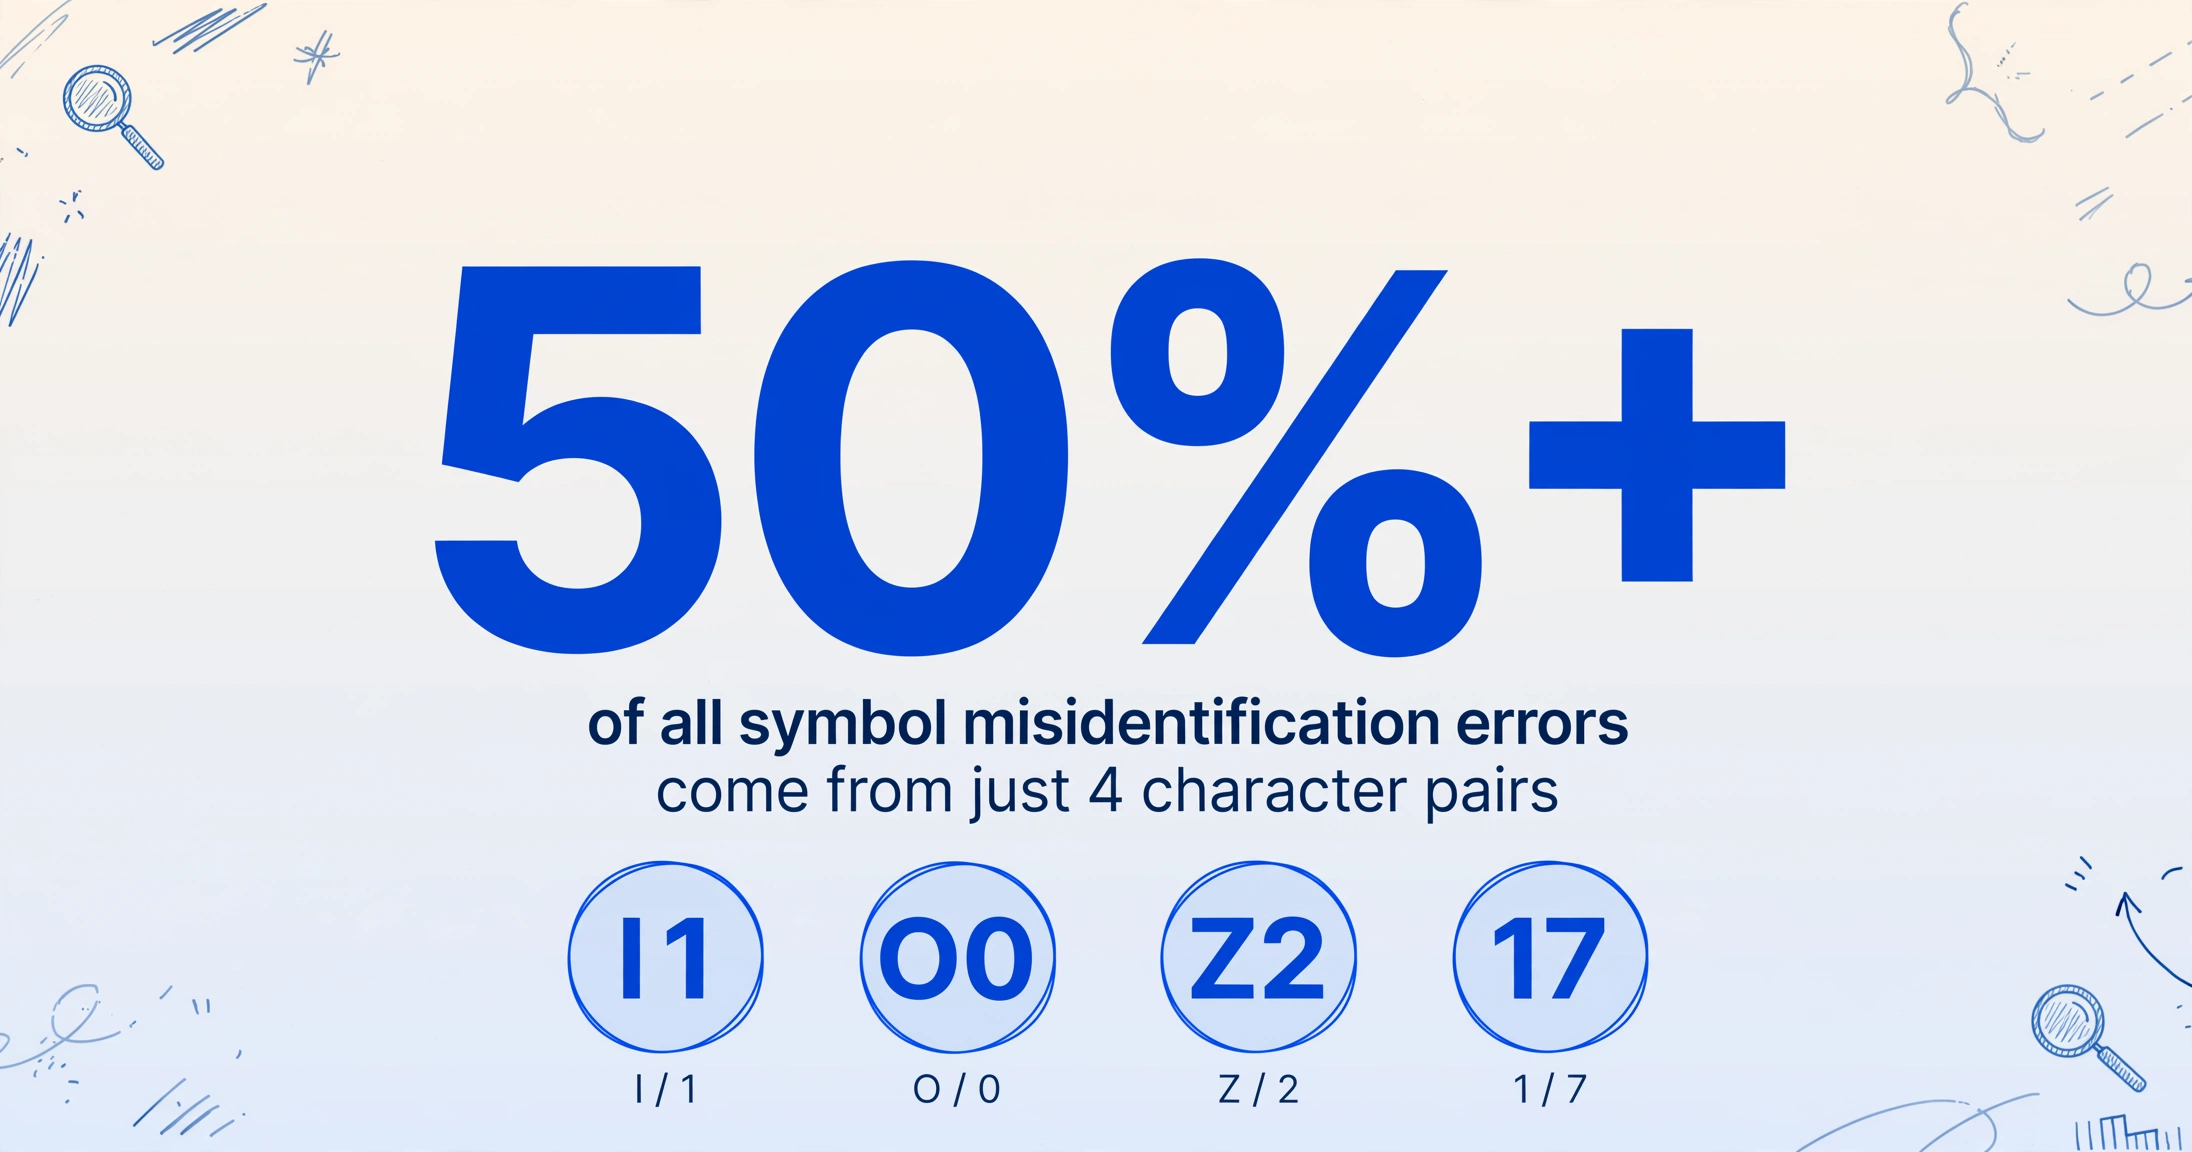
Une numérisation ajoute une deuxième source d'erreur en plus du problème de mise en page : les caractères peuvent être mal lus. Les numéros de série invitent à ce type d'erreur car ils sont courts, alphanumériques et volontairement riches en caractères à apparence similaire. La lettre O et le chiffre 0, le l minuscule et le chiffre 1, les lettres Z et 2, ainsi que B et 8 sont les paires classiques, et la recherche appliquée a documenté l'ampleur du phénomène : dans les travaux des Bell Laboratories encore cités dans la littérature médicale, les paires l/1, O/0, Z/2 et 1/7 représentaient plus de la moitié de toutes les erreurs de mauvaise identification de symboles (PMC5614409). Un seul caractère substitué dans un numéro de série en fait une chaîne différente, et une chaîne différente représente un actif différent pour chaque système en aval.
L'identifiant qui relie une machine à son historique dépend du maintien de l'intégrité de cette chaîne. Les spécifications générales GS1 définissent l'identifiant global d'actif individuel (GIAI) comme la clé numérique qui relie un actif à son propriétaire, son emplacement, sa valeur et ses enregistrements de cycle de vie, et elles précisent explicitement que le numéro de série du fabricant se trouve au centre de cet identifiant, qu'il ne doit pas changer pendant la durée de vie de l'actif, et que les variations de formatage telles que les traits d'union, les zéros de tête et la casse peuvent rompre une recherche (Spécifications générales GS1). L'observation du secteur situe le coût pratique au même endroit : les spécialistes des données de maintenance réparatrice (MRO) rapportent qu'une majorité d'enregistrements d'équipements industriels dans les ERP et GMAO sont incomplets, avec des détails techniques « piégés dans des documents PDF » qui n'ont jamais été extraits dans le système en premier lieu (Sharecat Data Services).
L'étape de saisie est celle qui concentre les erreurs. Une revue systématique de 2023 sur les méthodes de traitement des données dans la recherche clinique a mesuré exactement la tâche en question ici, lire une valeur à partir d'un document source et la saisir dans une base de données, et a regroupé le taux d'erreur de l'abstraction manuelle à partir des enregistrements sources à 6,57 %, contre 0,29 % pour la saisie directe unique avec la source devant l'opérateur (Garza et al., 2023). Lire et ressaisir à partir d'un document est mesurablement le chemin le plus sujet aux erreurs, c'est pourquoi l'exactitude d'un registre est décidée avant que la première formule ne s'exécute, par ce que la personne au bureau a copié.
Aucun fournisseur ne partage un format, et personne ne le contrôle
Chaque fournisseur imprime les trois mêmes champs selon une disposition différente, et le destinataire des documents n'a pas voix au chapitre. La communauté des recommandations sur les plaques signalétiques l'a documenté : UL 9691, la pratique recommandée pour les plaques signalétiques des équipements électriques, indique clairement que les informations des plaques signalétiques peuvent varier considérablement même entre des produits certifiés selon la même norme, et que « cette variabilité entraîne des difficultés sur le terrain, car chaque fabricant fournit les informations essentielles dans un format différent, selon son interprétation et son application des exigences » (UL 9691-2021).
Les champs eux-mêmes sont normalisés, même si les mises en page ne le sont pas. NFPA 79, la norme électrique pour les machines industrielles, exige une plaque signalétique portant le nom du fabricant, le modèle et le numéro de série sur les équipements de commande, entre autres marquages (NFPA 79), et le modèle d'identification des machines OPC UA traite le numéro de série comme une propriété obligatoire de toute identité de machine, unique dans le contexte de son fabricant et de son modèle (OPC UA 40001-1). Le contenu est réglementé. La disposition visuelle ne l'est pas, ce qui explique précisément pourquoi l'OCR basé sur des modèles continue de se briser : un modèle est une carte de l'emplacement d'un champ sur un format, et la dérive entre fournisseurs, voire entre révisions d'un même fournisseur, invalide la carte.
Les normes de gestion des actifs font peser la charge sur le registre plutôt que sur le document. ISO 55013:2024, le guide pour la gestion des données dans un contexte de gestion des actifs, exige que les organisations spécifient des exigences de qualité pour les données d'actifs, notamment l'exactitude, l'exhaustivité, la cohérence et l'actualité, et qu'elles comprennent la qualité des données avant de les utiliser pour des décisions (ISO 55013:2024). En pratique, cette clause signifie que le registre a une exigence d'exactitude documentée, et que la voie de saisie manuelle doit être mesurée par rapport à celle-ci. Les mécanismes génériques de conversion de documents numérisés sont couverts dans l'extraction de PDF numérisés vers une feuille de calcul et l'approche d'extraction de tableaux qui fonctionne pour les mises en page plus simples.
La solution : dites ce que vous voulez, pas où cela se trouve
La solution consiste à extraire par le sens plutôt que par la position. Extraction de colonnes personnalisées fonctionne à l'inverse des modèles : vous saisissez les noms de colonnes souhaités, fabricant, modèle et numéro de série, et l'IA localise chaque valeur dans le document en comprenant ce que signifie le champ, plutôt qu'en faisant correspondre une zone fixe ou un modèle. Les noms de colonnes que vous saisissez deviennent les en-têtes exacts du tableau de sortie. Comme la recherche est sémantique, la mise en page cesse d'importuner : l'en-tête Numéro de série au-dessus de ses valeurs est lu comme l'étiquette qu'il est, et les valeurs en dessous atterrissent dans la colonne numéro de série, que la page soit une bande verticale ou trois, que le texte soit au-dessus, en dessous ou à côté de l'étiquette.
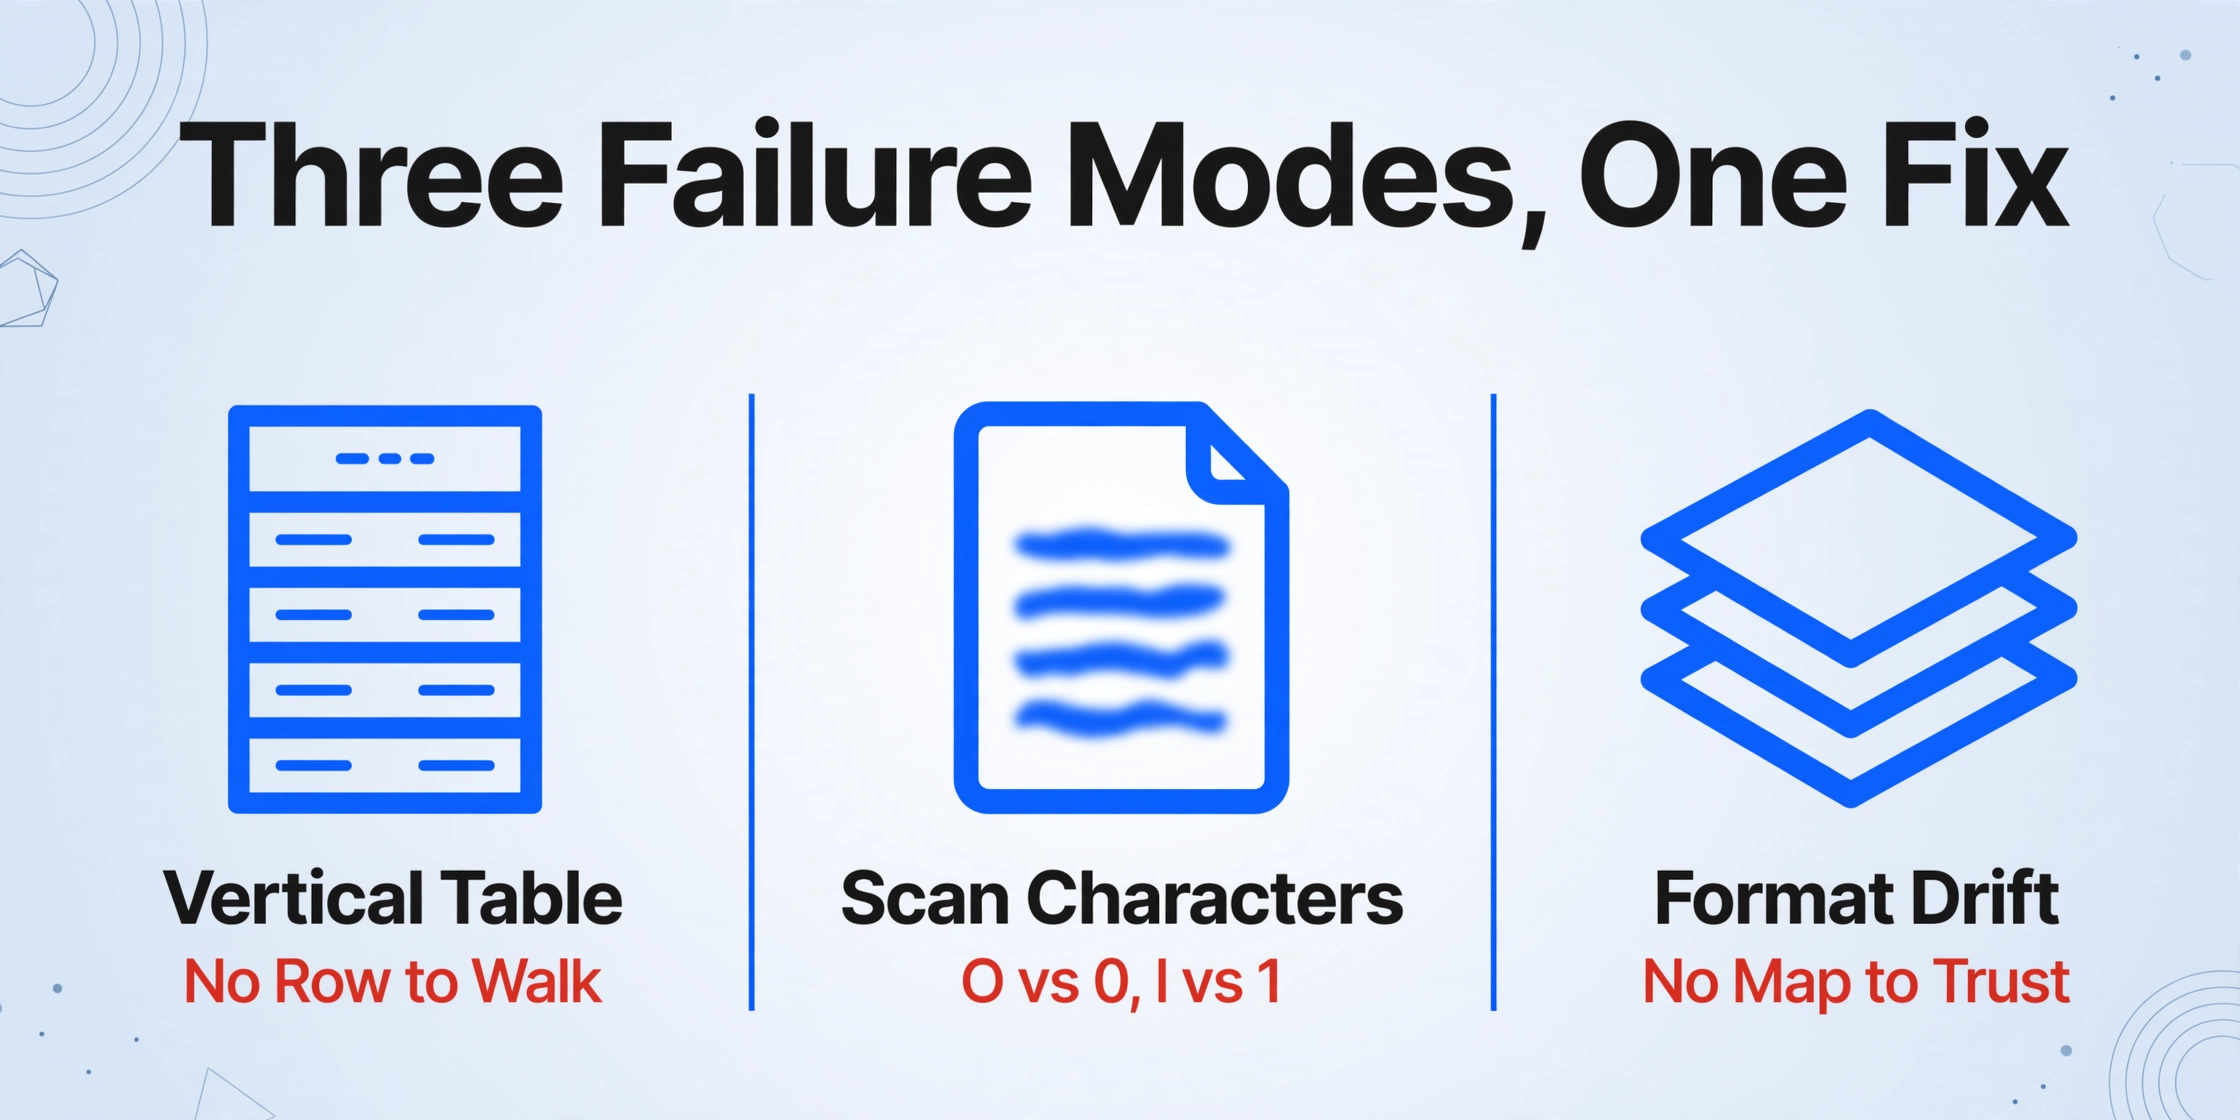
Ce mécanisme répond à chacun des trois modes de défaillance des sections précédentes. Le tableau vertical perd sa menace car aucune structure de ligne n'a besoin d'être reconstruite : l'IA s'ancre sur le sens de l'étiquette. Le mélange scanné et numérique perd sa menace car les deux passent par la même lecture sémantique, sans pipeline OCR séparé par source. Et la dérive de format perd sa menace car il n'y a aucune carte à invalider : une nouvelle mise en page de fournisseur n'est qu'une page de plus. La plainte initiale qui a lancé ce fil posait exactement cette question, à savoir si un outil pouvait gérer « le fabricant, le modèle et le numéro de série listés avec les en-têtes au-dessus des données ». C'est la mise en page que cette approche lit nativement.
Le reste du flux de travail suit le registre que l'équipe tient déjà. Téléversez tout le dossier comme un seul lot, et le traitement par lots fusionne chaque fichier en un seul tableau, une ligne par document, avec les trois mêmes en-têtes partout. Le niveau de modèle permet au compte d'exécuter un modèle de vision plus puissant pour les lots où la lisibilité est mauvaise, les scans à faible contraste, les plaques signalétiques poussiéreuses ou laminées, et les documents où une précision supplémentaire est rentable. Et comme un numéro de série avec un seul caractère erroné est pire qu'un vide, le Review Mode montre d'où vient chaque valeur extraite : survoler n'importe quelle cellule met en évidence la région exacte de l'image d'origine d'où elle a été lue, de sorte que les décisions 0-contre-O deviennent un coup d'œil à la source plutôt qu'une supposition.
Étape par étape : d'un dossier de PDF aux lignes du registre
Le flux de travail comporte quatre étapes, et aucune ne consiste à dessiner des zones ou à créer un analyseur par fournisseur. Voici la procédure à exécuter sur le prochain lot mixte qui arrive sur le bureau.
Nommez les colonnes dont le registre a besoin
Saisissez les noms des champs tels que vous souhaitez les voir apparaître, Make, Model, Serial Number, et ajoutez des colonnes d'étiquette ou d'emplacement si le registre en comporte. Ces noms deviennent les en-têtes de la sortie, ils doivent donc correspondre exactement à la feuille du registre, sans étape de traduction par la suite.
Téléversez tout le dossier en un seul lot
Les pages scannées, les PDF numériques et les photos de plaques signalétiques vont dans le même lot. Aucun prétraitement, aucun tri par type de source, aucun contrôle de qualité minimal. Le traitement par lots fusionne le tout en un seul tableau consolidé, de sorte que le registre est reconstruit en une seule exécution plutôt que fichier par fichier.
Vérifiez les valeurs sur lesquelles vous parieriez
Activez l'annotation automatique pour que chaque fichier traité revienne avec ses zones sources marquées. Survolez les cellules importantes, surtout les numéros de série, et confirmez chaque valeur par rapport à l'emplacement surligné sur l'original. L'étape qui signifiait autrefois relire chaque ligne signifie désormais vérifier celles qui sont signalées.
Exportez vers le registre ou l'import CMMS
Le résultat s'exporte en XLSX, CSV ou JSON, prêt à être intégré au classeur du registre ou préparé pour le modèle d'importation attendu par Maximo, UpKeep, Fiix ou la feuille de calcul que l'équipe tient déjà. Pour une équipe travaillant dans Google Sheets, l'extension extrait directement dans la feuille active.
La référence d'efficacité rend l'arithmétique évidente : la fiche produit de ce flux de travail indique 5 à 10 secondes par page contre environ 3 minutes de saisie manuelle, avec une précision allant jusqu'à 99 pour cent sur les données tabulaires imprimées. La réserve qui maintient l'honnêteté est que les données du registre alimentent les décisions de maintenance, de garantie et d'audit, c'est pourquoi l'étape de vérification n'est pas facultative. Pour le parcours OCR par lots que les gens essaient généralement en premier, la limite mérite d'être énoncée : l'OCR par lots rend les fichiers consultables mais ne produit pas de lignes, c'est la différence qui compte ici.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Ce que ce flux de travail ne peut toujours pas faire
Quelques limites méritent d'être nommées, car l'objectif de l'extraction ici est de constituer un registre auquel une équipe peut réellement se fier.
Un scan qu'une personne ne peut pas lire n'est pas récupérable. Les pages floues, à faible contraste ou déchirées produisent des lectures peu fiables quel que soit le niveau de modèle, et la bonne démarche consiste à demander une nouvelle numérisation ou une photo de la plaque signalétique physique plutôt que de nettoyer une sortie illisible.
Certains caractères ambigus restent véritablement ambigus. Les décisions 0-contre-O et l-contre-1 se résolvent souvent par le contexte, le champ, l'espacement, la somme de contrôle du format ou les caractères environnants, et Review Mode existe précisément pour que les cas résiduels soient vérifiés par rapport à l'image plutôt que devinés. Une petite part des lignes nécessite encore un regard humain, ce qui est le plafond honnête de toute approche de lecture de caractères.
Il remplit le registre à partir des documents ; il ne valide pas les documents. Si un fournisseur a imprimé un mauvais numéro de série ou si une erreur de saisie existe en amont dans le fichier source, la ligne extraite la reproduit fidèlement. Pour des décisions comme l'éligibilité à la garantie, où le document source est la source de vérité, la vérification par rapport à la plaque physique ou à un second enregistrement reste le contrôle.
Le registre est le livrable, et un GMAO est une décision plus vaste. L'extraction alimente l'un ou l'autre, mais elle ne fait pas choisir un GMAO à une équipe, et elle ne remplace pas le travail de vérification plaque par plaque qu'implique un inventaire physique des actifs. Pour les équipes de terrain et industrielles qui évaluent le paysage plus large, le panorama des outils d'extraction pour le terrain et l'industrie couvre la place de chaque approche, et le volet fabrication de la même décision est traité séparément dans l'extraction documentaire pour les achats en fabrication.
FAQ
Qu'est-ce qu'un tableau vertical exactement, et casse-t-il vraiment l'extraction ?
Il s'agit d'une mise en page où l'étiquette du champ se trouve au-dessus de ses valeurs plutôt qu'à côté, souvent sous forme de plusieurs bandes étroites côte à côte. Oui, cela casse les lecteurs de tableaux basés sur les lignes, car un tel lecteur reconstruit la page sous forme de grille et associe ce qui se trouve à côté dans l'ordre de lecture, si bien que les modèles et les numéros de série dérivent à travers la page. L'extraction sémantique lit l'étiquette comme un titre et prend les valeurs en dessous, donc la mise en page cesse d'être un problème.
Nos fichiers sont un mélange de PDF numérisés et numériques. Faut-il deux configurations ?
Non. Les deux vont dans le même lot et sont lus par la même passe sémantique, donc une page numérisée et un export numérique finissent en lignes dans le même tableau avec les mêmes en-têtes. Le mélange est le cas normal, pas un cas particulier.
Comment distinguer un numéro de série mal lu (0 vs O, 1 vs l) d'un correct ?
En regardant la source. Review Mode met en évidence la région exacte du document original d'où provient chaque valeur, et les deux directions fonctionnent : survolez la cellule pour l'emplacement de l'image, cliquez sur une région pour sauter à la cellule. Activez l'auto-annotation après le traitement pour que la vérification soit disponible pour chaque ligne sans rien exécuter de plus. Pour les numérisations plus difficiles, un niveau de modèle supérieur donne au modèle de vision sous-jacent plus de latitude sur les pages complexes ou à faible contraste.
Nous utilisons déjà Maximo ou UpKeep. Est-ce un remplacement ?
Non, et ce n'est pas nécessaire. Les données du registre doivent bien entrer quelque part, et l'extraction remplace la saisie à l'étape d'admission, produisant les lignes prêtes à importer qu'un CMMS attend. Pour les équipes qui n'utilisent pas encore de CMMS, la même passe maintient le flux de travail sur tableur sans la saisie manuelle.
Nous avons des centaines de pages en arrière. Un lot de cette taille est-il réaliste ?
Oui. Le traitement par lots est conçu exactement pour cela : téléchargez tout d'un coup et examinez le résultat fusionné, ce qui transforme un projet de saisie en tâche de vérification avec les mêmes définitions de colonnes. Le temps côté bureau passe des frappes aux contrôles ponctuels, avec la mise en évidence de Review Mode comme piste d'audit.
Quelles colonnes le registre doit-il comporter au-delà du fabricant, du modèle et du numéro de série ?
Le minimum standard issu de la pratique d'importation CMMS est l'identifiant d'étiquette ou d'actif, l'emplacement et la date d'installation, en plus du trio OEM. Chacune de ces informations peut être ajoutée en tant que colonnes extraites lorsque les documents les contiennent, et les colonnes absentes du document restent simplement vides plutôt que d'interrompre le passage.
Un numéro de série n'est pas une note, c'est une clé. Le registre détient les clés de chaque machine que vos documents décrivent, et la différence entre un registre qui fonctionne et un auquel personne ne fait confiance réside dans le fait que ces clés soient arrivées intactes.
Le prochain lot qui atterrit dans votre boîte aux lettres contient chaque numéro de série manquant à votre registre. Nommez les trois colonnes une fois, passez le dossier au crible et vérifiez les valeurs par rapport aux pages originales, et le registre cesse de dépendre de la personne au bureau qui tape le même document deux fois.