Captura Marca, Modelo y Número de Serie de PDF Escaneados y Digitales
El registro de equipos que alimenta este flujo de trabajo solo es tan bueno como sus columnas de marca, modelo y número de serie, y esas columnas solo son tan buenas como quien copia desde el PDF. En los documentos que envían clientes y proveedores, la cadena del modelo suele estar debajo de un encabezado impreso arriba: la palabra Model en la parte superior de una franja estrecha, el valor debajo, y Serial No. haciendo lo mismo en la siguiente franja. Cualquiera que haya abierto uno sabe cuáles son los campos. El problema de extracción es que la página no le ofrece nada que recorrer a un lector de tablas basado en filas, porque no hay estructura de filas que seguir.
Conclusiones Clave
- Si su registro sigue fallando, el instinto es culpar al OCR (el lector de caracteres), pero una tabla vertical no le ofrece nada que recorrer a un lector basado en filas.
- Volver a teclear un valor de un documento fuente tiene una tasa de error del 6.57 por ciento, frente al 0.29 por ciento al capturar con la fuente delante.
- Nombre las columnas una vez e ImageToTable.ai localiza cada valor por significado, así el diseño del siguiente proveedor es solo otra página.
El modo de fallo está descrito con precisión por alguien que hace este trabajo. En r/pdf, un usuario que abre de 10 a 100 PDF de clientes al día escribió: "Proceso entre 10 y 100 páginas de PDF al día de clientes, donde tengo que extraer manualmente el fabricante, el modelo y el número de serie a una tabla." Las páginas, añadió, "son tanto escaneadas como regulares, y los PDF no siempre comparten el mismo formato, lo que puede dificultarlo. La mayoría de las veces tienen tablas verticales donde el título de la columna es 'serial' y luego se listan debajo." Un segundo comentarista en el mismo hilo respondió antes de que llegara cualquier solución: "Las tablas verticales siempre son un dolor de cabeza para el OCR estándar. He lidiado con diseños de PDF desordenados similares antes" (r/pdf).
El fabricante, el modelo y el número de serie no son difíciles de encontrar a simple vista. Son difíciles de registrar sin una etapa de escritura, y los diseños que dificultan esa etapa son lo bastante comunes como para mencionarlos.
El lector que enfrenta este problema es cualquier equipo que deba mantener un registro y reciba a diario un lote de documentos de proveedores o clientes: hojas de especificaciones de equipos, fotografías de placas de identificación, catálogos, registros de servicio y calibración. Operaciones, compras, gestión de activos y el personal de finanzas que revaloriza equipos manejan los mismos tres campos. Los nombres varían, los formatos nunca coinciden, y un registro no acepta un número de serie a medio corregir mejor de lo que acepta uno en blanco. Este artículo analiza dónde se estanca realmente ese flujo de trabajo y qué cambia una extracción independiente del diseño.
Quién Realiza Este Trabajo y Qué Necesita un Registro de Él
El trabajo recae en un solo escritorio, aunque tres roles intervengan en el resultado. Un coordinador de recepción, un administrador de activos o de servicio, o un gerente de cuenta abre cada PDF, lee los tres valores y los escribe en una hoja que se convierte en el registro. El registro en sí suele ser un libro de Excel y, en algún momento, se importa a un CMMS o se consulta para decisiones de garantía, calibración y reemplazo. Las herramientas que los profesionales usan realmente para ese lado posterior incluyen IBM Maximo, UpKeep, Fiix, Limble y eMaint, y todas importan filas, no documentos.
| Rol | Qué hace realmente | Dónde pueden empezar a desviarse los datos |
|---|---|---|
| Coordinador de recepción | Abre cada PDF, lee fabricante, modelo y número de serie a simple vista, y los escribe en la hoja del registro | Omite una línea, transpone dígitos, copia de un escaneo de baja resolución, lee el encabezado como un valor |
| Líder de activos o administración | Es dueño del registro, relaciona cada fila con una etiqueta y ubicación, y prepara la importación a un CMMS | Confía en la fila escrita; una discrepancia con la etiqueta física solo aparece en la verificación o auditoría |
| Finanzas y compras | Usa registros vinculados al número de serie para reclamaciones de garantía, depreciación, pedidos de repuestos y disposiciones | Un número de serie incorrecto es un activo diferente para cada sistema posterior, por lo que las búsquedas no devuelven nada o devuelven la máquina equivocada |
El registro converge en un conjunto reducido de campos: fabricante, modelo, número de serie, etiqueta o ID de activo, ubicación y fecha de instalación. Un registro construido sobre esos campos respalda las decisiones de mantenimiento que se tratan en cómo convertir los registros de mantenimiento en un programa de mantenimiento preventivo, y la mecánica de importación importa porque una hoja llena de valores casi correctos sigue fallando en el límite del ERP, el fallo que nuestra guía sobre por qué los ERP rechazan hojas de cálculo con datos sucios detalla paso a paso.
Una Tabla Vertical No Ofrece Nada a un Lector Basado en Filas
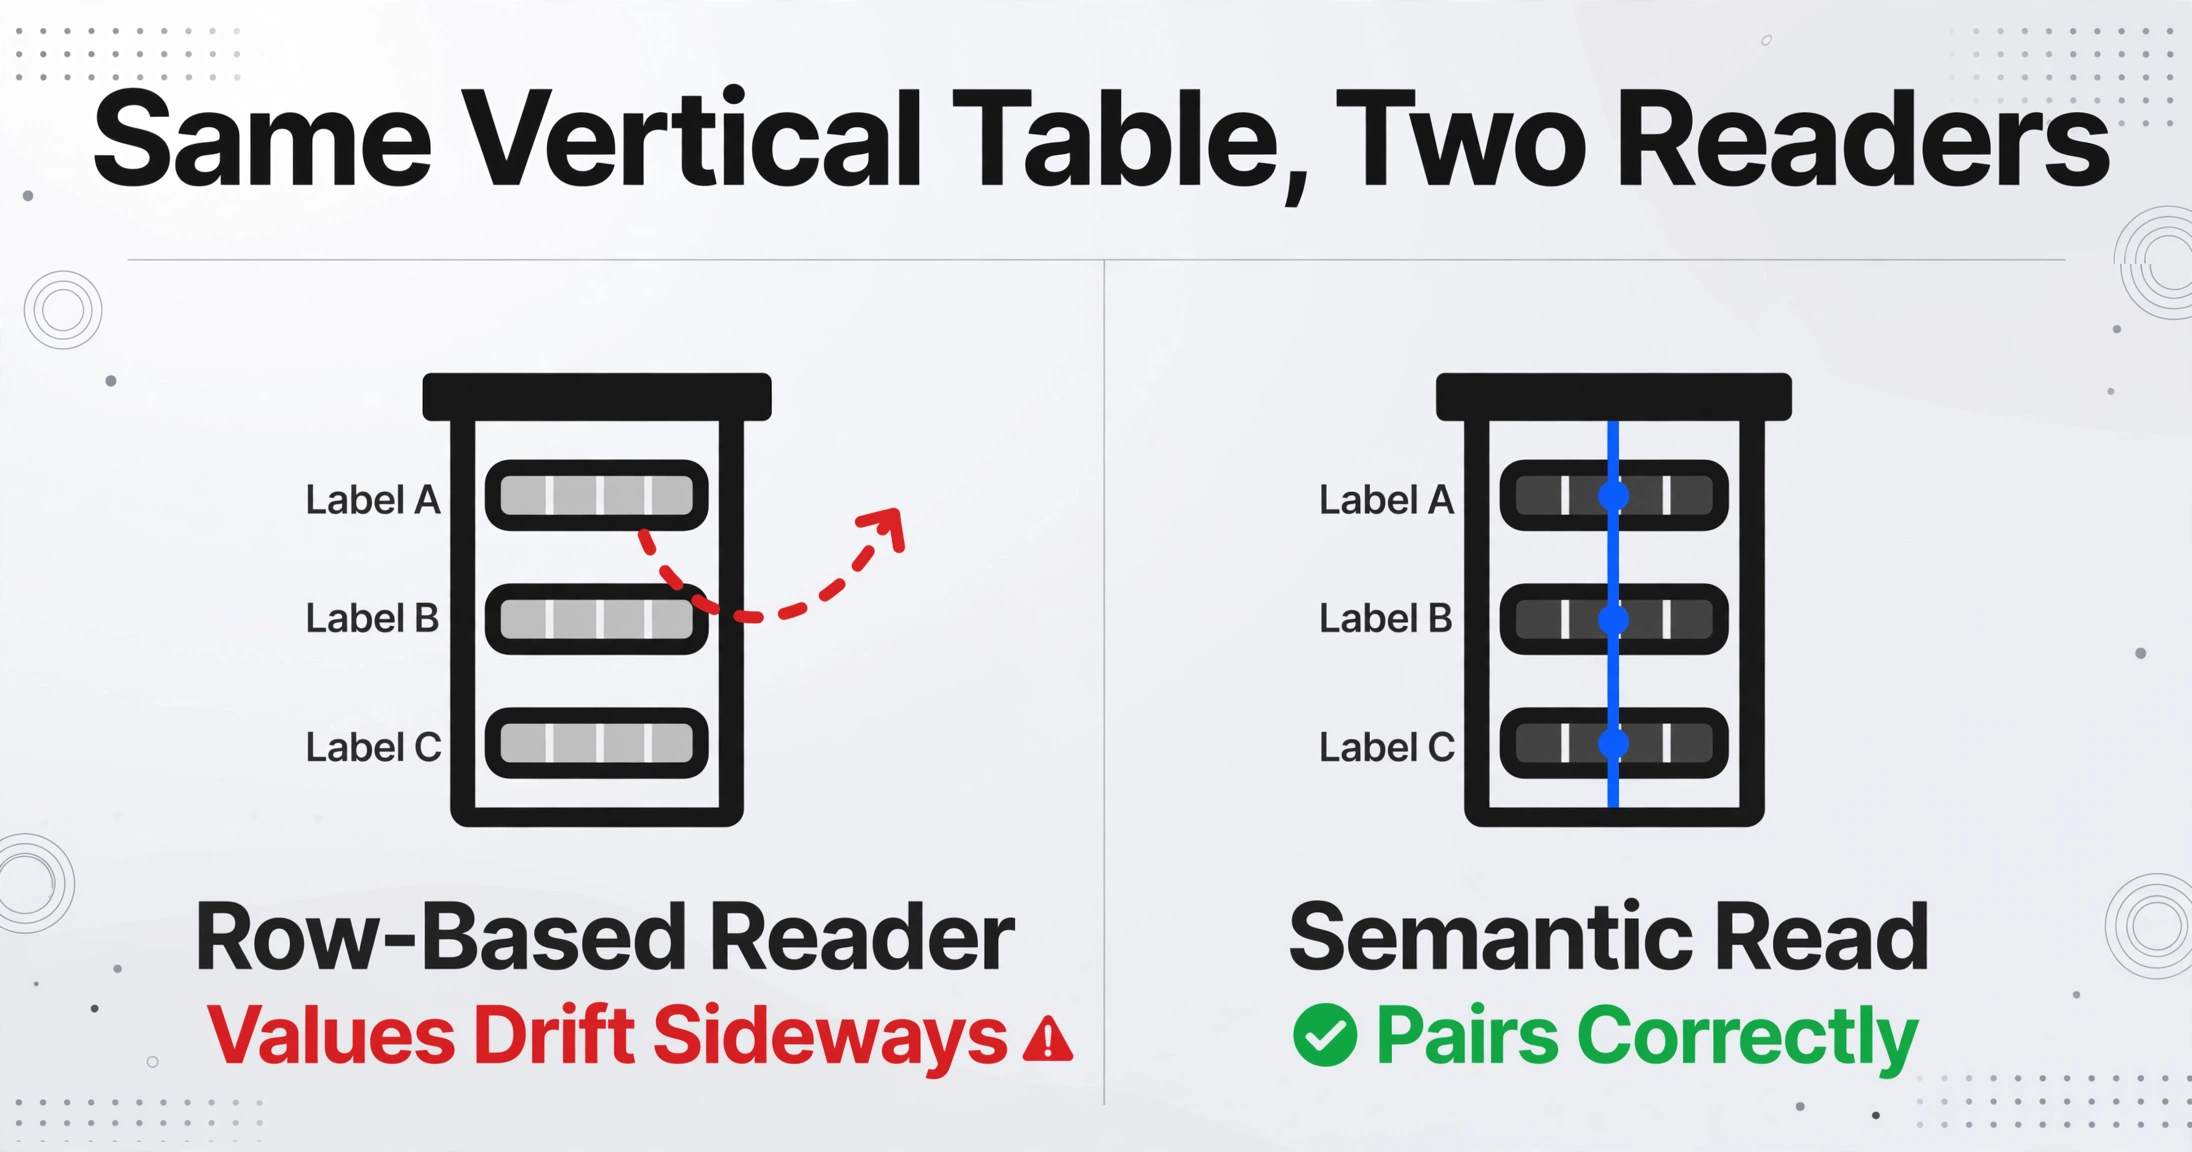
Una tabla vertical no tiene una fila por máquina, por lo que un extractor basado en filas inventa filas que no existen. La disposición que describió el autor de r/pdf, un encabezado impreso sobre sus valores con varias franjas de ese tipo una al lado de la otra, es exactamente la estructura que derrota la reconstrucción de tablas. Una persona lee la columna de números de serie bajo el encabezado N.º de serie y la columna de cadenas de modelo bajo Modelo. Una herramienta que asume una cuadrícula de izquierda a derecha en su lugar empareja cada modelo con el número de serie que le sigue en el orden de lectura, por lo que los valores se desvían lateralmente por la página.
Quienes construyen este software profesionalmente dicen lo mismo en sus propios foros. Un desarrollador que trabaja en extracción de tablas resumió el panorama en r/MachineLearning: "table transformer, paddleOCR, google doc AI, GOT OCR, GraphOCR, y muchos son buenos con estructuras de tabla simples, pero fallan al detectar y extraer tablas con estructura compleja." Otro profesional en el mismo hilo fue más directo: "También es mi experiencia que todos los modelos publicados fallan por completo en tablas complejas del mundo real" (r/MachineLearning). La razón por la que el fallo es estructural y no un problema de precisión del OCR se expone con claridad en un hilo sobre extracción de tablas: "El OCR es bueno con caracteres, pero las tablas se tratan de relaciones (significado de fila/columna/encabezado). La mayoría de los fallos son estructurales, no de 'mal OCR'" (r/founderledsales).
Una página puede contener una máquina o cien. El autor de r/pdf señaló de 1 a 100 conjuntos de fabricante/modelo/número de serie por página, lo que significa que el extractor no puede asumir "una página, un activo". Cada conjunto de valores debe ubicarse junto a su propia etiqueta, que es donde el fallo se vuelve costoso: una fila de registro construida a partir de dos columnas que se separaron tiene el modelo de una máquina y el número de serie de otra, y nada en la fila parece incorrecto hasta que una búsqueda falla.
Los escaneos añaden una segunda fuente de error: los propios caracteres
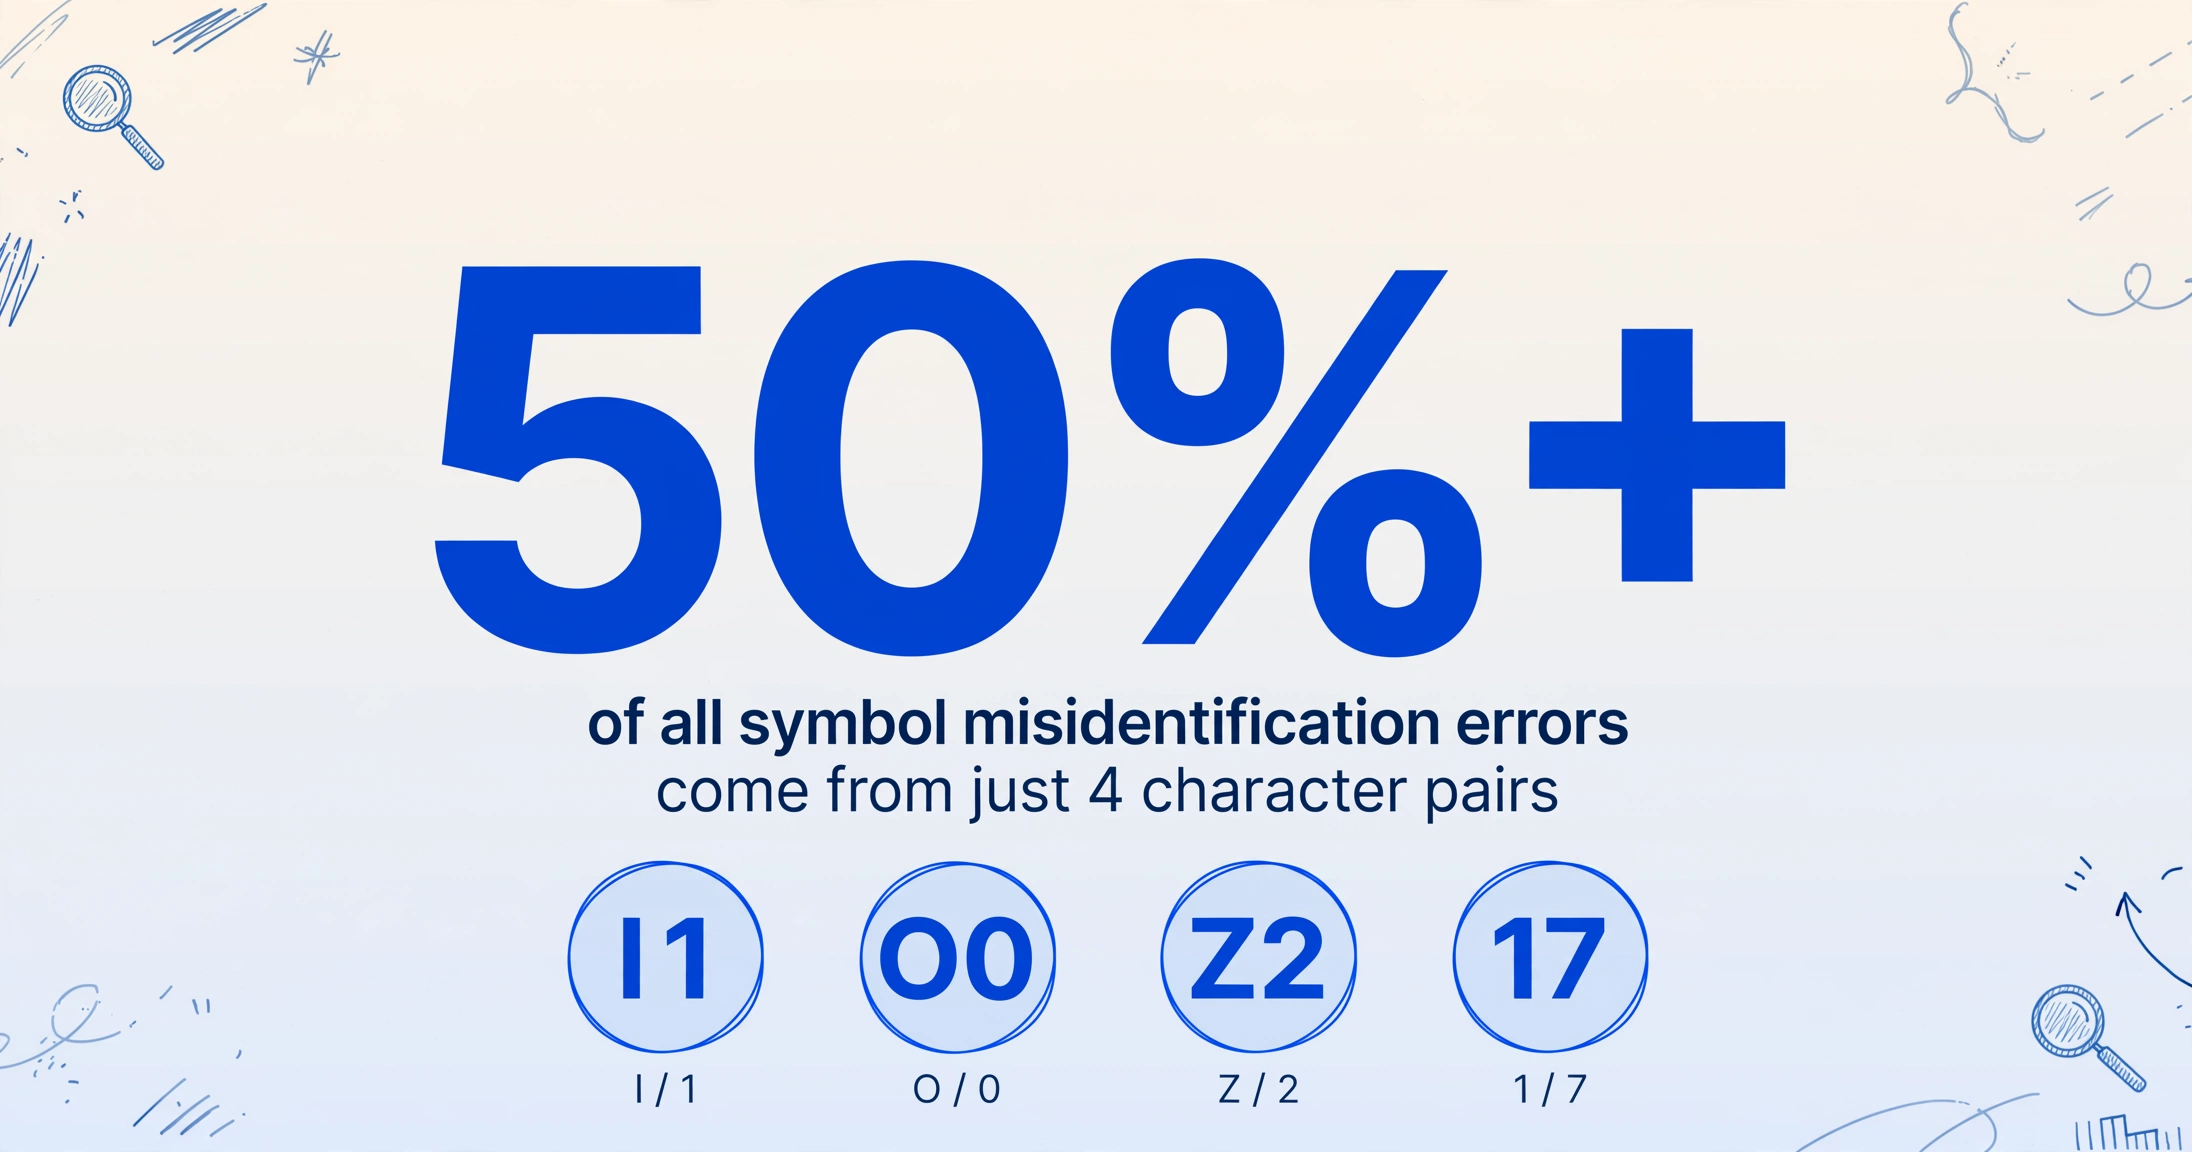
Un escaneo añade una segunda fuente de error además del problema de diseño: los caracteres pueden leerse mal. Los números de serie lo propician porque son cortos, alfanuméricos y deliberadamente cargados de caracteres similares. La letra O y el dígito 0, la l minúscula y el dígito 1, las letras Z y 2, y B y 8 son los pares clásicos, y la investigación aplicada ha documentado la magnitud: en el trabajo de Bell Laboratories que aún se cita en la literatura médica, los pares l/1, O/0, Z/2 y 1/7 representaron más de la mitad de todos los errores de identificación errónea de símbolos (PMC5614409). Un solo carácter sustituido en un número de serie lo convierte en una cadena diferente, y una cadena diferente es un activo diferente para todos los sistemas posteriores.
El identificador que vincula una máquina con su historial depende de que esa cadena permanezca intacta. Las GS1 General Specifications definen el Global Individual Asset Identifier (GIAI) como la clave digital que vincula un activo con su propietario, ubicación, valor y registros del ciclo de vida, y son explícitas al señalar que el número de serie del fabricante está en el centro de ese identificador, que no debe cambiar durante la vida del activo, y que las variaciones de formato, como guiones, ceros a la izquierda y mayúsculas, pueden romper una búsqueda (GS1 General Specifications). La observación del sector sitúa el coste práctico en el mismo lugar: los especialistas en datos de MRO informan que la mayoría de los registros de equipos ERP y CMMS industriales están incompletos, con detalles técnicos "atrapados en documentos PDF" que nunca se extrajeron al sistema en primer lugar (Sharecat Data Services).
La etapa de escritura es la parte que concentra el error. Una revisión sistemática de 2023 sobre métodos de procesamiento de datos en investigación clínica midió exactamente la tarea que nos ocupa, leer un valor de un documento fuente e introducirlo en una base de datos, y agrupó la tasa de error de la extracción manual de registros fuente en un 6,57 por ciento, frente al 0,29 por ciento de la introducción directa única con la fuente delante del operador (Garza et al., 2023). Leer y volver a escribir desde un documento es, mediblemente, la vía con mayor tasa de error, por lo que la precisión de un registro se decide antes de que se ejecute la primera fórmula, según lo que la persona en el escritorio copió.
Ningún proveedor comparte un formato, y nadie lo controla
Cada proveedor imprime los mismos tres campos en un diseño diferente, y la parte que recibe los documentos no tiene voz al respecto. La comunidad de guías para placas de identificación lo ha documentado: UL 9691, la práctica recomendada para placas de identificación en equipos eléctricos, afirma claramente que la información de la placa puede variar ampliamente incluso entre productos certificados según el mismo estándar, y que "esta variabilidad causa dificultades en el campo, ya que cada fabricante proporciona información esencial en un formato diferente según su interpretación y aplicación de los requisitos" (UL 9691-2021).
Los campos en sí están estandarizados aunque los diseños no lo estén. NFPA 79, el estándar eléctrico para maquinaria industrial, exige una placa con el nombre del fabricante, el modelo y el número de serie en los equipos de control, entre otras marcas (NFPA 79), y el modelo de identificación de maquinaria de OPC UA trata el número de serie como una propiedad obligatoria de cada identidad de máquina, única dentro del contexto de su fabricante y modelo (OPC UA 40001-1). El contenido está regulado. La disposición visual no lo está, que es exactamente por lo que el OCR basado en plantillas sigue fallando: una plantilla es un mapa de dónde se encuentra un campo en un formato, y la deriva entre proveedores, incluso entre revisiones de un mismo proveedor, invalida el mapa.
Los estándares de gestión de activos ponen la carga en el registro en lugar del documento. ISO 55013:2024, la guía para gestionar datos en un contexto de gestión de activos, exige que las organizaciones especifiquen requisitos de calidad para los datos de activos, incluyendo precisión, integridad, consistencia y puntualidad, y que comprendan la calidad de los datos antes de usarlos para tomar decisiones (ISO 55013:2024). En la práctica, esa cláusula significa que el registro tiene un requisito de precisión documentado, y que la ruta de entrada manual debe medirse contra ese requisito. La mecánica genérica de convertir documentos escaneados se cubre en extraer PDF escaneados a una hoja de cálculo y el enfoque de extracción de tablas que funciona para diseños más simples.
La solución: diga lo que quiere, no dónde está
La solución es extraer por significado en lugar de por posición. Extracción de Columnas Personalizadas funciona al revés que las plantillas: usted escribe los nombres de las columnas que desea —fabricante, modelo y número de serie— y la IA localiza cada valor en el documento comprendiendo qué significa el campo, en lugar de coincidir con una zona o plantilla fija. Los nombres de columna que introduce se convierten en los encabezados exactos de la tabla de salida. Como la búsqueda es semántica, la disposición deja de importar: el encabezado N.º de serie sobre sus valores se lee como la etiqueta que es, y los valores debajo aterrizan en la columna de número de serie tanto si la página es una tira vertical como tres, tanto si el texto está arriba, abajo o al lado de la etiqueta.
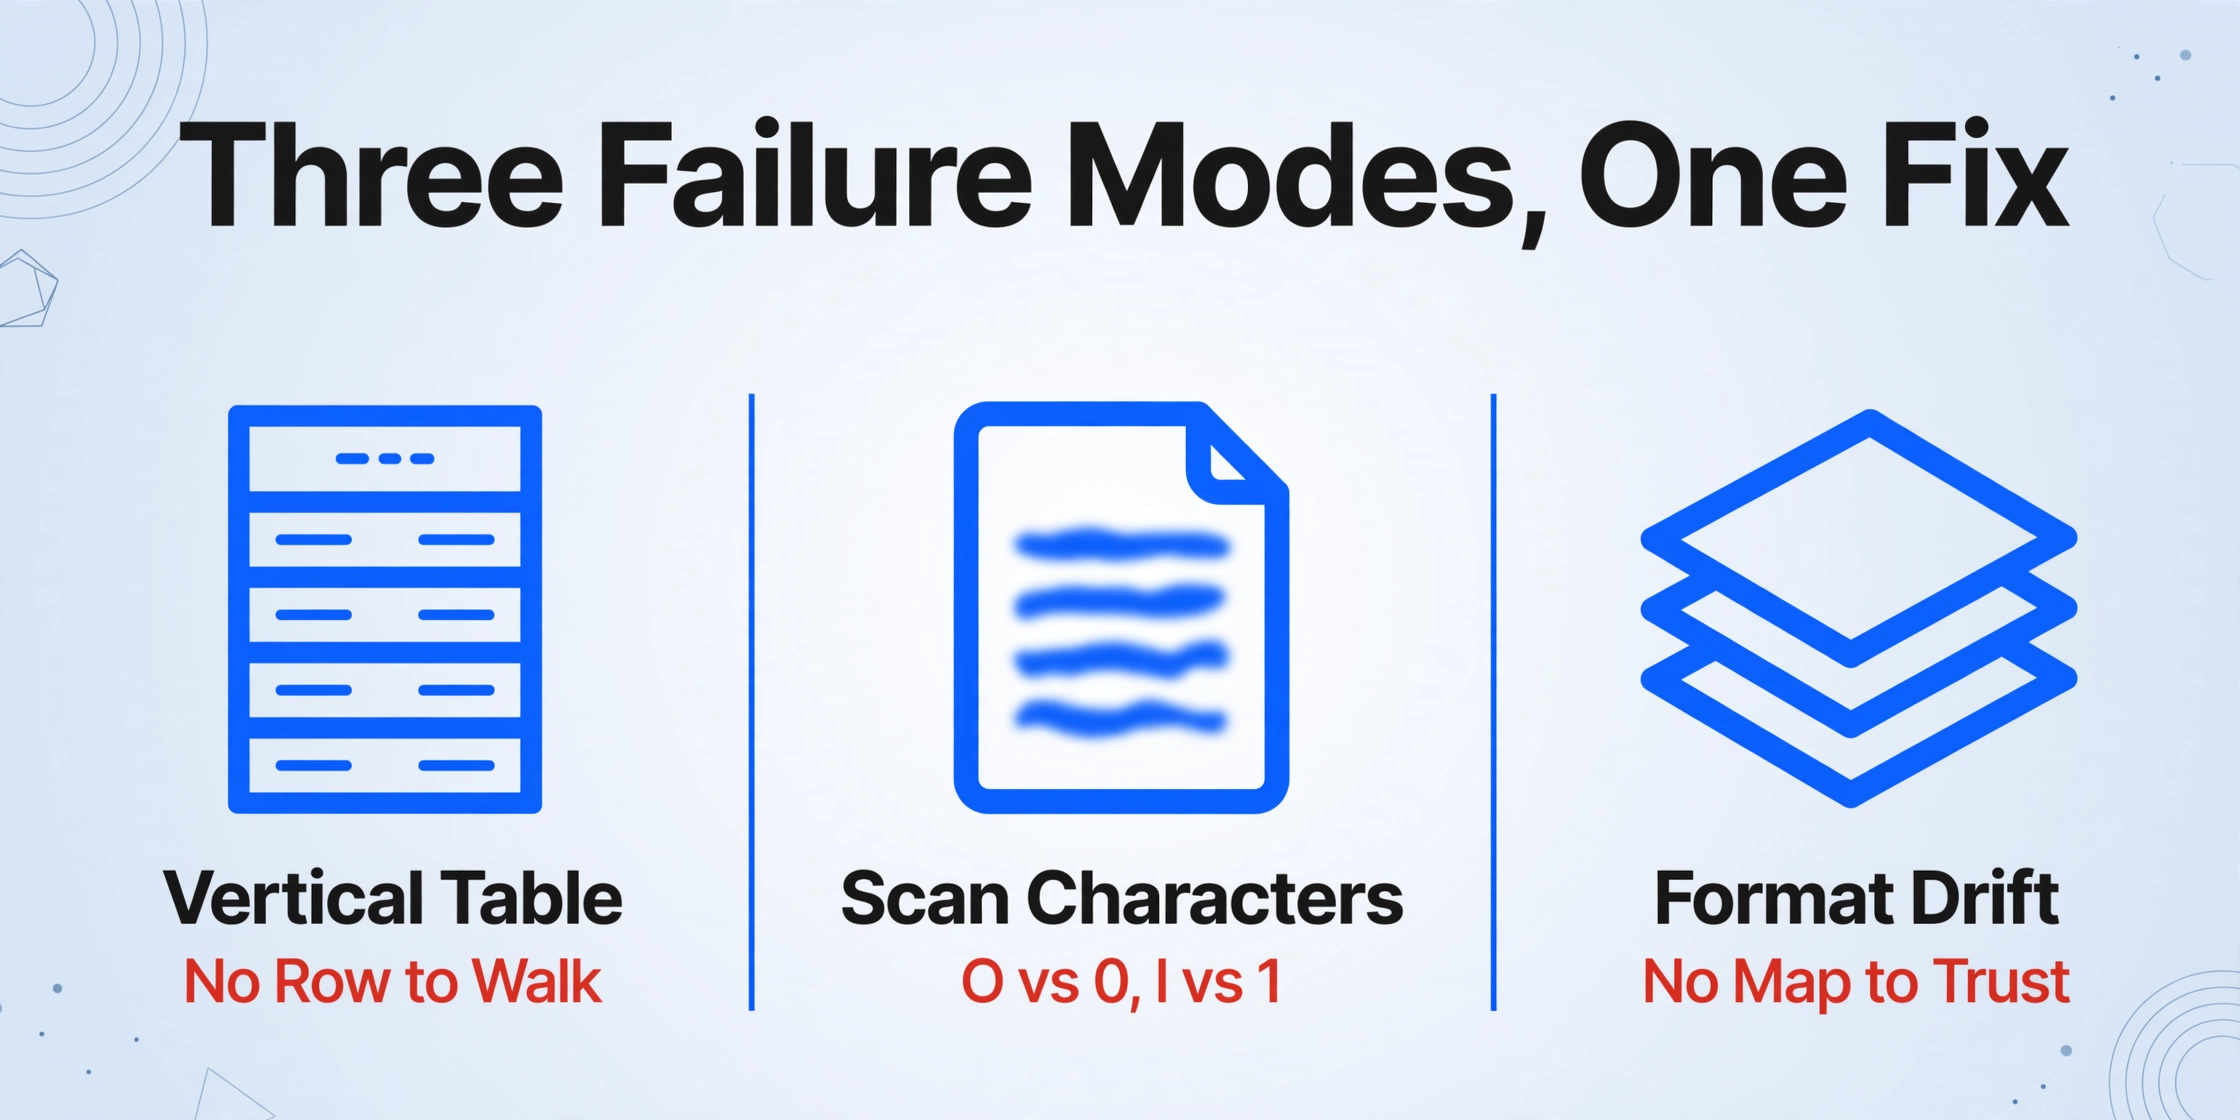
Ese único mecanismo responde a los tres modos de fallo de las secciones anteriores. La tabla vertical pierde su amenaza porque no hay que reconstruir ninguna estructura de filas: la IA se ancla en el significado de la etiqueta. La mezcla de escaneado y digital pierde su amenaza porque ambas pasan por la misma lectura semántica, sin un proceso de OCR separado por fuente. Y la deriva de formato pierde su amenaza porque no hay ningún mapa que invalidar: una nueva disposición de proveedor es solo otra página. La queja inicial que inició este hilo preguntaba exactamente eso: si una herramienta podía manejar "el fabricante, modelo y número de serie listados con los encabezados sobre los datos". Esa es la disposición que este enfoque lee de forma nativa.
El resto del flujo de trabajo sigue el registro que el equipo ya mantiene. Suba toda la carpeta como un solo lote, y el procesamiento por lotes fusiona cada archivo en una tabla, una fila por documento, con los mismos tres encabezados en todo momento. El nivel de modelo permite que la cuenta ejecute un modelo de visión más potente para los lotes donde la legibilidad es deficiente —escaneos de bajo contraste, placas de identificación polvorientas o laminadas y documentos donde la precisión adicional se paga sola—. Y como un número de serie con un carácter incorrecto es peor que uno en blanco, el Review Mode muestra de dónde proviene cada valor extraído: al pasar el cursor sobre cualquier celda se resalta la región exacta de la imagen original de la que se leyó, de modo que las decisiones entre 0 y O se convierten en una mirada a la fuente en lugar de una suposición.
Paso a paso: de una carpeta de PDF a filas de registro
El flujo de trabajo tiene cuatro pasos, y ninguno implica dibujar recuadros ni crear un analizador por proveedor. Este es el proceso para ejecutar en el próximo lote mixto que llegue a su escritorio.
Nombre las columnas que el registro necesita
Escriba los nombres de los campos tal como desea que aparezcan: fabricante, modelo, número de serie, y añada columnas de etiqueta o ubicación si el registro las incluye. Estos nombres se convierten en los encabezados de la salida, por lo que deben coincidir exactamente con la hoja de registro, sin necesidad de traducción posterior.
Sube la carpeta completa como un solo lote
Las páginas escaneadas, los PDF digitales y las fotos de placas van al mismo lote. Sin preprocesamiento, sin clasificar por tipo de fuente, sin requisito mínimo de calidad. El procesamiento por lotes fusiona todo en una sola tabla combinada para que el registro se reconstruya en una sola ejecución, no archivo por archivo.
Verifique los valores en los que apostaría
Active Auto-annotate para que cada archivo procesado regrese con sus regiones de origen marcadas. Pase el cursor sobre las celdas importantes, sobre todo los números de serie, y confirme cada valor contra el punto resaltado en el original. El paso que solía significar releer cada fila ahora significa revisar solo las marcadas.
Exporte al registro o a la importación del CMMS
El resultado se exporta como XLSX, CSV o JSON, listo para incorporar al libro de registro o preparado para la plantilla de importación que esperan Maximo, UpKeep, Fiix o la hoja de cálculo que el equipo ya mantiene. Para un equipo que trabaja en Google Sheets, el complemento extrae directamente a la hoja activa.
La línea base de eficiencia hace evidente la aritmética: la especificación del producto para este flujo es de 5 a 10 segundos por página frente a unos 3 minutos de entrada manual, con una precisión de hasta el 99 por ciento en datos tabulares impresos. La advertencia que lo mantiene honesto es que los datos del registro alimentan decisiones de mantenimiento, garantía y auditoría, por lo que el paso de verificación no es opcional. Para la ruta de OCR por lotes que la gente suele probar primero, vale la pena señalar el límite: el OCR por lotes hace que los archivos sean buscables pero no genera filas, que es la diferencia que importa aquí.
Los archivos se procesan de forma segura y no se almacenan.
Lo que este flujo de trabajo aún no puede hacer
Conviene nombrar algunos límites, porque el objetivo de la extracción aquí es crear un registro en el que el equipo realmente confíe.
Un escaneo que una persona no puede leer no es recuperable. Las páginas borrosas, de bajo contraste o rasgadas producen lecturas poco fiables sin importar el nivel de modelo, y lo correcto es solicitar un nuevo escaneo o una foto de la placa física en lugar de intentar limpiar una salida ilegible.
Algunos caracteres ambiguos siguen siendo genuinamente ambiguos. Las decisiones entre 0 y O o entre l y 1 suelen resolverse por el contexto, el campo, el espaciado, la suma de verificación del formato o los caracteres circundantes, y Review Mode existe precisamente para que los casos residuales se comprueben contra la imagen en lugar de adivinarse. Una pequeña proporción de filas todavía requiere una revisión humana, que es el límite honesto de cualquier enfoque de lectura de caracteres.
Completa el registro a partir de los documentos; no valida los documentos. Si un proveedor imprimió un número de serie incorrecto o existe un error de ingreso de datos más arriba en el archivo fuente, la fila extraída lo reproduce fielmente. Para decisiones como la elegibilidad de garantía, donde el documento fuente es el registro de referencia, la verificación contra la placa física o un segundo registro sigue siendo el control.
El registro es el entregable, y un CMMS es una decisión mayor. La extracción alimenta a cualquiera de los dos, pero no obliga al equipo a elegir un CMMS, ni reemplaza el trabajo de verificación placa por placa que implica un inventario físico de activos. Para los equipos de campo e industriales que evalúan el panorama más amplio, el panorama de herramientas de extracción para campo e industria cubre dónde encaja cada enfoque, y el lado de fabricación de la misma decisión se trata por separado en extracción de documentos para compras de fabricación.
Preguntas frecuentes
¿Qué es exactamente una tabla vertical y realmente rompe la extracción?
Es un diseño en el que la etiqueta del campo se sitúa encima de sus valores en lugar de al lado, a menudo en varias franjas estrechas una al lado de la otra. Sí, rompe los lectores de tablas basados en filas, porque un lector basado en filas reconstruye la página como una cuadrícula y empareja lo que esté adyacente en el orden de lectura, por lo que los modelos y los números de serie se desvían por la página. La extracción semántica lee la etiqueta como un encabezado y toma los valores que están debajo, por lo que el diseño deja de importar.
Nuestros archivos son una mezcla de PDF escaneados y digitales. ¿Necesitamos dos configuraciones?
No. Ambos van al mismo lote y son leídos por el mismo proceso semántico, por lo que una página escaneada y una exportación digital terminan como filas en la misma tabla con los mismos encabezados. La mezcla es el caso normal, no un caso excepcional.
¿Cómo distingo un número de serie mal leído (0 vs O, 1 vs l) de uno correcto?
Mirando la fuente. Review Mode resalta la región exacta del documento original de la que proviene cada valor, y ambas direcciones funcionan: pase el cursor sobre la celda para ver la ubicación de la imagen, haga clic en una región para saltar a la celda. Active Auto-annotate después del procesamiento para que la verificación esté disponible para cada fila sin ejecutar nada adicional. Para escaneos más difíciles, un nivel de modelo más alto le da al modelo de visión subyacente más margen en páginas complejas o de bajo contraste.
Ya usamos Maximo o UpKeep. ¿Esto es un reemplazo?
No, y no necesita serlo. Los datos del registro tienen que entrar de alguna manera, y la extracción reemplaza la escritura en el paso de ingreso, produciendo las filas listas para importar que un CMMS espera. Para equipos que aún no usan un CMMS, el mismo proceso mantiene vivo el flujo de trabajo de la hoja de cálculo sin la entrada manual.
Tenemos cientos de páginas atrasadas. ¿Es realista un lote de ese tamaño?
Sí. El procesamiento por lotes está diseñado exactamente para esto: suba todo a la vez y revise el resultado fusionado, lo que convierte un proyecto de escritura en una tarea de verificación con las mismas definiciones de columna. El tiempo del lado de la oficina pasa de pulsaciones de teclas a comprobaciones puntuales, con el resaltado de Review Mode como rastro de auditoría.
¿Qué columnas debe incluir el registro además de fabricante, modelo y número de serie?
El mínimo estándar según la práctica de importación de CMMS es el identificador de etiqueta o activo, la ubicación y la fecha de instalación, junto con el trío del fabricante. Cualquiera de estos puede añadirse como columnas extraídas cuando los documentos los incluyan, y las columnas que no estén en el documento simplemente permanecen en blanco sin interrumpir el proceso.
Un número de serie no es una nota, es una clave. El registro contiene las claves de cada máquina que describen sus documentos, y la diferencia entre un registro que funciona y uno en el que nadie confía es si esas claves llegaron intactas.
El próximo lote que llegue a su buzón tiene todos los números de serie que faltan en su registro. Nombre las tres columnas una vez, procese la carpeta y verifique los valores contra las páginas originales, y el registro dejará de depender de la persona que teclea el mismo documento dos veces.