Capture Fabricante, Modelo e Número de Série em PDFs Digitalizados e Digitais
O registro de equipamentos que este fluxo de trabalho alimenta só é tão bom quanto suas colunas de fabricante, modelo e número de série, e essas colunas só são tão boas quanto quem copia do PDF. Nos documentos que clientes e fornecedores enviam, a string do modelo geralmente fica abaixo de um cabeçalho impresso acima dela: a palavra Model no topo de uma faixa estreita, o valor abaixo, Serial No. fazendo o mesmo na próxima faixa. Qualquer pessoa que já abriu um sabe quais são os campos. O problema da extração é que a página não dá nada para um leitor de tabelas baseado em linhas percorrer, porque não há estrutura de linhas para seguir.
Principais Conclusões
- Se o seu registro continua dando errado, o instinto é culpar o OCR (o leitor de caracteres), mas uma tabela vertical não dá nada para um leitor baseado em linhas percorrer.
- Redigitar um valor de um documento de origem tem uma taxa de erro de 6,57 por cento contra 0,29 por cento para digitar com a fonte bem na sua frente.
- Nomeie as colunas uma vez e o ImageToTable.ai localiza cada valor pelo significado, então o layout do próximo fornecedor é apenas mais uma página.
O modo de falha é descrito com precisão por alguém que faz esse trabalho. No r/pdf, um usuário que abre de 10 a 100 PDFs de clientes por dia escreveu: "Eu processo entre 10 e 100 páginas de PDF por dia de clientes, onde preciso extrair manualmente fabricante, modelo e número de série para uma tabela." As páginas, acrescentou, "são escaneadas e normais, e os PDFs nem sempre compartilham o mesmo formato, o que pode dificultar. Eles têm tabelas verticais na maioria das vezes, onde o título da coluna é 'serial' e então eles são listados abaixo." Um segundo comentarista no mesmo tópico respondeu antes de qualquer solução chegar: "Tabelas verticais são sempre uma dor de cabeça para OCR padrão. Já lidei com layouts de PDF bagunçados semelhantes antes" (r/pdf).
O fabricante, o modelo e o número de série não são difíceis de encontrar a olho nu. Eles são difíceis de colocar em um registro sem uma etapa de digitação, e os layouts que derrotam essa etapa são comuns o suficiente para serem nomeados.
O leitor que enfrenta esse problema é qualquer equipe que precise manter um registro e tenha uma pilha diária de documentos de fornecedores ou clientes: folhas de especificações de equipamentos, fotografias de placas de identificação, catálogos, registros de serviço e calibração. Operações, compras, gestão de ativos e o pessoal de finanças que reavalia equipamentos lidam com os mesmos três campos. Os nomes variam, os formatos nunca coincidem, e um registro não aceita um número de série meio errado melhor do que aceita um em branco. Este artigo aborda onde esse fluxo de trabalho realmente trava e o que uma passagem de extração independente de layout muda.
Quem Faz Esse Trabalho e o Que um Registro Exige Dele
O trabalho recai sobre uma mesa, mesmo quando três funções tocam o resultado. Um coordenador de recebimento, administrador de serviços ou de ativos, ou gerente de conta abre cada PDF, lê os três valores e os digita em uma planilha que se torna o registro. O registro em si geralmente é um workbook do Excel e, em algum momento, é importado para um CMMS ou consultado para decisões de garantia, calibração e substituição. As ferramentas que os profissionais realmente usam nesse lado downstream incluem IBM Maximo, UpKeep, Fiix, Limble e eMaint, e todas importam linhas em vez de documentos.
| Função | O que eles realmente fazem | Onde os dados podem começar a se desviar |
|---|---|---|
| Coordenador de recebimento | Abre cada PDF, lê fabricante, modelo e número de série a olho nu e os digita na planilha do registro | Pula uma linha, troca dígitos, copia de uma digitalização de baixa resolução, lê o cabeçalho como um valor |
| Líder de ativos ou administrador | É dono do registro, combina cada linha a uma etiqueta e localização e prepara a importação para um CMMS | Confia na linha digitada; uma incompatibilidade com a etiqueta física só aparece na verificação ou auditoria |
| Finanças e compras | Usa registros vinculados ao número de série para reivindicações de garantia, depreciação, reabastecimento de peças de reposição e descartes | Um número de série errado é um ativo diferente para todos os sistemas downstream, então as consultas retornam nada ou a máquina errada |
A prática de registro converge para um conjunto pequeno de campos: fabricante, modelo, número de série, tag ou ID do ativo, localização e data de instalação. Um registro construído sobre esses campos dá suporte às decisões de manutenção abordadas em transformar logs de manutenção em um cronograma de PM, e a mecânica de importação importa porque uma planilha cheia de valores quase corretos ainda falha na fronteira do ERP, a falha que nosso guia sobre por que planilhas limpas são rejeitadas pelo ERP detalha.
Uma Tabela Vertical Não Dá Nada para um Leitor Baseado em Linhas Percorrer
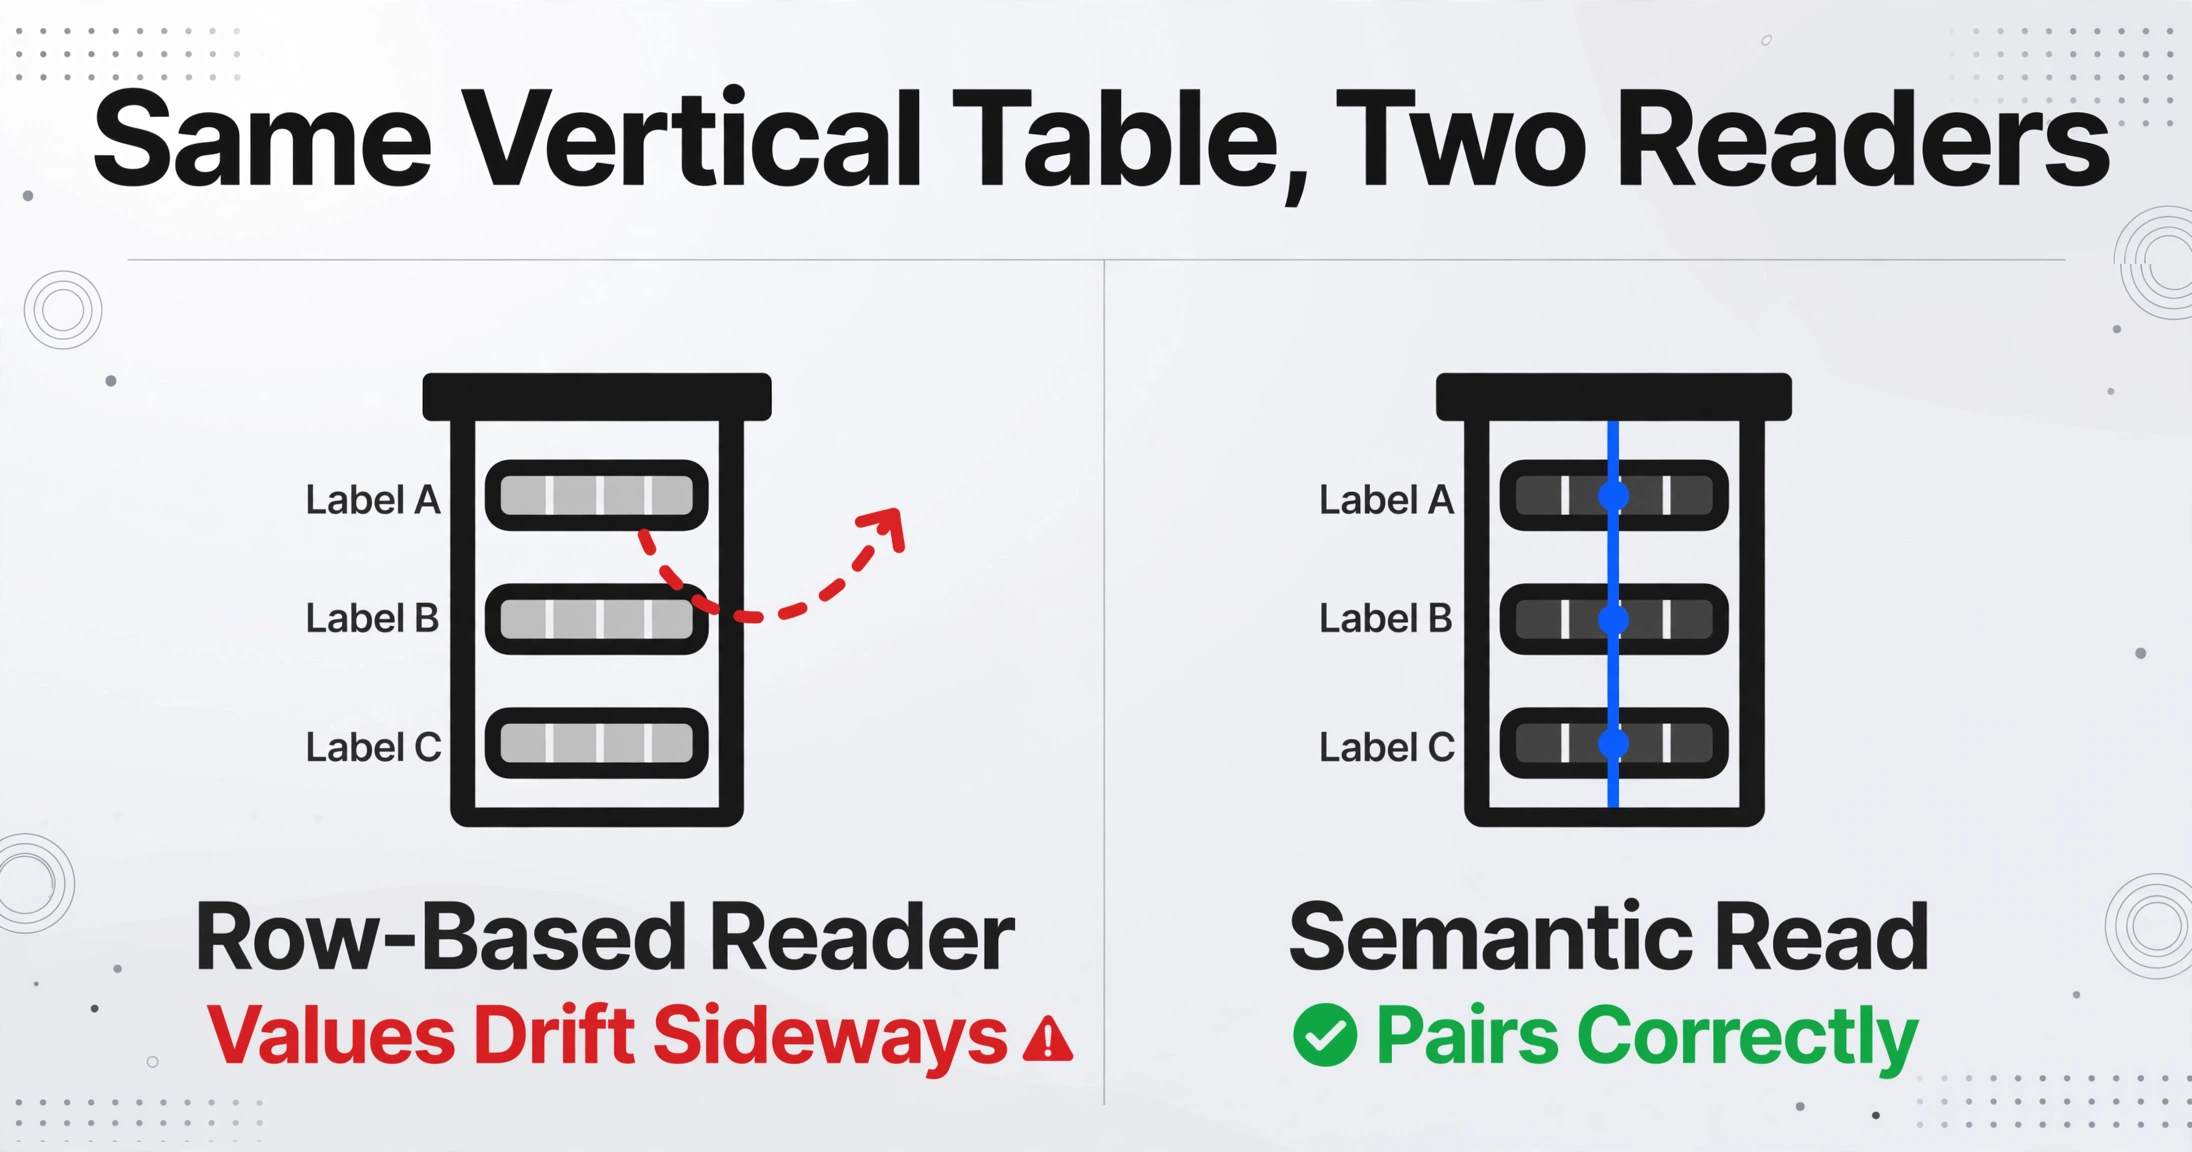
Uma tabela vertical não tem uma linha por máquina, então um extrator baseado em linhas inventa linhas que não existem. O layout descrito no pôster do r/pdf, um cabeçalho impresso acima de seus valores com várias dessas faixas lado a lado, é exatamente a estrutura que derrota a reconstrução da tabela. Uma pessoa lê a coluna de números de série sob o cabeçalho Nº de Série e a coluna de strings de modelo sob Modelo. Uma ferramenta que assume uma grade da esquerda para a direita, em vez disso, emparelha cada modelo com o serial que por acaso o segue na ordem de leitura, então os valores desviam lateralmente pela página.
As pessoas que constroem esse software profissionalmente dizem a mesma coisa em seus próprios fóruns. Um desenvolvedor que trabalha com extração de tabelas resumiu o cenário no r/MachineLearning: "table transformer, paddleOCR, google doc AI, GOT OCR, GraphOCR, e muitos são bons com estrutura de tabela simples, mas falham em detectar e extrair tabelas com estrutura complexa." Outro profissional na mesma thread foi mais direto: "Também é minha experiência que todos os modelos publicamente lançados falham completamente em tabelas complexas do mundo real" (r/MachineLearning). A razão pela qual a falha é estrutural e não um problema de precisão de OCR é declarada claramente em uma thread sobre extração de tabelas: "OCR é bom em caracteres, mas tabelas são sobre relacionamentos (significado de linha/coluna/cabeçalho). A maioria das falhas é estrutural, não 'OCR ruim'" (r/founderledsales).
Uma página pode conter uma máquina ou cem. O pôster do r/pdf observou de 1 a 100 conjuntos de fabricante/modelo/serial por página, o que significa que o extrator não pode assumir "uma página, um ativo." Cada conjunto de valores tem que ser localizado em relação ao seu próprio rótulo, que é onde a falha se torna cara: uma linha de registro construída a partir de duas colunas que se separaram tem um modelo de uma máquina e um serial de outra, e nada na linha parece errado até que uma consulta falhe.
A digitalização adiciona uma segunda fonte de erro: os próprios caracteres
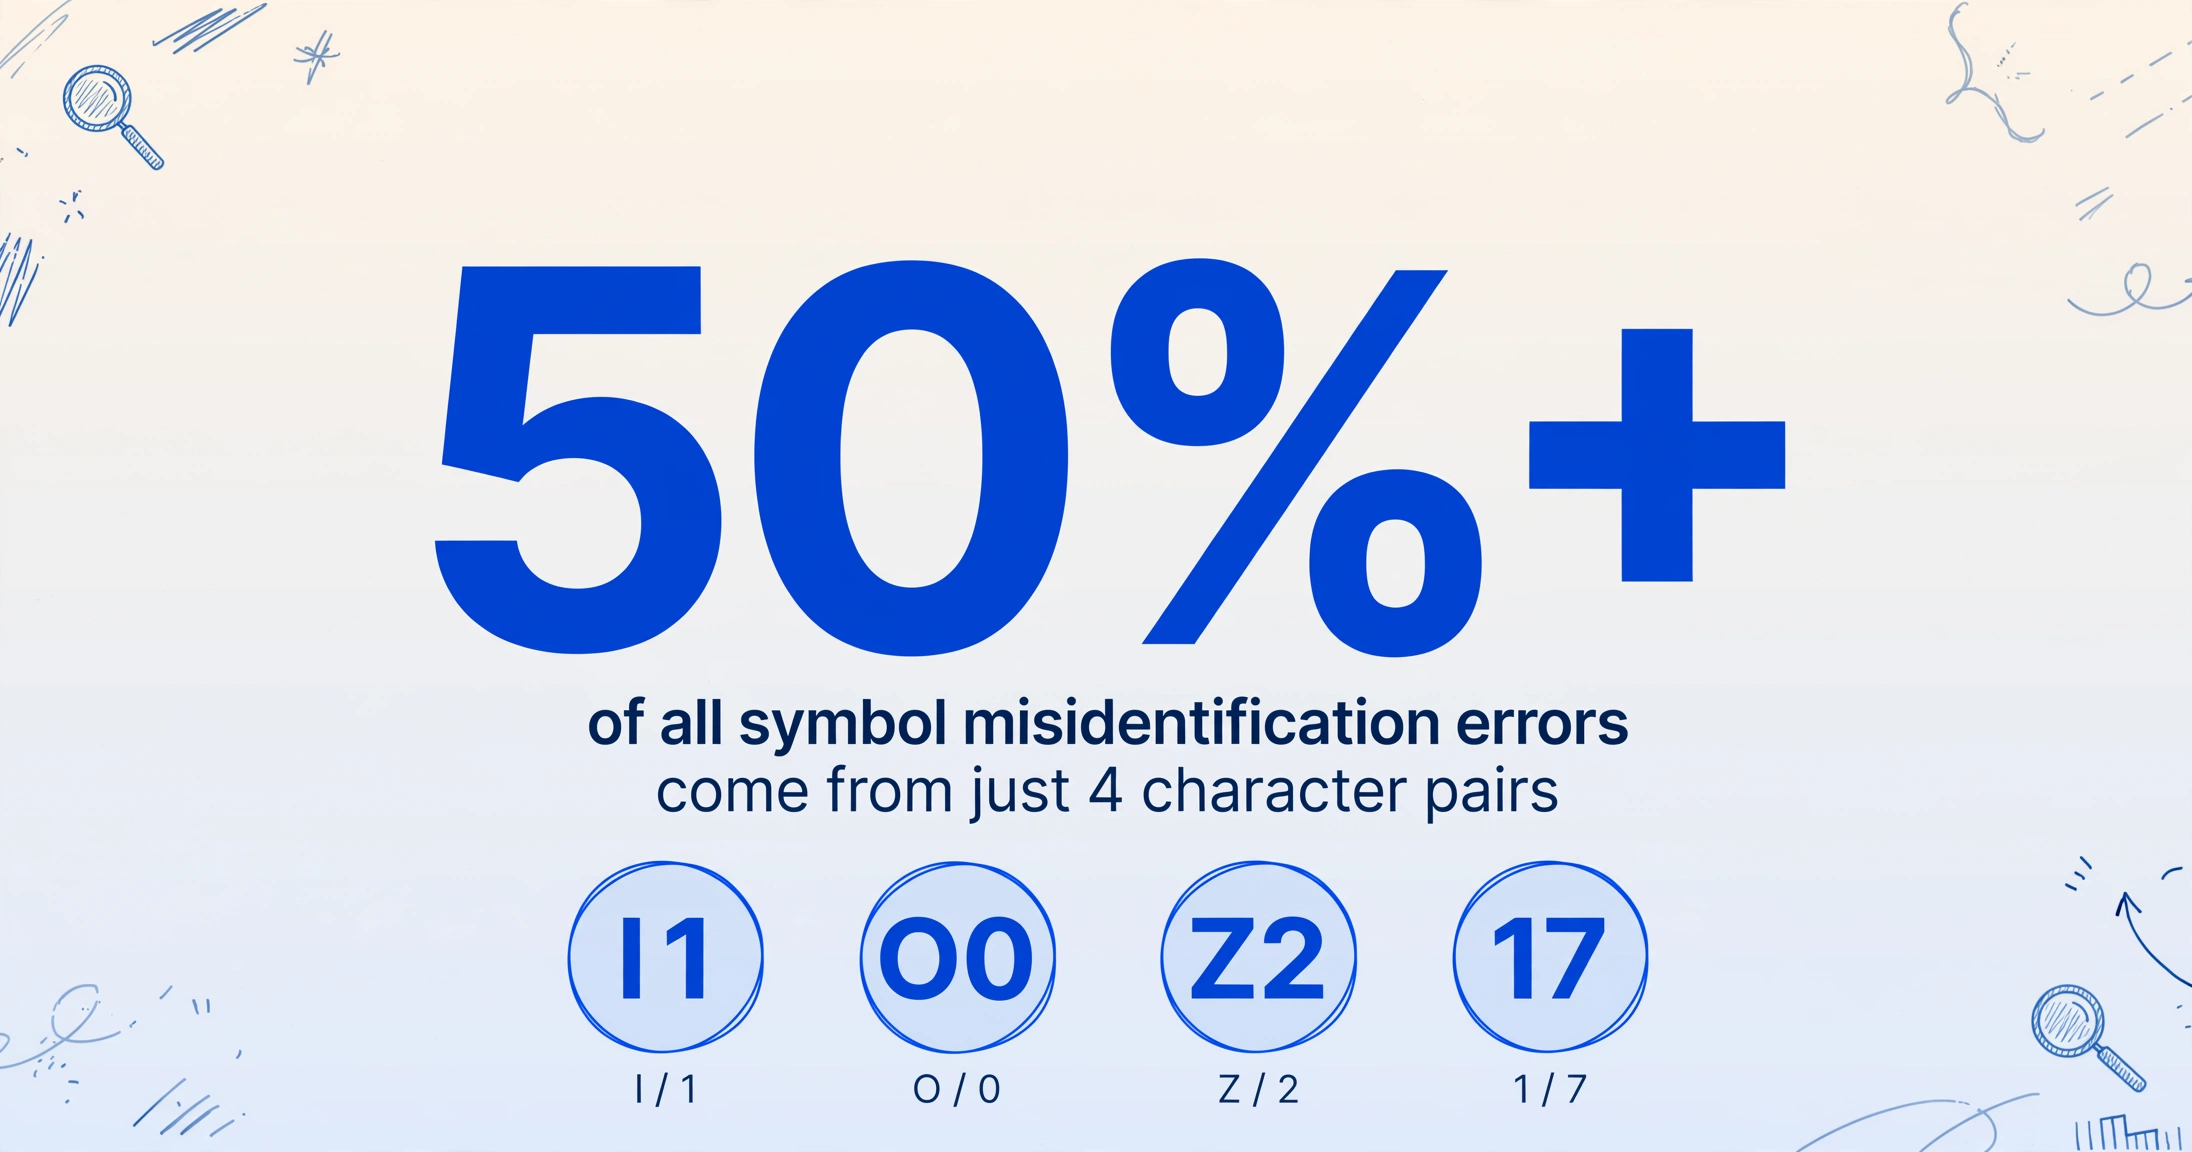
Uma digitalização adiciona uma segunda fonte de erro além do problema de layout: os caracteres podem ser lidos incorretamente. Os números de série convidam a isso porque são curtos, alfanuméricos e deliberadamente cheios de caracteres semelhantes. A letra O e o dígito 0, o l minúsculo e o dígito 1, as letras Z e 2, e B e 8 são os pares clássicos, e a pesquisa aplicada documentou a escala: no trabalho dos Bell Laboratories ainda citado na literatura médica, os pares l/1, O/0, Z/2 e 1/7 foram responsáveis por mais da metade de todos os erros de identificação incorreta de símbolos (PMC5614409). Um único caractere substituído em um número de série o torna uma string diferente, e uma string diferente é um ativo diferente para todos os sistemas downstream.
O identificador que vincula uma máquina ao seu histórico depende dessa string permanecer intacta. As GS1 General Specifications definem o Global Individual Asset Identifier (GIAI) como a chave digital que liga um ativo ao seu proprietário, localização, valor e registros de ciclo de vida, e são explícitas ao afirmar que o número de série do fabricante está no centro desse identificador, que ele não deve mudar durante a vida do ativo e que variações de formatação, como hífens, zeros à esquerda e maiúsculas/minúsculas, podem quebrar uma consulta (GS1 General Specifications). A observação do setor coloca o custo prático no mesmo lugar: especialistas em dados de MRO relatam que a maioria dos registros de equipamentos em ERPs industriais e CMMS está incompleta, com detalhes técnicos "presos em documentos PDF" que nunca foram extraídos para o sistema em primeiro lugar (Sharecat Data Services).
A etapa de digitação é a parte que concentra o erro. Uma revisão sistemática de 2023 sobre métodos de processamento de dados em pesquisa clínica mediu exatamente a tarefa em questão aqui, ler um valor de um documento de origem e inseri-lo em um banco de dados, e agrupou a taxa de erro da extração manual de registros de origem em 6,57 por cento, contra 0,29 por cento para digitação direta única com a fonte diante do operador (Garza et al., 2023). Ler e redigitar de um documento é comprovadamente o caminho com maior taxa de erro, e é por isso que a precisão de um registro é decidida antes da primeira fórmula ser executada, pelo que a pessoa na mesa copiou.
Nenhum fornecedor compartilha um formato, e ninguém o controla
Cada fornecedor imprime os mesmos três campos em um layout diferente, e a parte que recebe os documentos não tem direito a voto. A comunidade de orientação sobre placas de identificação documentou o porquê: a UL 9691, a prática recomendada para placas de identificação em equipamentos elétricos, afirma claramente que as informações da placa podem variar amplamente até mesmo entre produtos certificados pelo mesmo padrão, e que "essa variabilidade causa dificuldades em campo, pois cada fabricante fornece informações essenciais em um formato diferente, com base em sua interpretação e aplicação dos requisitos" (UL 9691-2021).
Os campos em si são padronizados, embora os layouts não sejam. A NFPA 79, o padrão elétrico para máquinas industriais, exige uma placa de identificação com o nome do fornecedor, o modelo e o número de série em equipamentos de controle, entre outras marcações (NFPA 79), e o modelo de identificação de máquinas OPC UA trata o número de série como uma propriedade obrigatória de toda identidade de máquina, exclusiva no contexto de seu fabricante e modelo (OPC UA 40001-1). O conteúdo é regulamentado. O arranjo visual não é, e é exatamente por isso que o OCR baseado em modelo continua falhando: um modelo é um mapa de onde um campo fica em um formato, e a variação entre fornecedores, até mesmo entre revisões de um único fornecedor, invalida o mapa.
Os padrões de gestão de ativos colocam a responsabilidade no registro, e não no documento. A ISO 55013:2024, a orientação para gerenciamento de dados em um contexto de gestão de ativos, exige que as organizações especifiquem requisitos de qualidade para dados de ativos, incluindo precisão, integridade, consistência e pontualidade, e que entendam a qualidade dos dados antes de usá-los para decisões (ISO 55013:2024). Na prática, essa cláusula significa que o registro tem um requisito de precisão documentado, e o caminho de entrada manual precisa ser medido contra ele. A mecânica genérica de conversão de documentos digitalizados é abordada em extração de PDFs digitalizados para uma planilha e a abordagem de extração de tabelas que funciona para layouts mais simples.
A Solução: Diga o Que Você Quiere, Não Onde Está
A solução é extraer por significado em vez de por posição. Extração de Colunas Personalizadas funciona ao contrário dos modelos: você digita os nomes das colunas que deseja, Make, Model e Serial Number, e a IA localiza cada valor no documento entendendo o que o campo significa, em vez de corresponder a uma zona ou modelo fixo. Os nomes das colunas que você insere se tornan exatamente os cabeçalhos da tabela de saída. Como a busca é semántica, o layout deixa de importar: o cabeçalho Serial No. acima de seus valores é lido como o rótulo que é, e os valores abaixo caen na coluna Serial Number, seja a página uma tira vertical ou três, seja o texto acima, abaixo ou ao lado do rótulo.
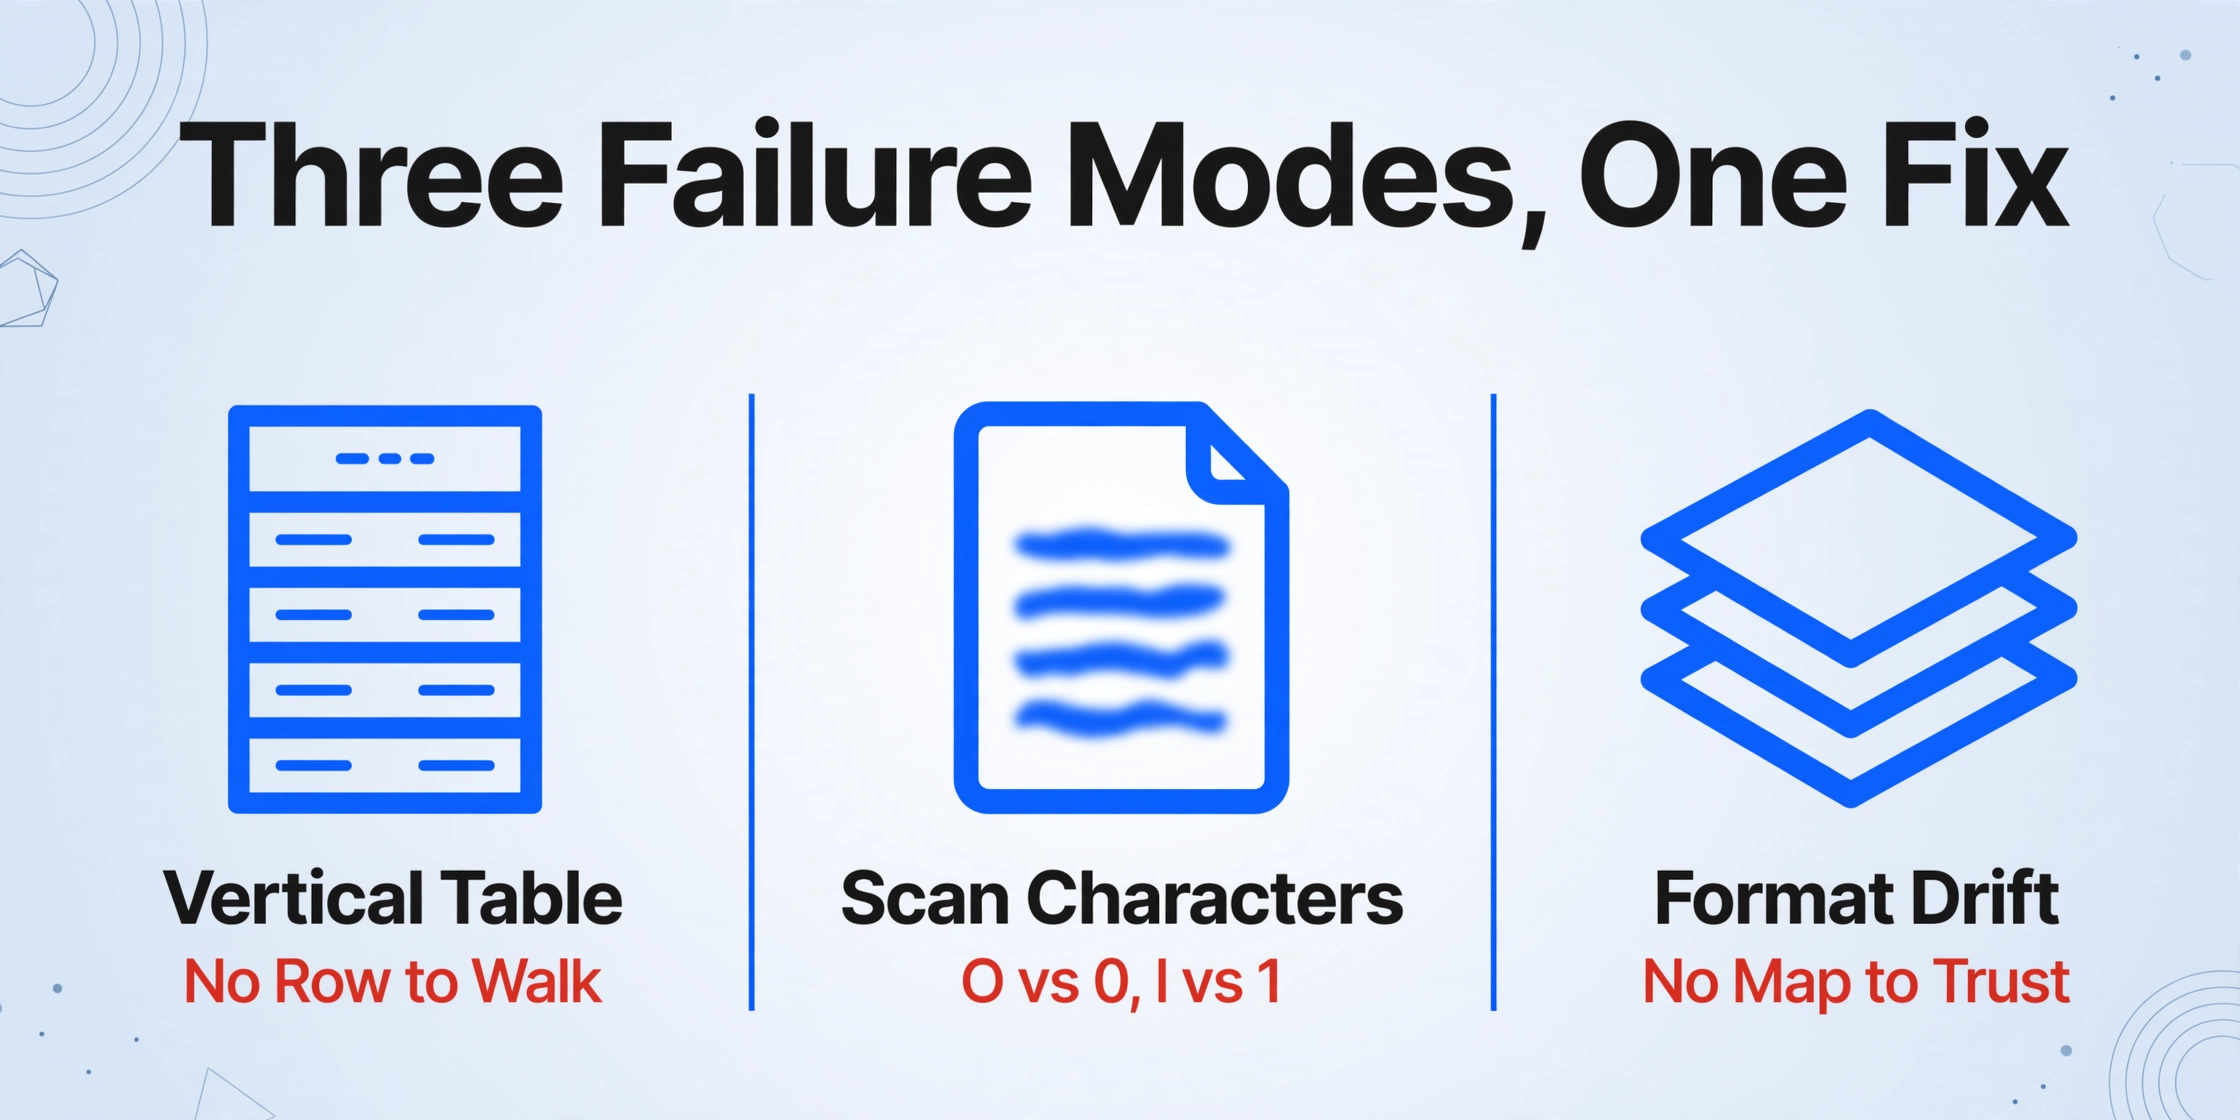
Ese mecanismo responde a cada um dos três modos de falha das seções anteriores. A tabela vertical perde sua ameaça porque não é necessário reconstruir nenhuna estrutura de filas: a IA se ancora no significado do rótulo. A mistura de digitalizado e digital perde sua ameaça porque ambos passan pela mesma leitura semántica, sem pipeline de OCR separado por fonte. E a deriva de formato perde sua ameaça porque não há mapa que invalidar: um novo layout de fornecedor é apenas outra página. A queixa inicial que começó este hilo preguntó exatamente esta questão, se uma herramienta podía manejar "the make model and serial number listed with the headers above the data." Ese es el layout que esta abordagem lee de forma nativa.
O resto do fluxo de trabalho segue o registro que a equipe já mantiene. Envie a carpeta inteira como um lote, e o processamento em lote mescla todos os arquivos em uma única tabela, uma fila por documento, com os mesmos três cabeçalhos em todo. Model Tier permite que a conta execute um modelo de visão más potente para os lotes onde a legibilidade é deficiente, digitalizaciones de baixo contraste, placas de identificação com poeira ou laminadas, e documentos onde a precisión extra se paga por sí misma. E como um número de série com um carácter incorreto é peor que um em branco, Review Mode mostra de onde veio cada valor extraído: ao passar o mouse sobre qualquer célula, se destaca a região exata da imagem original da qual foi lido, para que as decisões de 0-versus-O se tornen uma olhada à fonte em vez de uma suposição.
Passo a Passo: De uma Pasta de PDFs para Linhas de Registro
O fluxo de trabalho tem quatro etapas, e nenhuma envolve desenhar caixas ou criar um parser por fornecedor. Aqui está o procedimento para executar no próximo lote misto que chegar à mesa.
Defina os nomes das colunas que o registro precisa
Digite os nomes dos campos como deseja que apareçam: fabricante, modelo, número de série, e adicione colunas de etiqueta ou localização se o registro as tiver. Esses nomes se tornam os cabeçalhos da saída, então devem corresponder exatamente à planilha do registro, sem etapa de tradução posterior.
Carregue a pasta inteira como um único lote
Páginas escaneadas, PDFs digitais e fotos de placas de identificação entram no mesmo lote. Sem pré-processamento, sem separação por tipo de origem, sem requisito mínimo de qualidade. O processamento em lote funde tudo em uma única tabela mesclada, reconstruindo o registro de uma só vez, em vez de um arquivo por vez.
Verifique os valores nos quais você apostaria
Ative o auto-annotate para que cada arquivo processado retorne com suas regiões de origem marcadas. Passe o mouse sobre as células importantes, principalmente os números de série, e confirme cada valor contra o ponto destacado no original. A etapa que costumava significar reler cada linha agora significa verificar apenas as sinalizadas.
Exporte para o registro ou para a importação do CMMS
O resultado é exportado como XLSX, CSV ou JSON, pronto para ser inserido na pasta de trabalho do registro ou preparado para o modelo de importação que Maximo, UpKeep, Fiix ou a planilha que a equipe já mantém espera. Para uma equipe que trabalha no Google Sheets, o complemento extrai diretamente para a planilha ativa.
A linha de base de eficiência torna a aritmética óbvia: a especificação do produto para este fluxo é de 5 a 10 segundos por página, contra cerca de 3 minutos de entrada manual, com precisão de até 99% em dados de tabelas impressas. A ressalva que mantém isso honesto é que os dados do registro alimentam decisões de manutenção, garantia e auditoria, por isso a etapa de verificação não é opcional. Para o caminho de OCR em lote que as pessoas geralmente tentam primeiro, o limite vale ser declarado: o OCR em lote torna os arquivos pesquisáveis, mas não gera linhas, que é a diferença que importa aqui.
Os arquivos são processados com segurança e não são armazenados.
O Que Este Fluxo de Trabalho Ainda Não Consegue Fazer
Alguns limites merecem ser nomeados, porque o objetivo da extração aqui é um registro em que a equipe realmente confia.
Um scan que uma pessoa não consegue ler não é recuperável. Páginas borradas, com baixo contraste ou rasgadas produzem leituras não confiáveis independentemente do nível de modelo, e a atitude certa é solicitar um novo scan ou uma foto da placa física em vez de tentar limpar uma saída ilegível.
Alguns caracteres ambíguos permanecem genuinamente ambíguos. As decisões entre 0 e O e entre l e 1 geralmente se resolvem pelo contexto, pelo campo, pelo espaçamento, pelo checksum do formato ou pelos caracteres ao redor, e o Review Mode existe exatamente para que os casos residuais sejam conferidos contra a imagem em vez de adivinhados. Uma pequena parcela das linhas ainda exige uma olhada humana, o que é o limite honesto de qualquer abordagem de leitura de caracteres.
Ele preenche o registro a partir dos documentos; não valida os documentos. Se um fabricante imprimiu um número de série errado ou existe um erro de entrada de dados a montante no arquivo de origem, a linha extraída o reproduz fielmente. Para decisões como direito à garantia, em que o documento de origem é o registro da verdade, a verificação contra a placa física ou um segundo registro continua sendo o controle.
O registro é o entregável, e um CMMS é uma decisão maior. A extração alimenta um ou outro, mas não faz a equipe escolher um CMMS e não substitui o trabalho de verificação placa a placa que um inventário físico de ativos envolve. Para equipes de campo e industriais que avaliam o panorama mais amplo, o panorama de ferramentas de extração para campo e indústria cobre onde cada abordagem se encaixa, e o lado da fabricação da mesma decisão é tratado separadamente em extração de documentos para compras na fabricação.
FAQ
O que é exatamente uma tabela vertical, e ela realmente quebra a extração?
É um layout em que o rótulo do campo fica acima dos valores, em vez de ao lado deles, muitas vezes em várias faixas estreitas lado a lado. Sim, ela quebra os leitores de tabela baseados em linhas, porque um leitor baseado em linhas reconstrói a página como uma grade e associa o que estiver adjacente na ordem de leitura, então modelos e números de série se deslocam pela página. A extração semântica lê o rótulo como um cabeçalho e captura os valores abaixo dele, então o layout deixa de importar.
Nossos arquivos são uma mistura de PDFs escaneados e digitais. Precisamos de duas configurações?
Não. Ambos entram no mesmo lote e são lidos pela mesma passada semântica, então uma página escaneada e uma exportação digital acabam como linhas na mesma tabela, com os mesmos cabeçalhos. A mistura é o caso normal, não um caso excepcional.
Como distinguir um número de série lido incorretamente (0 vs O, 1 vs l) de um correto?
Observando a origem. O Review Mode destaca a região exata do documento original de onde cada valor veio, e ambas as direções funcionam: passe o mouse sobre a célula para ver a localização da imagem, clique em uma região para ir até a célula. Ative o auto-annotate após o processamento para que a verificação fique disponível para todas as linhas sem executar nada extra. Para escaneamentos mais difíceis, um nível de modelo mais alto dá ao modelo de visão subjacente mais margem em páginas complexas ou de baixo contraste.
Já usamos Maximo ou UpKeep. Isso é um substituto?
Não, e não precisa ser. Os dados do registro precisam entrar de alguma forma, e a extração substitui a digitação na etapa de entrada, produzindo as linhas prontas para importação que um CMMS espera. Para equipes que ainda não usam um CMMS, a mesma passada mantém o fluxo de trabalho com planilhas sem a entrada manual.
Temos centenas de páginas antigas. Um lote desse tamanho é viável?
Sim. O processamento em lote foi feito exatamente para isso: envie tudo de uma vez e revise a saída mesclada, o que transforma um projeto de digitação em uma tarefa de verificação com as mesmas definições de coluna. O tempo no escritório passa de digitação para verificações pontuais, com o destaque do Review Mode como trilha de auditoria.
Quais colunas o registro deve conter além de fabricante, modelo e número de série?
O mínimo padrão da prática de importação de CMMS é tag ou ID do ativo, localização e data de instalação, além do trio OEM. Qualquer uma delas pode ser adicionada como colunas extraídas quando os documentos as contêm, e as colunas que não estão no documento simplesmente permanecem em branco, sem interromper o processo.
Um número de série não é uma anotação, é uma chave. O registro contém chaves para cada máquina que seus documentos descrevem, e a diferença entre um registro que funciona e um em que ninguém confia é se essas chaves chegaram intactas.
O próximo lote que chegar na sua caixa de entrada tem todos os números de série que faltam no seu registro. Nomeie as três colunas uma vez, processe a pasta inteira e confira os valores com as páginas originais, e o registro deixa de depender da pessoa na mesa digitando o mesmo documento duas vezes.