Hersteller, Modell und Seriennummer aus gescannten und digitalen PDFs erfassen
Das Anlagenregister, das dieser Workflow speist, ist nur so gut wie seine Spalten für Hersteller, Modell und Seriennummer – und diese Spalten sind nur so gut wie die Person, die aus dem PDF abschreibt. Auf den Dokumenten, die Kunden und Lieferanten senden, steht die Modellbezeichnung meist unter einer darüber gedruckten Überschrift: das Wort Modell oben auf einem schmalen Streifen, der Wert darunter, Seriennr. im nächsten Streifen genauso. Jeder, der so ein Dokument geöffnet hat, weiß, was die Felder bedeuten. Das Extraktionsproblem ist, dass die Seite einem zeilenbasierten Tabellenleser nichts zu folgen gibt, weil es keine Zeilenstruktur gibt.
Wichtigste Erkenntnisse
- Wenn Ihr Register immer wieder falsch wird, liegt der Instinkt nahe, der OCR (dem Zeichenleser) die Schuld zu geben, aber eine vertikale Tabelle gibt einem zeilenbasierten Leser nichts zu folgen.
- Das Abtippen eines Werts aus einem Quelldokument läuft mit 6,57 Prozent Fehlerquote, gegenüber 0,29 Prozent beim Erfassen mit der Quelle direkt vor Augen.
- Benennen Sie die Spalten einmal und ImageToTable.ai findet jeden Wert anhand der Bedeutung – das nächste Layout eines Lieferanten ist dann nur eine weitere Seite.
Der Fehlermodus wird von jemandem präzise beschrieben, der diese Arbeit tatsächlich ausführt. In r/pdf schrieb ein Nutzer, der täglich 10 bis 100 Kunden-PDFs öffnet: „Ich verarbeite täglich 10–100 PDF-Seiten von Kunden, aus denen ich manuell Hersteller, Modell und Seriennummer in eine Tabelle übertragen muss." Die Seiten, so fügte er hinzu, „sind sowohl gescannt als auch regulär, und die PDFs haben nicht immer dasselbe Format, was es schwierig machen kann. Sie haben meistens vertikale Tabellen, in denen die Spaltenüberschrift ‚Seriennummer' lautet und die Werte darunter aufgelistet sind." Ein zweiter Kommentator im selben Thread antwortete, bevor eine Lösung vorgeschlagen wurde: „Vertikale Tabellen sind für Standard-OCR immer eine Herausforderung. Ich hatte schon mit ähnlich unübersichtlichen PDF-Layouts zu tun" (r/pdf).
Hersteller, Modell und Seriennummer sind mit dem Auge leicht zu finden. Sie in ein Register zu übertragen, ohne eine Tippphase, ist schwer – und die Layouts, die diese Phase scheitern lassen, sind häufig genug, um sie beim Namen zu nennen.
Der Leser, den dieses Problem betrifft, ist jedes Team, das ein Register führen muss und täglich einen Stapel Lieferanten- oder Kundendokumente erhält: Geräte-Datenblätter, Typenschild-Fotos, Kataloge, Wartungs- und Kalibrierungsaufzeichnungen. Betrieb, Beschaffung, Anlagenverwaltung und die Finanzabteilung, die Geräte neu bewertet, arbeiten alle mit denselben drei Feldern. Die Bezeichnungen variieren, die Formate stimmen nie überein, und ein Register akzeptiert eine halb falsche Seriennummer genauso wenig wie eine leere. Dieser Artikel zeigt, wo dieser Workflow tatsächlich ins Stocken gerät und was ein layoutunabhängiger Extraktionsdurchlauf verändert.
Wer führt diese Arbeit aus, und was ein Register von ihr braucht
Die Arbeit lastet auf einem Schreibtisch, auch wenn drei Rollen am Ergebnis beteiligt sind. Ein Wareneingangskoordinator, ein Service- oder Anlagenadministrator oder ein Account Manager öffnet jedes PDF, liest die drei Werte und tippt sie in ein Blatt, das zum Register wird. Das Register selbst ist meist eine Excel-Arbeitsmappe, die irgendwann entweder in ein CMMS importiert oder für Garantie-, Kalibrierungs- und Ersatzentscheidungen abgefragt wird. Die Tools, mit denen Praktiker diese nachgelagerte Seite tatsächlich betreiben, umfassen IBM Maximo, UpKeep, Fiix, Limble und eMaint – und jedes davon importiert Zeilen, nicht Dokumente.
| Rolle | Was sie tatsächlich tun | Wo die Daten abzuweichen beginnen können |
|---|---|---|
| Wareneingangskoordinator | Öffnet jedes PDF, liest Hersteller, Modell und Seriennummer mit dem Auge und tippt sie in das Registerblatt | Überspringt eine Zeile, vertauscht Ziffern, übernimmt aus einem niedrig aufgelösten Scan, liest die Kopfzeile als Wert |
| Anlagen- oder Admin-Leitung | Verantwortet das Register, ordnet jede Zeile einem Tag und Standort zu und bereitet den Import in ein CMMS vor | Vertraut der getippten Zeile; eine Abweichung vom physischen Tag fällt erst bei Verifizierung oder Audit auf |
| Finanzen und Beschaffung | Nutzen seriennummernverknüpfte Datensätze für Garantieansprüche, Abschreibungen, Ersatzteilbestellungen und Entsorgungen | Eine falsche Seriennummer ist für jedes nachgelagerte System ein anderes Asset, sodass Abfragen nichts oder die falsche Maschine liefern |
Die Registerpraxis konvergiert auf ein kleines Feldschema: Hersteller, Modell, Seriennummer, Tag oder Asset-ID, Standort und Installationsdatum. Ein auf diesen Feldern aufgebautes Register unterstützt die Wartungsentscheidungen, die in der Umwandlung von Wartungsprotokollen in einen PM-Zeitplan behandelt werden, und die Importmechanik ist wichtig, weil ein Blatt voller fast korrekter Werte an der ERP-Grenze immer noch scheitert – das Scheitern, das unser Leitfaden zu warum saubere Tabellen vom ERP abgelehnt werden im Detail durchgeht.
Eine vertikale Tabelle gibt einem zeilenbasierten Reader nichts zum Ablaufen
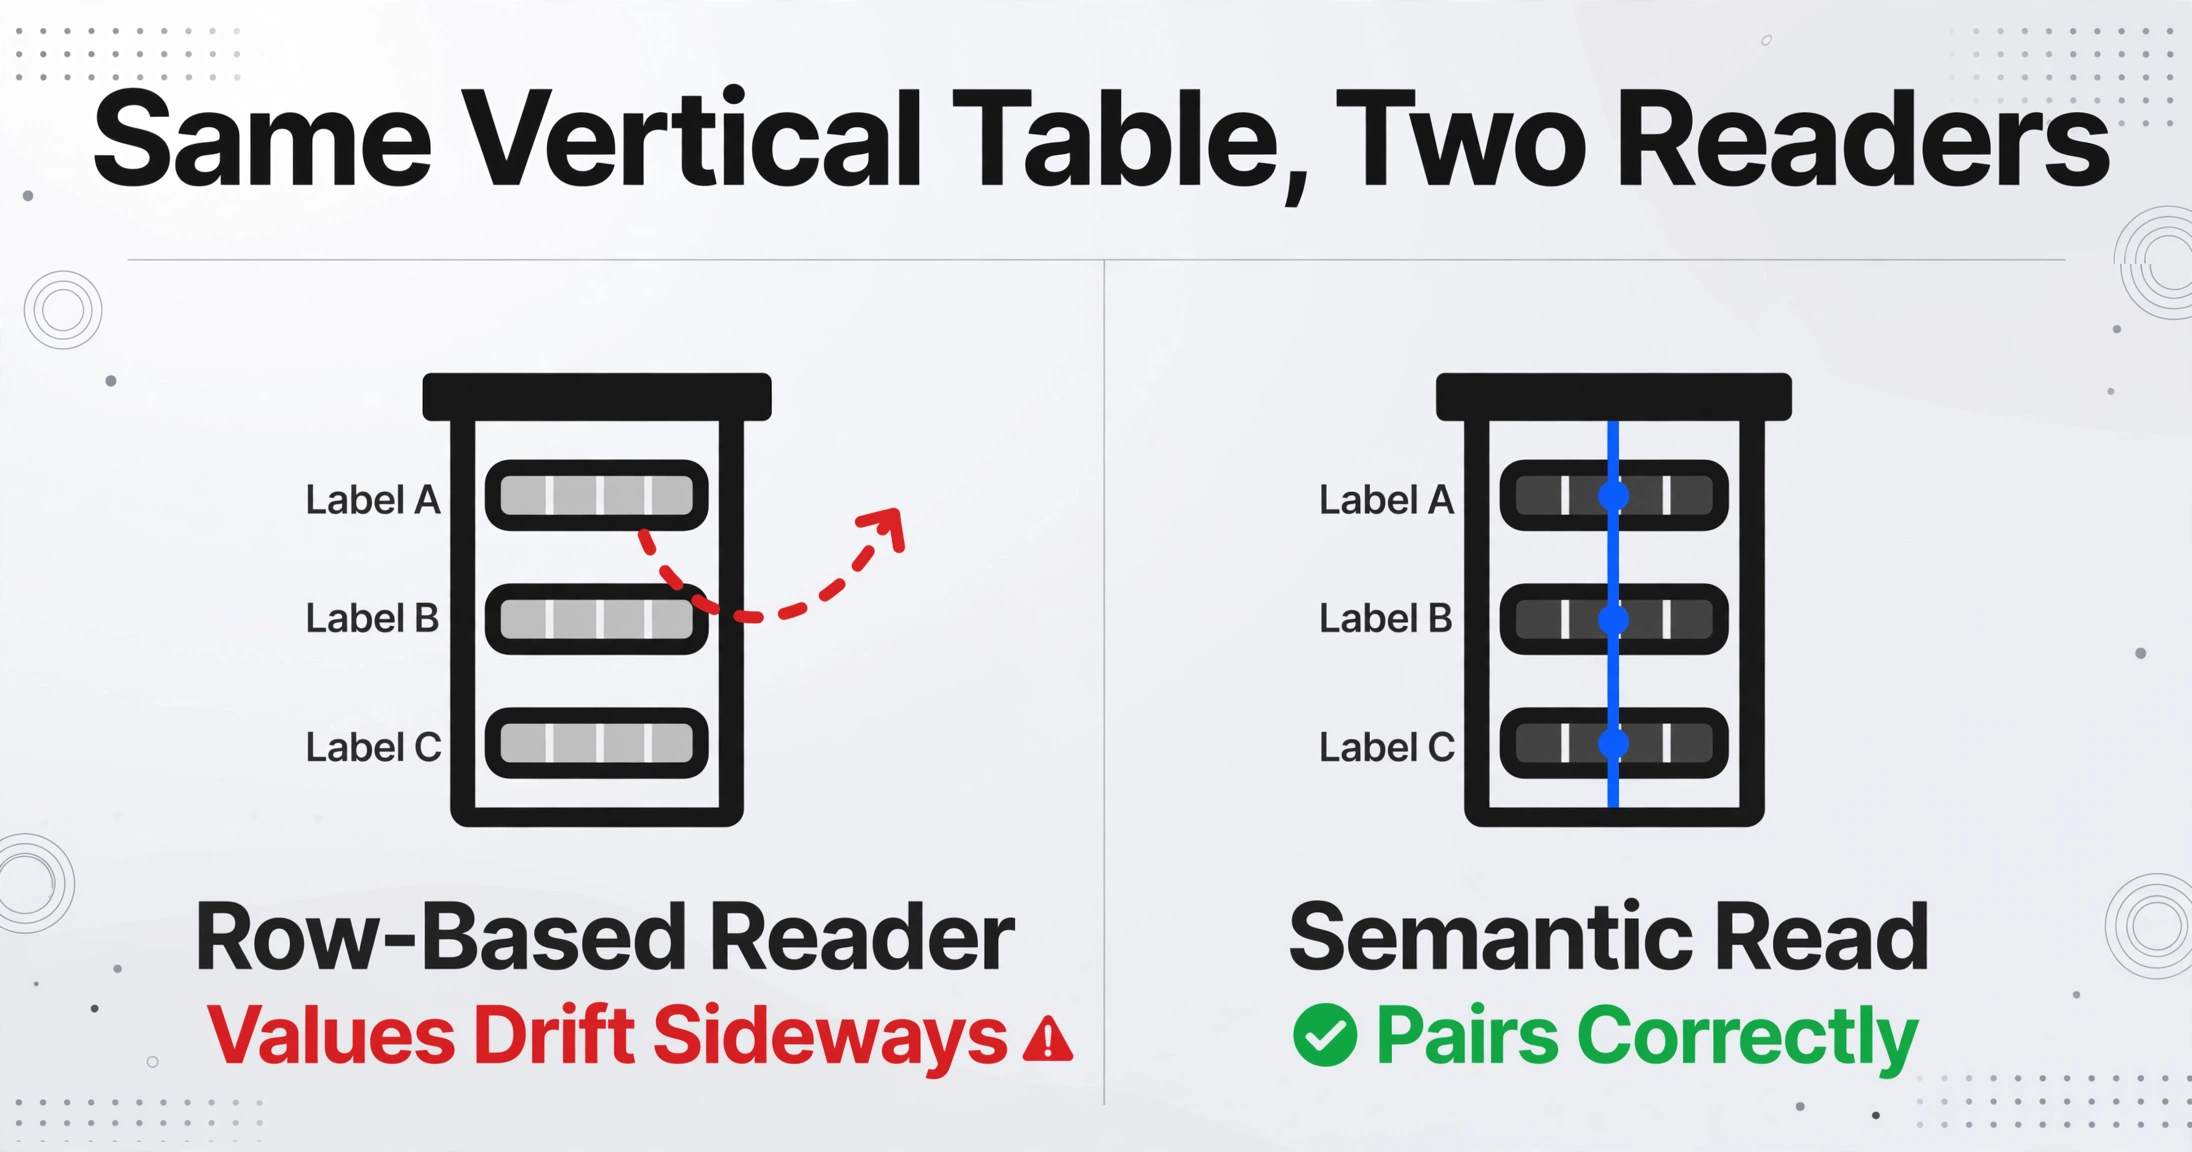
Eine vertikale Tabelle hat keine Zeile pro Maschine, daher erfindet ein zeilenbasierter Extraktor Zeilen, die nicht existieren. Das Layout, das der r/pdf-Poster beschrieb – ein Kopf über seinen Werten, mit mehreren solchen Streifen nebeneinander – ist genau die Struktur, die die Tabellenrekonstruktion aushebelt. Eine Person liest die Spalte der Seriennummern unter der Überschrift Serien-Nr. und die Spalte der Modellstrings unter Modell. Ein Tool, das ein Links-nach-rechts-Raster annimmt, paart stattdessen jedes Modell mit der Seriennummer, die in Lesereihenfolge zufällig folgt, sodass Werte seitwärts über die Seite driften.
Leute, die diese Software beruflich bauen, sagen in ihren eigenen Foren dasselbe. Ein Entwickler, der an Tabellenextraktion arbeitet, fasste die Lage in r/MachineLearning zusammen: „table transformer, paddleOCR, google doc AI, GOT OCR, GraphOCR, und viele sind gut bei einfacher Tabellenstruktur, scheitern aber daran, Tabellen mit komplexer Struktur zu erkennen und zu extrahieren.“ Ein anderer Praktiker im selben Thread war deutlicher: „Es ist auch meine Erfahrung, dass alle öffentlich veröffentlichten Modelle bei komplexen realen Tabellen völlig versagen“ (r/MachineLearning). Dass das Scheitern strukturell ist und kein OCR-Genauigkeitsproblem, wird in einem Thread zur Tabellenextraktion klar formuliert: „OCR ist gut bei Zeichen, aber Tabellen drehen sich um Beziehungen (Zeilen-/Spalten-/Kopf-Bedeutung). Die meisten Fehler sind strukturell, nicht ‚schlechtes OCR‘“ (r/founderledsales).
Eine Seite kann eine Maschine oder hundert tragen. Der r/pdf-Poster notierte 1 bis 100 Hersteller-/Modell-/Seriennummern-Sets pro Seite, was bedeutet, dass der Extraktor nicht „eine Seite, ein Asset“ annehmen kann. Jedes Werteset muss gegen sein eigenes Label lokalisiert werden – genau hier wird der Fehler teuer: Eine Registerzeile aus zwei auseinandergedrifteten Spalten hat ein Modell von einer Maschine und eine Seriennummer von einer anderen, und nichts an der Zeile sieht falsch aus, bis eine Suche fehlschlägt.
Scans fügen eine zweite Fehlerquelle hinzu: die Zeichen selbst
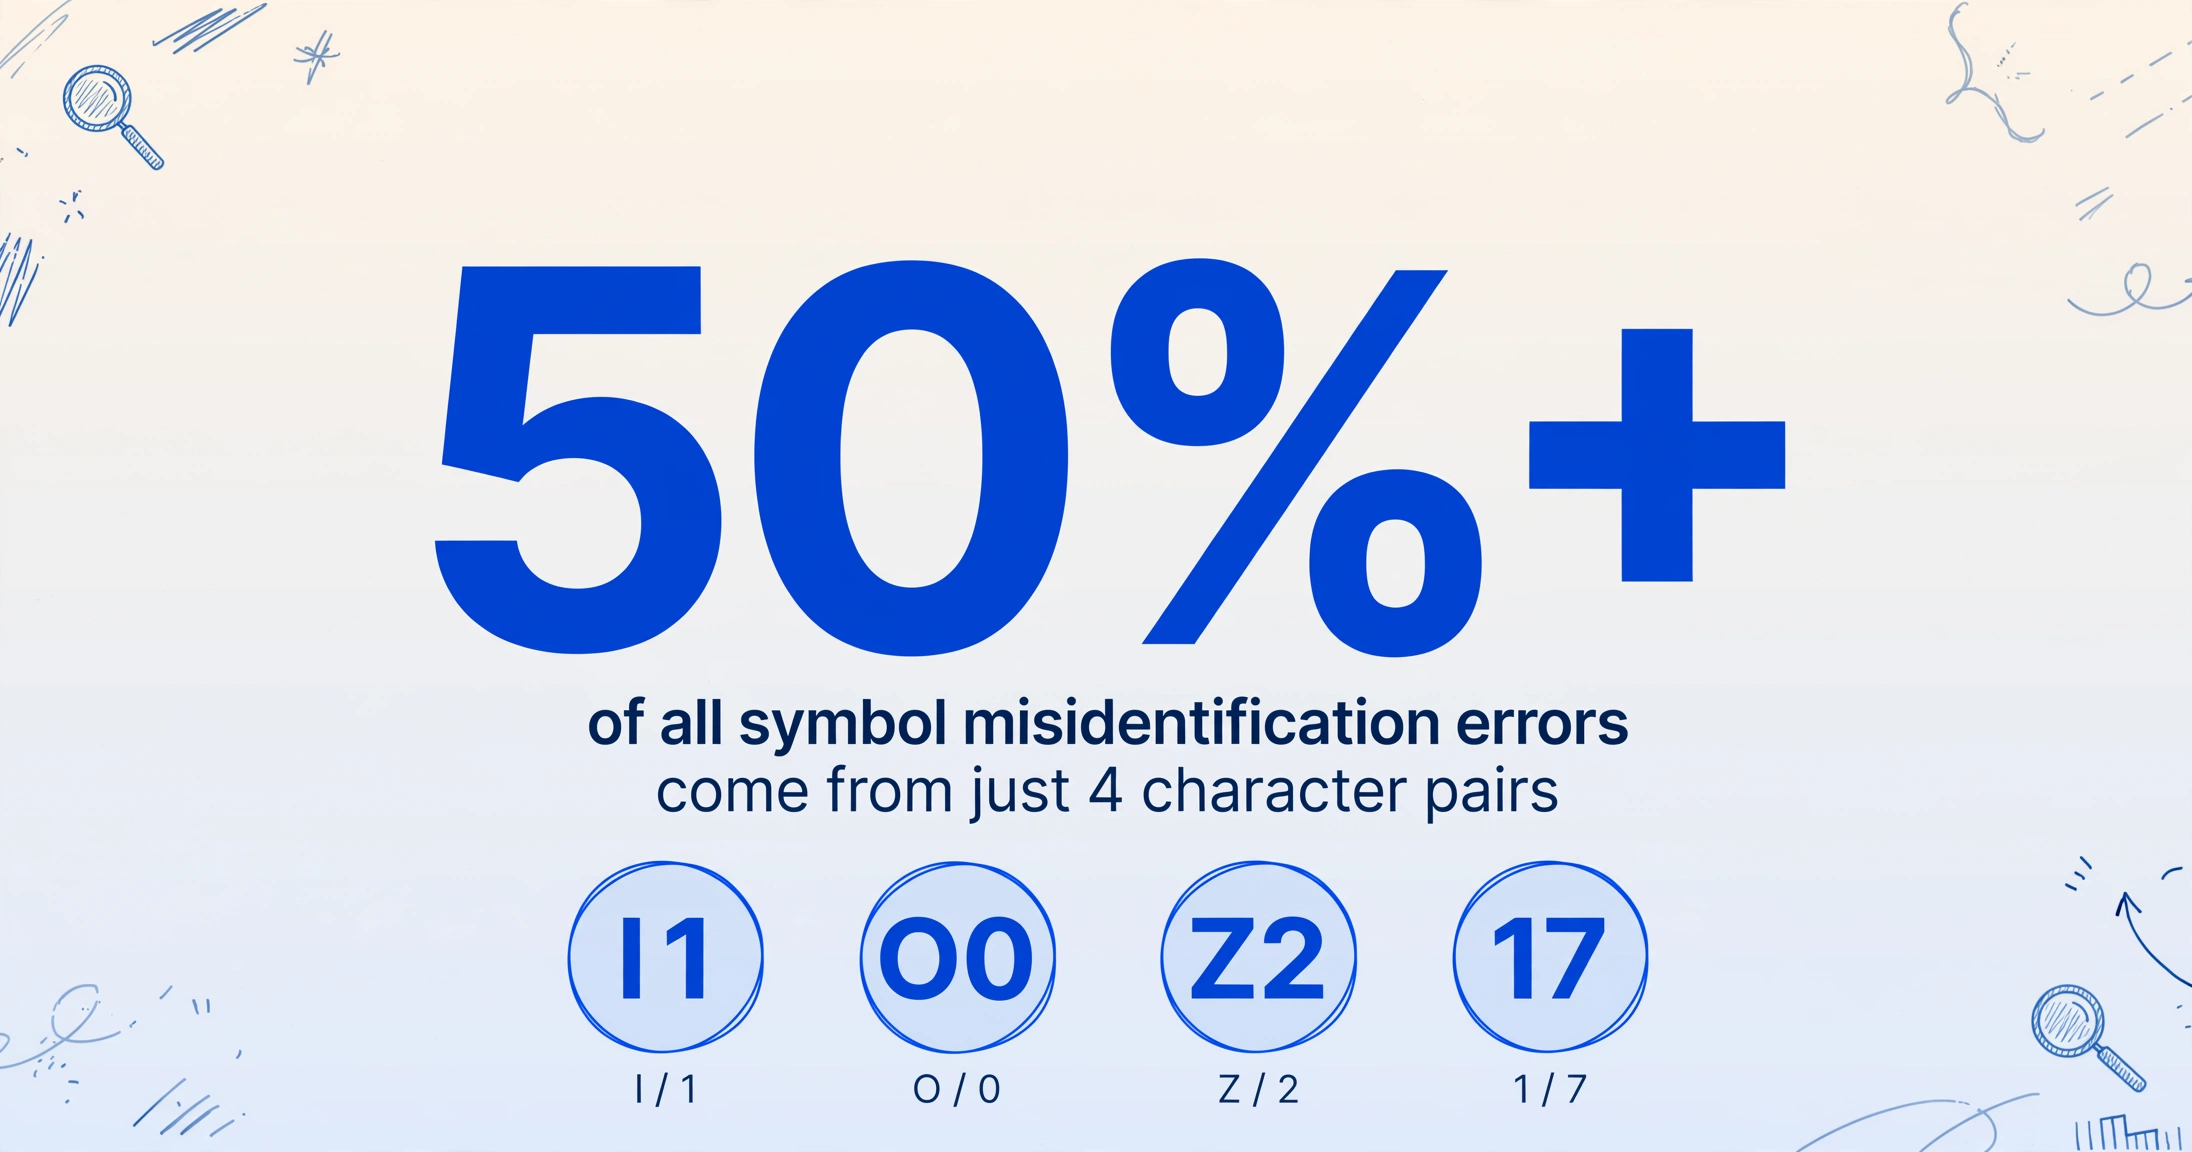
Ein Scan fügt zusätzlich zum Layoutproblem eine zweite Fehlerquelle hinzu: Die Zeichen können falsch gelesen werden. Seriennummern laden dazu ein, weil sie kurz, alphanumerisch und bewusst reich an ähnlich aussehenden Zeichen sind. Der Buchstabe O und die Ziffer 0, das kleine l und die Ziffer 1, die Buchstaben Z und 2 sowie B und 8 sind die klassischen Paare, und die angewandte Forschung hat das Ausmaß dokumentiert: In den Arbeiten der Bell Laboratories, die in der medizinischen Literatur bis heute zitiert werden, waren die Paare l/1, O/0, Z/2 und 1/7 für mehr als die Hälfte aller Symbolverwechslungsfehler verantwortlich (PMC5614409). Ein einziges ersetztes Zeichen in einer Seriennummer macht daraus eine andere Zeichenkette, und eine andere Zeichenkette ist für jedes nachgelagerte System ein anderes Asset.
Die Kennung, die eine Maschine mit ihrer Historie verbindet, hängt davon ab, dass diese Zeichenkette intakt bleibt. Die GS1 General Specifications definieren den Global Individual Asset Identifier (GIAI) als digitalen Schlüssel, der ein Asset mit seinem Eigentümer, Standort, Wert und Lebenszyklusdaten verknüpft, und sie legen ausdrücklich fest, dass die Seriennummer des Herstellers im Zentrum dieser Kennung steht, dass sie sich während der Lebensdauer des Assets nicht ändern darf und dass Formatierungsvarianten wie Bindestriche, führende Nullen und Groß-/Kleinschreibung eine Suche scheitern lassen können (GS1 General Specifications). Branchenbeobachtungen beziffern die praktischen Kosten an derselben Stelle: MRO-Datenspezialisten berichten, dass die Mehrheit der industriellen ERP- und CMMS-Anlagendatensätze unvollständig ist, wobei technische Details „in PDF-Dokumenten gefangen" sind, die von vornherein nie in das System extrahiert wurden (Sharecat Data Services).
Die Tippphase ist der Teil, in dem sich Fehler konzentrieren. Eine systematische Übersichtsarbeit von 2023 zu Datenverarbeitungsmethoden in der klinischen Forschung hat genau die hier behandelte Aufgabe gemessen, einen Wert aus einem Quelldokument abzulesen und in eine Datenbank einzugeben, und die Fehlerrate der manuellen Datenerfassung aus Quelldokumenten auf 6,57 Prozent beziffert, gegenüber 0,29 Prozent beim direkten einmaligen Abtippen mit der Quelle vor der Person (Garza et al., 2023). Ablesen und erneutes Abtippen aus einem Dokument ist nachweislich der fehleranfälligste Weg, weshalb die Genauigkeit eines Registers bereits entschieden ist, bevor die erste Formel läuft, nämlich durch das, was die Person am Schreibtisch abgeschrieben hat.
Kein Lieferant teilt ein Format, und niemand kontrolliert es
Jeder Lieferant druckt dieselben drei Felder in einem anderen Layout, und die Partei, die die Dokumente erhält, hat kein Mitspracherecht. Die Community der Typenschild-Richtlinien hat dokumentiert, warum: UL 9691, die empfohlene Praxis für Typenschilder an elektrischen Betriebsmitteln, stellt klar fest, dass Typenschildinformationen selbst zwischen Produkten, die nach demselben Standard zertifiziert sind, stark variieren können, und dass „diese Variabilität im Feld zu Schwierigkeiten führt, da jeder Hersteller wesentliche Informationen in einem anderen Format basierend auf seiner Auslegung und Anwendung der Anforderungen bereitstellt" (UL 9691-2021).
Die Felder selbst sind standardisiert, auch wenn die Layouts es nicht sind. NFPA 79, die elektrische Norm für Industriemaschinen, verlangt auf Steuergeräten unter anderem ein Typenschild mit Hersteller, Modell und Seriennummer (NFPA 79), und das OPC-UA-Maschinenidentifikationsmodell behandelt die Seriennummer als Pflichteigenschaft jeder Maschinenidentität, eindeutig im Kontext ihres Herstellers und Modells (OPC UA 40001-1). Der Inhalt ist reguliert. Die visuelle Anordnung nicht, und genau deshalb scheitert vorlagenbasierte OCR immer wieder: Eine Vorlage ist eine Karte, wo ein Feld in einem Format sitzt, und Abweichungen zwischen Anbietern, selbst zwischen Revisionen eines Anbieters, machen die Karte ungültig.
Asset-Management-Standards legen die Verantwortung auf das Register und nicht auf das Dokument. ISO 55013:2024, die Richtlinie für die Verwaltung von Daten im Asset-Management-Kontext, verlangt von Organisationen, Qualitätsanforderungen für Asset-Daten festzulegen, einschließlich Genauigkeit, Vollständigkeit, Konsistenz und Aktualität, und die Datenqualität zu verstehen, bevor sie für Entscheidungen verwendet wird (ISO 55013:2024). In der Praxis bedeutet diese Klausel, dass das Register eine dokumentierte Genauigkeitsanforderung hat und der manuelle Eingabepfad daran gemessen werden muss. Die allgemeinen Mechanismen zur Konvertierung gescannter Dokumente werden in Extrahieren gescannter PDFs in eine Tabellenkalkulation und dem Tabellenextraktionsansatz, der für einfachere Layouts funktioniert behandelt.
Die Lösung: Sagen, was Sie wollen, nicht wo es steht
Die Lösung besteht darin, nach Bedeutung statt nach Position zu extrahieren. Benutzerdefinierte Spaltenextraktion funktioniert genau umgekehrt zu Vorlagen: Sie geben die gewünschten Spaltennamen ein – Hersteller, Modell und Seriennummer – und die KI lokalisiert jeden Wert im Dokument, indem sie versteht, was das Feld bedeutet, statt eine feste Zone oder Vorlage abzugleichen. Die eingegebenen Spaltennamen werden zu den exakten Kopfzeilen der Ausgabetabelle. Da die Suche semantisch ist, spielt das Layout keine Rolle mehr: Die Kopfzeile „Seriennr." über ihren Werten wird als das Label gelesen, das sie ist, und die Werte darunter landen in der Spalte Seriennummer – egal ob die Seite ein vertikaler Streifen oder dreigeteilt ist, egal ob der Text über, unter oder neben dem Label steht.
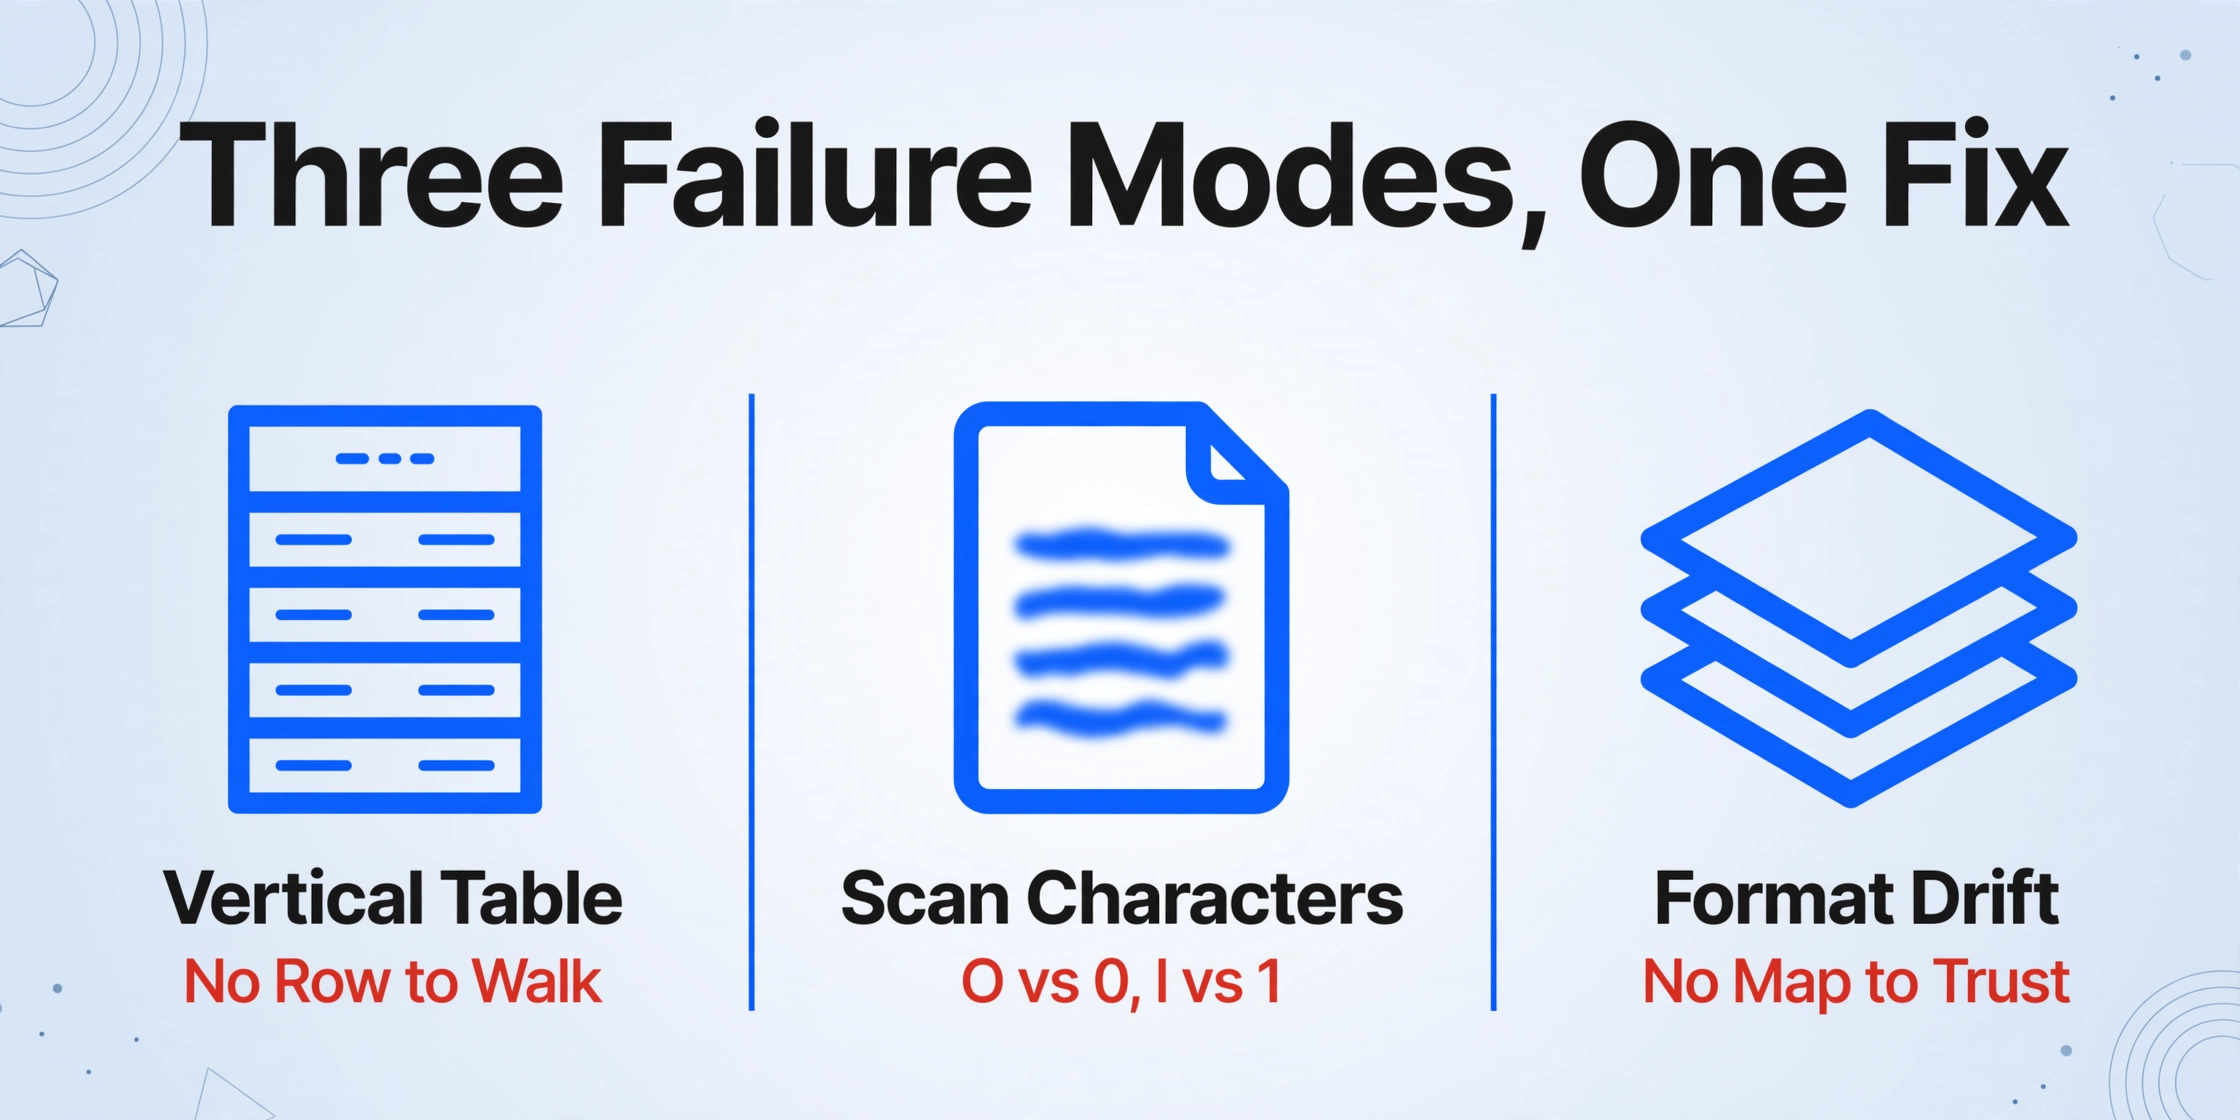
Dieser eine Mechanismus beantwortet alle drei Fehlerbilder aus den vorherigen Abschnitten. Die vertikale Tabelle verliert ihre Bedrohung, weil keine Zeilenstruktur rekonstruiert werden muss: Die KI verankert sich an der Bedeutung des Labels. Die Mischung aus Scan und Digitalem verliert ihre Bedrohung, weil beides durch denselben semantischen Lesevorgang läuft, ohne separate OCR-Pipeline pro Quelle. Und die Formatdrift verliert ihre Bedrohung, weil es keine Vorlage gibt, die ungültig werden könnte: Ein neues Lieferantenlayout ist einfach nur eine weitere Seite. Die ursprüngliche Beschwerde, die diesen Thread gestartet hat, stellte genau diese Frage – ob ein Tool „die Hersteller-, Modell- und Seriennummer mit den Kopfzeilen über den Daten" verarbeiten könne. Genau dieses Layout liest dieser Ansatz nativ.
Der Rest des Workflows folgt dem Register, das das Team bereits führt. Laden Sie den gesamten Ordner als einen Batch hoch, und die Stapelverarbeitung führt jede Datei zu einer Tabelle zusammen – eine Zeile pro Dokument, durchgehend mit denselben drei Kopfzeilen. Modellstufe ermöglicht es dem Konto, für Batches mit schlechter Lesbarkeit ein stärkeres Vision-Modell auszuführen – kontrastarme Scans, staubige oder laminierte Typenschilder und Dokumente, bei denen sich zusätzliche Präzision auszahlt. Und da eine Seriennummer mit einem falschen Zeichen schlimmer ist als eine leere, zeigt Review Mode, woher jeder extrahierte Wert stammt: Wenn Sie eine Zelle überfahren, wird der genaue Bildbereich des Originaldokuments hervorgehoben, aus dem der Wert gelesen wurde – so wird die 0-gegen-O-Frage zu einem Blick auf die Quelle statt zu einer Vermutung.
Schritt für Schritt: Von einem Ordner mit PDFs zu Registerzeilen
Der Workflow umfasst vier Schritte, und keiner davon erfordert das Zeichnen von Rahmen oder das Erstellen eines Parsers pro Lieferant. Hier ist der Durchlauf für den nächsten gemischten Batch, der auf dem Schreibtisch landet.
Die Spalten benennen, die das Register benötigt
Geben Sie die Feldnamen so ein, wie sie erscheinen sollen: Hersteller, Modell, Seriennummer, und fügen Sie Tag- oder Standortspalten hinzu, falls das Register diese führt. Diese Namen werden zu den Kopfzeilen der Ausgabe und sollten daher exakt mit dem Registerblatt übereinstimmen – kein Übersetzungsschritt im Nachhinein.
Den gesamten Ordner als einen Batch hochladen
Gescannte Seiten, digitale PDFs und Typenschildfotos kommen in denselben Batch. Keine Vorverarbeitung, kein Sortieren nach Quelltyp, keine Mindestqualitätsprüfung. Die Stapelverarbeitung führt alles zu einer zusammengeführten Tabelle zusammen, sodass das Register in einem Durchlauf neu aufgebaut wird, statt Datei für Datei.
Die Werte prüfen, auf die Sie sich verlassen würden
Aktivieren Sie Auto-annotate, damit jede verarbeitete Datei mit markierten Quellbereichen zurückkommt. Fahren Sie über die relevanten Zellen, vor allem die Seriennummern, und bestätigen Sie jeden Wert gegen die hervorgehobene Stelle im Original. Der Schritt, der früher das erneute Lesen jeder Zeile bedeutete, bedeutet jetzt nur noch die Prüfung der markierten.
In das Register oder den CMMS-Import exportieren
Das Ergebnis wird als XLSX, CSV oder JSON exportiert, bereit zur Übernahme in die Registerarbeitsmappe oder vorbereitet für die Importvorlage, die Maximo, UpKeep, Fiix oder die Tabelle, die das Team bereits führt, erwartet. Für ein Team, das in Google Sheets arbeitet, extrahiert das Add-on direkt in das aktive Blatt.
Die Effizienzbasis macht die Rechnung offensichtlich: Die Produktspezifikation für diesen Workflow liegt bei 5 bis 10 Sekunden pro Seite gegenüber etwa 3 Minuten manueller Eingabe, mit einer Genauigkeit von bis zu 99 Prozent bei gedruckten Tabellendaten. Der Vorbehalt, der es ehrlich hält, ist, dass Registerdaten Wartungs-, Garantie- und Prüfentscheidungen speisen – deshalb ist der Prüfschritt nicht optional. Für den Batch-OCR-Pfad, den man meist zuerst ausprobiert, lohnt es sich, die Grenze klar zu benennen: Batch-OCR macht Dateien durchsuchbar, erzeugt aber keine Zeilen, und genau dieser Unterschied zählt hier.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was dieser Workflow weiterhin nicht leisten kann
Einige Grenzen sollten benannt werden, denn der Sinn der Extraktion ist hier ein Register, dem ein Team tatsächlich vertraut.
Ein Scan, den eine Person nicht lesen kann, ist nicht rekonstruierbar. Unscharfe, kontrastarme oder zerrissene Seiten erzeugen unzuverlässige Ergebnisse – unabhängig von der Modellstufe. Die richtige Maßnahme ist, einen neuen Scan oder ein Foto des physischen Typenschilds anzufordern, statt unlesbare Ausgaben zu bereinigen.
Manche mehrdeutigen Zeichen bleiben wirklich mehrdeutig. Die Entscheidungen 0-gegen-O und l-gegen-1 lassen sich oft aus dem Kontext, dem Feld, der Abständen, der Format-Prüfsumme oder den umgebenden Zeichen ableiten. Review Mode existiert genau dafür, dass die Restfälle gegen das Bild geprüft statt geraten werden. Ein kleiner Anteil der Zeilen braucht weiterhin einen menschlichen Blick – das ist die ehrliche Grenze jedes Zeichenerkennungsansatzes.
Das Tool befüllt das Register aus den Dokumenten; es validiert die Dokumente nicht. Wenn ein Lieferant eine falsche Seriennummer gedruckt hat oder in der Quelldatei upstream ein Dateneingabefehler vorliegt, übernimmt die extrahierte Zeile diesen Fehler getreu. Bei Entscheidungen wie Garantieansprüchen, bei denen das Quelldokument die maßgebliche Aufzeichnung ist, bleibt die Prüfung gegen das physische Typenschild oder eine zweite Aufzeichnung die Kontrollinstanz.
Das Register ist das Ergebnis – und ein CMMS ist eine größere Entscheidung. Die Extraktion speist beides, aber sie zwingt ein Team nicht zur Wahl eines CMMS und ersetzt nicht die Typenschild-für-Typenschild-Prüfung, die eine physische Anlageninventur umfasst. Für Feld- und Industrieteams, die die größere Landschaft abwägen, zeigt die Übersicht der Extraktionstools für Feld und Industrie, wo jeder Ansatz passt, und die Fertigungsseite derselben Entscheidung ist getrennt behandelt in Dokumentextraktion für die Beschaffung in der Fertigung.
FAQ
Was genau ist eine vertikale Tabelle, und bricht sie wirklich die Extraktion?
Es handelt sich um ein Layout, bei dem die Feldbeschriftung über den Werten sitzt statt daneben, oft als mehrere schmale Streifen nebeneinander. Ja, es bricht zeilenbasierte Tabellenleser, weil ein zeilenbasierter Leser die Seite als Raster neu aufbaut und paarweise zusammenfügt, was in der Lesereihenfolge nebeneinander liegt, sodass Modelle und Seriennummern über die Seite driften. Semantische Extraktion liest die Beschriftung als Überschrift und nimmt die Werte darunter, sodass das Layout keine Rolle mehr spielt.
Unsere Dateien sind eine Mischung aus gescannten und digitalen PDFs. Brauchen wir zwei Einrichtungen?
Nein. Beide gehen in denselben Batch und werden vom selben semantischen Durchlauf gelesen, sodass eine gescannte Seite und ein digitaler Export als Zeilen in derselben Tabelle mit denselben Kopfzeilen landen. Die Mischung ist der Normalfall, kein Sonderfall.
Wie unterscheide ich eine falsch gelesene Seriennummer (0 vs. O, 1 vs. l) von einer korrekten?
Indem Sie auf die Quelle schauen. Review Mode hebt die genaue Stelle im Originaldokument hervor, aus der jeder Wert stammt, und beide Richtungen funktionieren: Fahren Sie über die Zelle, um die Bildposition zu sehen, klicken Sie auf eine Region, um zur Zelle zu springen. Aktivieren Sie Auto-annotate nach der Verarbeitung, damit die Prüfung für jede Zeile verfügbar ist, ohne etwas Zusätzliches auszuführen. Bei schwierigeren Scans gibt eine höhere Modellstufe dem zugrunde liegenden Vision-Modell mehr Spielraum bei komplexen oder kontrastarmen Seiten.
Wir nutzen bereits Maximo oder UpKeep. Ist das ein Ersatz?
Nein, und das muss es auch nicht sein. Die Registerdaten müssen irgendwie hineingelangen, und die Extraktion ersetzt das Abtippen beim Erfassungsschritt und erzeugt die importbereiten Zeilen, die ein CMMS erwartet. Für Teams, die noch kein CMMS nutzen, hält derselbe Durchlauf den Tabellenkalkulations-Workflow ohne manuelle Eingabe am Leben.
Wir haben Hunderte von Altseiten. Ist ein Batch dieser Größe realistisch?
Ja. Stapelverarbeitung ist genau dafür gebaut: Laden Sie alles auf einmal hoch und prüfen Sie das zusammengeführte Ergebnis, was ein Tipp-Projekt in eine Verifizierungsaufgabe mit denselben Spaltendefinitionen verwandelt. Die Bürozeit verschiebt sich von Tastatureingaben zu Stichprobenprüfungen, mit der Review Mode-Hervorhebung als Prüfpfad.
Welche Spalten sollte das Register über Hersteller, Modell und Seriennummer hinaus führen?
Der Standard-Mindestumfang aus der CMMS-Importpraxis umfasst neben dem OEM-Trio Tag- oder Asset-ID, Standort und Installationsdatum. Jede dieser Angaben kann als extrahierte Spalte hinzugefügt werden, sofern die Dokumente sie enthalten; Spalten, die im Dokument nicht vorkommen, bleiben einfach leer, ohne den Durchlauf zu unterbrechen.
Eine Seriennummer ist keine Notiz, sondern ein Schlüssel. Das Register hält Schlüssel für jede Maschine, die Ihre Dokumente beschreiben, und der Unterschied zwischen einem Register, das funktioniert, und einem, dem niemand vertraut, liegt darin, ob diese Schlüssel unversehrt angekommen sind.
Die nächste Charge, die in Ihrem Postfach landet, enthält jede Seriennummer, die Ihrem Register fehlt. Benennen Sie die drei Spalten einmal, lassen Sie den Ordner durchlaufen und prüfen Sie die Werte gegen die Originalseiten – dann hängt das Register nicht mehr von der Person am Schreibtisch ab, die dasselbe Dokument zweimal abtippt.