スキャン・デジタルPDFからメーカー、モデル、シリアル番号を 取得
このワークフローが生成する機器台帳の品質は、メーカー、モデル、シリアル番号の列にかかっており、その列の品質はPDFから転記する担当者次第です。顧客やサプライヤーから届く書類では、モデルの文字列は通常、その上に印刷されたヘッダーの下に配置されています。つまり、細い帯の上部に「Model」という単語、その下に値、次の帯にも同様に「Serial No.」が配置されています。一度開いたことがある人なら、どのフィールドかは分かります。抽出の問題は、ページに行ベースのテーブルリーダーが辿るべき行構造がないため、何も処理できないことです。
重要ポイント
- 台帳が頻繁に間違う場合、OCR(文字認識)を疑いがちですが、縦型テーブルは行ベースのリーダーに辿るべき構造を与えません。
- ソース文書からの値の再入力は6.57%のエラー率ですが、ソースを目の前に置いてキー入力する場合は0.29%です。
- 列を一度指定すれば、ImageToTable.aiが意味に基づいて各値を特定するため、次のサプライヤーのレイアウトも単なる別のページに過ぎません。
この障害モードは、実際にこの作業を行っている人物によって正確に説明されています。r/pdf で、1日に10〜100件の顧客PDFを開くユーザーはこう書いています。「顧客から届く1日10〜100ページのPDFを処理していますが、メーカー、モデル、シリアル番号を手動でテーブルに書き出す必要があります。」さらに、そのページは「スキャンされたものと通常のものが混在しており、PDFごとにフォーマットが異なることが多く、作業が難しくなります。ほとんどの場合、列のタイトルがシリアルで、その下に値が縦に並ぶ縦型テーブルになっています。」同じスレッドの別のコメント投稿者は、解決策が提示される前にこう答えています。「縦型テーブルは標準的なOCRにとって常に頭痛の種です。私も似たような乱雑なPDFレイアウトを扱ったことがあります」(r/pdf)。
メーカー、モデル、シリアル番号は、目で見つけるのは難しくありません。問題は、タイピングの工程を経ずに台帳に記録することが難しく、その工程を妨げるレイアウトが一般的すぎて、名前が付いているほどだということです。
この問題を抱える読者は、日々のベンダーや顧客からの書類(機器仕様書、銘板写真、カタログ、サービス・校正記録)と、記録すべき台帳を持つあらゆるチームです。運用、調達、資産管理、そして機器の再評価を行う財務スタッフは、すべて同じ3つのフィールドに触れます。名称は異なり、フォーマットは決して一致せず、台帳は半分だけ正しいシリアル番号を、空白のものと同じくらい受け入れません。この記事では、そのワークフローが実際にどこで停滞するのか、そしてレイアウトに依存しない抽出処理が何を変えるのかを説明します。
この作業を行うのは誰か、そして台帳がそれに求めるもの
結果に3つの役割が関わっていても、作業は1つのデスクに集中します。受入コーディネーター、サービス・資産管理者、またはアカウントマネージャーが各PDFを開き、3つの値を読み取り、台帳となるシートに入力します。台帳自体は通常Excelワークブックであり、ある時点でCMMSにインポートされるか、保証、校正、交換の判断のために照会されます。実務者がその下流側で実際に使用するツールには、IBM Maximo、UpKeep、Fiix、Limble、eMaintがあり、そのすべてがドキュメントではなく行をインポートします。
| 役割 | 実際の作業内容 | データの逸脱が始まり得る箇所 |
|---|---|---|
| 受入コーディネーター | 各PDFを開き、メーカー、モデル、シリアル番号を目で読み取り、台帳シートに入力する | 行を飛ばす、数字を入れ替える、低解像度スキャンからコピーする、ヘッダーを値として読み取る |
| 資産・管理リード | 台帳を管理し、各行をタグと場所に照合し、CMMSへのインポートを準備する | 入力された行を信頼する。物理タグとの不一致は、検証または監査時にのみ表面化する |
| 財務・調達 | シリアル番号にリンクされた記録を、保証請求、減価償却、スペアパーツ再発注、廃棄に使用する | 誤ったシリアル番号は、すべての下流システムにとって異なる資産となるため、検索は何も返さないか、誤った機械を返す |
登録情報は、メーカー、モデル、シリアル番号、タグまたは資産ID、設置場所、設置日という小さなフィールドセットに収束します。これらのフィールドで構築された登録情報は、保守ログをPMスケジュールに変換するで説明した保守判断をサポートします。また、インポートの仕組みも重要です。ほぼ正しい値が並んだシートでも、ERPの境界で失敗するからです。この失敗については、クリーンなスプレッドシートがERPに拒否される理由のガイドで詳しく説明しています。
縦型テーブルは行ベースのリーダーに読み取る手がかりを与えない
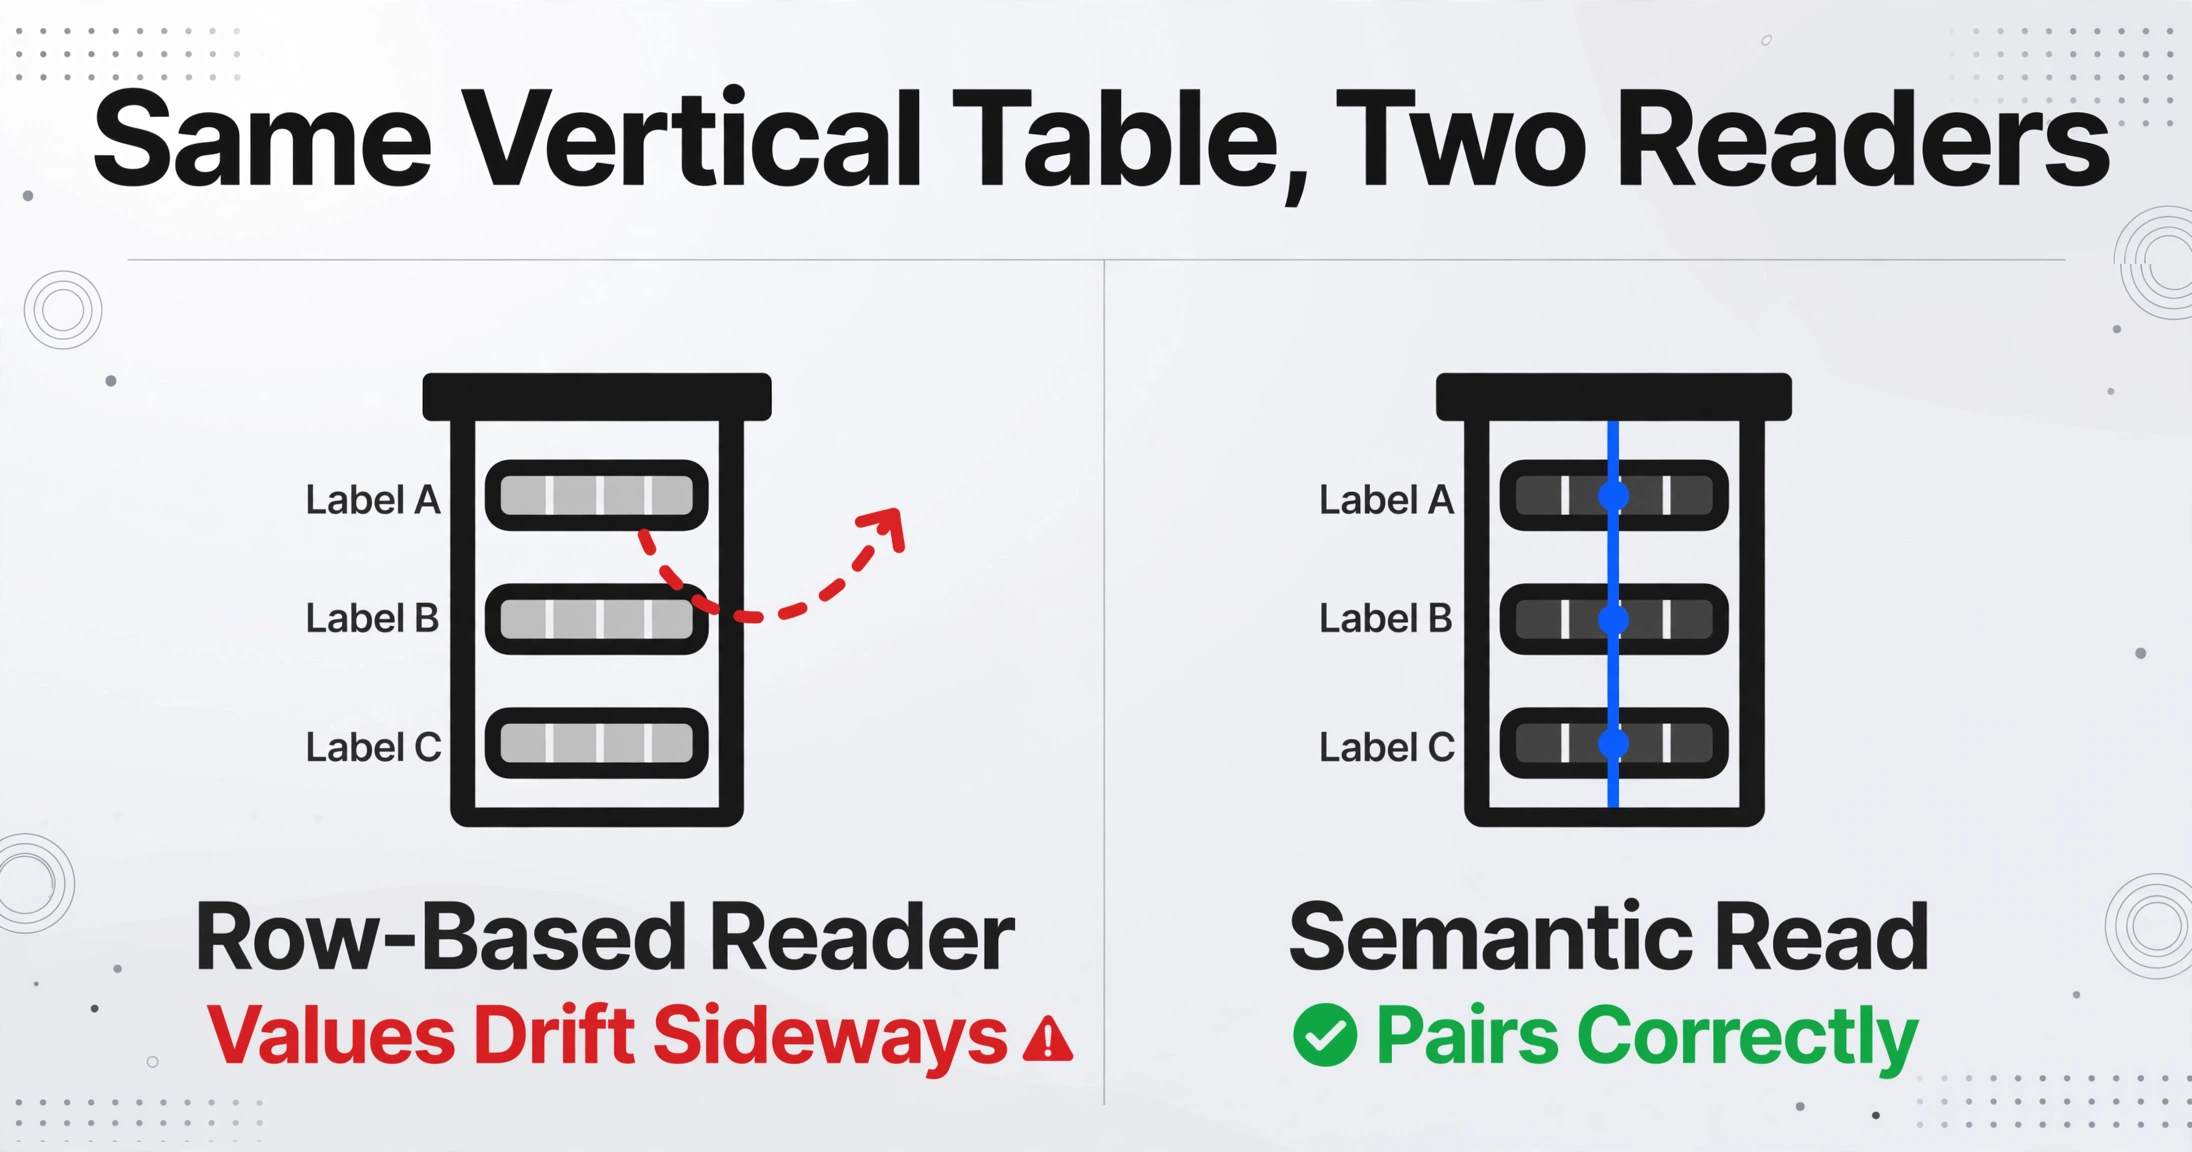
縦型テーブルには機械ごとの行がないため、行ベースの抽出ツールは存在しない行をでっち上げてしまいます。r/pdfの投稿者が説明したレイアウト、つまりヘッダーが値の上に印刷され、そのようなストリップが横に並ぶ構造は、まさにテーブル再構築を妨げる構造です。人間はSerial No.ヘッダーの下のシリアル番号の列と、Modelの下のモデル文字列の列を読み取ります。一方、左から右へのグリッドを前提とするツールは、すべてのモデルを読み取り順で後続するシリアル番号とペアリングしてしまうため、値がページ上で横にずれてしまいます。
このソフトウェアを職業として開発している人々も、自身のフォーラムで同じことを述べています。テーブル抽出に取り組む開発者はr/MachineLearningで状況を次のように要約しました。「table transformer、paddleOCR、google doc AI、GOT OCR、GraphOCRなど、多くのツールは単純なテーブル構造には優れているが、複雑な構造のテーブルの検出と抽出には失敗する」。同じスレッドの別の実務者はさらに率直でした。「公開されているモデルはすべて、複雑な実世界のテーブルでは完全に失敗するというのが私の経験でもある」(r/MachineLearning)。この失敗がOCRの精度の問題ではなく構造的なものである理由は、テーブル抽出に関するスレッドで明確に述べられています。「OCRは文字には優れているが、テーブルは関係性(行/列/ヘッダーの意味)に関するものだ。ほとんどの失敗は構造的なものであり、『OCRが悪い』わけではない」(r/founderledsales)。
1ページに1台の機械しかない場合もあれば、100台ある場合もあります。r/pdfの投稿者は、1ページあたり1〜100セットのメーカー/モデル/シリアル番号があると指摘しました。つまり、抽出ツールは「1ページ=1資産」と想定できません。すべての値セットを、それぞれのラベルに対応付けて配置する必要があります。ここで失敗が高くつくのです。ずれてしまった2つの列から構築された登録行には、ある機械のモデルと別の機械のシリアル番号が含まれており、ルックアップが失敗するまで、その行の何が問題なのかは誰にもわかりません。
スキャンは第二のエラー源を追加する:文字そのもの
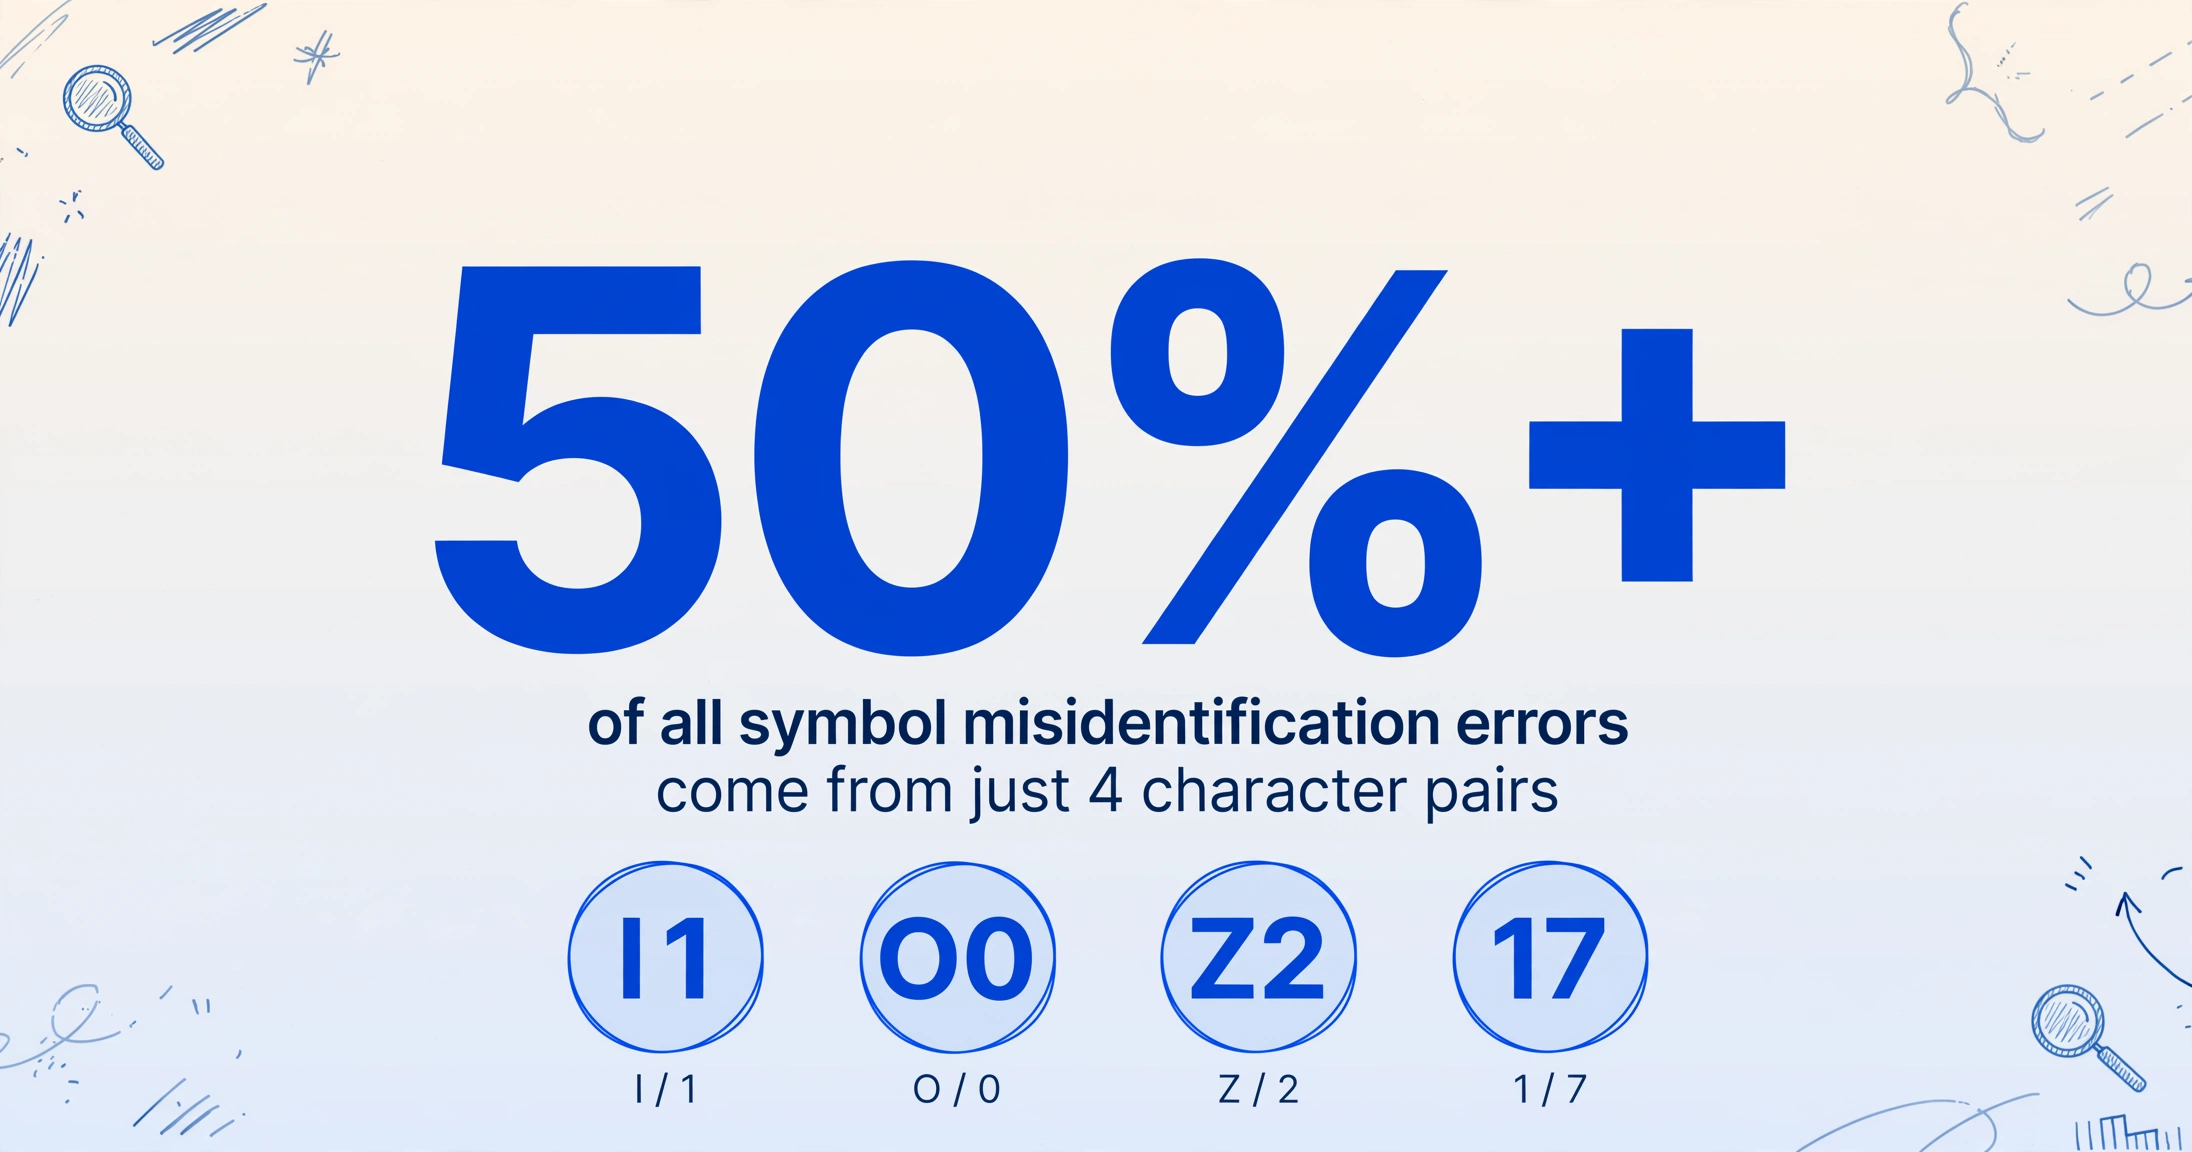
スキャンはレイアウトの問題に加えて、第二のエラー源を追加する:文字が誤って読み取られる可能性がある。シリアル番号は短く、英数字で、意図的に似た文字が多く含まれるため、この問題を招きやすい。文字Oと数字0、小文字のlと数字1、文字Zと2、そしてBと8は古典的なペアであり、応用研究はその規模を文書化している:医療文献で今も引用されるBell Laboratoriesの研究では、l/1、O/0、Z/2、1/7のペアが全記号誤認識エラーの半数以上を占めていた(PMC5614409)。シリアル番号の1文字が置き換わると、それは別の文字列になり、別の文字列は下流のすべてのシステムにとって別の資産になる。
機械をその履歴に結びつける識別子は、その文字列が無傷であることに依存している。GS1 General Specificationsは、Global Individual Asset Identifier(GIAI)を、資産をその所有者、場所、価値、ライフサイクル記録にリンクするデジタルキーとして定義し、メーカーのシリアル番号がその識別子の中心にあり、資産の寿命中に変更してはならず、ハイフン、先頭のゼロ、大文字小文字などの書式のばらつきが検索を壊す可能性があることを明示している(GS1 General Specifications)。業界の観察は実際のコストを同じ場所に置いている:MROデータ専門家は、産業用ERPおよびCMMS機器レコードの大部分が不完全であり、技術的な詳細が「PDFドキュメントの中に閉じ込められたまま」で、そもそもシステムに抽出されたことがないと報告している(Sharecat Data Services)。
タイピングの段階はエラーが集中する部分である。臨床研究におけるデータ処理方法に関する2023年の系統的レビューは、ここで扱うタスクそのもの、つまりソースドキュメントから値を読み取り、データベースに入力することを正確に測定し、ソースレコードからの手動抽出のエラー率を6.57パーセントと統合した。一方、オペレーターの目の前にソースがある状態での単純な直接キー入力では0.29パーセントだった(Garza et al., 2023)。ドキュメントから読み取って再入力することは、測定可能な範囲で最もエラー率の高い経路であり、それが、レジスターの正確性が最初の数式が実行される前に、机にいる人がコピーした内容によって決まる理由である。
サプライヤー間でフォーマットが統一されておらず、誰もそれを管理していない
どのサプライヤーも同じ3つの項目を異なるレイアウトで印刷しており、ドキュメントを受け取る側には発言権がありません。ネームプレートガイダンスのコミュニティはその理由を文書化しています。電気機器のネームプレートに関する推奨慣行であるUL 9691は、同じ規格に適合した製品間でもネームプレート情報が大きく異なる可能性があること、そして「このばらつきは、各メーカーが要件の解釈と適用に基づいて必須情報を異なるフォーマットで提供するため、現場で困難を引き起こす」と明記しています(UL 9691-2021)。
レイアウトは標準化されていなくても、項目自体は標準化されています。産業機械の電気規格であるNFPA 79は、制御機器にサプライヤー名、モデル、シリアル番号を記載したネームプレートを、他の表示とともに貼付することを要求しています(NFPA 79)。また、OPC UAの機械識別モデルは、シリアル番号をすべての機械IDの必須プロパティとして扱い、メーカーとモデルのコンテキスト内で一意であるとしています(OPC UA 40001-1)。内容は規制されていますが、視覚的な配置は規制されていません。これこそが、テンプレートベースのOCRが壊れ続ける理由です。テンプレートは、あるフォーマット上のフィールドの位置を示すマップであり、ベンダー間の差異、さらには同じベンダーのリビジョン間の差異によって、そのマップが無効になるからです。
資産管理規格は、ドキュメントではなく台帳に責任を課しています。資産管理の文脈でデータを管理するためのガイダンスであるISO 55013:2024は、組織に対し、正確性、完全性、一貫性、適時性を含む資産データの品質要件を指定し、意思決定に使用する前にデータ品質を理解することを要求しています(ISO 55013:2024)。実際には、この条項は台帳に文書化された正確性要件があり、手動入力経路がそれに対して測定される必要があることを意味します。スキャンしたPDFをスプレッドシートに変換する一般的な仕組みは、スキャンしたPDFをスプレッドシートに抽出する方法とより単純なレイアウトに有効なテーブル抽出アプローチで説明しています。
## 修正策:位置ではなく、内容を指定する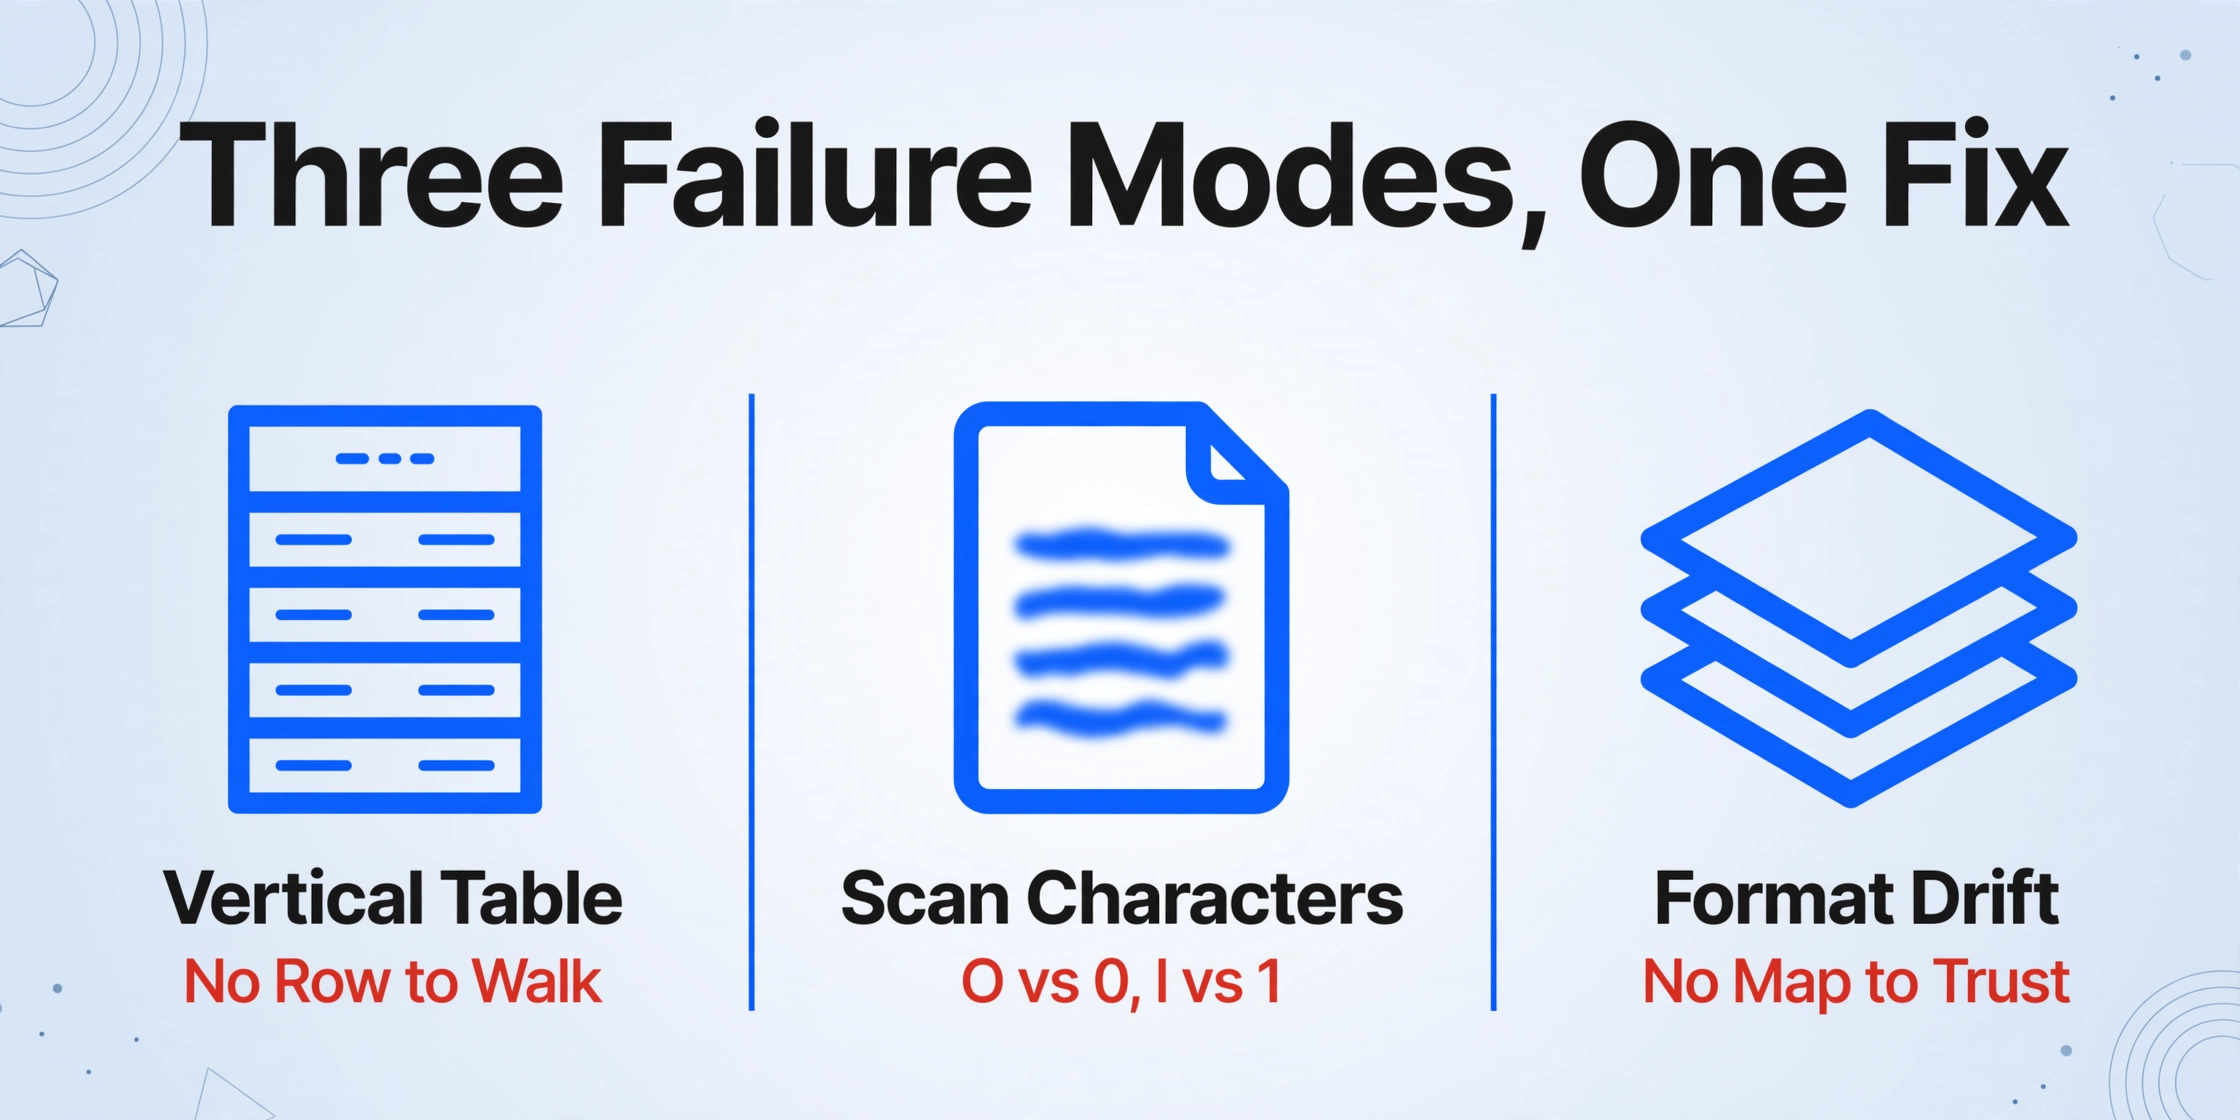
解決策は、位置ではなく意味に基づいて抽出することです。カスタム列抽出はテンプレートとは逆の考え方で動作します。必要な列名(メーカー、モデル、シリアル番号)を入力するだけで、AIがフィールドの意味を理解してドキュメント内の各値を特定します。固定の領域やテンプレートに一致させる必要はありません。入力した列名がそのまま出力テーブルのヘッダーになります。検索が意味ベースであるため、レイアウトは問題ではなくなります。値の上にあるSerial No.ヘッダーはラベルとして読み取られ、その下の値は、ページが縦一列でも3列でも、テキストがラベルの上・下・横のどこにあっても、シリアル番号列に格納されます。
この仕組みだけで、前のセクションで挙げた3つの失敗モードすべてに対応できます。縦一列の表は、行構造を再構築する必要がないため脅威ではなくなります。AIがラベルの意味に基づいて位置を特定するからです。スキャン文書とデジタル文書の混在も、両方が同じ意味ベースの読み取り処理を経由するため、ソースごとに別のOCRパイプラインを用意する必要がなく、脅威ではなくなります。フォーマットのゆらぎも、無効になるマップが存在しないため脅威ではありません。新しいサプライヤーのレイアウトは、単なる別の1ページにすぎません。このスレッドの発端となった最初の質問は、まさにこの点を尋ねていました。「データの上にヘッダーが記載されたメーカー、モデル、シリアル番号」を処理できるツールがあるかどうか。このアプローチは、まさにそのレイアウトをネイティブに読み取ります。
残りのワークフローは、チームが既に守っている運用方針に従います。フォルダ全体を1つのバッチとしてアップロードすると、バッチ処理がすべてのファイルを1つのテーブルにマージし、ドキュメントごとに1行、全体で同じ3つのヘッダーが使用されます。モデルティアを使用すると、視認性の悪いバッチ(コントラストの低いスキャン、ほこりやラミネート加工された銘板、追加の精度が価値に見合うドキュメントなど)に対して、より強力なビジョンモデルを実行できます。また、1文字でも誤りがあるシリアル番号は空白よりも深刻な問題であるため、確認モードでは各抽出値の出所が表示されます。任意のセルにカーソルを合わせると、それが読み取られた元画像の正確な領域がハイライト表示されるため、Oと0の判別は推測ではなく、ソースを一目見るだけで済みます。
ステップバイステップ:PDFフォルダからレジスタ行へ
ワークフローは4つのステップで構成され、いずれも枠の描画やサプライヤーごとのパーサー構築は不要です。次に机に届く混合バッチに対して実行する手順は以下の通りです。
レジスタに必要な列名を指定する
表示させたいフィールド名(メーカー、モデル、シリアル番号など)を入力し、レジスタが保持する場合はタグや位置情報の列も追加します。これらの名前が出力のヘッダーになるため、レジスタシートと完全に一致させ、後から変換作業が発生しないようにします。
フォルダ全体を1つのバッチとしてアップロードする
スキャンしたページ、デジタルPDF、銘板写真をすべて同じバッチに含めます。前処理やソースタイプによる仕分け、最低品質基準のチェックは不要です。バッチ処理によりすべてが1つの結合テーブルに統合され、レジスタをファイル単位ではなく一度の実行で再構築できます。
信頼できる値を検証する
Auto-annotateを有効にすると、処理済みの各ファイルにソース領域がマークされて返されます。重要なセル、特にシリアル番号にカーソルを合わせ、各値を元の画像のハイライト箇所と照合します。従来すべての行を再確認する必要があったステップが、フラグが付いたものだけを確認する作業に変わります。
レジスタまたはCMMSインポート用にエクスポートする
結果はXLSX、CSV、またはJSONでエクスポートされ、レジスタワークブックに直接取り込むか、Maximo、UpKeep、Fiix、またはチームが既に使用しているスプレッドシートが期待するインポートテンプレート用に準備できます。Google Sheetsで作業するチームの場合、アドオンはアクティブなシートに直接抽出します。
効率性の基準値で計算は明確です。このワークフローの製品仕様は、手動入力の約3分/ページに対して、1ページあたり5~10秒、印刷されたテーブルデータに対して最大99%の精度です。正直さを保つための注意点として、レジスタデータはメンテナンス、保証、監査の判断に使用されるため、検証ステップは必須です。通常最初に試されるバッチOCRパスの場合、境界線を明確にしておく価値があります:バッチOCRはファイルを検索可能にするが行は生成しない、これがここで重要な違いです。
ファイルは安全に処理され、保存されることはありません。
このワークフローでまだできないこと
いくつかの限界を明確にしておく必要があります。ここでの抽出の目的は、チームが実際に信頼できる台帳を作ることだからです。
人が読めないスキャンは復元できません。 ぼやけた画像、コントラストの低い画像、破れたページは、どのモデルティアでも信頼性の低い読み取り結果になります。その場合の正しい対応は、再スキャンを依頼するか、物理的な銘板の写真を撮ってもらうことであり、読み取り不能な出力を修正しようとすることではありません。
曖昧な文字は、やはり曖昧なままです。 0とO、lと1の判別は、文脈、フィールド、間隔、フォーマットのチェックサム、周囲の文字などから判断できることが多く、確認モードは、残ったケースを推測ではなく画像と照合して確認するために存在します。それでも、ごく一部の行は人の目での確認が必要です。これが、あらゆる文字認識アプローチの正直な限界です。
ドキュメントから台帳を埋めるものであり、ドキュメントを検証するものではありません。 ベンダーが誤ったシリアル番号を印刷した場合や、ソースファイルに上流のデータ入力エラーがある場合、抽出された行はそれを忠実に再現します。保証の権利などの判断において、ソースドキュメントが真実の記録である場合、物理的な銘板または別の記録との照合が管理手段として残ります。
成果物は台帳であり、CMMSの導入はより大きな判断です。 抽出はどちらにも対応しますが、チームにCMMSを選ばせるものではなく、物理的な資産棚卸しに伴う銘板から銘板への照合作業を置き換えるものでもありません。現場や産業チームがより広い状況を検討する場合、現場・産業向け抽出ツールの比較で各アプローチの適合性を説明し、同じ判断の製造業側については製造業の調達向けドキュメント抽出で説明しています。
FAQ
縦型テーブルとは具体的に何ですか?本当に抽出が失敗するのでしょうか?
フィールドのラベルが値の横ではなく上に配置されるレイアウトで、多くの場合、細いストリップが横に並んでいます。はい、行ベースのテーブルリーダーでは失敗します。行ベースのリーダーはページをグリッドとして再構築し、読み順で隣接するものをペアにするため、モデルとシリアル番号がページ上でずれてしまいます。セマンティック抽出はラベルを見出しとして読み取り、その下の値を取得するため、レイアウトは問題になりません。
ファイルはスキャンとデジタルPDFが混在しています。2つの設定が必要ですか?
いいえ。両方とも同じバッチに入り、同じセマンティックパスで読み取られるため、スキャンされたページとデジタルエクスポートは、同じヘッダーを持つ同じテーブルの行になります。混在は通常のケースであり、エッジケースではありません。
誤読されたシリアル番号(0とO、1とl)と正しいものをどう見分けますか?
ソースを見ることで見分けられます。確認モードは、各値が取得された元のドキュメントの正確な領域をハイライトし、両方向で機能します。セルにホバーすると画像の場所が表示され、領域をクリックするとセルにジャンプします。処理後に自動注釈をオンにすると、追加の実行なしで全行のチェックが利用可能になります。難しいスキャンの場合は、より高いモデルティアにより、複雑または低コントラストのページで基盤となるビジョンモデルに余裕が生まれます。
すでにMaximoやUpKeepを運用しています。これは置き換えですか?
いいえ、置き換える必要もありません。レジスタデータは何らかの方法で入力する必要があり、抽出は入力ステップでのタイピングを置き換え、CMMSが期待するインポート可能な行を生成します。まだCMMSを導入していないチームにとっては、同じパスが手入力なしでスプレッドシートのワークフローを維持します。
何百ものバックページがあります。その規模のバッチは現実的ですか?
はい。バッチ処理はまさにこのために作られています。すべてを一度にアップロードし、マージされた出力を確認します。これにより、タイピングプロジェクトが同じ列定義に対する検証タスクに変わります。オフィス側の時間はキーストロークからスポットチェックに移り、確認モードのハイライトが監査証跡となります。
台帳には、メーカー、モデル、シリアル番号以外にどの列を含めるべきですか?
CMMSインポートの実務における標準的な最小構成は、タグまたは資産ID、設置場所、設置日で、これらをOEMの3項目に加えます。これらのいずれも、ドキュメントに記載されている場合は抽出列として追加でき、ドキュメントにない列は空白のまま残り、処理を中断することはありません。
シリアル番号はメモではなく、キーです。台帳は、ドキュメントが記述するすべての機械のキーを保持し、機能する台帳と誰も信頼しない台帳の違いは、それらのキーが無傷で届くかどうかにあります。
次に届くバッチには、台帳に不足しているすべてのシリアル番号が含まれています。3つの列を一度指定し、フォルダーを処理して、元のページと値を照合すれば、台帳は同じ書類を二度入力する担当者に依存しなくなります。