Le guide complet du rapport quotidien de chantier
Extraction de données
Un rapport quotidien de chantier porte trois types de valeur distincts : c'est un document contractuel, un document de progression et une source de données pour le contrôle de projet. La plupart des équipes le traitent comme les deux premiers et ignorent le troisième — car extraire des données structurées de rapports de site manuscrits a historiquement nécessité soit une saisie manuelle, soit l'obligation pour les équipes de terrain d'utiliser des applications mobiles. Ce guide couvre l'ensemble : quelles données un rapport quotidien contient, pourquoi son extraction est importante, les défis uniques qui rendent ce document plus difficile qu'une facture ou un reçu, et comment l'extraction IA moderne transforme les rapports papier en données structurées sans demander à un seul membre d'équipe de changer sa façon de travailler.
Points clés
- 60 à 80 rapports quotidiens manuscrits, 1 800 à 3 200 points de données par mois — chaque chiffre doit être ressaisi par un gestionnaire de bureau avant d'atteindre la paie, la facturation ou la conformité.
- Depuis 15 ans, chaque tentative de numérisation a demandé la même chose impossible : qu'un surintendant terminant un quart de travail de 10 heures sur le terrain ouvre une application et tape au lieu de remplir un formulaire papier qu'il utilise depuis toute sa carrière.
- Vision AI lit les effectifs, les heures d'équipement et les quantités de matériaux à partir de tout formulaire manuscrit — ainsi les surintendants continuent d'utiliser le papier, et la feuille de calcul structurée arrive sans une seule frappe de ressaisie manuelle.
Qu'est-ce qu'un rapport quotidien de chantier ? (Et quelles données contient-il ?)
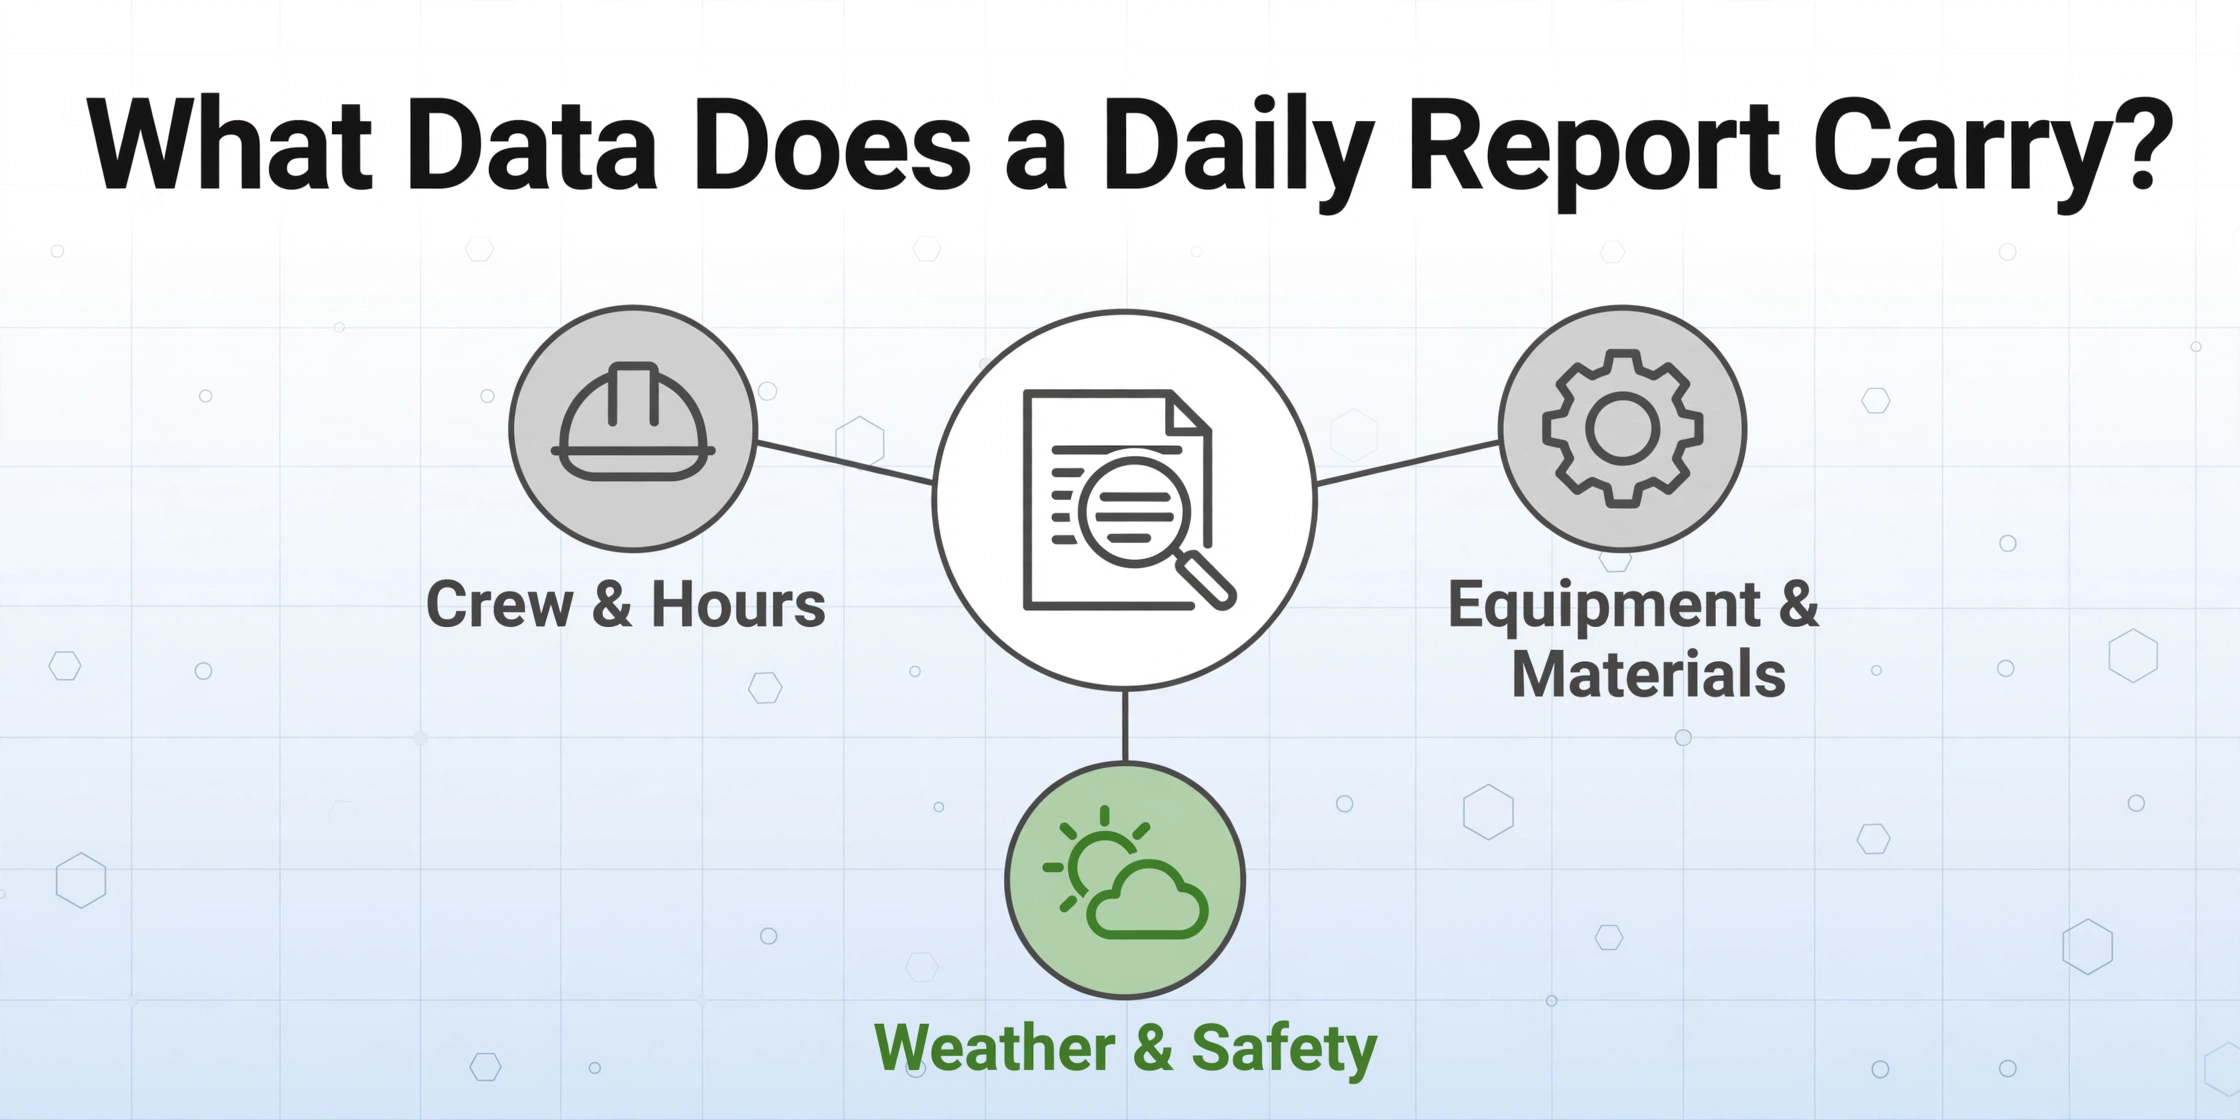
Un rapport quotidien de chantier — également appelé journal quotidien, rapport de site ou rapport de terrain — est le relevé écrit de tout ce qui s'est passé sur un chantier au cours d'une seule journée de travail. Sa base contractuelle provient de l'AIA A201-2017 §3.3.3.4, qui exige que l'entrepreneur conserve les registres d'inspection, les données d'essai et autres documents du projet sur le site. Bien que l'A201 définisse l'obligation de tenir des registres, l'industrie s'est accordée sur un ensemble standard de catégories d'informations présentes dans pratiquement tous les formulaires de rapport quotidien utilisés aujourd'hui.
Un rapport quotidien type contient de 15 à 35 points de données extractibles répartis en six catégories : composition de l'équipe et heures, équipement déployé et temps de fonctionnement, matériaux reçus et consommés, travaux achevés par corps de métier, conditions météorologiques et incidents de sécurité.
Concrètement, voici la taxonomie des champs qui apparaît sur la plupart des formulaires de rapport quotidien :
Catégories standard des champs d'un rapport quotidien de chantier :
En-tête / Identité
Date du rapport | Nom et numéro du projet | Emplacement/Zone du site | Numéro du rapport

Météo
Conditions du matin | Conditions de l'après-midi | Température (maximale/minimale)

Équipe et main-d'œuvre
Nom du membre de l'équipe | Métier/Rôle | Heures normales | Heures supplémentaires
Entreprise sous-traitante | Effectif du sous-traitant | Travaux réalisés par le sous-traitant

Équipement
Description de l'équipement | Numéro d'identification de l'équipement | Heures de fonctionnement
Notes sur l'équipement (inactif, maintenance, arrêt)

Matériaux
Description du matériau | Quantité livrée | Unité de mesure
Quantité consommée/installée | Nom du fournisseur

Travaux achevés
Zone/Emplacement | Métier/Portée | Description des travaux
Pourcentage d'avancement (si applicable)

Sécurité et incidents
Incident de sécurité (O/N) | Description de l'incident
Quasi-accident signalé | Inspection de sécurité effectuée

Retards et problèmes
Type de retard (météo/équipement/matériau/main-d'œuvre) | Durée (heures)
Description du retard | Impact sur le calendrier

Visiteurs et signatures
Nom du visiteur | Entreprise du visiteur | Heure d'arrivée / Heure de départ
Signature du surintendant | Signature du réviseur
Tous les formulaires ne comportent pas tous les champs — le journal d'un chef de chantier sur un petit site peut tenir sur une seule page avec une douzaine de lignes, tandis que le rapport d'un surintendant pour un entrepreneur général sur un grand projet peut s'étendre sur trois ou quatre pages avec des feuilles de continuation. Ce qui importe pour l'extraction, c'est que les catégories de champs restent cohérentes même lorsque la mise en page ne l'est pas. Un champ d'effectif peut être libellé « Main-d'œuvre », « Personnel sur site » ou « Membres de l'équipe » selon le formulaire, mais sa signification est la même dans toutes les versions.
Pourquoi extraire les données des rapports quotidiens ?
Si les rapports quotidiens sont déjà remplis par les chefs de chantier et stockés dans les dossiers de projet, pourquoi ajouter une étape d'extraction ? La réponse est qu'une pile de rapports papier est une information qui existe mais qui n'est pas exploitable — elle ne peut être triée, additionnée, analysée en tendance, ni intégrée dans les systèmes de gestion de projet. L'extraction transforme un enregistrement en donnée.
Contrôle de projet et suivi des coûts. Les heures de main-d'œuvre des rapports quotidiens alimentent le suivi des coûts de main-d'œuvre. Les heures d'équipement déclenchent les calendriers de maintenance et soutiennent l'allocation des coûts de location. Les quantités de matériaux consommées sont comparées aux quantités budgétées pour l'analyse des écarts. Sans extraction, chacun de ces transferts de données nécessite qu'une personne au bureau retape manuellement les chiffres du papier dans un tableur ou un ERP. Un projet avec trois sites actifs et cinq équipes chacun génère environ 60 à 80 rapports par mois — représentant entre 1 800 et 3 200 points de données saisis individuellement, selon la complexité du rapport.
Facturation et documentation des litiges. Sur les contrats en régie, les rapports quotidiens sont les principaux justificatifs des factures. En cas de litige, le rapport quotidien est ce qu'un entrepreneur présente comme preuve des travaux effectués. Une discussion Reddit sur les méthodes de suivi des journaux quotidiens a capturé la réalité : « Des formulaires papier et c'est le chaos. Des documents se perdent, l'écriture est illisible, et mon chef de bureau passe des heures chaque jour à essayer de reconstituer ce qui s'est passé. » Lorsque ce chef de bureau essaie également de produire une facture en régie, le risque d'heures facturables manquées est réel.
Conformité et dossiers réglementaires. Sur les projets financés par le gouvernement fédéral aux États-Unis, la loi Davis-Bacon exige des registres de paie certifiés qui suivent les heures travaillées par classification pour chaque ouvrier sur le site. Les données d'équipe des rapports quotidiens sont la source fondamentale de ces rapports certifiés. Les exigences de tenue de registres de l'OSHA en vertu du 29 CFR Partie 1926 imposent également la tenue de registres des blessures et maladies — les données d'incidents de sécurité des rapports quotidiens alimentent directement les registres OSHA 300. Lorsque les données sont extraites et structurées, la production de ces rapports prend des minutes au lieu d'un exercice de rapprochement d'une journée entière.
Le fil conducteur des trois cas d'usage : l'extraction ne remplace pas le rapport quotidien. Elle remplace le pont de données manuel entre le rapport et chaque système aval qui a besoin de l'information. Le formulaire papier reste utilisé. Le travail supplémentaire disparaît.
Les défis uniques de l'extraction des rapports journaliers
Les rapports journaliers de chantier présentent un profil de difficulté d'extraction qui diffère sensiblement de celui des factures, reçus et autres documents professionnels. Comprendre ces défis est essentiel pour définir des attentes réalistes et choisir la bonne approche.
Taux d'écriture manuscrite proche de 100 %. La plupart des factures et reçus sont imprimés ou tapés. Un rapport journalier est rempli à la main — souvent dans les 20 dernières minutes d'un quart de travail de 10 heures par un chef de chantier dont la compétence principale est de gérer les équipes, pas la calligraphie. La ROC traditionnelle, qui compare les formes des caractères à des modèles de polices, ne fonctionne tout simplement pas avec une précision viable sur l'écriture manuscrite car celle-ci présente une variation infinie de l'épaisseur du trait, de l'inclinaison et de la formation des lettres. Les modèles d'IA basés sur la vision traitent le texte manuscrit nettement mieux, mais le seul facteur de l'écriture manuscrite rend les rapports journaliers plus difficiles à extraire que les documents professionnels typiques.
Structures de tableaux intégrées avec des mises en page variables. Une seule page de rapport journalier peut contenir un tableau d'équipe, un tableau d'équipement, un journal des matériaux et une section de signature des visiteurs — chacun avec sa propre structure de colonnes. L'IA doit identifier où chaque tableau commence et se termine, et associer correctement les valeurs manuscrites à leurs en-têtes de colonnes. C'est fondamentalement plus complexe que d'extraire des champs plats comme une date ou un total de facture. L'évaluation détaillée des capacités d'extraction IA des rapports journaliers décompose la précision par type de champ et montre quelles configurations de tableau sont traitées de manière fiable.
Types de champs mixtes multidimensionnels. Températures, noms d'équipe, heures d'équipement, quantités de matériaux, descriptions narratives du travail, indicateurs de sécurité par cases à cocher — un rapport journalier mélange des champs numériques, du texte court, des paragraphes complets et des indicateurs binaires sur la même page. Une bonne configuration d'extraction traite chaque type de champ différemment : les nombres doivent rester numériques (pour la somme), les cases à cocher doivent devenir des indicateurs O/N, et le texte narratif doit préserver la phrase complète sans être compressé dans une cellule courte.
Mises en page de formulaires variables selon les projets et les entrepreneurs. Chaque entrepreneur général utilise un modèle de rapport journalier légèrement différent. Certains utilisent des formulaires imprimés avec des cases étiquetées. D'autres utilisent des carnets autocopiants avec des lignes vierges. Certains chefs de chantier dessinent leur propre tableau sur une page blanche. Un outil d'extraction basé sur des modèles nécessiterait une configuration par formulaire pour chaque variante — ce qui n'est pas réalisable sur le plan opérationnel lorsqu'un seul coordinateur de projet peut recevoir des rapports de dix chefs différents en une semaine. La méthode d'extraction doit être indépendante du format : elle lit le contenu par le sens, pas par la position sur la page.
Pièces jointes photo et annotations visuelles. De nombreux rapports journaliers incluent des photographies jointes ou intégrées — photos d'avancement, problèmes de sécurité, livraisons de matériaux. Ces photos contiennent des informations contextuelles mais ne peuvent pas être « extraites » en tant que champs de données structurées. La relation entre une entrée textuelle (« Section de trottoir fissurée ») et une photo jointe de la fissure est significative pour un réviseur humain mais actuellement hors du champ de l'extraction automatisée. L'approche pratique : traiter les photos comme des pièces jointes qui accompagnent les données structurées extraites.
La combinaison de ces défis — taux d'écriture manuscrite élevé, tableaux intégrés, types de champs mixtes et mises en page de formulaires variables — explique pourquoi les rapports journaliers ont résisté à la numérisation pendant 15 ans alors que le traitement des factures est devenu courant.
Méthodes traditionnelles vs extraction par IA : ce qui change
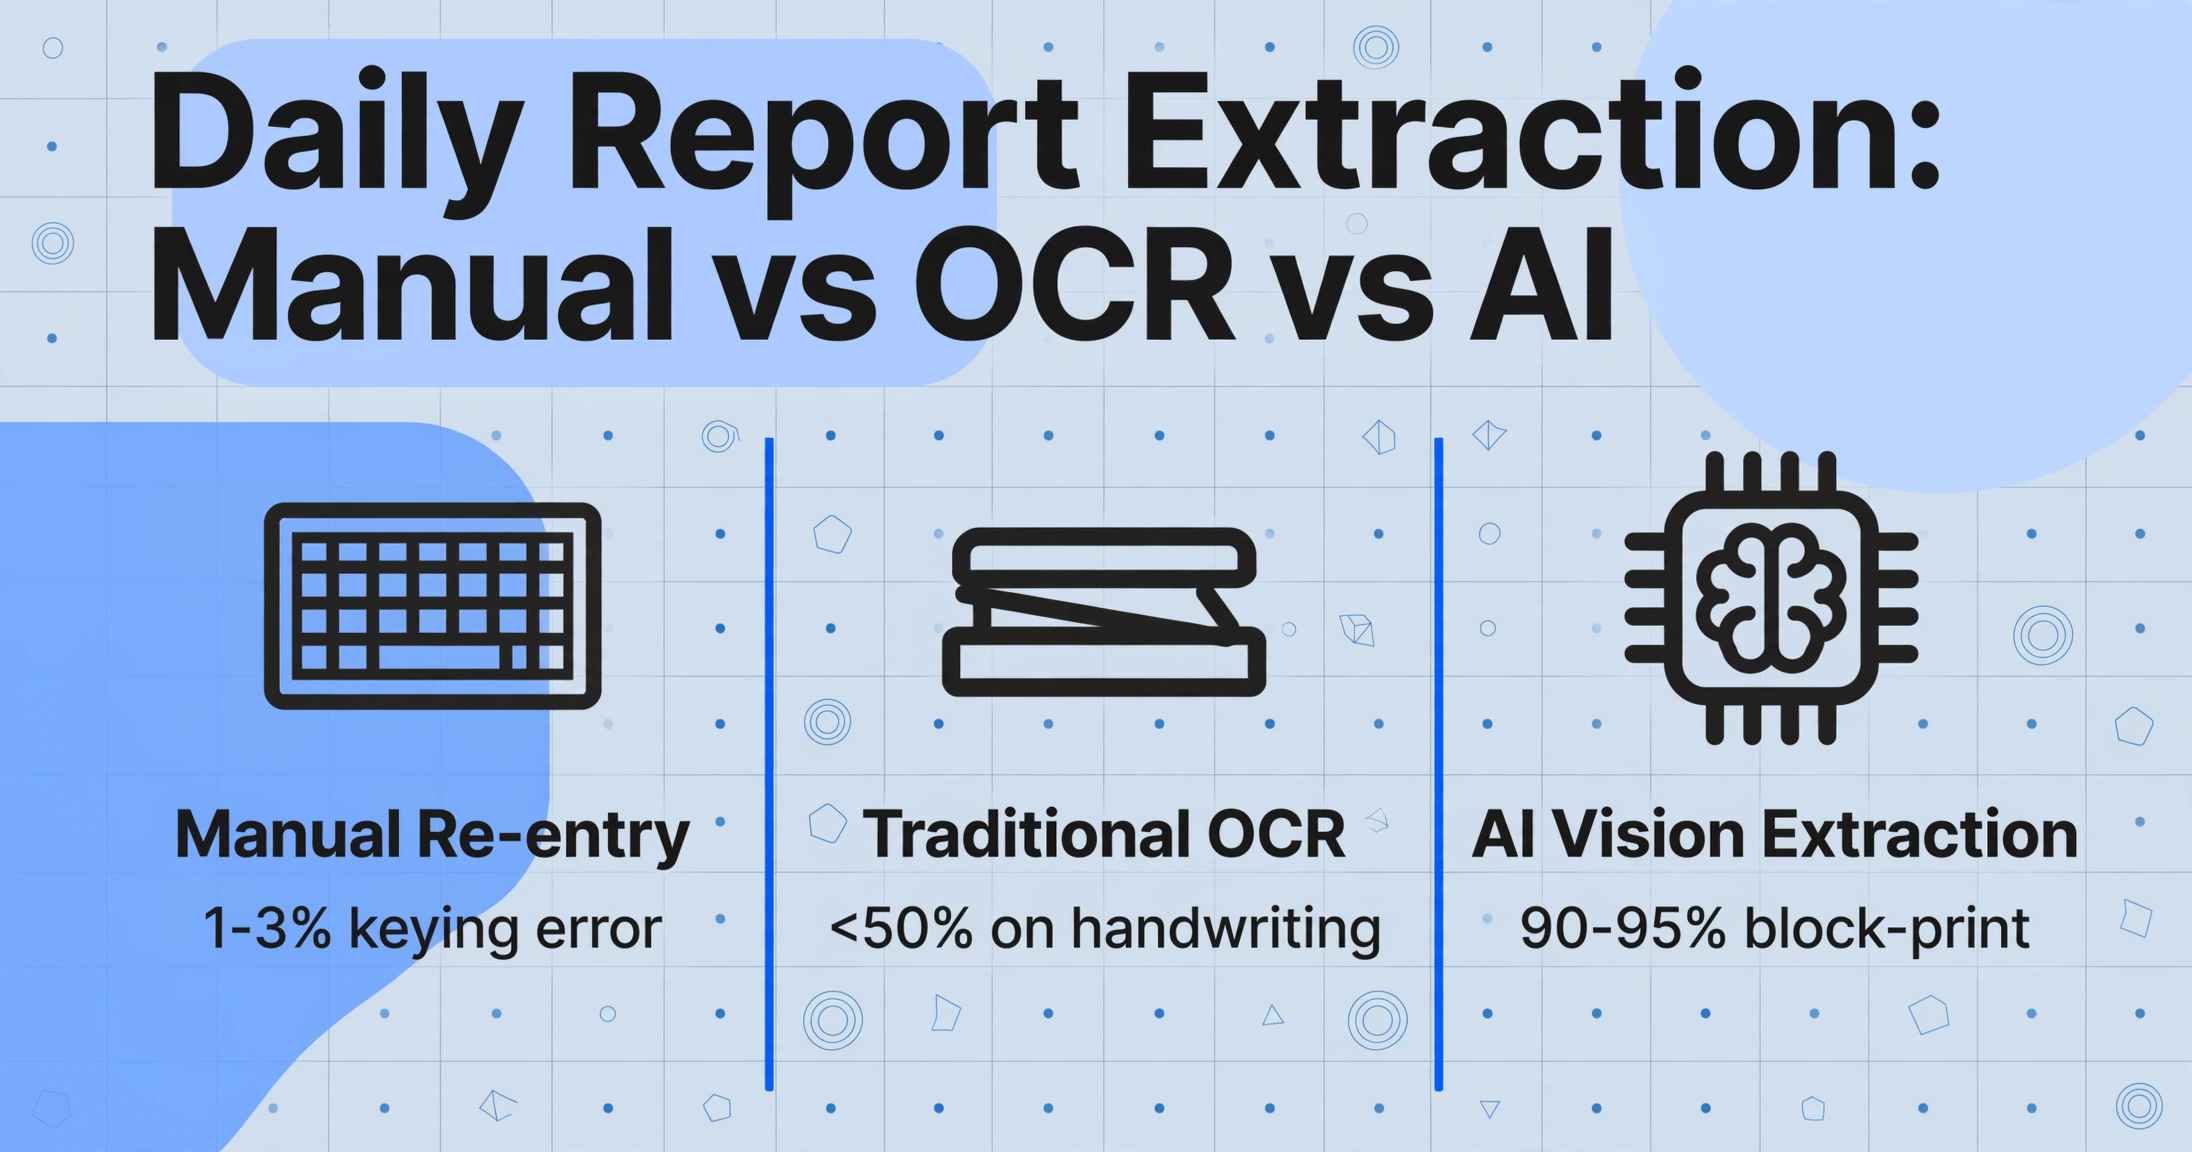
Il existe trois approches pour transférer les données des rapports quotidiens papier vers un format numérique. Chacune présente une structure de coûts, un profil de précision et un impact opérationnel différents pour les équipes de terrain et le personnel de bureau.
| Méthode | Fonctionnement | Précision | Temps par rapport | Impact sur l'équipe de terrain |
|---|---|---|---|---|
| Saisie manuelle | Le personnel de bureau lit le rapport manuscrit et saisit les données dans un tableur ou un ERP | Dépend de la personne qui saisit — taux d'erreur de frappe estimé à 1-3% sur les rapports lisibles | 5-12 minutes par rapport (30-60 champs) | Aucun — le papier reste tel quel |
| OCR traditionnel + correction manuelle | Les rapports numérisés passent dans un moteur OCR ; les étiquettes imprimées sont bien extraites, les champs manuscrits ressortent illisibles et doivent être corrigés manuellement | <50% sur l'écriture manuscrite — nécessite une ressaisie humaine complète de la plupart des champs | 8-15 minutes par rapport (numérisation + correction de la sortie OCR défectueuse) | Aucun — le papier reste tel quel |
| Extraction par vision IA + vérification ponctuelle | La photo du rapport est traitée par vision IA ; les données structurées sont exportées vers Excel ou CSV ; un humain vérifie 2 à 5 champs par rapport | 90-95% sur l'écriture en caractères d'imprimerie dans des cases étiquetées ; 75-85% sur l'écriture cursive (par champ, photo nette) | 3-5 minutes pour 5 rapports (par lots), vérification comprise | Aucun — le papier reste tel quel ; les surintendants photographient et envoient |
La différence essentielle ne réside pas seulement dans la vitesse — c'est la nature de l'effort humain requis. La saisie manuelle exige de la transcription : convertir une valeur manuscrite en valeur tapée, une tâche qui ne demande aucun jugement et qui est purement mécanique. L'extraction par IA avec vérification ponctuelle exige de la vérification : confirmer que la valeur extraite correspond à l'original, une tâche qu'un chef de projet peut accomplir en quelques secondes par champ. Le passage de la transcription à la vérification réduit simultanément la fatigue cognitive et les taux d'erreur, car la vérification repose sur la reconnaissance de formes (ce chiffre semble-t-il correct ?) tandis que la transcription repose sur la reproduction caractère par caractère.
L'OCR traditionnel se situe dans une zone grise inconfortable. Il extrait correctement les étiquettes et les en-têtes imprimés — généralement avec une précision de 95-99% pour le texte tapé — mais il tombe sous les 50% sur l'écriture manuscrite. Le résultat est une sortie mixte où certains champs sont corrects, d'autres erronés, et le relecteur humain ne peut se fier à aucun d'entre eux sans vérifier chaque champ. C'est en réalité pire que pas d'IA du tout, car le relecteur doit vérifier chaque champ mais ne peut pas simplement retaper depuis zéro — il doit lire chaque résultat OCR, le comparer à l'original et le corriger. Les gains de temps disparaissent. Pour les rapports quotidiens où l'écriture manuscrite domine, l'OCR traditionnel est le mauvais outil.
Le guide du chef de projet en construction pour l'extraction de données documentaires explique comment cette comparaison s'étend à d'autres types de documents de construction — factures, ordres de changement, demandes de paiement AIA — offrant un cadre unifié pour réfléchir à l'extraction sur l'ensemble des documents d'un entrepreneur.
Champs clés à extraire des rapports quotidiens
Tous les champs d'un rapport quotidien ne nécessitent pas une extraction. Certains champs sont des métadonnées pour le classement (numéro de rapport, nom du projet). D'autres sont des contenus narratifs qu'il est préférable de conserver tels quels (paragraphes descriptifs du travail). La cible d'extraction doit être les champs qui alimentent les processus en aval : les heures pour la paie, l'utilisation de l'équipement pour la facturation, les quantités de matériaux pour le suivi des coûts, et les incidents de sécurité pour les rapports de conformité.
Lors de la mise en place d'un flux d'extraction, les noms de colonnes que vous définissez deviennent à la fois les instructions d'extraction et les en-têtes de sortie. L'IA utilise la compréhension sémantique pour localiser les valeurs en faisant correspondre les noms de colonnes au contenu du document — la formulation de chaque colonne est donc importante. Une colonne nommée « Effectif » indique à l'IA de rechercher une valeur numérique près des étiquettes d'équipe ou de main-d'œuvre. Une colonne nommée « Nom du travailleur » lui indique de rechercher des noms individuels dans un tableau du personnel.
Voici un ensemble de départ recommandé de colonnes d'extraction pour un rapport quotidien standard, organisé par processus en aval qu'elles alimentent :
Colonnes d'extraction recommandées pour les rapports quotidiens de construction :
Identité (pour le classement et la référence croisée) :
Date du rapport | Nom du projet | Site / Emplacement

Main-d'œuvre (alimente la paie et les codes de coûts) :
Nom du travailleur | Métier | Heures régulières | Heures supplémentaires
Entreprise sous-traitante | Effectif du sous-traitant

Équipement (soutient la facturation et la maintenance) :
ID de l'équipement | Heures de fonctionnement de l'équipement

Matériaux (alimente le suivi des coûts) :
Nom du matériau | Quantité livrée | Quantité consommée | Unité

Sécurité (tenue des registres OSHA) :
Incident de sécurité (O/N) | Description de l'incident

Retard / Problème (impact sur le calendrier) :
Type de retard | Heures de retard | Description du retard

Météo (données contextuelles) :
Conditions météo (AM) | Conditions météo (PM) | Température
Le principe : concevez vos colonnes d'extraction autour des feuilles de calcul et des systèmes que les données alimentent, et non autour des champs du formulaire. Si votre système de suivi des coûts utilise « Classification des métiers » au lieu de « Corps de métier », nommez votre colonne « Classification des métiers » — l'étiquette qui correspond au système de destination évite une étape de correspondance ultérieure.
Pour des conseils sur la précision que vous pouvez attendre de chaque type de champ sur un rapport manuscrit, consultez la répartition de la précision d'extraction par type de champ. Les schémas sont cohérents : les nombres dans des cases étiquetées s'extraient de manière plus fiable, le texte narratif en cursive présente la plus grande variance de précision, et les indicateurs à cocher approchent 100 % quelle que soit la qualité de l'écriture.
Traitement par lots : plusieurs chantiers, plusieurs rapports, une seule feuille de calcul
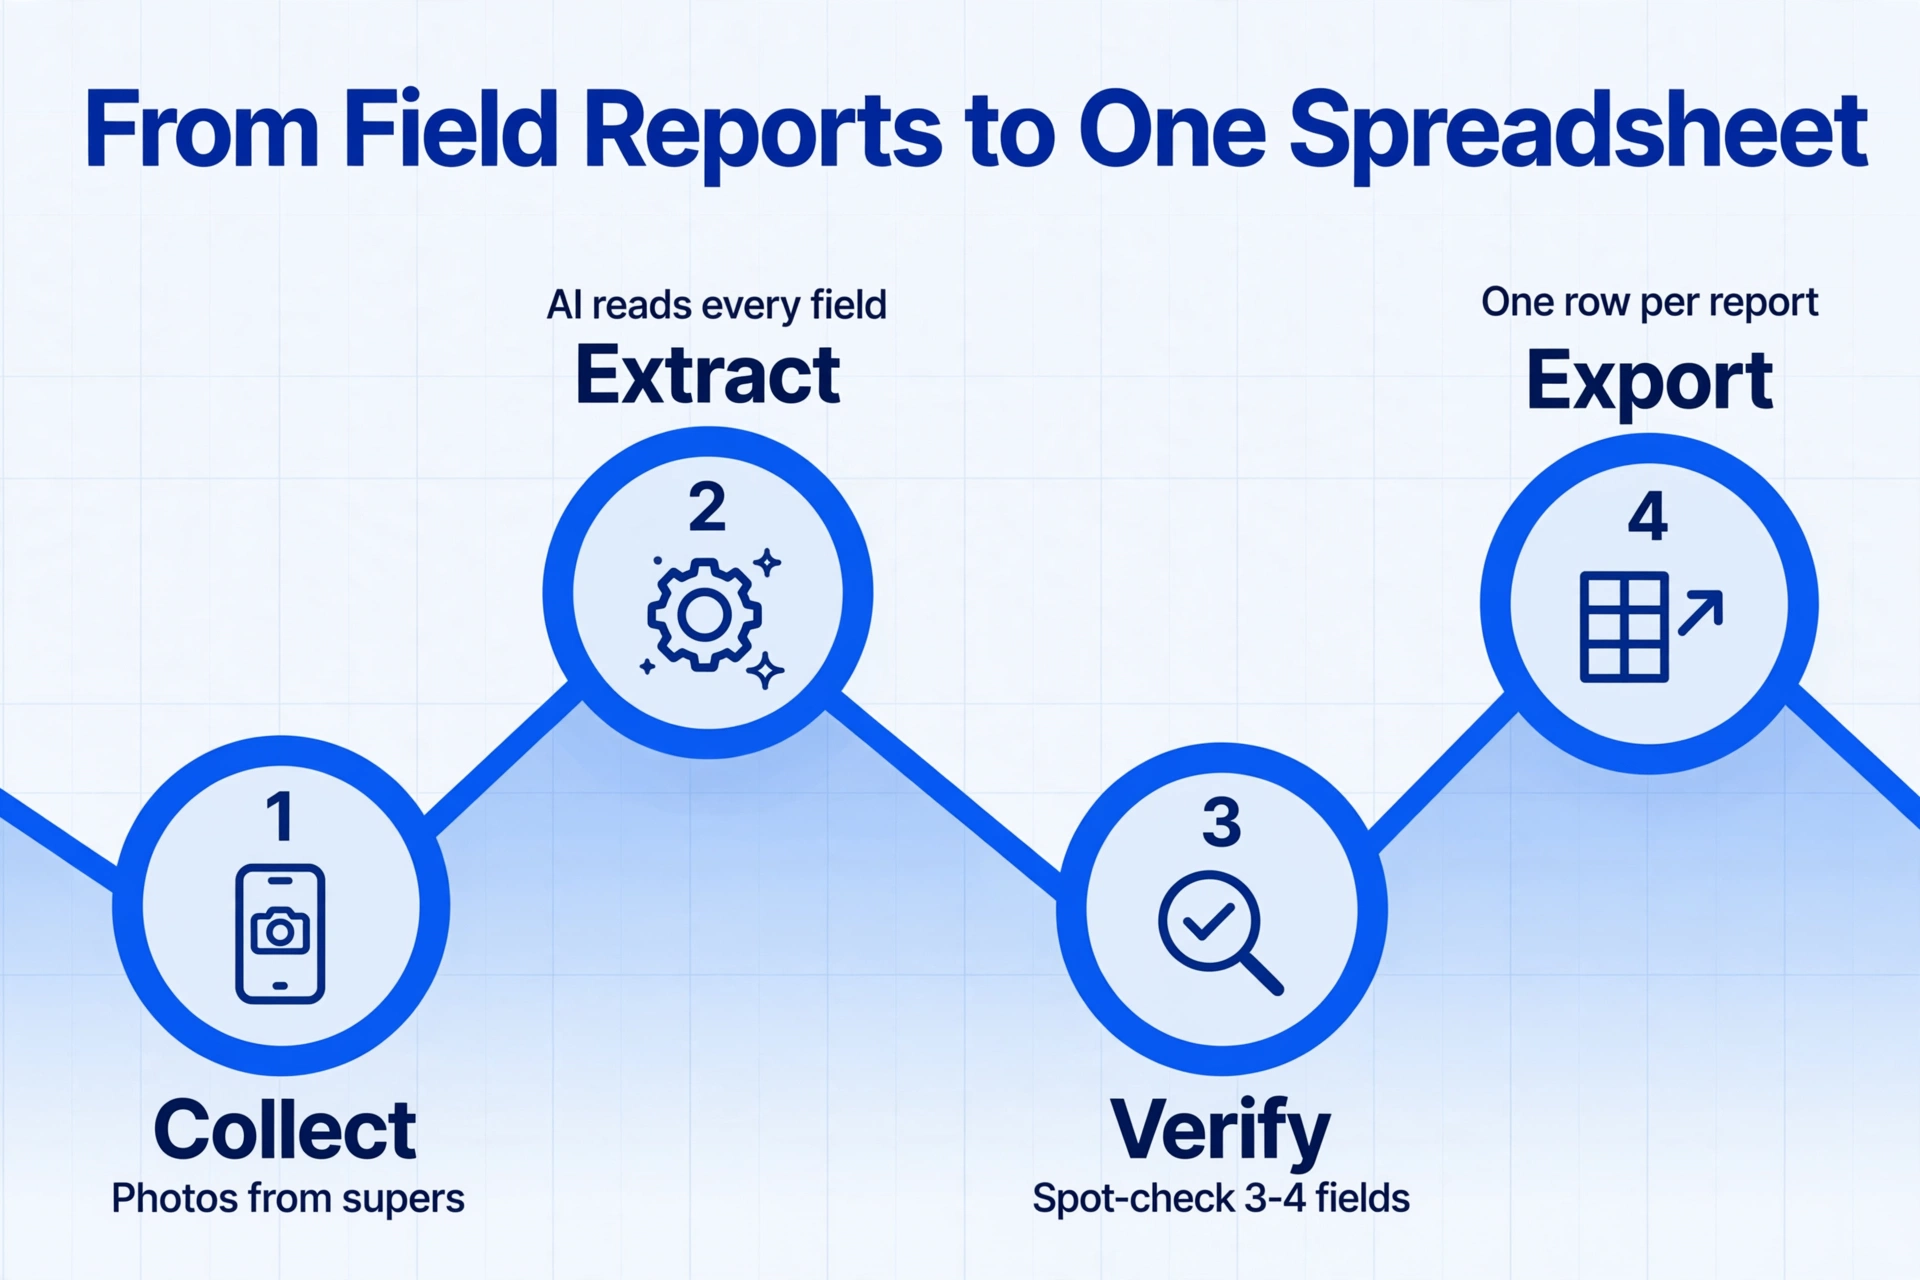
Le rythme réel de la rédaction de rapports dans le secteur de la construction est par nature basé sur des lots. Un coordinateur de projet ne traite pas un rapport puis s'arrête — il collecte les rapports de trois chefs de chantier sur deux sites pendant une semaine, puis doit tout consolider en un seul ensemble de chiffres. Le traitement par lots est ce qui rend l'extraction pratique à l'échelle d'un projet.
Dans un flux de travail par lots, tous les rapports téléchargés ensemble partagent les mêmes définitions de colonnes et produisent un tableau de sortie unique. L'IA traite chaque document indépendamment mais les sort en lignes fusionnées — le résultat est donc une seule feuille de calcul avec une ligne par rapport, quel que soit le nombre de formulaires ou de styles d'écriture différents dans le lot.
La décision opérationnelle clé dans le traitement par lots est de savoir comment identifier chaque rapport dans la sortie consolidée. Étant donné que l'IA lit « Nom du projet » et « Date du rapport » comme des champs extractibles, ceux-ci deviennent des colonnes de regroupement naturelles dans le tableau de sortie — permettant au coordinateur de trier, filtrer et additionner sur plusieurs sites sans ajouter manuellement des identifiants. Un chef de chantier qui envoie plusieurs rapports pour le même projet à des dates différentes verra chaque date comme une ligne distincte, automatiquement regroupée par nom de projet.
Le guide détaillé pour convertir par lots des rapports manuscrits de chantier en résumés hebdomadaires présente la configuration, les conventions de nommage et le flux de vérification pour traiter 20 à 30 rapports à la fois. La comparaison pratique du temps : traiter 20 rapports de quatre sites manuellement prend environ 2 à 3 heures de saisie. L'extraction par lots avec IA et vérification prend 15 à 25 minutes — et la sortie est déjà dans une seule feuille de calcul, pas une pile de fichiers séparés attendant d'être fusionnés.
Le traitement par lots résout également un problème subtil mais important : l'incohérence de format entre les rapports. Un coordinateur de projet recevant des rapports de plusieurs chefs de chantier sait que chacun utilise une mise en page légèrement différente. L'un utilise un formulaire PDF imprimé avec des cases étiquetées. Un autre utilise un carnet à copie carbone. Un troisième esquisse un tableau sur du papier blanc. Les outils basés sur des modèles nécessiteraient des configurations séparées pour chaque format. L'extraction sémantique — où l'IA lit par signification de champ, pas par position sur la page — traite les trois variantes de format à travers les mêmes définitions de colonnes. Le tableau de sortie a les mêmes colonnes, que le document source soit un formulaire imprimé professionnel ou un tableau dessiné à la main sur du papier millimétré.
Pour les équipes gérant cinq sites actifs ou plus avec plusieurs chefs de chantier soumettant des rapports quotidiennement, un flux de travail avec Lien de collecte amplifie encore le traitement par lots : générez un lien partageable que chaque chef de chantier ouvre depuis son téléphone, photographie son rapport et le soumet directement. Le lien ne nécessite aucune installation d'application, aucune connexion et aucune formation — et les fichiers arrivent automatiquement catégorisés dans la file de traitement du coordinateur de projet, prêts pour une seule extraction par lots à la fin de la semaine.
Exportation et utilisation des données extraites
L'extraction est une étape intermédiaire, pas finale. La valeur des données structurées dépend de leur destination et de leur utilisation. Les formats de sortie disponibles pour les données extraites des rapports quotidiens sont :
| Format | Idéal pour | Utilisation en aval |
|---|---|---|
| Excel (XLSX) | Résumés hebdomadaires de main-d'œuvre, rapports de coûts d'équipement, suivi de consommation de matériaux | S'ouvre directement dans Excel pour filtrage, tableaux croisés dynamiques, graphiques ; peut être importé dans Procore, Sage, Viewpoint |
| CSV | Importations dans les systèmes ERP et comptables | Format universel pour l'import de données ; compatible avec pratiquement toutes les plateformes comptables de construction |
| JSON | Intégrations personnalisées, workflows basés sur des API | Consommation programmatique ; adapté aux équipes disposant de pipelines de données internes ou d'outils de gestion de projet sur mesure |
Un workflow hebdomadaire pratique utilisant les données extraites ressemble à ceci :
Lundi matin : Le coordinateur de projet ouvre l'outil d'extraction, voit 15 rapports soumis via des liens de collecte pendant le week-end. Chaque rapport a été photographié par le superviseur à la fin de son quart de travail vendredi et téléchargé directement.
Extraction (15 minutes) : Le coordinateur sélectionne les 15 rapports, confirme les définitions de colonnes (inchangées depuis la semaine dernière) et lance l'extraction par lots. Le système traite chaque rapport, le coordinateur vérifie 3 à 4 champs par rapport — environ 10 minutes de vérification.
Export et distribution (5 minutes) : Le coordinateur exporte vers Excel, crée un tableau croisé pour les heures hebdomadaires par corps de métier, un autre pour l'utilisation de l'équipement, et un troisième pour la consommation de matériaux. Un résumé d'une page est distribué à l'équipe du projet avant le déjeuner.
Ce workflow remplace un processus qui prenait auparavant 3 à 4 heures de saisie le lundi matin — et les données n'étaient jamais assez structurées pour des tableaux croisés sans travail manuel supplémentaire.
Comment choisir un outil d'extraction pour les rapports quotidiens
Lors de l'évaluation d'outils d'extraction spécifiquement pour les rapports quotidiens de chantier, les critères standard d'extraction de documents ne s'appliquent pas directement. Les rapports quotidiens présentent des caractéristiques — écriture manuscrite, tableaux intégrés, mises en page variables — que la plupart des outils conçus pour les factures ne sont pas en mesure de traiter. Voici les critères spécifiques qui comptent pour ce type de document :
1. Capacité à traiter l'écriture manuscrite, pas seulement l'OCR. Les moteurs OCR traditionnels (Tesseract, ABBYY, l'OCR intégré d'Adobe Acrobat) sont conçus pour le texte imprimé. Si la documentation d'un outil mentionne des « zones de modèle » ou des « coordonnées fixes », il n'est pas conçu pour l'écriture manuscrite. Recherchez une Vision AI (modèles multimodaux de grande taille) qui traite la page comme une image et lit le contenu par compréhension visuelle. La différence n'est pas marginale — elle détermine si l'écriture manuscrite est extraite avec une précision de 40 % ou de 90 %.
2. Indépendance du format, pas correspondance de modèle. Les outils qui exigent une configuration de modèle par formulaire (dessiner des cadres autour des champs, entraîner sur des documents d'échantillonnage) ne sont pas viables sur le plan opérationnel pour les rapports quotidiens provenant de plusieurs surintendants avec des formulaires différents. La méthode d'extraction doit être sémantique — lire le contenu des champs par leur signification plutôt que par leur emplacement — afin qu'un changement de mise en page du formulaire ne nécessite pas de reconfiguration. C'est l'exigence opérationnelle la plus importante pour les entrepreneurs multi-sites.
3. Traitement par lots avec sortie fusionnée. L'extraction de documents individuels n'est pas utile à l'échelle d'un projet. L'outil doit prendre en charge le traitement par lots — téléchargement simultané de plusieurs rapports et génération d'un seul tableau consolidé — sans obliger l'utilisateur à extraire chaque rapport un par un et à fusionner manuellement.
4. Export vers Excel et CSV. La gestion de projets de construction repose sur des feuilles de calcul. L'outil doit exporter directement aux formats XLSX et CSV pouvant être ouverts, pivotés et importés dans Procore, Sage ou Viewpoint. Les formats d'export propriétaires qui ne peuvent pas être lus par les logiciels de bureau standard ajoutent une étape de conversion qui contredit l'objectif de l'automatisation.
5. Aucun cycle de formation ou de configuration. Les outils qui exigent le téléchargement de 10 à 20 documents d'échantillonnage pour la formation, ou qui nécessitent une « période d'apprentissage » avant de produire des résultats utilisables, ne correspondent pas à la réalité opérationnelle des projets de construction. L'extraction doit fonctionner dès le premier rapport, dès le premier jour — pas après un processus d'intégration de deux semaines.
Ces critères s'alignent sur le paradigme d'extraction sémantique sans modèle que le guide plus large sur l'extraction de documents de construction applique aux six principaux types de documents de construction. Pour les rapports quotidiens en particulier, les critères 1 et 2 sont non négociables — un outil qui ne peut pas traiter l'écriture manuscrite et la variation de format ne produira pas de résultats utilisables, quelles que soient ses autres capacités.
FAQ
Qu'est-ce qu'un rapport quotidien de chantier ?
Un rapport quotidien de chantier est un enregistrement écrit de toutes les activités, ressources et conditions importantes sur un chantier de construction pour une seule journée civile. Il documente la composition de l'équipe, les heures travaillées, l'équipement utilisé, les matériaux reçus, les travaux effectués, les conditions météorologiques, les incidents de sécurité et tout retard ou problème rencontré.
L'IA peut-elle extraire des données de rapports quotidiens manuscrits ?
Oui. La Vision AI moderne extrait les données manuscrites des rapports quotidiens avec une précision de 90-95 % pour l'écriture en lettres moulées dans des cases étiquetées, et de 75-85 % pour l'écriture cursive. La ventilation détaillée de la précision couvre les attentes par champ. La précision dépend principalement de la qualité des photos et de la lisibilité de l'écriture — et non de la disposition spécifique du formulaire.
L'extraction nécessite-t-elle de modifier le formulaire du rapport quotidien ?
Non. L'extraction sémantique lit le contenu par le sens, et non par la disposition du formulaire — les mêmes définitions de colonnes fonctionnent donc sur différents formulaires de différents chefs de chantier. Vous n'avez pas besoin de reconcevoir votre formulaire de rapport quotidien pour que l'extraction fonctionne.
Comment cela se compare-t-il à l'utilisation des rapports quotidiens de Raken, Fieldwire ou Procore ?
Ces outils remplacent le papier au moment de la saisie — le chef d'équipe remplit un rapport dans l'application au lieu de le faire sur papier. L'extraction par IA à partir de photos numérise les rapports papier existants sans exiger que les chefs d'équipe changent leur processus. Les approches sont complémentaires : certaines équipes préfèrent les applications, d'autres le papier, et l'extraction traite tout ce qui arrive.
Les données extraites peuvent-elles être importées dans Sage, Viewpoint ou Procore ?
Oui. Les résultats d'extraction sont disponibles en Excel (XLSX) ou CSV, qui peuvent tous deux être importés dans les systèmes prenant en charge l'importation de données par fichier. Les données sont structurées et vérifiées, l'étape d'importation est donc un téléchargement de fichier plutôt qu'une saisie manuelle. Les intégrations API en direct ne sont pas actuellement disponibles — il s'agit d'un flux de travail par transfert de fichier.
Combien de rapports quotidiens peuvent être traités en un seul lot ?
Le traitement par lots gère confortablement 20 à 50 rapports par session. La contrainte pratique est le temps de vérification — à raison de 15 à 30 secondes par rapport pour un contrôle ponctuel, un lot de 30 rapports nécessite 10 à 15 minutes de revue humaine. Le temps de traitement IA réel est de quelques secondes par rapport, quelle que soit la taille du lot.
Que se passe-t-il si un rapport contient une écriture illisible que l'IA ne peut pas déchiffrer ?
Si l'écriture est réellement illisible (indéchiffrable même pour un autre humain), l'IA produira une extraction à faible confiance ou partielle. L'approche pratique consiste à traiter les champs problématiques comme des exceptions de saisie manuelle. En pratique, 80 à 90 % des rapports quotidiens provenant de chantiers actifs ont une écriture suffisamment claire pour une extraction utile — les 10 à 20 % restants nécessitent une intervention humaine, quelle que soit la méthode utilisée.
Quelle est la chose la plus impactante que je puisse faire pour améliorer les résultats d'extraction ?
Photographiez le rapport à plat, de face, avec un bon éclairage, avant qu'il ne soit plié ou endommagé. L'écart de précision entre une photo correcte et une photo en angle prise en faible lumière est de 15 à 25 points de pourcentage — plus important que toute mise à niveau d'outil. Capturez l'original, pas la copie carbone, et utilisez un stylo à bille à encre foncée pour un contraste maximal.
L'extraction par IA fonctionne-t-elle avec les rapports incluant des photos jointes ?
Les photos intégrées ou jointes à un rapport quotidien contiennent des informations contextuelles qu'un réviseur humain doit voir, mais elles ne peuvent pas être « extraites » de manière significative en tant que champs de données structurés. L'approche recommandée consiste à extraire les champs texte (descriptions, emplacements, horodatages) du rapport et à conserver les photos comme pièces jointes accompagnant la sortie structurée.
Est-ce différent de l'extraction pour les factures de construction ?
Oui. Les factures sont généralement imprimées avec des mises en page cohérentes et un contenu saisi. Les rapports quotidiens sont manuscrits, utilisent des structures de tableaux variables et mélangent texte narratif et champs numériques. Le guide sur l'extraction des factures de construction couvre les détails spécifiques aux factures. La technologie d'extraction est la même — ce qui change, ce sont les définitions de colonnes et les domaines de vérification prioritaires.
Commencez avec un rapport — constatez la différence
Prenez une photo de n'importe quel rapport quotidien de chantier manuscrit et téléversez-la. En moins de 10 secondes, voyez ce qu'un modèle Vision AI extrait — effectifs, heures, identifiants d'équipement, quantités de matériaux. Sans inscription, sans configuration, sans formation.
Téléverser un rapport quotidien →