La guía completa para la extracción de datos del informe diario de obra
Extracción de datos
Un informe diario de obra aporta tres tipos distintos de valor: es un registro contractual, un documento de avance y una fuente de datos para el control del proyecto. La mayoría de los equipos lo tratan como las dos primeras cosas e ignoran la tercera, porque extraer datos estructurados de informes de obra escritos a mano ha requerido históricamente reingreso manual o forzar a los equipos de campo a usar aplicaciones móviles. Esta guía cubre el panorama completo: qué datos contiene un informe diario, por qué es importante extraerlos, los desafíos únicos que hacen que este documento sea más difícil que una factura o un recibo, y cómo la extracción moderna con IA convierte los informes en papel en datos estructurados sin pedirle a ningún miembro del equipo que cambie su forma de trabajar.
Conclusiones clave
- 60-80 informes diarios escritos a mano, 1.800-3.200 puntos de datos al mes: cada dígito debe ser reescrito por un gerente de oficina antes de llegar a nómina, facturación o cumplimiento normativo.
- Durante 15 años, cada intento de digitalización ha pedido lo mismo imposible: que un superintendente que termina un turno de 10 horas en el campo abra una aplicación y escriba en lugar de llenar un formulario en papel que ha usado toda su carrera.
- Vision AI lee recuentos de cuadrillas, horas de equipo y cantidades de materiales de cualquier formulario escrito a mano, de modo que los superintendentes siguen usando papel y la hoja de cálculo estructurada llega sin una sola pulsación de tecla de reescritura manual.
¿Qué es un informe diario de obra? (¿Y qué datos contiene?)
Un informe diario de obra — también llamado registro diario, informe de sitio o informe de campo — es el registro escrito de todo lo que ocurrió en un sitio de trabajo durante un solo día laboral. Su base contractual proviene de AIA A201-2017 §3.3.3.4, que exige que el contratista mantenga registros de inspección, datos de pruebas y otros registros del proyecto en el sitio. Si bien A201 define la obligación de mantener registros, la industria ha convergido en un conjunto estándar de categorías de información que aparecen en prácticamente todos los formularios de informe diario en uso hoy en día.
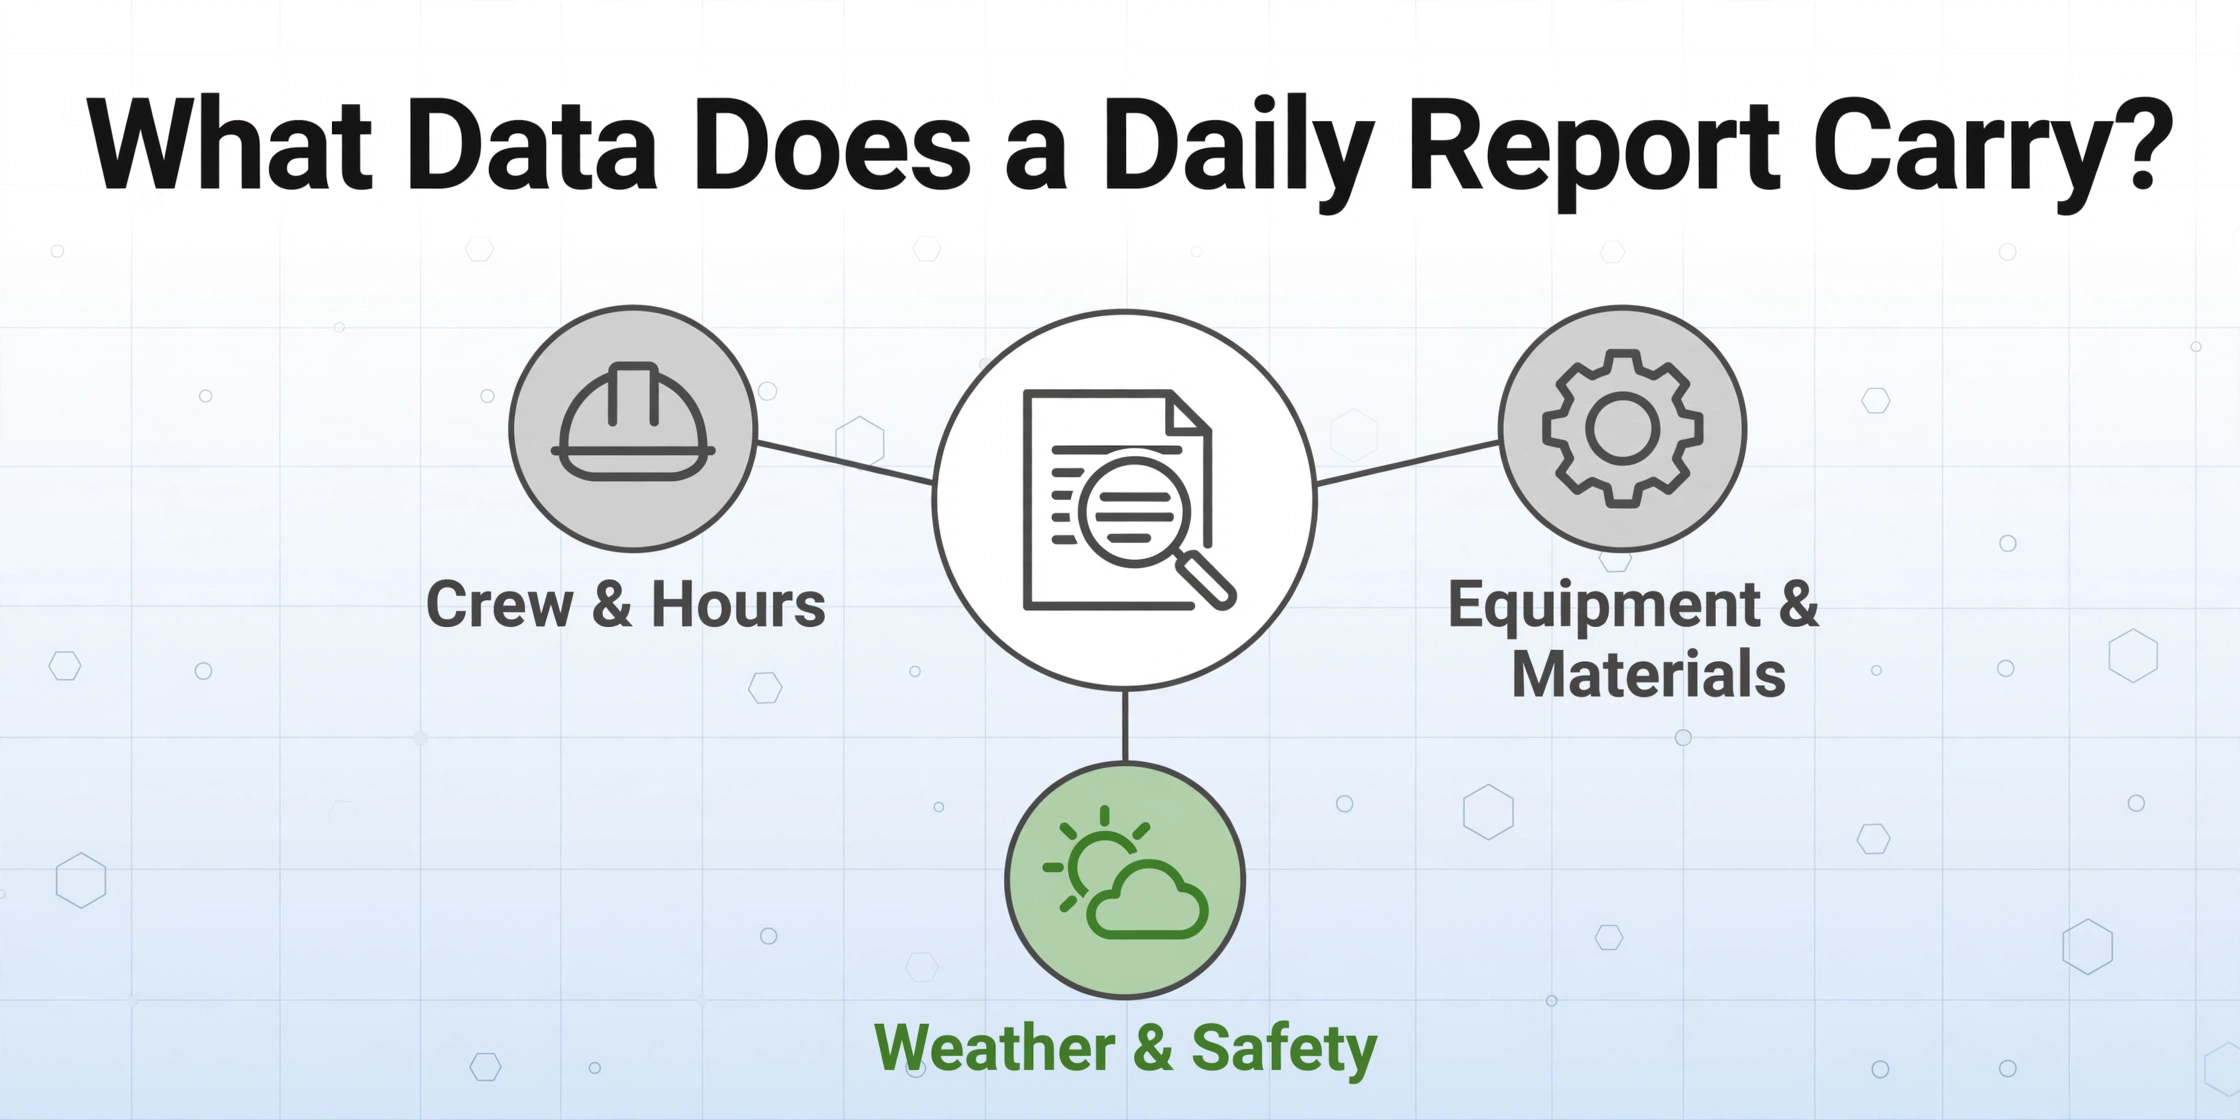
Un informe diario típico contiene de 15 a 35 puntos de datos extraíbles en seis categorías: composición y horas de la cuadrilla, equipo desplegado y tiempo de funcionamiento, materiales recibidos y consumidos, trabajo completado por oficio, condiciones climáticas e incidentes de seguridad.
Concretamente, esta es la taxonomía de campos que aparece en la mayoría de los formularios de informe diario:
Categorías estándar de campos del informe diario de obra:
Encabezado / Identidad
Fecha del informe | Nombre y número del proyecto | Ubicación/Área del sitio | Número de informe

Clima
Condiciones AM | Condiciones PM | Temperatura (máx./mín.)

Cuadrilla y mano de obra
Nombre del miembro de la cuadrilla | Oficio/Rol | Horas regulares | Horas extra
Empresa subcontratista | Número de cuadrilla del sub | Trabajo realizado por el sub

Equipo
Descripción del equipo | Número de identificación del equipo | Horas de funcionamiento
Notas del equipo (inactivo, mantenimiento, tiempo de inactividad)

Materiales
Descripción del material | Cantidad entregada | Unidad de medida
Cantidad consumida/instalada | Nombre del proveedor

Trabajo completado
Área/Ubicación | Oficio/Alcance | Descripción del trabajo
Porcentaje completado (si corresponde)

Seguridad e incidentes
Incidente de seguridad (S/N) | Descripción del incidente
Cuasi accidente reportado | Inspección de seguridad realizada

Retrasos y problemas
Tipo de retraso (clima/equipo/material/mano de obra) | Duración (horas)
Descripción del retraso | Impacto en el cronograma

Visitantes y firmas
Nombre del visitante | Empresa del visitante | Hora de entrada / Hora de salida
Firma del superintendente | Firma del revisor
No todos los formularios tienen todos los campos: el registro de un capataz de un sitio pequeño puede ser una sola página con una docena de líneas, mientras que el informe de un superintendente de un proyecto grande para un contratista general puede abarcar tres o cuatro páginas con hojas de continuación. Lo que importa para la extracción es que las categorías de campos sean consistentes incluso cuando el diseño no lo sea. Un campo de recuento de cuadrilla puede estar etiquetado como "Fuerza laboral", "Personal en el sitio" o "Miembros de la cuadrilla" según el formulario, pero su significado es el mismo en todas las versiones.
¿Por qué extraer datos de los informes diarios?
Si los superintendentes ya completan los informes diarios y se almacenan en las carpetas del proyecto, ¿por qué agregar un paso de extracción? La respuesta es que una pila de informes en papel es información que existe pero no es utilizable: no se puede ordenar, sumar, analizar tendencias ni integrar en sistemas de gestión de proyectos. La extracción es lo que convierte un registro en datos.
Control de proyectos y seguimiento de costos. Las horas de cuadrilla de los informes diarios alimentan el seguimiento de costos laborales. Las horas de equipo activan programas de mantenimiento y respaldan la asignación de costos de alquiler. Las cantidades de materiales consumidos se comparan con las cantidades presupuestadas para el análisis de variaciones. Sin extracción, cada una de estas transferencias de datos requiere que alguien en la oficina vuelva a escribir manualmente los números del papel en una hoja de cálculo o ERP. Un proyecto con tres sitios activos que ejecutan cinco cuadrillas cada uno genera aproximadamente de 60 a 80 informes por mes, lo que representa entre 1.800 y 3.200 puntos de datos escritos individualmente, según la complejidad del informe.
Facturación y documentación de disputas. En contratos de tiempo y materiales, los informes diarios son el principal documento de respaldo para las facturas. Si surge una disputa, el informe diario es lo que un contratista señala como evidencia del trabajo realizado. Un debate en Reddit sobre métodos de seguimiento de registros diarios capturó la realidad: "Formularios en papel y es un caos. Se pierden cosas, la letra es ilegible y mi gerente de oficina pasa horas todos los días solo tratando de reconstruir lo que sucedió". Cuando ese gerente de oficina también intenta producir una factura de T&M, el riesgo de horas facturables perdidas es real.
Registros de cumplimiento y regulatorios. En proyectos financiados con fondos federales en los Estados Unidos, la Ley Davis-Bacon exige registros de nómina certificados que rastreen las horas trabajadas por clasificación para cada trabajador en el sitio. Los datos de la cuadrilla del informe diario son la fuente fundamental para estos informes certificados. Los requisitos de mantenimiento de registros de OSHA bajo 29 CFR Parte 1926 también exigen el mantenimiento de registros de lesiones y enfermedades: los datos de incidentes de seguridad de los informes diarios alimentan directamente los registros OSHA 300. Cuando los datos se extraen y estructuran, producir estos informes toma minutos en lugar de un ejercicio de conciliación de un día completo.
El hilo común en los tres casos de uso: la extracción no reemplaza el informe diario. Reemplaza el puente de datos manual entre el informe y cada sistema posterior que necesita la información. El formulario en papel sigue en uso. El trabajo extra desaparece.
Los desafíos únicos de la extracción de informes diarios
Los informes diarios de construcción presentan un perfil de dificultad de extracción que difiere significativamente de facturas, recibos y la mayoría de otros documentos comerciales. Comprender estos desafíos es esencial para establecer expectativas realistas y elegir el enfoque adecuado.
Tasa de escritura a mano cercana al 100%. La mayoría de las facturas y recibos están impresos o escritos a máquina. Un informe diario se llena a mano, a menudo en los últimos 20 minutos de un turno de 10 horas por parte de un superintendente cuya habilidad principal es gestionar cuadrillas, no la caligrafía. El OCR tradicional, que compara formas de caracteres con modelos de fuente, simplemente no funciona con una precisión viable en escritura a mano porque esta tiene una variación infinita en grosor de trazo, inclinación y formación de letras. Los modelos de IA basados en visión manejan texto manuscrito significativamente mejor, pero el factor de escritura a mano por sí solo hace que los informes diarios sean más difíciles de extraer que el documento comercial típico.
Estructuras de tablas incrustadas con diseños variables. Una sola página de informe diario puede contener una tabla de cuadrilla, una tabla de equipos, un registro de materiales y una sección de registro de visitantes, cada una con su propia estructura de columnas. La IA debe identificar dónde comienza y termina cada tabla, y asociar correctamente los valores escritos a mano con sus encabezados de columna. Esto es fundamentalmente más complejo que extraer campos planos como una fecha o un total de factura. La evaluación detallada de capacidades para la extracción por IA de informes diarios desglosa la precisión por tipo de campo y muestra qué configuraciones de tabla se manejan de manera confiable.
Tipos de campo mixtos multidimensionales. Temperaturas, nombres de cuadrilla, horas de equipo, cantidades de materiales, descripciones narrativas del trabajo, indicadores de seguridad de casillas de verificación: un informe diario mezcla campos numéricos, texto corto, párrafos completos e indicadores binarios en la misma página. Una buena configuración de extracción maneja cada tipo de campo de manera diferente: los números deben permanecer numéricos (para sumar), las casillas de verificación deben convertirse en banderas S/N, y el texto narrativo debe preservar la oración completa sin ser comprimido en una celda corta.
Diseños de formularios variables entre proyectos y contratistas. Cada contratista general utiliza una plantilla de informe diario ligeramente diferente. Algunos usan formularios impresos con casillas etiquetadas. Otros usan cuadernos de copia carbón con líneas en blanco. Algunos superintendentes dibujan su propia tabla en una página en blanco. Una herramienta de extracción basada en plantillas requeriría configuración por formulario para cada variante, lo cual no es factible operativamente cuando un solo coordinador de proyecto puede recibir informes de diez superintendentes diferentes en una semana. El método de extracción debe ser independiente del formato: lee el contenido por significado, no por posición en la página.
Fotos adjuntas y anotaciones visuales. Muchos informes diarios incluyen fotografías adjuntas o incrustadas: fotos de progreso, problemas de seguridad, entregas de materiales. Estas fotos contienen información contextual pero no pueden "extraerse" como campos de datos estructurados. La relación entre una entrada de texto ("Sección de acera agrietada") y una foto adjunta de la grieta es significativa para un revisor humano, pero actualmente está fuera del alcance de la extracción automatizada. El enfoque práctico: tratar las fotos como archivos adjuntos que acompañan a los datos estructurados extraídos.
La combinación de estos desafíos — alta tasa de escritura a mano, tablas incrustadas, tipos de campo mixtos y diseños de formularios variables — explica por qué los informes diarios han resistido la digitalización durante 15 años mientras que el procesamiento de facturas se ha vuelto rutinario.
Métodos tradicionales vs. extracción con IA: qué cambia
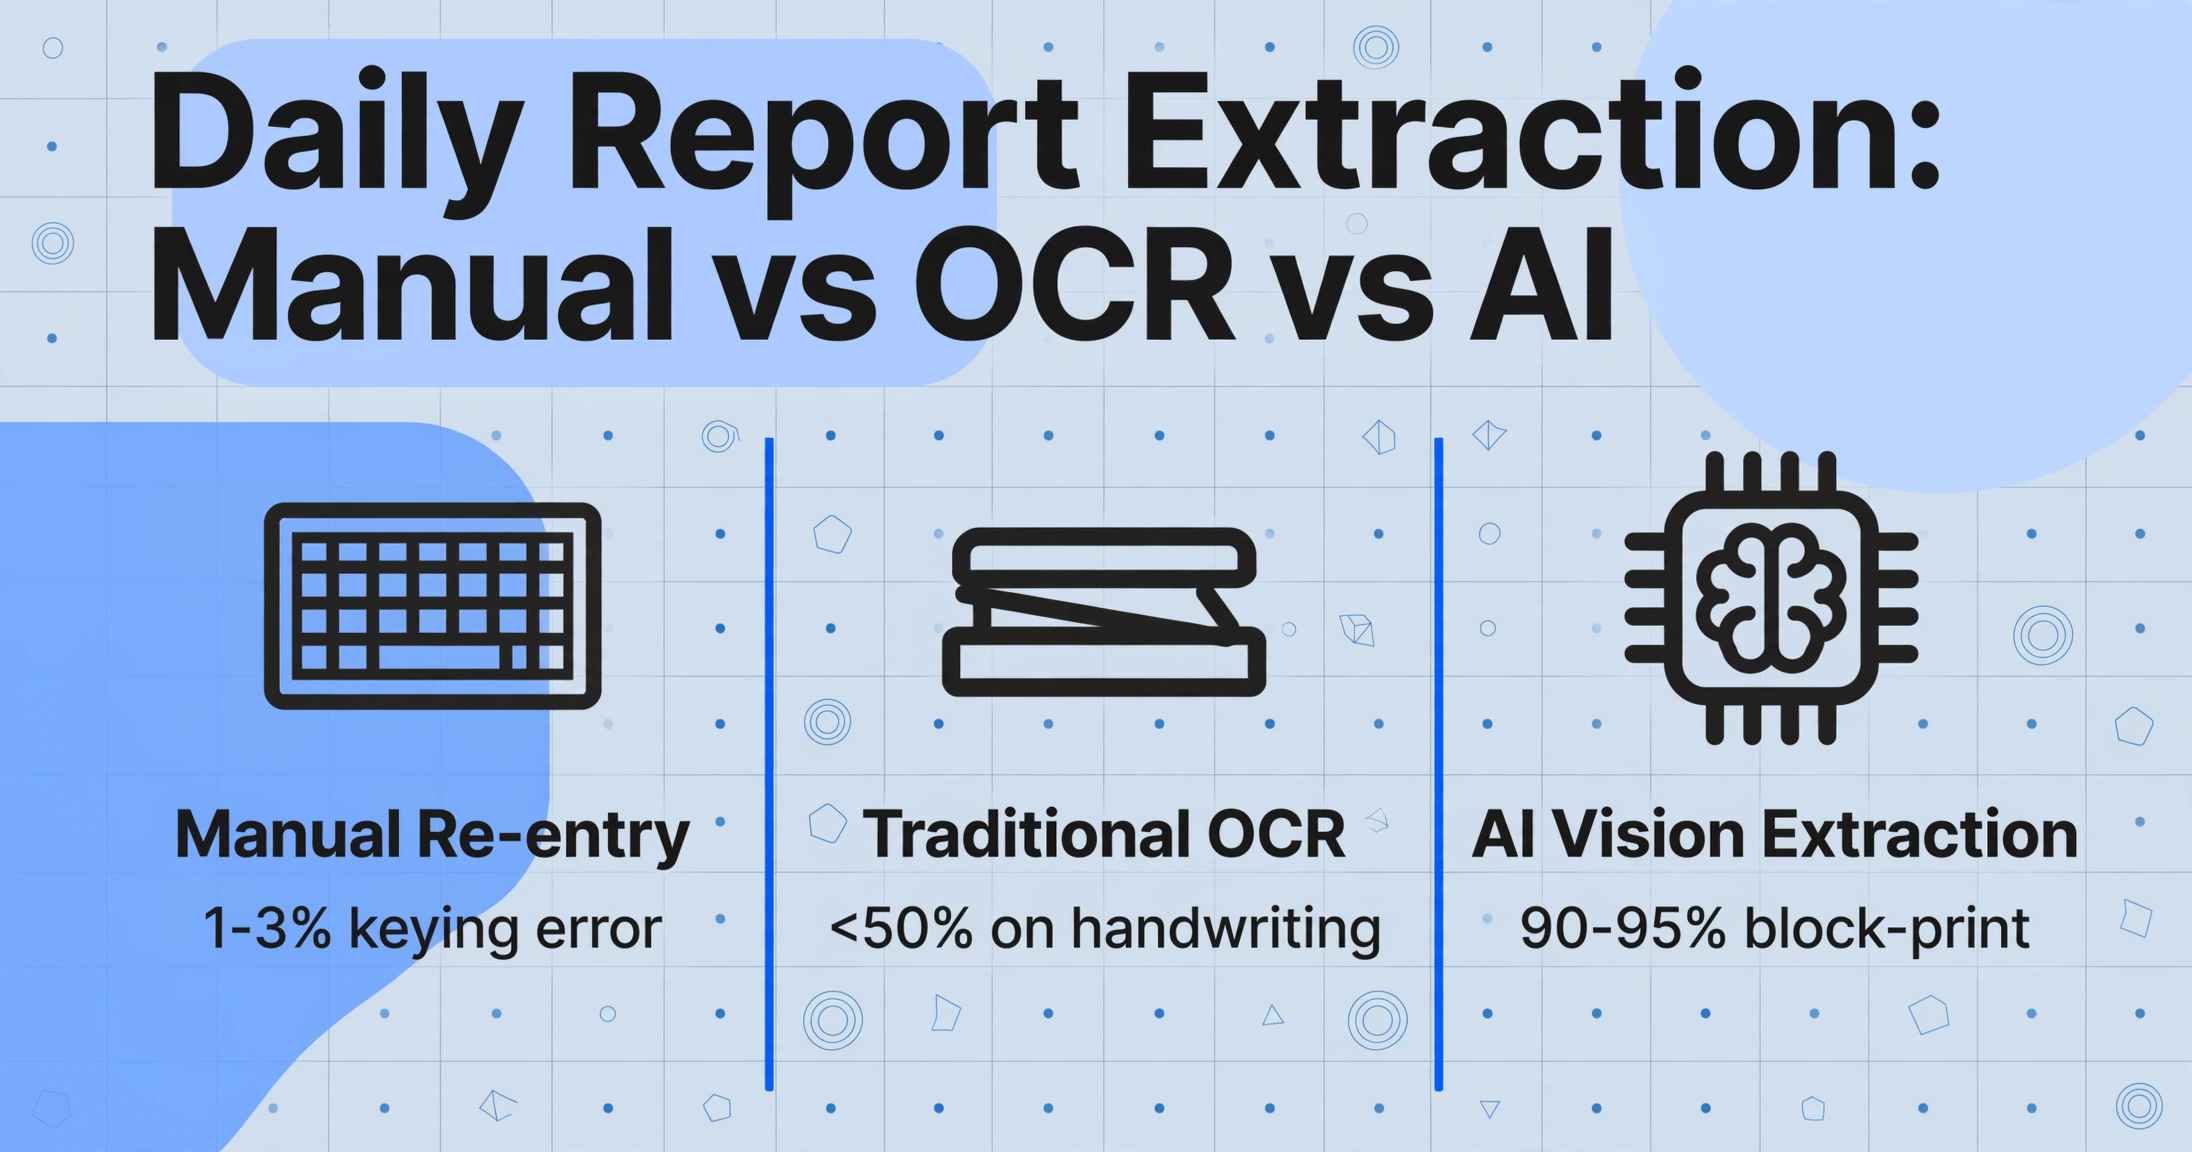
Existen tres enfoques para pasar los datos de los informes diarios en papel a un formato digital. Cada uno tiene una estructura de costos, un perfil de precisión y un impacto operativo diferentes para los equipos de campo y el personal de oficina.
| Método | Cómo funciona | Precisión | Tiempo por informe | Impacto en el equipo de campo |
|---|---|---|---|---|
| Reentrada manual | El personal de oficina lee el informe manuscrito y teclea los datos en una hoja de cálculo o ERP | Depende de quien teclea: se estima un 1-3% de error de tecleo en informes legibles | 5-12 minutos por informe (30-60 campos) | Ninguno: el papel continúa igual |
| OCR tradicional + corrección manual | Los informes escaneados pasan por un motor de OCR; las etiquetas impresas se extraen bien, los campos manuscritos salen distorsionados y deben corregirse manualmente | <50% en escritura a mano: requiere la reentrada humana completa de la mayoría de los campos | 8-15 minutos por informe (escaneo + corrección de la salida de OCR defectuosa) | Ninguno: el papel continúa igual |
| Extracción con visión de IA + verificación puntual | Una foto del informe se procesa con visión de IA; los datos estructurados se exportan a Excel o CSV; una persona verifica 2-5 campos por informe | 90-95% en escritura de imprenta en casillas etiquetadas; 75-85% en cursiva (por campo, con foto clara) | 3-5 minutos para 5 informes (por lotes), incluida la verificación | Ninguno: el papel continúa igual; los superintendentes fotografían y envían |
La diferencia crítica no es solo la velocidad: es la naturaleza del esfuerzo humano implicado. La reentrada manual requiere transcripción: convertir un valor manuscrito en un valor tecleado, una tarea que no exige criterio y es puramente mecánica. La extracción con IA con verificación puntual requiere verificación: confirmar que el valor extraído coincide con el original, una tarea que un gerente de proyecto puede completar en segundos por campo. El paso de la transcripción a la verificación reduce la fatiga cognitiva y las tasas de error simultáneamente, porque la verificación usa el reconocimiento de patrones (¿este número parece correcto?) mientras que la transcripción usa la reproducción carácter por carácter.
El OCR tradicional se encuentra en un punto intermedio incómodo. Extrae etiquetas y encabezados impresos razonablemente bien (normalmente con una precisión del 95-99% en texto mecanografiado), pero baja por debajo del 50% en escritura a mano. El resultado es una salida mixta donde algunos campos son correctos, otros incorrectos, y el revisor humano no puede confiar en ninguno sin comprobar cada campo. Esto es en realidad peor que no usar IA, porque el revisor debe comprobar cada campo pero no puede simplemente volver a teclear desde cero: debe leer cada resultado del OCR, compararlo con el original y corregirlo. El ahorro de tiempo desaparece. Para los informes diarios donde predomina la escritura a mano, el OCR tradicional es la herramienta equivocada.
La guía del jefe de proyecto para la extracción de datos de documentos explica cómo esta comparación se extiende a otros tipos de documentos de construcción — facturas, órdenes de cambio, solicitudes de pago AIA — y ofrece un marco unificado para pensar en la extracción en todo el conjunto de documentos de un contratista.
Campos clave para extraer de los informes diarios
No todos los campos de un informe diario necesitan extracción. Algunos campos son metainformación para el archivo (número de informe, nombre del proyecto). Otros son contenido narrativo que es mejor conservar tal cual (párrafos de descripción del trabajo). El objetivo de la extracción deben ser los campos que alimentan los procesos posteriores: horas para nómina, uso de equipos para facturación, cantidades de materiales para el seguimiento de costos e incidentes de seguridad para el reporte de cumplimiento.
Al configurar un flujo de extracción, los nombres de columna que defina se convierten tanto en las instrucciones de extracción como en los encabezados de salida. La IA utiliza comprensión semántica para localizar valores haciendo coincidir los nombres de columna con el contenido del documento — por lo que la redacción de cada columna importa. Una columna llamada "Crew Count" le indica a la IA que busque un valor numérico de recuento de personal cerca de las etiquetas de cuadrilla o mano de obra. Una columna llamada "Worker Name" le indica que busque nombres individuales en una tabla de personal.
Aquí tiene un conjunto inicial recomendado de columnas de extracción para un informe diario estándar, organizado según el proceso posterior que alimentan:
Columnas de extracción recomendadas para informes diarios de obra:
Identidad (para archivo y referencias cruzadas):
Fecha del informe | Nombre del proyecto | Sitio / Ubicación

Mano de obra (alimenta nómina y códigos de costo):
Nombre del trabajador | Oficio | Horas regulares | Horas extra
Empresa subcontratista | Recuento de cuadrilla del subcontratista

Equipos (respaldan facturación y mantenimiento):
ID del equipo | Horas de operación del equipo

Materiales (alimenta el seguimiento de costos):
Nombre del material | Cantidad entregada | Cantidad consumida | Unidad

Seguridad (registro OSHA):
Incidente de seguridad (Sí/No) | Descripción del incidente

Retraso / Problema (impacto en el cronograma):
Tipo de retraso | Horas de retraso | Descripción del retraso

Clima (datos contextuales):
Condición climática (AM) | Condición climática (PM) | Temperatura
El principio: diseñe sus columnas de extracción en torno a las hojas de cálculo y sistemas a los que alimentan los datos, no en torno a los campos del formulario. Si su sistema de seguimiento de costos usa "Trade Classification" en lugar de "Craft", nombre su columna "Trade Classification" — la etiqueta que coincide con el sistema de destino ahorra un paso de mapeo más adelante.
Para obtener orientación sobre la precisión que puede esperar de cada tipo de campo en un informe manuscrito, consulte el desglose de precisión de extracción por tipo de campo. Los patrones son consistentes: los números en casillas etiquetadas se extraen de forma más confiable, el texto narrativo en cursiva presenta la mayor variación de precisión y los indicadores de casillas de verificación se acercan al 100% independientemente de la calidad de la letra.
Procesamiento por lotes: varios sitios, varios informes, una sola hoja de cálculo
El ritmo real de la elaboración de informes de construcción es por naturaleza por lotes. Un coordinador de proyecto no procesa un informe y se detiene: recopila informes de tres supervisores en dos obras durante una semana y luego necesita consolidar todo en un solo conjunto de números. El procesamiento por lotes es lo que hace práctica la extracción a escala de proyecto.
En un flujo de trabajo por lotes, todos los informes cargados juntos comparten las mismas definiciones de columnas y producen una única tabla de salida. La IA procesa cada documento de forma independiente, pero los genera como filas combinadas, de modo que el resultado es una sola hoja de cálculo con una fila por informe, sin importar cuántos formatos o estilos de escritura diferentes haya en el lote.
La decisión operativa clave en el procesamiento por lotes es cómo identificar cada informe en la salida consolidada. Dado que la IA lee «Nombre del proyecto» y «Fecha del informe» como campos extraíbles, estos se convierten en columnas naturales de agrupación en la tabla de salida, lo que permite al coordinador ordenar, filtrar y sumar entre sitios sin añadir identificadores manualmente. Un superintendente que envía varios informes para el mismo proyecto en diferentes fechas tendrá cada fecha como una fila separada, agrupada automáticamente por nombre de proyecto.
La guía detallada para convertir por lotes informes manuscritos de obra en resúmenes semanales explica la configuración, las convenciones de nomenclatura y el flujo de verificación para procesar de 20 a 30 informes a la vez. La comparación práctica de tiempo: procesar 20 informes de cuatro sitios manualmente toma aproximadamente de 2 a 3 horas de escritura. La extracción por lotes con IA y verificación toma de 15 a 25 minutos, y la salida ya está en una sola hoja de cálculo, no en una pila de archivos separados esperando ser combinados.
El procesamiento por lotes también resuelve un problema sutil pero importante: la inconsistencia de formato entre informes. Un coordinador de proyecto que recibe informes de varios supervisores sabe que cada uno usa un diseño ligeramente diferente. Uno usa un formulario PDF impreso con casillas etiquetadas. Otro usa un cuaderno de copia carbón. Un tercero dibuja una tabla en papel en blanco. Las herramientas basadas en plantillas necesitarían configuraciones separadas para cada formato. La extracción semántica — donde la IA lee por significado del campo, no por posición en la página — procesa las tres variantes de formato con las mismas definiciones de columnas. La tabla de salida tiene las mismas columnas sin importar si el documento fuente era un formulario impreso profesional o una tabla dibujada a mano en papel cuadriculado.
Para equipos que gestionan cinco o más sitios activos con múltiples superintendentes que envían informes a diario, un flujo de trabajo con Enlace de Recopilación amplifica aún más el procesamiento por lotes: genere un enlace compartible que cada superintendente abra desde su teléfono, fotografía su informe y lo envíe directamente. El enlace no requiere instalación de aplicación, ni inicio de sesión, ni capacitación — y los archivos llegan categorizados automáticamente a la cola de procesamiento del coordinador del proyecto, listos para una única extracción por lotes al final de la semana.
Exportación y uso de los datos extraídos
La extracción es un paso intermedio, no el final. El valor de los datos estructurados depende de adónde van y cómo se usan. Los formatos de salida disponibles para los datos extraídos de informes diarios son:
| Formato | Ideal para | Uso posterior |
|---|---|---|
| Excel (XLSX) | Resúmenes semanales de mano de obra, informes de costos de equipo, seguimiento de consumo de materiales | Apertura directa en Excel para filtros, tablas dinámicas y gráficos; se puede importar a Procore, Sage, Viewpoint |
| CSV | Importaciones a sistemas ERP y contables | Formato universal para importación de datos; compatible con prácticamente todas las plataformas de contabilidad de construcción |
| JSON | Integraciones personalizadas, flujos de trabajo basados en API | Consumo programático; adecuado para equipos con canalizaciones de datos internas o herramientas de gestión de proyectos personalizadas |
Un flujo de trabajo semanal práctico con datos extraídos se ve así:
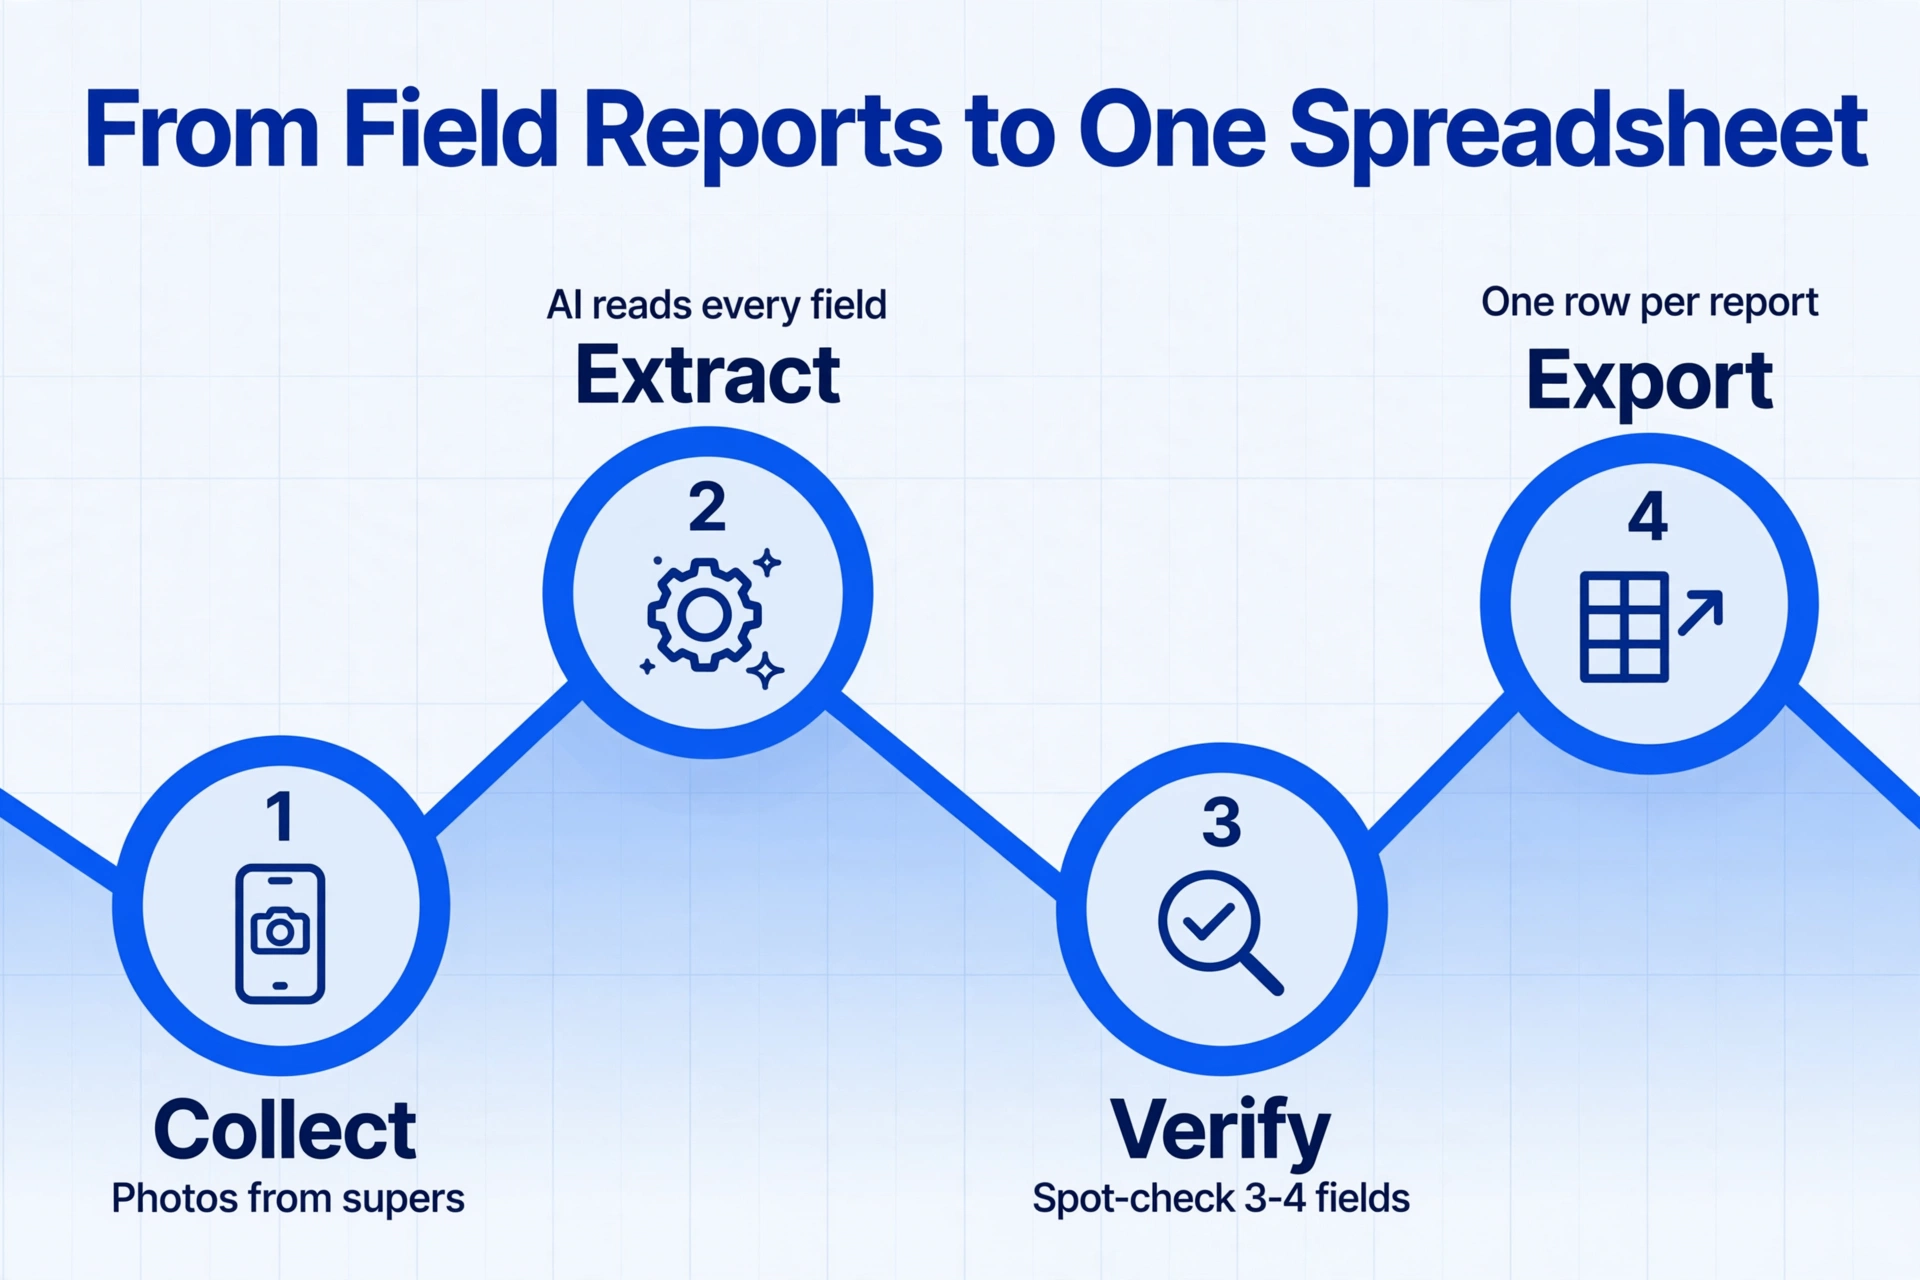
Lunes por la mañana: El coordinador del proyecto abre la herramienta de extracción y ve 15 informes enviados durante el fin de semana mediante Enlaces de Recopilación. Cada informe fue fotografiado por el superintendente al final de su turno el viernes y subido directamente.
Ejecución de extracción (15 minutos): El coordinador selecciona los 15 informes, confirma las definiciones de columna (sin cambios respecto a la semana anterior) e inicia la extracción por lotes. El sistema procesa cada informe; el coordinador verifica 3 o 4 campos por informe — unos 10 minutos de revisión.
Exportación y distribución (5 minutos): El coordinador exporta a Excel, crea una tabla dinámica para horas semanales por oficio, otra para uso de equipos y una tercera para consumo de materiales. Se distribuye un resumen de una página al equipo del proyecto antes del almuerzo.
Este flujo reemplaza un proceso que antes tomaba de 3 a 4 horas de escritura los lunes por la mañana, y los datos nunca estaban lo suficientemente estructurados para tablas dinámicas sin trabajo manual adicional.
Cómo elegir una herramienta de extracción de informes diarios
Al evaluar herramientas de extracción específicamente para informes diarios de obra, los criterios estándar de extracción de documentos no aplican directamente. Los informes diarios tienen características — escritura a mano, tablas incrustadas, diseños variables — que la mayoría de las herramientas enfocadas en facturas no fueron diseñadas para manejar. Estos son los criterios específicos que importan para este tipo de documento:
1. Capacidad de escritura a mano, no solo OCR. Los motores OCR tradicionales (Tesseract, ABBYY, el OCR integrado de Adobe Acrobat) están diseñados para texto impreso. Si la documentación de una herramienta menciona "zonas de plantilla" o "coordenadas fijas", no está diseñada para escritura a mano. Busque Vision AI (modelos multimodales grandes) que procesen la página como una imagen y lean el contenido mediante comprensión visual. La diferencia no es incremental — determina si la escritura a mano se extrae con una precisión del 40% o del 90%.
2. Independiente del formato, no coincidencia de plantillas. Las herramientas que requieren configuración de plantilla por formulario (dibujar cuadros alrededor de los campos, entrenar con documentos de muestra) no son operativamente viables para informes diarios de múltiples supervisores con diferentes formularios. El método de extracción debe ser semántico — leer el contenido del campo por significado en lugar de por ubicación — de modo que cambiar el diseño del formulario no requiera reconfiguración. Este es el requisito operativo más importante para contratistas con múltiples sitios.
3. Procesamiento por lotes con salida fusionada. La extracción de documentos individuales no es útil a escala de proyecto. La herramienta debe admitir procesamiento por lotes — cargar múltiples informes simultáneamente y generar una única tabla consolidada — sin requerir que el usuario extraiga cada informe uno a la vez y los fusione manualmente.
4. Exportación a Excel y CSV. La gestión de proyectos de construcción se basa en hojas de cálculo. La herramienta debe exportar directamente a formatos XLSX y CSV que puedan abrirse, pivotarse e importarse en Procore, Sage o Viewpoint. Los formatos de exportación propietarios que no pueden leerse con software de oficina estándar añaden un paso de conversión que anula el propósito de la automatización.
5. Sin ciclo de entrenamiento o configuración. Las herramientas que requieren cargar 10-20 documentos de muestra para entrenamiento, o que necesitan un "período de aprendizaje" antes de producir resultados utilizables, no coinciden con la realidad operativa de los proyectos de construcción. La extracción debe funcionar desde el primer informe el primer día — no después de un proceso de incorporación de dos semanas.
Estos criterios se alinean con el paradigma de extracción semántica sin plantilla que la guía más amplia de extracción de documentos de construcción aplica a los seis tipos principales de documentos de construcción. Para informes diarios específicamente, los criterios 1 y 2 son innegociables — una herramienta que no puede manejar escritura a mano y variación de formato no ofrecerá resultados utilizables independientemente de sus otras capacidades.
Preguntas frecuentes
¿Qué es un informe diario de obra?
Un informe diario de obra es un registro escrito de todas las actividades, recursos y condiciones significativas en un sitio de construcción durante un solo día calendario. Documenta la composición de la cuadrilla, las horas trabajadas, el equipo utilizado, los materiales recibidos, el trabajo completado, las condiciones climáticas, los incidentes de seguridad y cualquier retraso o problema encontrado.
¿Puede la IA extraer datos de informes diarios manuscritos?
Sí. La Vision AI moderna extrae datos manuscritos de informes diarios con una precisión del 90-95% para escritura en letra de molde dentro de casillas etiquetadas, y del 75-85% para texto cursivo. El desglose detallado de precisión cubre las expectativas a nivel de campo. La precisión depende principalmente de la calidad de la foto y la legibilidad de la escritura, no del diseño específico del formulario.
¿La extracción requiere cambiar el formulario del informe diario?
No. La extracción semántica lee el contenido por significado, no por el diseño del formulario, por lo que las mismas definiciones de columnas funcionan en diferentes formularios de diferentes superintendentes. No necesita rediseñar su formulario de informe diario para que la extracción funcione.
¿Cómo se compara esto con el uso de informes diarios de Raken, Fieldwire o Procore?
Esas herramientas reemplazan el papel en el punto de creación: el capataz completa un informe en la aplicación en lugar de en papel. La extracción con IA a partir de fotos digitaliza los informes de papel existentes sin exigir que los capataces cambien su proceso. Los enfoques son complementarios: algunos equipos prefieren aplicaciones, otros prefieren papel, y la extracción maneja lo que llegue.
¿Pueden importarse los datos extraídos en Sage, Viewpoint o Procore?
Sí. El resultado de la extracción está disponible en Excel (XLSX) o CSV, ambos pueden importarse en sistemas que admiten importación de datos basada en archivos. Los datos están estructurados y verificados, por lo que el paso de importación es una carga de archivo, no una sesión de reingreso manual. Las integraciones API en vivo no están disponibles actualmente; este es un flujo de trabajo de transferencia de archivos.
¿Cuántos informes diarios se pueden procesar en un solo lote?
El procesamiento por lotes maneja cómodamente de 20 a 50 informes por sesión. La limitación práctica es el tiempo de verificación: a 15-30 segundos por informe para una revisión puntual, un lote de 30 informes requiere de 10 a 15 minutos de revisión humana. El tiempo real de procesamiento de IA es de unos pocos segundos por informe, independientemente del tamaño del lote.
¿Qué sucede si un informe tiene mala caligrafía que la IA no puede leer?
Si la caligrafía es genuinamente ilegible (incluso para otra persona), la IA producirá una extracción parcial o de baja confianza. El enfoque práctico es tratar los campos problemáticos como excepciones de entrada manual. En la práctica, el 80-90% de los informes diarios de obras activas tienen caligrafía lo suficientemente clara para una extracción útil; el 10-20% restante requiere intervención humana independientemente del método utilizado.
¿Cuál es la acción más impactante que puedo tomar para mejorar los resultados de extracción?
Fotografíe el informe plano, de frente y con buena luz, antes de que se doble o se dañe. La diferencia de precisión entre una foto adecuada y una instantánea en ángulo con poca luz es de 15 a 25 puntos porcentuales, más que cualquier mejora de herramienta. Capture la copia original, no la copia carbón, y use un bolígrafo de tinta oscura para obtener el máximo contraste.
¿Funciona la extracción con IA en informes que incluyen fotos adjuntas?
Las fotos incrustadas o adjuntas a un informe diario contienen información contextual que un revisor humano necesita ver, pero no pueden "extraerse" de manera significativa como campos de datos estructurados. El enfoque recomendado es extraer los campos de texto (descripciones, ubicaciones, marcas de tiempo) del informe y conservar las fotos como archivos adjuntos que acompañan la salida estructurada.
¿Es esto diferente de la extracción para facturas de construcción?
Sí. Las facturas suelen imprimirse con diseños consistentes y contenido mecanografiado. Los informes diarios son manuscritos, utilizan estructuras de tabla variables y combinan texto narrativo con campos numéricos. La guía para la extracción de facturas de construcción cubre los detalles específicos de facturas. La tecnología de extracción es la misma; lo que cambia son las definiciones de columnas y las áreas de enfoque de verificación.
Comience con un Informe: Vea la Diferencia
Tome una foto de cualquier informe diario de obra manuscrito y súbala. En menos de 10 segundos, vea lo que un modelo de Vision AI extrae: recuentos de cuadrilla, horas, identificadores de equipo, cantidades de materiales. Sin registro, sin configuración, sin capacitación.
Subir un Informe Diario →