O Guia Completo para Extração de Dados de
Relatórios Diários de Obra
Um relatório diário de obra carrega três tipos distintos de valor: é um registro contratual, um documento de progresso e uma fonte de dados para controles de projeto. A maioria das equipes o trata como os dois primeiros e ignora o terceiro — porque extrair dados estruturados de relatórios manuscritos de campo sempre exigiu redigitação manual ou forçar as equipes de campo a usar aplicativos móveis. Este guia cobre o quadro completo: quais dados um relatório diário carrega, por que extraí-los importa, os desafios únicos que tornam este documento mais difícil que uma fatura ou recibo, e como a extração moderna por IA transforma relatórios em papel em dados estruturados sem pedir que nenhum membro da equipe mude sua forma de trabalhar.
Principais Conclusões
- 60-80 relatórios diários manuscritos, 1.800-3.200 pontos de dados por mês — cada dígito precisa ser redigitado por um gerente de escritório antes de chegar à folha de pagamento, faturamento ou conformidade.
- Por 15 anos, toda tentativa de digitalização exigiu a mesma coisa impossível: que um superintendente terminando um turno de 10 horas no campo abra um aplicativo e digite em vez de preencher um formulário em papel que usou durante toda a carreira.
- O Vision AI lê contagens de equipe, horas de equipamento e quantidades de materiais de qualquer formulário manuscrito — assim os superintendentes continuam usando papel, e a planilha estruturada chega sem uma única tecla de redigitação manual.
O que é um relatório diário de obra? (E quais dados ele contém?)
Um relatório diário de obra — também chamado de diário de obra, relatório de campo ou relatório de site — é o registro escrito de tudo o que aconteceu em um canteiro de obras durante um único dia de trabalho. Sua base contratual vem da AIA A201-2017 §3.3.3.4, que exige que o empreiteiro mantenha registros de inspeção, dados de testes e outros registros do projeto no local. Embora a A201 defina a obrigação de manter registros, o setor convergiu para um conjunto padrão de categorias de informação que aparecem em praticamente todos os formulários de relatório diário em uso hoje.
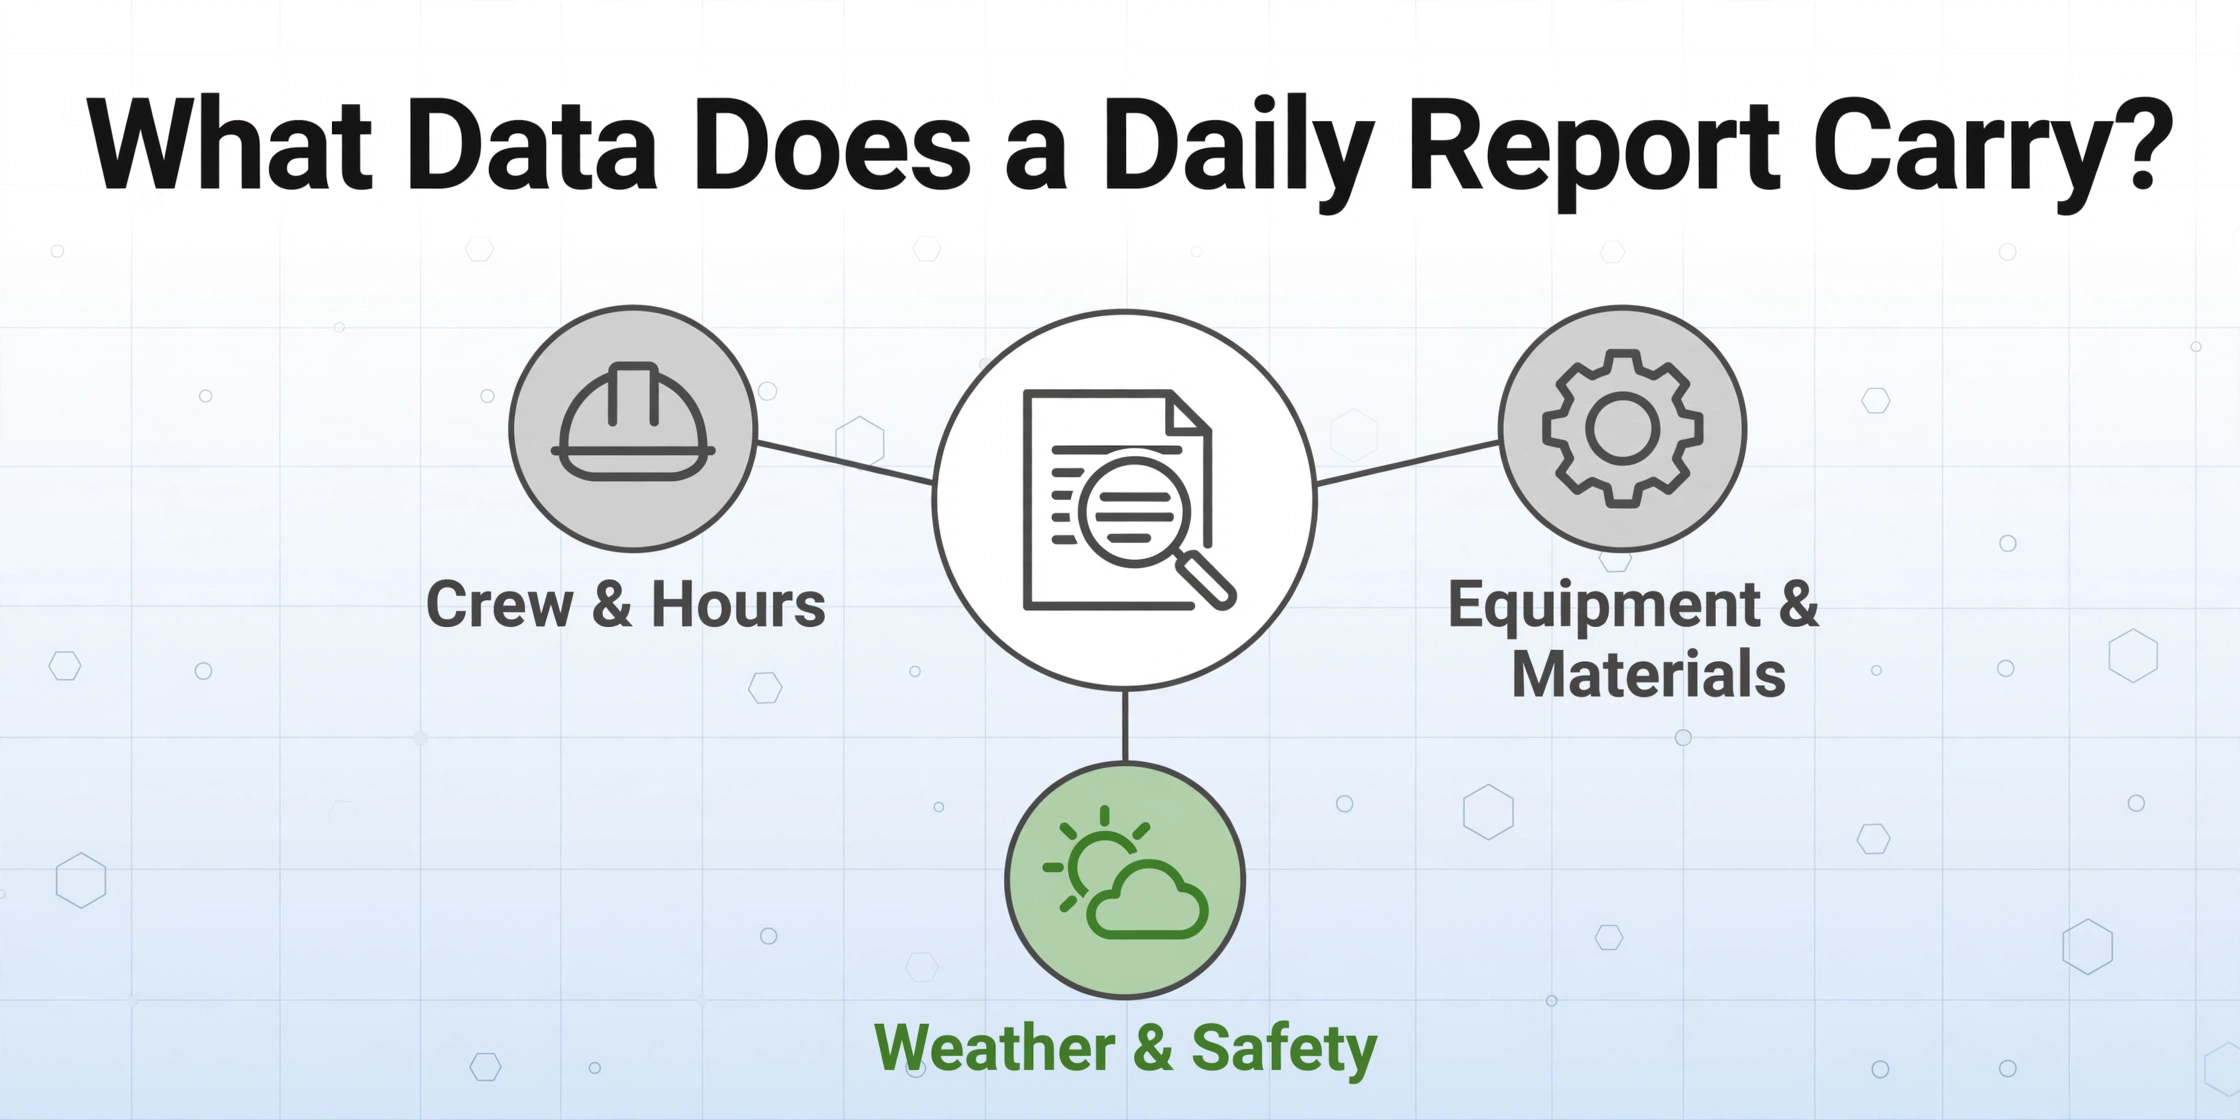
Um relatório diário típico contém de 15 a 35 pontos de dados extraíveis em seis categorias: composição da equipe e horas, equipamentos mobilizados e tempo de operação, materiais recebidos e consumidos, trabalho concluído por especialidade, condições climáticas e incidentes de segurança.
Concretamente, aqui está a taxonomia de campos que aparece na maioria dos formulários de relatório diário:
Categorias padrão de campos do relatório diário de obra:
Cabeçalho / Identificação
Data do Relatório | Nome e Número do Projeto | Local/Área do Canteiro | Número do Relatório

Clima
Condições da Manhã | Condições da Tarde | Temperatura (Máx./Mín.)

Equipe e Mão de Obra
Nome do Membro da Equipe | Especialidade/Função | Horas Normais | Horas Extras
Empresa Subcontratada | Número de Equipes da Subcontratada | Trabalho Realizado pela Subcontratada

Equipamentos
Descrição do Equipamento | Número de Identificação do Equipamento | Horas de Operação
Observações sobre Equipamentos (ocioso, manutenção, paralisação)

Materiais
Descrição do Material | Quantidade Entregue | Unidade de Medida
Quantidade Consumida/Instalada | Nome do Fornecedor

Trabalho Concluído
Área/Local | Especialidade/Escopo | Descrição do Trabalho
Percentual Concluído (se aplicável)

Segurança e Incidentes
Incidente de Segurança (S/N) | Descrição do Incidente
Quase Acidente Registrado | Inspeção de Segurança Realizada

Atrasos e Problemas
Tipo de Atraso (clima/equipamento/material/mão de obra) | Duração (horas)
Descrição do Atraso | Impacto no Cronograma

Visitantes e Assinaturas
Nome do Visitante | Empresa do Visitante | Hora de Entrada / Hora de Saída
Assinatura do Superintendente | Assinatura do Revisor
Nem todo formulário tem todos os campos — o diário de um encarregado de obra pequena pode ser uma única página com uma dúzia de linhas, enquanto o relatório de um superintendente de grande projeto para um empreiteiro geral pode ocupar três ou quatro páginas com folhas de continuação. O que importa para a extração é que as categorias de campos sejam consistentes mesmo quando o layout não é. Um campo de contagem de equipe pode ser rotulado como "Workforce", "Personnel on Site" ou "Crew Members" dependendo do formulário, mas seu significado é o mesmo em todas as versões.
Por que extrair dados dos relatórios diários?
Se os relatórios diários já são preenchidos pelos superintendentes e armazenados nas pastas do projeto, por que adicionar uma etapa de extração? A resposta é que uma pilha de relatórios em papel é informação que existe, mas não é utilizável — não pode ser classificada, somada, analisada em tendências nem alimentar os sistemas de gestão de projetos. A extração é o que transforma um registro em dados.
Controles de projeto e acompanhamento de custos. As horas de equipe dos relatórios diários alimentam o acompanhamento de custos de mão de obra. As horas de equipamento acionam cronogramas de manutenção e apoiam a alocação de custos de locação. As quantidades de materiais consumidas são comparadas com as quantidades orçadas para análise de variação. Sem extração, cada uma dessas transferências de dados exige que alguém no escritório redigite manualmente os números do papel para uma planilha ou ERP. Um projeto com três canteiros ativos e cinco equipes em cada um gera cerca de 60 a 80 relatórios por mês — o que representa de 1.800 a 3.200 pontos de dados digitados individualmente, dependendo da complexidade do relatório.
Faturamento e documentação de disputas. Em contratos de tempo e material, os relatórios diários são a principal documentação de suporte das faturas. Se surgir uma disputa, o relatório diário é o que o empreiteiro aponta como evidência do trabalho realizado. Uma discussão no Reddit sobre métodos de acompanhamento de diários de obra capturou a realidade: "Formulários em papel e é um caos. As coisas se perdem, a caligrafia é ilegível, e minha gerente de escritório passa horas todos os dias só tentando juntar o que aconteceu." Quando essa gerente de escritório também está tentando emitir uma fatura de T&M, o risco de horas faturáveis perdidas é real.
Conformidade e registros regulatórios. Em projetos com financiamento federal nos Estados Unidos, a Lei Davis-Bacon exige registros de folha de pagamento certificados que acompanhem as horas trabalhadas por classificação para cada trabalhador no canteiro. Os dados de equipe dos relatórios diários são a fonte fundamental para esses relatórios certificados. Os requisitos de manutenção de registros da OSHA, sob a 29 CFR Part 1926, também exigem a manutenção de registros de lesões e doenças — os dados de incidentes de segurança dos relatórios diários alimentam diretamente os registros OSHA 300. Quando os dados são extraídos e estruturados, produzir esses relatórios leva minutos em vez de um dia inteiro de reconciliação.
O ponto em comum entre os três casos de uso: a extração não substitui o relatório diário. Ela substitui a ponte manual de dados entre o relatório e todos os sistemas downstream que precisam da informação. O formulário em papel continua em uso. O trabalho extra desaparece.
Os Desafios Únicos da Extração de Relatórios Diários
Os relatórios diários de obra apresentam um perfil de dificuldade de extração que difere significativamente de faturas, recibos e da maioria dos outros documentos comerciais. Compreender esses desafios é essencial para definir expectativas realistas e escolher a abordagem correta.
Taxa de manuscrito próxima de 100%. A maioria das faturas e recibos é impressa ou digitada. Um relatório diário é preenchido à mão — frequentemente nos últimos 20 minutos de um turno de 10 horas, por um superintendente cuja principal habilidade é gerenciar equipes, não caligrafia. O OCR tradicional, que compara formas de caracteres com modelos de fontes, simplesmente não funciona com precisão viável em manuscritos, porque a escrita à mão tem variação infinita na espessura do traço, inclinação e formação das letras. Modelos de IA baseados em visão lidam com texto manuscrito significativamente melhor, mas o fator manuscrito por si só torna os relatórios diários mais difíceis de extrair do que o documento comercial típico.
Estruturas de tabela incorporadas com layouts variáveis. Uma única página de relatório diário pode conter uma tabela de equipe, uma tabela de equipamentos, um registro de materiais e uma seção de assinatura de visitantes — cada uma com sua própria estrutura de colunas. A IA deve identificar onde cada tabela começa e termina, e associar corretamente os valores manuscritos aos seus cabeçalhos de coluna. Isso é fundamentalmente mais complexo do que extrair campos simples como uma data ou o total de uma fatura. A avaliação detalhada de capacidade para extração de relatórios diários por IA detalha a precisão por tipo de campo e mostra quais configurações de tabela são tratadas de forma confiável.
Tipos de campo mistos e multidimensionais. Temperaturas, nomes de equipe, horas de equipamento, quantidades de materiais, descrições narrativas do trabalho, indicadores de segurança em caixas de seleção — um relatório diário mistura campos numéricos, texto curto, parágrafos completos e indicadores binários na mesma página. Uma boa configuração de extração trata cada tipo de campo de forma diferente: números precisam permanecer numéricos (para soma), caixas de seleção precisam se tornar indicadores S/N, e o texto narrativo precisa preservar a frase completa sem ser comprimido em uma célula curta.
Layouts de formulário variáveis entre projetos e empreiteiros. Cada empreiteiro geral usa um modelo de relatório diário ligeiramente diferente. Alguns usam formulários impressos com caixas rotuladas. Outros usam cadernos com papel-carbono e linhas em branco. Alguns superintendentes desenham sua própria tabela em uma página em branco. Uma ferramenta de extração baseada em modelo exigiria configuração por formulário para cada variante — o que não é operacionalmente viável quando um único coordenador de projeto pode receber relatórios de dez superintendentes diferentes em uma semana. O método de extração deve ser independente de formato: ele lê o conteúdo pelo significado, não pela posição na página.
Fotos anexadas e anotações visuais. Muitos relatórios diários incluem fotografias anexadas ou incorporadas — fotos de progresso, problemas de segurança, entregas de materiais. Essas fotos contêm informações contextuais, mas não podem ser "extraídas" como campos de dados estruturados. A relação entre uma entrada de texto ("Trecho de calçada rachado") e uma foto anexada da rachadura é significativa para um revisor humano, mas atualmente está fora do escopo da extração automatizada. A abordagem prática: tratar as fotos como anexos que acompanham os dados estruturados extraídos.
A combinação desses desafios — alta taxa de manuscrito, tabelas incorporadas, tipos de campo mistos e layouts de formulário variáveis — explica por que os relatórios diários resistiram à digitalização por 15 anos, enquanto o processamento de faturas se tornou rotina.
Métodos Tradicionais vs Extração por IA: O Que Muda
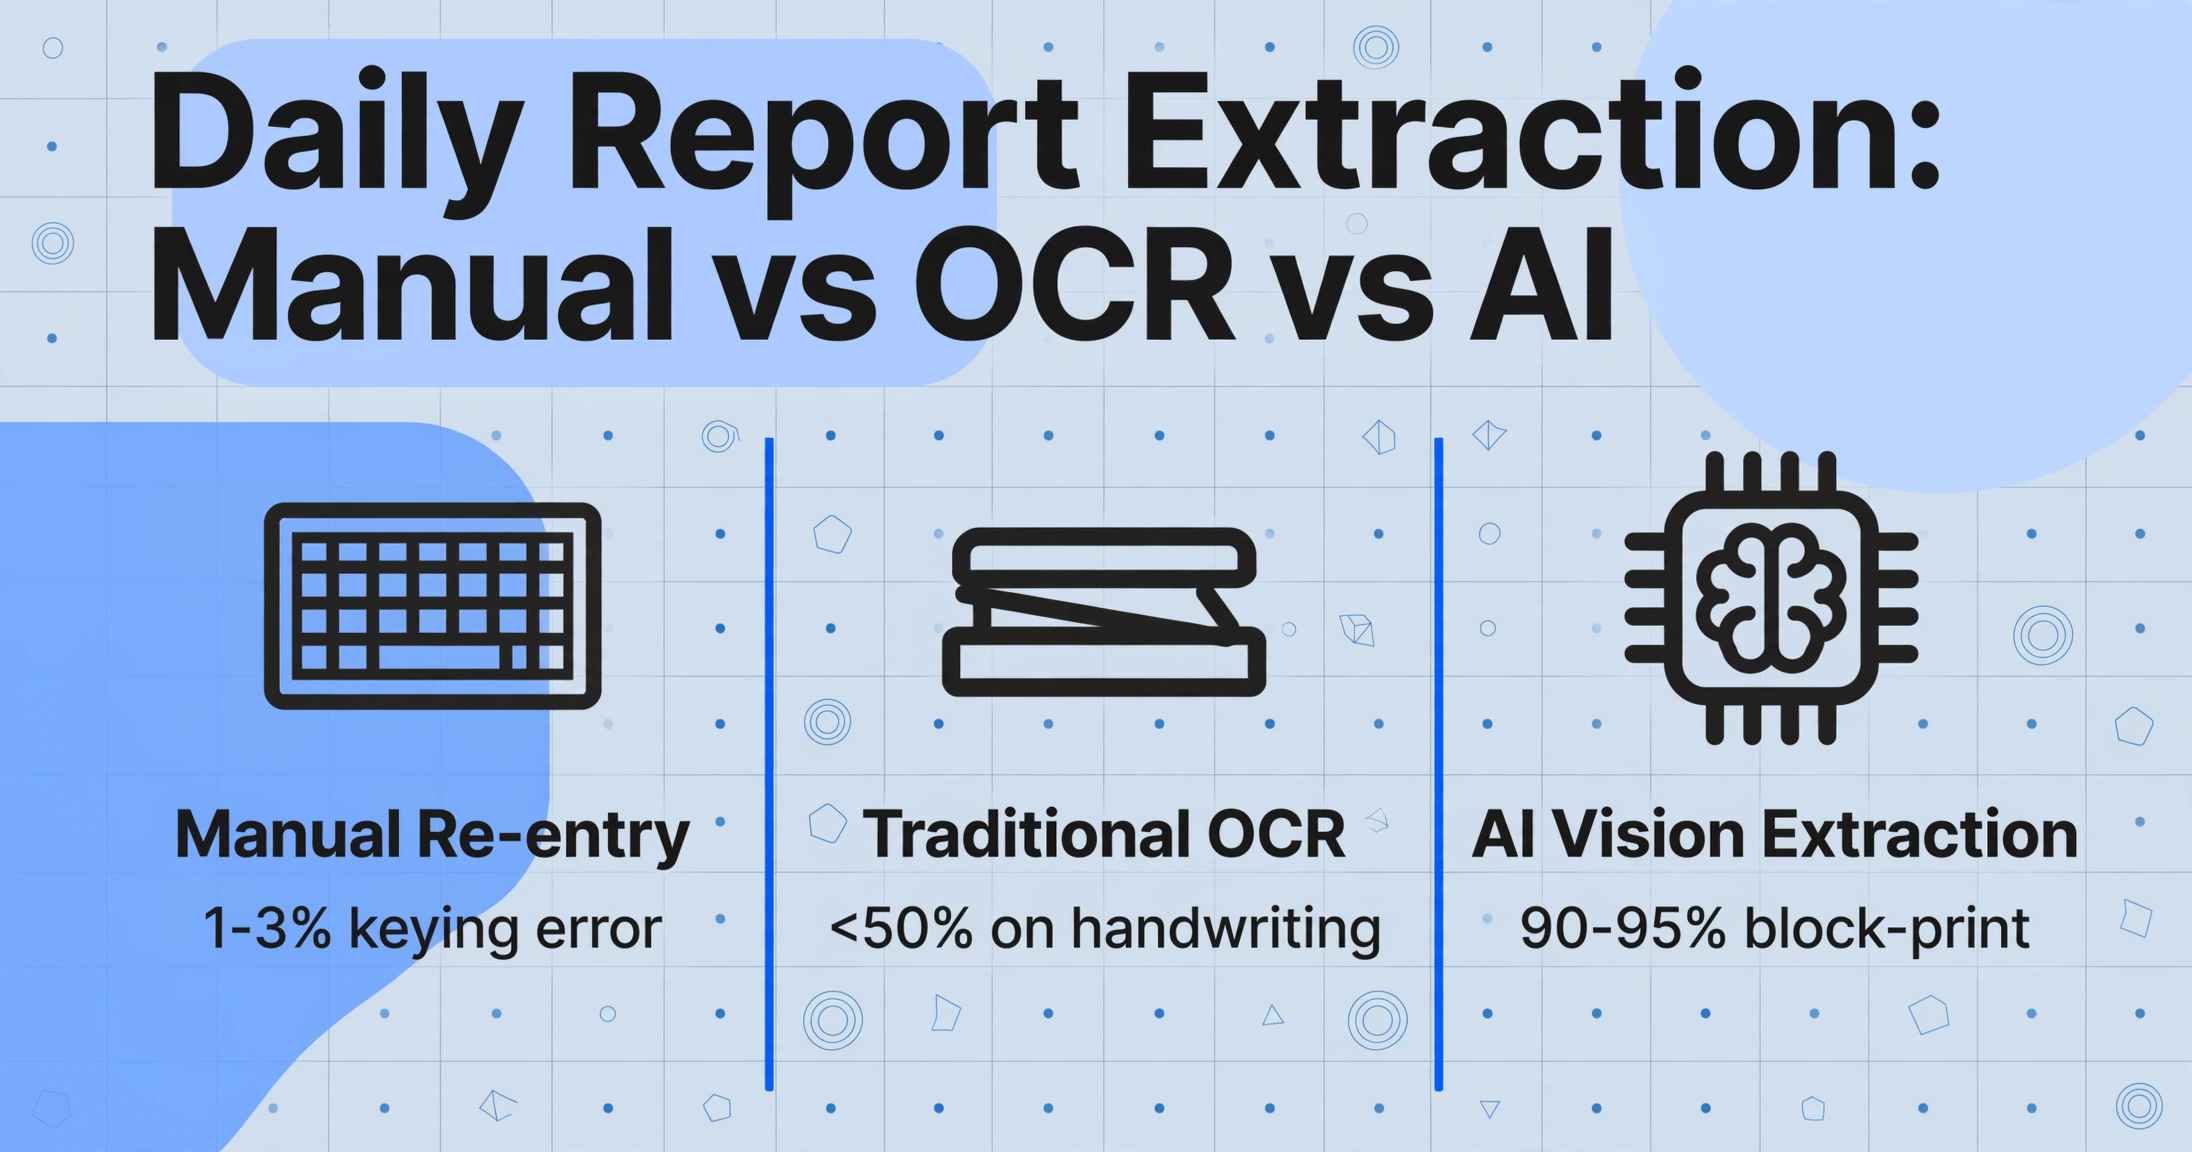
Existem três abordagens para transferir dados de relatórios diários em papel para um formato digital. Cada uma tem uma estrutura de custos, um perfil de precisão e um impacto operacional diferentes sobre as equipes de campo e o pessoal de escritório.
| Método | Como Funciona | Precisão | Tempo por Relatório | Impacto na Equipe de Campo |
|---|---|---|---|---|
| Redigitação manual | O pessoal de escritório lê o relatório manuscrito e digita os dados em uma planilha ou ERP | Depende do digitador — taxa estimada de erro de digitação de 1-3% em relatórios legíveis | 5-12 minutos por relatório (30-60 campos) | Nenhum — o papel continua como está |
| OCR tradicional + correção manual | Os relatórios digitalizados passam por um mecanismo de OCR; os rótulos impressos são extraídos bem, os campos manuscritos saem ilegíveis e precisam ser corrigidos manualmente | <50% em manuscrito — exige redigitação humana completa da maioria dos campos | 8-15 minutos por relatório (digitalizar + corrigir a saída quebrada do OCR) | Nenhum — o papel continua como está |
| Extração por IA vision + verificação pontual | Foto do relatório processada por IA vision; dados estruturados exportados para Excel ou CSV; o humano verifica 2-5 campos por relatório | 90-95% em manuscrito de letra de forma em caixas rotuladas; 75-85% em cursivo (por campo, foto nítida) | 3-5 minutos para 5 relatórios (lote), incluindo a verificação | Nenhum — o papel continua como está; os superintendentes fotografam e enviam |
A diferença crítica não é apenas a velocidade — é a natureza do esforço humano envolvido. A redigitação manual exige transcrição: converter um valor manuscrito em um valor digitado, uma tarefa que não exige julgamento e é puramente mecânica. A extração por IA com verificação pontual exige verificação: confirmar que o valor extraído corresponde ao original, uma tarefa que um gerente de projeto pode concluir em segundos por campo. A mudança da transcrição para a verificação reduz a fadiga cognitiva e as taxas de erro simultaneamente, porque a verificação usa correspondência de padrões (esse número parece certo?) enquanto a transcrição usa reprodução caractere por caractere.
O OCR tradicional fica em um meio-termo desconfortável. Ele extrai rótulos e cabeçalhos impressos razoavelmente bem — tipicamente com 95-99% de precisão para texto digitado — mas cai para menos de 50% em manuscrito. O resultado é uma saída mista em que alguns campos estão certos, alguns estão errados, e o revisor humano não pode confiar em nenhum deles sem verificar cada campo. Isso é, na verdade, pior do que não ter IA alguma, porque o revisor precisa verificar cada campo, mas não pode simplesmente redigitar do zero — ele precisa ler cada resultado do OCR, compará-lo ao original e corrigi-lo. A economia de tempo desaparece. Para relatórios diários em que o manuscrito predomina, o OCR tradicional é a ferramenta errada.
O guia do gerente de projetos de construção para extração de dados de documentos aborda como essa comparação se estende a outros tipos de documentos de construção — faturas, ordens de mudança, pedidos de pagamento AIA — oferecendo uma estrutura unificada para pensar sobre extração em todo o conjunto de documentos de um empreiteiro.
Campos Principais a Extrair dos Relatórios Diários
Nem todo campo de um relatório diário precisa ser extraído. Alguns campos são metainformações para arquivamento (número do relatório, nome do projeto). Outros são conteúdo narrativo que é melhor manter como está (parágrafos de descrição do trabalho). O alvo da extração devem ser os campos que alimentam processos posteriores: horas para folha de pagamento, uso de equipamentos para faturamento, quantidades de materiais para rastreamento de custos e incidentes de segurança para relatórios de conformidade.
Ao configurar um fluxo de trabalho de extração, os nomes das colunas que você define se tornam tanto as instruções de extração quanto os cabeçalhos de saída. A IA usa compreensão semântica para localizar valores combinando nomes de colunas com o conteúdo do documento — portanto, a redação de cada coluna importa. Uma coluna chamada "Crew Count" instrui a IA a procurar um valor numérico de efetivo perto de rótulos de equipe ou mão de obra. Uma coluna chamada "Worker Name" instrui a procurar nomes individuais em uma tabela de pessoal.
Aqui está um conjunto inicial recomendado de colunas de extração para um relatório diário padrão, organizado pelo processo posterior que elas alimentam:
Colunas de extração recomendadas para relatórios diários de obra:
Identidade (para arquivamento e referência cruzada):
Report Date | Project Name | Site / Location

Mão de obra (alimenta folha de pagamento e códigos de custo):
Worker Name | Trade | Regular Hours | Overtime Hours
Subcontractor Company | Sub Crew Count

Equipamentos (apoia faturamento e manutenção):
Equipment ID | Equipment Hours Run

Materiais (alimenta rastreamento de custos):
Material Name | Quantity Delivered | Quantity Consumed | Unit

Segurança (registros OSHA):
Safety Incident (Y/N) | Incident Description

Atraso / Problema (impacto no cronograma):
Delay Type | Delay Hours | Delay Description

Clima (dados contextuais):
Weather Condition (AM) | Weather Condition (PM) | Temperature
O princípio: projete suas colunas de extração em torno das planilhas e sistemas para os quais os dados vão, não em torno dos campos do formulário. Se seu sistema de rastreamento de custos usa "Trade Classification" em vez de "Craft", nomeie sua coluna como "Trade Classification" — o rótulo que corresponde ao sistema de destino economiza uma etapa de mapeamento depois.
Para orientações sobre a precisão que você pode esperar de cada tipo de campo em um relatório manuscrito, consulte o detalhamento da precisão de extração por tipo de campo. Os padrões são consistentes: números em caixas rotuladas são extraídos com mais confiabilidade, texto narrativo cursivo apresenta a maior variação de precisão, e indicadores de caixa de seleção se aproximam de 100% independentemente da qualidade da caligrafia.
Processamento em Lote: Vários Canteiros, Vários Relatórios, Uma Planilha
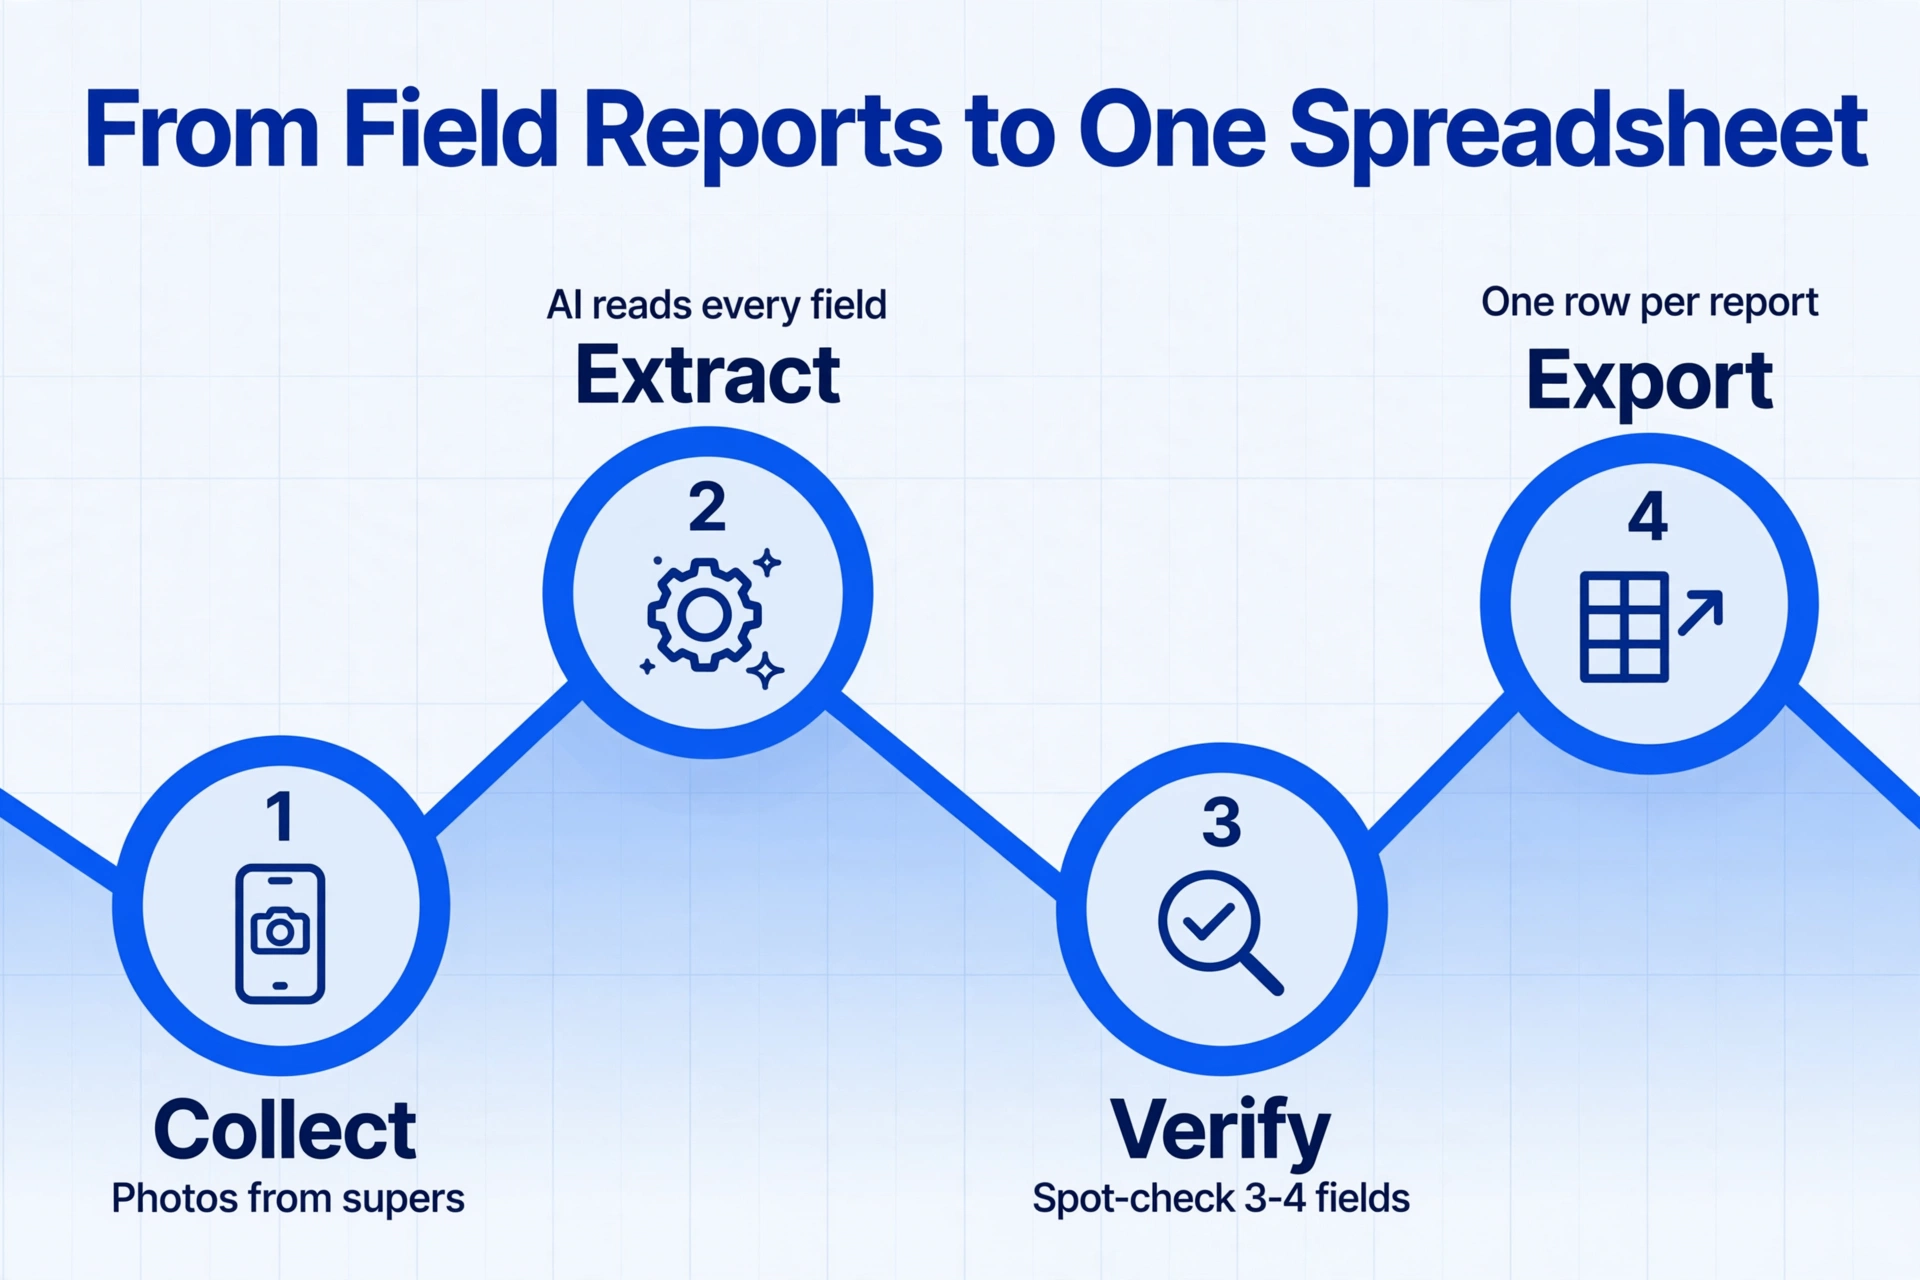
O ritmo real dos relatórios de obra é, por natureza, em lote. Um coordenador de projeto não processa um relatório e para — ele coleta relatórios de três supervisores em dois canteiros ao longo de uma semana e depois precisa consolidar tudo em um único conjunto de números. O processamento em lote é o que torna a extração prática na escala do projeto.
Em um fluxo de trabalho em lote, todos os relatórios enviados juntos compartilham as mesmas definições de coluna e produzem uma única tabela de saída. A IA processa cada documento de forma independente, mas os gera como linhas mescladas — assim, o resultado é uma planilha com uma linha por relatório, independentemente de quantos formulários ou estilos de caligrafia diferentes havia no lote.
A principal decisão operacional no processamento em lote é como identificar cada relatório na saída consolidada. Como a IA lê "Nome do Projeto" e "Data do Relatório" como campos extraíveis, eles se tornam colunas naturais de agrupamento na tabela de saída — permitindo que o coordenador ordene, filtre e some entre canteiros sem adicionar identificadores manualmente. Um supervisor que envia vários relatórios para o mesmo projeto em datas diferentes terá cada data como uma linha separada, agrupada automaticamente pelo nome do projeto.
O guia detalhado para converter em lote relatórios de obra manuscritos em resumos semanais percorre a configuração, as convenções de nomenclatura e o fluxo de verificação para processar de 20 a 30 relatórios por vez. A comparação prática de tempo: processar 20 relatórios de quatro canteiros manualmente leva cerca de 2 a 3 horas de digitação. A extração em lote com IA e verificação leva de 15 a 25 minutos — e a saída já está em uma única planilha, não em uma pilha de arquivos separados esperando para serem mesclados.
O processamento em lote também resolve um problema sutil, mas importante: a inconsistência de formato entre os relatórios. Um coordenador de projeto que recebe relatórios de vários supervisores sabe que cada supervisor usa um layout ligeiramente diferente. Um usa um formulário PDF impresso com caixas rotuladas. Outro usa um caderno de cópia carbono. Um terceiro esboça uma tabela em papel em branco. Ferramentas baseadas em modelo precisariam de configurações separadas para cada formato. A extração baseada em semântica — em que a IA lê pelo significado do campo, não pela posição na página — processa as três variantes de formato com as mesmas definições de coluna. A tabela de saída tem as mesmas colunas, independentemente de o documento de origem ser um formulário impresso profissional ou uma tabela desenhada à mão em papel milimetrado.
Para equipes que gerenciam cinco ou mais canteiros ativos com vários supervisores enviando relatórios diariamente, um fluxo de trabalho com Link de Coleta amplia ainda mais o processamento em lote: gere um link compartilhável que cada supervisor abre pelo celular, fotografa seu relatório e envia diretamente. O link não exige instalação de aplicativo, login nem treinamento — e os arquivos chegam autocategorizados na fila de processamento do coordenador de projeto, prontos para uma única extração em lote no fim da semana.
Exportação e uso dos dados extraídos
A extração é a etapa intermediária, não a final. O valor dos dados estruturados depende de para onde vão e como são usados. Os formatos de saída disponíveis para os dados extraídos do relatório diário de obra são:
| Formato | Ideal para | Uso posterior |
|---|---|---|
| Excel (XLSX) | Resumos semanais de mão de obra, relatórios de custos de equipamentos, acompanhamento do consumo de materiais | Abre diretamente no Excel para filtragem, tabelas dinâmicas e gráficos; pode ser importado para Procore, Sage, Viewpoint |
| CSV | Importações em sistemas ERP e de contabilidade | Formato universal para importação de dados; compatível com praticamente todas as plataformas de contabilidade de construção |
| JSON | Integrações personalizadas, fluxos de trabalho orientados por API | Consumo programático; adequado para equipes com pipelines de dados internos ou ferramentas de gestão de projetos personalizadas |
Um fluxo de trabalho semanal prático usando dados extraídos funciona assim:
Segunda-feira de manhã: O coordenador do projeto abre a ferramenta de extração e vê 15 relatórios enviados via Link de Coleta durante o fim de semana. Cada relatório foi fotografado pelo encarregado no fim do turno na sexta-feira e enviado diretamente.
Execução da extração (15 minutos): O coordenador seleciona os 15 relatórios, confirma as definições das colunas (inalteradas em relação à semana anterior) e inicia a extração em lote. O sistema processa cada relatório, e o coordenador verifica por amostragem 3 a 4 campos por relatório — cerca de 10 minutos de conferência.
Exportação e distribuição (5 minutos): O coordenador exporta para Excel, cria uma tabela dinâmica de horas semanais por especialidade, outra de utilização de equipamentos e uma terceira de consumo de materiais. Um resumo de uma página é distribuído à equipe do projeto antes do almoço.
Esse fluxo de trabalho substitui um processo que antes levava de 3 a 4 horas de digitação na segunda-feira de manhã — e os dados nunca eram estruturados o suficiente para tabelas dinâmicas sem trabalho manual adicional.
Como Escolher uma Ferramenta de Extração de Relatórios Diários
Ao avaliar ferramentas de extração especificamente para relatórios diários de obra, os critérios padrão de extração de documentos não se aplicam diretamente. Os relatórios diários têm características — escrita à mão, tabelas incorporadas, layouts variáveis — que a maioria das ferramentas voltadas para faturas não foi projetada para lidar. Aqui estão os critérios específicos que importam para esse tipo de documento:
1. Capacidade de escrita à mão, não apenas OCR. Os mecanismos tradicionais de OCR (Tesseract, ABBYY, o OCR integrado do Adobe Acrobat) são projetados para texto impresso. Se a documentação de uma ferramenta menciona "zonas de modelo" ou "coordenadas fixas", ela não foi projetada para escrita à mão. Procure Vision AI (grandes modelos multimodais) que processam a página como imagem e leem o conteúdo por compreensão visual. A diferença não é incremental — ela determina se a escrita à mão é extraída com 40% ou 90% de precisão.
2. Independência de formato, não correspondência de modelo. Ferramentas que exigem configuração de modelo por formulário (desenhar caixas ao redor dos campos, treinar com documentos de exemplo) não são operacionalmente viáveis para relatórios diários de vários supervisores com formulários diferentes. O método de extração deve ser semântico — lendo o conteúdo do campo pelo significado, e não pela localização — para que alterar o layout do formulário não exija reconfiguração. Este é o requisito operacional mais importante para empreiteiras com vários canteiros.
3. Processamento Prioritário em Lote com saída mesclada. A extração de documentos individuais não é útil na escala de um projeto. A ferramenta deve oferecer suporte ao processamento em lote — enviando vários relatórios simultaneamente e gerando uma única tabela consolidada — sem exigir que o usuário extraia cada relatório um de cada vez e faça a mesclagem manualmente.
4. Exportação para Excel e CSV. O gerenciamento de projetos de construção funciona com planilhas. A ferramenta deve exportar diretamente para os formatos XLSX e CSV, que podem ser abertos, dinamizados e importados para o Procore, Sage ou Viewpoint. Formatos de exportação proprietários que não podem ser lidos por softwares de escritório padrão adicionam uma etapa de conversão que anula o propósito da automação.
5. Sem ciclo de treinamento ou configuração. Ferramentas que exigem o envio de 10 a 20 documentos de exemplo para treinamento, ou que precisam de um "período de aprendizado" antes de produzir resultados utilizáveis, não correspondem à realidade operacional dos projetos de construção. A extração deve funcionar desde o primeiro relatório no primeiro dia — não depois de um processo de integração de duas semanas.
Esses critérios estão alinhados com o paradigma de extração semântica e sem modelo que o guia mais amplo de extração de documentos de construção aplica a todos os seis principais tipos de documentos de construção. Para relatórios diários especificamente, os critérios 1 e 2 são inegociáveis — uma ferramenta que não consegue lidar com escrita à mão e variação de formato não entregará resultados utilizáveis, independentemente de suas outras capacidades.
Perguntas frequentes
O que é um relatório diário de obra?
Um relatório diário de obra é um registro escrito de todas as atividades, recursos e condições significativas em um canteiro de obras durante um único dia corrido. Ele documenta a composição da equipe, horas trabalhadas, equipamentos utilizados, materiais recebidos, trabalho concluído, condições climáticas, incidentes de segurança e quaisquer atrasos ou problemas encontrados.
A IA consegue extrair dados de relatórios diários manuscritos?
Sim. A Vision AI moderna extrai dados manuscritos de relatórios diários com 90-95% de precisão para letra de forma em caixas identificadas, e 75-85% para texto cursivo. O detalhamento de precisão cobre as expectativas por campo. A precisão depende principalmente da qualidade da foto e da legibilidade da caligrafia — não do layout específico do formulário.
A extração exige alterar o formulário do relatório diário?
Não. A extração semântica lê o conteúdo pelo significado, não pelo layout do formulário — então as mesmas definições de coluna funcionam em formulários diferentes de superintendentes diferentes. Você não precisa redesenhar seu formulário de relatório diário para que a extração funcione.
Como isso se compara ao uso dos relatórios diários do Raken, Fieldwire ou Procore?
Essas ferramentas substituem o papel no momento da criação — o encarregado preenche um relatório no aplicativo em vez de no papel. A extração por IA a partir de fotos digitaliza relatórios em papel existentes sem exigir que os encarregados mudem seu processo. As abordagens são complementares: algumas equipes preferem aplicativos, outras preferem papel, e a extração lida com o que chegar.
Os dados extraídos podem ser importados para Sage, Viewpoint ou Procore?
Sim. A saída da extração está disponível em Excel (XLSX) ou CSV, ambos podem ser importados em sistemas que suportam importação de dados baseada em arquivo. Os dados são estruturados e verificados, então a etapa de importação é um upload de arquivo em vez de uma sessão de redigitação manual. Integrações de API ao vivo não estão disponíveis no momento — este é um fluxo de trabalho de transferência de arquivo.
Quantos relatórios diários podem ser processados em um único lote?
O processamento em lote lida confortavelmente com 20 a 50 relatórios por sessão. A restrição prática é o tempo de verificação — a 15-30 segundos por relatório para conferência por amostragem, um lote de 30 relatórios exige 10-15 minutos de revisão humana. O tempo real de processamento da IA é de alguns segundos por relatório, independentemente do tamanho do lote.
O que acontece se um relatório tiver caligrafia ruim que a IA não consegue ler?
Se a caligrafia for genuinamente ilegível (não legível nem mesmo para outra pessoa), a IA produzirá uma extração parcial ou de baixa confiança. A abordagem prática é tratar os campos problemáticos como exceções de entrada manual. Na prática, 80-90% dos relatórios diários de canteiros de obras ativos têm caligrafia clara o suficiente para uma extração útil — os 10-20% restantes exigem intervenção humana, independentemente do método utilizado.
Qual é a coisa mais impactante que posso fazer para melhorar os resultados da extração?
Fotografe o relatório plano, de frente, com boa iluminação, antes que ele seja dobrado ou danificado. A diferença de precisão entre uma foto adequada e um instantâneo angular com pouca luz é de 15-25 pontos percentuais — maior do que qualquer atualização de ferramenta. Capture a via original, não a cópia a carbono, e use uma caneta esferográfica escura para obter o máximo de contraste.
A extração por IA funciona com relatórios que incluem fotos anexadas?
Fotos incorporadas ou anexadas a um relatório diário carregam informações contextuais que um revisor humano precisa ver, mas não podem ser "extraídas" de forma significativa como campos de dados estruturados. A abordagem recomendada é extrair os campos de texto (descrições, locais, carimbos de data e hora) do relatório e manter as fotos como anexos de arquivo que acompanham a saída estruturada.
Isso é diferente da extração para faturas de construção?
Sim. As faturas normalmente são impressas com layouts consistentes e conteúdo digitado. Os relatórios diários são manuscritos, usam estruturas de tabela variáveis e misturam texto narrativo com campos numéricos. O guia para extração de faturas de construção aborda detalhes específicos de faturas. A tecnologia de extração é a mesma — o que muda são as definições de colunas e os focos de verificação.
Comece com um relatório — veja a diferença
Tire uma foto de qualquer relatório diário de obra manuscrito e faça o upload. Em menos de 10 segundos, veja o que um modelo de Vision AI extrai — contagens de equipe, horas, IDs de equipamentos, quantidades de materiais. Sem cadastro, sem configuração, sem treinamento.
Fazer upload de um relatório diário →