L'OCR peut-il lire les captures d'écran ?
Oui — et elles sont plus faciles que les photos
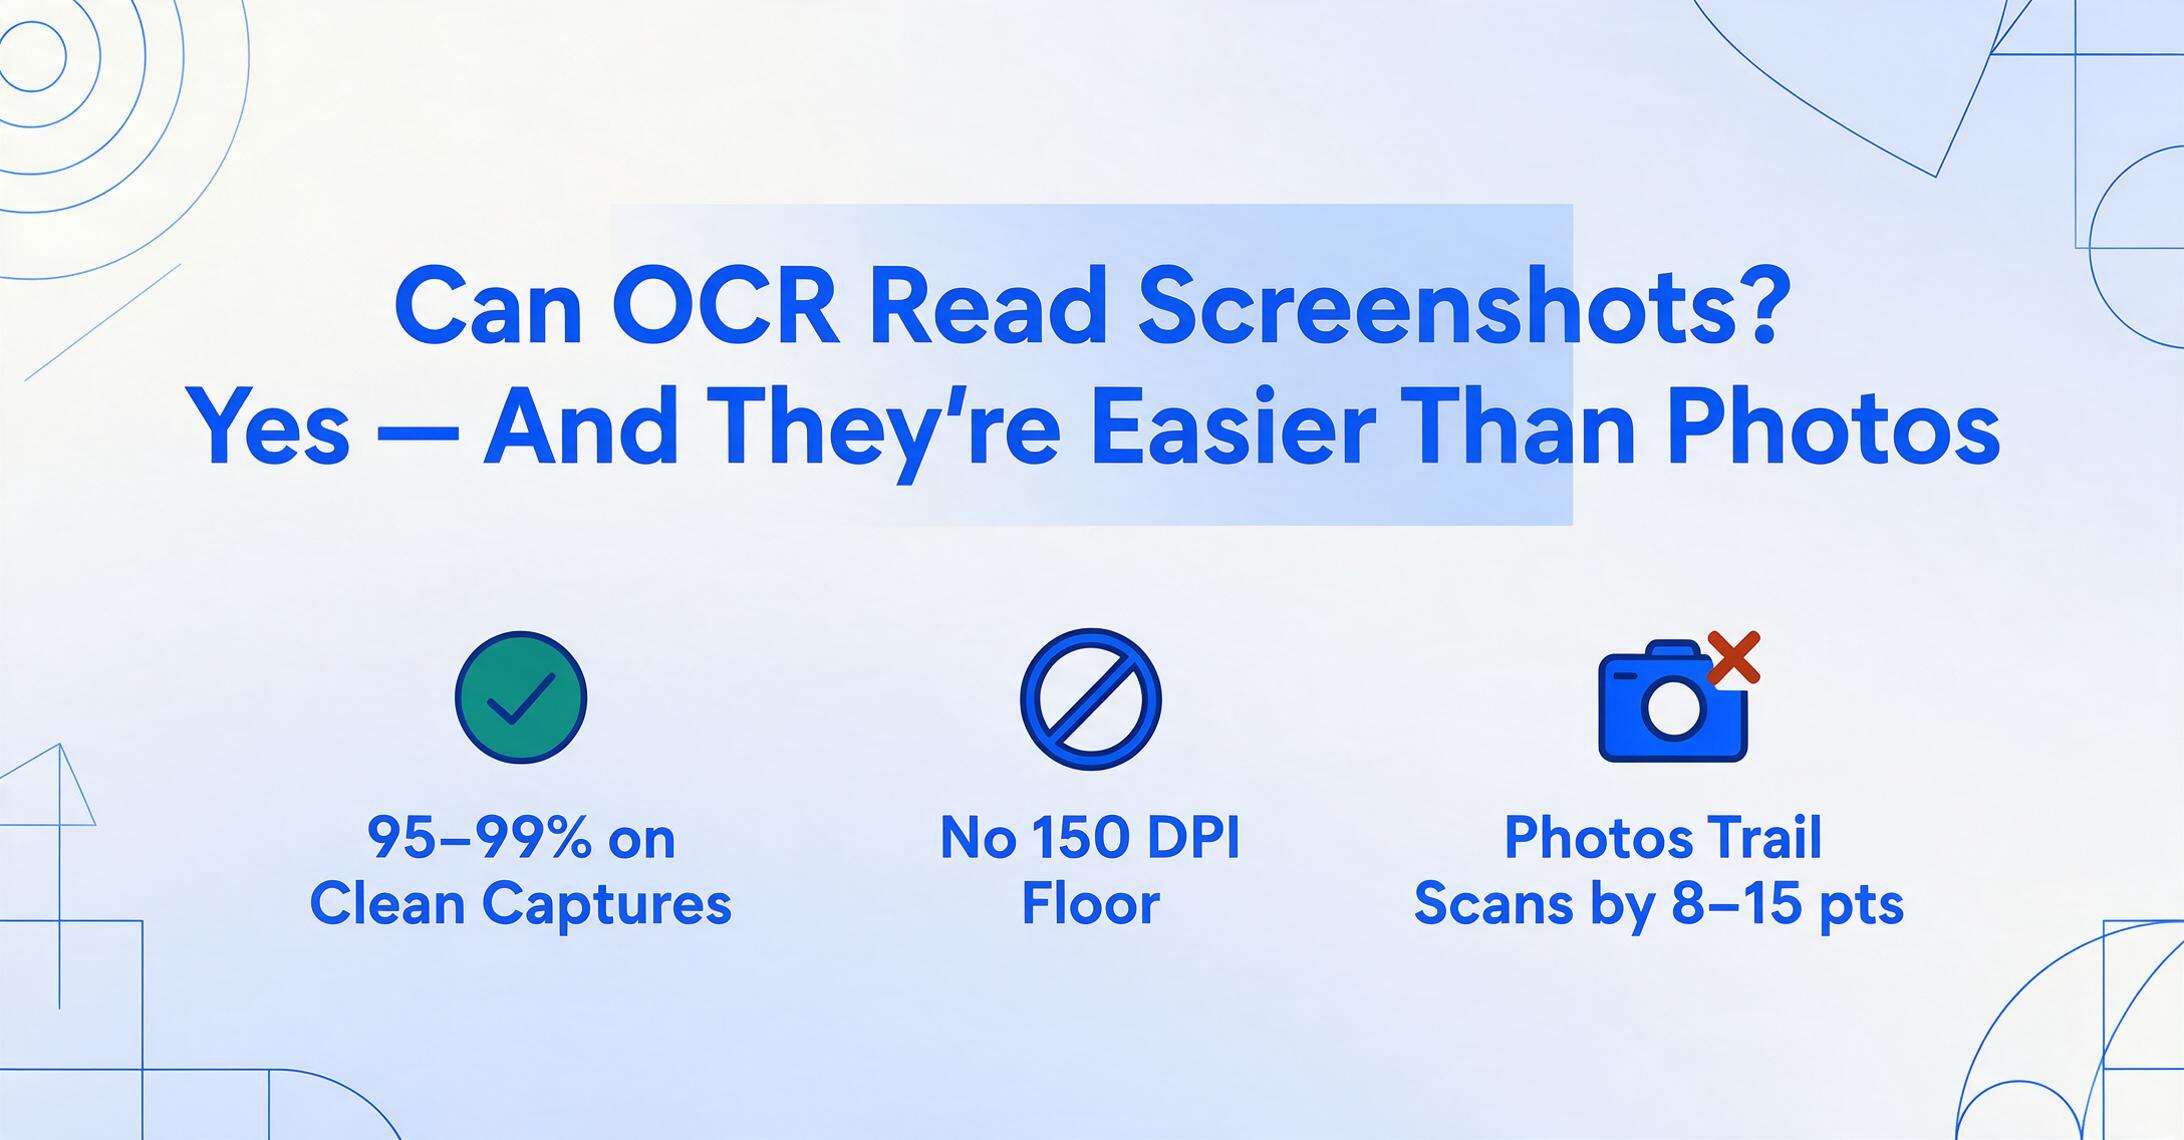
Oui. L'OCR alimenté par l'IA lit les captures d'écran avec une précision supérieure à celle des photos ou des scans — et dans de nombreux cas, l'écart est significatif. Une capture d'écran propre d'une confirmation de paiement ou d'un tableau de bord d'application produit une précision de près de 99 % sur du texte numérique imprimé. Ces mêmes données capturées comme photo de téléphone d'un écran ? Attendez-vous à 5 à 10 points de pourcentage de moins. La raison est simple : les captures d'écran n'ont ni distorsion de perspective, ni éclairage inégal, ni flou de mouvement, et une résolution au pixel constant que le texte numérique a été conçu pour. Les défis sont différents — artefacts de compression des applications de messagerie, contenu recadré et interfaces en mode sombre — mais ils sont plus prévisibles et plus faciles à contourner que la physique variable d'un cliché d'appareil photo.
Points clés à retenir
- Envoyez une capture d'écran via WhatsApp et vous perdez silencieusement 10 points de précision — la compression de l'application de chat détruit plus de données que le mauvais éclairage ne le fera jamais.
- L'entrée la plus propre pour l'extraction par l'IA n'est pas un scan à 300 DPI. C'est une capture d'écran native de votre appareil — aucune distorsion de perspective, aucune ombre, aucun flou de mouvement.
- Trois habitudes de capture corrigent presque tous les échecs de capture d'écran : partagez les fichiers non compressés, faites défiler pour capturer la largeur complète des données et désactivez le mode sombre avant de capturer.
Précision de la lecture des captures d'écran par l'IA
Les chiffres dépendent de la qualité de la capture — mais sur une capture d'écran nette et non compressée de texte numérique, les modèles de vision IA modernes atteignent une précision proche de celle d'un scan papier, sans aucun matériel dédié.
L'OCR traditionnel a un seuil minimum : 150 DPI. En dessous, les contours des caractères deviennent flous, la segmentation échoue et les taux d'erreur grimpent. Les captures d'écran sont généralement réalisées à la résolution de l'écran — 72 à 96 DPI sur les moniteurs standard, 150+ sur les écrans Retina haute densité. C'est pourquoi les outils OCR classiques peinent avec les captures : ils ont été conçus pour du papier scanné à 300 DPI, et une capture à 75 DPI leur ressemble à un fax basse résolution. La communauté SuperUser en a fait l'expérience dans un long fil de discussion où les utilisateurs ont testé plusieurs outils OCR sur des captures et se sont systématiquement heurtés à des limites de précision sous le seuil des DPI.
Les modèles de vision IA modernes n'ont pas ce plancher de DPI. Ils traitent les images comme un humain lit un écran — en comprenant le contexte visuel global, sans isoler chaque trait de caractère. Une capture d'écran nette et non compressée prise directement sur un ordinateur ou un téléphone moderne (1440p ou plus) atteint une précision de texte imprimé supérieure à 95 %, et souvent proche de 99 % sur des polices standard et des mises en page prévisibles. Les captures d'écran issues d'écrans haute densité (Retina, 4K) sont encore meilleures car la densité de pixels donne plus de signal à l'IA par caractère. Dans un test de la communauté SAP comparant plusieurs méthodes d'extraction, les applications OCR standard de galerie sur Android et iOS ont traité les captures nettes avec une précision raisonnable, tandis que l'extraction par LLM — GPT-4 avec vision — a produit des transcriptions quasi parfaites à partir des mêmes captures.
La baisse de qualité vient de la compression. Une capture partagée via WhatsApp, Messenger ou SMS est recompressée — parfois agressivement — introduisant des artefacts JPEG, des bords adoucis et une profondeur de couleur réduite. Sur une capture fortement compressée, la précision de l'IA tombe à environ 85–92 %. C'est encore utilisable pour de nombreux flux de travail, mais pas sans intervention. Règle empirique : une capture directe sur l'appareil surpasse une capture transférée de 8 à 12 points de pourcentage sur le même contenu.
Pourquoi les captures d'écran sont plus faciles pour l'IA que les photos
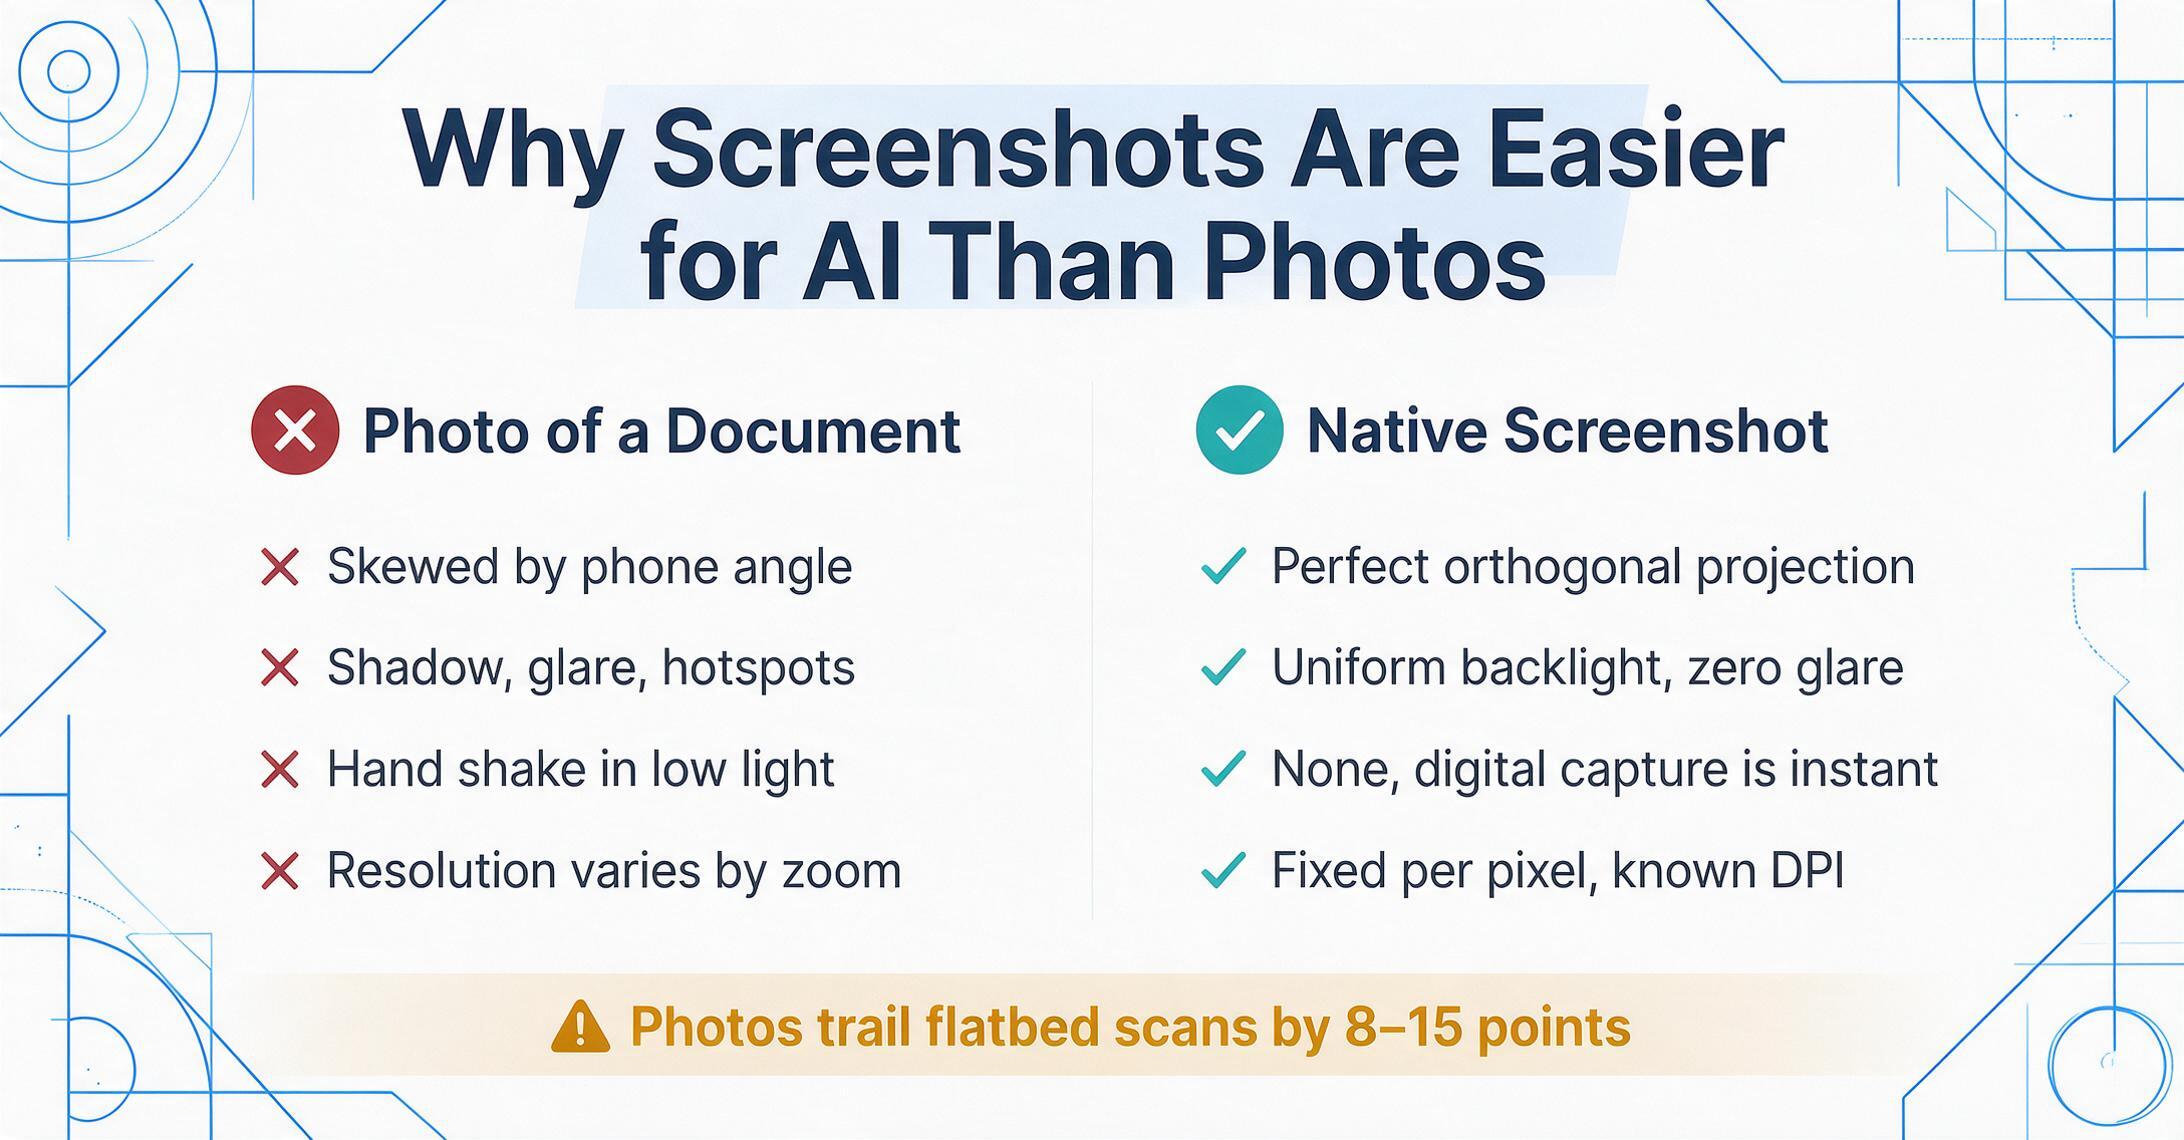
C'est la partie que la plupart des gens comprennent à l'envers. Une photo capture la réalité à travers un objectif — et la réalité est bruitée. Une capture d'écran capture une grille de pixels qui a déjà été conçue pour être lue.
Lorsqu'une personne prend une photo d'un document papier, l'IA doit résoudre plusieurs problèmes avant même de commencer à lire : corriger l'inclinaison de perspective (le téléphone était-il tenu en biais ?), compenser un éclairage inégal (y a-t-il une ombre en bas ?), supprimer le flou de mouvement, gérer la courbure du papier et faire face au bruit inhérent d'un capteur d'appareil photo dans une lumière imparfaite. Chacune de ces étapes introduit des erreurs qui s'accumulent tout au long du processus. Un benchmark indépendant de 2026 de codesota.com a montré que les photos de documents obtenaient systématiquement des résultats inférieurs de 8 à 15 points de pourcentage aux scans à plat en termes de précision au niveau des caractères, uniquement à cause de ces variables physiques.
Une capture d'écran les élimine toutes :
| Variable | Photo de document | Capture d'écran |
|---|---|---|
| Distorsion de perspective | Presque toujours présente — l'angle du téléphone déforme le texte | Aucune — projection orthogonale parfaite |
| Éclairage | Ombres inégales, reflets, zones surexposées dues au flash | Rétroéclairage uniforme, zéro reflet |
| Flou de mouvement | Tremblement de la main, surtout en basse lumière | Aucun — la capture numérique est instantanée |
| Cohérence de la résolution | Varie énormément selon la distance, l'objectif, le zoom | Fixe par pixel, DPI connu |
| Rendu du texte | Texture du papier, bavure d'encre, qualité d'impression variables | Rendu de police anticrénelé, épaisseur de trait constante |
| Bruit de fond | Surface du bureau, doigts, ombres, texture du papier | Généralement un fond d'interface de couleur unie |
La tâche de l'IA sur une capture d'écran est fondamentalement plus simple : elle lit du texte numérique sur un canevas numérique. Les caractères ont été rendus par un moteur de police — épaisseurs de trait constantes, crénage uniforme, formes prévisibles. Les moteurs OCR traditionnels n'exploitent pas cela car ils traitent chaque entrée comme une photographie. Les modèles modernes de vision-langage le font : ils reconnaissent que de l'Helvetica sur un fond d'application blanc est un type d'entrée fondamentalement différent d'un serif de 10 points sur du papier vieilli, et ils ajustent leur stratégie de lecture en conséquence. C'est le changement de paradigme — passer du traitement de chaque image comme une photographie dégradée à la compréhension de la nature de la source.
L'implication pratique est simple. Si vous avez le choix entre photographier un écran avec votre téléphone et prendre une capture d'écran native, choisissez la capture d'écran. Elle produira de meilleurs résultats d'extraction à chaque fois. Pour une comparaison plus approfondie de l'impact des différents types d'entrée sur la précision, consultez notre analyse de la précision d'extraction des captures d'écran, PDF, photos et scans.
Ce que l'IA réussit bien à partir de captures d'écran
L'IA excelle sur les captures d'écran où l'information suit des schémas numériques prévisibles — champs étiquetés, mises en page tabulaires et conventions d'interface cohérentes. Ces schémas sont omniprésents dans les applications et tableaux de bord utilisés quotidiennement.
Confirmations de paiement et écrans de transaction. Les reçus Venmo, les confirmations PayPal, les écrans de virement des applications bancaires, les tableaux de bord Stripe — tous partagent une structure commune : un montant de transaction, une date, un expéditeur ou destinataire, et un numéro de référence. Les données sont du texte numérique sur fond propre, souvent avec un code couleur à fort contraste (vert pour les paiements reçus, rouge pour les paiements envoyés). L'IA lit ces champs avec une précision quasi parfaite car les étiquettes sont prévisibles (« Montant », « Date », « De », « ID de transaction ») et les valeurs entretiennent des relations visuelles cohérentes avec leurs étiquettes. Pour les équipes qui rapprochent des dizaines de captures de paiement chaque jour — courant dans le e-commerce, la gestion immobilière et la comptabilité des petites entreprises — l'extraction par lots transforme une tâche de recoupement manuel en pipeline automatisé. Consultez notre guide sur l'extraction de données à partir de captures d'écran de paiement pour un flux de travail détaillé.
Tableaux de bord d'applications et écrans d'analyse. Tableaux de bord de ventes, panneaux Google Analytics, vues de gestion des stocks, résumés de revenus Stripe — des données qui vivent dans une application mais ne s'exportent pas facilement vers une feuille de calcul. Prendre une capture d'écran et extraire les chiffres dans Excel est souvent plus rapide que de chercher un bouton d'exportation qui n'existe peut-être pas. La mise en page tabulaire de la plupart des tableaux de bord — des lignes de métriques avec des en-têtes étiquetés — se mappe naturellement aux colonnes d'une feuille de calcul. Les modèles de vision IA reconnaissent les structures de tableaux dans les captures d'écran et préservent les relations lignes-colonnes pendant l'extraction, de sorte qu'un tableau « Revenus par canal » dans une capture de tableau de bord devient un tableau structuré « Canal | Revenus » dans votre feuille de calcul. Pour le traitement par lots de captures d'écran provenant de plusieurs tableaux de bord en un seul jeu de données, voir le traitement par lots de captures d'écran d'applications en feuille de calcul structurée.
Formulaires web et tableaux de données. Écrans ERP, vues de contacts CRM, pages de suivi d'expédition — les logiciels d'entreprise regorgent de données piégées derrière des interfaces web. Prendre une capture d'écran et extraire les champs évite d'avoir besoin d'un accès API, de droits d'exportation ou de l'intervention du service informatique. Le rendu de texte numérique dans les applications web est net et standardisé, et l'IA le lit avec une précision de 95 à 99 % sur des captures non compressées. Pour un exemple pratique de fonctionnement de bout en bout, voir comment obtenir des données de captures d'écran dans Excel sans saisie manuelle.
Données cliniques issues des écrans de DSE. Les systèmes de dossiers de santé électroniques sont notoirement limités en matière de capacités d'exportation. Les chercheurs et les gestionnaires de données cliniques ont souvent recours à la transcription manuelle des résultats de laboratoire, des listes de médicaments et des données démographiques des patients depuis les écrans de DSE vers des jeux de données de recherche. L'extraction par capture d'écran offre une solution de contournement : capturez l'écran, extrayez les données structurées et compilez-les dans une feuille de calcul — sans API du fournisseur de DSE. La précision sur les captures d'écran de DSE propres avec des polices standard est élevée, bien que les champs contenant des abréviations médicales inhabituelles ou des codes propriétaires puissent nécessiter une vérification. Pour les équipes qui construisent des jeux de données cliniques à partir de captures d'écran, notre article sur l'extraction de données cliniques à partir de captures d'écran de DSE couvre le flux de travail et les étapes de validation en détail.
Là où l’extraction de captures d’écran devient délicate
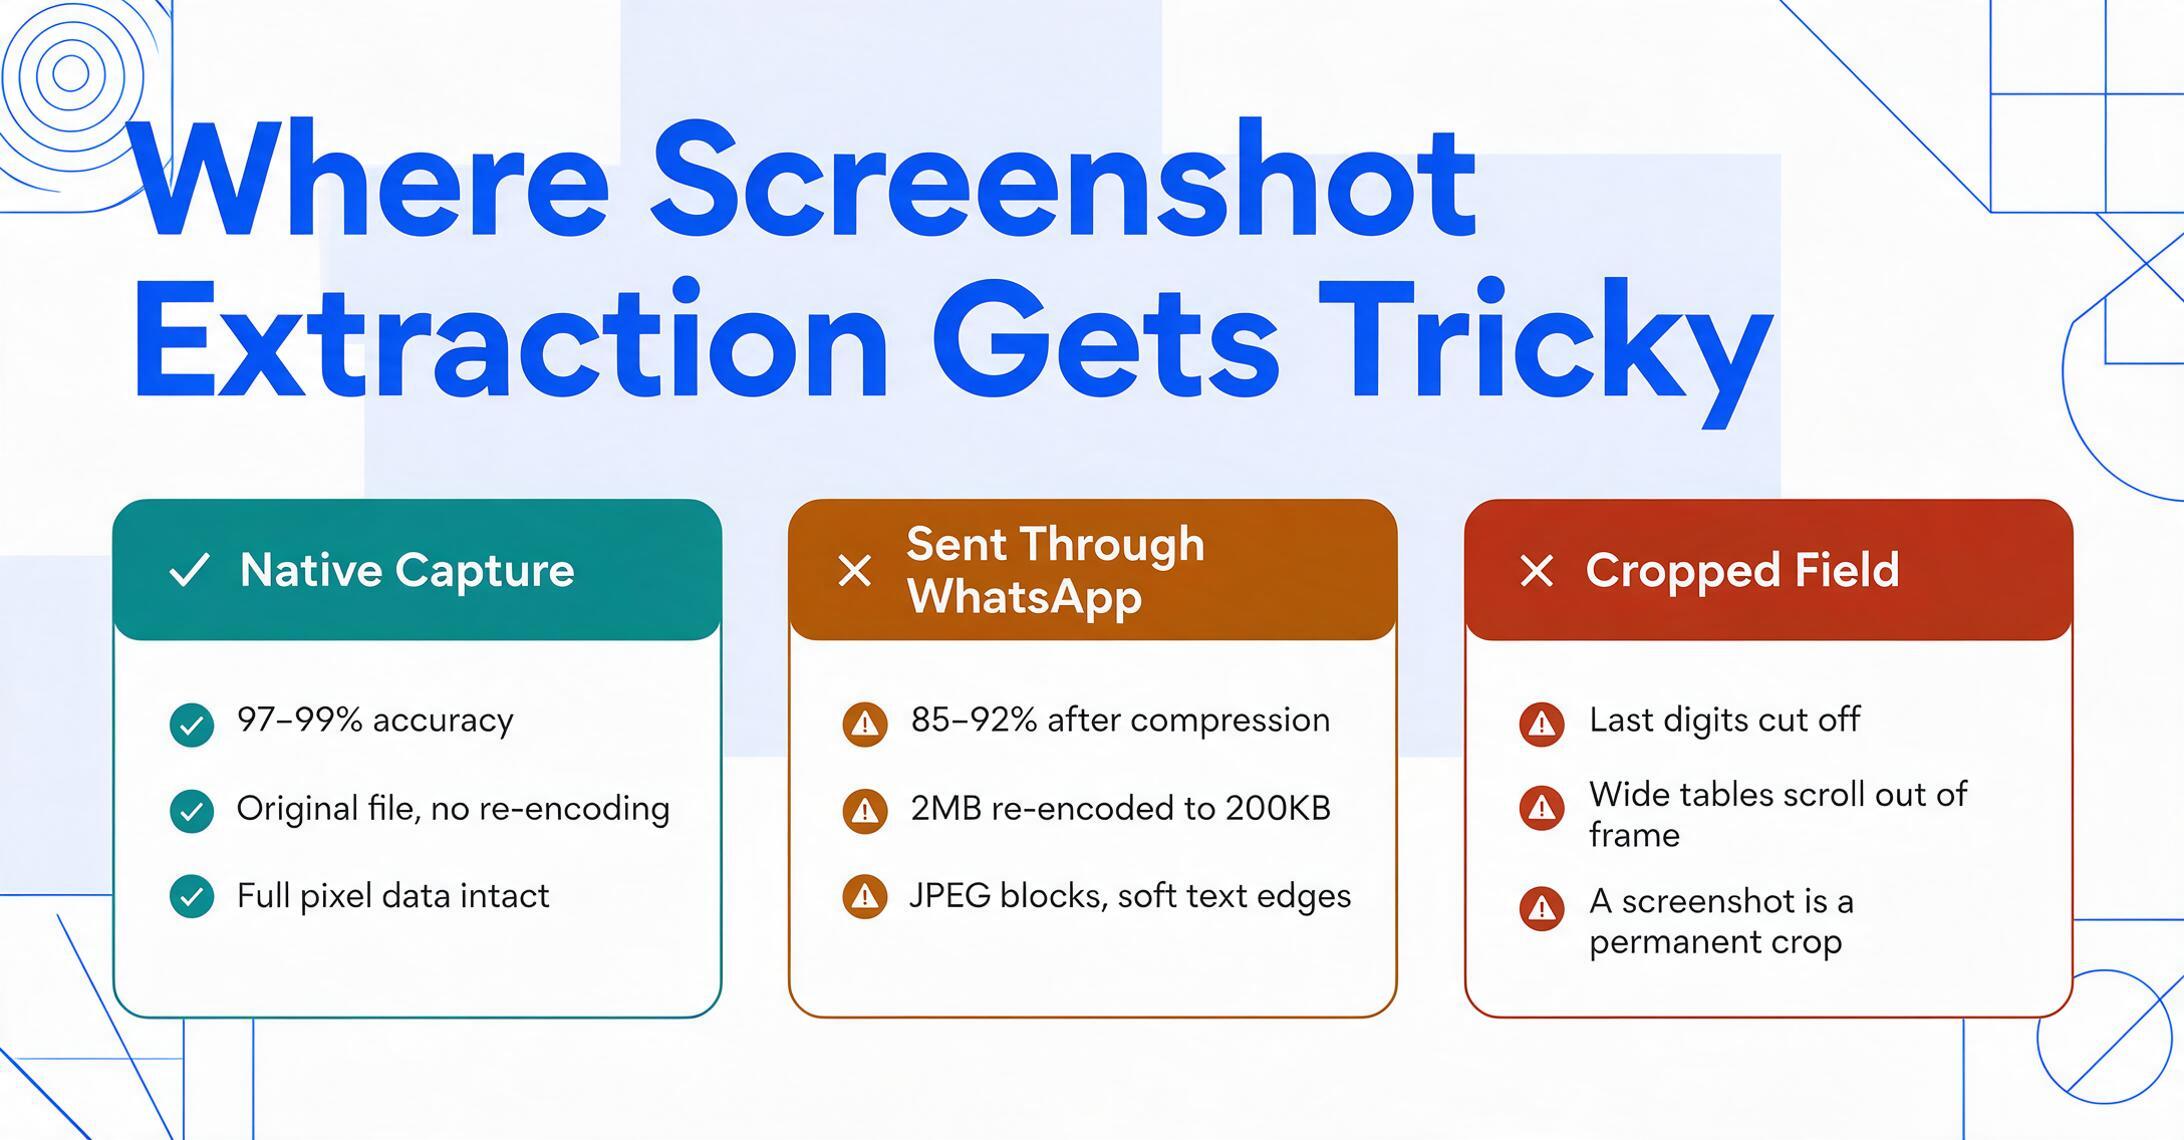
Les captures d’écran éliminent les variables physiques qui nuisent à l’OCR photo — mais elles introduisent leurs propres modes de défaillance. Savoir ce qui casse, c’est savoir comment l’éviter.
Captures d’écran fortement compressées provenant d’applications de messagerie. WhatsApp, Messenger, SMS et WeChat compressent tous les images avant l’envoi. Une capture d’écran qui semble nette sur votre téléphone à 2 Mo est réencodée en 200 Ko avant d’arriver dans la conversation du destinataire — introduisant des artefacts de bloc JPEG, des bords de texte adoucis et un dégradé de couleurs. Sur un benchmark de 50 captures de paiement partagées via WhatsApp, la précision d’extraction est tombée à 85–92 % contre 97–99 % sur les captures originales. L’IA surpasse toujours l’OCR traditionnel dans ces conditions — elle utilise le contexte pour combler les lacunes qu’un moteur de correspondance de caractères ne peut pas — mais le taux d’erreur est suffisamment élevé pour qu’une vérification devienne nécessaire. La solution : si vous recevez des captures d’écran de la part d’autres personnes, demandez-leur de les partager par e-mail ou via un stockage cloud (Google Drive, Dropbox) plutôt que par des applications de chat. Ces canaux préservent la qualité d’origine.
Champs recadrés ou incomplets. Une capture d’écran qui coupe le dernier chiffre d’un numéro de compte, ou recadre le bord droit d’un tableau, crée un problème d’information qu’aucune IA ne peut résoudre. Contrairement à une photo où la caméra peut être repositionnée, une capture d’écran est un recadrage permanent — si les données ne sont pas dans le cadre, elles sont perdues. Cela est particulièrement courant avec les longs identifiants de transaction, les numéros de compte bancaire complets et les tableaux de bord larges qui défilent horizontalement. La solution : capturez la largeur complète de la zone de données. Si le contenu défile, prenez plusieurs captures qui se chevauchent légèrement — les outils d’IA modernes gèrent mieux le contenu en double entre les captures que les données manquantes.
Interfaces en mode sombre. De nombreuses applications et systèmes d’exploitation utilisent désormais le mode sombre par défaut — texte clair sur fond sombre. Les modèles de vision IA sont principalement entraînés sur des documents à fond clair (texte noir sur papier blanc), et le mode sombre inverse cette relation de contraste. Bien que les derniers modèles gèrent raisonnablement bien le mode sombre — la précision ne chute généralement que de 2 à 4 points de pourcentage par rapport au mode clair sur le même contenu — les moteurs OCR plus anciens ou moins performants peuvent échouer complètement sur le texte inversé. Un fil Reddit de 2025 dans r/computervision a documenté un utilisateur dont le pipeline d’extraction s’est complètement cassé lorsque son entreprise a basculé les tableaux de bord en mode sombre du jour au lendemain. La solution : si votre outil d’extraction a du mal avec le mode sombre, basculez temporairement l’application en mode clair avant la capture, ou inversez les couleurs de la capture d’écran avant le traitement.
Éléments d’interface qui se chevauchent. Bannières de notification, surlignages du curseur, infobulles, menus déroulants — les captures d’écran capturent souvent des éléments d’interface transitoires superposés aux données que vous voulez réellement. Les modèles d’IA ne distinguent pas toujours entre « couche au-dessus des données » et « partie des données ». Un curseur survolant un nombre peut être mal interprété comme un point décimal. Une bannière de notification peut injecter du texte sans rapport dans vos champs extraits. La solution : fermez les notifications, éloignez le curseur des zones de données et fermez tout menu contextuel avant la capture.
Comment obtenir des extractions propres à partir de captures d'écran
Quelques secondes d'attention avant la capture permettent d'économiser des minutes de correction après l'extraction. Voici ce qui fait la différence en matière de précision d'extraction de captures d'écran.
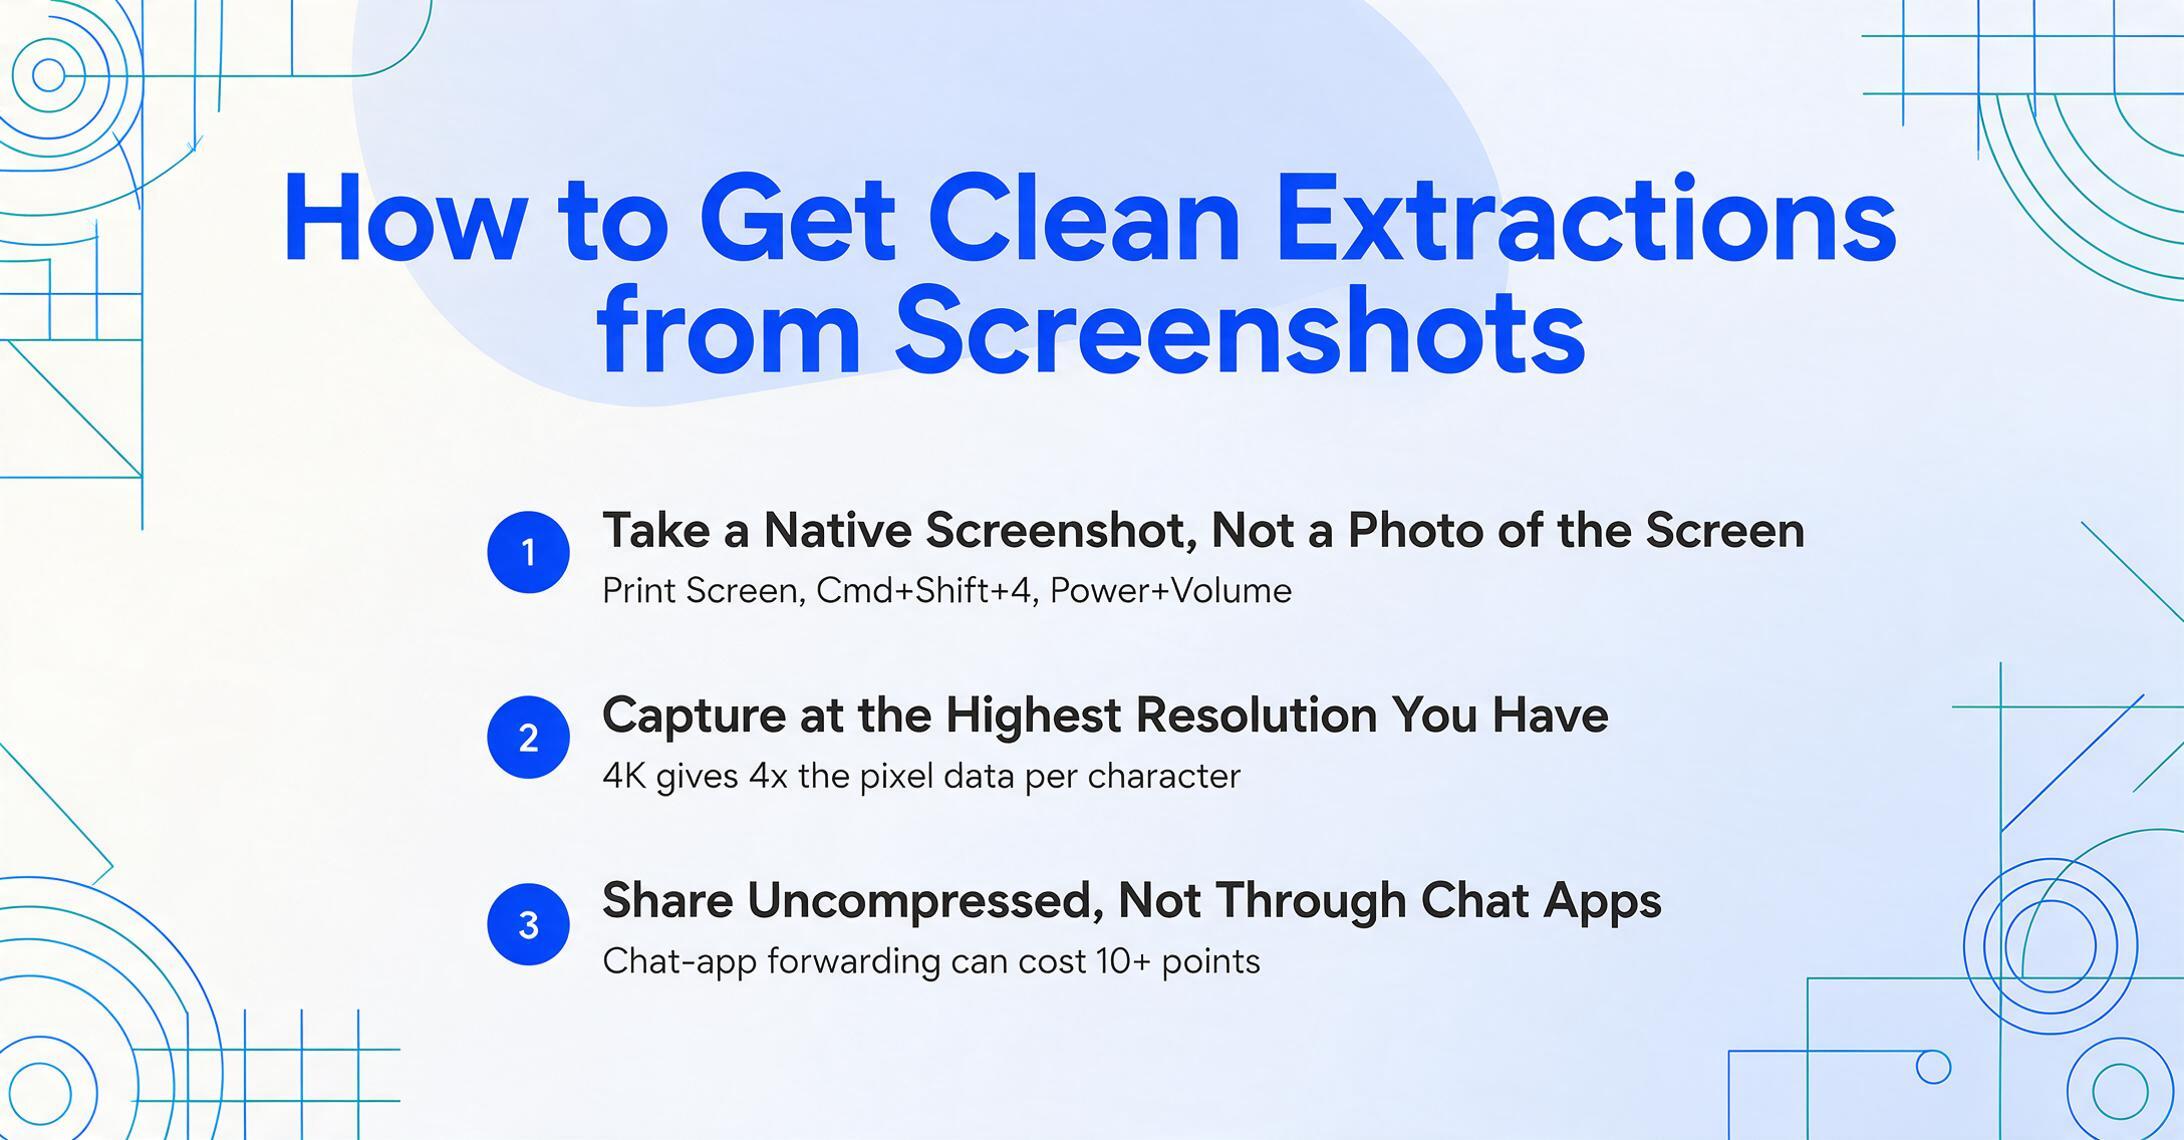
1. Prenez des captures d'écran natives, pas des photos d'écrans. C'est la règle la plus importante. Utilisez la fonction de capture d'écran intégrée de votre appareil — Impr. écran sur Windows, Cmd+Maj+4 sur Mac, Power+Volume sur les téléphones. Une capture d'écran native capture la grille de pixels exacte affichée par l'écran. Une photo d'écran prise avec un appareil photo réintroduit des motifs de moiré, des reflets et une distorsion de perspective — tous les problèmes que les captures d'écran étaient censées éliminer.
2. Capturez à la résolution la plus élevée disponible. Si votre écran est en 1080p, votre capture d'écran est en 1080p. Si votre écran est en 4K, votre capture d'écran est en 4K — et l'IA reçoit quatre fois plus de données de pixels par caractère. Les écrans haute densité (Retina, ordinateurs portables 4K, téléphones QHD+) produisent des captures d'écran avec beaucoup plus de détails par glyphe, ce qui se traduit directement par une précision d'extraction plus élevée. Si vous avez le choix de l'appareil à utiliser pour la capture, choisissez celui avec la résolution la plus élevée.
3. Partagez sans compression — utilisez l'e-mail ou le stockage cloud, pas le chat. WhatsApp, Messenger et SMS suppriment tous la qualité d'image pour économiser de la bande passante. Les pièces jointes par e-mail, les liens Google Drive et les transferts AirDrop directs préservent le fichier d'origine. La différence de précision d'extraction entre une capture d'écran originale et la même image transférée via WhatsApp peut être de plus de 10 points de pourcentage — assez pour transformer un flux de travail automatisé en un flux nécessitant une vérification manuelle.
4. Faites défiler et capturez toute la zone de données. Les longs tableaux, les formulaires multi-sections et les tableaux de bord larges ne tiennent souvent pas sur un seul écran. Si les données défilent, prenez plusieurs captures plein écran avec un léger chevauchement plutôt que d'essayer de zoomer pour tout capturer en une seule petite capture illisible. Les outils d'extraction IA qui prennent en charge le traitement par lots peuvent consolider les captures qui se chevauchent en une seule sortie — mais ils ne peuvent pas récupérer les données qui n'étaient jamais dans le cadre.
5. Désactivez le mode sombre si votre outil a du mal. C'est une solution rapide avec des résultats immédiats. Si vous obtenez une sortie brouillée à partir d'une capture en mode sombre, basculez l'application en mode clair, recapturez et retraitez. Les quelques secondes nécessaires pour changer de thème sont des ordres de grandeur plus rapides que la correction manuelle d'une page entière d'erreurs de texte inversé. À mesure que les modèles d'IA s'améliorent, la gestion du mode sombre s'améliore également, mais ce n'est pas encore universellement résolu.
Exemples réels d'extraction de captures d'écran
Voici les scénarios où l'extraction de captures d'écran remplace des heures de saisie manuelle — pas des hypothèses, mais les flux de travail réellement utilisés.
Rapprochement des captures d'écran de paiement avec un grand livre. Un gestionnaire immobilier reçoit des paiements de loyer via Venmo, Zelle, PayPal et virement bancaire. Chaque matin, 20 à 30 captures d'écran de confirmation de paiement arrivent des locataires. Chaque capture contient le même ensemble de champs — montant, date, expéditeur, note de référence — mais dans des mises en page différentes selon l'application. L'extraction par IA lit toutes ces captures avec un seul ensemble de noms de colonnes (« Montant », « Date », « Expéditeur », « Note ») et produit une feuille de calcul unique pour le rapprochement avec le registre des loyers. Pas d'inscription des locataires, pas d'intégration d'application, juste des captures d'écran vers le grand livre. Pour les équipes qui traitent des captures d'écran de paiement à grande échelle, consultez notre guide sur le rapprochement par lots des captures d'écran de paiement avec un grand livre.
Extraction des données de vente depuis les tableaux de bord d'applications. Une petite entreprise de commerce électronique vend sur Shopify, Amazon et Etsy. Chaque plateforme a son propre tableau de bord avec les revenus, les commandes et les frais — et aucune n'exporte facilement vers un format commun. Prendre des captures d'écran de tableaux de bord quotidiennes et extraire les indicateurs clés dans une feuille de calcul unifiée donne au propriétaire une source unique de vérité sans payer pour un outil d'analyse multicanal. Trois captures d'écran par jour, une extraction par lot, une feuille de calcul consolidée. Le flux de travail prend moins de deux minutes une fois configuré. Pour un guide pas à pas, voir la création d'un pipeline de données sans code à partir de captures d'écran vers Google Sheets.
Construction de jeux de données de recherche clinique à partir de captures d'écran de dossiers de santé électroniques (EHR). Une équipe de recherche menant une revue rétrospective de dossiers doit extraire les valeurs de laboratoire, les listes de médicaments et les codes de diagnostic de 500 dossiers patients dans un système EHR sans capacité d'exportation en masse. Chaque dossier nécessite 15 à 20 points de données. La transcription manuelle prendrait des semaines. L'extraction basée sur des captures d'écran — capture de chaque écran pertinent, extraction des champs cibles et compilation dans une feuille de calcul de recherche — réduit la phase de collecte de données de semaines à jours. La clé est de définir des noms de colonnes cohérents sur toutes les captures afin que les données de 500 écrans patients différents aboutissent dans le même format structuré. Pour la méthodologie complète, y compris les protocoles de validation, voir l'extraction de données cliniques à partir de captures d'écran EHR pour la recherche.
Suivi des captures d'écran de notes de frais des employés. Le personnel de terrain soumet des rapports de dépenses en prenant des captures d'écran de reçus numériques — confirmations de courses Uber, commandes de repas livrés, pages de réservation d'hôtel — et les transmet à l'équipe financière. Chaque capture contient un nom de fournisseur, un montant, une date et un contenu identifiable par catégorie. L'extraction par IA lit ces champs dans des colonnes et produit un rapport de dépenses consolidé, prêt pour approbation. L'équipe financière ne ressaisit rien. Pour un flux de travail détaillé, voir le traitement des captures d'écran de notes de frais des employés dans Excel.
Questions fréquentes
Un OCR peut-il lire du texte sur une capture d'écran ?
Oui — et l'OCR moderne basé sur l'IA lit les captures d'écran plus précisément que l'OCR traditionnel ne lit les scans papier. Une capture d'écran nette et non compressée de texte numérique atteint 95 à 99 % de précision sur les polices standard. Les moteurs OCR classiques qui nécessitent une entrée à 150+ DPI peinent avec les captures à 72–96 DPI, mais les modèles de vision par IA n'ont pas cette limitation — ils lisent les écrans comme le ferait un humain, en comprenant le contexte visuel plutôt qu'en isolant les traits de chaque caractère.
La qualité de la capture d'écran affecte-t-elle la précision de l'OCR ?
Considérablement. Une capture d'écran non compressée prise directement sur un appareil donne des résultats quasi parfaits. La même capture transmise via WhatsApp ou Messenger est recompressée, introduisant des artefacts qui peuvent faire chuter la précision de 8 à 12 points. La résolution compte aussi : une capture en 4K offre à l'IA quatre fois plus de données pixel par caractère qu'une capture en 1080p, améliorant directement la précision sur les petits textes et les tableaux denses.
L'IA peut-elle extraire des champs de données spécifiques des captures d'écran, et pas seulement transcrire tout le texte ?
Oui — c'est là que l'extraction par IA se distingue de l'OCR basique. Au lieu de déverser tout le texte d'une capture dans une transcription brute, les outils d'IA dotés de Extraction de colonnes personnalisées vous permettent de définir les champs souhaités — « Montant », « Date », « ID de transaction », « Fournisseur » — et l'IA localise et extrait uniquement ces valeurs dans des colonnes structurées. Ainsi, une capture de paiement, un tableau de bord d'application et un écran de dossier médical peuvent tous alimenter les mêmes colonnes de feuille de calcul, même s'ils sont très différents visuellement. Vous définissez la sortie ; l'IA détermine où se trouve chaque valeur sur chaque capture.
L'IA peut-elle lire les captures d'écran en mode sombre ?
Oui, avec des réserves. Les modèles de vision par IA modernes gèrent les interfaces en mode sombre avec une précision inférieure de 2 à 4 points par rapport au mode clair sur le même contenu. Les moteurs OCR plus anciens ou moins performants peuvent échouer complètement sur le texte inversé — ils sont principalement entraînés sur des documents à texte foncé sur fond clair. Si votre outil a du mal avec les captures en mode sombre, passer l'application en mode clair avant de prendre la capture est la solution la plus rapide.
L'IA peut-elle traiter par lots des captures d'écran de différentes applications dans une seule feuille de calcul ?
Oui — et c'est l'utilisation principale. L'extraction par IA repose sur la compréhension sémantique, et non sur la correspondance de modèles. Lorsque vous définissez des noms de colonnes comme « Montant », « Date » et « Expéditeur », l'IA trouve ces valeurs sur une capture d'écran de Venmo, une confirmation PayPal et un écran de transfert d'application bancaire — chacun avec une mise en page différente — et les affiche dans les mêmes colonnes structurées. Le format n'a pas besoin de correspondre car l'IA lit le sens, pas la position.
Ai-je besoin d'un scanner ou d'un matériel spécial pour obtenir de bons résultats OCR sur des captures d'écran ?
Non — c'est justement l'intérêt. Les captures d'écran ne nécessitent aucun matériel supplémentaire. La fonction de capture d'écran intégrée à tout appareil moderne (Impr. écran sous Windows, Cmd+Maj+4 sur Mac, Power+Volume sur les téléphones) produit une qualité d'entrée égale ou supérieure à celle d'un scan à plat d'un document imprimé, car aucune étape optique ne dégrade le signal. Une capture d'écran reproduit exactement la grille de pixels affichée par l'écran — sans lentille, sans bruit de capteur, sans problème de mise au point.
Quelle est la différence entre l'OCR traditionnel et l'IA pour lire des captures d'écran ?
L'OCR traditionnel segmente l'image en caractères individuels, fait correspondre chaque forme à un motif connu, puis assemble le résultat. À 72–96 DPI — la résolution typique d'une capture d'écran — les bords des caractères sont flous et la segmentation échoue. Les modèles de vision par IA fonctionnent différemment : ils traitent toute la capture d'écran d'un coup, en utilisant le contexte (texte environnant, étiquettes de champs, motifs de mise en page) pour déterminer ce que dit chaque morceau de texte. C'est pourquoi l'IA lit une capture d'écran WhatsApp compressée avec une précision de 85 % alors que Tesseract renvoie surtout du charabia. Pour une comparaison plus approfondie des deux approches, consultez notre article sur l'extraction de données par IA vs l'OCR traditionnel.
Les captures d'écran sont le format d'entrée le plus propre que les outils d'extraction par IA puissent recevoir — résolution constante, aucune distorsion de perspective, texte numérique clair et mises en page prévisibles. Les défis qui existent — compression, mode sombre, contenu recadré — sont réels mais gérables avec quelques simples habitudes de capture. Si vous photographiez encore vos écrans avec votre téléphone ou saisissez manuellement les données d'une application vers une feuille de calcul, un pipeline direct de captures d'écran vous donnera une meilleure précision avec moins d'effort. Le seul moyen de savoir à quel point cela fonctionne sur vos captures d'écran spécifiques est de l'essayer sur une vraie.
Pour une vue d'ensemble de ce que l'extraction par IA peut et ne peut pas faire, commencez par ce qu'est l'extraction de documents par IA et comment elle fonctionne. Si vous capturez déjà des écrans et souhaitez mettre en place un pipeline automatisé, consultez notre guide sur l'extraction de données de captures d'écran vers Excel. Et pour évaluer si vos captures d'écran sont assez nettes pour une extraction fiable, la comparaison dans capture d'écran vs PDF vs photo vs scan pour l'extraction vous aidera à décider.