¿Puede el OCR leer capturas de pantalla?
Sí, y son más fáciles que las fotos
Sí. El OCR impulsado por IA lee capturas de pantalla con mayor precisión que fotos o escaneos — y en muchos casos, la diferencia es significativa. Una captura limpia de una confirmación de pago o un panel de app produce una precisión cercana al 99% en texto digital impreso. ¿Ese mismo dato capturado como foto de teléfono de una pantalla? Espere entre 5 y 10 puntos porcentuales menos. La razón es simple: las capturas de pantalla no tienen distorsión de perspectiva, ni iluminación desigual, ni desenfoque por movimiento, y tienen una resolución de píxeles consistente para la que fue diseñado el texto digital. Los desafíos son diferentes — artefactos de compresión de apps de mensajería, contenido recortado e interfaces en modo oscuro — pero son más predecibles y más fáciles de resolver que la física variable de una foto de cámara.
Conclusiones clave
- Reenvíe una captura de pantalla por WhatsApp y perderá silenciosamente 10 puntos de precisión: la compresión de la app de chat destruye más datos que la mala iluminación.
- La entrada más limpia para la extracción con IA no es un escaneo de 300 DPI. Es una captura nativa de su dispositivo: cero distorsión de perspectiva, cero sombras, cero desenfoque por movimiento.
- Tres hábitos de captura solucionan casi todos los fallos de capturas de pantalla: comparta archivos sin comprimir, desplácese para capturar todo el ancho de los datos y desactive el modo oscuro antes de capturar.
Qué tan bien lee la IA las capturas de pantalla
Los números dependen de la calidad de la captura, pero en una captura limpia y sin comprimir de texto digital, los modelos modernos de visión por IA alcanzan una precisión cercana a la del escaneo de documentos impresos, sin necesidad de hardware adicional.
El OCR tradicional tiene un mínimo estricto: 150 DPI. Por debajo de eso, los bordes de los caracteres se difuminan, la segmentación falla y las tasas de error se disparan. Las capturas de pantalla suelen capturarse a la resolución de la pantalla: 72 a 96 DPI en monitores estándar, 150+ en pantallas Retina de alta densidad. Por eso las herramientas OCR antiguas tienen problemas con las capturas: fueron diseñadas para papel escaneado a 300 DPI, y una captura de 75 DPI les parece un fax de baja resolución. La comunidad de SuperUser documentó esto en un extenso hilo donde los usuarios probaron múltiples herramientas OCR en capturas y constantemente encontraban límites de precisión por debajo del umbral de DPI.
Los modelos modernos de visión por IA no tienen este piso de DPI. Procesan imágenes como un humano lee una pantalla: comprendiendo el contexto visual completo, no aislando trazos de caracteres individuales. Una captura limpia y sin comprimir tomada directamente en un portátil o teléfono moderno (1440p o superior) produce una precisión superior al 95% en texto impreso, y a menudo cerca del 99% en fuentes estándar y diseños predecibles. Las capturas de pantallas de alta densidad (Retina, 4K) rinden aún mejor porque la densidad de píxeles le da a la IA más señal por carácter. En una prueba de la comunidad SAP que comparó múltiples métodos de extracción, las aplicaciones de galería OCR estándar en Android e iOS manejaron capturas limpias con precisión razonable, mientras que la extracción basada en LLM (GPT-4 con visión) produjo transcripciones casi perfectas a partir de las mismas capturas.
La caída viene de la compresión. Una captura compartida por WhatsApp, Messenger o SMS se re-comprime, a veces agresivamente, introduciendo artefactos JPEG, bordes suavizados y profundidad de color reducida. En una captura muy comprimida, la precisión de la IA cae a aproximadamente 85–92%. Eso sigue siendo útil para muchos flujos de trabajo, pero no es automático. La regla general: una captura directa del dispositivo supera a una reenviada en 8–12 puntos porcentuales sobre el mismo contenido.
Por qué las capturas de pantalla son más fáciles para la IA que las fotos
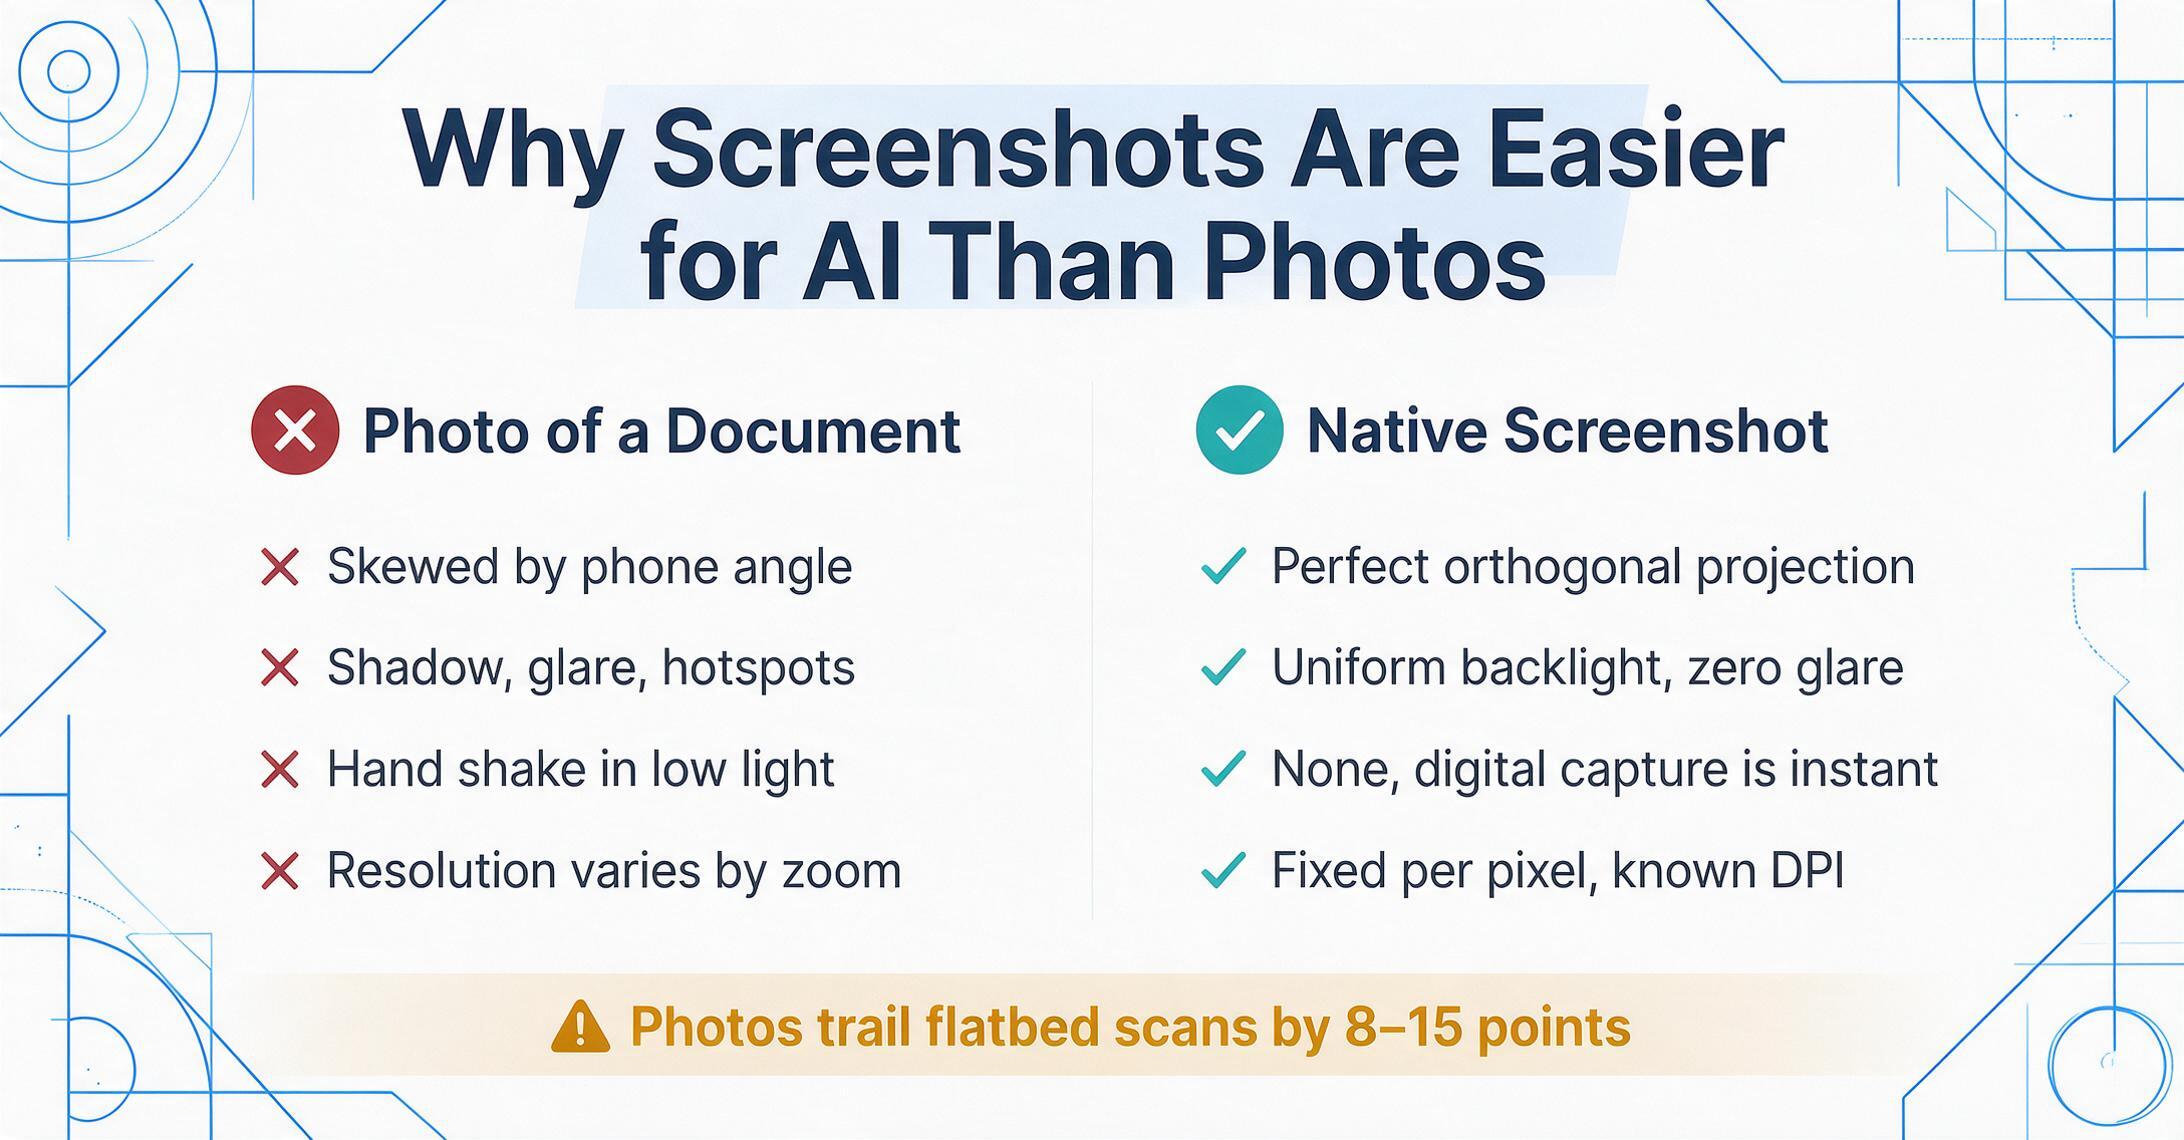
Esta es la parte que la mayoría entiende al revés. Una foto captura la realidad a través de una lente, y la realidad es ruidosa. Una captura de pantalla captura una cuadrícula de píxeles que ya fue diseñada para ser leída.
Cuando alguien toma una foto de un documento en papel, la IA tiene que resolver múltiples problemas antes siquiera de empezar a leer: corregir la inclinación de perspectiva (¿el teléfono estaba en ángulo?), compensar la iluminación desigual (¿hay una sombra en la parte inferior?), eliminar el desenfoque por movimiento, manejar el curvado del papel y lidiar con el ruido inherente del sensor de la cámara al disparar con luz imperfecta. Cada uno de estos pasos introduce errores que se acumulan a lo largo del proceso. Un análisis comparativo independiente de 2026 de codesota.com mostró que las fotos de documentos rindieron consistentemente por debajo de los escaneos planos por 8–15 puntos porcentuales en precisión a nivel de caracteres, únicamente por estas variables físicas.
Una captura de pantalla elimina todas ellas:
| Variable | Foto de documento | Captura de pantalla |
|---|---|---|
| Distorsión de perspectiva | Casi siempre presente: el ángulo del teléfono sesga el texto | Ninguna: proyección ortogonal perfecta |
| Iluminación | Sombras desiguales, reflejos, puntos calientes del flash | Retroiluminación uniforme, cero reflejos |
| Desenfoque por movimiento | Temblor de mano, especialmente con poca luz | Ninguno: la captura digital es instantánea |
| Consistencia de resolución | Varía enormemente según distancia, lente y zoom | Fija por píxel, DPI conocido |
| Renderizado de texto | La textura del papel, el sangrado de tinta y la calidad de impresión varían | Renderizado de fuentes con suavizado, grosor de trazo consistente |
| Ruido de fondo | Superficie del escritorio, dedos, sombras, textura del papel | Normalmente un fondo de interfaz de color sólido |
La tarea de la IA con una captura de pantalla es fundamentalmente más simple: está leyendo texto digital sobre un lienzo digital. Los caracteres fueron renderizados por un motor de fuentes: grosores de trazo consistentes, interletraje uniforme, formas predecibles. Los motores OCR tradicionales no aprovechan esto porque tratan cada entrada como una fotografía. Los modelos modernos de visión-lenguaje sí lo hacen: reconocen que Helvetica sobre un fondo blanco de aplicación es un tipo de entrada fundamentalmente distinto que una serif de 10 puntos sobre papel envejecido, y ajustan su estrategia de lectura en consecuencia. Este es el cambio de paradigma: pasar de tratar cada imagen como una fotografía degradada a comprender la naturaleza de la fuente.
La implicación práctica es sencilla. Si tienes la opción entre fotografiar una pantalla con tu teléfono y tomar una captura de pantalla nativa, toma la captura de pantalla. Producirá mejores resultados de extracción en todos los casos. Para una comparación más profunda de cómo los diferentes tipos de entrada afectan la precisión, consulta nuestro análisis sobre precisión de extracción de capturas de pantalla, PDF, fotos y escaneos.
Lo que la IA hace bien con las capturas de pantalla
La IA destaca en capturas de pantalla donde la información sigue patrones digitales predecibles: campos etiquetados, diseños tabulares y convenciones de interfaz consistentes. Estos patrones están en todas las aplicaciones y paneles que las personas usan a diario.
Confirmaciones de pago y pantallas de transacciones. Recibos de Venmo, confirmaciones de PayPal, pantallas de transferencias bancarias, paneles de Stripe: todos comparten una estructura común: un monto de transacción, una fecha, un remitente o destinatario y un número de referencia. Los datos son texto digital sobre un fondo limpio, a menudo con codificación de colores de alto contraste (verde para recibido, rojo para enviado). La IA lee estos campos con precisión casi perfecta porque las etiquetas son predecibles ("Monto", "Fecha", "De", "ID de transacción") y los valores mantienen relaciones visuales consistentes con sus etiquetas. Para equipos que concilian docenas de capturas de pago a diario — común en comercio electrónico, administración de propiedades y contabilidad de pequeñas empresas — la extracción por lotes convierte una tarea manual de verificación cruzada en un proceso automatizado. Consulte nuestra guía sobre extracción de datos de capturas de pago para ver un flujo de trabajo detallado.
Paneles de aplicaciones y pantallas de análisis. Paneles de ventas, paneles de Google Analytics, vistas de gestión de inventario, resúmenes de ingresos de Stripe: datos que viven en una aplicación pero no se exportan fácilmente a una hoja de cálculo. Tomar una captura de pantalla y extraer los números a Excel suele ser más rápido que buscar un botón de exportación que quizás no exista. El diseño tabular de la mayoría de los paneles — filas de métricas con encabezados etiquetados — se asigna naturalmente a columnas de hoja de cálculo. Los modelos de visión de IA reconocen estructuras de tablas en capturas de pantalla y preservan las relaciones fila-columna durante la extracción, de modo que una tabla "Ingresos por canal" en una captura de panel se convierte en una tabla estructurada "Canal | Ingresos" en su hoja de cálculo. Para procesar por lotes capturas de múltiples paneles en un solo conjunto de datos, consulte procesamiento por lotes de capturas de aplicaciones en una hoja de cálculo estructurada.
Formularios web y tablas de datos. Pantallas de ERP, vistas de contactos de CRM, páginas de seguimiento de envíos: el software empresarial está lleno de datos atrapados detrás de interfaces web. Tomar una captura de pantalla y extraer los campos evita la necesidad de acceso a API, permisos de exportación o participación de TI. El renderizado de texto digital en aplicaciones web es nítido y estandarizado, y la IA lo lee con una precisión del 95–99% en capturas sin comprimir. Para ver un ejemplo práctico de cómo funciona esto de principio a fin, consulte cómo obtener datos de capturas de pantalla a Excel sin escribir.
Datos clínicos de pantallas de EHR. Los sistemas de historiales clínicos electrónicos son conocidos por sus limitadas capacidades de exportación. Los investigadores y gestores de datos clínicos a menudo recurren a transcribir manualmente resultados de laboratorio, listas de medicamentos y datos demográficos de pacientes desde pantallas de EHR a conjuntos de datos de investigación. La extracción basada en capturas de pantalla ofrece una solución alternativa: capturar la pantalla, extraer los datos estructurados y compilarlos en una hoja de cálculo, sin necesidad de API del proveedor de EHR. La precisión en capturas de EHR limpias con fuentes estándar es alta, aunque los campos con abreviaturas médicas inusuales o códigos propietarios pueden requerir verificación. Para equipos que crean conjuntos de datos clínicos a partir de capturas de pantalla, nuestro artículo sobre extracción de datos clínicos de capturas de EHR cubre el flujo de trabajo y los pasos de validación en detalle.
Dónde la extracción de capturas de pantalla se complica
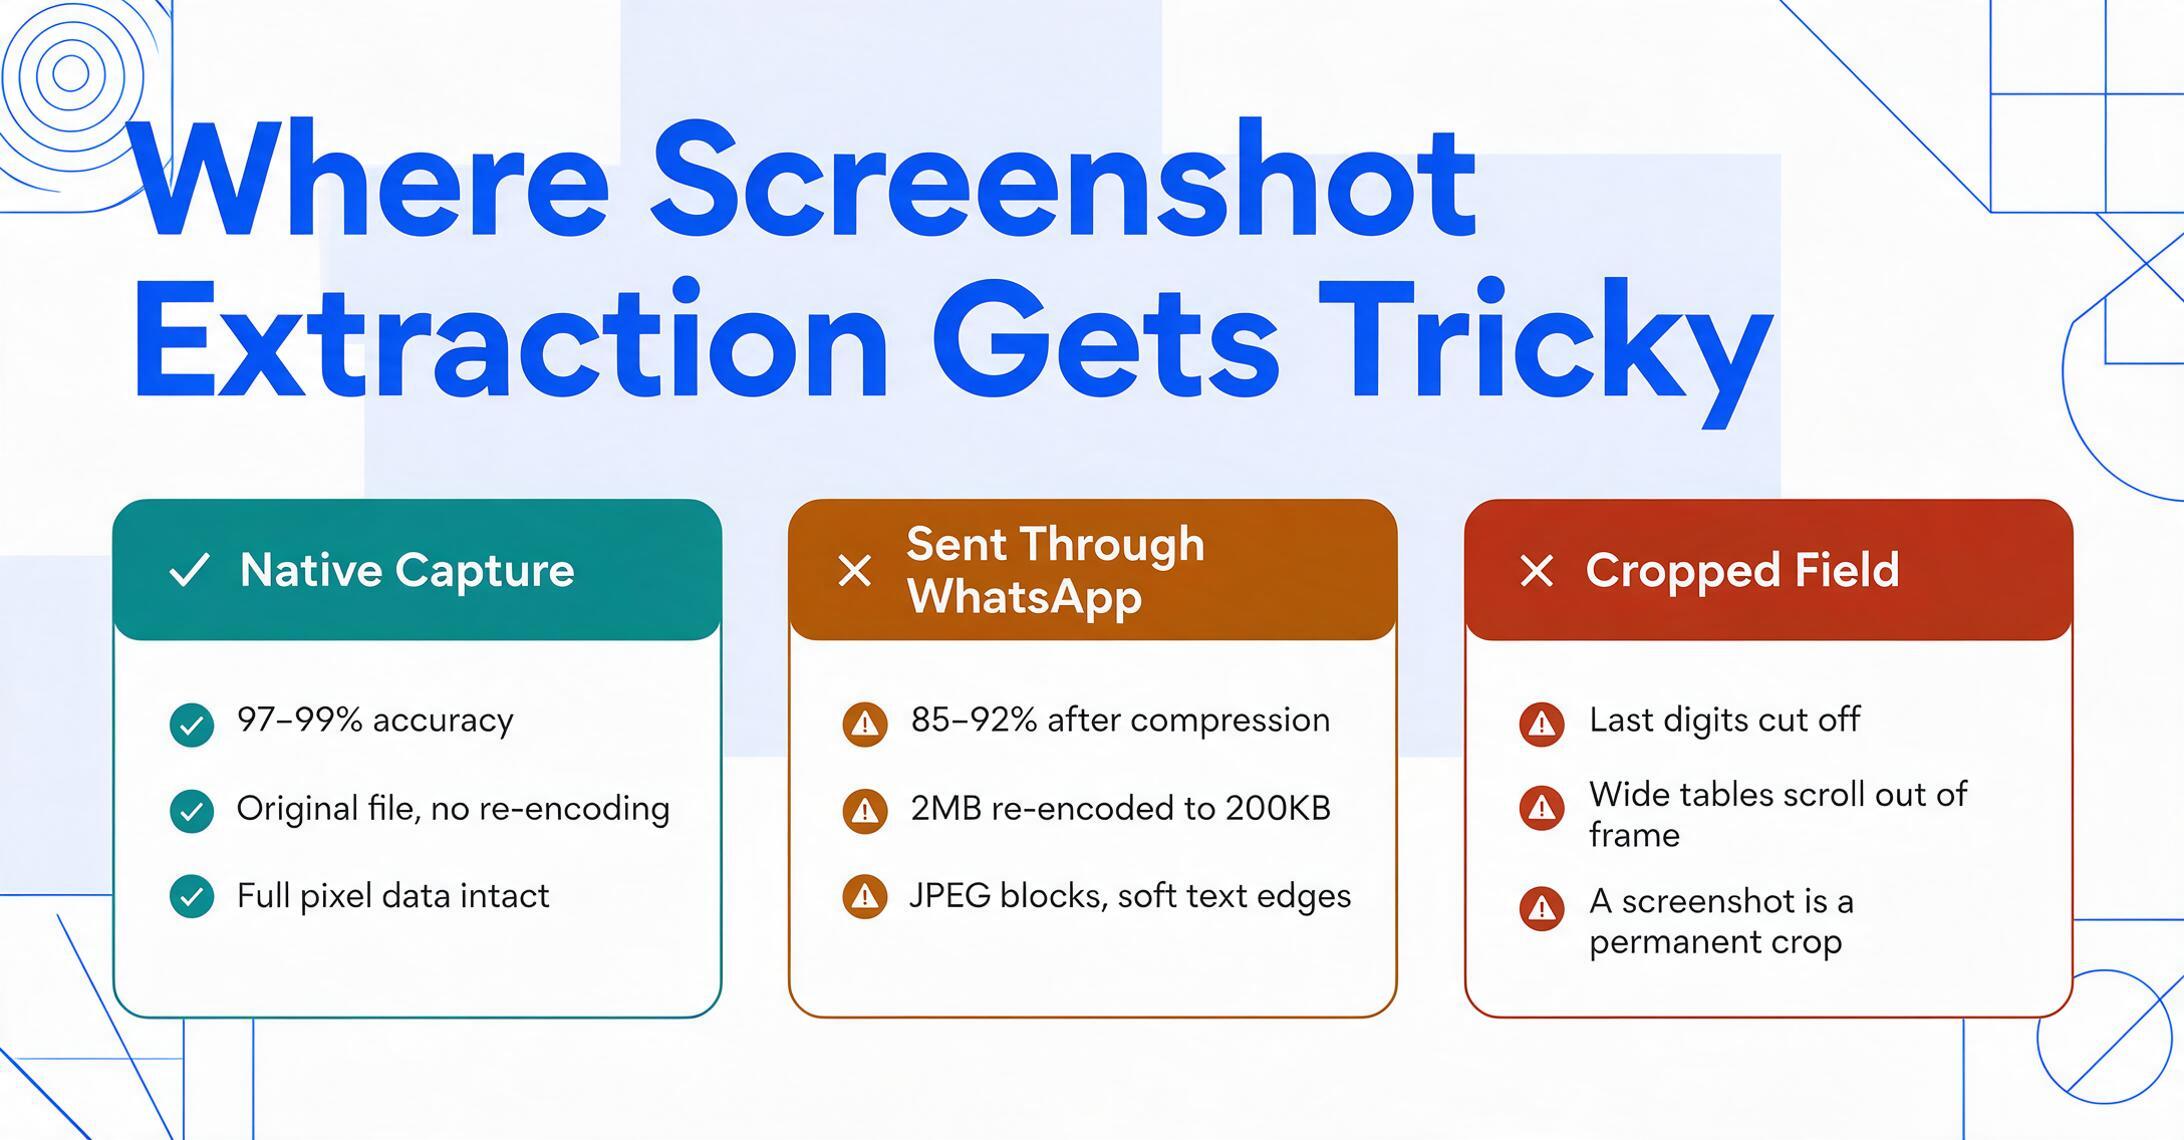
Las capturas de pantalla eliminan las variables físicas que afectan al OCR de fotos, pero introducen sus propios modos de fallo. Saber qué falla es cómo lo evitas.
Capturas muy comprimidas de aplicaciones de mensajería. WhatsApp, Messenger, SMS y WeChat comprimen las imágenes antes de enviarlas. Una captura que se ve nítida en tu teléfono con 2MB se recodifica a 200KB antes de llegar al chat del destinatario, introduciendo artefactos de bloque JPEG, bordes de texto suavizados y bandas de color. En una prueba de 50 capturas de pagos compartidas por WhatsApp, la precisión de extracción cayó al 85–92% en comparación con el 97–99% de las capturas originales. La IA sigue superando al OCR tradicional en estas condiciones — usa el contexto para llenar vacíos que un motor de coincidencia de caracteres no puede — pero la tasa de error es lo suficientemente alta como para que la verificación sea necesaria. La solución: si recibes capturas de otros, pídeles que las compartan por correo electrónico o almacenamiento en la nube (Google Drive, Dropbox) en lugar de aplicaciones de chat. Estos canales preservan la calidad original.
Campos recortados o incompletos. Una captura que corta el último dígito de un número de cuenta, o recorta el borde derecho de una tabla, crea un problema de información que ninguna IA puede resolver. A diferencia de una foto donde la cámara puede reposicionarse, una captura es un recorte permanente — si los datos no están en el encuadre, se pierden. Esto es especialmente común con ID de transacción largos, números de cuenta bancaria completos y tablas de panel amplias que se desplazan horizontalmente. La solución: captura el ancho completo del área de datos. Si el contenido se desplaza, toma varias capturas que se superpongan ligeramente — las herramientas modernas de IA manejan mejor el contenido duplicado entre capturas que los datos faltantes.
Interfaces de modo oscuro. Muchas aplicaciones y sistemas operativos ahora usan modo oscuro por defecto — texto claro sobre fondo oscuro. Los modelos de visión de IA están entrenados predominantemente con documentos de fondo claro (texto negro sobre papel blanco), y el modo oscuro invierte esta relación de contraste. Aunque los modelos más recientes manejan el modo oscuro razonablemente bien — la precisión suele caer solo 2–4 puntos porcentuales en comparación con el modo claro en el mismo contenido — los motores OCR más antiguos o menos capaces pueden fallar por completo con texto invertido. Un hilo de Reddit de 2025 en r/computervision documentó a un usuario cuya canalización de extracción se rompió por completo cuando su empresa cambió los paneles a modo oscuro de la noche a la mañana. La solución: si tu herramienta de extracción tiene problemas con el modo oscuro, cambia temporalmente la aplicación al modo claro antes de capturar, o invierte los colores de la captura antes de procesarla.
Elementos de interfaz superpuestos. Banners de notificación, resaltados del cursor, información sobre herramientas, menús desplegables — las capturas suelen capturar elementos de interfaz transitorios superpuestos sobre los datos que realmente quieres. Los modelos de IA no siempre distinguen entre "capa sobre los datos" y "parte de los datos". Un cursor sobre un número puede leerse mal como un punto decimal. Un banner de notificación puede inyectar texto no relacionado en tus campos extraídos. La solución: descarta las notificaciones, aleja el cursor de las áreas de datos y cierra cualquier menú emergente antes de capturar.
Cómo Obtener Extracciones Limpias de Capturas de Pantalla
Unos segundos de atención antes de capturar ahorran minutos de corrección después de la extracción. Esto es lo que marca la diferencia en la precisión de la extracción de capturas de pantalla.
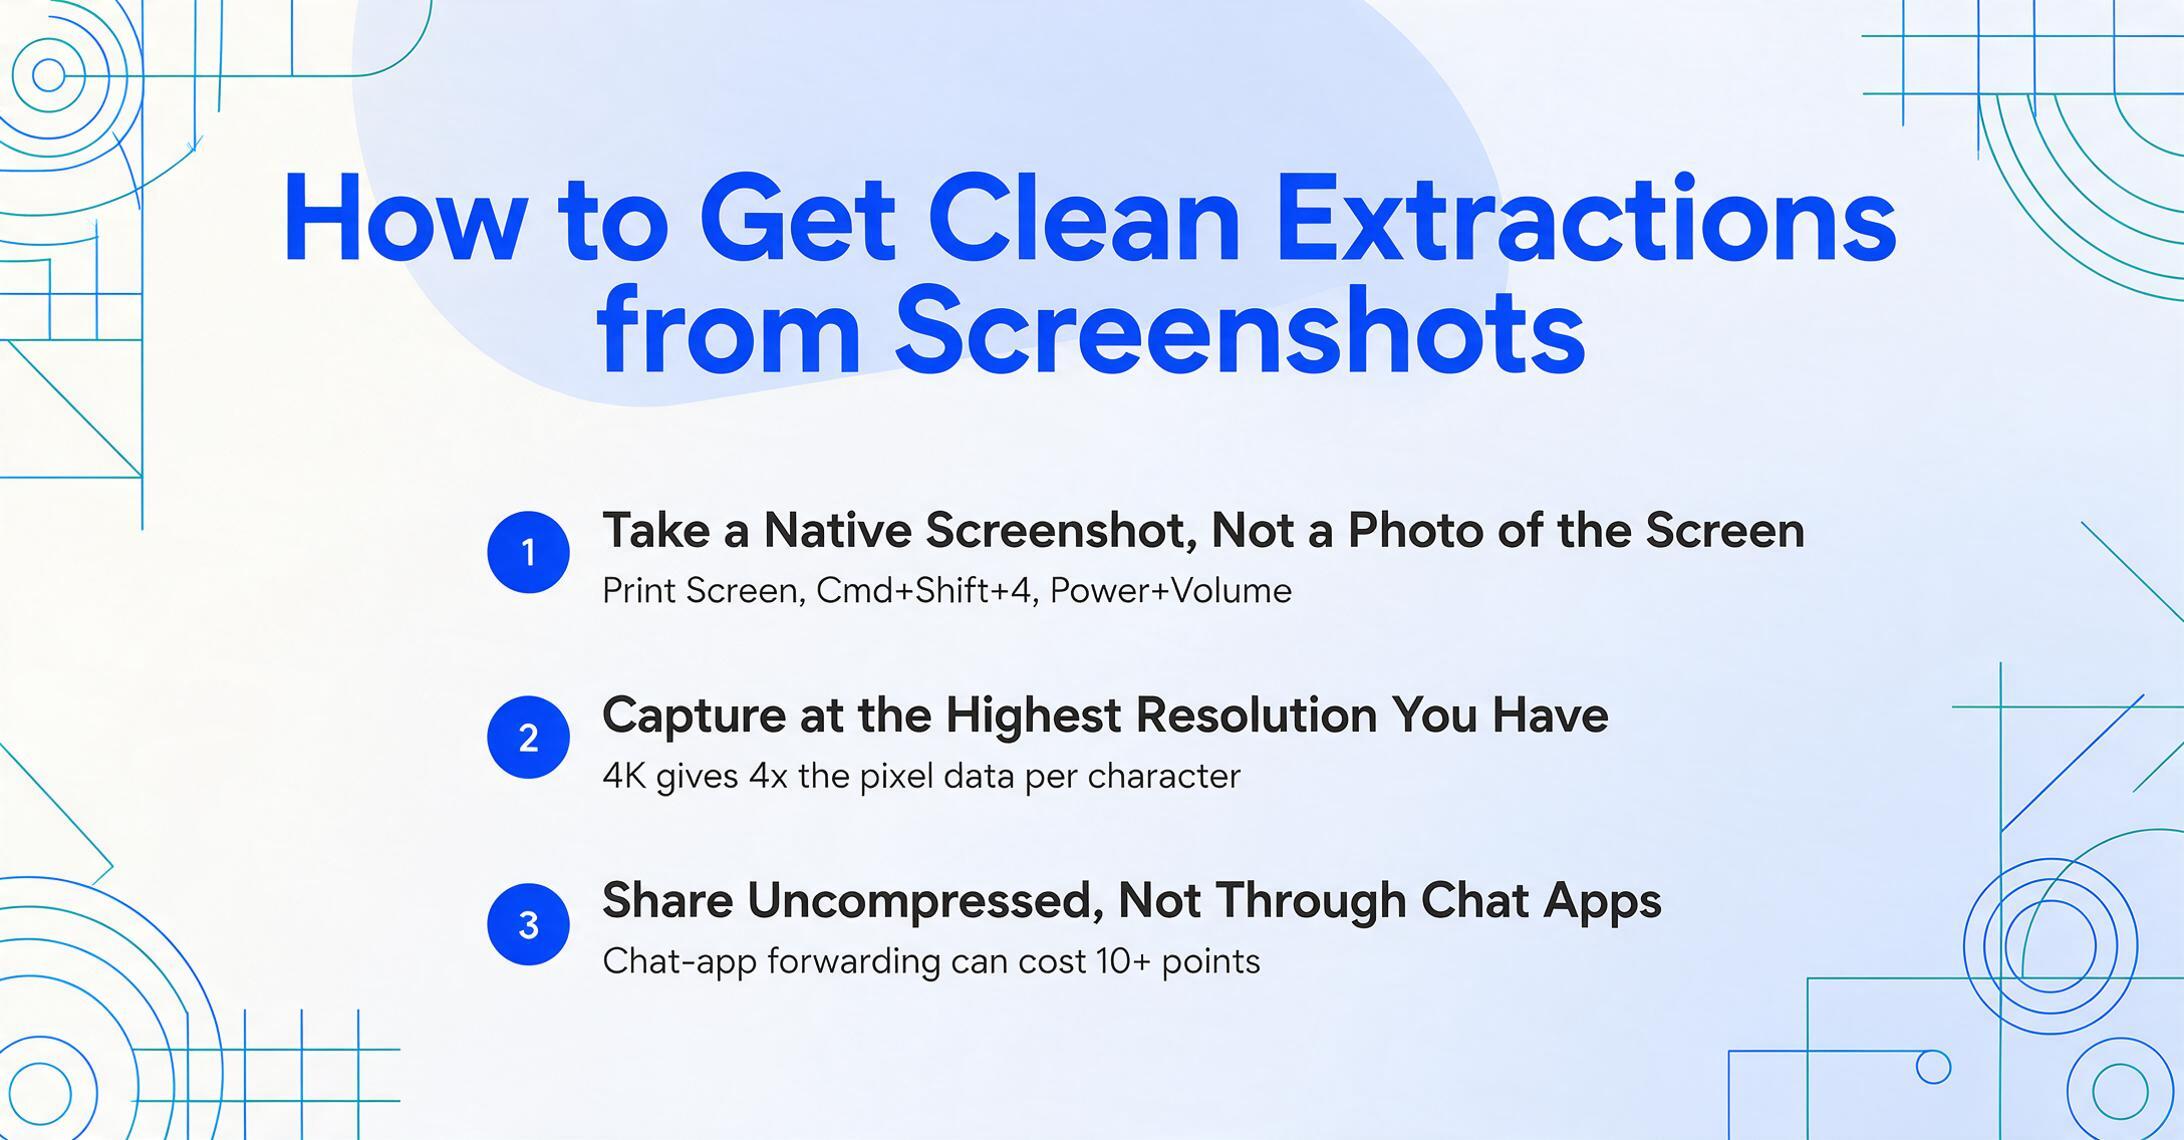
1. Tome capturas de pantalla nativas, no fotos de pantallas. Esta es la regla de mayor impacto. Use la función de captura integrada de su dispositivo: Imprimir Pantalla en Windows, Cmd+Shift+4 en Mac, Power+Volume en teléfonos. Una captura nativa captura la cuadrícula de píxeles exacta que mostró la pantalla. Una foto de una pantalla, tomada con una cámara, reintroduce patrones de moiré, reflejos y distorsión de perspectiva: todos los problemas que las capturas debían eliminar.
2. Capture a la resolución más alta disponible. Si su pantalla es 1080p, su captura es 1080p. Si su pantalla es 4K, su captura es 4K, y la IA obtiene cuatro veces más datos de píxeles por carácter. Las pantallas de alta densidad de píxeles (Retina, portátiles 4K, teléfonos QHD+) producen capturas con significativamente más detalle por glifo, lo que se traduce directamente en una mayor precisión de extracción. Si tiene la opción de elegir desde qué dispositivo capturar, use el de mayor resolución disponible.
3. Comparta sin comprimir: use correo electrónico o almacenamiento en la nube, no chat. WhatsApp, Messenger y SMS reducen la calidad de imagen para ahorrar ancho de banda. Los archivos adjuntos de correo, los enlaces de Google Drive y las transferencias directas por AirDrop conservan el archivo original. La diferencia en la precisión de extracción entre una captura original y la misma imagen reenviada por WhatsApp puede ser de más de 10 puntos porcentuales: suficiente para convertir un flujo de trabajo automatizado en uno que requiere revisión manual.
4. Desplácese y capture toda el área de datos. Las tablas largas, los formularios de varias secciones y los paneles amplios a menudo no caben en una sola pantalla. Si los datos se desplazan, tome múltiples capturas de pantalla completa con una ligera superposición en lugar de intentar alejar el zoom y capturar todo en una captura diminuta e ilegible. Las herramientas de extracción con IA que admiten procesamiento por lotes pueden consolidar capturas superpuestas en una sola salida, pero no pueden recuperar datos que nunca estuvieron en el encuadre.
5. Desactive el modo oscuro si su herramienta tiene dificultades. Esta es una solución rápida con resultados inmediatos. Si obtiene resultados confusos de una captura en modo oscuro, cambie la aplicación al modo claro, vuelva a capturar y reprocese. Los pocos segundos que toma cambiar de tema son órdenes de magnitud más rápidos que corregir manualmente una página completa de errores de texto invertido. A medida que los modelos de IA mejoran, el manejo del modo oscuro está mejorando, pero aún no está resuelto universalmente.
Ejemplos Reales de Extracción de Capturas de Pantalla
Estos son los escenarios donde la extracción de capturas de pantalla reemplaza horas de ingreso manual de datos — no son hipótesis, sino los flujos de trabajo que la gente realmente ejecuta.
Conciliando capturas de pantalla de pagos con un libro mayor. Un administrador de propiedades recibe pagos de alquiler a través de Venmo, Zelle, PayPal y transferencias bancarias. Cada mañana, llegan de 20 a 30 capturas de pantalla de confirmación de pago de los inquilinos. Cada captura contiene el mismo conjunto de campos — monto, fecha, remitente, nota de referencia — pero en diferentes diseños según la aplicación. La extracción con IA lee todas con un solo conjunto de nombres de columnas ("Monto", "Fecha", "Remitente", "Nota") y genera una sola hoja de cálculo para la conciliación con el registro de alquileres. Sin registro de inquilinos, sin integración de aplicaciones, solo capturas de pantalla al libro mayor. Para equipos que procesan capturas de pantalla de pagos a gran escala, consulte nuestra guía sobre conciliación de capturas de pantalla de pagos por lotes con el libro mayor.
Extrayendo datos de ventas de paneles de aplicaciones. Un pequeño negocio de comercio electrónico vende en Shopify, Amazon y Etsy. Cada plataforma tiene su propio panel con ingresos, pedidos y tarifas — y ninguna exporta fácilmente a un formato común. Tomar capturas de pantalla de paneles diarias y extraer las métricas clave a una hoja de cálculo unificada le da al propietario una única fuente de verdad sin pagar por una herramienta de análisis multicanal. Tres capturas por día, una extracción por lotes, una hoja de cálculo consolidada. El flujo de trabajo toma menos de dos minutos una vez configurado. Para un tutorial paso a paso, consulte cómo crear un pipeline de datos sin código desde capturas de pantalla a Google Sheets.
Construyendo conjuntos de datos de investigación clínica a partir de pantallas de EHR. Un equipo de investigación que realiza una revisión retrospectiva de historiales clínicos necesita extraer valores de laboratorio, listas de medicamentos y códigos de diagnóstico de 500 registros de pacientes en un sistema EHR sin capacidad de exportación masiva. Cada registro requiere de 15 a 20 puntos de datos. La transcripción manual tomaría semanas. La extracción basada en capturas de pantalla — capturando cada pantalla relevante, extrayendo los campos objetivo y compilándolos en una hoja de cálculo de investigación — reduce la fase de recopilación de datos de semanas a días. La clave es definir nombres de columnas consistentes en todas las capturas para que los datos de 500 pantallas de pacientes diferentes lleguen al mismo formato estructurado. Para la metodología completa, incluidos los protocolos de validación, consulte extracción de datos clínicos de capturas de pantalla de EHR para investigación.
Rastreando capturas de pantalla de gastos de empleados. El personal de campo presenta informes de gastos tomando capturas de pantalla de recibos digitales — confirmaciones de viajes en Uber, pedidos de entrega de comida, páginas de reservas de hotel — y las reenvían al equipo de finanzas. Cada captura contiene nombre del proveedor, monto, fecha y contenido identificable por categoría. La extracción con IA lee estos campos en columnas y genera un informe de gastos consolidado, listo para aprobación. El equipo de finanzas no vuelve a escribir nada. Para un flujo de trabajo detallado, consulte procesamiento de capturas de pantalla de gastos de empleados en Excel.
Preguntas Frecuentes
¿Puede el OCR leer texto de una captura de pantalla?
Sí, y el OCR moderno con IA lee capturas de pantalla con mayor precisión que el OCR tradicional al escanear papel. Una captura limpia y sin comprimir de texto digital alcanza un 95–99% de precisión en fuentes estándar. Los motores OCR tradicionales que requieren 150+ DPI tienen problemas con capturas de 72–96 DPI, pero los modelos de visión por IA no tienen esta limitación: leen pantallas como los humanos, entendiendo el contexto visual en lugar de aislar trazos de caracteres individuales.
¿La calidad de la captura afecta la precisión del OCR?
Significativamente. Una captura sin comprimir tomada directamente en un dispositivo produce resultados casi perfectos. La misma captura reenviada por WhatsApp o Messenger se re-comprime, introduciendo artefactos que pueden reducir la precisión entre 8 y 12 puntos porcentuales. La resolución también importa: una captura en 4K le da a la IA cuatro veces más datos de píxeles por carácter en comparación con una captura en 1080p, mejorando directamente la precisión en texto pequeño y tablas densas.
¿Puede la IA extraer campos de datos específicos de capturas, no solo transcribir todo el texto?
Sí — aquí es donde la extracción con IA se diferencia del OCR básico. En lugar de volcar todo el texto de una captura en una transcripción sin procesar, las herramientas de IA con Extracción de Columnas Personalizadas te permiten definir los campos que deseas — "Monto", "Fecha", "ID de Transacción", "Proveedor" — y la IA localiza y extrae solo esos valores en columnas estructuradas. Esto significa que una captura de pago, un panel de aplicación y una pantalla de EHR pueden alimentar las mismas columnas de hoja de cálculo, aunque tengan un aspecto completamente diferente. Tú defines la salida; la IA descubre dónde vive cada valor en cada captura.
¿Puede la IA leer capturas de pantalla en modo oscuro?
Sí, con matices. Los modelos modernos de visión por IA manejan interfaces en modo oscuro con una precisión 2–4 puntos porcentuales menor que en modo claro para el mismo contenido. Los motores OCR más antiguos o menos capaces pueden fallar por completo con texto invertido — están entrenados predominantemente en documentos con texto oscuro sobre fondo claro. Si tu herramienta tiene problemas con capturas en modo oscuro, cambiar la aplicación a modo claro antes de tomar la captura es la solución más rápida.
¿Puede la IA procesar por lotes capturas de pantalla de diferentes aplicaciones en una sola hoja de cálculo?
Sí, y este es el caso de uso principal. La extracción con IA funciona mediante comprensión semántica, no mediante coincidencia de plantillas. Cuando defines nombres de columnas como "Monto", "Fecha" y "Remitente", la IA encuentra esos valores en una captura de Venmo, una confirmación de PayPal y una pantalla de transferencia de la app del banco — cada una con un diseño diferente — y los coloca en las mismas columnas estructuradas. El formato no necesita coincidir porque la IA lee el significado, no la posición.
¿Necesito un escáner o hardware especial para obtener buenos resultados de OCR en capturas de pantalla?
No, ese es el punto. Las capturas de pantalla no requieren hardware adicional. La función de captura integrada en cualquier dispositivo moderno (Imprimir pantalla en Windows, Cmd+Shift+4 en Mac, Power+Volumen en teléfonos) produce una calidad de entrada que iguala o supera un escaneo plano de un documento impreso, porque no hay paso óptico que degrade la señal. Una captura de pantalla captura la cuadrícula de píxeles exacta que mostró la pantalla — sin lente, sin ruido de sensor, sin problemas de enfoque.
¿Cuál es la diferencia entre el OCR tradicional y la IA para leer capturas de pantalla?
El OCR tradicional funciona segmentando una imagen en caracteres individuales, comparando cada forma con un patrón conocido y ensamblando el resultado. A 72–96 DPI — la resolución típica de una captura de pantalla — los bordes de los caracteres se difuminan y la segmentación falla. Los modelos de visión con IA funcionan de manera diferente: procesan toda la captura a la vez, usando el contexto (texto circundante, etiquetas de campo, patrones de diseño) para resolver qué dice cada fragmento de texto. Por eso la IA lee una captura de WhatsApp comprimida con un 85% de precisión mientras que Tesseract devuelve en su mayoría texto sin sentido. Para una comparación más profunda de los dos enfoques, consulta nuestro artículo sobre extracción de datos con IA vs OCR tradicional.
Las capturas de pantalla son el formato de entrada más limpio que pueden recibir las herramientas de extracción con IA: resolución constante, sin distorsión de perspectiva, texto digital claro y diseños predecibles. Los desafíos que existen — compresión, modo oscuro, contenido recortado — son reales pero manejables con algunos hábitos simples de captura. Si todavía estás fotografiando pantallas con tu teléfono o escribiendo datos manualmente de una aplicación a una hoja de cálculo, un flujo directo de capturas de pantalla te dará mejor precisión con menos esfuerzo. La única forma de saber qué tan bien funciona con tus capturas específicas es probarlo con una real.
Para una visión más amplia de lo que la extracción con IA puede y no puede hacer, comienza con qué es la extracción de documentos con IA y cómo funciona. Si ya estás capturando pantallas y quieres configurar un flujo automatizado, consulta nuestra guía sobre extracción de datos de capturas de pantalla a Excel. Y si estás evaluando si tus capturas son lo suficientemente claras para una extracción confiable, la comparación en extracción de captura vs PDF vs foto vs escaneo te ayudará a decidir.