Comment vérifier une extraction par lots de 500 documents
Sans vérifier chaque ligne
Vous venez de traiter 500 factures avec un outil d'extraction IA. Le résultat semble propre — un tableau Excel avec chaque ligne remplie, des totaux qui paraissent raisonnables. Mais une pensée s'installe : et si quelque chose était discrètement faux ? Un montant mal lu à la ligne 147. Un article manquant à la ligne 323. Un format de date qui a inversé le mois et le jour quelque part au milieu. Vous ne pouvez pas tout vérifier. Mais vous ne pouvez pas non plus faire aveuglément confiance. Cet article vous propose une voie intermédiaire — trois méthodes d'échantillonnage éprouvées adaptées du contrôle qualité industriel, plus une liste de contrôle pratique qui prend 30 minutes, pas 30 heures.
Points clés à retenir
- 20 heures pour vérifier manuellement 500 documents — et après le document 200, votre taux de détection d'erreurs chute suffisamment pour que les 300 vérifications restantes vous achètent une fausse confiance, pas de la sécurité.
- Les taux d'erreur de comparaison visuelle humaine atteignent 3 à 5 pour cent dans des conditions idéales et se dégradent avec la fatigue — c'est pourquoi les auditeurs professionnels utilisent l'échantillonnage statistique, et non une revue à 100 pour cent, comme méthodologie standard.
- Les tables d'échantillonnage ISO 2859-1 — la même norme que les usines utilisent pour inspecter 50 unités sur 10000 — vous permettent d'inspecter 50 documents en 30 minutes et de prendre une décision de réussite ou d'échec statistiquement défendable avec une piste d'audit.
Pourquoi la vérification est un problème en soi
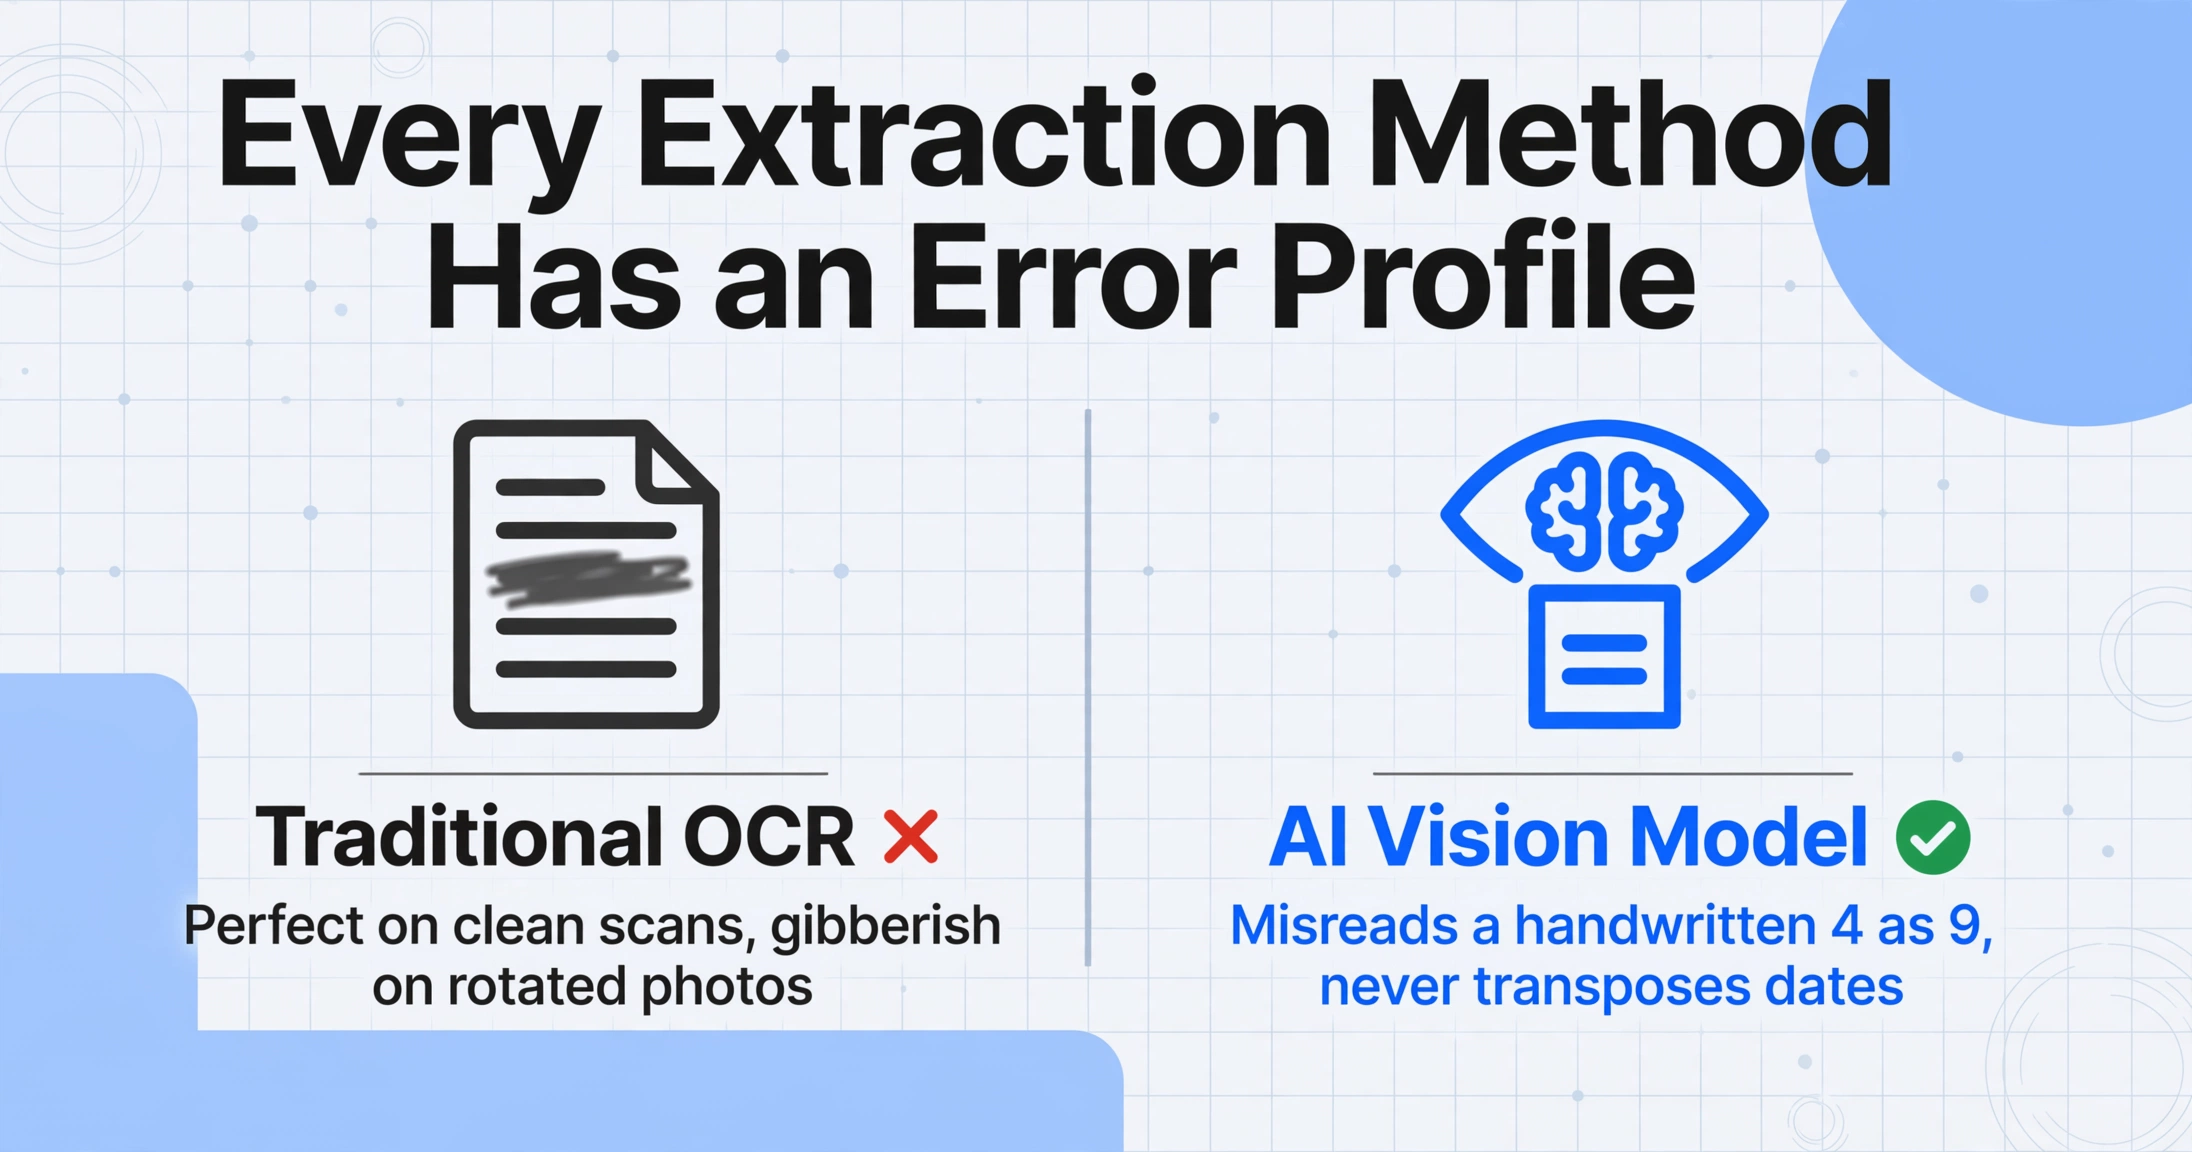
Le secret peu reluisant de l'extraction de documents — qu'il s'agisse d'OCR par modèle, de modèles de vision IA ou de saisie manuelle à l'ancienne — est que aucune méthode n'est précise à 100 %. Ni l'IA. Ni les employés de saisie de données. Ni une intégration ERP haut de gamme. La différence entre les outils réside dans le profil d'erreur : le type d'erreurs commises, leur fréquence et les champs concernés.
Un modèle de vision IA comme ImageToTable.ai peut mal lire un « 4 » manuscrit comme un « 9 » sur un bon de livraison — mais il ne transposera jamais vos dates de facture et vos numéros de commande comme pourrait le faire un humain fatigué. L'OCR traditionnel peut saisir parfaitement chaque caractère d'un PDF scanné impeccable, puis produire du charabia sur une photo de reçu légèrement pivotée. Chaque outil a des schémas que vous pouvez apprendre.
Mais voici la vérité inconfortable : vous ne pouvez pas savoir si une extraction spécifique est correcte sans consulter le document source. Aucun score de confiance, aucune mesure de précision, aucune garantie du fournisseur ne vous dit si le total de cette facture est juste. La question n'est pas « puis-je faire confiance à l'outil ? » — c'est « combien dois-je vérifier, et comment vérifier efficacement ? »
C'est là qu'intervient la méthodologie de contrôle qualité, qui emprunte à une discipline que la plupart des employés de bureau ne touchent jamais : l'échantillonnage d'acceptation statistique. La même logique qui permet à une usine d'inspecter 50 unités sur un lot de 10 000 et de décider si tout le lot est conforme est celle dont vous avez besoin pour vos résultats d'extraction.
Méthode 1 — Échantillonnage statistique (AQL)
L'AQL (Acceptable Quality Limit) est une norme ISO 2859-1 utilisée depuis des décennies dans le secteur manufacturier pour répondre exactement à cette question : « J'ai un lot important. Je ne peux pas tout inspecter. Combien dois-je inspecter, et comment décider si le lot est suffisamment bon ? »
La logique s'applique directement à la vérification de l'extraction de documents. Vous traitez chaque document de votre lot comme une « unité », vous définissez ce qui constitue un « défaut » (une valeur de champ erronée, un article manquant, un montant mal lu), et vous appliquez un plan d'échantillonnage.
Comment appliquer l'AQL à la vérification de l'extraction
| Taille du lot (documents) | Taille de l'échantillon à inspecter | AQL 2,5 % — Accepter | AQL 2,5 % — Rejeter |
|---|---|---|---|
| 50 | 13 | ≤1 erreur | ≥2 erreurs |
| 200 | 32 | ≤2 erreurs | ≥3 erreurs |
| 500 | 50 | ≤2 erreurs | ≥3 erreurs |
| 1 000 | 80 | ≤5 erreurs | ≥6 erreurs |
| 5 000 | 200 | ≤10 erreurs | ≥11 erreurs |
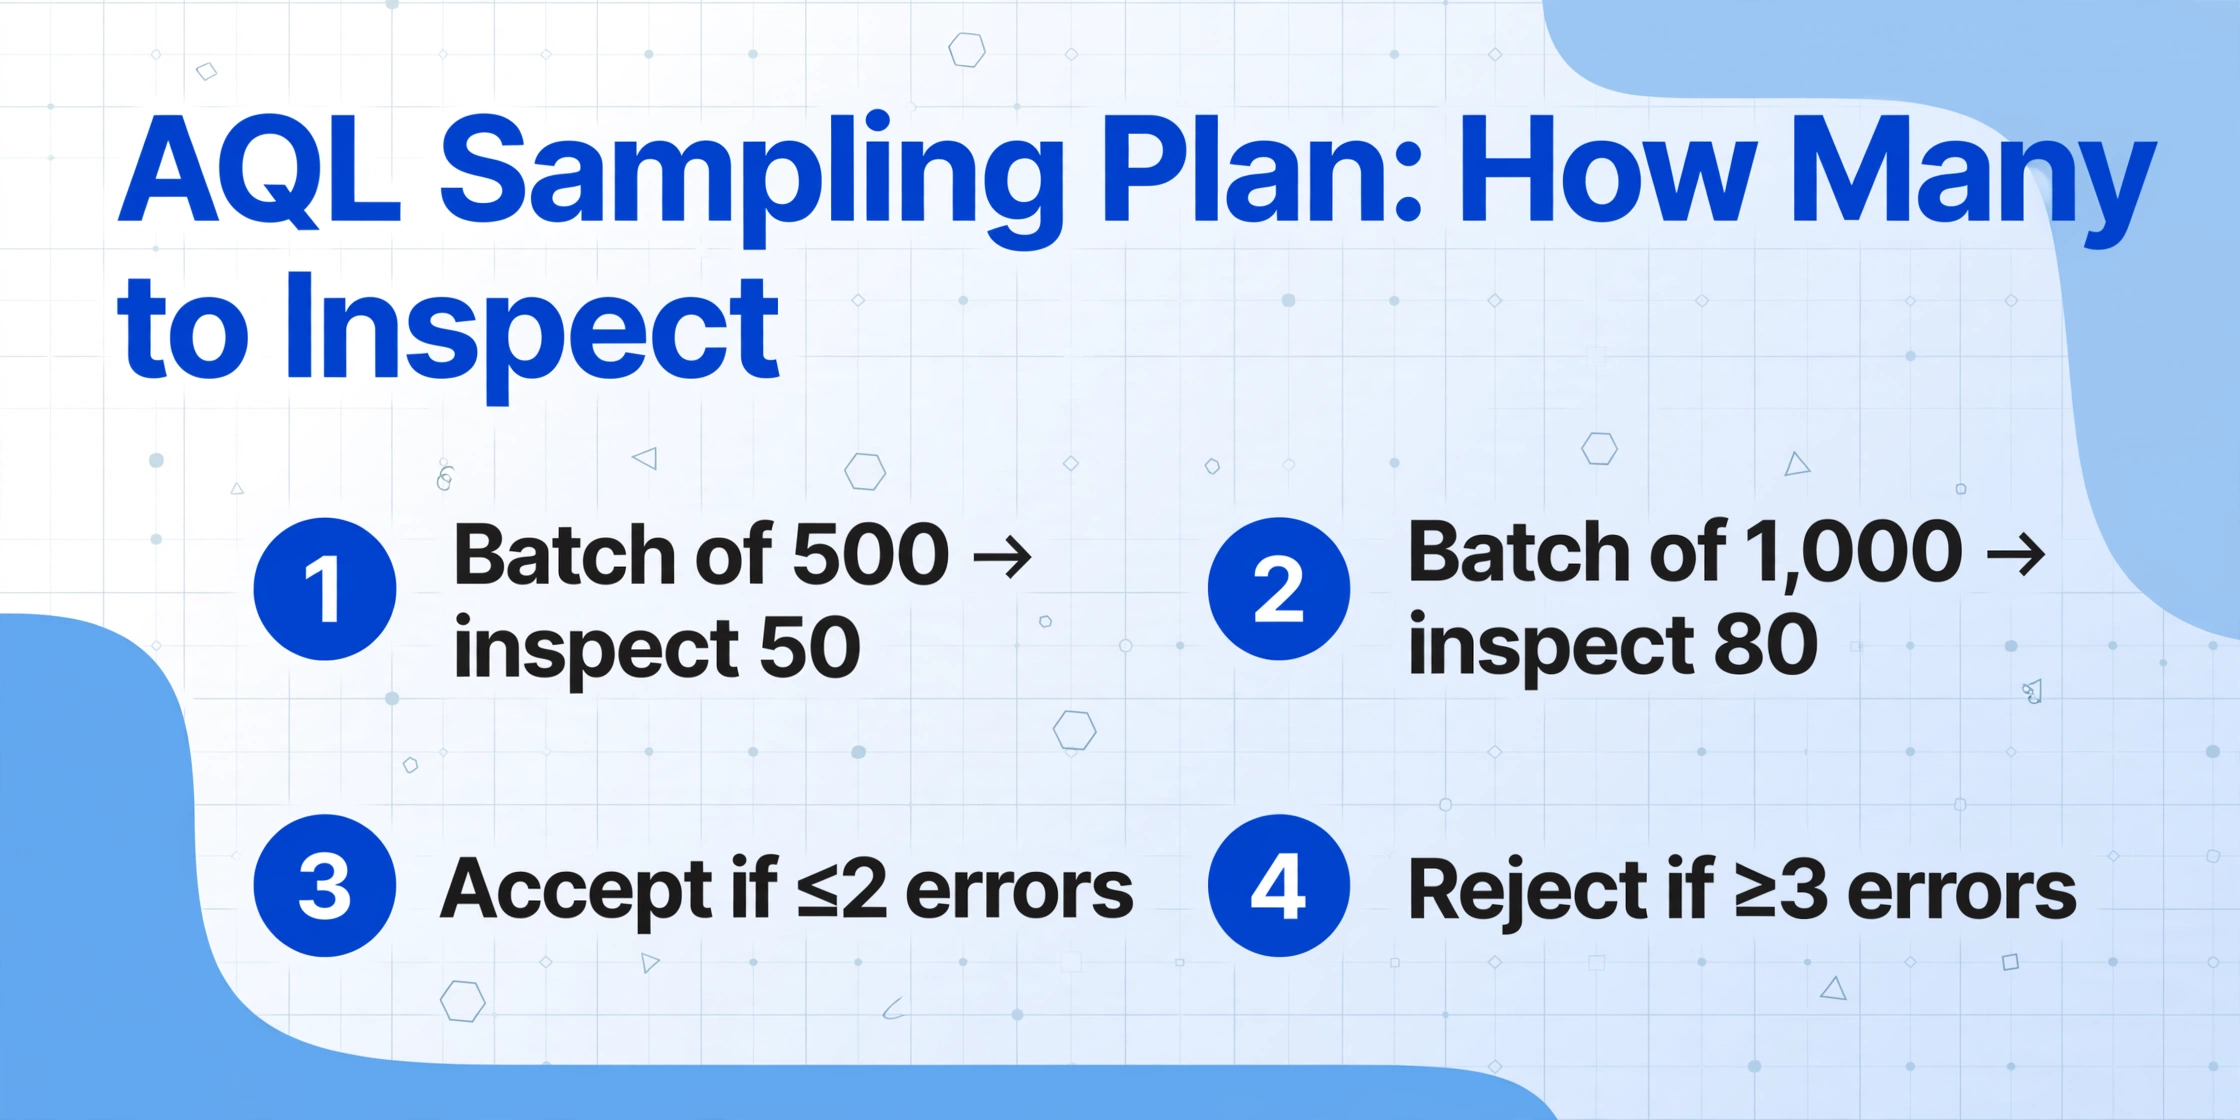
Plan d'échantillonnage AQL 2,5 % simplifié basé sur la norme ISO 2859-1 (niveau d'inspection général II). Tailles d'échantillon arrondies pour un usage pratique.
Voici comment l'utiliser en pratique :
Étape 1 : Prenez votre lot de 500 documents extraits. À l'aide d'un générateur de nombres aléatoires (la fonction =RANDBETWEEN(1,500) d'Excel fonctionne très bien), sélectionnez 50 documents à inspecter.
Étape 2 : Pour chaque document sélectionné, ouvrez le fichier original en parallèle des données extraites. Vérifiez les champs clés : numéro de facture, date, montant total, nom du fournisseur. Indiquez si chaque champ est correct ou contient une erreur. Les « erreurs » incluent les données manquantes, les valeurs incorrectes, la corruption du format (des dates qui ressemblent à des numéros de série) et les données hallucinées qui n'existent pas sur le document original.
Étape 3 : Comptez le nombre total de documents comportant une ou plusieurs erreurs. Si ≤2 documents contiennent des erreurs, le lot est accepté — vous pouvez publier les données en toute confiance. Si ≥3 documents contiennent des erreurs, le lot est rejeté — vous devez soit réinspecter un échantillon plus large, soit corriger le processus d'extraction, soit faire appel à un examen humain pour l'ensemble du lot.
Pourquoi cela fonctionne : Un AQL de 2,5 % signifie que vous acceptez un taux de défauts maximal tolérable de 2,5 % sur l'ensemble du lot. Pour les documents financiers comme les factures et les bons de commande, il s'agit d'un seuil pratique — bien inférieur aux taux d'erreur de la saisie manuelle (les références du secteur situent la saisie manuelle entre 3 et 5 % d'erreurs), sans exiger la rigueur irréaliste d'une tolérance de 0 %.
Méthode 2 — Échantillonnage stratifié par type de document
L'AQL fonctionne bien lorsque tous les documents du lot sont à peu près du même type. Mais les lots réels sont rarement uniformes. Votre « lot de 500 » peut inclure 300 factures de fournisseurs, 120 bons de commande et 80 récépissés de livraison — et voici le point clé : la précision varie selon le type de document.
Les factures des principaux fournisseurs avec des mises en page cohérentes (pensez aux factures Amazon Business ou aux fournisseurs de fournitures de bureau) auront une précision d'extraction plus élevée que les récépissés de livraison griffonnés à la main sur les chantiers. Les bons de commande avec des tableaux propres et dactylographiés se comporteront différemment des factures contractuelles multipages avec des lignes d'articles denses. Les mélanger dans un seul échantillon AQL risque de manquer des problèmes dans le sous-ensemble plus petit et à plus haut risque.
L'échantillonnage stratifié résout ce problème en divisant votre lot en strates (groupes) en fonction du type de document, puis en échantillonnant chaque groupe indépendamment. Cela garantit que chaque classe de document bénéficie de son propre contrôle qualité.
| Strates (type de document) | Nombre | Taille de l'échantillon | Accepter (≤ N erreurs) | Rejeter (≥ N erreurs) |
|---|---|---|---|---|
| Factures fournisseurs (mise en page propre) | 300 | 32 | ≤2 | ≥3 |
| Bons de commande (dactylographiés, structurés) | 120 | 20 | ≤1 | ≥2 |
| Récépissés de livraison (manuscrits, variés) | 80 | 13 | ≤1 | ≥2 |
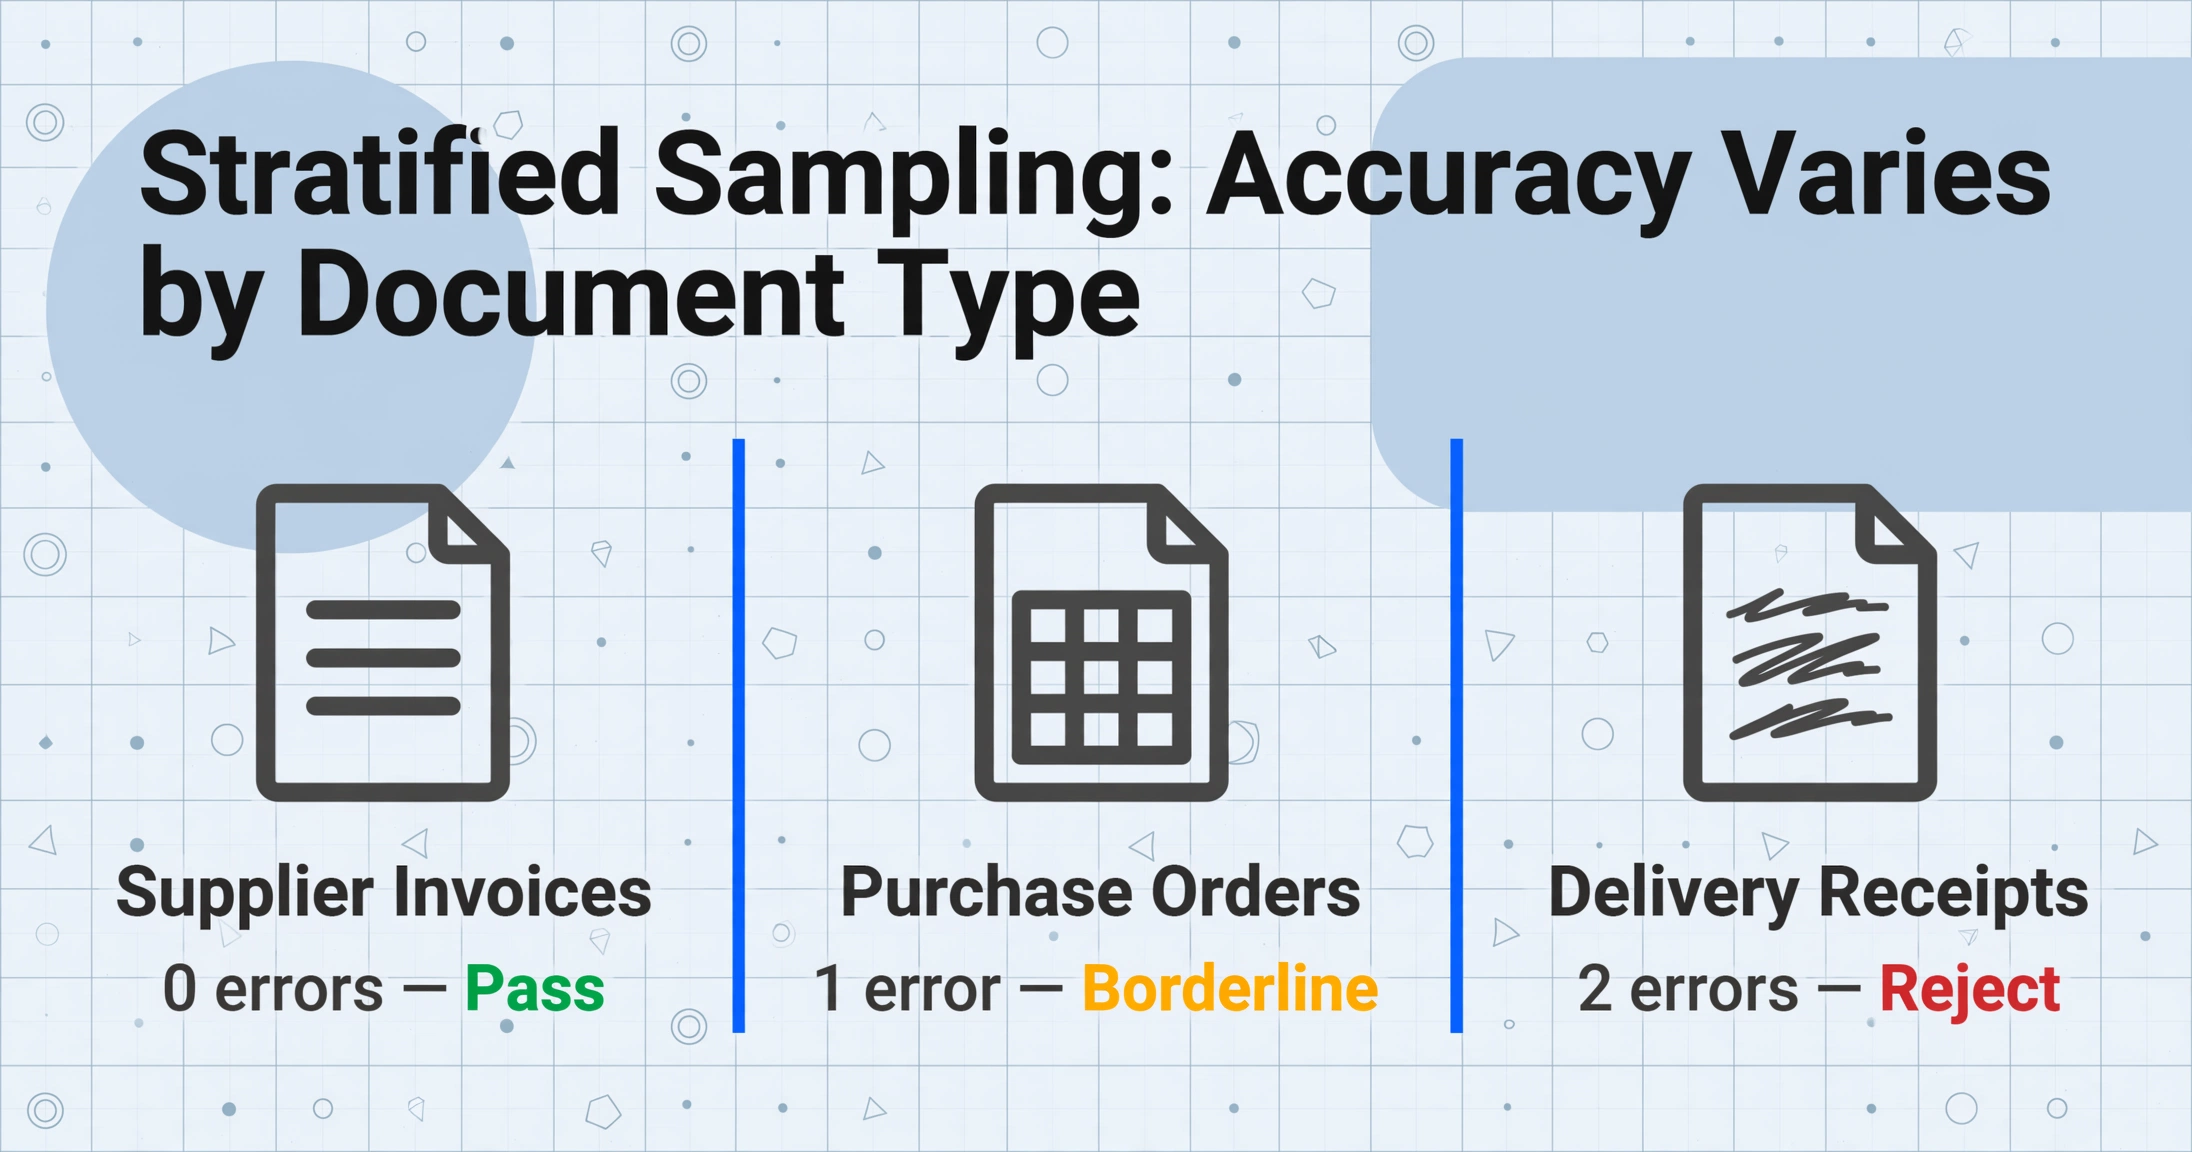
Échantillonnage stratifié appliqué à un lot mixte de 500 documents répartis en trois types.
Avec l'échantillonnage stratifié, vous pourriez découvrir que les factures fournisseurs réussissent facilement (0 erreur dans l'échantillon), que les bons de commande présentent un problème mineur (1 erreur — limite), mais que les récépissés de livraison manuscrits échouent à l'échantillon (2 erreurs — rejet). Cela vous indique précisément où concentrer vos ressources de vérification manuelle : seuls les récépissés de livraison nécessitent un examen complet, et non la totalité du lot. Vous avez économisé des heures de vérification sur les factures et les bons de commande, et vous avez identifié la véritable zone à problème avec une précision chirurgicale.
Pour ce faire, séparez vos résultats d'extraction en onglets ou feuilles de calcul par type de document avant l'échantillonnage. Si votre outil d'extraction ajoute une colonne « type de document » ou « nom du fichier source » — ce que fait ImageToTable.ai en mode batch — cette séparation prend quelques secondes.
Méthode 3 — Échantillonnage par priorité de champ
La troisième méthode inverse la logique : au lieu d'échantillonner des documents entiers, vous ciblez des champs spécifiques à différents taux d'inspection. Toutes les données ne se valent pas. Un total de facture de 149 230,00 $ décalé de 1 000 $ est un vrai problème. Le champ « Adresse de paiement » décalé d'un caractère ne l'est probablement pas.
L'échantillonnage par priorité de champ attribue chaque champ à l'un des trois niveaux d'inspection :
| Niveau | Champs | Taux d'inspection | Pourquoi |
|---|---|---|---|
| Niveau 1 — 100 % | Total de facture, montants des lignes, quantités, dates, numéro de facture, numéro de bon de commande, montants de taxes | Chaque document | Ces champs alimentent les paiements, les rapprochements et la conformité. Une erreur ici a un impact financier direct. |
| Niveau 2 — Échantillonnage | Nom du fournisseur, adresse, descriptions des lignes, prix unitaires (lorsqu'ils ne déterminent pas le total) | Échantillon aléatoire de 10 à 20 % | Les erreurs ici comptent mais causent rarement des pertes financières. Elles affectent la précision des rapports et la recherche. |
| Niveau 3 — Exceptions uniquement | Champs de référence, notes, codes internes, mentions en pied de page, numéros de page | Uniquement lorsqu'ils sont signalés par les règles de validation | Ces champs sont informatifs. Un mauvais numéro en pied de page n'a aucun impact commercial. |
Le flux de travail pratique : parcourez les résultats d'extraction colonne par colonne, en appliquant le taux d'inspection approprié pour chaque niveau. Pour les champs du niveau 1, utilisez la mise en forme conditionnelle d'Excel pour signaler tout élément suspect — totaux ne correspondant pas aux sommes des lignes, dates hors plage, numéros de facture en double. Pour le niveau 2, utilisez =RAND() pour marquer un sous-ensemble aléatoire à vérifier visuellement. Pour le niveau 3, ne les vérifiez que si une règle de validation (comme « le champ doit commencer par INV- ») échoue.
La beauté de cette approche est qu'elle évolue. Dans un lot de 500 documents, vérifier chaque champ du niveau 1 reste un travail considérable — mais cela concentre votre temps sur les champs où les erreurs coûtent réellement de l'argent. Et à mesure que vous gagnez de l'expérience avec votre combinaison de documents, vous remarquerez quels champs appartiennent à quel niveau pour votre flux de travail spécifique.
Liste de vérification pratique en 6 étapes
Voici le flux de travail complet, du moment où votre extraction se termine jusqu'au moment où vous décidez si les données sont prêtes. Il combine les trois méthodes en un seul processus actionnable.
Si votre lot contient des types de documents mixtes, divisez-les en groupes distincts. Les factures avec les factures, les reçus avec les reçus, les bons de commande avec les bons de commande. Chaque type a un profil de précision différent et nécessite son propre plan d'échantillonnage.
Avant d'examiner un document, faites passer vos données dans des règles de validation de base : =SUM(line items) = total (pour détecter les écarts comme ceux détaillés dans notre guide sur les écarts de calcul des lignes d'articles), vérifiez que tous les numéros de facture suivent un format attendu (INV-#####), signalez les dates hors de votre plage d'activité et comptez les champs clés en double. Ces contrôles détectent environ 30 % des erreurs sans inspecter un seul document.
Vérifiez ponctuellement les totaux, les dates, les numéros de facture et les quantités sur chaque document. Si la taille du lot rend l'inspection à 100 % peu pratique (par exemple 5 000 documents ou plus), réduisez à un échantillon stratifié de 20 % sur le niveau 1 — mais n'échantillonnez jamais les champs de niveau 1 à moins de 20 %.
À l'aide du tableau de la méthode 1, sélectionnez votre échantillon aléatoire pour chaque strate. Inspectez chaque champ (tous les niveaux) sur chaque document échantillonné. Si une strate échoue à l'AQL, escaladez tout le groupe — ne supposez pas que l'échec était aléatoire.
Créez un journal simple : date du lot, nombre total de documents, taille de l'échantillon par strate, nombre d'erreurs trouvées, décision de réussite/échec par strate et toute action corrective entreprise. Ce journal sert à deux fins : il couvre votre piste d'audit (important pour les flux de travail conformes à la loi SOX) et il vous aide à repérer les tendances de précision au fil du temps.
Réussite — toutes les strates réussissent l'AQL et les contrôles des champs de niveau 1 semblent propres. Libérez les données. Réussite conditionnelle — échecs mineurs de strates limités à des champs à faible impact. Corrigez ces strates spécifiques et libérez. Échec — erreurs systémiques dans toutes les strates. Rejetez le lot et corrigez le processus d'extraction avant de le relancer.
L'ensemble du processus, de l'étape 1 à l'étape 6, prend environ 30 minutes à un opérateur expérimenté pour un lot de 500 documents — contre plus de 20 heures pour une vérification manuelle à 100 %. Le compromis n'est pas « précision vs. rapidité » — c'est que vous obtenez 95 % de la confiance pour 2,5 % du temps investi, et vous savez exactement quels documents nécessitent une attention particulière.
Quand la vérification ne suffit pas
L'échantillonnage par sondage vous indique si un lot est suffisamment bon. Il ne corrige pas la qualité d'extraction sous-jacente. Si vous observez certains schémas dans vos résultats de vérification, la réponse appropriée n'est pas « échantillonner plus agressivement » — c'est de corriger le processus d'extraction en amont.
Surveillez ces signaux :
- Échecs systématiques de champs : Chaque document de l'échantillon présente la même erreur de champ — par exemple, la colonne « Total » contient systématiquement le sous-total au lieu du total général. Ce n'est pas un bruit aléatoire ; c'est un problème de mappage de colonnes. Vérifiez votre configuration d'extraction ou réfléchissez à la manière dont votre outil gère les champs de totaux.
- Erreurs groupées provenant d'une source de documents spécifique : Toutes les erreurs proviennent de numérisations effectuées sur un smartphone particulier ou de PDF d'un fournisseur spécifique. Cela indique que le problème est en amont, dans la qualité des documents, et non dans le modèle d'extraction lui-même.
- Corruption au niveau du format : Des dates affichées comme des numéros de série Excel, des valeurs monétaires dépourvues de symboles, des tableaux de lignes d'articles fusionnés en cellules uniques. Ces problèmes sont souvent causés par des cellules fusionnées, des structures de tableaux incohérentes ou des documents sources avec un formatage complexe — des problèmes que nous abordons en profondeur dans notre guide d'extraction des cellules fusionnées.
- Échecs AQL persistants sur plusieurs lots : Si trois lots consécutifs échouent à l'échantillonnage, vous avez un problème de précision systémique que le rééchantillonnage ne résoudra pas. À ce stade, la réponse honnête est : l'outil ou la configuration actuelle ne répond pas à votre seuil de qualité. Il est temps d'évaluer une approche différente.
Savoir quand escalader est aussi important que savoir comment échantillonner. Un outil comme ImageToTable.ai qui prend en charge le traitement par lots avec plusieurs modes d'extraction vous offre des options — passer du mode Vers Tableau au mode Vers Word, ajuster les définitions de colonnes ou essayer différents modes de reconnaissance peut résoudre des problèmes persistants sans changer complètement d'outil.
Mais si vous avez essayé des ajustements et que le taux d'erreur reste supérieur à votre seuil AQL, la bonne décision est de reconnaître la limitation, pas de baisser vos exigences. Certains types de documents nécessitent véritablement une approche différente — et ce n'est pas un échec d'un outil, c'est une compréhension réaliste de ce que l'extraction IA actuelle peut et ne peut pas faire.
Questions fréquentes
Comment choisir entre l'échantillonnage AQL, stratifié et par priorité de champ ?
Utilisez les trois — ils sont complémentaires, pas alternatifs. Commencez par la priorité de champ pour protéger vos champs financiers. Utilisez l'échantillonnage stratifié pour gérer des types de documents mixtes. Appliquez l'AQL comme base statistique pour les décisions de conformité. La checklist ci-dessus combine les trois en un seul flux.
Une vérification à 100 % ne donne-t-elle pas de meilleurs résultats qu'un échantillonnage ?
En théorie, oui. En pratique, vérifier 500 documents à 100 % est si long et fastidieux que cela crée son propre problème de qualité : la fatigue du vérificateur. Après 200 documents, la capacité de détection d'erreurs chute fortement. Un échantillon discipliné de 10 %, fait avec soin, détecte souvent plus d'erreurs qu'une revue à 100 % bâclée par épuisement. C'est la même raison pour laquelle les auditeurs professionnels utilisent l'échantillonnage : ce n'est pas de la paresse, c'est une méthodologie.
Que faire si mon lot passe l'AQL mais que je trouve des erreurs plus tard ?
Ce n'est pas un échec de la méthode — c'est un résultat statistique correct. Un plan AQL à 2,5 % accepte explicitement que jusqu'à 2,5 % des documents puissent contenir des erreurs. Si vous découvrez une erreur isolée en aval, corrigez-la et continuez. Si vous découvrez un schéma d'erreurs systématique que l'échantillon a manqué, cela indique que votre plan d'échantillonnage doit être ajusté — soit votre seuil AQL est trop laxiste pour votre cas d'usage, soit vos limites de strates sont erronées.
Puis-je automatiser une partie de ce processus de vérification ?
Partiellement. Les contrôles de cohérence automatisés (étape 2) peuvent être exécutés dans Excel avec des formules et du formatage conditionnel. La sélection de l'échantillon (étapes 3-4) peut être randomisée avec =ALEA() ou =ALEA.ENTRE.BORNES(). Mais la comparaison document par document — ouvrir l'original et le comparer aux données extraites — nécessite encore un œil humain. Des outils de vérification basés sur l'IA existent, mais ils introduisent une deuxième couche d'incertitude liée à l'IA, ce qui va à l'encontre de l'objectif d'une vérification indépendante.
À quelle fréquence dois-je vérifier les lots récurrents ?
Pour des lots hebdomadaires ou mensuels, vérifiez chaque lot jusqu'à avoir un historique. Une fois que vous voyez 5 lots consécutifs ou plus passer l'AQL au même seuil, vous pouvez réduire à une vérification ponctuelle tous les trois lots — mais vérifiez toujours le premier lot après tout changement : nouveau type de document, nouveau fournisseur, nouvelle configuration d'extraction ou mise à jour d'outil. Le moment où vous arrêtez complètement de vérifier est celui où une erreur silencieuse passera inaperçue.
La Vérité Honnête
Tout outil d'extraction de documents, qu'il soit basé sur l'IA ou non, a un taux d'erreur. La différence entre une bonne et une mauvaise implémentation n'est pas de savoir si des erreurs se produisent — c'est ce que vous en faites.
Une entreprise qui traite 500 factures sans plan de vérification joue. Une entreprise qui passe 40 heures à vérifier chaque champ de chaque facture brûle de l'argent. Une entreprise qui utilise une méthodologie d'échantillonnage structurée — combinant des seuils AQL, un échantillonnage stratifié par type de document et une inspection par priorité de champ — opère de manière professionnelle. Elle connaît son taux d'erreur, elle sait quand accepter un lot et quand le rejeter, et elle dispose d'une piste d'audit pour prouver son processus.
Ce juste milieu professionnel est ce que ce cadre vous offre. Il est adapté de la norme ISO 2859-1 — une norme qui régit les décisions qualité dans l'industrie manufacturière depuis des décennies — parce que les mathématiques fonctionnent. Et cela s'applique quel que soit l'outil d'extraction que vous utilisez. La méthode est indépendante de l'outil ; seul le profil d'erreur attendu change.
Testez-le sur votre prochain lot. Choisissez 50 documents au hasard. Passez 30 minutes à les vérifier. Voyez si les résultats vous apprennent quelque chose que vous ignoriez sur la qualité de votre extraction.