500件のバッチ抽出を検証する方法
すべての行をチェックせずに
500件の請求書をAI抽出ツールで処理したばかりです。出力はきれいに見えます — すべての行が埋まったExcelテーブル、妥当な合計額。しかし、こんな考えが頭をよぎります:何かが静かに間違っていたらどうしよう? 147行目の金額の読み間違い。323行目の明細項目の欠落。途中で月と日が逆転した日付形式。500件すべてをチェックすることはできません。しかし、盲目的に信頼することもできません。この記事では、その中間の道を紹介します — 産業品質管理から応用した3つの実証済みサンプリング方法と、30時間ではなく30分で完了する実用的なチェックリストです。
重要なポイント
- 500件の文書を手動で検証するには20時間かかります — そして200件目を過ぎると、エラー発見率が十分に低下するため、残りの300件のチェックは安全性ではなく誤った自信を得ているにすぎません。
- 理想的な条件下での人間の視覚比較エラー率は3〜5%に達し、疲労とともに悪化します — そのため、プロの監査人は100%レビューではなく統計的サンプリングを標準手法として使用しています。
- ISO 2859-1サンプリング表 — 工場が10000個中50個を検査するために使用するのと同じ標準 — を使用すると、50件の文書を30分で検査し、監査証跡付きの統計的に正当な合格・不合格の判断を下すことができます。
検証が独自の問題である理由
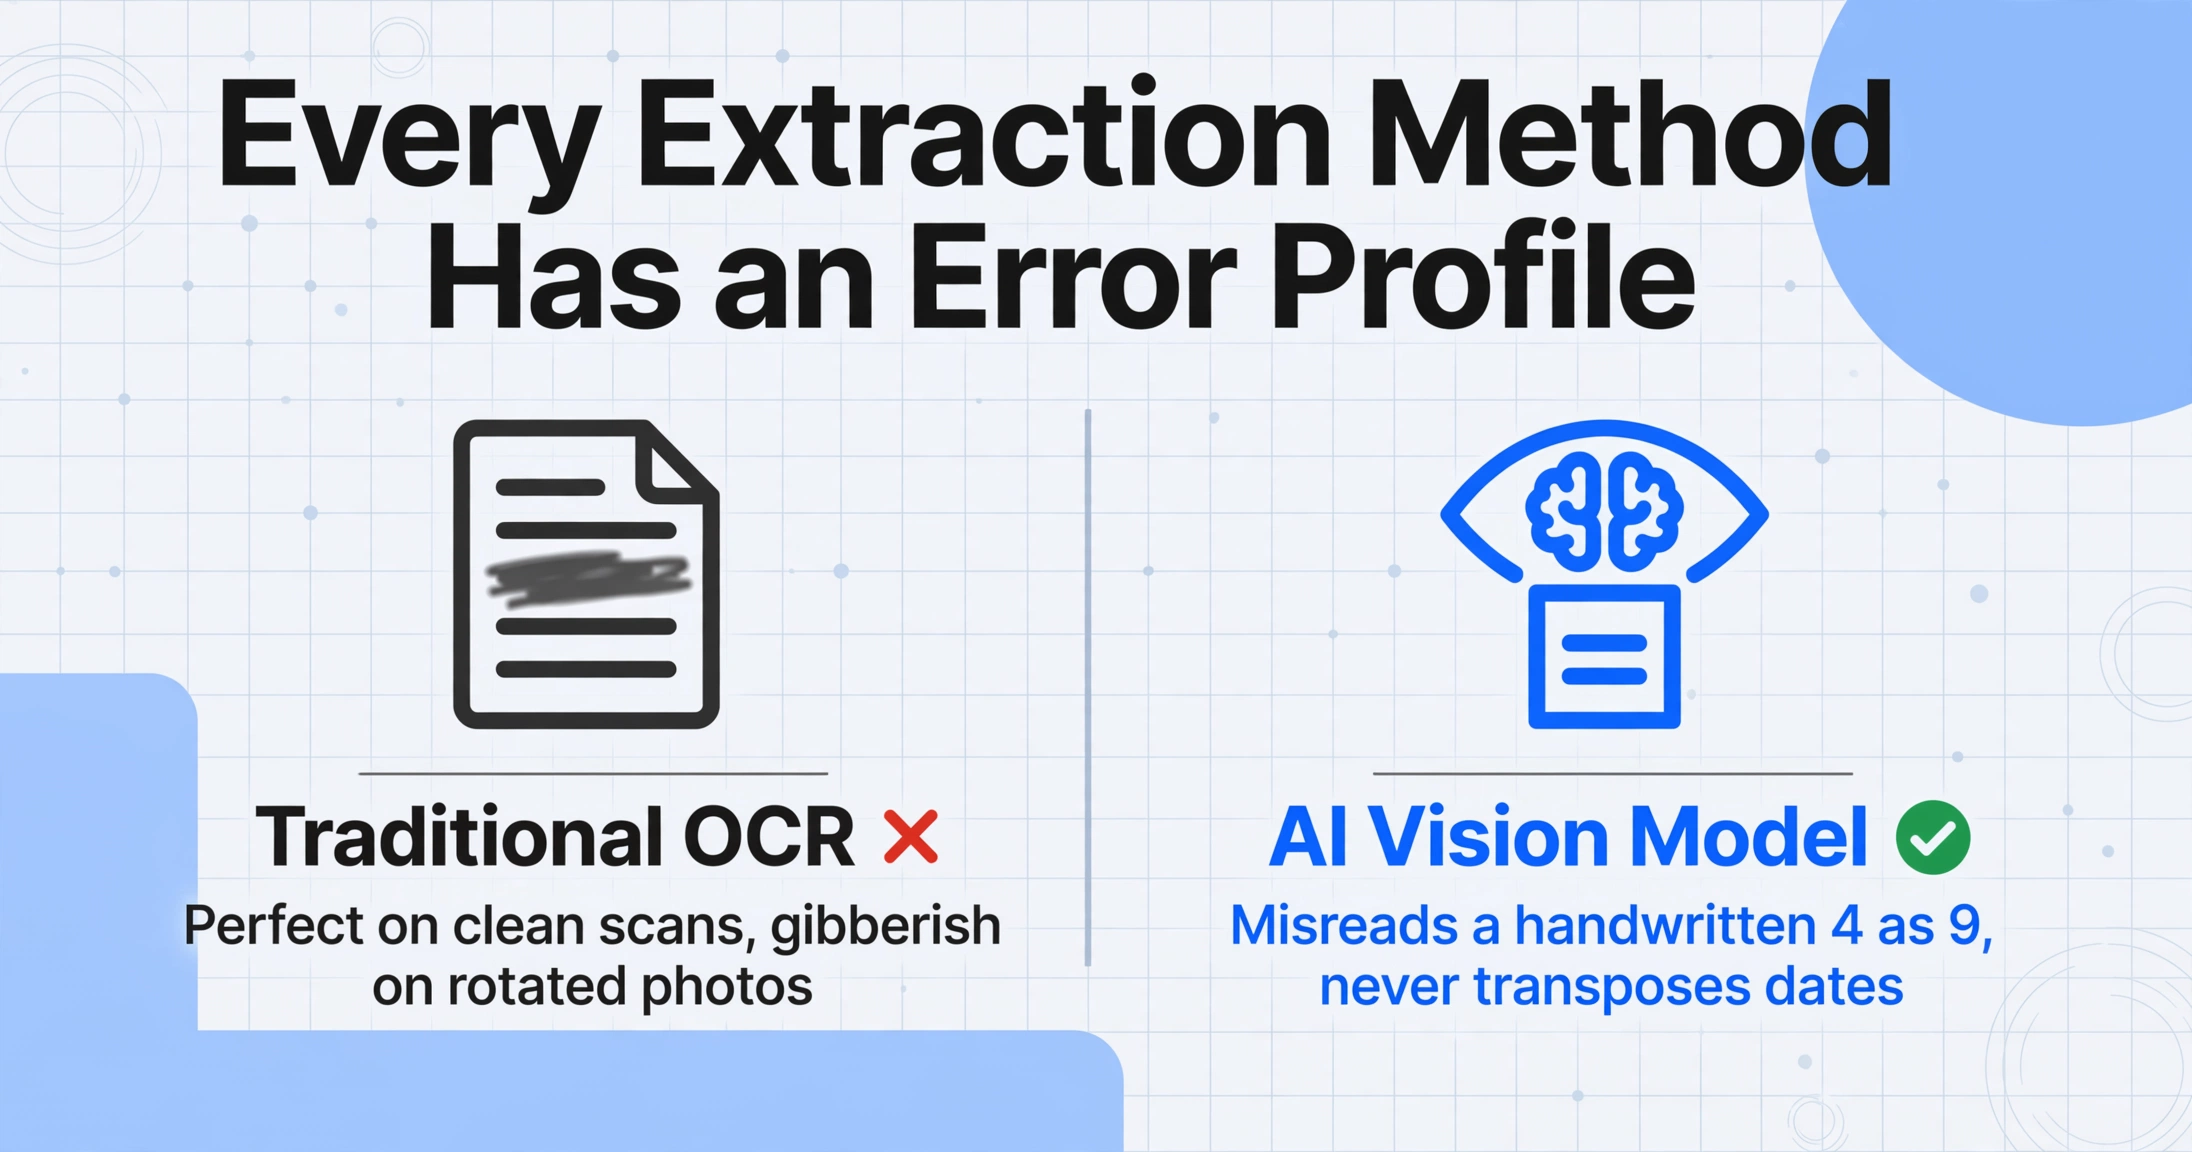
文書抽出の隠れた真実—テンプレートOCR、AIビジョンモデル、昔ながらの手入力のいずれを使っても—100%正確な方法は存在しないということです。AIも、人間のデータ入力担当者も、高価なERP統合も例外ではありません。ツール間の違いはエラープロファイル、つまりどのような種類のエラーを、どのくらいの頻度で、どのフィールドで発生させるかという点にあります。
ImageToTable.aiのようなAIビジョンモデルは、納品書の手書きの「4」を「9」と誤読するかもしれませんが、疲れた人間のように請求書の日付と注文番号をうっかり入れ替えることは決してありません。従来のOCRは、鮮明なスキャンPDFのすべての文字を正確に認識しても、少し回転したレシート写真では意味不明な出力になることがあります。各ツールには学ぶべきパターンがあります。
しかし、ここに厄介な真実があります。特定の抽出結果が正しいかどうかは、元の文書を見なければ分かりません。信頼スコアも、精度指標も、ベンダーの保証も、その1枚の請求書の合計が正しいかどうかは教えてくれません。問題は「ツールを信頼できるか」ではなく、「どのくらい確認する必要があり、どう効率的に確認するか」です。
そこで品質管理の方法論が登場します。これは、ほとんどのオフィスワーカーが触れたことのない分野から借用したものです。統計的受入サンプリングです。10,000個の出荷ロットから50個を検査してロット全体の合否を判断する工場のロジックは、抽出結果にもそのまま当てはまります。
方法1 — 統計的サンプリング(AQL)
許容品質限界(AQL)は、製造業で数十年にわたり使用されているISO 2859-1規格であり、まさにこの問いに答えるためのものです。「大量のバッチがあります。すべてを検査することはできません。何件を検査し、バッチが十分に良いかどうかをどのように判断すればよいでしょうか?」
このロジックは、文書抽出の検証にそのまま適用できます。バッチ内の各文書を「ユニット」として扱い、「欠陥」とみなすもの(誤ったフィールド値、欠落した明細項目、誤読された金額など)を定義し、サンプリング計画を適用します。
抽出検証にAQLを適用する方法
| バッチサイズ(文書数) | 検査するサンプルサイズ | AQL 2.5% — 受入 | AQL 2.5% — 却下 |
|---|---|---|---|
| 50 | 13 | ≤1エラー | ≥2エラー |
| 200 | 32 | ≤2エラー | ≥3エラー |
| 500 | 50 | ≤2エラー | ≥3エラー |
| 1,000 | 80 | ≤5エラー | ≥6エラー |
| 5,000 | 200 | ≤10エラー | ≥11エラー |
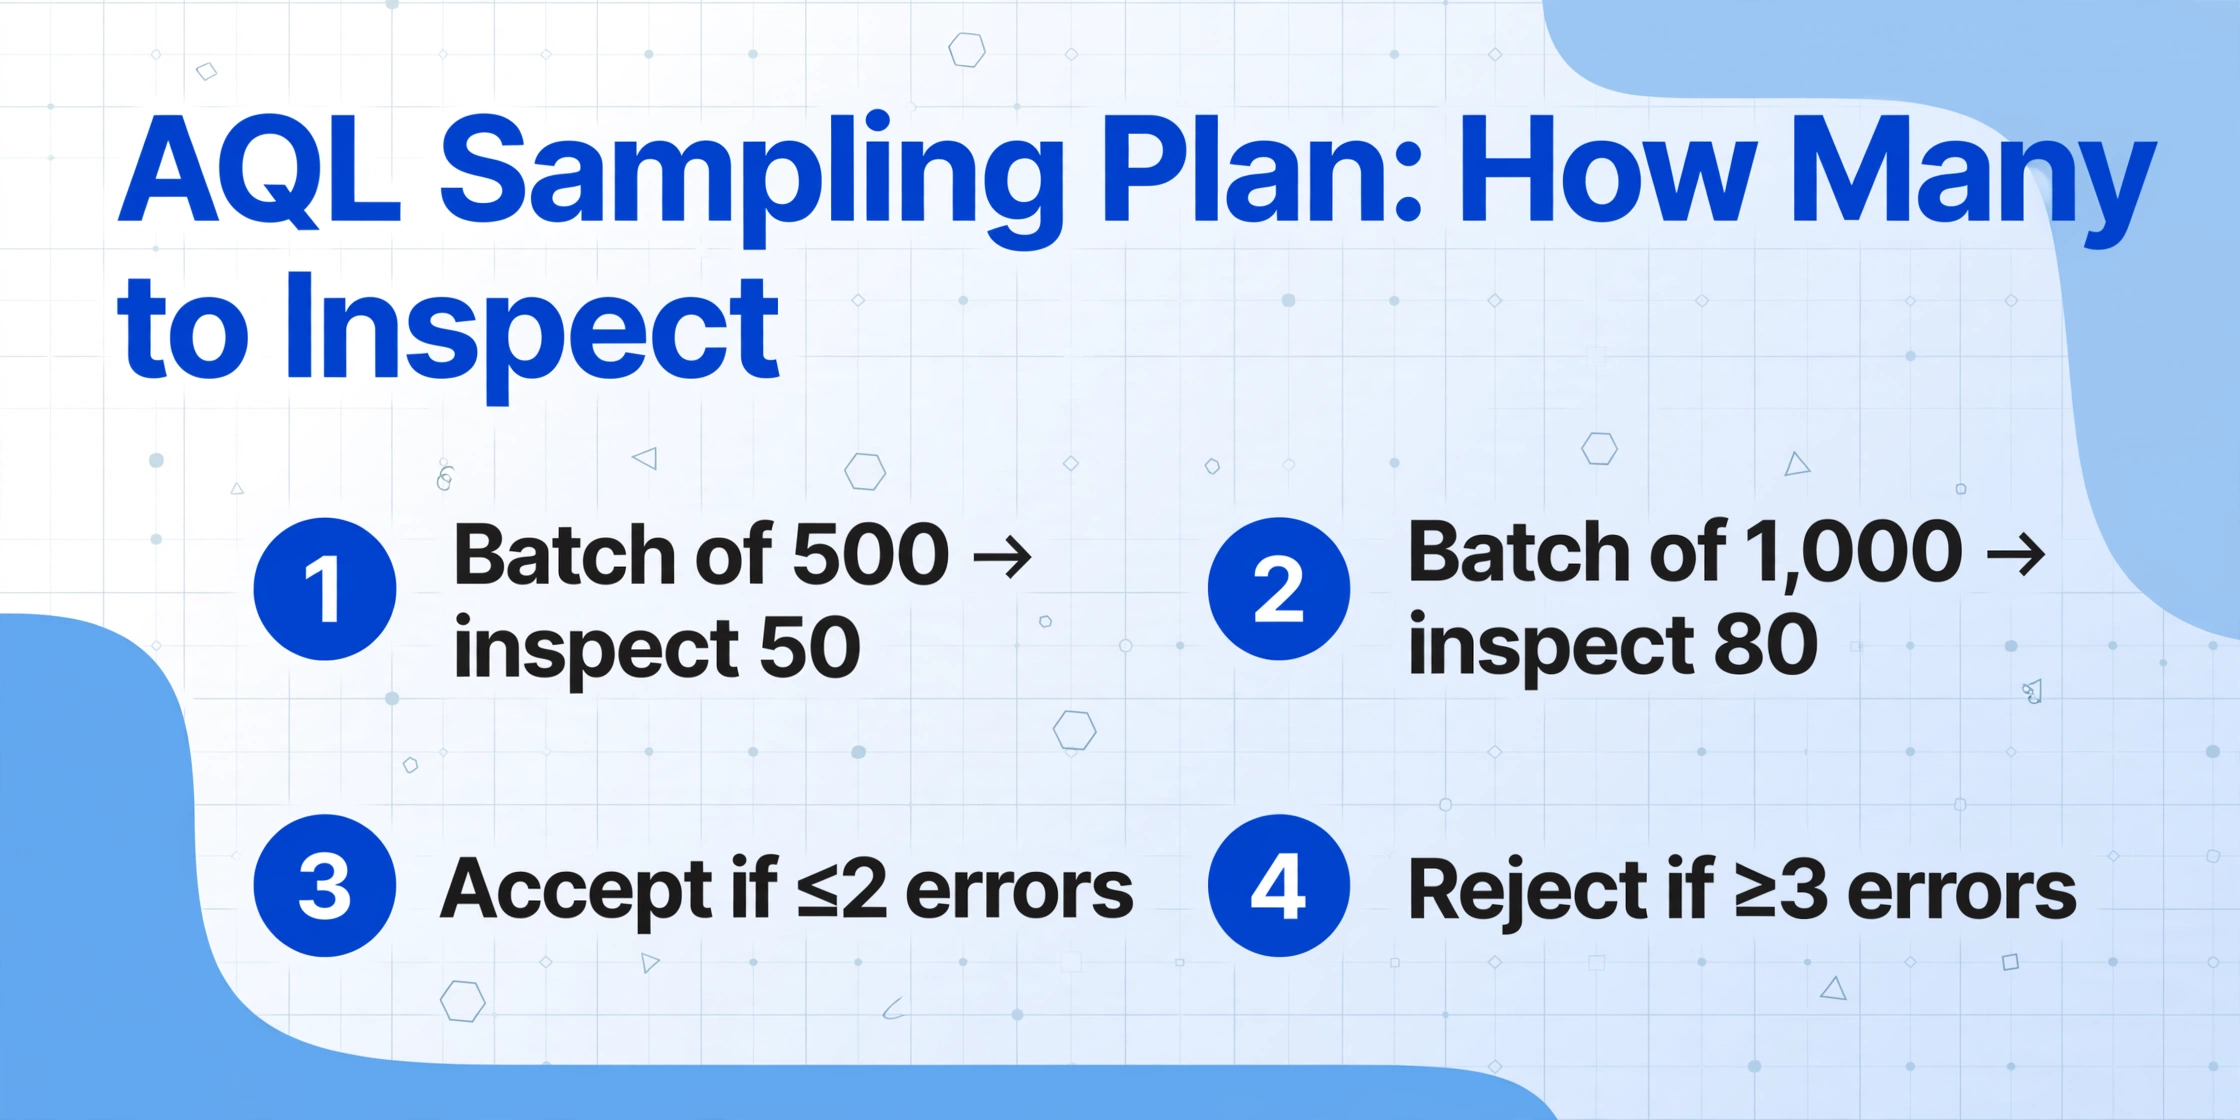
ISO 2859-1(一般検査レベルII)に基づく簡易AQL 2.5%サンプリング計画。サンプルサイズは実用性を考慮して丸めています。
実際の使用方法は次のとおりです。
ステップ1:500件の抽出済み文書のバッチを用意します。乱数生成器(Excelの=RANDBETWEEN(1,500)で問題ありません)を使用して、検査する50件の文書を選びます。
ステップ2:選択した各文書について、元のファイルを抽出データと並べて開きます。請求書番号、日付、合計金額、ベンダー名などの主要フィールドを確認します。各フィールドが正しいか、エラーがあるかをマークします。「エラー」には、データの欠落、誤った値、形式の破損(シリアル番号のように見える日付など)、および元の文書に存在しない幻覚データが含まれます。
ステップ3:1つ以上のエラーがある文書の総数を集計します。エラーがある文書が≤2件の場合、バッチは合格です。データを自信を持ってリリースできます。エラーがある文書が≥3件の場合、バッチは不合格です。より大きなサンプルを再検査するか、抽出プロセスを修正するか、バッチ全体を人間によるレビューにエスカレーションする必要があります。
なぜこれが有効か:AQL(許容品質限界)2.5%は、バッチ全体で許容できる最悪の欠陥率が2.5%であることを意味します。請求書や発注書などの財務文書では、これは実用的な閾値です。手動データ入力のエラー率(業界ベンチマークでは手動入力のエラー率は3〜5%)よりもはるかに低く、0%許容という非現実的な厳格さを要求しません。
方法2 — 文書タイプ別の層別サンプリング
AQLは、バッチ内のすべての文書がほぼ同じタイプの場合に有効です。しかし、実際のバッチが均一であることはほとんどありません。あなたの「500件のバッチ」には、仕入先からの請求書300件、発注書120件、納品書80件が含まれているかもしれません。そして、ここが重要なポイントです:精度は文書タイプによって異なります。
一貫したレイアウトを持つ主要サプライヤーからの請求書(Amazon Businessの請求書やオフィス用品ベンダーなどを考えてください)は、現場からの手書きの納品書よりも抽出精度が高くなります。クリーンでタイプされた表を持つ発注書は、項目が密集した複数ページの契約請求書とは異なるパフォーマンスを示します。これらを1つのAQLサンプルに混ぜると、より小さくリスクの高いサブセットの問題を見逃すリスクがあります。
層別サンプリングは、文書タイプに基づいてバッチを層(グループ)に分割し、各グループを独立してサンプリングすることでこの問題を解決します。これにより、すべてのクラスの文書が独自の品質チェックを受けることが保証されます。
| 層(文書タイプ) | 件数 | サンプルサイズ | 受入(エラー数≤N) | 却下(エラー数≥N) |
|---|---|---|---|---|
| 仕入先請求書(クリーンなレイアウト) | 300 | 32 | ≤2 | ≥3 |
| 発注書(タイプ済み、構造化) | 120 | 20 | ≤1 | ≥2 |
| 納品書(手書き、多様) | 80 | 13 | ≤1 | ≥2 |
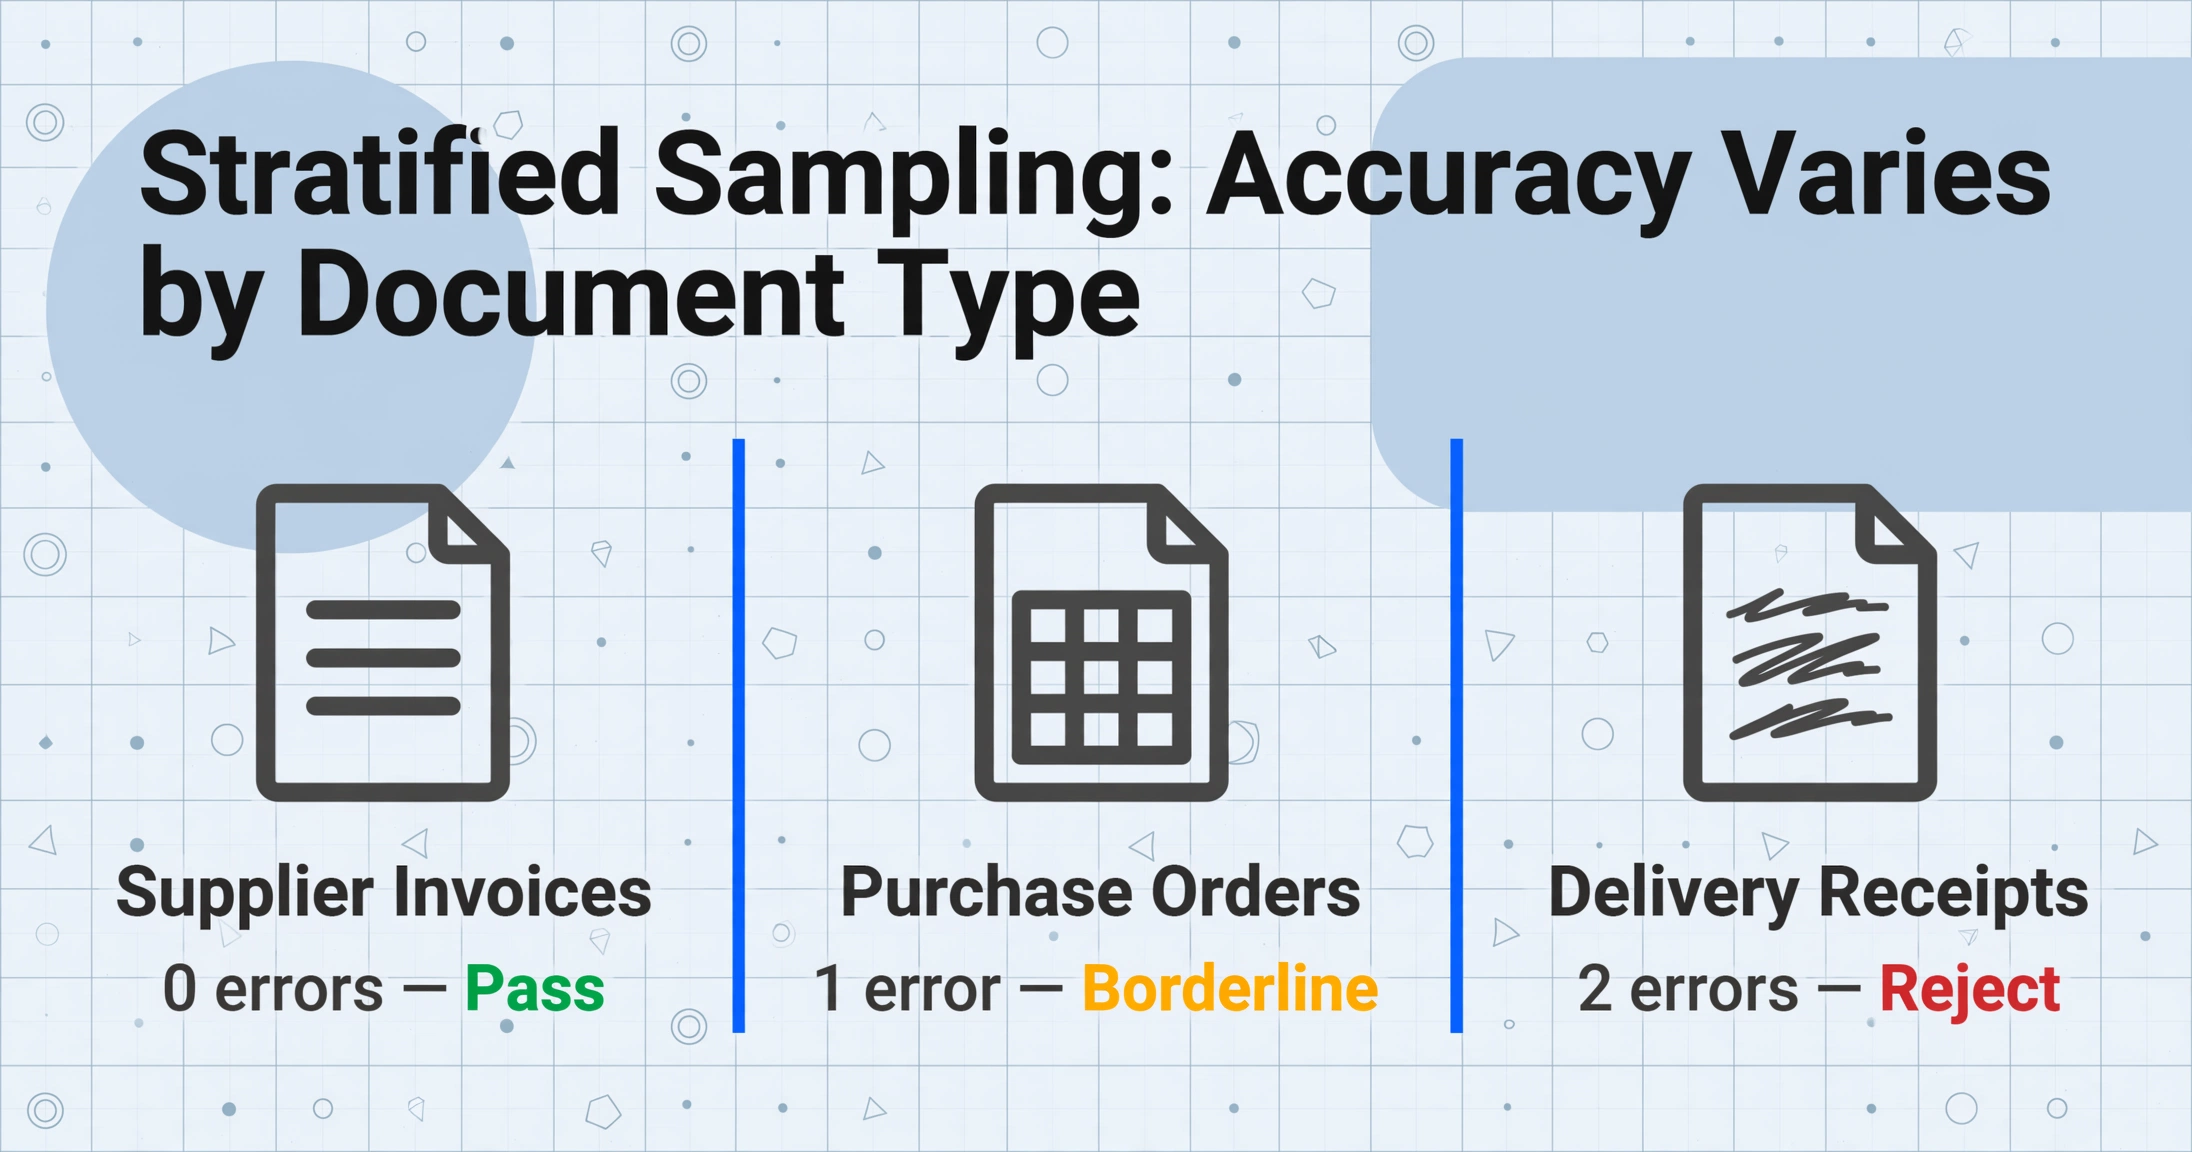
3つのタイプにわたる500件の混合バッチに適用された層別サンプリング。
層別サンプリングを使用すると、仕入先請求書は簡単に合格し(サンプルでエラー0件)、発注書には軽微な問題があり(エラー1件 — 境界線)、手書きの納品書はサンプルに不合格となる(エラー2件 — 却下)ことが判明するかもしれません。これにより、手動レビューリソースをどこに集中させるべきかが正確にわかります:バッチ全体ではなく、納品書のみを完全に精査する必要があります。請求書と発注書のチェックにかかる時間を節約でき、真の問題領域を外科手術的な精度で特定できたことになります。
これを実装するには、抽出結果を文書タイプごとにタブまたはワークシートに分けてからサンプリングします。抽出ツールが「文書タイプ」または「ソースファイル名」列を追加する場合(ImageToTable.aiはバッチモードでこれを行います)、この分割は数秒で完了します。
方法3 — フィールド優先サンプリング
3つ目の方法はロジックを逆転させます。文書全体をサンプリングする代わりに、特定のフィールドを異なる検査率で対象にします。すべてのデータが同じ価値を持つわけではありません。$149,230.00の請求書合計が$1,000ずれているのは重大な問題です。「送金先住所」フィールドが1文字ずれていても、おそらく問題にはなりません。
フィールド優先サンプリングでは、各フィールドを3つの検査階層のいずれかに割り当てます:
| 階層 | フィールド | 検査率 | 理由 |
|---|---|---|---|
| 階層1 — 100% | 請求書合計、明細金額、数量、日付、請求書番号、発注番号、税額 | すべての文書 | これらは支払い、照合、コンプライアンスに使用されます。ここでのエラーは直接的な財務影響があります。 |
| 階層2 — サンプリング | ベンダー名、住所、明細の説明、単価(合計の主要因でない場合) | 10〜20%のランダムサンプル | ここでのエラーは重要ですが、財務損失を引き起こすことはほとんどありません。レポートの正確性と検索可能性に影響します。 |
| 階層3 — 例外のみ | 参照フィールド、メモ、内部コード、フッターの免責事項、ページ番号 | 検証ルールでフラグが立てられた場合のみ | これらは情報提供用です。フッター番号の誤りはビジネスへの影響はゼロです。 |
実用的なワークフロー:抽出結果を列ごとにスキャンし、各階層に適切な検査率を適用します。階層1のフィールドでは、Excelの条件付き書式を使用して疑わしいものをフラグします — 明細合計と一致しない合計、範囲外の日付、重複する請求書番号など。階層2では、=RAND()を使用して視覚的検証用のランダムサブセットをマークします。階層3では、検証ルール(「フィールドはINV-で始まる必要がある」など)が失敗した場合のみチェックします。
このアプローチの利点はスケーラブルであることです。500文書のバッチでは、すべての階層1フィールドをチェックするのは依然として多くの作業ですが、エラーが実際のコストにつながるフィールドに時間を集中させることができます。そして、文書ミックスに関する経験を積むにつれて、特定のワークフローでどのフィールドがどの階層に属するかがわかるようになります。
実践的な検証チェックリスト(6ステップ)
抽出が完了してからデータの利用可否を判断するまでの全ワークフローをここに示します。3つの手法をすべて1つの実践的なプロセスに統合しています。
バッチに複数の文書タイプが混在している場合は、グループごとに分けてください。請求書は請求書同士、領収書は領収書同士、注文書は注文書同士でまとめます。文書タイプごとに精度プロファイルが異なるため、それぞれに適したサンプリング計画が必要です。
文書を確認する前に、基本的な検証ルールでデータをチェックしてください:=SUM = 合計(明細行の計算不一致ガイドで詳述したような不一致を検出)、すべての請求書番号が期待されるパターン(INV-#####)に従っているか、業務範囲外の日付にフラグを立てる、重複するキーフィールドを数える。これらのチェックで、文書を1件も確認せずに約30%のエラーを検出できます。
すべての文書で合計、日付、請求書番号、数量をスポットチェックします。バッチサイズが大きく100%検査が非現実的な場合(例:5,000件以上)、Tier 1では20%の層別サンプリングに落としますが、Tier 1フィールドを20%未満でサンプリングすることは絶対にしないでください。
方法1の表を使用して、各層のランダムサンプルを選択します。サンプリングされた各文書のすべてのフィールド(全Tier)を検査します。層がAQLに不合格の場合、そのグループ全体をエスカレーションしてください。不合格がランダムだったと想定しないでください。
簡単なログを作成します:バッチ日付、総文書数、層ごとのサンプルサイズ、検出されたエラー数、層ごとの合格/不合格判定、実施した是正措置。このログには2つの目的があります:監査証跡をカバーし(SOX準拠ワークフローに重要)、時間の経過に伴う精度トレンドを把握するのに役立ちます。
合格 — すべての層がAQLに合格し、Tier 1フィールドチェックも問題なし。データをリリースします。条件付き合格 — 影響の少ないフィールドに限定した軽微な層の不合格。該当する層のみを修正してリリースします。不合格 — 層全体にわたる系統的なエラー。バッチを却下し、再実行する前に抽出プロセスを修正します。
ステップ1からステップ6までの全プロセスは、経験豊富なオペレーターが500件のバッチで約30分かかります。一方、100%手動検証では20時間以上かかります。このトレードオフは「精度対速度」ではなく、時間投資の2.5%で95%の信頼性を得られ、どの文書をより詳しく確認すべきかが正確にわかるという点です。
検証だけでは不十分な場合
スポットチェックサンプリングは、バッチが十分に良いかどうかを教えてくれますが、根本的な抽出品質を修正するものではありません。検証結果に特定のパターンが見られる場合、正しい対応は「より積極的にサンプリングする」ことではなく、上流の抽出プロセスを修正することです。
次のようなシグナルに注意してください:
- 体系的なフィールド障害:サンプル内のすべての文書で同じフィールドが誤っている場合(例:「合計」列に総計ではなく小計が一貫して入っている)。これはランダムなノイズではなく、列マッピングの問題です。抽出設定を確認するか、ツールが合計フィールドをどのように処理するかを検討してください。
- 特定の文書ソースでのエラーの集中:すべてのエラーが特定のスマートフォンでのスキャンや特定のベンダーのPDFから発生している場合。これは、問題が抽出モデル自体ではなく、上流の文書品質にあることを示しています。
- フォーマットレベルの破損:日付がExcelシリアル番号として表示される、通貨記号が削除される、明細行のテーブルが単一セルに崩れるなど。これらは多くの場合、結合セル、一貫性のないテーブル構造、複雑なフォーマットのソース文書が原因です。これらの問題については、結合セル抽出ガイドで詳しく説明しています。
- 複数のバッチにわたる持続的なAQL(許容品質限界)違反:3回連続でバッチがサンプリングに不合格となった場合、再サンプリングでは解決できない体系的な精度問題があります。この時点で正直な答えは、現在のツールまたは設定が品質しきい値を満たしていないということです。別のアプローチを評価する時期です。
いつエスカレーションすべきかを知ることは、サンプリング方法を知ることと同じくらい重要です。ImageToTable.aiのようなツールは、複数の抽出モードを備えたバッチ処理をサポートしており、Wordに変換モードからテーブルに変換モードへの切り替え、列定義の調整、異なる認識モードの試行など、ツールを完全に切り替えることなく持続的な問題を解決するオプションを提供します。
しかし、調整を試みてもエラー率がAQL(許容品質限界)のしきい値を超えている場合、正しい判断は限界を認めることであり、基準を下げることではありません。一部の文書タイプは本当に異なるアプローチを必要とします。それはツールの失敗ではなく、現在のAI抽出ができることとできないことの現実的な理解です。
よくある質問
AQL、層別サンプリング、フィールド優先サンプリングはどう使い分ければいいですか?
3つすべてを併用してください。これらは代替手段ではなく、補完関係にあります。まずフィールド優先サンプリングで重要な財務フィールドを保護します。層別サンプリングで複数の文書タイプに対応します。AQLを統計的な基盤として合否判定に用います。上記のチェックリストは、これら3つを1つのワークフローに統合したものです。
サンプリングより全数確認の方が良い結果が得られるのでは?
理論上はそうです。しかし実際には、500件の文書を全数確認するのは非常に時間がかかり退屈なため、確認者の疲労という新たな品質問題が生じます。200件を確認した後、ほとんどの人のエラー発見率は急激に低下します。規律正しい10%のサンプリングを注意深く行う方が、疲れ切った状態での全数確認よりも多くのエラーを発見できることがよくあります。プロの監査人がサンプリングを利用するのも同じ理由で、それは怠惰ではなく方法論なのです。
バッチがAQLに合格した後でエラーが見つかった場合は?
それは手法の失敗ではなく、正しい統計的結果です。AQL 2.5%の計画は、最大2.5%の文書にエラーが含まれる可能性があることを明示的に許容します。後工程で単発のエラーを発見した場合は修正して先に進んでください。サンプルが見逃した体系的なエラーパターンを発見した場合は、サンプリング計画の調整が必要です。AQL閾値がユースケースに対して緩すぎるか、層の境界が間違っている可能性があります。
この確認プロセスは自動化できますか?
部分的には可能です。自動化された健全性チェック(ステップ2)は、Excelの数式と条件付き書式で実行できます。サンプル選択(ステップ3-4)は、=RAND()や=RANDBETWEEN()でランダム化できます。しかし、実際の文書ごとの比較(原本を開いて抽出データと照合する作業)は、現時点では人間の目が必要です。AIによる検証ツールも存在しますが、AIの不確実性が新たな層として加わるため、独立した検証の目的が損なわれます。
定期バッチの検証はどのくらいの頻度で行うべきですか?
週次または月次のバッチの場合、実績ができるまでは毎回検証してください。同じ閾値で5回以上の連続合格が確認できたら、3回に1回のスポットチェックに減らせます。ただし、新しい文書タイプ、新しいサプライヤー、新しい抽出設定、ツールのアップデートなど、何か変更があった後の最初のバッチは必ず検証してください。検証を完全にやめた瞬間に、静かなエラーがすり抜けることになります。
正直な真実
どんな文書抽出ツールにも、AI搭載であろうとなかろうと、エラー率は存在します。良い実装と悪い実装の違いは、エラーが発生するかどうかではなく、それにどう対処するかです。
検証計画なしに500件の請求書を処理する会社はギャンブルをしています。すべての請求書のすべてのフィールドをチェックするために40時間を費やす会社は、無駄に金を燃やしています。AQLしきい値、文書タイプ別の層別サンプリング、フィールド優先度検査を組み合わせた構造化サンプリング手法を採用する会社は、プロフェッショナルに運営しています。自社のエラー率を把握し、バッチをいつ受け入れ、いつ拒否するかを判断し、そのプロセスを証明する監査証跡を持っています。
このフレームワークが提供するのは、そのプロフェッショナルな中間点です。これはISO 2859-1(製造業における品質判断を何十年にもわたって規定してきた規格)を応用したものです。なぜなら、その計算式は有効だからです。そして、使用する抽出ツールに関係なく適用できます。この手法はツールに依存しません。変化するのは期待されるエラープロファイルのみです。
次のバッチで試してみてください。ランダムに50件の文書を選び、30分かけてチェックしてください。その結果が、抽出品質について知らなかった何かを教えてくれるかもしれません。