Cómo verificar una extracción por lotes de 500 documentos
Sin revisar cada fila
Acaba de procesar 500 facturas con una herramienta de extracción con IA. El resultado se ve limpio: una tabla de Excel con todas las filas completas y totales que parecen razonables. Pero surge la duda: ¿y si algo está mal en silencio? Un importe mal leído en la fila 147. Una partida faltante en la fila 323. Un formato de fecha que invirtió mes y día en algún punto intermedio. No puede revisar las 500. Pero tampoco puede confiar a ciegas. Este artículo le ofrece un camino intermedio: tres métodos de muestreo comprobados, adaptados del control de calidad industrial, más una lista de verificación práctica que toma 30 minutos, no 30 horas.
Conclusiones clave
- 20 horas para verificar manualmente 500 documentos — y después del documento 200, su tasa de detección de errores baja lo suficiente como para que las 300 revisiones restantes le compren falsa confianza, no seguridad.
- Las tasas de error de comparación visual humana alcanzan del 3 al 5 por ciento en condiciones ideales y se degradan con la fatiga — por eso los auditores profesionales usan el muestreo estadístico, no la revisión al 100 por ciento, como metodología estándar.
- Las tablas de muestreo ISO 2859-1 — el mismo estándar que usan las fábricas para inspeccionar 50 unidades de 10 000 — le permiten inspeccionar 50 documentos en 30 minutos y tomar una decisión de aprobación o rechazo estadísticamente defendible con un rastro de auditoría.
Por qué la verificación es un problema en sí mismo
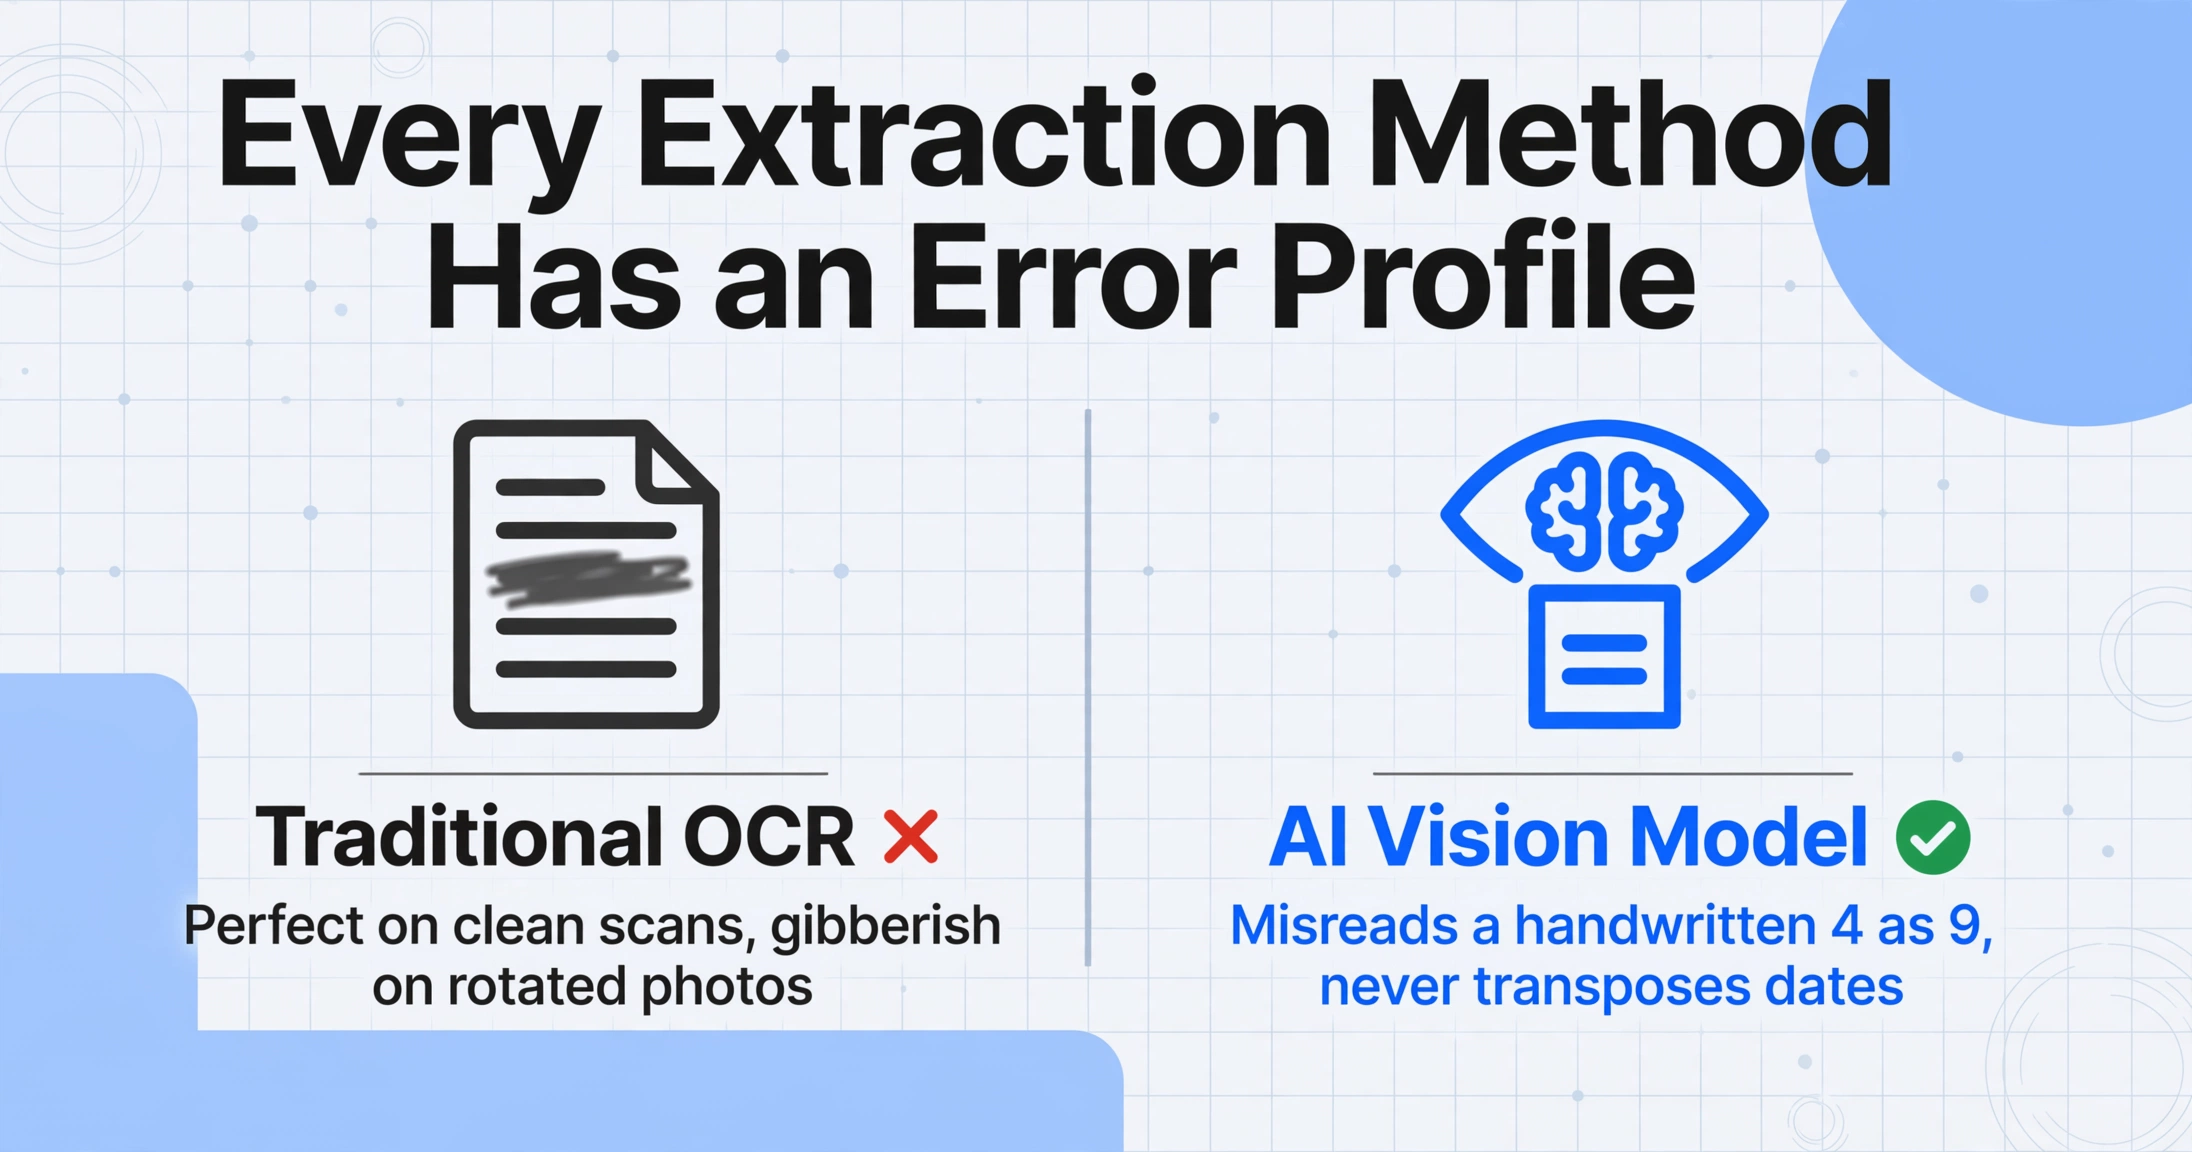
El secreto poco conocido de la extracción de documentos — ya sea que use OCR con plantillas, modelos de visión con IA o el ingreso manual tradicional — es que ningún método es 100% preciso. Ni la IA. Ni los empleados de captura de datos. Ni una integración ERP de primera. La diferencia entre las herramientas es el perfil de error: qué tipo de errores cometen, con qué frecuencia y en qué campos.
Un modelo de visión con IA como ImageToTable.ai podría leer mal un "4" manuscrito como un "9" en un albarán, pero nunca transpondrá accidentalmente las fechas de sus facturas y los números de sus órdenes de compra como podría hacerlo una persona cansada. El OCR tradicional podría acertar cada carácter en un PDF escaneado impecable, y luego producir texto sin sentido en una foto de recibo ligeramente rotada. Cada herramienta tiene patrones que se pueden aprender.
Pero esta es la verdad incómoda: no puede saber si una extracción específica es correcta sin revisar el documento fuente. Ninguna puntuación de confianza, métrica de precisión o garantía del proveedor le dice si el total de esa factura es correcto. La pregunta no es "¿puedo confiar en la herramienta?" — es "¿cuánto necesito verificar y cómo lo hago de manera eficiente?"
Ahí es donde entra la metodología de control de calidad, que toma prestado de una disciplina que la mayoría de los oficinistas nunca tocan: muestreo de aceptación estadístico. La misma lógica que permite a una fábrica inspeccionar 50 unidades de un envío de 10,000 unidades y decidir si todo el lote pasa es la lógica que necesita para sus resultados de extracción.
Método 1 — Muestreo estadístico (AQL)
El Límite de Calidad Aceptable (AQL) es un estándar ISO 2859-1 utilizado durante décadas en la fabricación para responder exactamente a esta pregunta: "Tengo un lote grande. No puedo inspeccionarlo todo. ¿Cuántos debo inspeccionar y cómo decido si el lote es lo suficientemente bueno?"
La lógica se transfiere directamente a la verificación de extracción de documentos. Usted trata cada documento de su lote como una "unidad", define qué cuenta como un "defecto" (un valor de campo incorrecto, una partida faltante, un monto mal leído) y aplica un plan de muestreo.
Cómo aplicar AQL a la verificación de extracción
| Tamaño del lote (documentos) | Tamaño de la muestra a inspeccionar | AQL 2.5% — Aceptar | AQL 2.5% — Rechazar |
|---|---|---|---|
| 50 | 13 | ≤1 error | ≥2 errores |
| 200 | 32 | ≤2 errores | ≥3 errores |
| 500 | 50 | ≤2 errores | ≥3 errores |
| 1,000 | 80 | ≤5 errores | ≥6 errores |
| 5,000 | 200 | ≤10 errores | ≥11 errores |
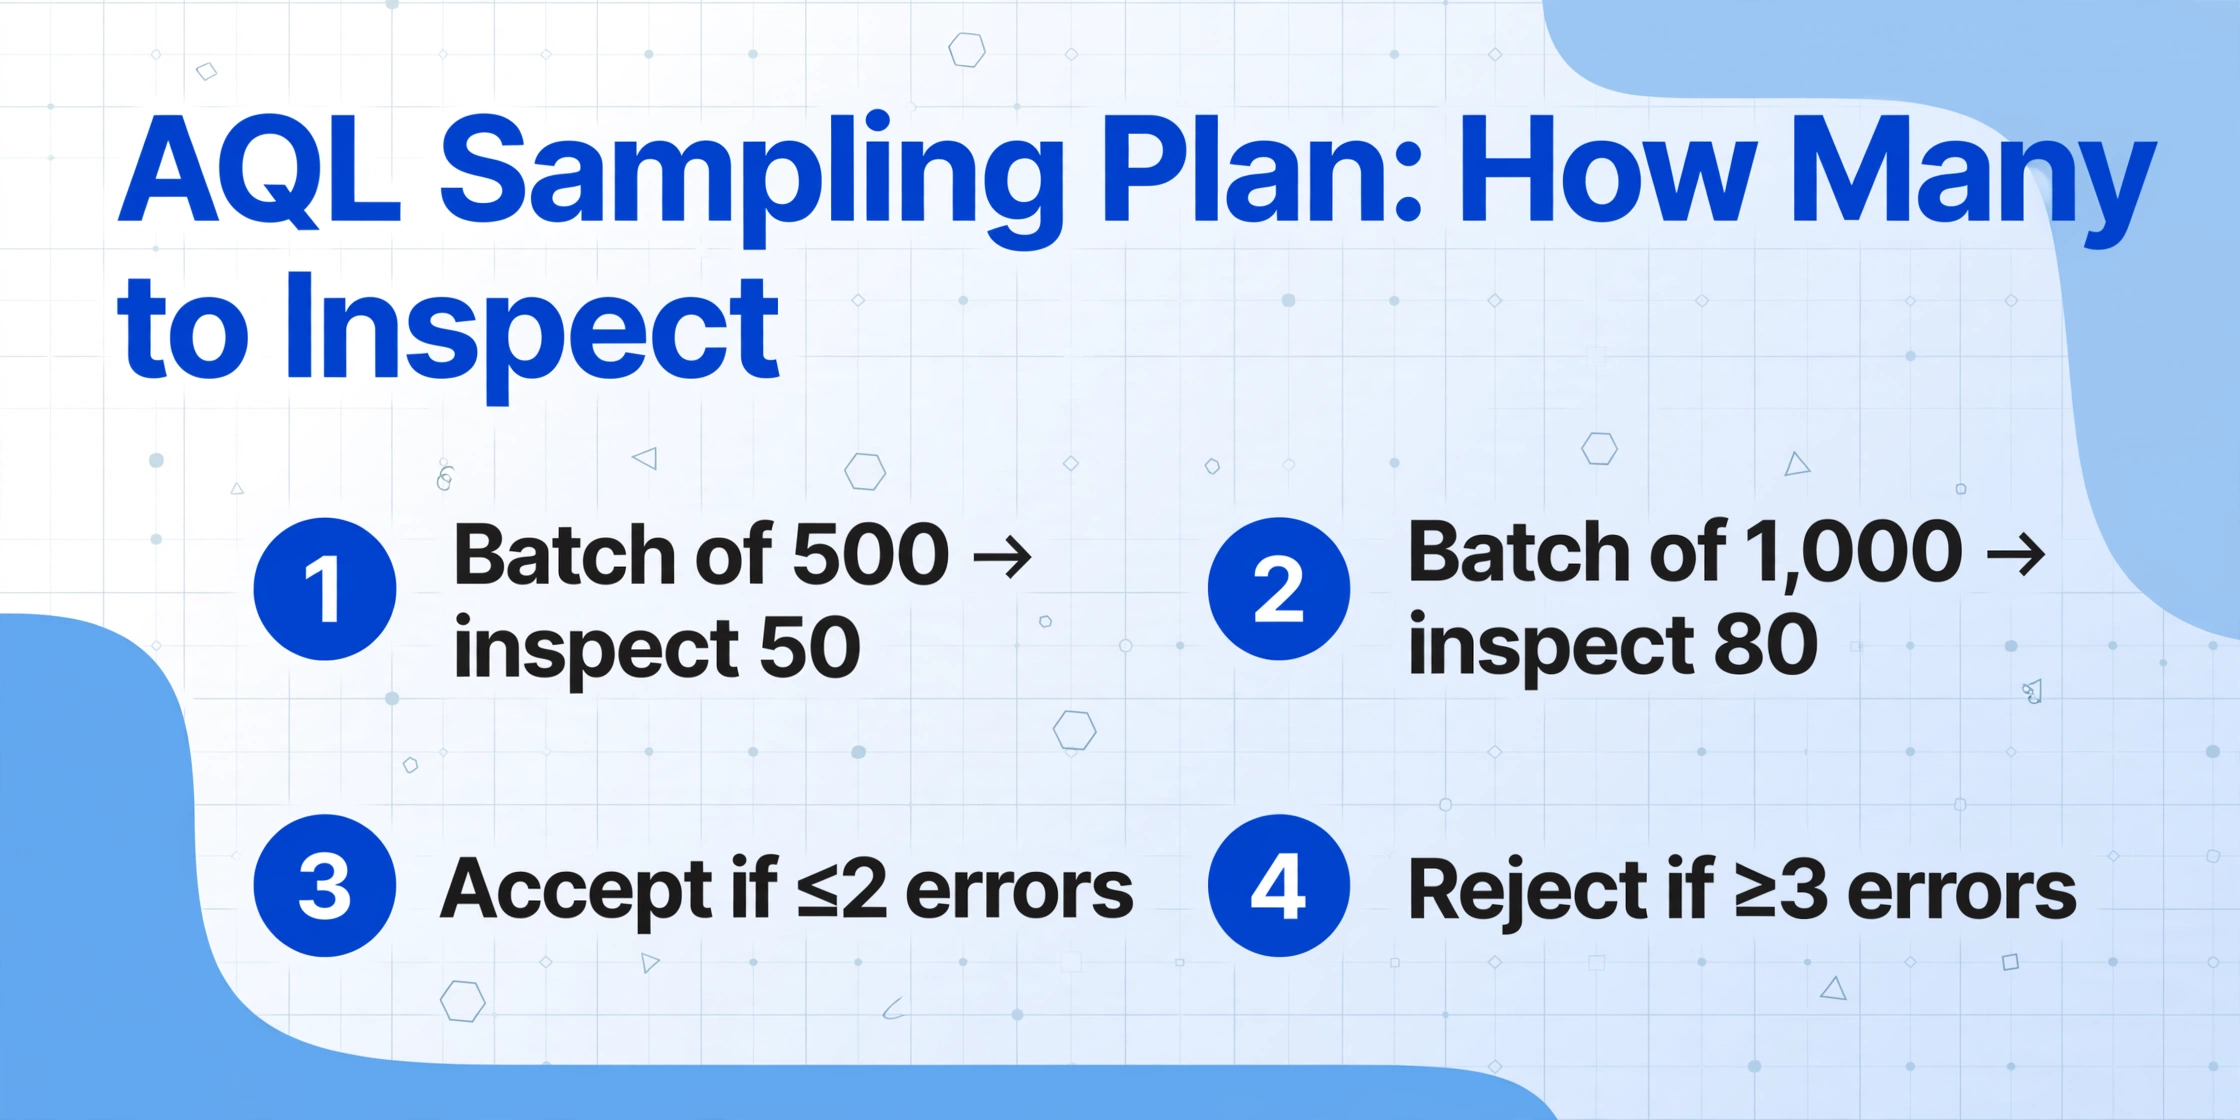
Plan de muestreo AQL 2.5% simplificado basado en ISO 2859-1 (Nivel de inspección general II). Tamaños de muestra redondeados para uso práctico.
Así es como se usa en la práctica:
Paso 1: Tome su lote de 500 documentos extraídos. Usando un generador de números aleatorios (la función =RANDBETWEEN(1,500) de Excel funciona bien), seleccione 50 documentos para inspeccionar.
Paso 2: Para cada documento seleccionado, abra el archivo original junto con los datos extraídos. Verifique los campos clave: número de factura, fecha, monto total, nombre del proveedor. Marque si cada campo es correcto o tiene un error. Los "errores" incluyen datos faltantes, valores incorrectos, corrupción de formato (fechas que parecen números de serie) y datos alucinados que no existen en el documento original.
Paso 3: Sume el número total de documentos con uno o más errores. Si ≤2 documentos tienen errores, el lote pasa — puede liberar los datos con confianza. Si ≥3 documentos tienen errores, el lote falla — necesita reinspectionar una muestra más grande, corregir el proceso de extracción o escalar a revisión humana para todo el lote.
Por qué funciona: Un AQL del 2,5% significa que está aceptando una tasa de defectos tolerable máxima del 2,5% en todo el lote. Para documentos financieros como facturas y órdenes de compra, este es un umbral práctico — mucho más bajo que la mayoría de las tasas de error de entrada manual de datos (los puntos de referencia de la industria sitúan la captura manual en tasas de error del 3–5%), sin exigir el rigor poco práctico de una tolerancia del 0%.
Método 2 — Muestreo estratificado por tipo de documento
El AQL funciona bien cuando todos los documentos del lote son aproximadamente del mismo tipo. Pero los lotes del mundo real rara vez son uniformes. Su "lote de 500" podría incluir 300 facturas de proveedores, 120 órdenes de compra y 80 recibos de entrega — y aquí está la clave: la precisión varía según el tipo de documento.
Las facturas de proveedores importantes con diseños consistentes (piense en facturas de Amazon Business o proveedores de material de oficina) tendrán una mayor precisión de extracción que los recibos de entrega manuscritos de las obras. Las órdenes de compra con tablas mecanografiadas y limpias se comportarán de manera diferente a las facturas contractuales de varias páginas con líneas de detalle densas. Mezclarlas en una sola muestra AQL corre el riesgo de pasar por alto problemas en el subconjunto más pequeño y de mayor riesgo.
El muestreo estratificado resuelve esto dividiendo su lote en estratos (grupos) según el tipo de documento y muestreando cada grupo de forma independiente. Esto garantiza que cada clase de documento reciba su propio control de calidad.
| Estrato (tipo de documento) | Cantidad | Tamaño de la muestra | Aceptar (≤ N errores) | Rechazar (≥ N errores) |
|---|---|---|---|---|
| Facturas de proveedores (diseño limpio) | 300 | 32 | ≤2 | ≥3 |
| Órdenes de compra (mecanografiadas, estructuradas) | 120 | 20 | ≤1 | ≥2 |
| Recibos de entrega (manuscritos, variados) | 80 | 13 | ≤1 | ≥2 |
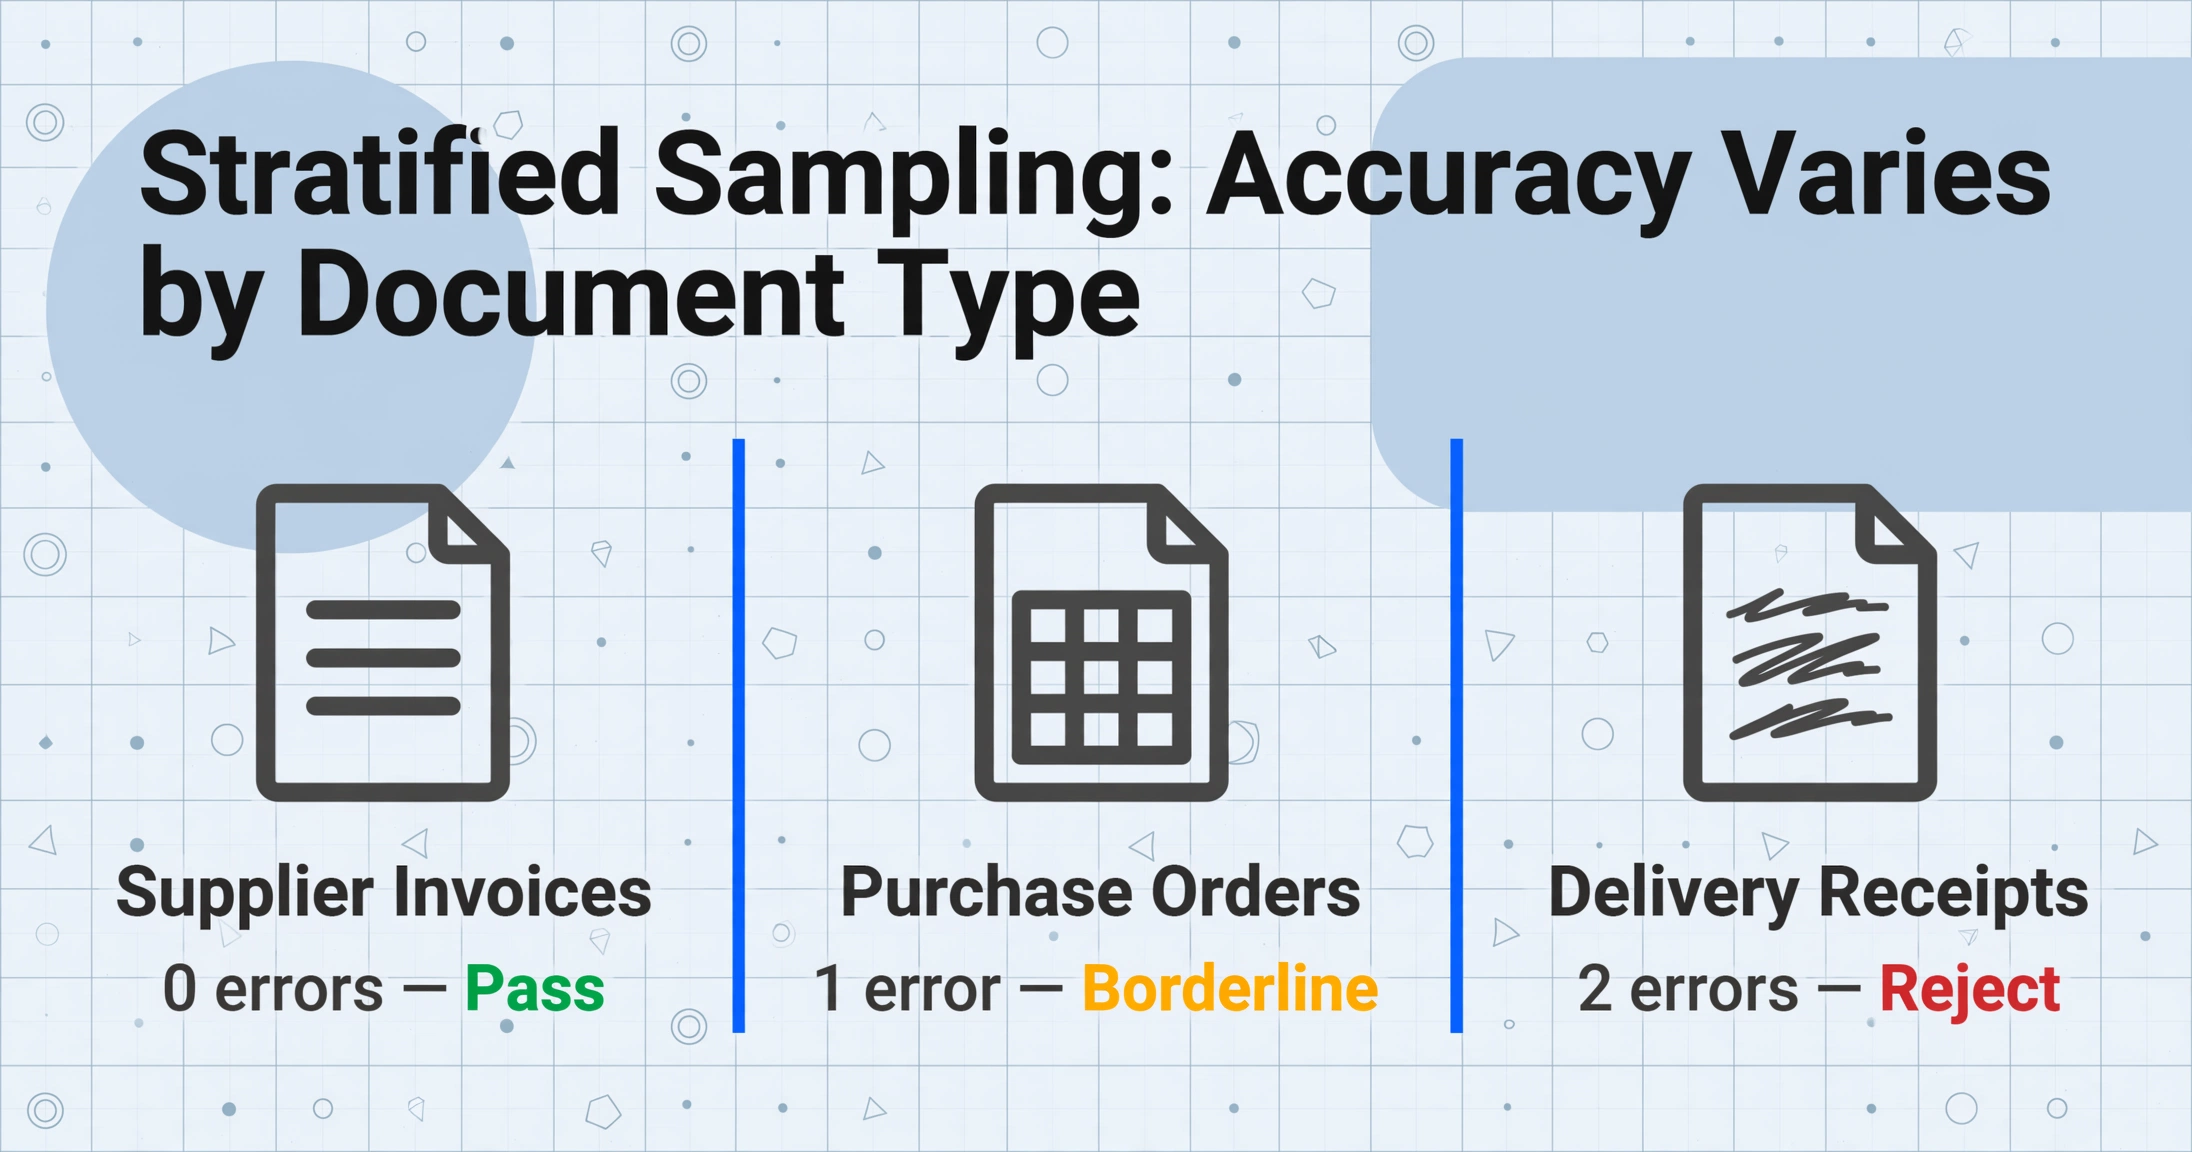
Muestreo estratificado aplicado a un lote mixto de 500 documentos de tres tipos.
Con el muestreo estratificado, podría descubrir que las facturas de proveedores pasan fácilmente (0 errores en la muestra), las órdenes de compra tienen un problema menor (1 error — en el límite), pero los recibos de entrega manuscritos no superan la muestra (2 errores — rechazar). Eso le indica exactamente dónde centrar sus recursos de revisión manual: solo los recibos de entrega necesitan una revisión completa, no todo el lote. Se ahorró horas de verificación en las facturas y las órdenes de compra, e identificó el área problemática real con precisión quirúrgica.
Para implementar esto, separe su resultado de extracción en pestañas u hojas de cálculo por tipo de documento antes del muestreo. Si su herramienta de extracción añade una columna de "tipo de documento" o "nombre de archivo de origen" — como hace ImageToTable.ai en modo de lote — esta división toma segundos.
Método 3 — Muestreo por prioridad de campo
El tercer método invierte la lógica: en lugar de muestrear documentos completos, usted apunta a campos específicos con diferentes tasas de inspección. No todos los datos son iguales. Un total de factura de $149,230.00 que difiera por $1,000 es un problema real. Que el campo "Dirección de envío" difiera por un carácter probablemente no lo sea.
El muestreo por prioridad de campo asigna cada campo a uno de tres niveles de inspección:
| Nivel | Campos | Tasa de inspección | Por qué |
|---|---|---|---|
| Nivel 1 — 100% | Total de factura, montos de partidas, cantidades, fechas, número de factura, número de orden de compra, montos de impuestos | Cada documento | Estos alimentan pagos, conciliaciones y cumplimiento. Un error aquí tiene impacto financiero directo. |
| Nivel 2 — Muestreo | Nombre del proveedor, dirección, descripciones de partidas, precios unitarios (cuando no son el factor del total) | Muestra aleatoria del 10–20% | Los errores aquí importan pero rara vez causan pérdidas financieras. Afectan la precisión de informes y la capacidad de búsqueda. |
| Nivel 3 — Solo excepciones | Campos de referencia, notas, códigos internos, avisos de pie de página, números de página | Solo cuando las reglas de validación lo marcan | Estos son informativos. Un número de pie de página incorrecto no tiene impacto comercial. |
El flujo de trabajo práctico: revise los resultados extraídos columna por columna, aplicando la tasa de inspección adecuada para cada nivel. Para los campos del Nivel 1, use el formato condicional de Excel para marcar cualquier cosa sospechosa — totales que no coinciden con las sumas de partidas, fechas en el rango incorrecto, números de factura duplicados. Para el Nivel 2, use =RAND() para marcar un subconjunto aleatorio para verificación visual. Para el Nivel 3, revíselos solo si una regla de validación (como "el campo debe comenzar con INV-") falla.
La belleza de este enfoque es que escala. En un lote de 500 documentos, revisar cada campo del Nivel 1 sigue siendo mucho trabajo — pero enfoca su tiempo en los campos donde los errores cuestan dinero real. Y a medida que gane experiencia con su mezcla de documentos, notará qué campos pertenecen a cada nivel para su flujo de trabajo específico.
Lista de verificación práctica en 6 pasos
Aquí tiene el flujo de trabajo completo, desde el momento en que finaliza la extracción hasta que decide si los datos están listos. Combina los tres métodos en un solo proceso accionable.
Si su lote contiene tipos de documentos mixtos, divídalos en grupos separados. Las facturas van con facturas, los recibos con recibos, las órdenes de compra con órdenes de compra. Cada tipo tiene un perfil de precisión diferente y necesita su propio plan de muestreo.
Antes de revisar cualquier documento, pase sus datos por reglas de validación básicas: =SUM(line items) = total (para detectar discrepancias como las detalladas en nuestra guía de discrepancia matemática en partidas), verifique que todos los números de factura sigan un patrón esperado (INV-#####), marque las fechas fuera de su rango comercial y cuente los campos clave duplicados. Estas comprobaciones detectan alrededor del 30% de los errores sin inspeccionar un solo documento.
Verifique puntualmente totales, fechas, números de factura y cantidades en cada documento. Si el tamaño del lote hace que la inspección al 100% sea poco práctica (por ejemplo, más de 5,000 documentos), reduzca a una muestra estratificada del 20% en el Nivel 1 — pero nunca muestree los campos de Nivel 1 a menos del 20%.
Usando la tabla del Método 1, seleccione su muestra aleatoria para cada estrato. Inspeccione cada campo (todos los niveles) en cada documento muestreado. Si un estrato falla el AQL, escale todo ese grupo — no asuma que la falla fue aleatoria.
Cree un registro simple: fecha del lote, total de documentos, tamaño de muestra por estrato, número de errores encontrados, decisión de aprobado/rechazado por estrato y cualquier acción correctiva tomada. Este registro tiene dos propósitos: cubre su pista de auditoría (importante para flujos de trabajo compatibles con SOX) y le ayuda a detectar tendencias de precisión con el tiempo.
Aprobado — todos los estratos pasan el AQL y las verificaciones de campos de Nivel 1 se ven limpias. Libere los datos. Aprobado condicional — fallas menores en estratos confinadas a campos de bajo impacto. Corrija esos estratos específicos y libere. Rechazado — errores sistémicos en todos los estratos. Rechace el lote y corrija el proceso de extracción antes de volver a ejecutarlo.
Todo el proceso, del Paso 1 al Paso 6, le toma a un operador experimentado unos 30 minutos para un lote de 500 documentos, frente a más de 20 horas de verificación manual al 100%. La disyuntiva no es "precisión frente a velocidad": es que se obtiene el 95% de la confianza con el 2,5% de la inversión de tiempo, y se sabe exactamente qué documentos requieren una atención más detallada.
Cuando Verificar No Es Suficiente
El muestreo de verificación le indica si un lote es lo bastante bueno. No corrige la calidad subyacente de la extracción. Si observa ciertos patrones en los resultados de verificación, la respuesta correcta no es "muestrear de forma más agresiva", sino corregir el proceso de extracción en fases anteriores.
Esté atento a estas señales:
- Fallos sistemáticos de campos: Todos los documentos de la muestra tienen el mismo campo incorrecto; por ejemplo, la columna "Total" contiene sistemáticamente el subtotal en lugar del total general. Esto no es ruido aleatorio; es un problema de asignación de columnas. Revise su configuración de extracción o considere cómo gestiona su herramienta los campos de totales.
- Errores agrupados en una fuente de documentos específica: Todos los errores provienen de escaneos realizados con un teléfono inteligente concreto o de los PDF de un proveedor específico. Esto indica que el problema está en la calidad del documento en fases anteriores, no en el propio modelo de extracción.
- Corrupción a nivel de formato: Fechas que aparecen como números de serie de Excel, valores de moneda sin símbolos, tablas de líneas de pedido que se colapsan en celdas individuales. Estos problemas suelen deberse a celdas combinadas, estructuras de tabla inconsistentes o documentos fuente con formato complejo; problemas que tratamos en profundidad en nuestra guía de extracción de celdas combinadas.
- Fallos persistentes de AQL en varios lotes: Si tres lotes consecutivos no superan el muestreo, tiene un problema de precisión sistémico que un nuevo muestreo no resolverá. En este punto, la respuesta honesta es: la herramienta o configuración actual no cumple su umbral de calidad. Es hora de evaluar un enfoque diferente.
Saber cuándo escalar es tan importante como saber muestrear. Una herramienta como ImageToTable.ai que admite procesamiento por lotes con múltiples modos de extracción le ofrece opciones: cambiar del modo A Tabla al modo A Word, ajustar las definiciones de columnas o probar diferentes modos de reconocimiento puede resolver problemas persistentes sin cambiar de herramienta por completo.
Pero si ha probado ajustes y la tasa de error sigue por encima de su umbral de AQL, la decisión correcta es reconocer la limitación, no bajar sus estándares. Algunos tipos de documentos realmente necesitan un enfoque diferente, y eso no es un fallo de ninguna herramienta; es una comprensión realista de lo que la extracción de IA actual puede y no puede hacer.
Preguntas Frecuentes
¿Cómo elijo entre muestreo AQL, estratificado y por prioridad de campo?
Usa los tres: son complementarios, no alternativas. Empieza con prioridad de campo para proteger tus campos financieros. Usa muestreo estratificado para manejar tipos de documento mixtos. Aplica AQL como base estadística para decisiones de aprobado/rechazo. La lista anterior combina los tres en un solo flujo de trabajo.
¿La verificación al 100% no da mejores resultados que el muestreo?
En teoría, sí. En la práctica, verificar 500 documentos al 100% es tan lento y tedioso que introduce su propio problema de calidad: fatiga del revisor. Tras revisar 200 documentos, la tasa de detección de errores de la mayoría cae drásticamente. Una muestra disciplinada del 10% hecha con cuidado suele detectar más errores que una revisión al 100% apresurada por agotamiento. Por eso los auditores profesionales usan muestreo: no es pereza, es metodología.
¿Qué pasa si mi lote pasa AQL pero luego encuentro errores?
Eso no es un fallo del método, es un resultado estadístico correcto. Un plan AQL 2.5% acepta explícitamente que hasta el 2.5% de los documentos pueda tener errores. Si encuentras un error aislado aguas abajo, corrígelo y sigue adelante. Si descubres un patrón sistémico de errores que la muestra no detectó, indica que tu plan de muestreo necesita ajustes: o tu umbral AQL es demasiado laxo para tu caso de uso, o los límites de tus estratos son incorrectos.
¿Puedo automatizar algo de este proceso de verificación?
Parcialmente. Las comprobaciones automáticas de cordura (Paso 2) pueden ejecutarse en Excel con fórmulas y formato condicional. La selección de la muestra (Pasos 3-4) se puede aleatorizar con =ALEATORIO() o =ALEATORIO.ENTRE(). Pero la comparación documento por documento — abrir el original y compararlo con los datos extraídos — requiere ojos humanos por ahora. Existen herramientas de verificación con IA, pero introducen una segunda capa de incertidumbre de IA, lo que contradice el propósito de una verificación independiente.
¿Con qué frecuencia debo verificar lotes recurrentes?
Para lotes semanales o mensuales, verifica cada lote hasta tener un historial. Una vez que veas 5+ lotes consecutivos que pasen AQL con el mismo umbral, puedes reducir a verificaciones puntuales cada tres lotes. Pero verifica siempre el primer lote después de cualquier cambio: nuevo tipo de documento, nuevo proveedor, nueva configuración de extracción o actualización de herramienta. En el momento en que dejes de verificar por completo, un error silencioso se colará.
La Verdad Sincera
Toda herramienta de extracción de documentos, con IA o sin ella, tiene un margen de error. La diferencia entre una buena implementación y una mala no es si ocurren errores, sino qué haces al respecto.
Una empresa que procesa 500 facturas sin un plan de verificación está apostando. Una que dedica 40 horas a revisar cada campo de cada factura está quemando dinero. Una que utiliza una metodología de muestreo estructurado —combinando umbrales AQL, muestreo estratificado por tipo de documento e inspección por prioridad de campo— opera de forma profesional. Conoce su tasa de error, sabe cuándo aceptar un lote y cuándo rechazarlo, y tiene una pista de auditoría que respalda su proceso.
Ese punto medio profesional es lo que este marco te ofrece. Está adaptado de la norma ISO 2859-1 —un estándar que ha regido las decisiones de calidad en la fabricación durante décadas— porque las matemáticas funcionan. Y se aplica independientemente de la herramienta de extracción que uses. El método es independiente de la herramienta; solo cambia el perfil de error esperado.
Pruébalo en tu próximo lote. Elige 50 documentos al azar. Dedica 30 minutos a revisarlos. Mira si los resultados te dicen algo que no sabías sobre la calidad de tu extracción.