Como verificar uma extração em lote de 500 documentos
Sem conferir cada linha
Você acabou de processar 500 notas fiscais com uma ferramenta de extração por IA. O resultado parece limpo — uma tabela Excel com todas as linhas preenchidas, totais que parecem razoáveis. Mas o pensamento surge: e se algo estiver silenciosamente errado? Um valor lido incorretamente na linha 147. Um item ausente na linha 323. Um formato de data que inverteu mês e dia em algum lugar no meio. Você não pode conferir todos os 500. Mas também não pode confiar cegamente neles. Este artigo oferece um caminho intermediário — três métodos comprovados de amostragem adaptados do controle de qualidade industrial, além de um checklist prático que leva 30 minutos, não 30 horas.
Principais conclusões
- 20 horas para verificar manualmente 500 documentos — e após o documento 200, sua taxa de detecção de erros cai o suficiente para que as 300 verificações restantes comprem falsa confiança, não segurança.
- A taxa de erro humano na comparação visual chega a 3 a 5 por cento em condições ideais e piora com a fadiga — por isso auditores profissionais usam amostragem estatística, e não revisão de 100%, como metodologia padrão.
- As tabelas de amostragem ISO 2859-1 — o mesmo padrão que fábricas usam para inspecionar 50 unidades de 10.000 — permitem inspecionar 50 documentos em 30 minutos e tomar uma decisão de aprovação ou reprovação estatisticamente defensável, com trilha de auditoria.
Por que a verificação é um problema à parte
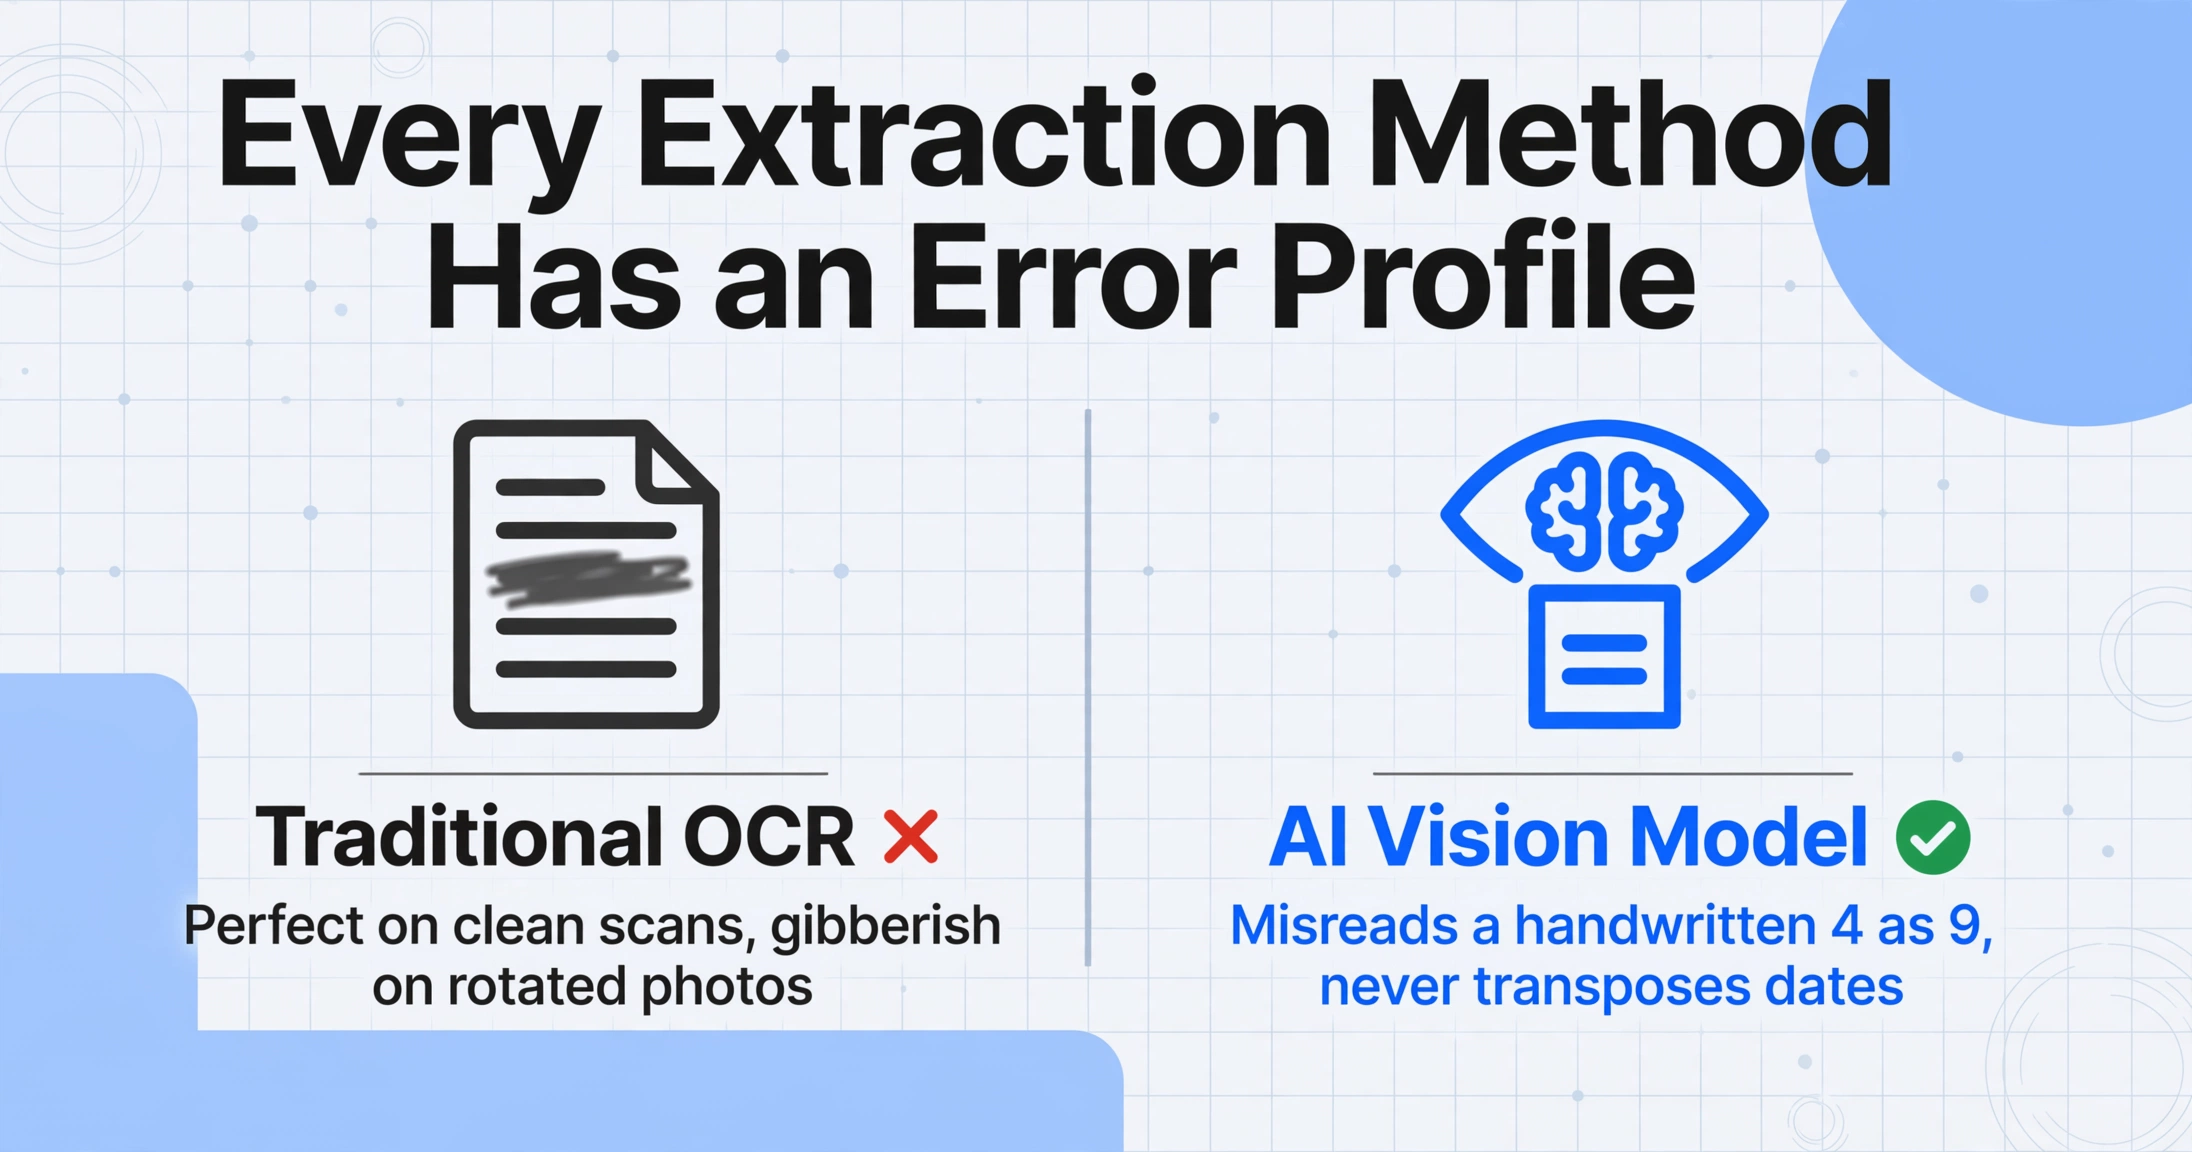
O segredo sujo da extração de documentos — seja com OCR por modelo, modelos de visão de IA ou digitação manual à moda antiga — é que nenhum método é 100% preciso. Nem IA. Nem digitadores humanos. Nem uma integração de ERP sofisticada. A diferença entre as ferramentas é o perfil de erro: que tipo de erro cometem, com que frequência e em quais campos.
Um modelo de visão de IA como o ImageToTable.ai pode ler errado um "4" manuscrito como "9" em um aviso de entrega — mas nunca vai transpor acidentalmente suas datas de fatura e números de pedido como um humano cansado poderia. O OCR tradicional pode acertar cada caractere em um PDF escaneado impecável e depois produzir algo sem sentido em uma foto levemente rotacionada de um recibo. Cada ferramenta tem padrões que você pode aprender.
Mas aqui está a verdade desconfortável: você não pode saber se uma extração específica está correta sem olhar o documento de origem. Nenhuma pontuação de confiança, métrica de precisão ou garantia do fornecedor diz se o total daquela fatura está certo. A pergunta não é "posso confiar na ferramenta?" — é "quanto preciso verificar e como fazer isso com eficiência?"
É aí que entra a metodologia de controle de qualidade, que vem de uma disciplina que a maioria dos trabalhadores de escritório nunca toca: amostragem estatística de aceitação. A mesma lógica que permite a uma fábrica inspecionar 50 unidades de um lote de 10.000 e decidir se o lote inteiro passa é a lógica que você precisa para seus resultados de extração.
Método 1 — Amostragem estatística (AQL)
O Limite de Qualidade Aceitável (AQL) é um padrão ISO 2859-1 usado há décadas na fabricação para responder exatamente a esta questão: "Tenho um lote grande. Não posso inspecionar tudo. Quantos devo inspeccionar e como decido se o lote é suficientemente bom?"
A lógica se transfere diretamente à verificação de extração de documentos. Você trata cada documento do lote como uma "unidade", define o que conta como "defecto" (um valor de campo incorreto, uma linha de item ausente, um montante mal lido) e aplica um plano de amostragem.
Como aplicar AQL à verificação de extração
| Tamaño do lote (documentos) | Tamaño da muestra a inspeccionar | AQL 2.5% — Aceitar | AQL 2.5% — Rejeitar |
|---|---|---|---|
| 50 | 13 | ≤1 error | ≥2 erros |
| 200 | 32 | ≤2 erros | ≥3 erros |
| 500 | 50 | ≤2 erros | ≥3 erros |
| 1.000 | 80 | ≤5 erros | ≥6 erros |
| 5.000 | 200 | ≤10 erros | ≥11 erros |
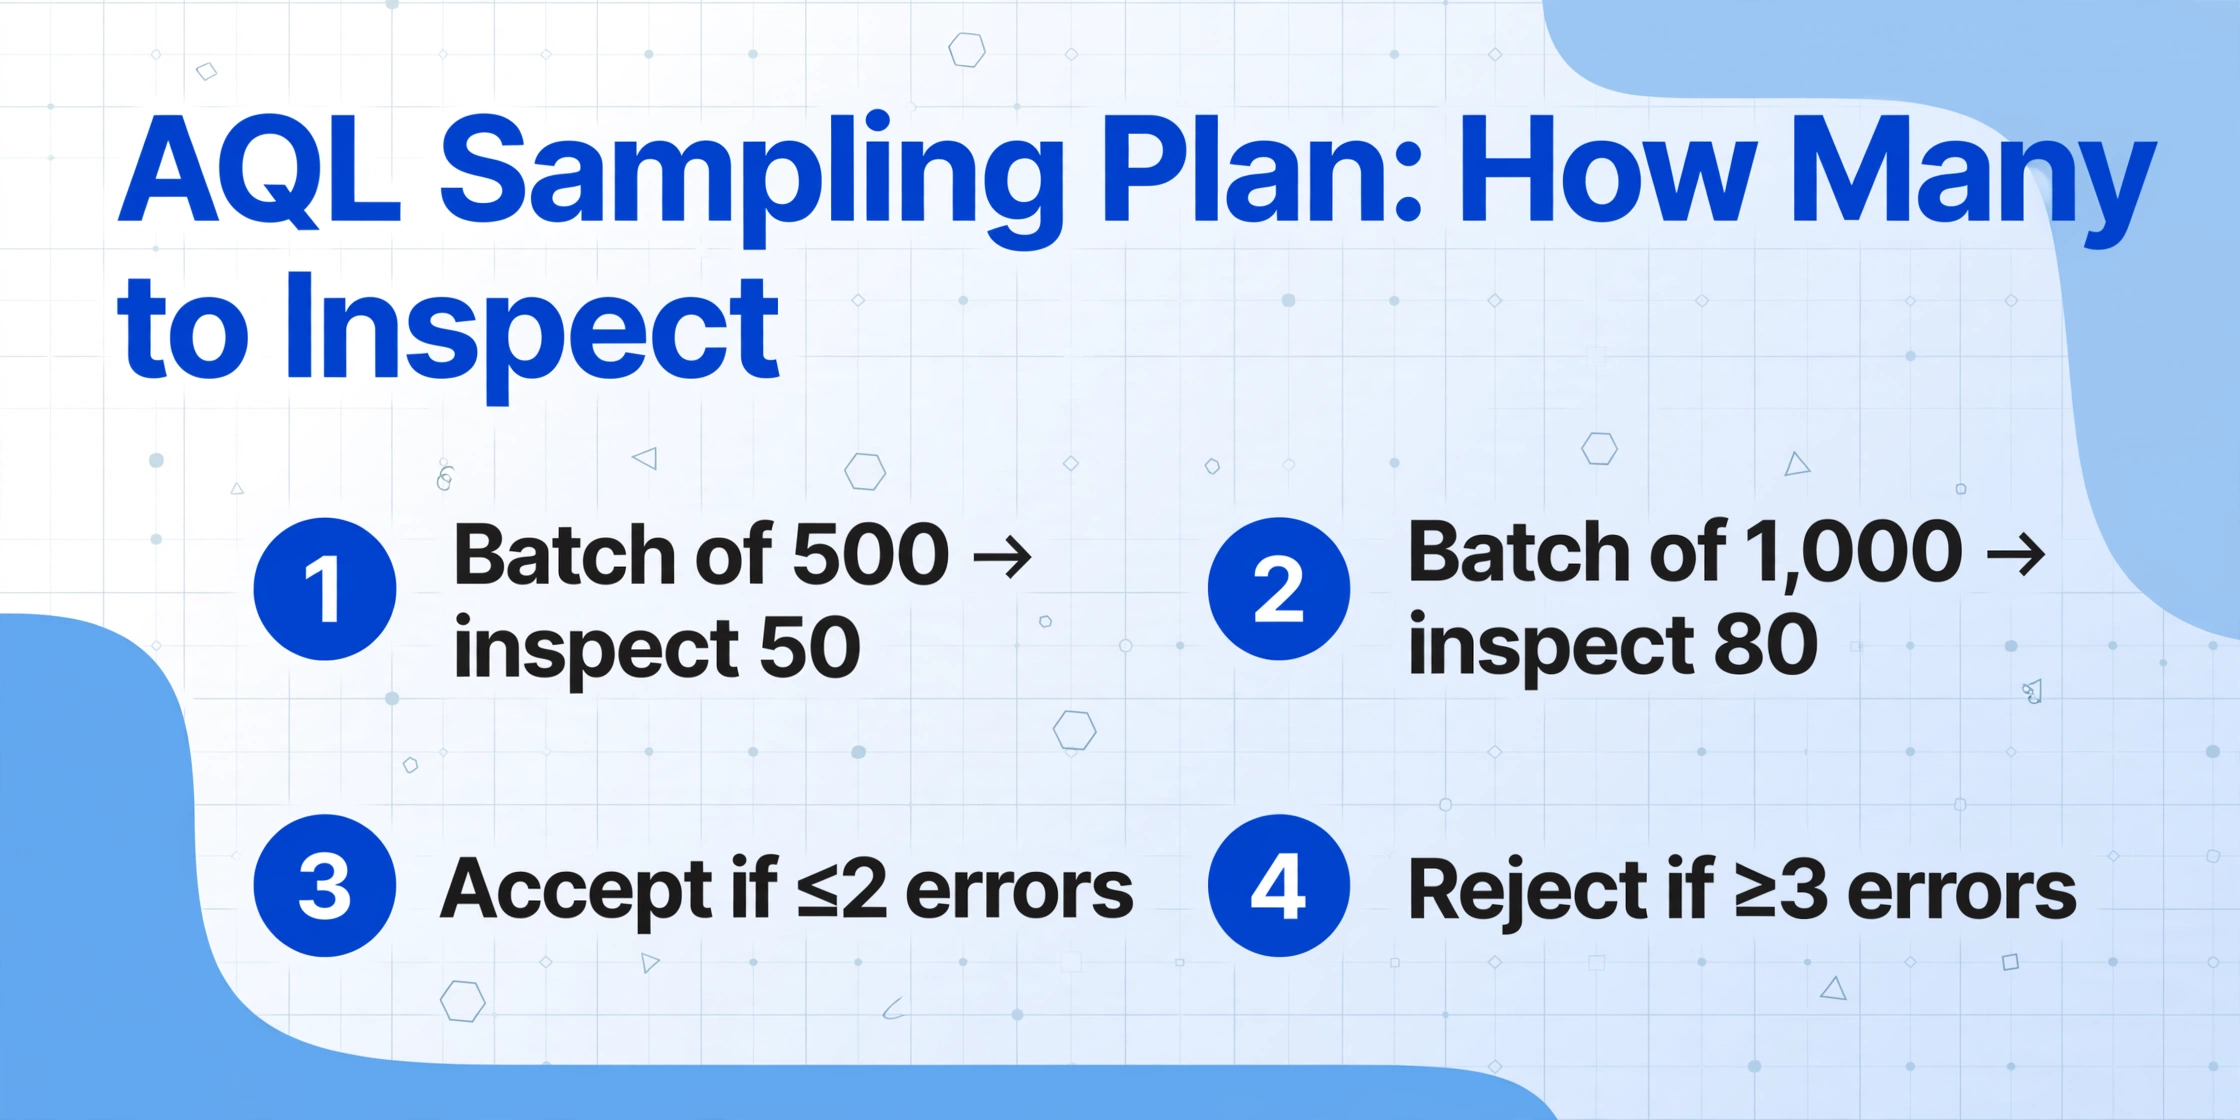
Plano de amostragem AQL 2.5% simplificado baseado em ISO 2859-1 (Nível de Inspeção Geral II). Tamaños de muestra arredondados para uso prático.
Veja como usarlo na prática:
Passo 1: Pegue seu lote de 500 documentos extraídos. Usando um generador de números aleatórios (a função =RANDBETWEEN(1,500) do Excel funciona bem), seleccione 50 documentos para inspeccionar.
Passo 2: Para cada documento seleccionado, abra o arquivo original junto com os dados extraídos. Verifique os campos principais: número de fatura, data, montante total, nome do fornecedor. Marque se cada campo está correto ou tem um error. "Erros" incluem dados ausentes, valores incorretos, corrupção de formato (datas que parecen números de série) e dados alucinados que não existem no documento original.
Passo 3: Some o número total de documentos com um ou mais erros. Se ≤2 documentos têm erros, o lote passa — você pode liberar os dados com confianza. Se ≥3 documentos têm erros, o lote falha — você precisa re-inspeccionar uma muestra maior, corrigir o processo de extração ou escalar à revisão humana para todo o lote.
Por que isso funciona: Um AQL de 2,5% significa que você está aceitando uma taxa de defeito máxima tolerável de 2,5% em todo o lote. Para documentos financeiros, como faturas e ordens de compra, este é um limite prático — muito menor do que a maioria das taxas de erro de entrada manual de dados (os benchmarks do setor colocam a digitação manual em taxas de erro de 3–5%), sem exigir o rigor impraticável de tolerância de 0%.
Método 2 — Amostragem estratificada por tipo de documento
O AQL funciona bem quando todos os documentos no lote são aproximadamente do mesmo tipo. Mas os lotes do mundo real raramente são uniformes. Seu "lote de 500" pode incluir 300 faturas de fornecedores, 120 ordens de compra e 80 recibos de entrega — e aqui está o ponto-chave: a precisão varia de acordo com o tipo de documento.
Faturas de fornecedores importantes com layouts consistentes (pense em faturas do Amazon Business ou fornecedores de materiais de escritório) terão maior precisão de extração do que os recibos de entrega manuscritos de canteiros de obras. Ordens de compra com tabelas limpas e digitadas terão desempenho diferente de faturas de contratos com várias páginas e itens de linha densos. Misturá-los em uma única amostra AQL corre o risco de perder problemas no subconjunto menor e de maior risco.
Amostragem estratificada resolve isso dividindo seu lote em estratos (grupos) com base no tipo de documento e, em seguida, amostrando cada grupo de forma independente. Isso garante que cada classe de documento receba sua própria verificação de qualidade.
| Estratos (tipo de documento) | Quantidade | Tamanho da amostra | Aceitar (≤ N erros) | Rejeitar (≥ N erros) |
|---|---|---|---|---|
| Faturas de fornecedores (layout limpo) | 300 | 32 | ≤2 | ≥3 |
| Ordens de compra (digitadas, estruturadas) | 120 | 20 | ≤1 | ≥2 |
| Recibos de entrega (manuscritos, variados) | 80 | 13 | ≤1 | ≥2 |
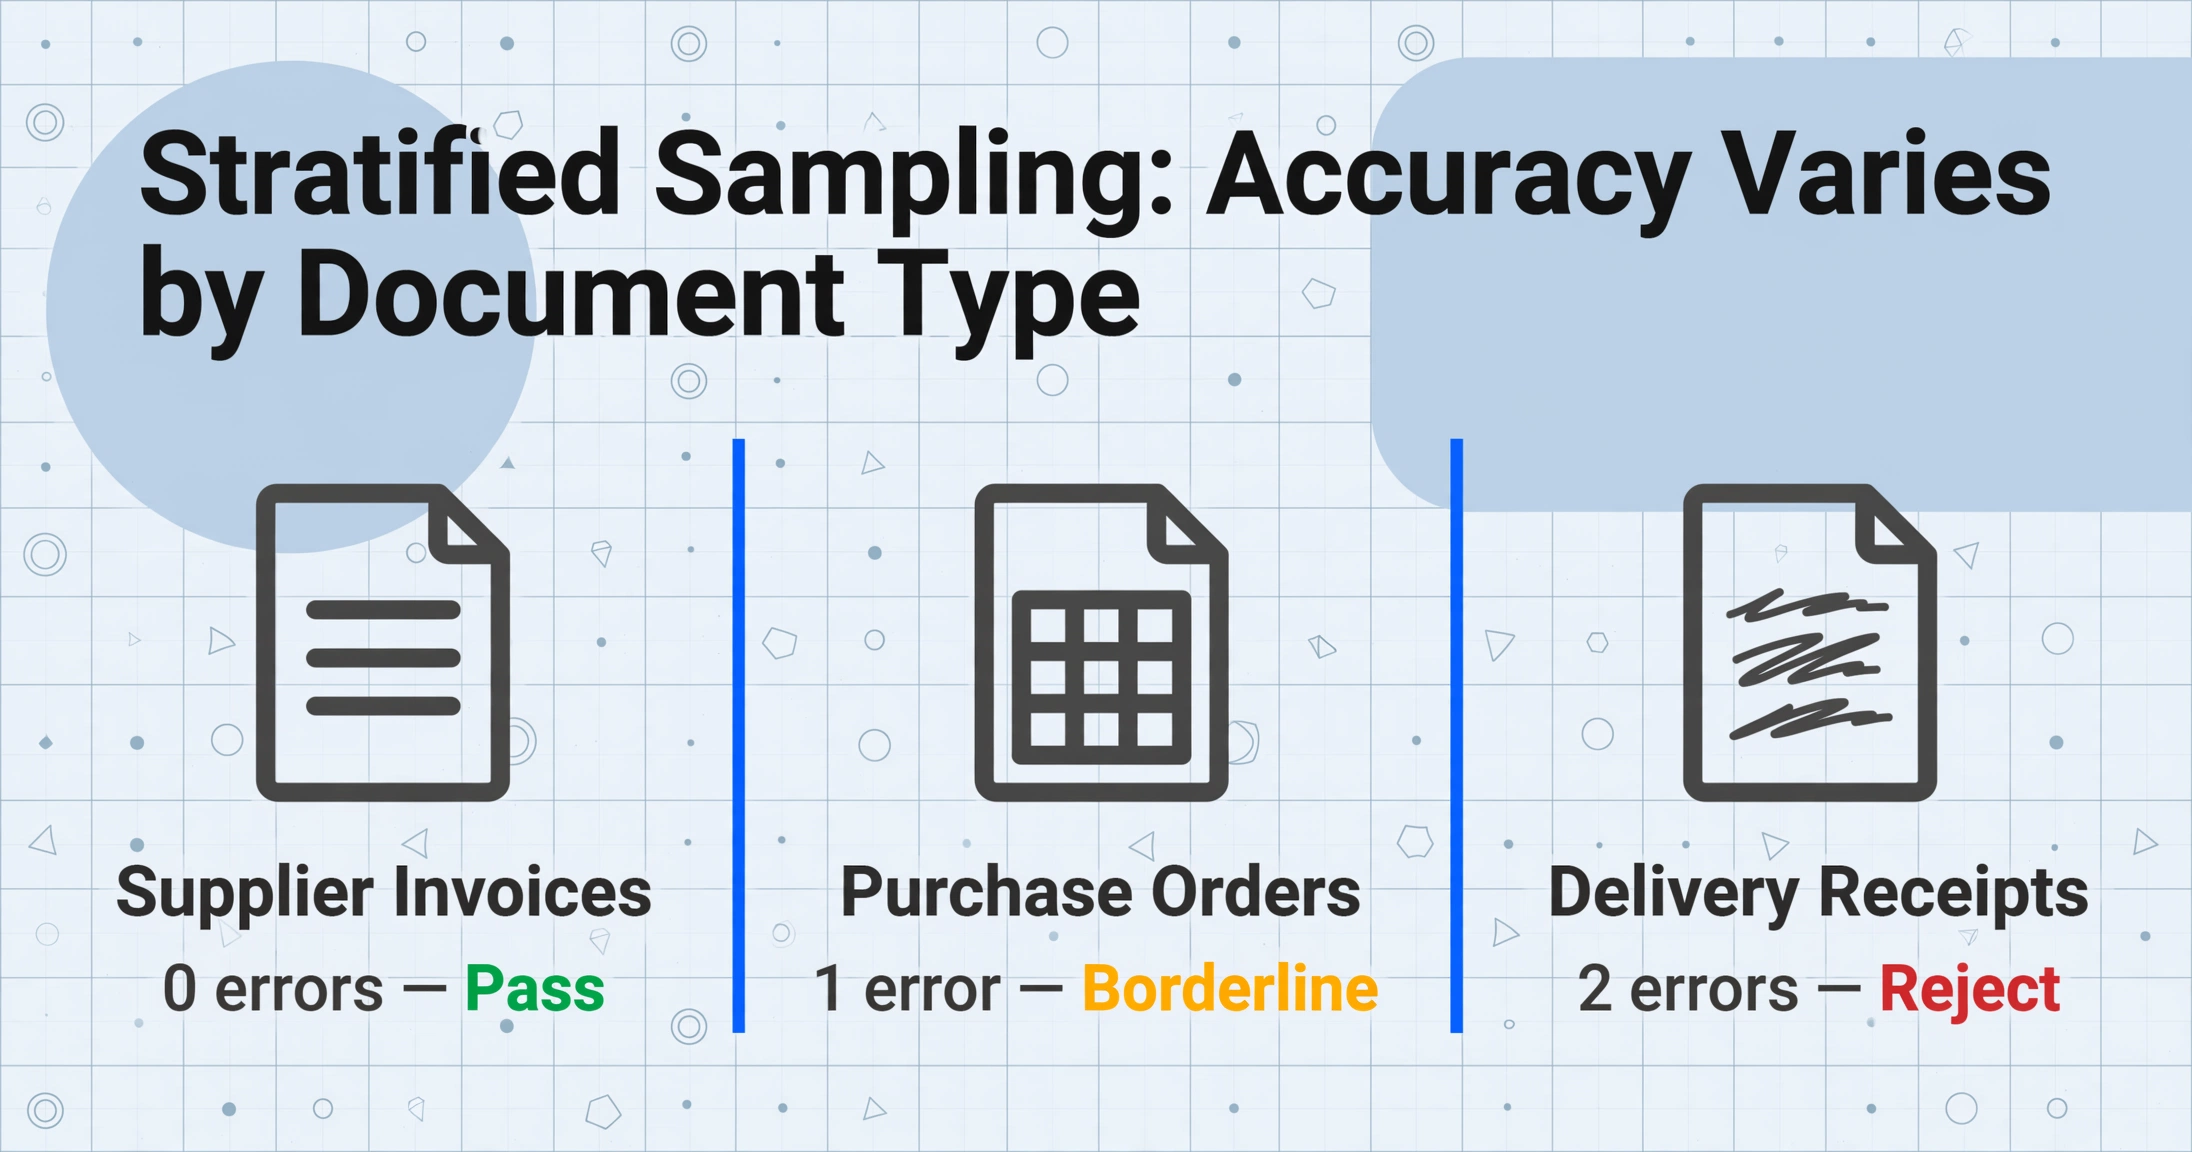
Amostragem estratificada aplicada a um lote misto de 500 documentos em três tipos.
Com a amostragem estratificada, você pode descobrir que as faturas dos fornecedores passam facilmente (0 erros na amostra), as ordens de compra têm um problema menor (1 erro — limítrofe), mas os recibos de entrega manuscritos falham na amostra (2 erros — rejeitar). Isso indica exatamente onde concentrar seus recursos de revisão manual: apenas os recibos de entrega precisam de uma verificação completa, não o lote inteiro. Você economizou horas de verificação nas faturas e ordens de compra e identificou a área problemática real com precisão cirúrgica.
Para implementar isso, separe sua saída de extração em abas ou planilhas por tipo de documento antes da amostragem. Se sua ferramenta de extração adicionar uma coluna "tipo de documento" ou "nome do arquivo de origem" — o que o ImageToTable.ai faz no modo em lote — essa divisão leva segundos.
Método 3 — Amostragem por prioridade de campo
O terceiro método inverte a lógica: em vez de amostrar documentos inteiros, você segmenta campos específicos em diferentes taxas de inspeção. Nem todos os dados são iguais. Um total de fatura de $149.230,00 com diferença de $1.000 é um problema real. O campo "Endereço de remessa" com um caractere errado provavelmente não é.
A amostragem por prioridade de campo atribui cada campo a um de três níveis de inspeção:
| Nível | Campos | Taxa de inspeção | Por quê |
|---|---|---|---|
| Nível 1 — 100% | Total da fatura, valores de itens, quantidades, datas, número da fatura, número do pedido, valores de impostos | Cada documento | Esses alimentam pagamentos, conciliações e conformidade. Um erro aqui tem impacto financeiro direto. |
| Nível 2 — Amostragem | Nome do fornecedor, endereço, descrições de itens, preços unitários (quando não são o principal fator do total) | Amostra aleatória de 10–20% | Erros aqui importam, mas raramente causam perda financeira. Eles afetam a precisão de relatórios e a capacidade de busca. |
| Nível 3 — Somente exceções | Campos de referência, notas, códigos internos, avisos de rodapé, números de página | Apenas quando sinalizados por regras de validação | Esses são informativos. Um número de rodapé errado não tem impacto nos negócios. |
O fluxo de trabalho prático: revise os resultados extraídos coluna por coluna, aplicando a taxa de inspeção adequada para cada nível. Para campos do Nível 1, use a formatação condicional do Excel para sinalizar qualquer coisa suspeita — totais que não correspondem às somas dos itens, datas fora do intervalo, números de fatura duplicados. Para o Nível 2, use =RAND() para marcar um subconjunto aleatório para verificação visual. Para o Nível 3, verifique apenas se uma regra de validação (como "o campo deve começar com INV-") falhar.
A beleza dessa abordagem é que ela escala. Em um lote de 500 documentos, verificar cada campo do Nível 1 ainda é muito trabalho — mas direciona seu tempo para os campos onde erros custam dinheiro de verdade. E conforme você ganha experiência com sua combinação de documentos, notará quais campos pertencem a cada nível no seu fluxo de trabalho específico.
Checklist Prático de Verificação em 6 Etapas
Aqui está o fluxo de trabalho completo, desde o momento em que a extração termina até o momento em que você decide se os dados estão prontos. Ele combina os três métodos em um único processo acionável.
Se o seu lote contiver tipos de documentos mistos, divida-os em grupos separados. Notas fiscais com notas fiscais, recibos com recibos, pedidos de compra com pedidos de compra. Cada tipo tem um perfil de precisão diferente e precisa do seu próprio plano de amostragem.
Antes de examinar qualquer documento, execute seus dados por regras básicas de validação: =SUM(line items) = total (para detectar divergências como as detalhadas no nosso guia de divergência de matemática de itens de linha), verifique se todos os números de nota fiscal seguem um padrão esperado (INV-#####), sinalize datas fora do seu intervalo comercial e conte campos-chave duplicados. Essas verificações detectam cerca de 30% dos erros sem inspecionar um único documento.
Faça uma verificação pontual de totais, datas, números de nota fiscal e quantidades em cada documento. Se o tamanho do lote tornar a inspeção de 100% impraticável (digamos, 5.000+ documentos), reduza para uma amostra estratificada de 20% no Nível 1 — mas nunca amostre campos de Nível 1 com menos de 20%.
Usando a tabela do Método 1, selecione sua amostra aleatória para cada estrato. Inspecione cada campo (todos os níveis) em cada documento amostrado. Se um estrato falhar no AQL, escale esse grupo inteiro — não presuma que a falha foi aleatória.
Crie um registro simples: data do lote, total de documentos, tamanho da amostra por estrato, número de erros encontrados, decisão de aprovação/reprovação por estrato e quaisquer ações corretivas tomadas. Este registro serve a dois propósitos: cobre sua trilha de auditoria (importante para fluxos de trabalho em conformidade com SOX) e ajuda você a identificar tendências de precisão ao longo do tempo.
Aprovado — todos os estratos passam no AQL e as verificações de campos de Nível 1 estão limpas. Libere os dados. Aprovação condicional — falhas menores em estratos confinadas a campos de baixo impacto. Corrija esses estratos específicos e libere. Reprovado — erros sistêmicos entre estratos. Rejeite o lote e corrija o processo de extração antes de executar novamente.
Todo o processo, da Etapa 1 à Etapa 6, leva a um operador experto cerca de 30 minutos para um lote de 500 documentos — em comparação com mais de 20 horas para uma verificação 100% manual. A compensação não é "precisão vs. velocidade" — é que você obtiene 95% da confianza por 2,5% do tempo investido, e você sabe exatamente quais documentos precisam de atenção mais próxima.
Quando a Verificação Não é Suficiente
A amostragem de verificação por pontos diz se um lote é suficientemente bom. Não corrige a qualidade subjacente da extração. Se você observa certos padrões nos resultados de verificação, a resposta correta não é "amostrear de forma mais agressiva" — é corrigir o processo de extração a montante.
Fique atento a estes sinais:
- Falhas sistemáticas de campo: Cada documento na amostra tem o mesmo campo errado — por exemplo, a columna "Total" contém consistentemente o subtotal em lugar do total geral. Isto não é ruido aleatório; é um problema de mapeamento de columna. Verifique sua configuração de extração ou considere como sua ferramenta maneja campos de total.
- Erros agrupados em uma fonte de documento específica: Todos os erros provienen de digitalizaciones feitas em um smartphone específico ou de PDFs de um fornecedor específico. Isto indica que o problema está a montante na qualidade do documento, não no modelo de extração em si.
- Corrupção a nível de formato: Datas que aparecen como números de série do Excel, valores de moeda despojados de símbolos, tabelas de itens de linha que se colapsan em células únicas. Estes problemas são frequentemente causados por células mescladas, estruturas de tabela inconsistentes ou documentos de origem com formatos complexos — problemas que abordamos em profundidade em nosso guía de extração de células mescladas.
- Falhas persistentes de AQL em múltiples lotes: Se três lotes consecutivos falham na amostragem, você tem um problema sistémico de precisão que a reamostragem não resolverá. Neste ponto, a resposta honesta é: a ferramenta ou configuração atual não está cumprindo seu limiar de qualidade. É hora de avaliar uma abordagem diferente.
Saber quando escalar é tão importante como saber amostrear. Uma ferramenta como ImageToTable.ai que suporta processamento em lote com múltiples modos de extração lhe dá opções — cambiar de modo Para Tabela a Para Word, ajustar definições de columna ou experimentar com diferentes modos de reconhecimento pode resolver problemas persistentes sem cambiar de ferramenta por completo.
Mas se você tentou ajustes e a taxa de erro ainda está acima de seu limiar de AQL, a decisão correta é reconhecer a limitação, não baixar seus padrões. Alguns tipos de documento genuinamente necessitan de uma abordagem diferente — e isso não é uma falha de nenhuma ferramenta, é uma compreensão realista do que a extração de IA atual pode e não pode fazer.
Perguntas Frequentes
Como escolher entre amostragem AQL, estratificada e por prioridade de campo?
Use as três — elas são complementares, não alternativas. Comece pela prioridade de campo para proteger seus campos financeiros. Use a amostragem estratificada para lidar com tipos mistos de documentos. Aplique o AQL como base estatística para decisões de aprovação/reprovação. A lista acima combina as três em um único fluxo de trabalho.
A verificação de 100% não dá melhores resultados que a amostragem?
Na teoria, sim. Na prática, verificar 100% de 500 documentos é tão demorado e tedioso que introduz seu próprio problema de qualidade — a fadiga do revisor. Após verificar 200 documentos, a taxa de detecção de erros da maioria das pessoas cai drasticamente. Uma amostra disciplinada de 10% feita com cuidado frequentemente captura mais erros do que uma revisão apressada de 100% feita por exaustão. É pelo mesmo motivo que auditores profissionais usam amostragem: não é preguiça, é metodologia.
E se meu lote passar no AQL, mas eu encontrar erros depois?
Isso não é uma falha do método — é um resultado estatístico correto. Um plano AQL 2,5% aceita explicitamente que até 2,5% dos documentos podem ter erros. Se você descobrir um erro isolado posteriormente, corrija-o e siga em frente. Se descobrir um padrão sistêmico de erros que a amostra não detectou, isso indica que seu plano de amostragem precisa de ajustes — ou seu limite AQL está muito flexível para seu caso de uso, ou seus limites de estratificação estão errados.
Posso automatizar parte deste processo de verificação?
Parcialmente. As verificações de sanidade automatizadas (Etapa 2) podem ser executadas no Excel usando fórmulas e formatação condicional. A seleção da amostra (Etapas 3-4) pode ser aleatória com =RAND() ou =RANDBETWEEN(). Mas a comparação documento por documento — abrir o original e compará-lo com os dados extraídos — ainda requer olhos humanos. Ferramentas de verificação com IA existem, mas introduzem uma segunda camada de incerteza da IA, o que anula o propósito da verificação independente.
Com que frequência devo verificar lotes recorrentes?
Para lotes semanais ou mensais, verifique cada lote até ter um histórico. Depois de ver 5+ lotes consecutivos passarem no AQL no mesmo limite, você pode reduzir para verificações pontuais a cada três lotes — mas sempre verifique o primeiro lote após qualquer mudança: novo tipo de documento, novo fornecedor, nova configuração de extração ou atualização de ferramenta. No momento em que você parar de verificar completamente, um erro silencioso passará despercebido.
A Verdade Sincera
Toda ferramenta de extração de documentos, com ou sem IA, tem uma taxa de erro. A diferença entre uma boa implementação e uma ruim não é se os erros acontecem — é o que você faz com eles.
Uma empresa que processa 500 faturas sem um plano de verificação está apostando. Uma empresa que gasta 40 horas conferindo cada campo de cada fatura está queimando dinheiro. Uma empresa que usa uma metodologia de amostragem estruturada — combinando limites de NQA, amostragem estratificada por tipo de documento e inspeção por prioridade de campo — está operando profissionalmente. Eles conhecem sua taxa de erro, sabem quando aceitar um lote e quando rejeitá-lo, e têm uma trilha de auditoria para comprovar seu processo.
Esse meio-termo profissional é o que este framework oferece. Ele é adaptado da ISO 2859-1 — uma norma que rege decisões de qualidade na manufatura há décadas — porque a matemática funciona. E se aplica independentemente da ferramenta de extração que você usa. O método é neutro em relação à ferramenta; apenas o perfil de erro esperado muda.
Teste no seu próximo lote. Pegue 50 documentos aleatórios. Gaste 30 minutos conferindo-os. Veja se os resultados revelam algo que você não sabia sobre a qualidade da sua extração.