Extracción de documentos para logística:
Guía de compras para operaciones
El mercado de extracción de documentos con IA ha madurado hasta el punto en que "¿puede leer un PDF?" ya no es una pregunta útil: la respuesta casi siempre es sí. La pregunta que importa para las operaciones logísticas es si la herramienta puede leer seis PDFs diferentes de seis socios comerciales distintos — un BOL directo de un transportista de camiones, un BOL marítimo con notificación de pedido de una naviera, una factura comercial del exportador, una lista de empaque del almacén, un CBP 7501 del agente aduanal y una factura de flete del departamento de facturación del transportista — y cruzar los datos para que el conteo de piezas en el BOL coincida con el cargo de línea en la factura. Esos son los documentos logísticos que llegan con cada envío transfronterizo. Una herramienta que maneja bien uno de ellos pero ninguno de los demás es peor que no tener herramienta alguna: crea un conjunto de datos parcial que aún lo deja parcheando vacíos manualmente.
Conclusiones clave
- Un agente de carga de tamaño mediano necesita 45 plantillas de extracción solo para leer los BOL de los transportistas con los que trabaja, porque cada transportista imprime los documentos en un formato diferente.
- Todas esas plantillas fallan silenciosamente cuando un transportista rediseña sus documentos, y la primera alerta es un cargo por demora en un contenedor que salió del puerto hace tres días.
- ImageToTable.ai lee el número de contenedor por significado en cualquier formato de transportista, de modo que los datos del BOL y de la factura quedan en filas adyacentes de la misma hoja de cálculo, donde el cruce de referencias se convierte en una sola fórmula.
El panorama de los documentos logísticos: un envío, seis formatos
Un solo envío transfronterizo genera un rastro documental que la mayoría de los entornos de oficina nunca ven. El exportador emite un conocimiento de embarque — pero ¿de qué tipo? Un BOL directo, no negociable y consignado a un destinatario designado, es el más común para carga por camión. Un BOL con notificación de pedido, negociable mediante endoso, aparece en envíos marítimos donde las mercancías pueden cambiar de propietario durante el tránsito. Un BOL multimodal cubre movimientos de contenedores que combinan segmentos de camión, ferrocarril y buque bajo un solo documento — consulte nuestra guía completa de extracción de datos de BOL para el desglose completo de tipos de BOL y estándares de validación. Cada transportista imprime estos en su propia plantilla: el BOL marítimo de Maersk organiza los datos del exportador y del consignatario verticalmente con el puerto de carga y descarga en bloques dedicados; el BOL de camión de ODFL agrupa los mismos campos horizontalmente en el tercio superior de la página con filas de unidades de manejo debajo; un transportista regional de LTL puede plegar todo en un diseño de una sola columna con números de referencia estampados a mano.
Luego llega la factura comercial del exportador — con códigos HS, valores declarados, incoterms y país de origen. La lista de empaque viene del almacén, detallando cantidad de piezas, peso por caja y detalle a nivel de SKU. El agente aduanal envía el CBP Form 7501 — el Resumen de Entrada presentado ante la Oficina de Aduanas y Protección Fronteriza de EE. UU. — con más de 40 bloques de datos que incluyen número de entrada, código de puerto, clasificación HTS, valor ingresado, cálculo de aranceles e información de la fianza. Si el envío es por vía marítima, también está la presentación ISF 10+2 bajo 19 CFR Part 149, con vencimiento 24 horas antes de la carga del buque, con 12 elementos de datos que cubren fabricante, vendedor, comprador, parte destinataria, país de origen y número HTS. Y luego llega la factura de flete — cargo por línea, recargo por combustible, accesorios, días de demora, relojes de detención.
Seis documentos, seis fuentes, seis formatos — y un solo contenedor en el puerto de Long Beach con el reloj de demora ya corriendo. Según las reglas de la Comisión Marítima Federal bajo 46 CFR Part 541, la factura de demora de un transportista debe incluir campos específicos — número de BOL, número de contenedor, puerto de descarga, fechas de tiempo libre, fecha de disponibilidad, fechas de cargo específicas, base de tarifa y contacto para disputas — o la factura puede ser inválida. Eso significa que la persona que audita la factura necesita datos de BOL en un formato estructurado antes de la fecha límite de pago, no después. Este es el problema estructural: los documentos son interdependientes, el reloj corre y los datos están bloqueados en PDF.
La extracción de documentos logísticos no se trata de leer un documento más rápido. Se trata de leer seis documentos interdependientes y detectar discrepancias en los campos que determinan si usted paga $4,200 o $8,900 por un movimiento de contenedor.
Criterio de Evaluación 1: Cómo Maneja la Diversidad de Formatos
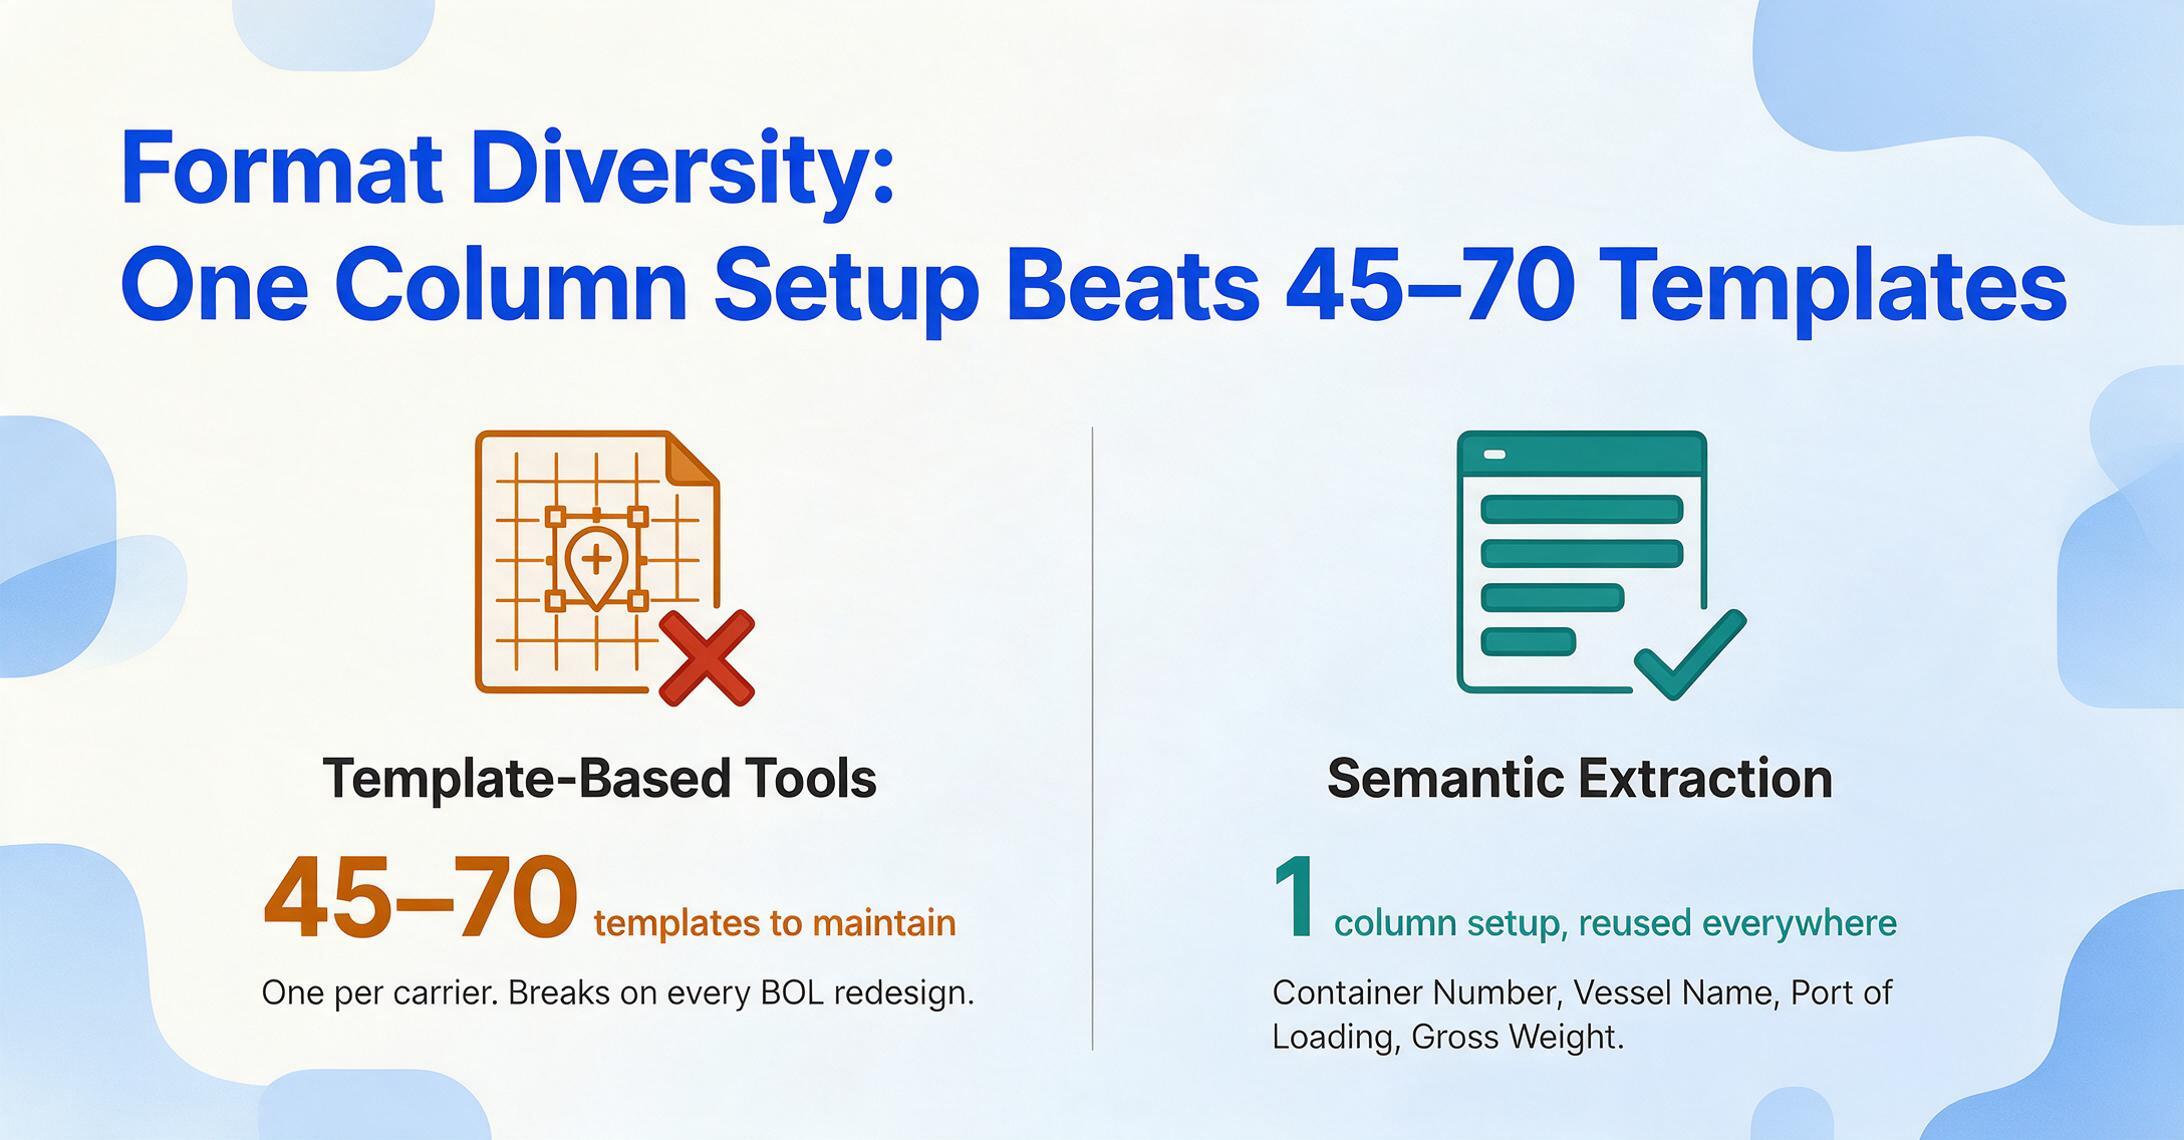
La primera prueba de cualquier herramienta de extracción de documentos para logística es la diversidad de formatos — y esto significa algo diferente a lo que muestran la mayoría de las demostraciones de proveedores. La demostración estándar carga un PDF perfectamente escaneado con fuentes limpias y extrae campos en segundos. Un operador logístico necesita saber qué sucede cuando carga un BOL de Maersk, un BOL de MSC, un BOL de COSCO y un BOL de un transportista regional de camiones en el mismo lote con la misma configuración de columnas, y el número de contenedor está en un cuadrante diferente de la página en el formato de cada transportista.
La mayoría de las herramientas de extracción se dividen en dos categorías aquí. Las herramientas basadas en plantillas requieren que dibuje cuadros delimitadores o defina anclas de coordenadas para cada campo en cada diseño de documento — lo que significa mantener una plantilla por transportista. Un agente de carga de tamaño mediano que trabaja con 15 a 20 transportistas oceánicos y otros 30 a 50 transportistas regionales de camiones necesita mantener de 45 a 70 plantillas, y cada una de ellas fallará la próxima vez que un transportista rediseñe su BOL. La segunda categoría — la que usa ImageToTable.ai — es la extracción semántica mediante un modelo de visión: usted escribe los nombres de las columnas que desea extraer (Número de Contenedor, Nombre del Buque, Puerto de Carga, Peso Bruto), y la IA localiza los valores en cada documento al comprender qué significan esos campos semánticamente, no al recordar dónde estaban en una plantilla. La misma configuración de columnas — lo que la herramienta llama Extracción de Columnas Personalizadas — funciona en todos los formatos de transportistas simultáneamente porque la IA lee como lo haría una persona: escanea el documento en busca del concepto "Número de Contenedor" y extrae la cadena alfanumérica junto a él, sin importar dónde aparezca esa cadena en la página.
Esta distinción importa más en logística que en cualquier otra industria. En cuentas por pagar, el formato de una factura varía — pero la variación entre una factura de Sysco y una de US Foods es modesta: ambas colocan el total en la esquina inferior derecha, ambas listan las partidas en una tabla. En logística, la variación entre un BOL oceánico de Maersk y un BOL LTL de Estes es arquitectónica — los documentos están diseñados para marcos regulatorios diferentes, modos de transporte diferentes, estructuras de responsabilidad diferentes. Una herramienta basada en plantillas que funciona para facturas de AP fallará en el primer cambio de transportista en un flujo de trabajo logístico.
Al evaluar, pruebe esto directamente: lleve BOLs de tres transportistas diferentes — uno oceánico, uno LTL nacional, uno regional de camiones — al entorno de demostración de la herramienta con el mismo conjunto de columnas de extracción. Si necesita crear una plantilla separada para cada uno, el tiempo que ahorra en extracción lo gastará en mantenimiento de plantillas. Para una prueba comparativa de cómo nueve herramientas de extracción manejan realmente este tipo de variación entre transportistas, consulte nuestra comparación de herramientas de extracción de documentos logísticos; para conocer los detalles de cómo procesar un BOL de principio a fin, consulte cómo extraer datos de BOL a Excel.
Criterio de Evaluación 2: ¿Puede Hacer Referencias Cruzadas Entre Documentos?
La extracción de un solo documento es lo básico. Lo que separa a una herramienta capacitada para logística de un lector de documentos genérico es si admite los flujos de conciliación que los gerentes de logística realmente ejecutan — comenzando con la verificación cruzada de BOL contra factura de flete.
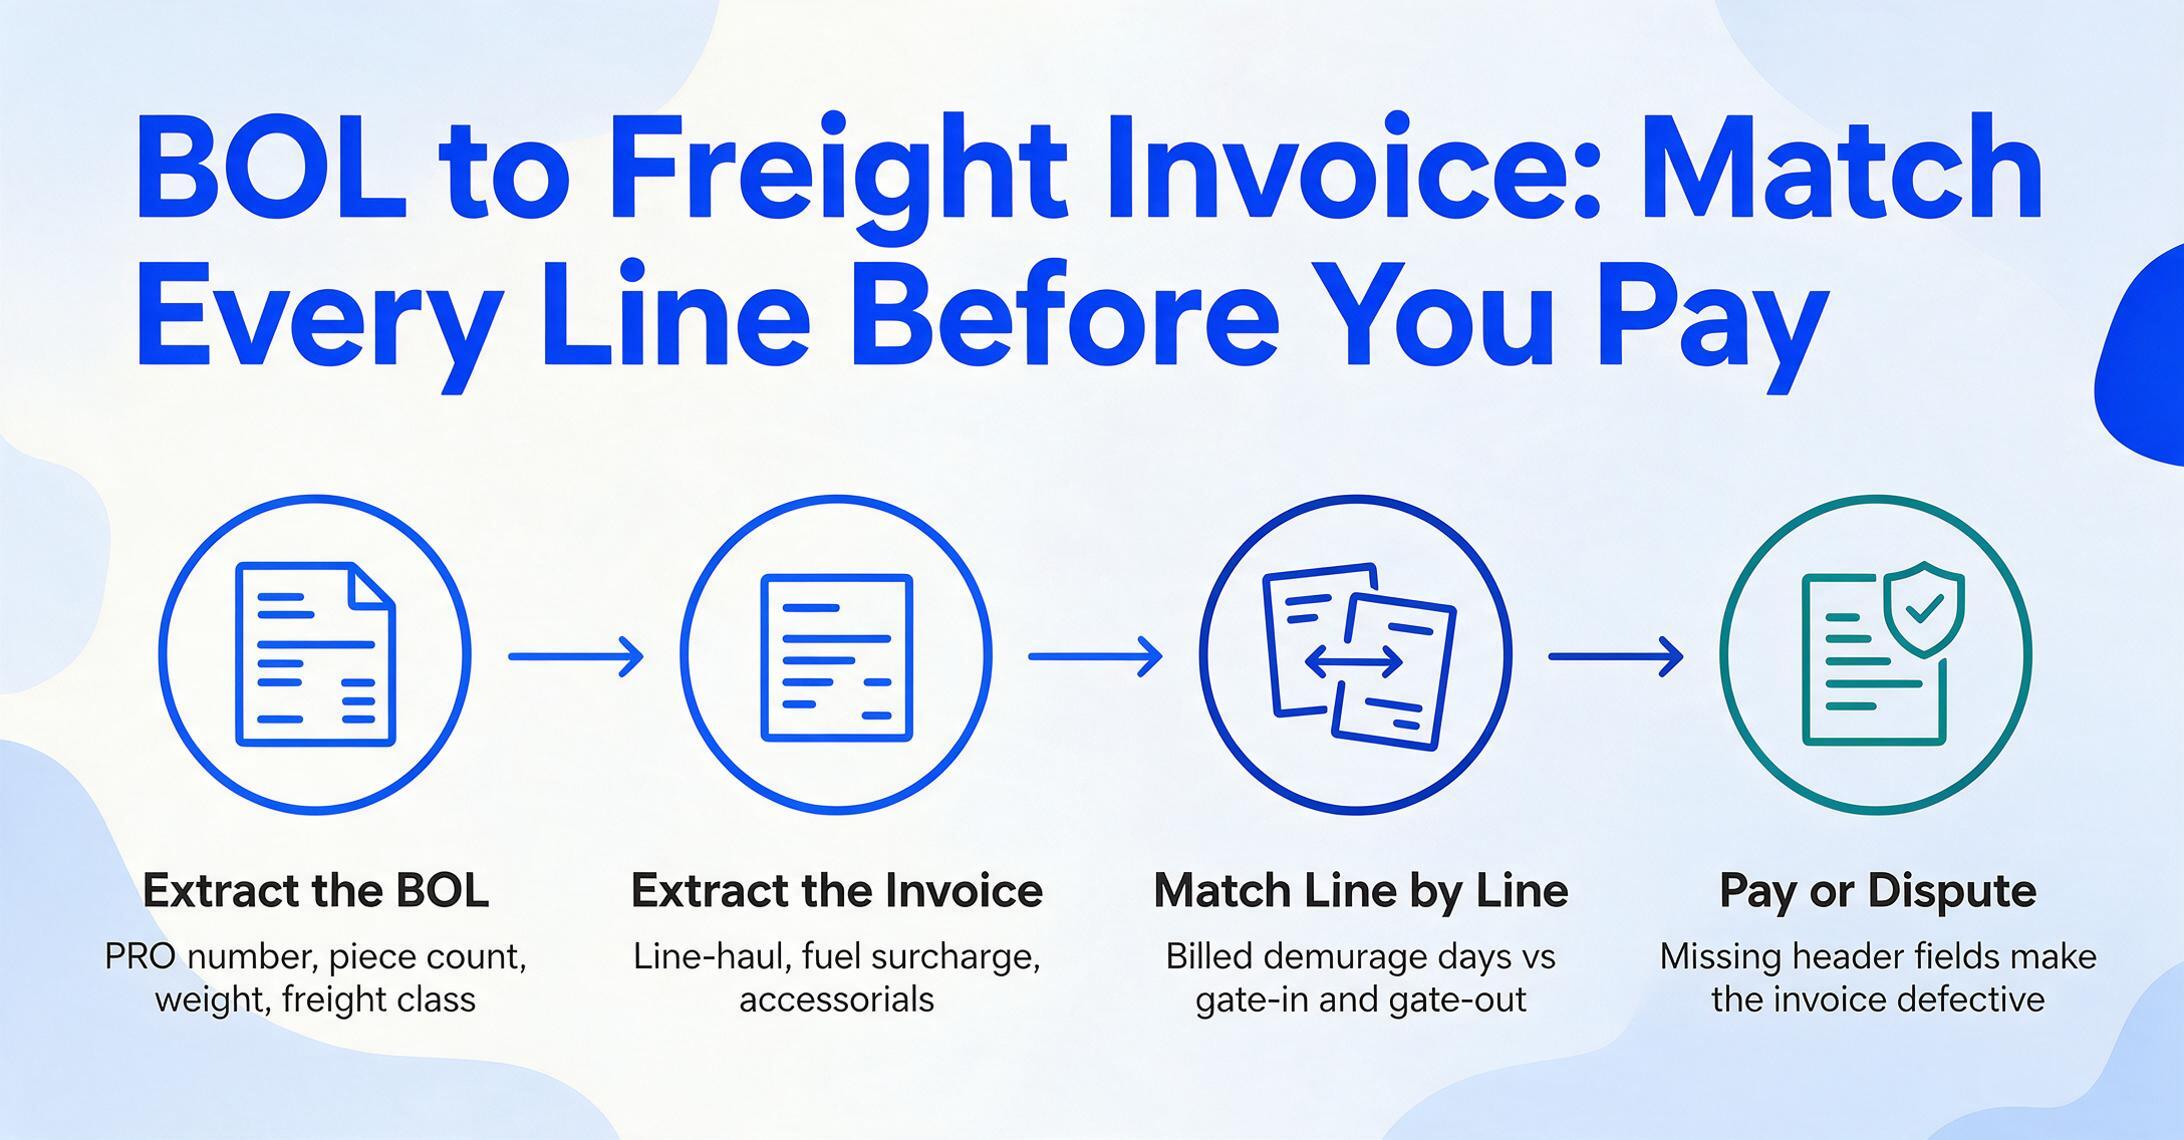
Una factura de flete de una naviera no es una factura simple. Detalla el cargo por transporte principal, un recargo por combustible indexado a una tarifa específica de combustible de búnker, cualquier cargo accesorio — uso de chasis, días de demora, días de detención, cargos por documentación, recargo por materiales peligrosos — y un total. Cada línea de detalle necesita verificación contra un documento fuente. El cargo por transporte principal debe coincidir con la confirmación de tarifa acordada en la reserva. El número de piezas y el peso en la factura deben coincidir con la descripción de carga declarada en el BOL. Los días de demora facturados deben alinearse con las marcas de tiempo de entrada y salida de la terminal contra el tiempo libre permitido en la tarifa de la terminal. Y según 46 CFR Part 541, la factura también debe contener campos de encabezado específicos — si falta el número de BOL, el número de contenedor, la fecha de disponibilidad o la base de tarifa, la factura es defectuosa y puede que no sea necesario pagarla en absoluto.
Aquí es donde una herramienta que extrae tanto BOL como facturas de flete en la misma hoja de cálculo crea un flujo de trabajo que las herramientas de un solo documento no pueden. Usted sube el BOL, configura columnas para número PRO, número de piezas, peso, clase de flete y transportista. Luego sube la factura de flete en el mismo lote, extrayendo transporte principal, recargo por combustible, cargos accesorios y número de piezas facturado. Los dos tipos de documento alimentan filas o columnas adyacentes de una sola hoja de cálculo, y la referencia cruzada — ¿coincide el peso facturado con el peso del BOL? ¿coincide el número de piezas? — se convierte en una verificación de fórmula en lugar de una búsqueda manual entre dos PDF separados y una calculadora.
La misma lógica aplica a lista de empaque → recepción en almacén y factura comercial → validación de declaración aduanera. Una vez que los datos de los seis documentos de un paquete de envío viven en la misma tabla estructurada, el paso de conciliación que actualmente consume la mañana de un coordinador de logística se convierte en un filtro de hoja de cálculo. Esta es la capacidad que hace que una herramienta de extracción de documentos sea genuinamente útil para una operación logística — no solo leer más rápido, sino hacer visibles las discrepancias antes de que se conviertan en cargos por demora.
El 57% de los ejecutivos de logística reportaron retrasos en envíos durante el último año directamente vinculados a errores documentales. La mayoría de esos errores no fueron campos omitidos — fueron campos desalineados entre documentos que nadie verificó de forma cruzada porque verificar seis PDF a mano toma más tiempo que la ventana de tiempo libre del envío.
Criterio de Evaluación 3: Extracción Preparada para Aduanas
Si su operación mueve mercancías a través de fronteras, la herramienta de extracción debe manejar documentos aduaneros — y este es un requisito más difícil de lo que parece. Los formularios aduaneros son documentos densos, estandarizados por el gobierno, con requisitos de precisión a nivel de campo que un enfoque genérico de "extraer todo el texto" no satisface.
El CBP Form 7501, el Resumen de Entrada, es un PDF de 27 páginas con más de 40 bloques de datos. El Bloque 1 contiene el número de entrada alfanumérico de 11 dígitos (código de presentador de tres dígitos + número de entrada de siete dígitos + un dígito de verificación). El Bloque 2 especifica el código de tipo de entrada — 01 para consumo, 21 para almacén. El Bloque 6 contiene el código de puerto (2704 para Los Ángeles). Los bloques 33 a 36 contienen el detalle de la línea de partida: número HTS, país de origen, valor ingresado en USD y cálculo de aranceles. Cada uno de estos campos tiene una consecuencia posterior. Un código HTS incorrecto — específicamente la clasificación del Arancel Armonizado de 10 dígitos — activa una tasa de arancel diferente, lo que puede significar miles de dólares en sobrepago o una auditoría del CBP.
La presentación ISF 10+2, requerida para todas las importaciones marítimas, agrega 12 elementos de datos más: vendedor, comprador, importador de registro, consignatario, fabricante, parte receptora, país de origen y número HTS, entre otros. Estos deben ser consistentes con la factura comercial y los datos del BOL, o el CBP marca la presentación y el contenedor no se libera de la terminal.
Una herramienta de extracción de grado logístico debe extraer los campos aduaneros con sus etiquetas intactas — no solo la cadena numérica "8471.30.0100" sino la asociación que dice "este es el código HTS para las computadoras portátiles en la línea de partida 1." Debe extraer el país de origen por línea de partida, no solo una vez desde el encabezado. Y debe permitirle extraer datos aduaneros en la misma hoja de cálculo donde ya se encuentran los datos del BOL y de la factura, para que el resumen de entrada del agente aduanal pueda validarse contra la factura comercial y la descripción de carga del BOL en una sola vista.
La prueba práctica: solicite al proveedor que procese un PDF real de CBP 7501 durante la evaluación. Observe si los códigos HTS extraídos coinciden con las líneas de partida a las que pertenecen, o si la herramienta genera una lista desordenada de códigos sin asociación con la línea de partida. En aduanas, un código sin su contexto de línea de partida es inútil.
Criterio de Evaluación 4: Cómo Llegan los Documentos a la Herramienta
La mayoría de los marcos de evaluación para la extracción de documentos se centran únicamente en lo que ocurre después de la carga — qué tan rápido, qué tan preciso, qué formato toma la exportación. Pero el paso anterior a la extracción — cómo entran realmente los documentos a la cola de procesamiento — es donde las operaciones logísticas pierden más tiempo del que esperan.
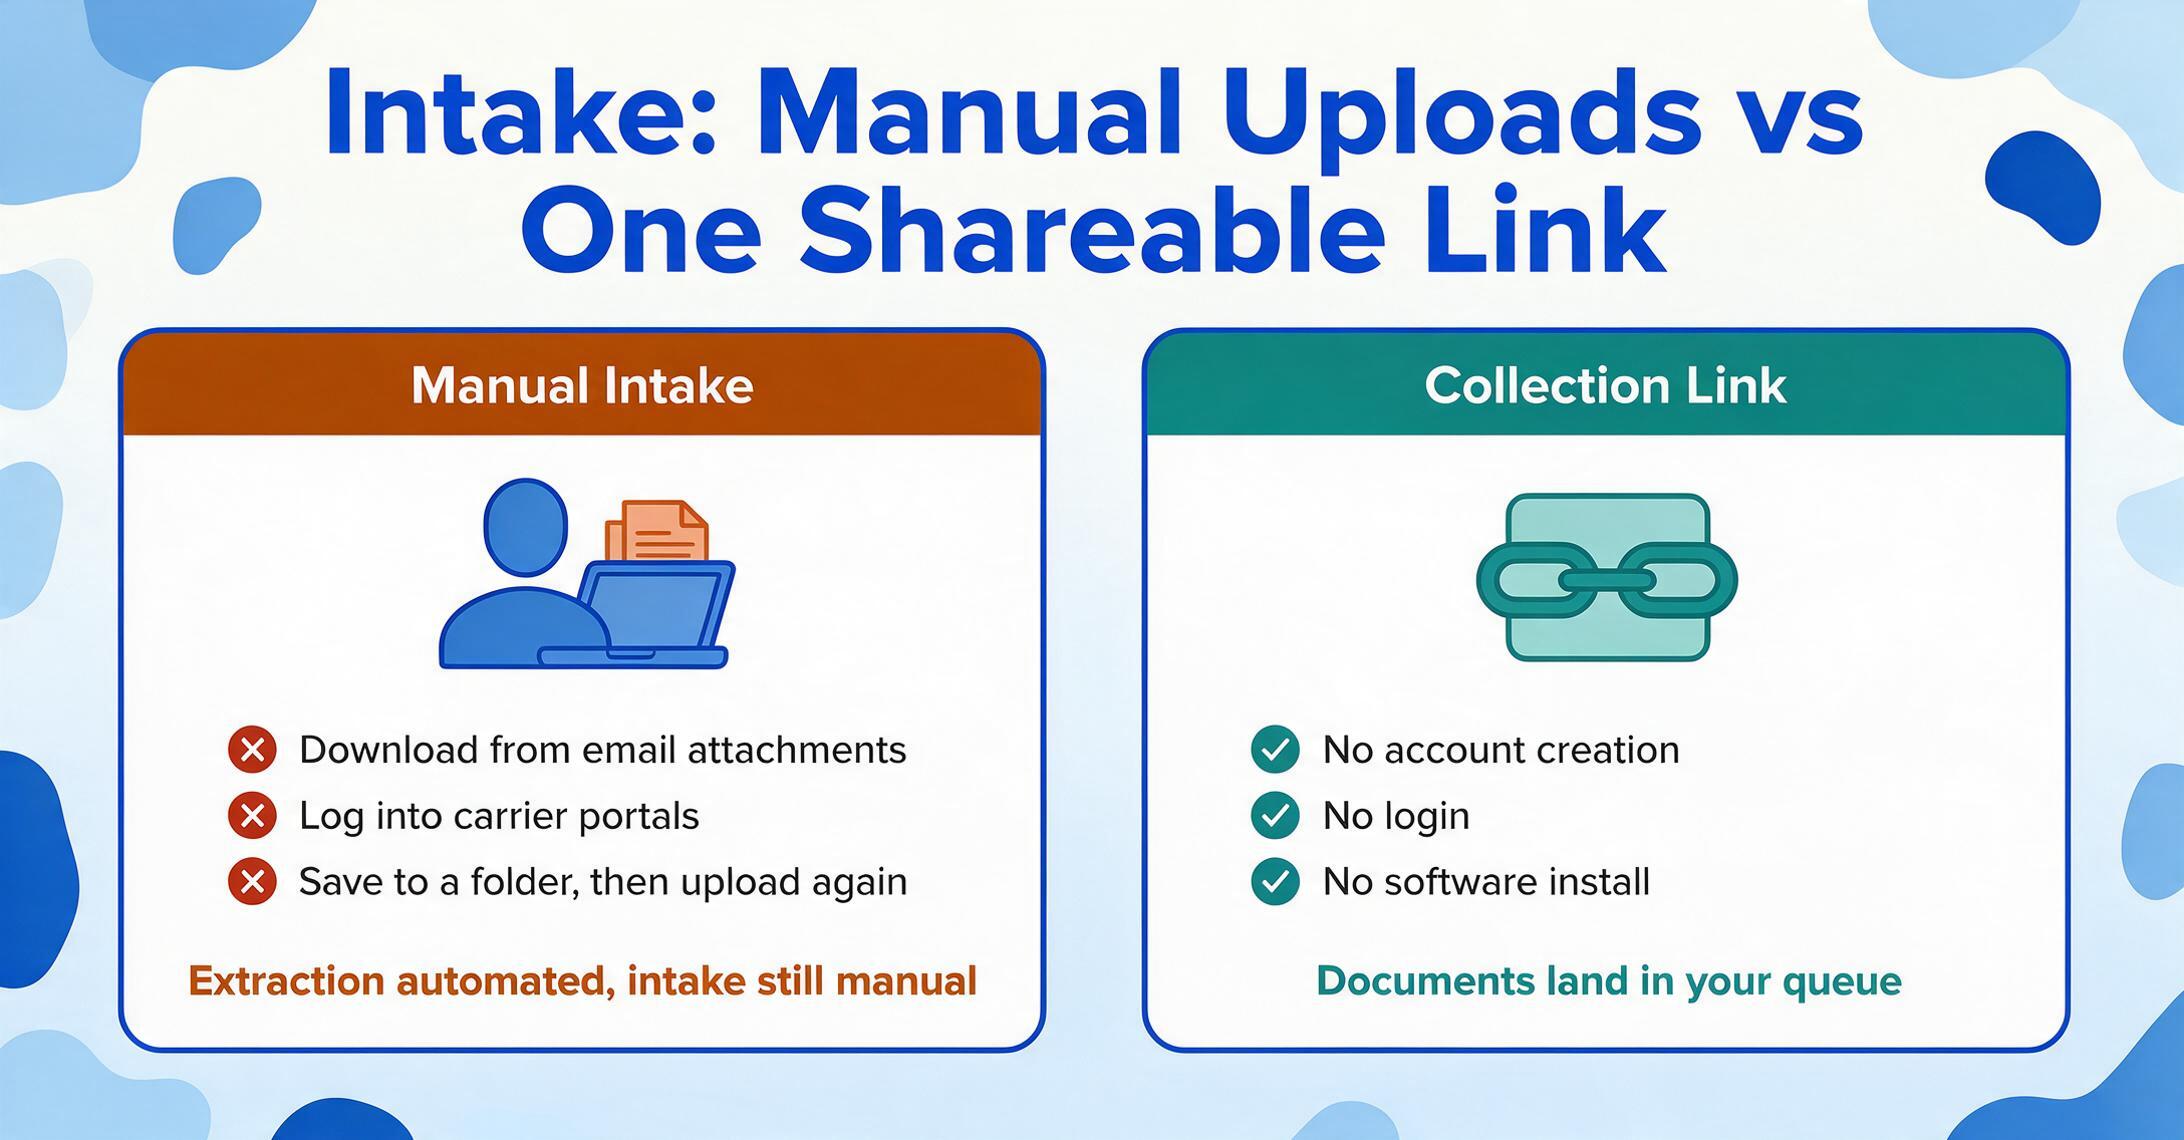
En un flujo de trabajo logístico típico, los BOL llegan como archivos adjuntos de correo electrónico de los embarcadores. Las facturas de los transportistas llegan a través de portales de transportistas o como archivos PDF adjuntos del departamento de facturación. Las declaraciones de aduana provienen del agente aduanal. Las listas de empaque provienen del almacén de origen. Cada fuente es una persona diferente, un canal diferente y, a menudo, una zona horaria diferente. Si su herramienta de extracción requiere que usted sea quien suba todo — descargar archivos adjuntos del correo, iniciar sesión en portales de transportistas, guardar archivos en una carpeta y luego subirlos a la herramienta — ha automatizado el paso de extracción pero ha dejado el paso de recepción completamente manual.
Aquí es donde una función como Enlace de Recopilación cambia el cálculo de la evaluación. Un Enlace de Recopilación es una URL compartible que usted genera desde su cuenta. Lo envía al escritorio de despacho de un transportista, al almacén de un embarcador o a un agente aduanal — y ellos abren el enlace, ingresan un código de verificación corto y suben sus documentos directamente a su cola de procesamiento. Sin creación de cuenta, sin inicio de sesión, sin instalación de software en su lado. El BOL del transportista, la lista de empaque del almacén y la declaración de aduana del agente aduanal llegan a su cola automáticamente, y su configuración de extracción de columnas los procesa en lote.
Al evaluar herramientas, haga dos preguntas sobre la recepción: ¿la herramienta requiere que usted sea quien suba los archivos, o pueden las partes externas enviar documentos directamente? Y si el envío externo es posible, ¿funciona sin que el remitente necesite una licencia o cuenta de pago? En logística, donde los documentos fluyen de docenas de socios comerciales externos, la automatización de la recepción es tan importante como la precisión de la extracción — y es el criterio que la mayoría de las listas de verificación de evaluación omiten por completo.
Una Herramienta vs. Soluciones Puntuales: Cómo Tomar la Decisión
Para este punto, el patrón es claro: la extracción de documentos logísticos no es un problema de un solo documento. Es un problema de conciliación de múltiples documentos donde cada documento alimenta datos que validan al siguiente. Una herramienta que solo maneja BOL crea un conjunto de datos estructurados mientras deja facturas de flete, declaraciones aduaneras y listas de empaque en sus PDFs originales — y la referencia cruzada que realmente previene sobrepagos y retrasos aduaneros todavía tiene que hacerse a mano.
Las soluciones puntuales — una herramienta para extracción de BOL, otra para procesamiento de facturas, una plataforma específica para aduanas — introducen su propio costo: los datos viven en tres sistemas separados, sin una forma automatizada de vincular el contenedor MSCU1234567 entre la extracción de un BOL en una herramienta y la extracción de una factura de flete en otra. La respuesta de la industria logística a esta fragmentación ha sido históricamente el TMS: CargoWise, Descartes, MercuryGate, Trinium — plataformas que gestionan el ciclo completo del envío desde la reserva hasta el pago. Pero las plataformas TMS fueron construidas para un flujo de trabajo donde la entrada de datos ya había ocurrido. Gestionan la carga después de que los datos están en el sistema. En el momento en que llega un BOL en papel o un PDF escaneado, el TMS está inactivo — alguien todavía tiene que escribir.
Una herramienta de extracción que procesa los seis tipos de documentos logísticos con la misma configuración de columnas elimina el problema de los silos de datos. Los datos del BOL, la factura de flete, los datos aduaneros y el certificado de empaque llegan a una sola hoja de cálculo, y la referencia cruzada que solía consumir horas se convierte en un conjunto de verificaciones de fórmulas — o una revisión visual de filas adyacentes — que toma minutos.
Esto no requiere un contrato empresarial. ImageToTable.ai procesa los seis tipos de documentos — BOLs, facturas comerciales, certificados de empaque, declaraciones aduaneras, facturas de flete y recibos de entrega — con la misma configuración de Extracción de Columnas Personalizadas utilizada para cualquier documento. El precio comienza en $19 por mes, muy por debajo del costo por usuario de una actualización de módulo TMS. Para un análisis más profundo de cómo la extracción encaja en el panorama más amplio de entrada de datos, consulte nuestra visión general de lo que realmente hace el software de extracción de documentos y el panorama actual de herramientas en 2026. Si está evaluando plataformas empresariales frente a alternativas ligeras, la comparación de extracción empresarial vs. SMB cubre las compensaciones. Y para un enfoque estructurado en la selección de herramientas, el marco de evaluación de extracción de documentos proporciona una metodología de propósito general que complementa los criterios específicos de logística cubiertos aquí.
La herramienta de extracción logística adecuada no le obliga a elegir entre tipos de documentos. Procesa el paquete completo de envío — BOL, factura, certificado de empaque, declaración aduanera — con una sola configuración de columnas, para que la referencia cruzada se convierta en una fórmula, no en una auditoría manual.
Preguntas Frecuentes
¿La extracción de documentos funciona con BOL manuscritos y recibos de entrega?
Sí, con salvedades. Las herramientas de extracción basadas en modelos de visión pueden leer escritura a mano en BOLs y documentos de prueba de entrega — firmas del conductor, recuentos de piezas escritos a mano, sellos de almacén — pero la precisión disminuye en comparación con el texto impreso, particularmente en escaneos de baja resolución o copias carbón donde la tercera capa es tenue. Para campos manuscritos en documentos impresos (un conductor escribiendo a mano una corrección de recuento de piezas en un BOL impreso), la precisión es generalmente alta. Para formularios completamente manuscritos, espere revisar los datos extraídos en lugar de confiar en ellos sin verificación.
¿Puede manejar documentos aduaneros multilingües?
Sí. Una factura comercial de un proveedor chino escrita en mandarín, una lista de empaque alemana ("Lieferschein" en lugar de "Packing List"), o un certificado de origen coreano — los modelos de visión procesan el texto visual independientemente del idioma y etiquetan los valores extraídos bajo sus nombres de columna en inglés. La herramienta lee lo que está en la página; el encabezado de columna que usted elija se convierte en la etiqueta de salida. Para una operación logística japonesa, consulte nuestra guía de entrada de datos IA sin código.
¿Cómo encaja la extracción con mi TMS existente — CargoWise, Descartes, MercuryGate?
La extracción de documentos no reemplaza su TMS — lo alimenta. Usted extrae datos estructurados de BOLs, facturas y formularios aduaneros en una hoja de cálculo de Excel, y luego importa esa hoja a su TMS mediante su función estándar de importación de datos. La mayoría de las plataformas TMS — CargoWise mediante carga XML, Descartes mediante importación CSV, MercuryGate mediante el cargador de datos — aceptan importaciones masivas de hojas de cálculo. La herramienta de extracción maneja el paso de PDF a hoja de cálculo que el TMS no cubre; el TMS maneja la gestión de carga, el seguimiento y los pasos de liquidación para los que fue diseñado. No se requiere integración de API a menos que su volumen justifique crear una.
¿Cuál es la tasa de precisión específicamente en documentos logísticos?
Para BOL impresos, facturas comerciales y formularios aduaneros con fuentes claras, la precisión de datos en tablas impresas alcanza hasta el 99%, lo que equivale a aproximadamente un campo que requiere revisión por cada cien campos extraídos, o alrededor de una corrección por cada 8-10 documentos. Los campos manuscritos, las descripciones de carga de varias líneas con partidas anidadas y los escaneos de baja resolución (PDF de calidad de fax) reducen la precisión y pueden requerir revisión humana de las extracciones marcadas. El flujo de trabajo práctico es: la IA extrae todo, usted verifica los campos marcados de baja confianza y revisa documentos manuscritos o dañados. Esto es aproximadamente 18 veces más rápido que la entrada manual completa, incluso con el paso de revisión incluido. Para una comparación más profunda del OCR heredado frente a la extracción moderna con IA específicamente en tipos de documentos logísticos, consulte nuestra guía de OCR para logística.
¿Necesito herramientas separadas para cada tipo de documento?
No — y este fue el argumento central del marco de evaluación anterior. Una herramienta que utiliza extracción semántica (leyendo campos por significado, no por posición en una plantilla) maneja BOL, facturas de flete, listas de empaque, declaraciones aduaneras y facturas comerciales con la misma configuración de columnas. Usted define las columnas una vez — Número de Contenedor, Nombre del Buque, Código HS, Valor Declarado, Cargo de Línea — y la misma configuración funciona en los seis tipos de documentos cuando los sube en lote. Las herramientas separadas por tipo de documento crean silos de datos que dificultan la referenciación cruzada; una sola herramienta crea un conjunto de datos unificado donde la referenciación cruzada se convierte en una fórmula de hoja de cálculo.
Evalúe con sus propios documentos
Suba un BOL de Maersk, una factura de carga de Estes y una lista de empaque. Vea si una sola configuración de columnas extrae los tres en la misma hoja de cálculo — sin crear una sola plantilla.
Pruebe ImageToTable.ai GratisNo requiere registro. Los archivos se procesan de forma segura y no se almacenan.