Dokumentextraktion für die Logistik:
Ein Einkaufsführer für Betriebsleiter
Der Markt für KI-gestützte Dokumentextraktion ist inzwischen so ausgereift, dass die Frage „Kann es ein PDF lesen?" nicht mehr weiterhilft – die Antwort ist fast immer ja. Die entscheidende Frage für den Logistikbetrieb ist, ob das Tool sechs verschiedene PDFs von sechs verschiedenen Geschäftspartnern lesen kann – einen geraden BOL von einem LKW-Spediteur, einen Order-Notify-Seefracht-BOL von einer Reederei, eine Handelsrechnung vom Exporteur, eine Packliste vom Lager, ein CBP 7501 vom Zollagenten und eine Frachtrechnung von der Abrechnungsabteilung des Spediteurs – und die Daten so abzugleichen, dass die Stückzahl auf dem BOL mit der Streckengebühr auf der Rechnung übereinstimmt. Das sind die Logistikdokumente, die mit jeder grenzüberschreitenden Sendung eintreffen. Ein Tool, das eines davon gut verarbeitet, aber keines der anderen, ist schlimmer als gar kein Tool – es erzeugt einen unvollständigen Datensatz, bei dem Sie Lücken weiterhin manuell schließen müssen.
Wichtigste Erkenntnisse
- Ein mittelgroßer Spediteur benötigt 45 Extraktionsvorlagen, um nur die BOLs der Spediteure zu lesen, mit denen er zusammenarbeitet, weil jeder Spediteur Dokumente in einem anderen Layout druckt.
- Diese Vorlagen versagen alle stillschweigend, wenn ein Spediteur seine Dokumente neu gestaltet, und die erste Warnung ist eine Liegegebühr für einen Container, der vor drei Tagen den Hafen verlassen hat.
- ImageToTable.ai liest die Container-Nummer anhand der Bedeutung über jedes Spediteur-Layout hinweg, sodass BOL- und Rechnungsdaten in benachbarten Zeilen derselben Tabelle landen, wo der Abgleich zu einer einzigen Formel wird.
Die Logistikdokumentlandschaft: Eine Sendung, sechs Formate
Eine einzelne grenzüberschreitende Sendung erzeugt einen Papierpfad, den die meisten Büroumgebungen nie zu Gesicht bekommen. Der Versender stellt ein Konnossement aus – aber welche Art? Ein Straight-BOL, nicht verhandelbar und an einen benannten Empfänger konsigniert, ist bei LKW-Fracht am häufigsten. Ein Order-Notify-BOL, durch Indossament verhandelbar, erscheint bei Seefrachtsendungen, bei denen die Ware während des Transports den Eigentümer wechseln kann. Ein multimodales BOL deckt Containerbewegungen ab, die LKW-, Bahn- und Schiffssegmente unter einem Dokument kombinieren – siehe unseren vollständigen Leitfaden zur BOL-Datenextraktion für die vollständige Aufschlüsselung der BOL-Typen und Validierungsstandards. Jede Reederei druckt diese auf ihrer eigenen Vorlage: Maersks See-BOL ordnet Versender- und Empfängerdaten vertikal an, mit Verladehafen und Entladehafen in eigenen Blöcken; ODFLs LKW-BOL gruppiert dieselben Felder horizontal über das obere Drittel der Seite, mit Handling-Unit-Zeilen darunter; eine regionale LTL-Spedition kann alles in einem einspaltigen Layout mit handgestempelten Referenznummern zusammenfassen.
Dann trifft die Handelsrechnung vom Exporteur ein – mit HS-Codes, deklarierten Werten, Incoterms und Ursprungsland. Die Packliste kommt aus dem Lager und listet Stückzahl, Gewicht pro Karton und SKU-Details auf. Der Zollagent sendet das CBP Form 7501 – die Entry Summary, eingereicht bei der U.S. Customs and Border Protection – mit über 40 Datenblöcken, einschließlich Entry-Nummer, Hafen-Code, HTS-Klassifizierung, deklariertem Wert, Zollberechnung und Bürgschaftsinformationen. Bei Seefracht gibt es außerdem die ISF-10+2-Meldung gemäß 19 CFR Part 149, fällig 24 Stunden vor dem Verladen, mit 12 Datenelementen zu Hersteller, Verkäufer, Käufer, Empfänger, Ursprungsland und HTS-Nummer. Und dann trifft die Frachtrechnung ein – Linienfracht, Kraftstoffzuschlag, Nebengebühren, Liegegeldtage, Detentionsuhren.
Sechs Dokumente, sechs Quellen, sechs Formate – und ein einzelner Container im Hafen von Long Beach, dessen Liegegeld-Uhr bereits läuft. Gemäß den Regeln der Federal Maritime Commission unter 46 CFR Part 541 muss die Liegegeldrechnung einer Reederei bestimmte Felder enthalten – BOL-Nummer, Container-Nummer, Entladehafen, Freizeitdaten, Verfügbarkeitsdatum, konkrete Gebührendaten, Gebührenbasis und Streitkontakt – andernfalls kann die Rechnung ungültig sein. Das bedeutet, dass die Person, die die Rechnung prüft, die BOL-Daten in einem strukturierten Format benötigt, bevor die Zahlungsfrist abläuft, nicht danach. Das ist das strukturelle Problem: Die Dokumente sind voneinander abhängig, die Uhr tickt, und die Daten sind in PDFs eingeschlossen.
Bei der Extraktion von Logistikdokumenten geht es nicht darum, ein Dokument schneller zu lesen. Es geht darum, sechs voneinander abhängige Dokumente zu lesen und Abweichungen bei den Feldern aufzudecken, die darüber entscheiden, ob Sie 4.200 $ oder 8.900 $ für einen Containertransport zahlen.
Bewertungskriterium 1: Umgang mit Formatvielfalt
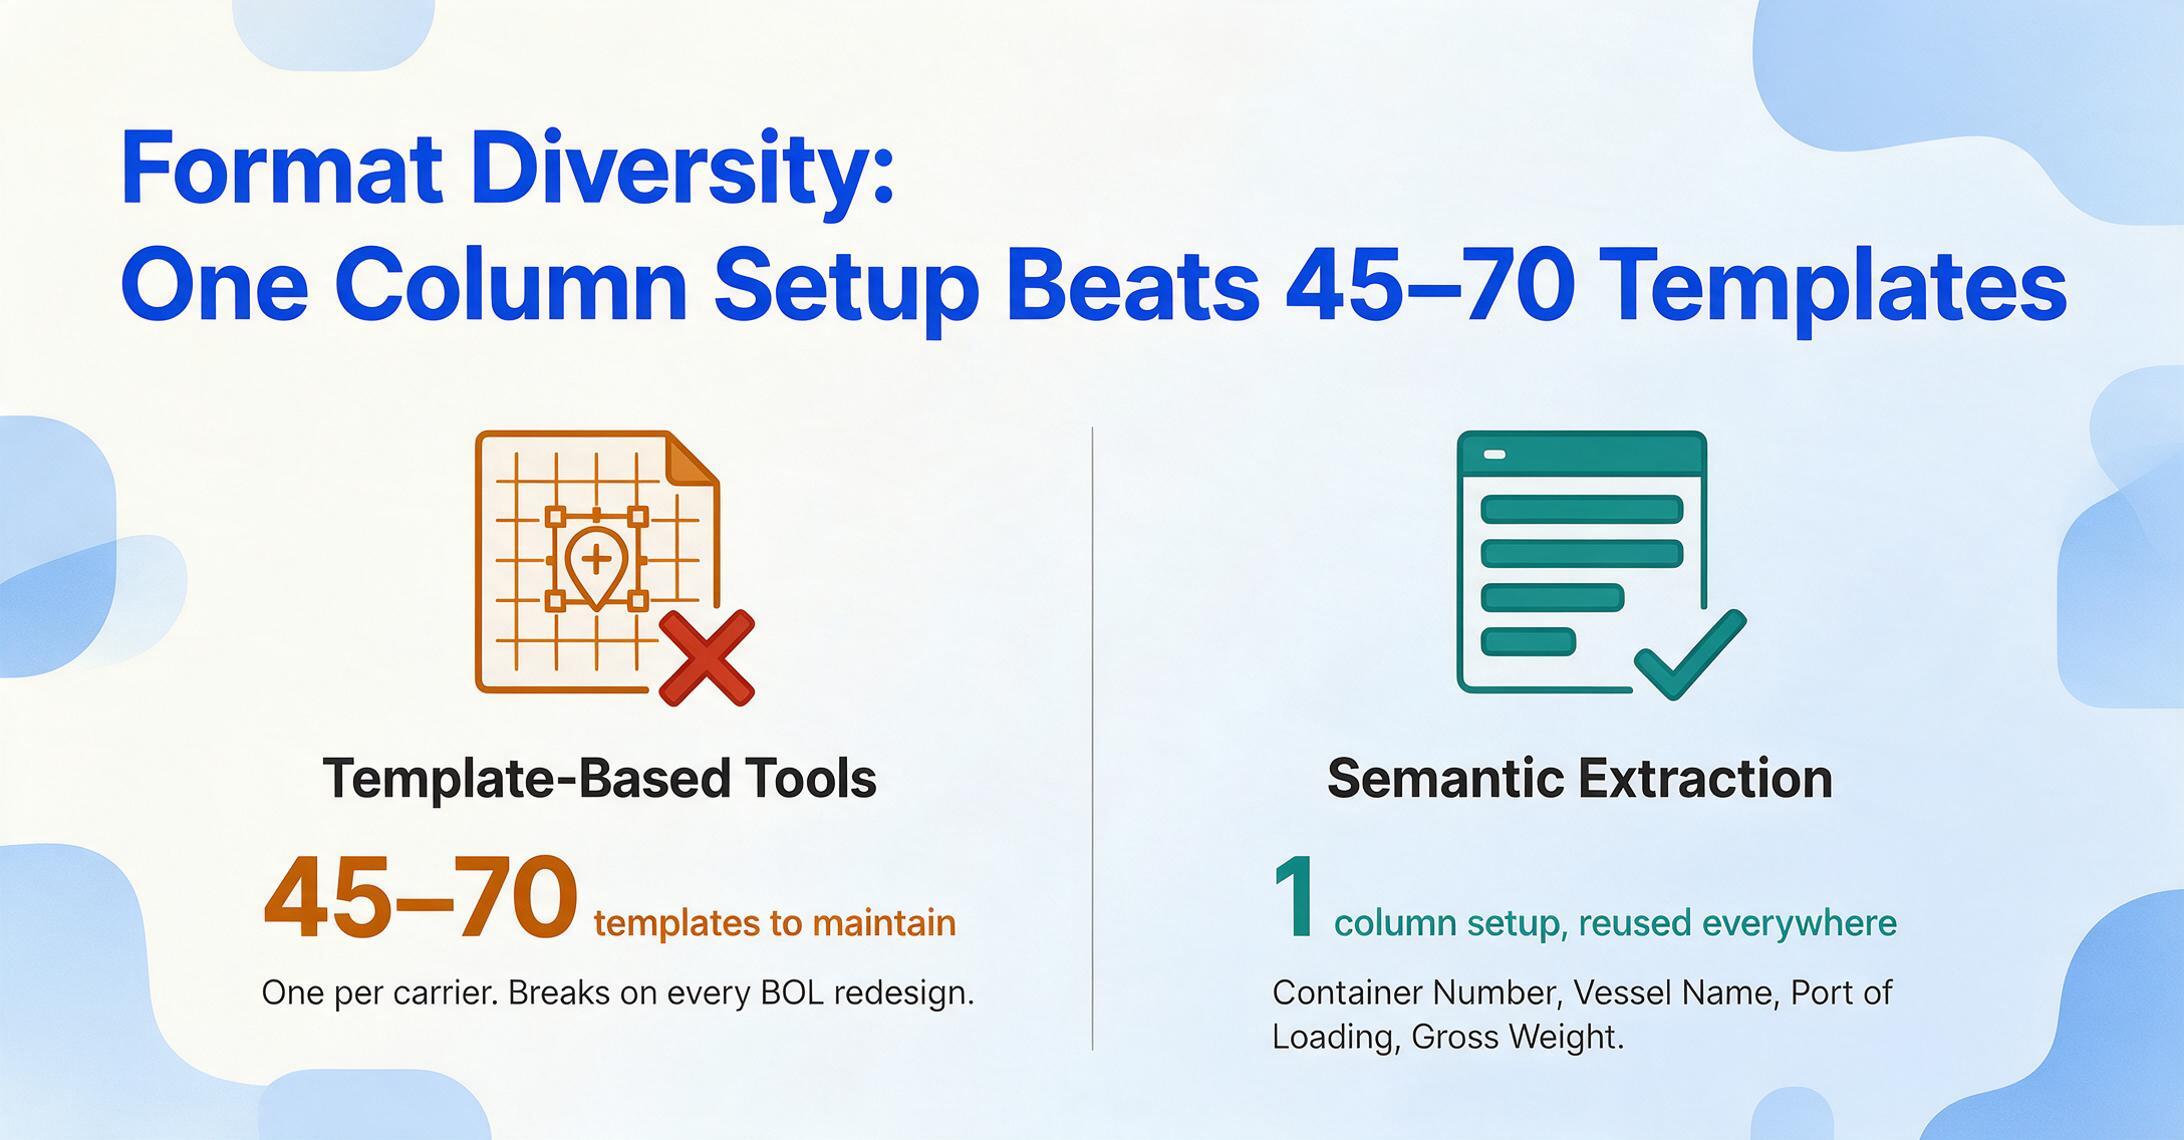
Der erste Test für jedes Dokumentextraktionstool in der Logistik ist die Formatvielfalt – und das bedeutet etwas anderes, als die meisten Verkäufer-Demos zeigen. Die Standard-Demo lädt ein perfekt gescanntes PDF mit sauberen Schriftarten und extrahiert Felder in Sekunden. Ein Logistikbetreiber muss wissen, was passiert, wenn er eine Maersk-BOL, eine MSC-BOL, eine COSCO-BOL und eine BOL eines regionalen Spediteurs im selben Batch mit derselben Spalteneinrichtung lädt und die Container-Nummer bei jedem Carrier-Format in einem anderen Quadranten der Seite steht.
Die meisten Extraktionstools fallen hier in eine von zwei Kategorien. Vorlagenbasierte Tools erfordern, dass Sie Begrenzungsrahmen zeichnen oder Koordinatenanker für jedes Feld in jedem Dokumentlayout definieren – das bedeutet eine Vorlage pro Carrier zu pflegen. Ein mittelgroßer Spediteur, der mit 15 bis 20 See-Carriern und weiteren 30 bis 50 regionalen Lkw-Carriern arbeitet, muss 45 bis 70 Vorlagen pflegen, von denen jede beim nächsten Redesign der BOL durch einen Carrier bricht. Die zweite Kategorie – die ImageToTable.ai verwendet – ist semantische Extraktion durch ein Vision-Modell: Sie geben die Spaltennamen ein, die extrahiert werden sollen (Container-Nummer, Schiffsname, Verladehafen, Bruttogewicht), und die KI lokalisiert die Werte in jedem Dokument, indem sie versteht, was diese Felder semantisch bedeuten – nicht, indem sie sich merkt, wo sie in einer Vorlage standen. Dieselbe Spalteneinrichtung – die das Tool Benutzerdefinierte Spaltenextraktion nennt – funktioniert gleichzeitig über alle Carrier-Formate, weil die KI liest wie ein Mensch: Sie durchsucht das Dokument nach dem Konzept „Container-Nummer" und zieht die alphanumerische Zeichenfolge daneben – unabhängig davon, wo auf der Seite diese Zeichenfolge erscheint.
Dieser Unterschied ist in der Logistik wichtiger als in jeder anderen Branche. In der Kreditorenbuchhaltung variiert ein Rechnungsformat – aber die Variation zwischen einer Sysco-Rechnung und einer US-Foods-Rechnung ist moderat: Beide platzieren die Summe unten rechts, beide listen Positionen in einer Tabelle. In der Logistik ist die Variation zwischen einer Maersk-See-BOL und einer Estes-LTL-BOL architektonisch – die Dokumente sind für unterschiedliche regulatorische Rahmenwerke, unterschiedliche Transportarten und unterschiedliche Haftungsstrukturen gebaut. Ein vorlagenbasiertes Tool, das für AP-Rechnungen funktioniert, scheitert beim ersten Carrier-Wechsel in einem Logistik-Workflow.
Testen Sie dies bei der Bewertung direkt: Laden Sie BOLs von drei verschiedenen Carriern – einen See-Carrier, einen nationalen LTL-Carrier, einen regionalen Lkw-Carrier – in die Demo-Umgebung des Tools mit demselben Satz an Extraktionsspalten. Wenn Sie für jeden eine separate Vorlage erstellen müssen, geben Sie die gesparte Extraktionszeit für die Vorlagenpflege aus. Für einen direkten Vergleich, wie neun Extraktionstools diese Art von Carrier-Varianz tatsächlich bewältigen, sehen Sie unseren Vergleich der Logistik-Dokumentextraktionstools; für die Mechanik, eine BOL Ende-zu-Ende durch den Workflow zu führen, siehe BOL-Daten nach Excel extrahieren.
Bewertungskriterium 2: Kann es dokumentübergreifend abgleichen?
Die Extraktion aus einem einzelnen Dokument ist nur die Grundlage. Was ein logistiktaugliches Tool von einem generischen Dokumentenleser unterscheidet, ist die Unterstützung der Abgleich-Workflows, die Logistikmanager tatsächlich durchführen – angefangen beim BOL-zu-Frachtrechnungs-Abgleich.
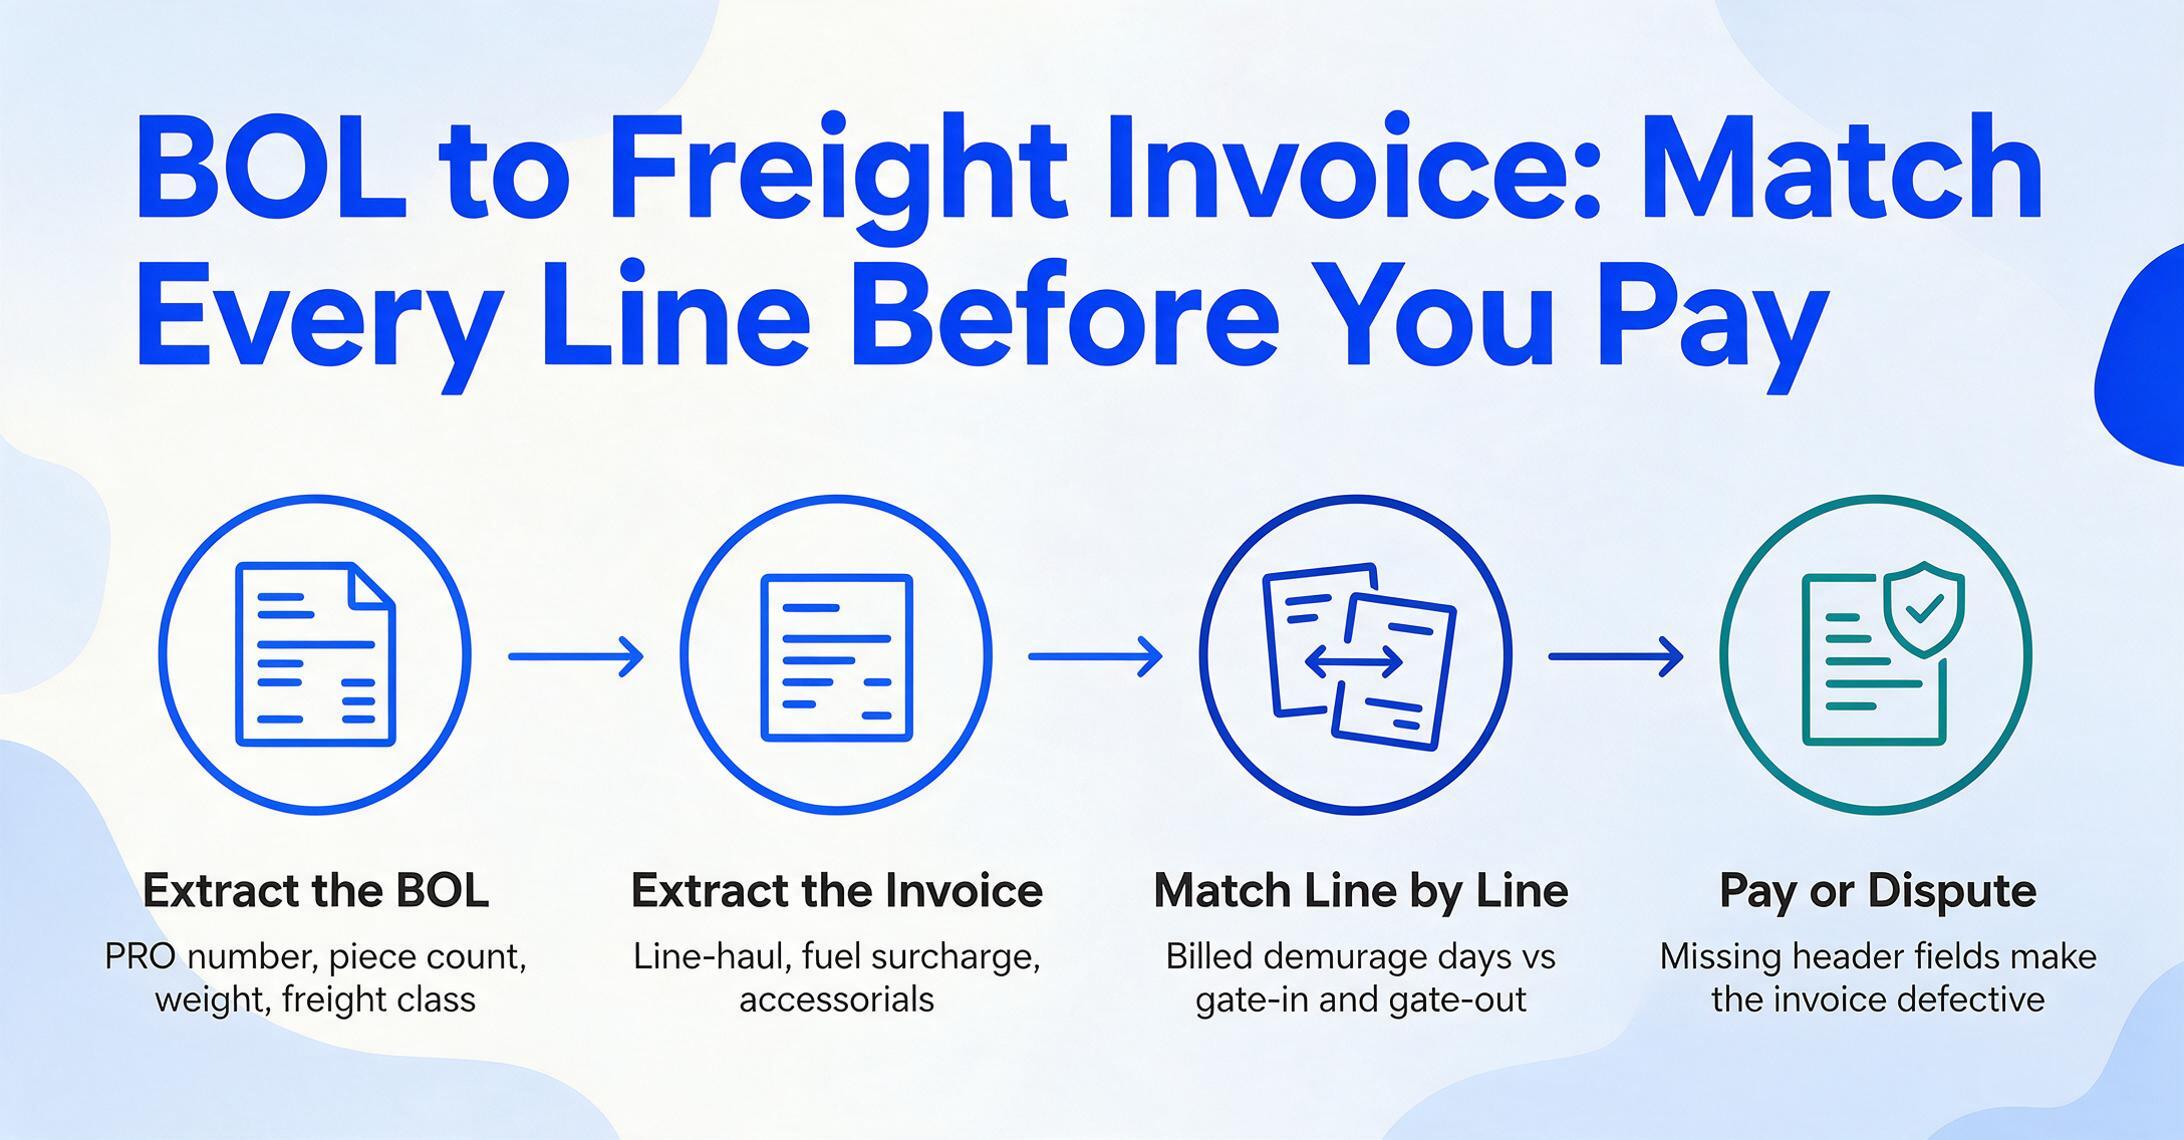
Eine Frachtrechnung einer Seefrachtreederei ist keine einfache Rechnung. Sie listet die Frachtkosten, einen Treibstoffzuschlag, der an einen bestimmten Bunkerölpreis gekoppelt ist, etwaige Nebenkosten – Chassis-Nutzung, Liegegeldtage, Containertage, Dokumentationsgebühren, Gefahrgutzuschläge – sowie eine Gesamtsumme auf. Jede Position muss gegen ein Quelldokument geprüft werden. Die Frachtkosten sollten dem bei der Buchung vereinbarten Ratenbestätigung entsprechen. Stückzahl und Gewicht auf der Rechnung sollten mit der deklarierten Frachtbeschreibung des BOL übereinstimmen. Die berechneten Liegegeldtage sollten mit den Gate-in- und Gate-out-Zeitstempeln im Verhältnis zur Freizeit im Terminaltarif übereinstimmen. Und gemäß 46 CFR Part 541 muss die Rechnung außerdem bestimmte Kopfzeilenfelder enthalten – wenn BOL-Nummer, Container-Nummer, Verfügbarkeitsdatum oder Ratenbasis fehlen, ist die Rechnung fehlerhaft und muss möglicherweise gar nicht bezahlt werden.
Hier schafft ein Tool, das sowohl BOLs als auch Frachtrechnungen in dieselbe Tabelle extrahiert, einen Workflow, den Einzeldokument-Tools nicht bieten können. Sie laden das BOL hoch, legen Spalten für PRO-Nummer, Stückzahl, Gewicht, Frachtklasse und Spediteur fest. Dann laden Sie die Frachtrechnung in denselben Batch hoch und extrahieren Frachtkosten, Treibstoffzuschlag, Nebenkosten und berechnete Stückzahl. Die beiden Dokumenttypen fließen in benachbarte Zeilen oder Spalten einer Tabelle ein, und der Abgleich – stimmt das berechnete Gewicht mit dem BOL-Gewicht überein? stimmt die Stückzahl? – wird zu einer Formelprüfung statt einer manuellen Suche durch zwei separate PDFs und einen Taschenrechner.
Dieselbe Logik gilt für Packliste → Wareneingang und Handelsrechnung → Zollanmeldungsprüfung. Sobald die Daten aus allen sechs Dokumenten eines Sendungspakets in derselben strukturierten Tabelle liegen, wird der Abgleichsschritt, der derzeit den Morgen eines Logistikkoordinators beansprucht, zu einem Tabellenfilter. Das ist die Fähigkeit, die ein Dokumentextraktionstool für einen Logistikbetrieb wirklich nützlich macht – nicht nur schnelleres Lesen, sondern das Sichtbarmachen von Abweichungen, bevor sie zu Liegegeldkosten werden.
57 % der Logistikführungskräfte berichteten, dass Sendungsverzögerungen im vergangenen Jahr direkt auf Dokumentfehler zurückzuführen waren. Die meisten dieser Fehler waren keine übersehenen Felder – es waren nicht übereinstimmende Felder zwischen Dokumenten, die niemand abgeglichen hat, weil das manuelle Abgleichen von sechs PDFs länger dauert als das Freizeitfenster der Sendung.
Bewertungskriterium 3: Zollfertige Extraktion
Wenn Ihr Unternehmen Waren über Grenzen bewegt, muss das Extraktionstool Zolldokumente verarbeiten können – und das ist eine härtere Anforderung, als es klingt. Zollformulare sind dichte, behördlich standardisierte Dokumente mit Anforderungen an die Präzision auf Feldebene, die ein generischer „gesamten Text extrahieren“-Ansatz nicht erfüllt.
CBP Form 7501, die Entry Summary, ist ein 27-seitiges PDF mit über 40 Datenblöcken. Block 1 enthält die 11-stellige alphanumerische Entry-Nummer (dreistelliger Filer-Code + siebenstellige Entry-Nummer + eine Prüfziffer). Block 2 gibt den Entry-Typ-Code an – 01 für Verbrauch, 21 für Lager. Block 6 enthält den Port-Code (2704 für Los Angeles). Die Blöcke 33 bis 36 enthalten die Positionsdetails: HTS-Nummer, Ursprungsland, deklarierter Wert in USD und Zollberechnung. Jedes dieser Felder hat eine nachgelagerte Konsequenz. Ein falscher HS-Code – konkret die 10-stellige Harmonized-Tariff-Schedule-Klassifikation – löst einen anderen Zollsatz aus, was Tausende von Dollar an Überzahlung oder ein CBP-Audit bedeuten kann.
Die ISF-10+2-Meldung, die für alle Seeimporte erforderlich ist, fügt 12 weitere Datenelemente hinzu: Verkäufer, Käufer, Importeur of Record, Empfänger, Hersteller, Warenempfänger, Ursprungsland und HS-Code, um nur einige zu nennen. Diese müssen mit den Daten der Handelsrechnung und des BOL konsistent sein, sonst markiert CBP die Meldung und der Container wird nicht vom Terminal freigegeben.
Ein logistiktaugliches Extraktionstool sollte Zollfelder mit ihren Bezeichnungen extrahieren – nicht nur die Zahlenfolge „8471.30.0100“, sondern auch die Zuordnung, die besagt: „Dies ist der HS-Code für die Laptops in Position 1.“ Es sollte das Ursprungsland pro Position ziehen, nicht nur einmal aus dem Kopfbereich. Und es sollte Ihnen ermöglichen, Zolldaten in dieselbe Tabelle zu extrahieren, in der bereits BOL- und Rechnungsdaten liegen, sodass die Entry Summary des Zollagenten in einer Ansicht gegen die Handelsrechnung und die BOL-Frachtbeschreibung validiert werden kann.
Der praktische Test: Bitten Sie den Anbieter, während der Evaluierung ein echtes CBP-7501-PDF zu verarbeiten. Beobachten Sie, ob die extrahierten HS-Codes mit den Positionen übereinstimmen, zu denen sie gehören, oder ob das Tool eine verworrene Liste von Codes ohne Positionszuordnung ausgibt. Im Zollwesen ist ein Code ohne seinen Positionskontext nutzlos.
Bewertungskriterium 4: Wie Dokumente in das Tool gelangen
Die meisten Bewertungsrahmen für Dokumentextraktion konzentrieren sich vollständig auf das, was nach dem Hochladen passiert – wie schnell, wie genau, welches Format der Export annimmt. Aber der Schritt vor der Extraktion – wie Dokumente tatsächlich in die Verarbeitungswarteschlange gelangen – ist der Punkt, an dem Logistikabläufe mehr Zeit verlieren, als sie erwarten.
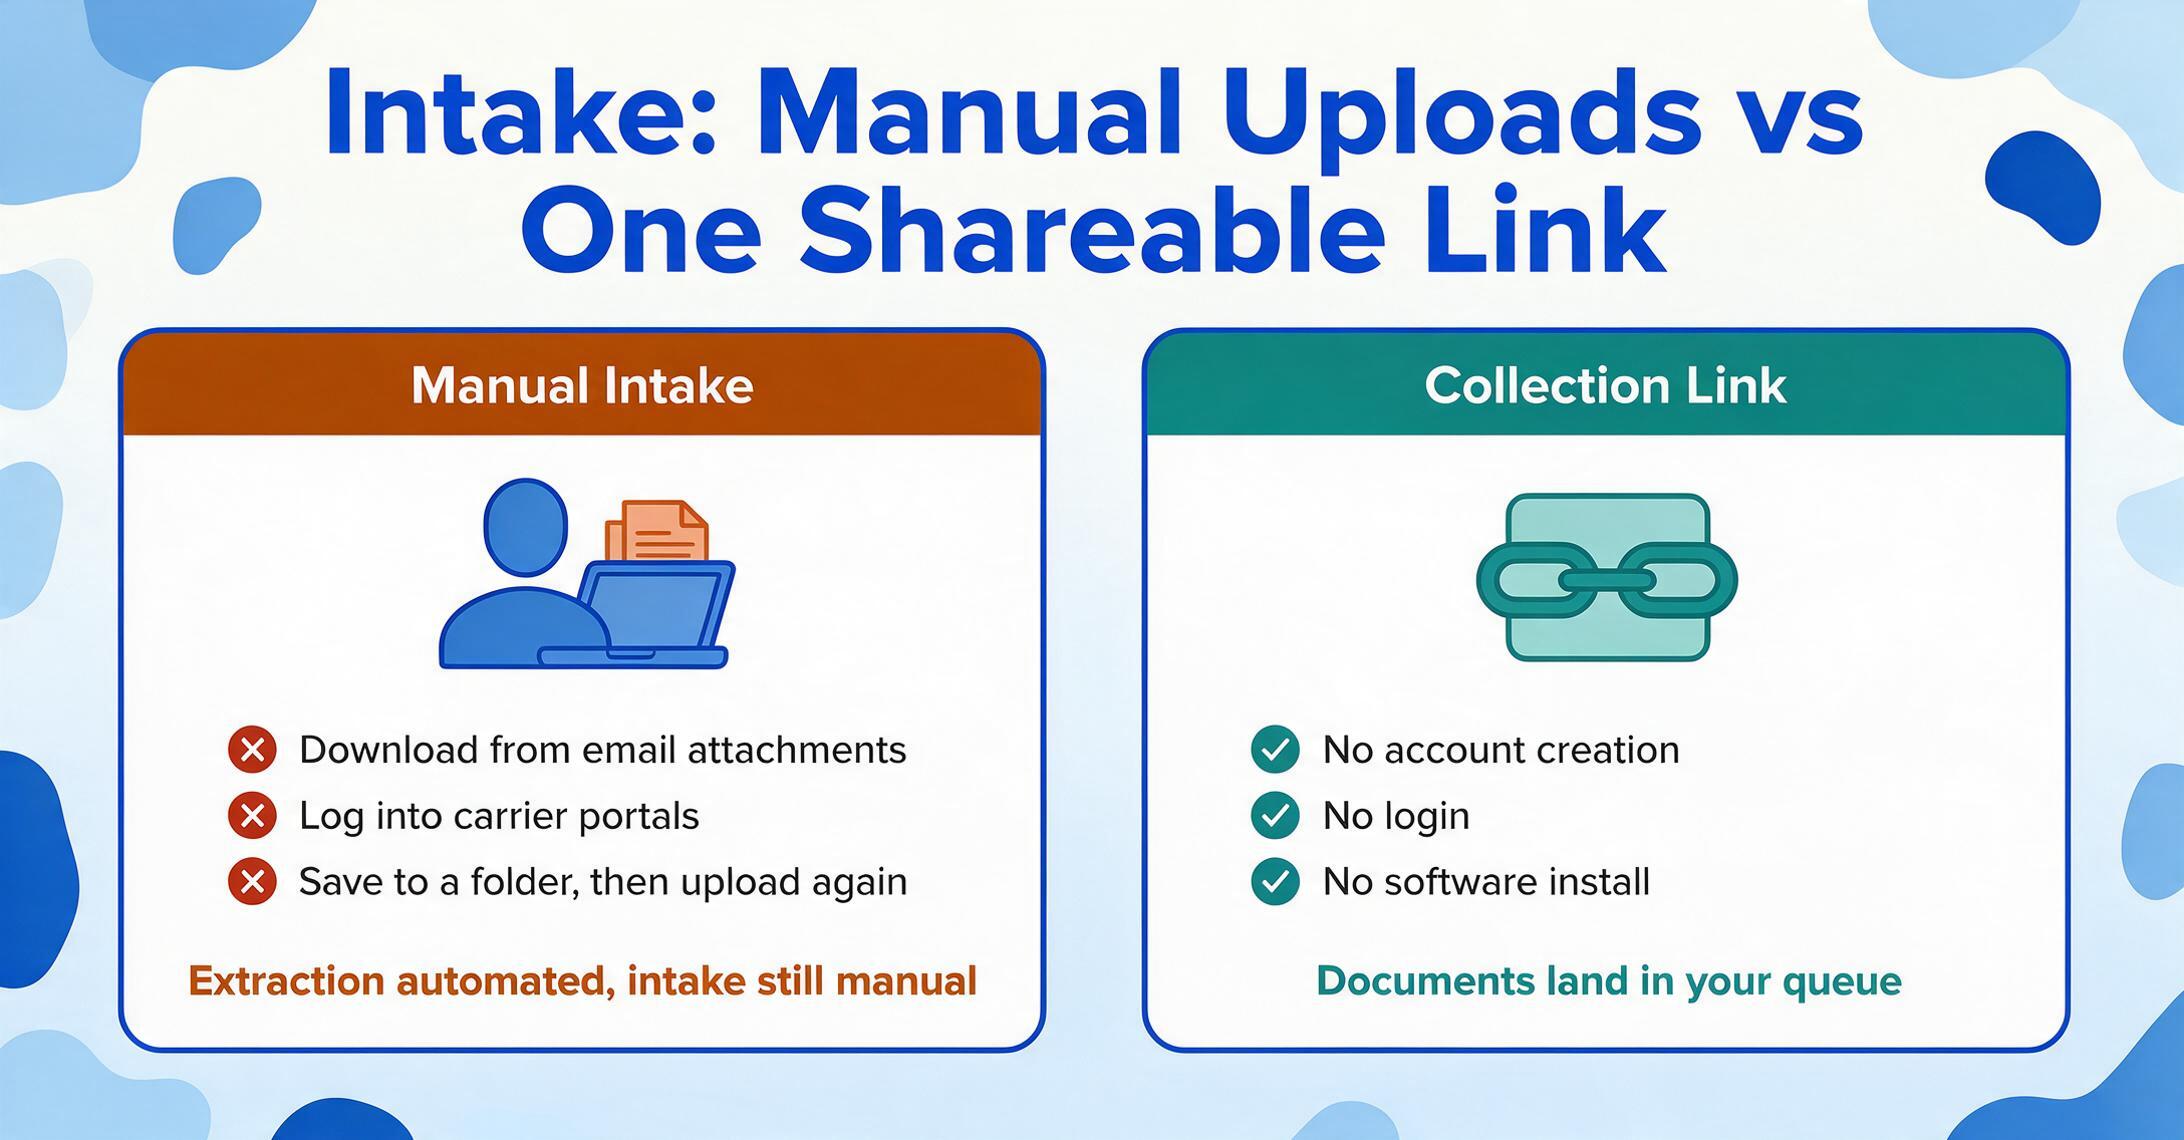
In einem typischen Logistikworkflow treffen BOLs als E-Mail-Anhänge von Versendern ein. Carrier-Rechnungen kommen über Carrier-Portale oder als PDF-Anhänge von der Abrechnungsabteilung. Zollanmeldungen kommen vom Makler. Packlisten kommen vom Ursprungslager. Jede Quelle ist eine andere Person, ein anderer Kanal und oft eine andere Zeitzone. Wenn Ihr Extraktionstool erfordert, dass Sie derjenige sind, der alles hochlädt – Anhänge aus E-Mails herunterladen, sich in Carrier-Portalen anmelden, Dateien in einem Ordner speichern und sie dann in das Tool hochladen – haben Sie den Extraktionsschritt automatisiert, aber den Erfassungsschritt vollständig manuell gelassen.
Hier ändert eine Funktion wie Sammellink die Bewertungslogik. Ein Sammellink ist eine teilbare URL, die Sie aus Ihrem Konto generieren. Sie senden sie an die Disposition eines Carriers, das Lager eines Versenders oder einen Zollmakler – und diese öffnen den Link, geben einen kurzen Verifizierungscode ein und laden ihre Dokumente direkt in Ihre Verarbeitungswarteschlange hoch. Keine Kontoeinrichtung, keine Anmeldung, keine Softwareinstallation auf deren Seite. Die BOL vom Carrier, die Packliste vom Lager und die Zollanmeldung vom Makler landen automatisch in Ihrer Warteschlange, und Ihre Spaltenextraktionseinrichtung verarbeitet sie im Batch.
Bei der Bewertung von Tools sollten Sie zwei Fragen zur Erfassung stellen: Erfordert das Tool, dass Sie der Uploader sind, oder können externe Parteien Dokumente direkt einreichen? Und wenn externe Einreichung möglich ist, funktioniert sie, ohne dass der Einreicher eine kostenpflichtige Lizenz oder ein Konto benötigt? In der Logistik, wo Dokumente von Dutzenden externen Handelspartnern fließen, ist die Erfassungsautomatisierung genauso wichtig wie die Extraktionsgenauigkeit – und es ist das Kriterium, das die meisten Bewertungschecklisten vollständig auslassen.
Ein Tool vs. Einzellösungen: Die Entscheidung treffen
Inzwischen ist das Muster klar: Die Extraktion von Logistikdokumenten ist kein Problem mit einem einzelnen Dokument. Es ist ein Problem der Abgleichung mehrerer Dokumente, bei dem jedes Dokument Daten liefert, die das nächste validieren. Ein Tool, das nur BOLs verarbeitet, erstellt einen strukturierten Datensatz, während Frachtrechnungen, Zollanmeldungen und Packlisten in ihren ursprünglichen PDFs verbleiben – und der Querverweis, der tatsächlich Überzahlungen und Zollverzögerungen verhindert, muss weiterhin von Hand erfolgen.
Einzellösungen – ein Tool für die BOL-Extraktion, ein anderes für die Rechnungsverarbeitung, eine zollspezifische Plattform für Anmeldungen – bringen ihre eigenen Kosten mit sich: Die Daten leben in drei getrennten Systemen, ohne automatische Möglichkeit, den Container MSCU1234567 über eine BOL-Extraktionsausgabe in einem Tool und eine Frachtrechnungsextraktionsausgabe in einem anderen abzugleichen. Die Antwort der Logistikbranche auf diese Fragmentierung war historisch das TMS: CargoWise, Descartes, MercuryGate, Trinium – Plattformen, die den gesamten Sendungslebenszyklus von der Buchung bis zur Abrechnung verwalten. Aber TMS-Plattformen wurden für einen Workflow gebaut, in dem die Dateneingabe bereits erfolgt ist. Sie verwalten die Ladung, nachdem die Daten im System sind. In dem Moment, in dem ein Papier-BOL oder ein gescanntes PDF ankommt, ist das TMS untätig – jemand muss trotzdem tippen.
Ein Extraktionstool, das alle sechs Logistikdokumenttypen mit demselben Spalten-Setup verarbeitet, beseitigt das Datensilo-Problem. Die BOL-Daten, Frachtrechnungsdaten, Zolldaten und Packlistendaten landen alle in einer Tabelle, und der Querverweis, der früher Stunden beanspruchte, wird zu einer Reihe von Formelprüfungen – oder einer visuellen Prüfung benachbarter Zeilen – die Minuten dauert.
Das erfordert keinen Enterprise-Vertrag. ImageToTable.ai verarbeitet alle sechs Dokumenttypen – BOLs, Handelsrechnungen, Packlisten, Zollanmeldungen, Frachtrechnungen und Lieferbelege – mit demselben Benutzerdefinierte Spaltenextraktion-Setup, das für jedes Dokument verwendet wird. Die Preise beginnen bei 19 $ pro Monat, weit unter den Pro-User-Kosten eines TMS-Modul-Upgrades. Für einen tieferen Einblick, wie die Extraktion in die breitere Dateneingabelandschaft passt, siehe unsere Übersicht über was Dokumentextraktionssoftware tatsächlich tut und die aktuelle Landschaft der Tools im Jahr 2026. Wenn Sie Enterprise-Plattformen gegen leichte Alternativen abwägen, deckt der Enterprise- vs. SMB-Extraktionsvergleich die Kompromisse ab. Und für einen strukturierten Ansatz zur Tool-Auswahl bietet das Bewertungsrahmen für Dokumentextraktion eine allgemeine Methodik, die die hier behandelten logistikspezifischen Kriterien ergänzt.
Das richtige Logistik-Extraktionstool zwingt Sie nicht, zwischen Dokumenttypen zu wählen. Es verarbeitet das gesamte Sendungspaket – BOL, Rechnung, Packliste, Zollanmeldung – mit einem Spalten-Setup, sodass der Querverweis zu einer Formel wird, nicht zu einer manuellen Prüfung.
Häufig gestellte Fragen
Funktioniert die Dokumentextraktion mit handschriftlichen BOLs und Lieferbelegen?
Ja, mit Einschränkungen. Extraktionstools auf Basis von Vision-Modellen können Handschrift auf BOLs und Liefernachweisen lesen – Fahrerunterschriften, handschriftlich ausgefüllte Stückzahlen, Lagerstempel – aber die Genauigkeit ist geringer als bei gedrucktem Text, insbesondere bei Scans mit niedriger Auflösung oder Durchschlägen, bei denen die dritte Kopie blass ist. Bei handschriftlichen Feldern auf ansonsten gedruckten Dokumenten (ein Fahrer korrigiert handschriftlich eine Stückzahl auf einem gedruckten BOL) ist die Genauigkeit in der Regel hoch. Bei vollständig handschriftlichen Formularen sollten Sie die extrahierten Daten überprüfen, anstatt sich ohne Verifizierung darauf zu verlassen.
Kann es mehrsprachige Zolldokumente verarbeiten?
Ja. Eine Handelsrechnung eines chinesischen Lieferanten auf Mandarin, eine deutsche Packliste („Lieferschein" statt „Packing List") oder ein koreanisches Ursprungszeugnis – Vision-Modelle verarbeiten den visuellen Text unabhängig von der Sprache und beschriften die extrahierten Werte unter Ihren englischen Spaltennamen. Das Tool liest, was auf der Seite steht; die Spaltenüberschrift, die Sie wählen, wird zur Ausgabebeschriftung. Für einen japanischen Logistikbetrieb finden Sie in unserem No-Code-KI-Datenerfassungsleitfaden weitere Informationen.
Wie passt die Extraktion zu meinem bestehenden TMS – CargoWise, Descartes, MercuryGate?
Die Dokumentextraktion ersetzt Ihr TMS nicht – sie speist es. Sie extrahieren strukturierte Daten aus BOLs, Rechnungen und Zollformularen in eine Excel-Tabelle und importieren diese Tabelle dann über die Standard-Datenimportfunktion in Ihr TMS. Die meisten TMS-Plattformen – CargoWise über XML-Upload, Descartes über CSV-Import, MercuryGate über den Datenlader – akzeptieren Massenimporte von Tabellenkalkulationen. Das Extraktionstool übernimmt den PDF-zu-Tabellen-Schritt, den das TMS nicht abdeckt; das TMS übernimmt die Ladungsverwaltung, Sendungsverfolgung und Abwicklung, für die es entwickelt wurde. Keine API-Integration erforderlich, es sei denn, Ihr Volumen rechtfertigt eine.
Wie hoch ist die Genauigkeitsrate speziell bei Logistikdokumenten?
Bei gedruckten BOLs, Handelsrechnungen und Zollformularen mit klaren Schriftarten erreicht die Datengenauigkeit bei gedruckten Tabellen bis zu 99 % – das bedeutet etwa ein Feld, das pro hundert extrahierten Feldern überprüft werden muss, oder etwa eine Korrektur pro 8–10 Dokumenten. Handschriftliche Felder, mehrzeilige Frachtbeschreibungen mit verschachtelten Positionen und Scans mit niedriger Auflösung (Fax-Qualität als PDF) reduzieren die Genauigkeit und können eine manuelle Überprüfung der markierten Extraktionen erfordern. Der praktische Arbeitsablauf ist: Die KI extrahiert alles, Sie prüfen die markierten Felder mit niedriger Konfidenz und überprüfen handschriftliche oder beschädigte Dokumente. Das ist selbst mit dem Überprüfungsschritt etwa 18-mal schneller als die vollständige manuelle Eingabe. Für einen tieferen Vergleich von herkömmlicher OCR mit moderner KI-Extraktion speziell bei Logistikdokumenttypen, siehe unseren OCR-Leitfaden für die Logistik.
Brauche ich separate Tools für jeden Dokumenttyp?
Nein – und das war das Kernargument des oben genannten Bewertungsrahmens. Ein Tool, das semantische Extraktion verwendet (Felder nach Bedeutung lesen, nicht nach Vorlagenposition), verarbeitet BOLs, Frachtrechnungen, Packlisten, Zollanmeldungen und Handelsrechnungen mit demselben Spaltenaufbau. Sie definieren die Spalten einmal – Container-Nummer, Schiffsname, HS-Code, deklarierter Wert, Linienfrachtgebühr – und derselbe Aufbau funktioniert für alle sechs Dokumenttypen, wenn Sie sie im Batch hochladen. Separate Tools pro Dokumenttyp erzeugen Datensilos, die das Querverweisen erschweren; ein Tool erstellt einen einheitlichen Datensatz, in dem Querverweise zu einer Tabellenkalkulationsformel werden.
Testen Sie es mit Ihren eigenen Dokumenten
Laden Sie einen Maersk-BOL, eine Estes-Frachtrechnung und eine Packliste hoch. Prüfen Sie, ob ein einziger Spaltenaufbau alle drei in dieselbe Tabelle extrahiert – ohne eine einzige Vorlage zu erstellen.
ImageToTable.ai kostenlos testenKeine Anmeldung erforderlich. Dateien werden sicher verarbeitet und nicht gespeichert.