Extraction de documents pour la logistique :
Guide d'achat pour les opérations
Le marché de l'extraction de documents par IA a atteint un niveau de maturité où « peut-il lire un PDF ? » n'est plus une question utile — la réponse est presque toujours oui. La question qui compte pour les opérations logistiques est de savoir si l'outil peut lire six PDF différents provenant de six partenaires commerciaux différents — un BOL simple d'un transporteur routier, un BOL maritime avec avis de commande d'une compagnie de navigation, une facture commerciale de l'exportateur, une liste de colisage de l'entrepôt, un CBP 7501 du courtier en douane, et une facture de fret du service de facturation du transporteur — et recouper les données pour que le nombre de pièces sur le BOL corresponde aux frais de transport sur la facture. Ce sont les documents logistiques qui accompagnent chaque expédition transfrontalière. Un outil qui gère bien l'un d'eux mais aucun des autres est pire que pas d'outil du tout — il crée un ensemble de données partiel qui vous laisse encore combler les lacunes manuellement.
Points clés à retenir
- Un transitaire de taille moyenne a besoin de 45 modèles d'extraction rien que pour lire les BOL des transporteurs avec lesquels il travaille, car chaque transporteur imprime ses documents dans une mise en page différente.
- Ces modèles échouent tous silencieusement lorsqu'un transporteur redessine ses documents, et la première alerte est une facture de surestaries sur un conteneur qui a quitté le port il y a trois jours.
- ImageToTable.ai lit le numéro de conteneur par le sens, quelle que soit la mise en page du transporteur, afin que les données du BOL et de la facture atterrissent dans des lignes adjacentes de la même feuille de calcul, où le recoupement devient une simple formule.
Le paysage documentaire logistique : une expédition, six formats
Une seule expédition transfrontalière génère une trace papier que la plupart des environnements de bureau ne voient jamais. L'expéditeur émet un connaissement — mais lequel ? Un BOL direct, non négociable et consigné à un destinataire nommé, est le plus courant pour le fret routier. Un BOL « order-notify », négociable par endossement, apparaît dans les expéditions maritimes où les marchandises peuvent changer de propriétaire pendant le transit. Un BOL multimodal couvre les mouvements de conteneurs qui combinent des segments routiers, ferroviaires et maritimes sous un seul document — voir notre guide complet sur l'extraction de données BOL pour la répartition complète des types de BOL et des normes de validation. Chaque transporteur imprime ces documents sur son propre modèle : le BOL maritime de Maersk organise les données de l'expéditeur et du destinataire verticalement avec le port de chargement et de déchargement dans des blocs dédiés ; le BOL routier d'ODFL regroupe les mêmes champs horizontalement sur le tiers supérieur de la page avec des lignes d'unités de manutention en dessous ; un transporteur régional LTL peut tout regrouper dans une mise en page à une seule colonne avec des numéros de référence tamponnés à la main.
Ensuite, la facture commerciale arrive de l'exportateur — avec les codes HS, les valeurs déclarées, les incoterms et le pays d'origine. La liste de colisage vient de l'entrepôt, détaillant le nombre de pièces, le poids par carton et les détails au niveau SKU. Le courtier en douane envoie le CBP Form 7501 — le Entry Summary déposé auprès des douanes et de la protection des frontières des États-Unis — avec plus de 40 blocs de données comprenant le numéro d'entrée, le code de port, la classification HTS, la valeur entrée, le calcul des droits et les informations de caution. Si l'expédition est maritime, il y a aussi le dépôt ISF 10+2 en vertu du 19 CFR Part 149, dû 24 heures avant le chargement du navire, avec 12 éléments de données couvrant le fabricant, le vendeur, l'acheteur, la partie destinataire, le pays d'origine et le numéro HTS. Et puis la facture de fret arrive — frais de ligne, surcharge carburant, accessoires, jours de surestaries, horloges de détention.
Six documents, six sources, six formats — et un seul conteneur au port de Long Beach avec l'horloge de surestaries déjà en marche. Selon les règles de la Federal Maritime Commission sous le 46 CFR Part 541, la facture de surestaries d'un transporteur doit inclure des champs spécifiques — numéro de BOL, numéro de conteneur, port de déchargement, dates de temps libre, date de disponibilité, dates de facturation spécifiques, base de taux et contact de litige — sinon la facture peut être invalide. Cela signifie que la personne qui audite la facture a besoin des données BOL dans un format structuré avant la date limite de paiement, pas après. C'est le problème structurel : les documents sont interdépendants, l'horloge tourne et les données sont enfermées dans des PDF.
L'extraction de documents logistiques ne consiste pas à lire un document plus rapidement. Il s'agit de lire six documents interdépendants et de faire ressortir les écarts sur les champs qui déterminent si vous payez 4 200 $ ou 8 900 $ pour un mouvement de conteneur.
Critère d'évaluation 1 : Gestion de la diversité des formats
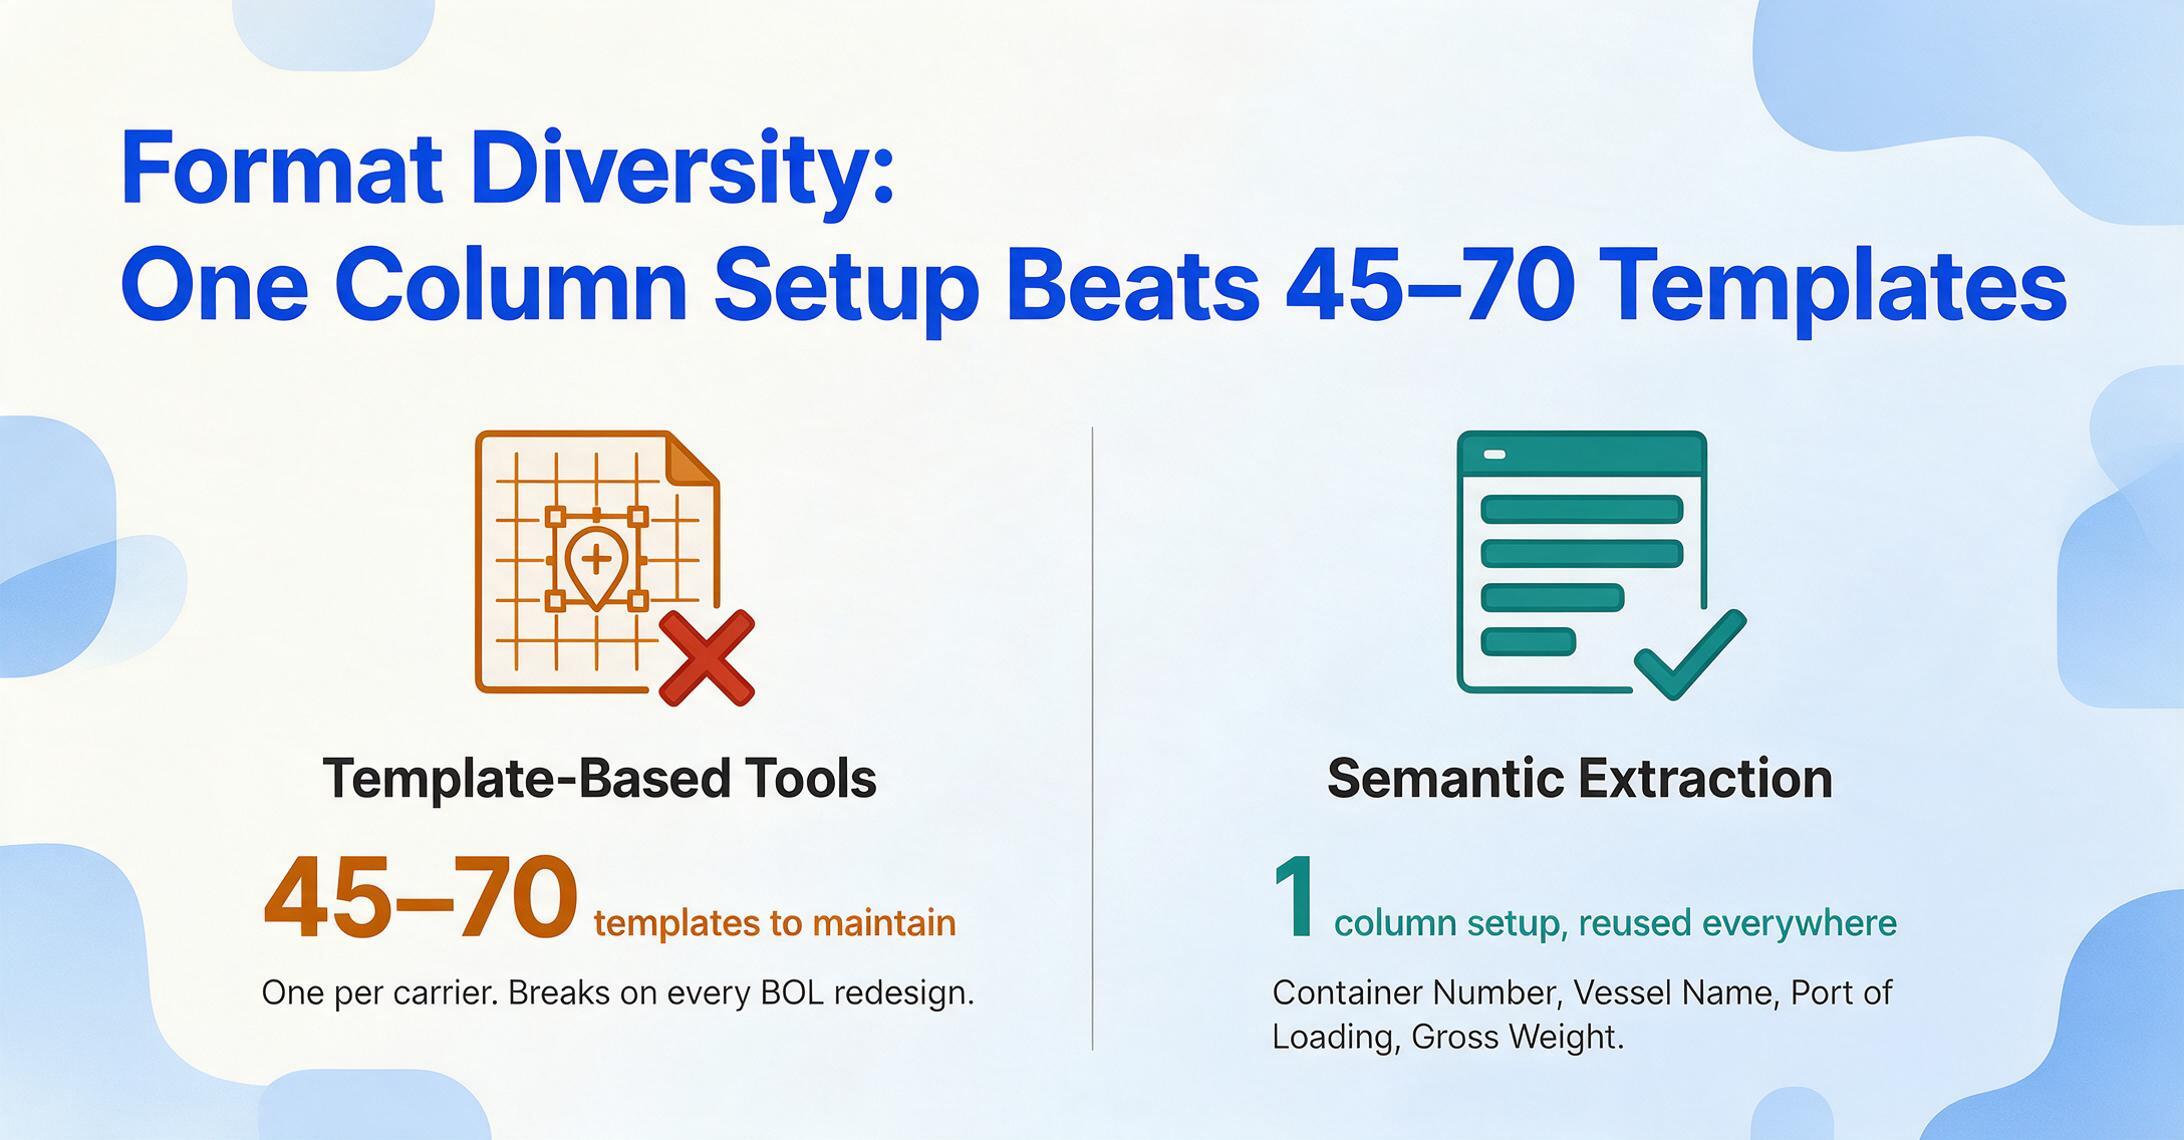
Le premier test de tout outil d'extraction de documents pour la logistique est la diversité des formats — et cela signifie quelque chose de différent de ce que montrent la plupart des démos de fournisseurs. La démo standard charge un PDF parfaitement scanné avec des polices propres et extrait les champs en quelques secondes. Un opérateur logistique doit savoir ce qui se passe lorsque vous chargez un BOL Maersk, un BOL MSC, un BOL COSCO et un BOL d'un transporteur régional dans le même lot avec la même configuration de colonnes, et que le numéro de conteneur se trouve dans un quadrant différent de la page sur chaque format de transporteur.
La plupart des outils d'extraction se répartissent en deux catégories ici. Les outils basés sur des modèles exigent que vous dessiniez des cadres de délimitation ou définissiez des ancres de coordonnées pour chaque champ sur chaque mise en page de document — ce qui signifie maintenir un modèle par transporteur. Un transitaire de taille moyenne travaillant avec 15 à 20 transporteurs maritimes et 30 à 50 transporteurs routiers régionaux doit maintenir 45 à 70 modèles, chacun d'entre eux échouant à la prochaine refonte du BOL par un transporteur. La deuxième catégorie — celle qu'utilise ImageToTable.ai — est l'extraction sémantique via un modèle de vision : vous saisissez les noms de colonnes à extraire (numéro de conteneur, nom du navire, port de chargement, poids brut), et l'IA localise les valeurs sur chaque document en comprenant ce que ces champs signifient sémantiquement, et non en se souvenant de leur emplacement sur un modèle. La même configuration de colonnes — ce que l'outil appelle Extraction de colonnes personnalisées — fonctionne simultanément sur tous les formats de transporteurs, car l'IA lit comme le ferait une personne : en parcourant le document à la recherche du concept « numéro de conteneur » et en extrayant la chaîne alphanumérique adjacente, quel que soit l'endroit où cette chaîne apparaît sur la page.
Cette distinction importe plus en logistique que dans tout autre secteur. En comptabilité fournisseurs, le format d'une facture varie — mais la variation entre une facture Sysco et une facture US Foods est modeste : les deux placent le total en bas à droite, les deux listent les lignes d'articles dans un tableau. En logistique, la variation entre un BOL maritime Maersk et un BOL LTL Estes est architecturale — les documents sont conçus pour des cadres réglementaires différents, des modes de transport différents, des structures de responsabilité différentes. Un outil basé sur des modèles qui fonctionne pour les factures AP échouera dès le premier changement de transporteur dans un flux de travail logistique.
Lors de l'évaluation, testez cela directement : apportez des BOL de trois transporteurs différents — un maritime, un LTL national, un routier régional — dans l'environnement de démonstration de l'outil avec le même ensemble de colonnes d'extraction. Si vous devez créer un modèle séparé pour chacun, le temps gagné sur l'extraction sera dépensé en maintenance de modèles. Pour un test comparatif de la manière dont neuf outils d'extraction gèrent réellement ce type de variation entre transporteurs, consultez notre comparaison des outils d'extraction de documents logistiques ; pour les mécanismes d'exécution d'un BOL de bout en bout dans le flux de travail, consultez comment extraire les données BOL vers Excel.
Critère d'évaluation 2 : Peut-il recouper les informations entre les documents ?
L'extraction d'un document unique n'est que le minimum. Ce qui distingue un outil adapté à la logistique d'un lecteur de documents générique, c'est sa capacité à prendre en charge les flux de rapprochement que les responsables logistiques exécutent réellement — à commencer par la vérification croisée entre le BOL et la facture de fret.
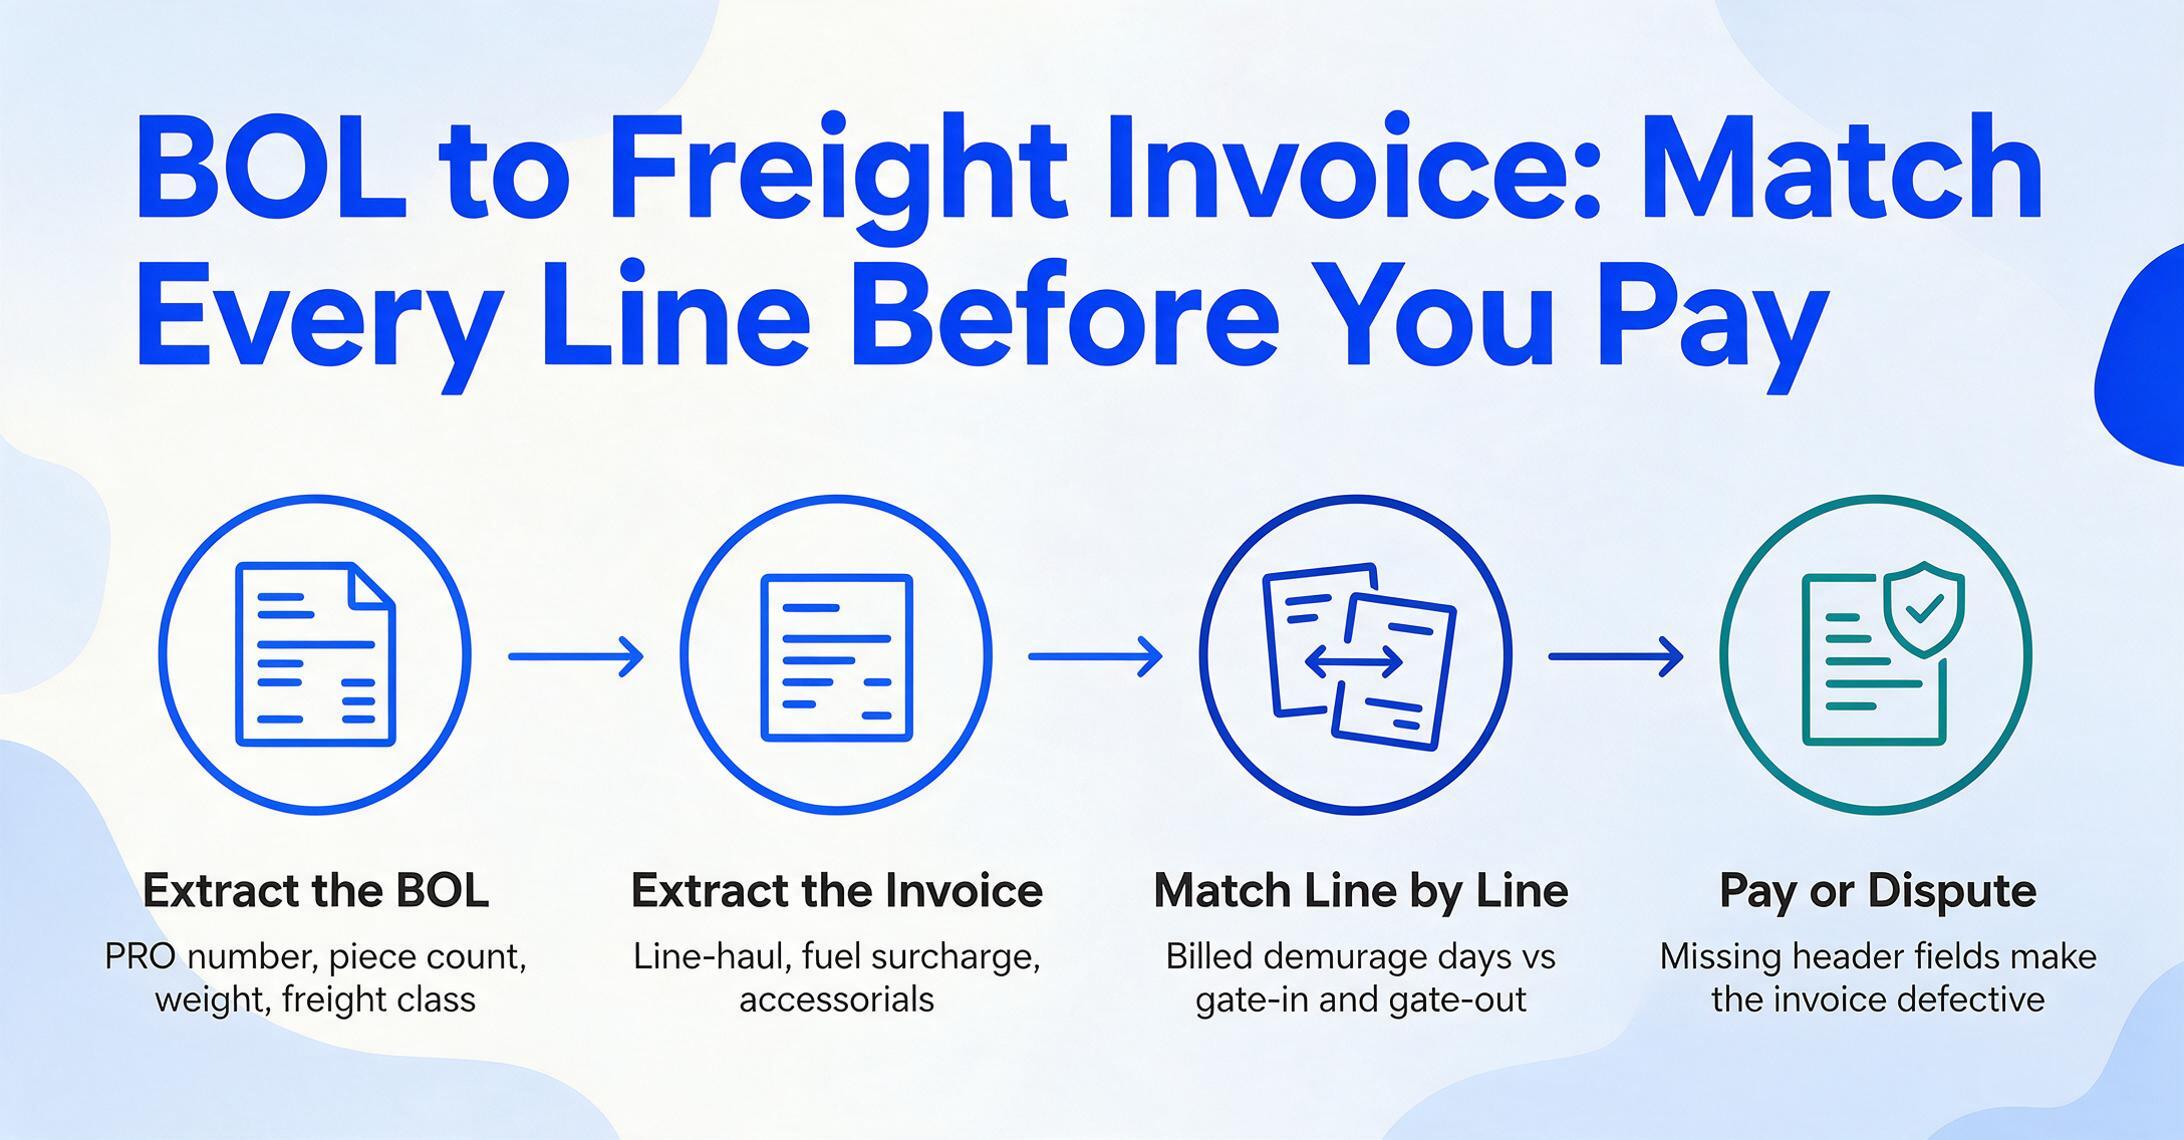
Une facture de fret d'un transporteur maritime n'est pas une simple facture. Elle détaille le prix du transport principal, un supplément carburant indexé sur un taux de soute spécifique, les éventuels frais accessoires — utilisation du châssis, jours de surestaries, jours de détention, frais de documentation, supplément pour matières dangereuses — et un total. Chaque ligne doit être vérifiée par rapport à un document source. Le prix du transport principal doit correspondre à la confirmation de tarif convenue à la réservation. Le nombre de pièces et le poids indiqués sur la facture doivent correspondre à la description de la cargaison déclarée sur le BOL. Les jours de surestaries facturés doivent être alignés sur les horodatages d'entrée et de sortie du terminal, par rapport au temps franc autorisé par le tarif du terminal. Et conformément au 46 CFR Part 541, la facture doit également contenir des champs d'en-tête spécifiques — si le numéro de BOL, le numéro de conteneur, la date de disponibilité ou la base de tarification manquent, la facture est défectueuse et peut ne pas devoir être payée du tout.
C'est là qu'un outil qui extrait à la fois les BOL et les factures de fret dans la même feuille de calcul crée un flux de travail que les outils mono-document ne peuvent pas offrir. Vous téléchargez le BOL, définissez des colonnes pour le numéro PRO, le nombre de pièces, le poids, la classe de fret et le transporteur. Ensuite, vous téléchargez la facture de fret dans le même lot, en extrayant le prix du transport principal, le supplément carburant, les frais accessoires et le nombre de pièces facturé. Les deux types de documents alimentent des lignes ou des colonnes adjacentes d'une seule feuille de calcul, et la vérification croisée — le poids facturé correspond-il au poids du BOL ? le nombre de pièces est-il aligné ? — devient une vérification par formule plutôt qu'une recherche manuelle dans deux PDF séparés avec une calculatrice.
La même logique s'applique à la liste de colisage → la réception en entrepôt et à la facture commerciale → la validation de la déclaration en douane. Une fois que les données des six documents d'un dossier d'expédition se trouvent dans le même tableau structuré, l'étape de rapprochement qui occupe actuellement toute la matinée d'un coordinateur logistique devient un simple filtre de feuille de calcul. C'est cette capacité qui rend un outil d'extraction de documents véritablement utile pour une opération logistique — non seulement pour lire plus vite, mais aussi pour rendre les écarts visibles avant qu'ils ne se transforment en frais de surestaries.
57 % des dirigeants logistiques ont signalé des retards d'expédition au cours de l'année écoulée, directement liés à des erreurs documentaires. La plupart de ces erreurs n'étaient pas des champs manquants — c'étaient des champs incohérents entre les documents, que personne n'avait recoupés parce que la vérification manuelle de six PDF prend plus de temps que la fenêtre de temps franc de l'expédition.
Critère d'évaluation 3 : Extraction prête pour les douanes
Si votre activité implique le transport de marchandises à travers les frontières, l'outil d'extraction doit gérer les documents douaniers — et cette exigence est plus difficile qu'il n'y paraît. Les formulaires douaniers sont des documents denses, normalisés par le gouvernement, avec des exigences de précision au niveau des champs qu'une approche générique « extraire tout le texte » ne satisfait pas.
Le CBP Form 7501, le résumé d'entrée, est un PDF de 27 pages avec plus de 40 blocs de données. Le bloc 1 contient le numéro d'entrée alphanumérique à 11 chiffres (code de déclarant à trois chiffres + numéro d'entrée à sept chiffres + un chiffre de contrôle). Le bloc 2 précise le code de type d'entrée — 01 pour la consommation, 21 pour l'entrepôt. Le bloc 6 contient le code du port (2704 pour Los Angeles). Les blocs 33 à 36 contiennent le détail des lignes : numéro HTS, pays d'origine, valeur déclarée en USD et calcul des droits. Chacun de ces champs a une conséquence en aval. Un code HTS erroné — notamment la classification à 10 chiffres du tarif douanier harmonisé — déclenche un taux de droits différent, ce qui peut signifier des milliers de dollars de trop-payé ou un audit du CBP.
La déclaration ISF 10+2, obligatoire pour toutes les importations maritimes, ajoute 12 éléments de données : vendeur, acheteur, importateur de référence, destinataire, fabricant, partie destinataire, pays d'origine et numéro HTS, entre autres. Ces éléments doivent être cohérents avec les données de la facture commerciale et du BOL, sinon le CBP signale la déclaration et le conteneur n'est pas libéré du terminal.
Un outil d'extraction de qualité logistique devrait extraire les champs douaniers avec leurs étiquettes intactes — pas seulement la chaîne numérique « 8471.30.0100 », mais l'association qui indique « c'est le code HTS pour les ordinateurs portables de la ligne 1 ». Il devrait extraire le pays d'origine par ligne, et non seulement une fois depuis l'en-tête. Et il devrait vous permettre d'extraire les données douanières dans la même feuille de calcul où les données du BOL et de la facture sont déjà présentes, afin que le résumé d'entrée du courtier en douane puisse être validé par rapport à la facture commerciale et à la description de la cargaison du BOL en une seule vue.
Le test pratique : demandez au fournisseur de traiter un vrai PDF CBP 7501 pendant l'évaluation. Vérifiez si les codes HTS extraits correspondent aux lignes auxquelles ils appartiennent, ou si l'outil produit une liste désordonnée de codes sans association de ligne. En douane, un code sans son contexte de ligne est inutile.
Critère d'évaluation 4 : Comment les documents arrivent dans l'outil
La plupart des cadres d'évaluation pour l'extraction de documents se concentrent entièrement sur ce qui se passe après le téléversement — la rapidité, la précision, le format d'export. Mais l'étape précédant l'extraction — la manière dont les documents entrent réellement dans la file de traitement — est là où les opérations logistiques perdent plus de temps qu'elles ne le pensent.
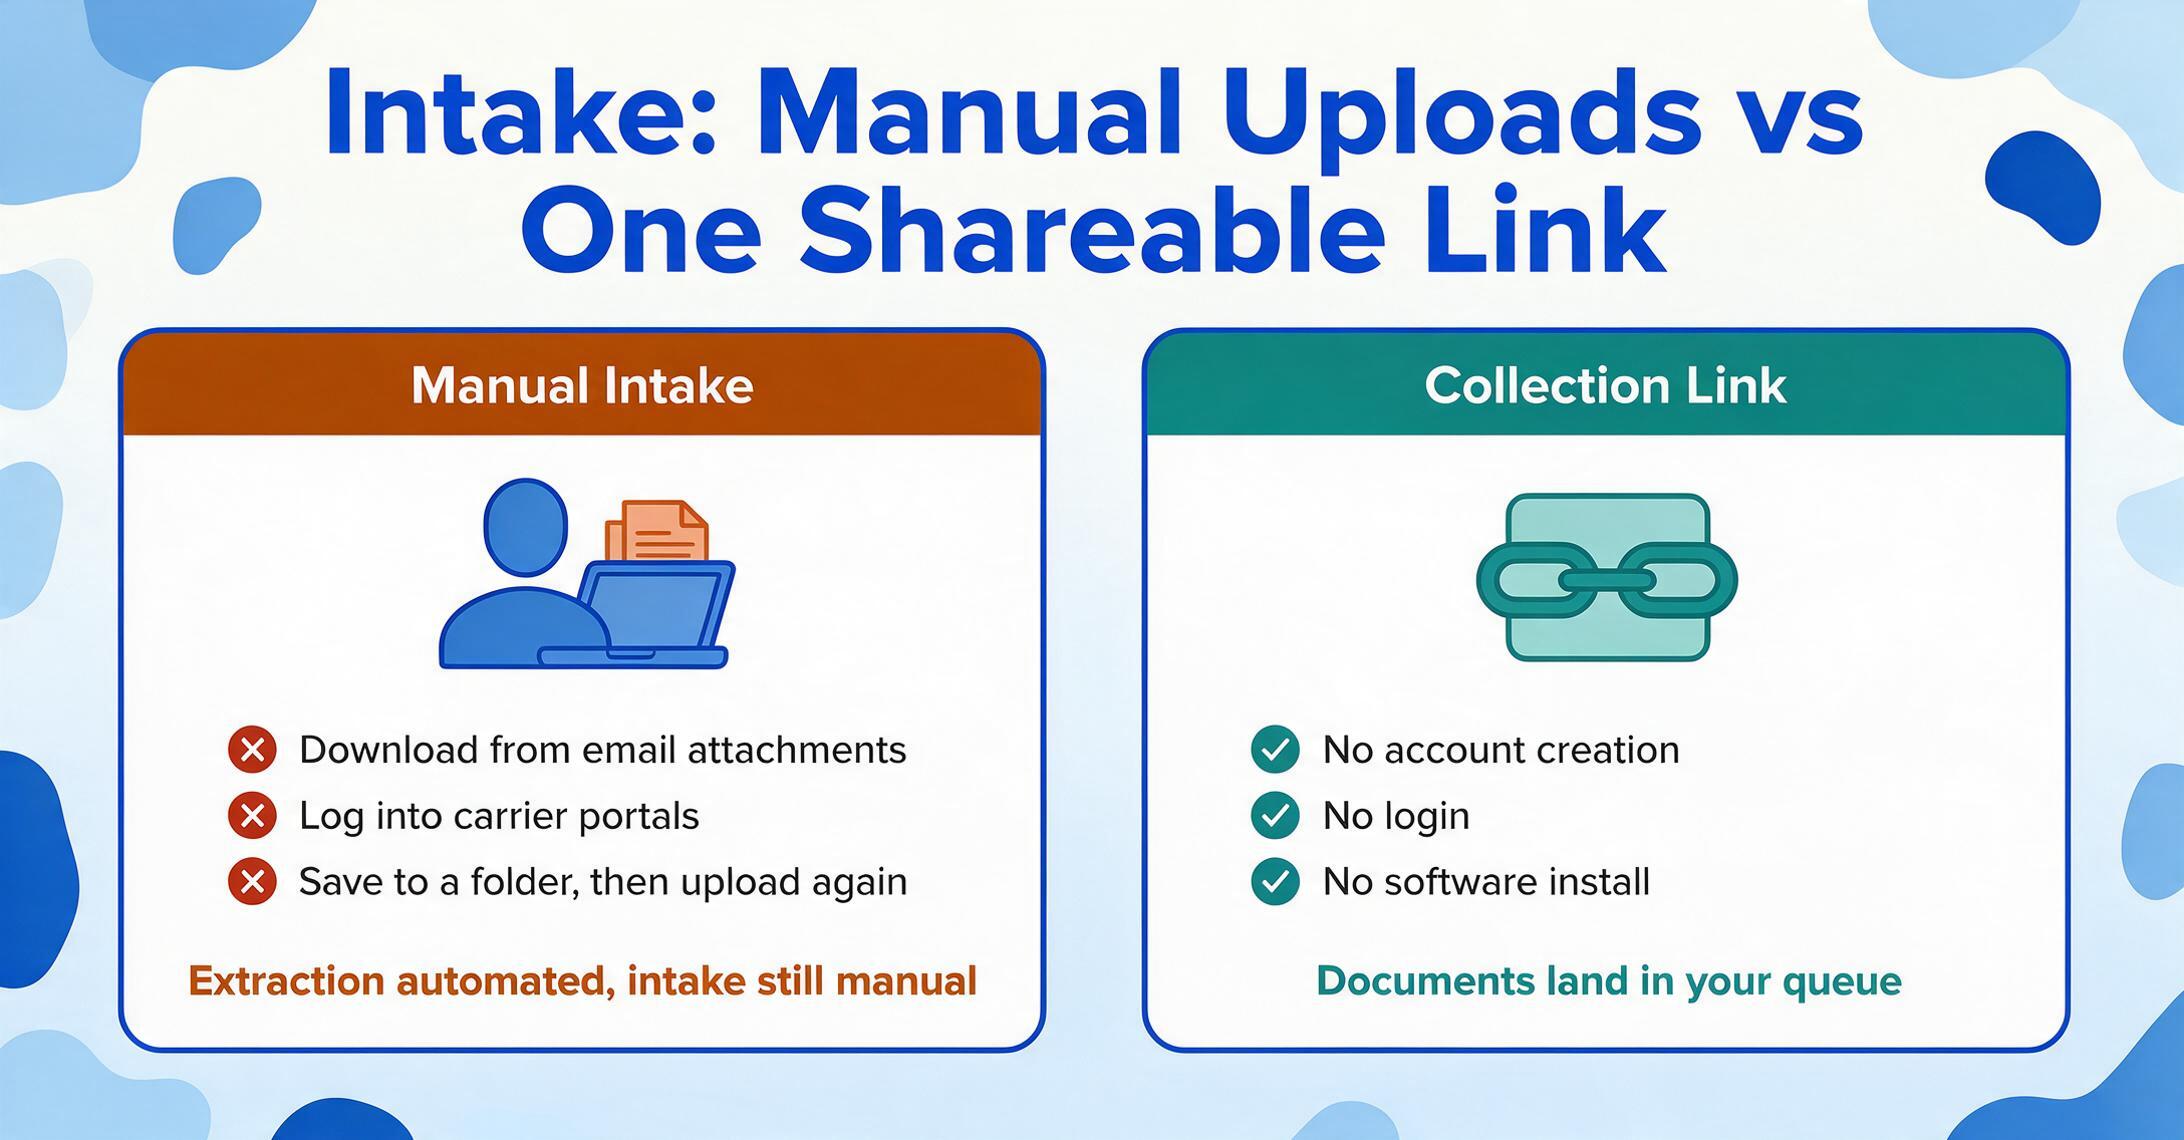
Dans un flux de travail logistique typique, les BOL arrivent en pièces jointes d'e-mails des expéditeurs. Les factures des transporteurs arrivent via les portails des transporteurs ou en PDF de la part du service de facturation. Les déclarations douanières viennent du courtier. Les listes de colisage viennent de l'entrepôt d'origine. Chaque source est une personne différente, un canal différent, et souvent un fuseau horaire différent. Si votre outil d'extraction exige que vous soyez celui qui téléverse tout — télécharger les pièces jointes des e-mails, se connecter aux portails des transporteurs, enregistrer les fichiers dans un dossier, puis les téléverser dans l'outil — vous avez automatisé l'étape d'extraction mais laissé l'étape de saisie entièrement manuelle.
C'est là qu'une fonctionnalité comme Lien de collecte change la donne dans l'évaluation. Un Lien de collecte est une URL partageable que vous générez depuis votre compte. Vous l'envoyez au bureau de répartition d'un transporteur, à l'entrepôt d'un expéditeur, ou à un courtier en douane — et ils ouvrent le lien, saisissent un court code de vérification, et téléversent leurs documents directement dans votre file de traitement. Pas de création de compte, pas de connexion, pas d'installation de logiciel de leur côté. Le BOL du transporteur, la liste de colisage de l'entrepôt et la déclaration douanière du courtier arrivent tous automatiquement dans votre file, et votre configuration d'extraction de colonnes les traite par lots.
Lors de l'évaluation des outils, posez deux questions sur la saisie : l'outil exige-t-il que vous soyez celui qui téléverse, ou des parties externes peuvent-elles soumettre des documents directement ? Et si la soumission externe est possible, fonctionne-t-elle sans que le soumissionnaire ait besoin d'une licence ou d'un compte payant ? En logistique, où les documents proviennent de dizaines de partenaires commerciaux externes, l'automatisation de la saisie est aussi importante que la précision de l'extraction — et c'est le critère que la plupart des listes de contrôle d'évaluation omettent entièrement.
Un outil unique ou des solutions ponctuelles : comment choisir
Le schéma est désormais clair : l'extraction de documents logistiques n'est pas un problème de document unique. C'est un problème de rapprochement multi-documents où chaque document alimente des données qui valident le suivant. Un outil qui ne traite que les BOL crée un jeu de données structuré tout en laissant les factures de fret, les déclarations douanières et les listes de colisage dans leurs PDF d'origine — et le recoupement qui évite réellement les trop-payés et les retards douaniers doit encore être effectué à la main.
Les solutions ponctuelles — un outil pour l'extraction des BOL, un autre pour le traitement des factures, une plateforme douanière dédiée aux déclarations — ont leur propre coût : les données vivent dans trois systèmes distincts, sans moyen automatisé de faire correspondre le conteneur MSCU1234567 entre la sortie d'extraction d'un BOL dans un outil et celle d'une facture de fret dans un autre. La réponse historique de l'industrie logistique à cette fragmentation a été le TMS : CargoWise, Descartes, MercuryGate, Trinium — des plateformes qui gèrent l'ensemble du cycle de vie de l'expédition, de la réservation au règlement. Mais les plateformes TMS ont été conçues pour un flux de travail où la saisie des données avait déjà eu lieu. Elles gèrent la charge une fois les données dans le système. Dès qu'un BOL papier ou un PDF scanné arrive, le TMS est inactif — quelqu'un doit encore saisir les données.
Un outil d'extraction unique qui traite les six types de documents logistiques avec la même configuration de colonnes élimine le problème du silo de données. Les données des BOL, des factures de fret, des données douanières et des documents de colisage atterrissent toutes dans une seule feuille de calcul, et le recoupement qui prenait des heures devient un ensemble de vérifications de formules — ou un balayage visuel des lignes adjacentes — qui prend quelques minutes.
Cela ne nécessite pas de contrat d'entreprise. ImageToTable.ai traite les six types de documents — BOL, factures commerciales, documents de colisage, déclarations douanières, factures de fret et reçus de livraison — avec la même configuration d'extraction de colonnes personnalisées utilisée pour tout document. Le prix commence à 19 $ par mois, bien en dessous du coût par utilisateur d'une mise à niveau de module TMS. Pour un aperçu plus approfondi de la manière dont l'extraction s'intègre dans le paysage plus large de la saisie de données, consultez notre aperçu de ce que fait réellement un logiciel d'extraction de documents et le paysage actuel des outils en 2026. Si vous comparez les plateformes d'entreprise aux alternatives légères, la comparaison entre l'extraction pour les entreprises et les PME couvre les compromis. Et pour une approche structurée de la sélection d'outils, le cadre d'évaluation de l'extraction de documents fournit une méthodologie générale qui complète les critères spécifiques à la logistique abordés ici.
Le bon outil d'extraction logistique ne vous oblige pas à choisir entre les types de documents. Il traite l'ensemble du dossier d'expédition — BOL, facture, document de colisage, déclaration douanière — avec une seule configuration de colonnes, afin que le recoupement devienne une formule, et non un audit manuel.
Questions fréquemment posées
L'extraction de documents fonctionne-t-elle avec les BOL manuscrits et les récépissés de livraison ?
Oui, avec certaines réserves. Les outils d'extraction basés sur des modèles de vision peuvent lire l'écriture manuscrite sur les BOL et les documents de preuve de livraison — signatures des conducteurs, quantités remplies à la main, tampons d'entrepôt — mais la précision diminue par rapport au texte imprimé, en particulier pour les scans en basse résolution ou les doublons de papier carbone où la troisième couche est peu visible. Pour les champs manuscrits sur des documents autrement imprimés (un conducteur écrivant à la main une correction de quantité sur un BOL imprimé), la précision est généralement élevée. Pour les formulaires entièrement manuscrits, prévoyez de vérifier les données extraites plutôt que de vous y fier sans contrôle.
Peut-il gérer les documents douaniers multilingues ?
Oui. Une facture commerciale d'un fournisseur chinois rédigée en mandarin, une liste de colisage allemande (« Lieferschein » au lieu de « Packing List ») ou un certificat d'origine coréen — les modèles de vision traitent le texte visuel quelle que soit la langue et étiquettent les valeurs extraites sous vos noms de colonnes en anglais. L'outil lit ce qui figure sur la page ; l'en-tête de colonne que vous choisissez devient le libellé de sortie. Pour une opération logistique japonaise, consultez notre guide de saisie de données IA sans code.
Comment l'extraction s'intègre-t-elle à mon TMS existant — CargoWise, Descartes, MercuryGate ?
L'extraction de documents ne remplace pas votre TMS — elle l'alimente. Vous extrayez des données structurées des BOL, factures et formulaires douaniers dans une feuille de calcul Excel, puis vous importez cette feuille dans votre TMS via sa fonction d'import de données standard. La plupart des plateformes TMS — CargoWise via le téléchargement XML, Descartes via l'import CSV, MercuryGate via le chargeur de données — acceptent les imports de feuilles de calcul en masse. L'outil d'extraction gère l'étape PDF-vers-feuille de calcul que le TMS ne couvre pas ; le TMS gère la gestion des chargements, le suivi et le règlement pour lesquels il a été conçu. Aucune intégration API n'est requise, sauf si votre volume justifie d'en construire une.
Quel est le taux de précision sur les documents logistiques en particulier ?
Pour les BOL imprimés, les factures commerciales et les formulaires douaniers avec des polices claires, la précision des données de tableaux imprimés atteint jusqu'à 99 % — ce qui équivaut à environ un champ à vérifier sur cent champs extraits, soit environ une correction pour 8 à 10 documents. Les champs manuscrits, les descriptions de marchandises sur plusieurs lignes avec des éléments imbriqués, et les scans en basse résolution (PDF de qualité fax) réduisent la précision et peuvent nécessiter une vérification humaine des extractions signalées. Le flux de travail pratique est le suivant : l'IA extrait tout, vous vérifiez les champs signalés à faible confiance, et vous examinez les documents manuscrits ou endommagés. C'est environ 18 fois plus rapide que la saisie manuelle complète, même en incluant l'étape de vérification. Pour une comparaison plus approfondie de l'OCR hérité par rapport à l'extraction IA moderne, spécifiquement sur les types de documents logistiques, consultez notre guide OCR pour la logistique.
Ai-je besoin d'outils séparés pour chaque type de document ?
Non — et c'était l'argument central du cadre d'évaluation ci-dessus. Un outil qui utilise l'extraction sémantique (lecture des champs par leur signification, et non par leur position dans un modèle) gère les BOL, les factures de fret, les listes de colisage, les déclarations en douane et les factures commerciales avec la même configuration de colonnes. Vous définissez les colonnes une seule fois — Numéro de conteneur, Nom du navire, Code HS, Valeur déclarée, Frais de transport principal — et la même configuration fonctionne pour les six types de documents lorsque vous les téléversez en lot. Des outils séparés par type de document créent des silos de données qui rendent le recoupement plus difficile ; un seul outil crée un ensemble de données unifié où le recoupement devient une formule de tableur.
Évaluez sur vos propres documents
Téléversez un BOL Maersk, une facture de fret Estes et une liste de colisage. Voyez si une seule configuration de colonnes extrait les trois dans le même tableur — sans créer un seul modèle.
Essayez ImageToTable.ai gratuitementAucune inscription requise. Les fichiers sont traités de manière sécurisée et non stockés.