Paysage des logiciels d'extraction de documents 2026
Une carte, pas un classement
Deux outils peuvent tous deux extraire des données de factures à partir d'un PDF. L'un coûte $19 par mois. L'autre nécessite une conversation avec une équipe commerciale qui commence à $1,500 par mois. Ils utilisent la même classe d'AI sous le capot. L'écart de prix de 75x ne concerne pas la qualité d'extraction — il s'agit du fait qu'ils ont été conçus pour des organisations complètement différentes, avec des structures d'équipe différentes, des profils de volume différents et une tolérance différente à la complexité de mise en œuvre. Si vous commencez votre recherche de fournisseurs et comparez les fonctionnalités entre les fourchettes de prix sans d'abord comprendre quelle catégorie d'outil a été conçue pour votre situation, vous n'évaluez pas — vous devinez. Cet article dessine la carte.
Points clés
- 100+ fournisseurs d'extraction de documents revendiquent tous une précision de 99% — et un outil comme ImageToTable.ai à $19/mois utilise la même classe d'AI sous le capot que ceux qui commencent à $1,500.
- Comparer les fonctionnalités entre les fourchettes de prix est l'erreur la plus coûteuse que les acheteurs commettent — un outil sans code à $19 et une plateforme d'entreprise à $1,500 n'ont jamais été conçus pour être des alternatives, ils ont été construits pour des organisations différentes avec des structures d'équipe différentes.
- Trois questions vous placeront dans la bonne catégorie plus rapidement que toute démo de fournisseur : combien de documents par mois, qui utilise l'outil, et ce qui arrive aux données après l'extraction.
Pourquoi la catégorie importe plus que les fonctionnalités
Le marché du traitement intelligent des documents a atteint environ 3,2 milliards de dollars en 2026, avec une croissance projetée de 18 à 30 % de CAGR selon le cabinet d'analystes auquel vous vous adressez — Mordor Intelligence l'estime à 3,17 milliards de dollars, tandis que Fortune Business Insights rapporte 14,16 milliards de dollars dans un périmètre plus large incluant les services adjacents de gestion documentaire. (L'écart entre ces chiffres est en soi un signal : différents analystes comptent différentes choses, et « l'extraction de documents » en tant que catégorie a des contours flous.)
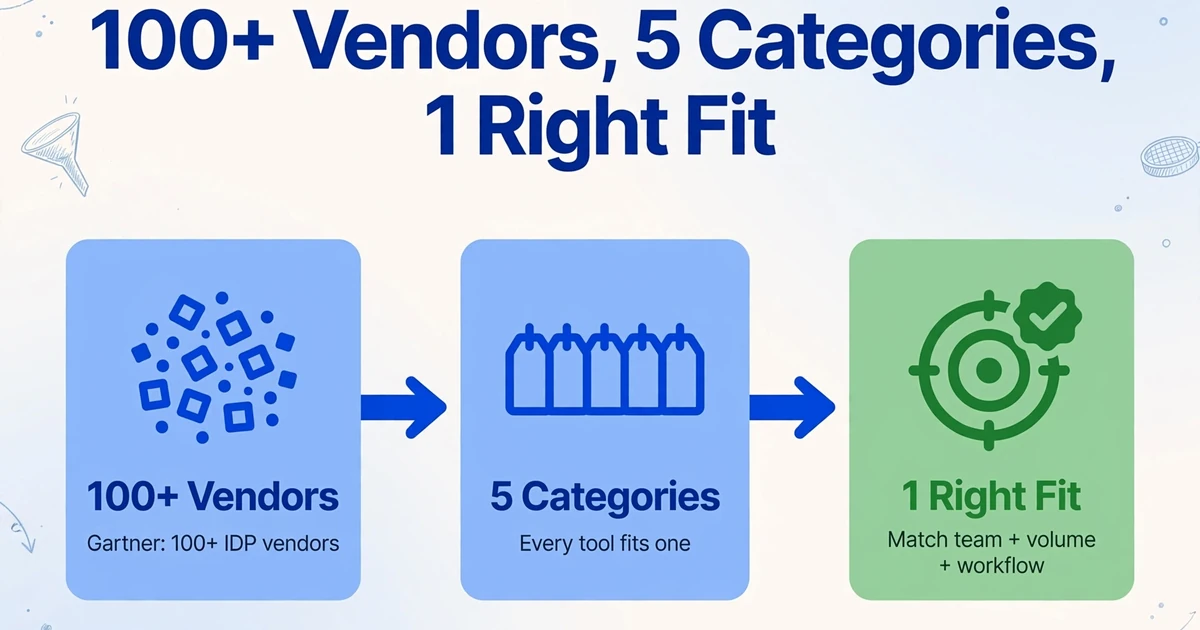
Ce qui importe plus que la taille exacte du marché, c'est la fragmentation. Le plus récent Magic Quadrant de Gartner pour le traitement intelligent des documents recense plus de 100 fournisseurs — des hyperscalers du cloud aux startups de niche. Pour un acheteur qui vient d'ouvrir un onglet de recherche, ce nombre est paralysant.
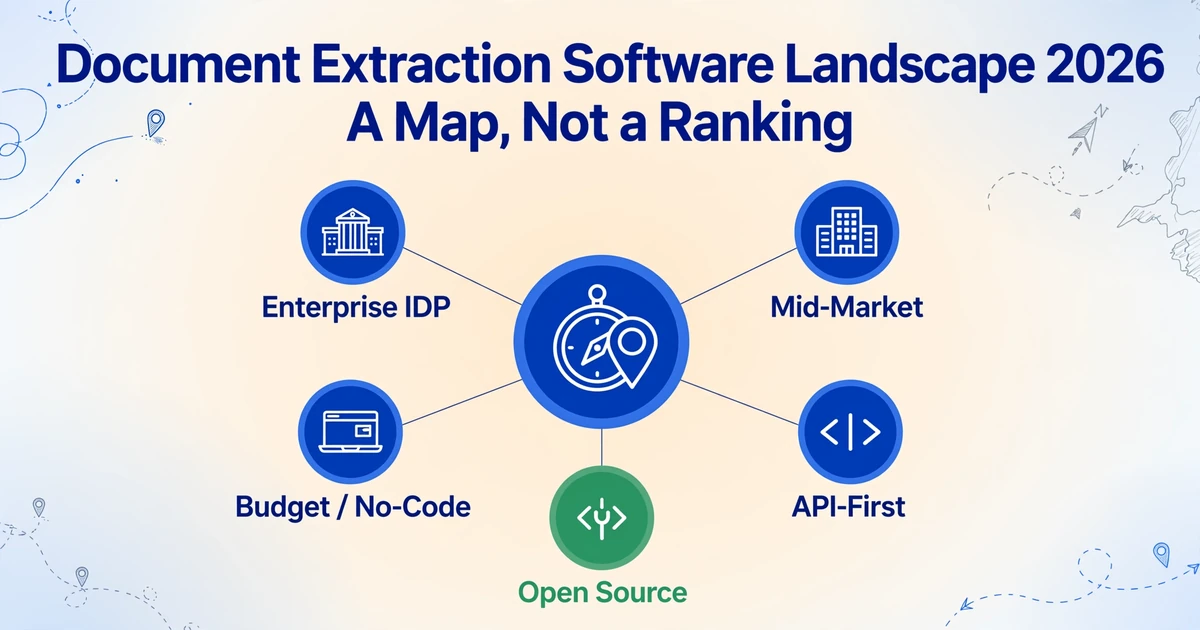
Mais la fragmentation n'est pas aléatoire. Chaque outil sur le marché appartient à l'une d'environ cinq catégories, chacune construite autour d'une réponse différente aux mêmes trois questions : Quelle est la taille de l'organisation ? Combien de documents transitent par mois ? Qui va utiliser l'outil — un ingénieur, un comptable, ou les deux ?
Les catégories ne sont pas des niveaux de qualité. Un outil à 19 $/mois n'est pas une version « inférieure » d'une plateforme d'entreprise à 1 500 $/mois — c'est une architecture différente optimisée pour un cas d'usage différent. L'erreur qui coûte le plus cher aux acheteurs n'est pas de choisir le mauvais outil au sein d'une catégorie. C'est de choisir la mauvaise catégorie entièrement — puis de passer des mois à essayer de faire correspondre l'outil.
Avant de comparer les outils
Sachez quelle catégorie a été conçue pour la taille de votre équipe, votre volume mensuel et vos compétences techniques. Une mauvaise adéquation de catégorie est l'erreur la plus coûteuse dans la sélection d'un logiciel d'extraction de documents — et elle est invisible dans un tableau comparatif de fonctionnalités.
Les cinq catégories en un coup d'œil
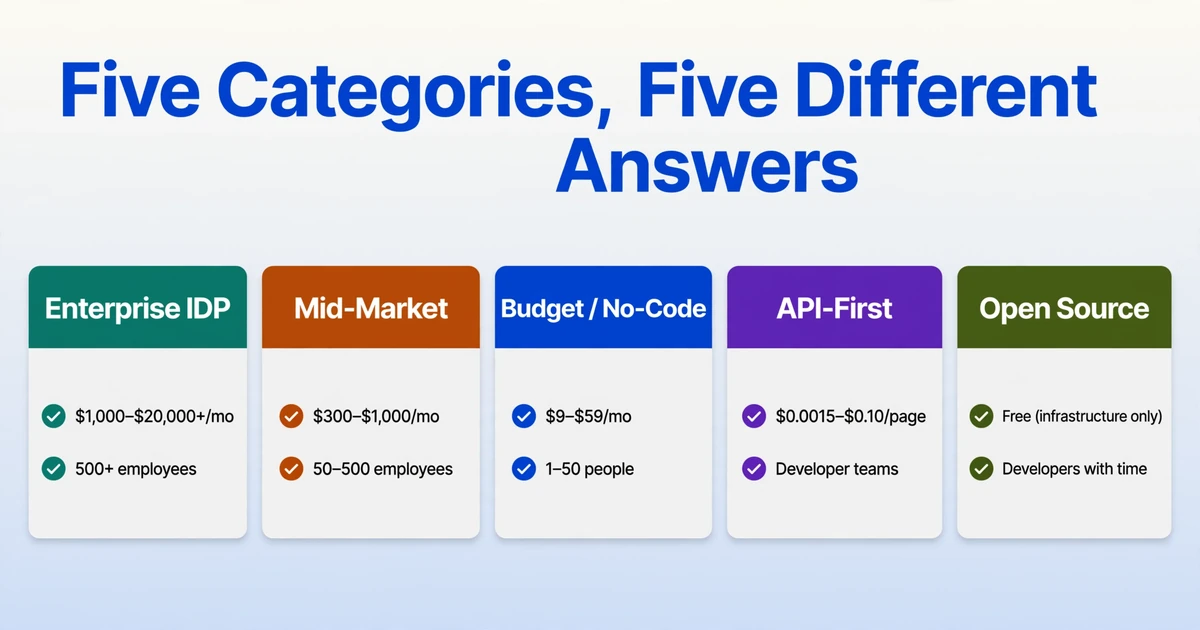
Voici le paysage en un tableau. Chaque catégorie est une réponse différente à la question : « À qui cela s'adresse-t-il, combien cela coûte-t-il, et quel est le compromis ? » Le reste de cet article détaille chacune d'elles.
| Catégorie | À qui cela s'adresse | Fourchette de prix typique | Compromis principal | Exemples |
|---|---|---|---|---|
| IDP d'entreprise | Organisations de 500+ employés, équipe informatique dédiée, exigences de conformité | 1 000 $–20 000 $+/mois | Puissance maximale, poids d'implémentation maximal | ABBYY Vantage, Hyperscience, Rossum, UiPath IXP |
| Spécialisé mid-market | 50–500 employés, équipe finance/opérations, volume modéré | 300 $–1 000 $/mois | Bonne précision à un coût raisonnable, mais couverture de flux de travail moindre | Nanonets, Docsumo, Affinda, Docparser |
| Budget / Sans code | 1 à 50 personnes, sans support informatique, configuration rapide requise | 9 $–59 $/mois | Démarrage le plus rapide, coût le plus bas, limité aux flux d'extraction uniquement | ImageToTable.ai, Airparser, Parseur, Parsio |
| API d'abord / Cloud-natif | Équipes de développeurs intégrant l'extraction dans leur propre produit | Par page (0,0015 $–0,10 $/page) | Contrôle complet du pipeline, nécessite un investissement en ingénierie | Google Document AI, Amazon Textract, Azure Document Intelligence |
| Open Source | Développeurs avec du temps, équipes nécessitant un contrôle total des données | Gratuit (coût d'infrastructure uniquement) | Coût de licence nul, charge d'ingénierie maximale | Tesseract, PaddleOCR, docTR |
Plateformes IDP d'entreprise : quand l'échelle exige une suite complète
Les plateformes IDP d'entreprise constituent la catégorie que la plupart des acheteurs rencontrent en premier — car elles disposent des plus grands budgets marketing et des plus longues histoires commerciales. Les outils de ce niveau — ABBYY Vantage, Hyperscience, le traitement intelligent de documents d'UiPath, l'offre entreprise de Rossum — ont été conçus pour des organisations traitant des dizaines de milliers de documents par mois dans plusieurs départements, avec du personnel informatique dédié, des processus d'achat formels et des exigences de conformité qui imposent des pistes d'audit.
Ce que vous achetez : Une plateforme de traitement documentaire de bout en bout. L'extraction n'est qu'un module. La plateforme comprend également la classification des documents (identification automatique du type de document qui vient d'arriver), les règles de validation, le routage basé sur la confiance (les résultats à haute confiance passent directement, les résultats à faible confiance vont dans une file de révision humaine), les connecteurs d'intégration ERP/CRM et le contrôle d'accès basé sur les rôles. Quand ABBYY ou Rossum vend à une entreprise, ils ne vendent pas de l'extraction — ils vendent une couche d'exploitation documentaire.
Le coût réel : Le plan de démarrage de Rossum commence autour de 18 000 $ par an. Le niveau entreprise de Nanonets démarre à 999 $/mois et augmente avec le volume. ABBYY ne publie aucun prix. Mais le coût de la licence est généralement le plus petit des deux postes de dépense. La mise en œuvre — configuration des types de documents, entraînement des modèles, intégration avec les systèmes existants, formation du personnel — prend généralement de 3 à 12 mois et coûte plus cher que la première année de licence. Un rapport de Forrester sur l'adoption de l'IDP note que les acheteurs qui sous-estiment la complexité de la mise en œuvre « voient souvent des taux de précision en phase pilote qui semblent prometteurs mais ne parviennent pas à se traduire en production sans des mois de réglages ».
Le compromis : Vous obtenez la pile d'automatisation documentaire la plus complète disponible. Vous obtenez également la charge de mise en œuvre la plus lourde. Si votre organisation traite réellement plus de 10 000 documents par mois sur plusieurs types de documents et dispose d'une équipe informatique pour gérer le déploiement, la charge lourde est rentabilisée par la densité d'automatisation — une seule plateforme gère tout, de l'ingestion du courrier à la comptabilisation ERP. Si vous traitez 300 factures par mois et n'avez pas de département informatique, vous payez pour une complexité d'infrastructure que vous n'utiliserez jamais et un calendrier de déploiement qui dépassera votre patience.
Les plateformes d'entreprise ont également tendance à être les plus performantes en matière de manuscrit et de structures de tableaux complexes — Hyperscience a notamment bâti sa réputation sur le traitement de documents manuscrits pour les agences gouvernementales et les payeurs de soins de santé. Si votre mix documentaire comprend un pourcentage important de formulaires manuscrits, le niveau entreprise peut être la seule catégorie offrant la précision nécessaire pour les traiter proprement.
Outils spécialisés pour le marché intermédiaire : une puissance ciblée sans le superflu
Les outils du marché intermédiaire se situent dans la fourchette de 300 à 1 000 $ par mois et résolvent le problème que les plateformes d'entreprise créent pour les organisations plus petites : trop d'outil, trop de coûts, trop de mise en œuvre. Nanonets, Docsumo, Affinda et Docparser sont les noms les plus visibles ici. Ils n'essaient pas d'être des plateformes tout-en-un — ils se concentrent sur l'extraction et vous laissent gérer le flux de travail en aval avec vos outils existants.
Ce qui diffère des solutions d'entreprise : Vous bénéficiez d'une extraction basée sur l'IA qui gère des mises en page variables sans modèle — la même technologie sous-jacente que le niveau entreprise. Ce que vous n'aurez pas, c'est la pile complète d'automatisation des flux de travail : pas d'acheminement d'approbation intégré, pas de bibliothèque de connecteurs ERP, pas de contrôle d'accès basé sur les rôles pour les audits de conformité. Ces outils partent du principe que vous avez déjà des systèmes pour ces fonctions et que vous avez seulement besoin de l'extraction pour alimenter ces systèmes en données.
Le point idéal : Un cabinet comptable de taille moyenne traitant de 2 000 à 5 000 documents par mois. Un volume suffisant pour que la saisie manuelle soit réellement coûteuse, mais pas assez pour justifier un déploiement d'entreprise de 6 mois. L'approche OCR zonal de Docparser fonctionne bien pour les organisations ayant des mises en page de documents cohérentes (mêmes fournisseurs chaque mois, mêmes formulaires). Nanonets et Docsumo utilisent des modèles d'apprentissage profond qui gèrent mieux les variations — utile lorsque vos documents entrants proviennent de plus de 50 contreparties différentes sans que deux formats ne soient identiques.
Le compromis : Une meilleure précision que les outils économiques sur les types de documents répétitifs à volume élevé, à une fraction du prix des solutions d'entreprise. Mais vous atteindrez un plafond en matière de personnalisation — vous voulez ajouter une règle de validation personnalisée qui recoupe les données extraites avec votre ERP avant que le résultat ne soit accepté ? C'est le territoire des solutions d'entreprise. Le niveau intermédiaire couvre l'extraction en profondeur ; il vous laisse gérer le « ce qui se passe après l'extraction ».
De nombreux acheteurs de ce niveau doivent également décider s'ils veulent passer par une API ou par une approche sans code — certains outils du marché intermédiaire offrent les deux voies, et le choix dépend de la disponibilité de développeurs pour créer des intégrations ou de la nécessité de tout faire fonctionner via une interface navigateur.
Outils économiques / sans code : le palier en libre-service
C'est là que le paysage a le plus évolué au cours des deux dernières années. Des outils comme ImageToTable.ai, Airparser, Parseur et Parsio opèrent dans la fourchette de 9 à 59 $/mois. Ils sont conçus pour un acheteur précis : quelqu'un qui doit extraire des données de documents aujourd'hui, qui ne peut pas attendre un cycle d'approvisionnement et qui n'a pas de développeur pour créer une intégration. L'ensemble du flux de travail s'exécute dans un navigateur.
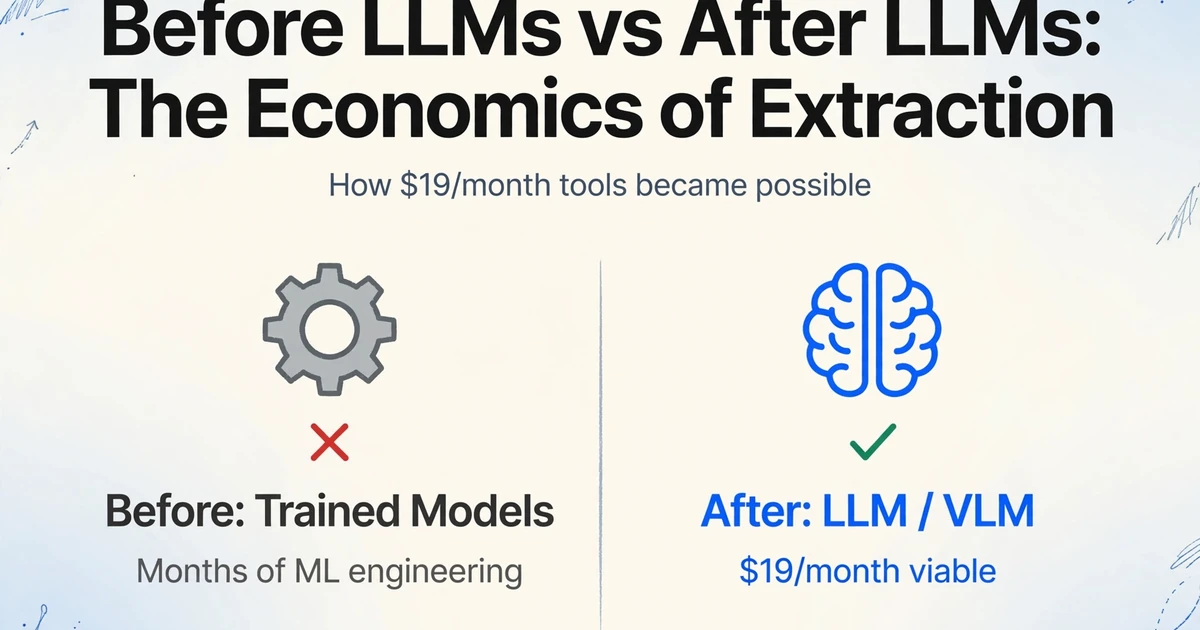
Le changement technologique qui a rendu cette catégorie viable : Il y a deux ans, un outil d'extraction à 19 $/mois ne pouvait pas exister, car la seule façon d'obtenir une précision décente passait par des modèles entraînés — et l'entraînement de modèles exigeait soit (a) des mois d'ingénierie en machine learning, soit (b) de payer un fournisseur d'entreprise qui l'avait déjà fait. L'arrivée des grands modèles de langage et des modèles vision-langage a changé l'économie. Au lieu d'entraîner un modèle par type de document, ces outils envoient votre document à un LLM ou un VLM qui le lit comme le ferait un humain — en comprenant ce que les champs signifient, et non où ils se trouvent sur la page. Le coût par document de cette approche a suffisamment baissé pour rendre les forfaits à 19 $/mois viables pour des centaines de pages par mois.
Comment cela fonctionne en pratique : Vous téléversez un PDF, un JPG ou une capture d'écran. Vous saisissez les noms des champs souhaités — « Numéro de facture, Nom du fournisseur, Total, Date d'échéance ». L'IA trouve chaque valeur n'importe où sur la page en comprenant la sémantique, et non les coordonnées. Dans ImageToTable.ai, cela s'appelle Extraction de colonnes personnalisées : les noms de colonnes que vous saisissez deviennent les en-têtes de votre feuille de calcul de sortie. Besoin de traiter 50 factures à la fois ? Téléversez-les en un lot et obtenez un seul fichier Excel fusionné — chaque facture devient une ligne avec les colonnes que vous avez spécifiées. Vous pouvez même définir des colonnes calculées qui effectuent des calculs pendant l'extraction — comme « Total de la ligne (Qté × Prix unitaire) » — afin que la feuille de calcul que vous téléchargez contienne des réponses, et pas seulement des données brutes.
La plupart des outils de ce palier proposent également une fonction Lien de collecte : générez une URL partageable, envoyez-la à des clients ou à des membres de l'équipe, et leurs documents téléversés arrivent directement dans votre file de traitement — aucune inscription requise de leur côté.
Le compromis : Cette catégorie offre le délai le plus court avant le premier résultat du marché — souvent moins de 2 minutes entre l'arrivée sur la page et le téléchargement d'une feuille de calcul. Le compromis, c'est que vous obtenez une extraction, pas une plateforme de flux de travail. Si vous avez besoin d'une comptabilisation automatique dans l'ERP, d'un routage d'approbation ou d'une file de revue humaine avec des autorisations granulaires basées sur les rôles, vous avez besoin d'un outil d'une catégorie supérieure. Les outils économiques gèrent très bien l'étape d'extraction ; ils n'automatisent pas ce qui se passe avant ou après.
Quand les outils économiques gagnent
Un cabinet comptable de 3 personnes traite 200 factures clients par mois. Une plateforme IDP d'entreprise coûte 12× plus cher que le revenu mensuel généré par ces clients. Un outil économique à 19 $/mois extrait les mêmes champs des mêmes factures en utilisant la même classe d'IA — et le comptable travaille dans Excel 45 secondes après le téléversement. Ce qui manque, ce n'est pas la qualité d'extraction ; c'est l'automatisation des flux de travail dont ils n'avaient pas besoin en premier lieu.
API-First / Cloud-Native : construisez votre propre pipeline
Google Document AI, Amazon Textract et Azure Document Intelligence appartiennent à une catégorie entièrement différente. Ce ne sont pas des outils — ce sont des composants d'infrastructure. Vous ne vous connectez pas à un tableau de bord pour téléverser des fichiers. Vous écrivez du code qui envoie des documents à un point de terminaison REST et reçoit du JSON structuré en retour. La tarification est à la page (de 0,0015 $ à 0,10 $ selon le processeur), et le postulat est que votre équipe d'ingénierie construira l'ensemble du pipeline autour de l'étape d'extraction.
À qui cela s'adresse : aux entreprises SaaS intégrant l'extraction de documents dans leur propre produit. Aux équipes de développement d'entreprise disposant d'une infrastructure cloud existante et ayant besoin de l'extraction comme maillon d'une chaîne automatisée. Aux organisations traitant des documents à des volumes où la tarification à la page est moins chère que le SaaS par siège — si vous traitez 50 000 pages par mois, le tarif de Textract à 0,015 $/page (750 $ au total) peut être nettement moins cher qu'une plateforme d'entreprise à 1 500 $/mois, à condition d'avoir l'équipe d'ingénierie pour construire l'infrastructure environnante.
Ce que les fournisseurs cloud font bien : les processeurs pré-entraînés de Google Document AI pour les factures, les reçus et les documents d'identité sont réellement performants. L'extraction de tableaux d'Amazon Textract gère des mises en page complexes qui font échouer de nombreux outils tiers. Document Intelligence d'Azure s'intègre naturellement à l'écosystème Microsoft 365 et Power Platform dans lequel de nombreuses entreprises évoluent déjà.
La lacune : ce sont des API d'extraction, pas des solutions de traitement documentaire. Classification, validation, gestion des exceptions, revue humaine — tout cela doit être construit. Google, Amazon et Microsoft fournissent le moteur ; vous fournissez la voiture. Un développeur qui décrivait la construction d'une plateforme d'extraction de documents sur Reddit l'a dit clairement : « L'extraction de documents consiste moins à trouver un modèle parfait qu'à construire un système capable de gérer des milliers de variations de documents. » L'API vous donne la première étape — l'extraction — pas le système.
Pour les équipes qui évaluent s'il faut construire ou acheter, la ventilation complète des coûts — temps de développement, infrastructure, maintenance et tarification API — est détaillée dans notre analyse build vs buy. En bref : construire a du sens lorsque l'extraction de documents est votre produit, pas votre frais généraux.
Open Source : gratuit comme un chiot
Tesseract — développé à l'origine chez HP dans les années 1980, désormais maintenu par Google — reste le moteur OCR le plus déployé au monde. PaddleOCR, de Baidu, a gagné un essor considérable depuis 2023 grâce à sa prise en charge multilingue solide (plus de 100 langues) et à ses capacités de reconnaissance de tableaux. docTR, construit sur PyTorch et TensorFlow, propose une architecture plus moderne avec une détection et une reconnaissance entraînables de bout en bout.
Ces outils sont gratuits. La licence ne coûte rien. Mais l'OCR open source n'est pas de l'extraction de documents — c'est de la reconnaissance de caractères. Tesseract peut vous indiquer le texte présent sur une page. Il ne peut pas vous dire quelle chaîne de texte est le numéro de facture et laquelle est la référence PO. Cette logique de classification, d'extraction et de structuration, c'est vous qui la construisez — et c'est là que se trouve le coût réel.
Quand l'open source fonctionne : Vous avez un développeur qui connaît la vision par ordinateur, vous traitez des documents aux mises en page strictement fixes (même formulaire, mêmes coordonnées, à chaque fois), et votre volume justifie le coût de développement. PaddleOCR en particulier dispose d'un pipeline de reconnaissance de tableaux performant qui, combiné à un post-traitement personnalisé, peut rivaliser avec les outils commerciaux sur les documents tabulaires structurés — comme le notent les développeurs de la communauté OCR de Reddit qui l'ont comparé aux modèles plus récents et l'ont jugé comme l'option open source la plus fiable pour une utilisation en production.
Quand ce n'est pas le cas : Vos documents varient en termes de mise en page selon les contreparties. Vous avez besoin d'une extraction au niveau des champs, pas seulement d'un résultat textuel. Vous n'avez pas d'ingénieur en vision par ordinateur dans votre équipe. Dans ces conditions, l'outil « gratuit » coûte plus cher en temps d'ingénierie qu'un abonnement SaaS économique ne coûterait en un an.
Ce qui a changé en 2025–2026 : trois tendances qui redessinent le marché
Le paysage des fournisseurs ne reste pas figé. Trois évolutions structurelles redessinent activement les frontières de catégories décrites ci-dessus.
1. Les LLM et les VLM remplacent l'extraction basée sur des modèles — cette fois, pour de bon
Pendant deux décennies, l'approche dominante de l'extraction de documents reposait sur la correspondance de modèles : dessiner une zone autour du champ numéro de facture, indiquer au logiciel « la valeur est ici », et espérer que la facture suivante la place au même endroit. L'apprentissage automatique a légèrement amélioré cette approche en apprenant des motifs à partir d'exemples étiquetés, mais la dépendance fondamentale à une mise en page cohérente persistait. Boris Evelson, VP et analyste principal chez Forrester, écrivant dans le Document Mining and Analytics Platforms Landscape Q4 2025, décrit l'IA générative et agentique comme un « égaliseur qui remet en cause la capacité des fournisseurs à se différencier » sur les architectures basées sur des règles et des modèles.
Ce changement est architectural, pas incrémental. Un modèle de vision-langage ne cherche pas un champ à des coordonnées (x : 342, y : 891). Il lit le document dans son ensemble et répond à la question « quel est le montant total sur cette page ? » en comprenant la relation entre l'étiquette « Total » et le nombre à côté — indépendamment de l'endroit où ils apparaissent. C'est la même approche qu'utilise un lecteur humain, et c'est pourquoi les outils de toutes les catégories ont ajouté « sans modèle » à leur marketing en 2025-2026.
L'effet pratique : les outils qui ne pouvaient gérer que 80 % des formats de documents peuvent désormais en gérer plus de 95 %, car le mode d'échec — « la mise en page a changé » — n'est plus un mode d'échec du tout.
2. Traitement documentaire agentique : une extraction qui ne s'arrête pas à l'extraction
Le terme « agentique » a été fortement surexploité — et nous aborderons ce qui est réel par rapport à ce qui relève du marketing — mais l'idée centrale est authentique. L'IDP traditionnel fait ceci : saisir un document, produire du JSON. Le traitement documentaire agentique fait ceci : saisir un document, l'IA planifie un flux de travail en plusieurs étapes, extrait les données, les valide par rapport à des règles connues, les recoupe avec les données d'autres documents, et agit — en publiant dans un ERP, en déclenchant une approbation, en signalant une anomalie.
Kognitos définit l'extraction de données agentique comme des systèmes où « des agents d'IA autonomes planifient des flux de travail en plusieurs étapes, raisonnent de manière itérative sur un contenu ambigu, s'adaptent à des formats jamais vus auparavant, valident leurs propres résultats et prennent de plus en plus d'actions sur ce qu'ils extraient ». Le mot clé est itérativement : un système agentique qui rencontre un champ ambigu ne devine pas — il relit le document, vérifie le contexte et, s'il reste incertain, fait remonter le problème à un humain avec une question précise sur un champ précis.
La prévision parallèle Worldwide IDP Software Forecast d'IDC projette une croissance du marché de 29,6 % en CAGR, « principalement tirée par l'adoption des capacités d'IA agentique et générative dans l'automatisation documentaire ». La trajectoire est réelle, mais l'état actuel est inégal : l'étude Emerging Technology Trends 2025 de Deloitte a révélé que si 38 % des organisations pilotent l'IA agentique, seulement 11 % ont des agents activement en production.
3. Modèles multimodaux : les documents ne sont plus seulement du texte
La troisième tendance est la plus discrète, mais pourrait s'avérer la plus lourde de conséquences. Les outils d'extraction des générations précédentes traitaient les documents comme du texte qui se trouvait sur une image — d'abord l'OCR, puis le NLP. Ce pipeline échouait dès que la mise en page visuelle comptait : cases à cocher, signatures manuscrites à côté de dates imprimées, photos intégrées dans des rapports.
Les modèles vision-langage réduisent le pipeline OCR→NLP à une seule étape. Ils traitent le document comme une entrée visuelle — des pixels, pas du texte extrait — et raisonnent directement dessus. Un VLM peut répondre à la question « la case "Approuvé" est-elle cochée ? » en regardant la case, pas en déduisant du texte environnant. Il peut lire une note manuscrite dans la marge d'une facture imprimée sans étape distincte de reconnaissance de l'écriture.
Cela compte pour le paysage, car cela brouille la frontière entre les catégories. Un outil à petit budget de 19 $/mois utilisant un backend VLM peut désormais gérer des types de documents qui, il y a trois ans, exigeaient une plateforme d'entreprise dotée d'un modèle d'écriture manuscrite dédié. La technologie qui servait à différencier les niveaux de prix se diffuse vers le bas — ce qui signifie que la différenciation réelle entre les catégories passe de la précision d'extraction au workflow, à l'intégration et au support.
Surexploité vs Réel : séparer le signal du bruit
Chaque site web de fournisseur en 2026 a ajouté « propulsé par l'IA », « agentique » et « sans modèle » à sa page d'accueil. Voici ce qui se passe réellement par rapport à ce qui relève du marketing.
| Affirmation | Ce qui est réel | Ce qui est exagéré |
|---|---|---|
| « Précision de 99 % » | La précision OCR au niveau des caractères sur du texte numérique propre et haute résolution dépasse effectivement 99 % avec les outils modernes. | La précision d'extraction au niveau des champs sur des documents réels — numérisés, inclinés, tamponnés, multilingues — dépasse rarement 95 %. La plupart des affirmations de « 99 % » mesurent la mauvaise chose. Lorsque vous avez besoin que le total de la facture soit correct, la précision des caractères est sans importance ; la précision des champs est primordiale. |
| « Extraction sans modèle » | Les outils basés sur les LLM et les VLM gèrent réellement des mises en page variables sans configuration par type de document. C'est une technologie réelle et fonctionnelle en 2026, disponible via des outils de différentes gammes de prix. | « Sans modèle » ne signifie pas « zéro configuration ». Vous devez toujours indiquer à l'outil quels champs extraire. L'innovation réside dans le fait que vous décrivez les champs sémantiquement (« Date d'échéance ») plutôt que spatialement (« case à x:342, y:891 ») — pas dans le fait que l'outil devine quelles données vous souhaitez. |
| « IA agentique » | Le raisonnement multi-étapes, l'auto-validation et l'extraction adaptative fonctionnent dans des déploiements contrôlés — en particulier pour le traitement des factures où les règles de validation sont bien définies. | Seulement 11 % des organisations ont déployé des agents en production selon les données de Deloitte. La plupart des fonctionnalités « agentiques » en 2026 sont de l'extraction en une seule étape avec une vérification de validation — utile, mais pas la couche de traitement documentaire autonome que le marketing laisse entendre. |
| « Aucune formation requise » | Les outils basés sur les LLM fonctionnent immédiatement sur les types de documents courants sans données d'entraînement étiquetées — une amélioration réelle par rapport à la génération d'outils ML de 2018-2024. | Les cas limites — structures de tableaux inhabituelles, documents mixtes multilingues, pages fortement tamponnées ou faxées — bénéficient toujours d'une configuration, et les déploiements en entreprise investissent encore un temps considérable dans l'optimisation pour leur mix documentaire spécifique. |
Le signal le plus honnête que vous puissiez obtenir d'un fournisseur ne se trouve pas sur sa page d'accueil. Il se trouve sur sa page de tarification : si les chiffres sont visibles sans parler aux ventes, l'outil a été conçu pour les acheteurs en libre-service. Si chaque formule indique « Contacter les ventes », l'outil a été conçu pour les cycles d'achat en entreprise — et tout ce qui concerne le calendrier de mise en œuvre, le modèle de support et la complexité contractuelle le reflètera.
Comment utiliser ce panorama pour affiner votre recherche
Vous avez vu les cinq catégories. Vous avez vu les tendances qui les transforment. Maintenant : par quelle catégorie devriez-vous commencer ? Trois questions suffisent pour trancher, plus vite que n'importe quel tableau comparatif de fonctionnalités.
Combien de documents par mois ?
Moins de 500 : les outils économiques/sans code géreront votre volume sans difficulté. 500 à 5 000 : les outils de milieu de gamme offrent une meilleure précision à grande échelle et incluent souvent des fonctions de workflow de base. Plus de 5 000 : IDP d'entreprise ou API d'abord — l'économie par document des outils économiques commence à se dégrader, et la profondeur d'intégration des plateformes d'entreprise commence à porter ses fruits.
Qui va l'utiliser ?
Pas de développeurs dans l'équipe : restez dans le niveau sans code ou milieu de gamme — ces outils sont conçus pour une utilisation via navigateur par des utilisateurs non techniques. Un ou deux développeurs disponibles : l'approche API d'abord devient viable, et vous pouvez envisager de construire un pipeline autour de Google Document AI ou Textract. Équipe d'ingénierie complète : open source ou API d'abord, en sachant que « gratuit » signifie des heures d'ingénierie.
Que deviennent les données après l'extraction ?
Elles vont dans un tableur que vous vérifiez manuellement : le niveau économique suffit. Elles doivent être envoyées automatiquement dans un ERP et déclencher des workflows en aval : vous aurez besoin d'un outil de milieu de gamme ou d'entreprise avec des connecteurs d'intégration. Elles alimentent votre propre produit SaaS : l'approche API d'abord est la seule architecture qui a du sens — vous intégrez l'extraction, vous ne l'utilisez pas directement.
Remarquez ce qui est absent de ces trois questions : le nombre de fonctionnalités, les pourcentages de précision et les vidéos de démonstration des fournisseurs. Ces éléments comptent au sein de la catégorie que vous avez choisie. Mais si vous n'avez pas d'abord répondu à la question de la catégorie, vous comparez des outils qui n'ont jamais été conçus pour se faire concurrence.
Une fois votre catégorie identifiée, l'étape suivante consiste à évaluer des outils spécifiques. Le cadre de notre guide d'évaluation en 6 dimensions explique quoi tester, comment le tester et comment savoir quand vous en avez assez testé — sans vous inscrire à un pilote de 3 mois.
Si vous en êtes encore au tout début — sans savoir ce qu'est un logiciel d'extraction de données — commencez par notre guide du débutant avant de vous lancer dans le choix d'une catégorie.
Questions fréquemment posées
Comment savoir si je suis dans la mauvaise catégorie ?
Le signe le plus fiable : vous payez pour des fonctionnalités que vous n'utilisez pas, ou vous développez des fonctionnalités que l'outil aurait dû inclure. Si vous êtes sur un plan entreprise et que vous n'avez jamais touché au module d'automatisation des flux de travail, vous êtes surclassé. Si vous êtes sur un plan économique et que vous avez créé un script Python qui interroge l'API de l'outil toutes les heures pour alimenter votre ERP, vous avez dépassé la catégorie. L'adéquation à la catégorie repose sur le rapport entre les fonctionnalités utilisées et les fonctionnalités payées — et sur le fait de savoir si les fonctionnalités manquantes vous coûtent plus en solutions de contournement que le niveau supérieur ne coûterait en frais d'abonnement.
Existe-t-il un outil qui fonctionne dans toutes les catégories ?
Aucun outil unique ne couvre bien les cinq catégories. Certains outils proposent plusieurs niveaux qui comblent deux catégories adjacentes — Nanonets, par exemple, propose à la fois un plan en libre-service pour le marché intermédiaire et un niveau entreprise avec automatisation des flux de travail. Mais le même outil sous-jacent ne peut pas être simultanément optimisé pour un comptable indépendant qui télécharge 100 reçus par mois et un service achats qui traite 50 000 bons de commande. L'architecture, le modèle de support et la structure tarifaire qui servent un cas d'usage nuisent activement à l'autre.
Et si mon volume fluctue d'un mois à l'autre ?
Plusieurs outils des niveaux économique et intermédiaire proposent une tarification à l'utilisation ou par crédits qui gère mieux les fluctuations que les allocations mensuelles fixes de pages. ImageToTable.ai, Airparser et Parseur fonctionnent sur des modèles basés sur l'utilisation où vous payez pour ce que vous traitez plutôt que de réserver une capacité. Si votre volume est constamment imprévisible, évitez les outils avec des plafonds de pages stricts — les frais de dépassement s'accumulent rapidement et le contrat annuel que vous avez signé pour obtenir une remise devient une contrainte.
Ces outils gèrent-ils les documents manuscrits ?
Les plateformes d'entreprise — en particulier Hyperscience et ABBYY — disposent des capacités de reconnaissance d'écriture manuscrite les plus robustes, développées au fil des années de traitement de formulaires de réclamation manuscrits, de dossiers médicaux et de documents gouvernementaux. Parmi les outils économiques et de milieu de gamme, la prise en charge de l'écriture manuscrite varie considérablement. Les outils utilisant des modèles de vision-langage (dont ImageToTable.ai) peuvent lire une écriture manuscrite claire dans son contexte — par exemple, un total manuscrit à côté d'une étiquette imprimée — mais les paragraphes denses de cursive restent difficiles dans toutes les catégories. Si votre lot de documents est principalement manuscrit, testez la précision de la reconnaissance sur vos propres documents avant de vous engager envers un outil ; ne vous fiez pas aux affirmations d'un fournisseur sans vérifier sur vos propres échantillons.
Quel est le moyen le plus rapide de tester une catégorie avant de s'engager ?
Les outils économiques et de milieu de gamme de la catégorie sans code proposent généralement une démo ou un essai gratuit qui vous permet de téléverser vos propres documents et de voir les résultats immédiatement — sans appel commercial, sans contrat. C'est le plus grand avantage des paliers en libre-service : vous pouvez valider si l'outil fonctionne sur vos documents en moins de 5 minutes. Les outils d'entreprise exigent une conversation commerciale pour accéder à un essai, et l'essai lui-même implique souvent une session de configuration guidée. Si vous n'êtes pas sûr de la catégorie dont vous avez besoin, commencez par le bas — testez d'abord un outil économique. S'il fait le travail, vous avez économisé des milliers. Sinon, les lacunes que vous découvrirez vous indiqueront exactement les fonctionnalités dont vous avez besoin au palier supérieur.
La carte n'est pas le territoire
Le paysage décrit ici est exact à la mi-2026, mais les frontières évoluent. La technologie qui différenciait les plateformes d'entreprise il y a trois ans — extraction sans modèle, reconnaissance d'écriture manuscrite, prise en charge multilingue — est désormais disponible dans des outils à un dixième du prix. La technologie qui les différenciera dans trois ans — des flux de travail agentiques qui réduisent réellement la relecture humaine, un raisonnement multimodal qui traite tout document sans configuration — est en cours de développement dans toutes les catégories.
Ce qui ne change pas, c'est la logique de correspondance. Le meilleur outil pour une entreprise de 3 personnes traitant 200 factures par mois ne sera jamais le même que le meilleur outil pour une entreprise de 500 personnes en traitant 50 000. Les catégories existent parce que différentes organisations ont des besoins structurellement différents, et aucun progrès de l'IA ne change cela. Commencez par votre équipe, votre volume et votre flux de travail en aval. L'outil s'ensuit.
Testez sur vos propres documents, dans votre propre catégorie, selon vos propres seuils. Un test de 5 minutes avec une facture réelle de votre fournisseur le moins coopératif vous en apprendra plus que toutes les matrices de fonctionnalités de cette page.