Document Extraction Software Landscape 2026
A Map, Not a Ranking
두 도구 모두 PDF에서 인보이스 데이터를 추출할 수 있습니다. 하나는 월 19달러입니다. 다른 하나는 월 1,500달러부터 시작하는 영업팀과의 상담이 필요합니다. 두 도구 모두 내부적으로 동일한 등급의 AI를 사용합니다. 75배의 가격 차이는 추출 품질 때문이 아닙니다 — 완전히 다른 조직, 다른 팀 구조, 다른 볼륨 프로필, 그리고 구현 복잡성에 대한 다른 허용 수준을 위해 만들어졌기 때문입니다. 가격대별 기능을 비교하면서 어떤 카테고리의 도구가 자신의 상황에 맞게 만들어졌는지 먼저 이해하지 않고 공급업체 검색을 시작한다면, 평가하는 것이 아니라 추측하는 것입니다. 이 글은 그 지도를 그려드립니다.
핵심 요점
- 100개 이상의 문서 추출 공급업체가 모두 99% 정확도를 주장합니다 — 그리고 월 19달러의 ImageToTable.ai와 같은 도구는 월 1,500달러부터 시작하는 도구와 동일한 등급의 AI를 내부적으로 사용합니다.
- 가격대별 기능을 비교하는 것은 구매자가 저지르는 가장 비용이 많이 드는 실수입니다 — 19달러의 노코드 도구와 1,500달러의 엔터프라이즈 플랫폼은 결코 대안이 될 수 없으며, 서로 다른 팀 구조를 가진 서로 다른 조직을 위해 만들어졌습니다.
- 세 가지 질문이 어떤 공급업체 데모보다 더 빠르게 올바른 카테고리를 찾게 해줍니다: 월 문서 수, 도구를 운영하는 사람, 추출 후 데이터의 처리 방식입니다.
카테고리가 기능보다 중요한 이유
지능형 문서 처리 시장은 2026년 약 32억 달러에 달하며, 어느 분석 기관에 물어보느냐에 따라 연평균 성장률(CAGR) 18~30%로 성장할 것으로 전망됩니다 — Mordor Intelligence는 31억 7천만 달러로 평가하는 반면, Fortune Business Insights는 인접 문서 관리 서비스를 포함한 더 넓은 범위에서 141억 6천만 달러로 보고합니다. (이 수치들의 차이 자체가 하나의 신호입니다: 분석 기관마다 집계하는 대상이 다르며, '문서 추출'이라는 카테고리의 경계는 모호합니다.)
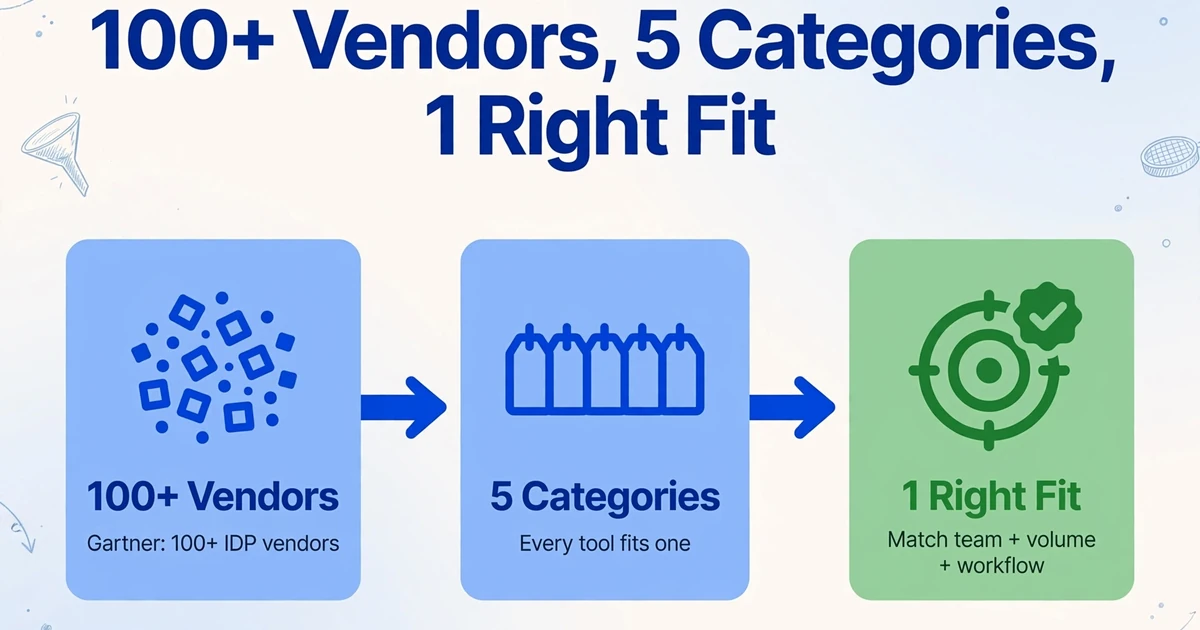
정확한 시장 규모보다 더 중요한 것은 시장의 파편화입니다. Gartner의 가장 최근 Intelligent Document Processing Magic Quadrant는 클라우드 하이퍼스케일러부터 틈새 스타트업까지 100개 이상의 벤더를 기록하고 있습니다. 검색 탭을 막 연 구매자에게 그 숫자는 압도적입니다.
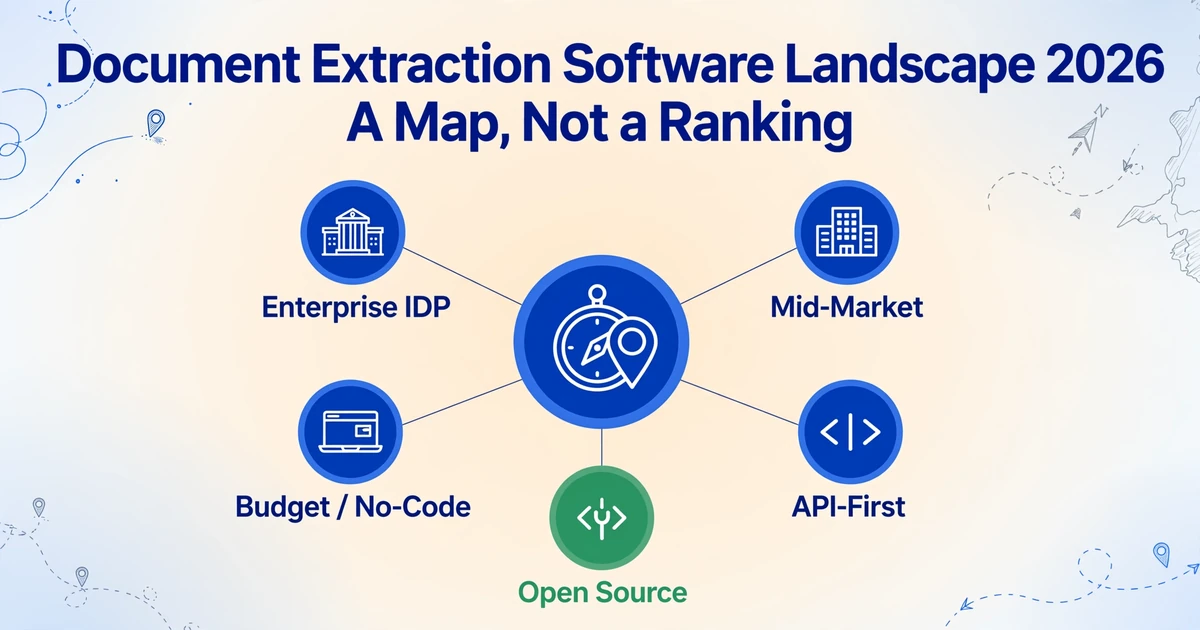
하지만 파편화는 무작위적이지 않습니다. 시장의 모든 도구는 대략 다섯 가지 카테고리 중 하나에 속하며, 각 카테고리는 동일한 세 가지 질문에 대한 서로 다른 답변을 중심으로 구축되었습니다: 조직의 규모는 얼마나 됩니까? 월간 처리 문서량은 얼마입니까? 도구를 운영할 사람은 누구입니까 — 엔지니어, 회계사, 아니면 둘 다입니까?
카테고리는 품질 등급이 아닙니다. 월 19달러짜리 예산 도구는 월 1,500달러짜리 엔터프라이즈 플랫폼의 '더 나쁜' 버전이 아니라, 다른 사용 사례에 최적화된 다른 아키텍처입니다. 구매자에게 가장 큰 비용을 초래하는 실수는 카테고리 내에서 잘못된 도구를 선택하는 것이 아닙니다. 완전히 잘못된 카테고리를 선택한 다음, 도구를 맞추기 위해 수개월을 소비하는 것입니다.
도구를 비교하기 전에
팀 규모, 월간 문서량, 기술 역량에 맞게 설계된 카테고리가 무엇인지 파악하세요. 카테고리 불일치는 문서 추출 소프트웨어 선택에서 가장 비용이 많이 드는 실수이며 — 기능 비교표에서는 보이지 않습니다.
다섯 가지 카테고리 한눈에 보기
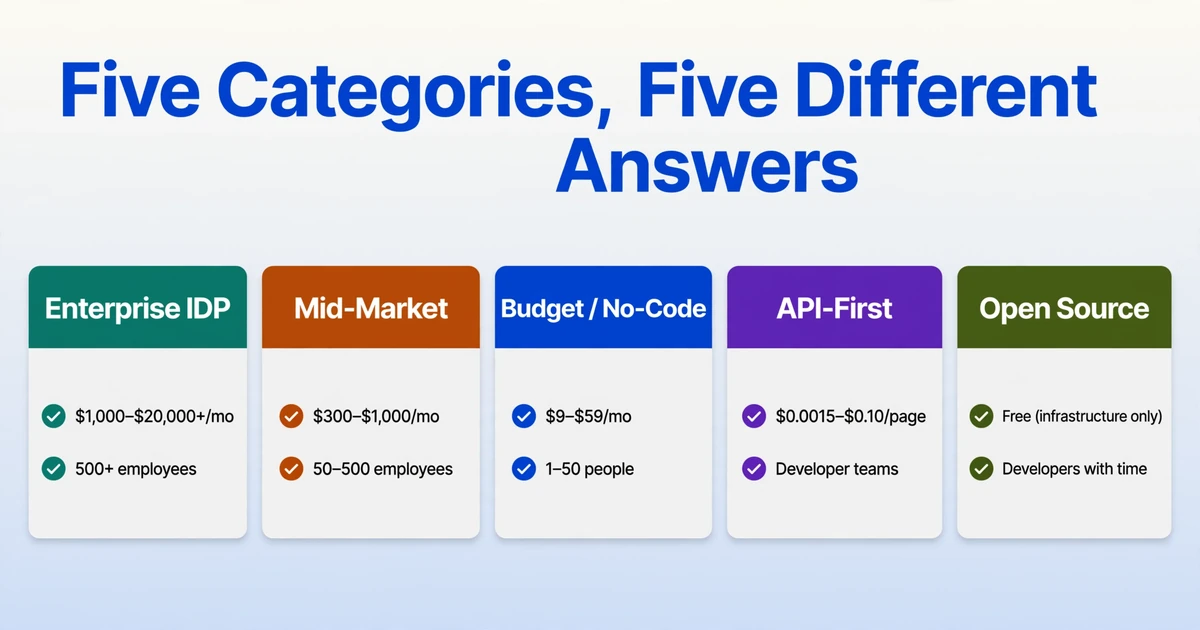
다음 표에서 전체 구도를 한눈에 확인할 수 있습니다. 각 카테고리는 "누구를 위한 것인가, 비용은 얼마인가, 무엇을 맞바꾸는가"에 대한 서로 다른 답변입니다. 이 글의 나머지 부분에서 각각을 자세히 설명합니다.
| 카테고리 | 대상 | 일반적인 가격대 | 핵심 트레이드오프 | 예시 |
|---|---|---|---|---|
| 엔터프라이즈 IDP | 500인 이상 조직, 전담 IT, 규정 준수 요건 | 월 $1,000–$20,000+ | 최대 성능, 최대 구현 부담 | ABBYY Vantage, Hyperscience, Rossum, UiPath IXP |
| 중견기업 특화 | 50–500인, 재무/운영팀, 중간 규모 볼륨 | 월 $300–$1,000 | 합리적 비용으로 우수한 정확도, 다만 워크플로우 커버리지는 부족 | Nanonets, Docsumo, Affinda, Docparser |
| 예산 / 노코드 | 1–50인, IT 지원 없음, 빠른 구축 필요 | 월 $9–$59 | 가장 빠른 시작, 가장 낮은 비용, 추출 전용 워크플로우로 제한 | ImageToTable.ai, Airparser, Parseur, Parsio |
| API 우선 / 클라우드 네이티브 | 자체 제품에 추출 기능을 통합하는 개발자 팀 | 페이지당 $0.0015–$0.10 | 전체 파이프라인 제어, 엔지니어링 투자 필요 | Google Document AI, Amazon Textract, Azure Document Intelligence |
| 오픈소스 | 시간이 있는 개발자, 전체 데이터 제어가 필요한 팀 | 무료(인프라 비용만) | 라이선스 비용 없음, 최대 엔지니어링 부담 | Tesseract, PaddleOCR, docTR |
엔터프라이즈 IDP 플랫폼: 규모가 요구될 때 필요한 완전한 제품군
엔터프라이즈 IDP 플랫폼은 대부분의 구매자가 가장 먼저 접하는 카테고리입니다. 마케팅 예산이 가장 크고 영업 역사가 가장 길기 때문입니다. 이 등급의 도구(ABBYY Vantage, Hyperscience, UiPath의 Intelligent Document Processing, Rossum의 엔터프라이즈 오퍼링)는 여러 부서에서 월 수만 건의 문서를 처리하고, 전담 IT 인력, 공식 조달 프로세스, 감사 추적을 요구하는 규정 준수 요건을 갖춘 조직을 위해 구축되었습니다.
구매하는 것: 종합 문서 처리 플랫폼입니다. 추출은 하나의 모듈일 뿐입니다. 플랫폼에는 문서 분류(방금 도착한 문서 유형 자동 식별), 검증 규칙, 신뢰도 기반 라우팅(신뢰도 높은 결과는 자동 통과, 낮은 결과는 인간 검토 큐로 이동), ERP/CRM 통합 커넥터, 역할 기반 접근 제어도 포함됩니다. ABBYY나 Rossum이 엔터프라이즈에 판매할 때 추출을 파는 것이 아니라 문서 운영 레이어를 파는 것입니다.
실제 비용: Rossum의 스타터 플랜은 연간 약 $18,000부터 시작합니다. Nanonets의 엔터프라이즈 등급은 월 $999부터 시작하며 볼륨에 따라 확장됩니다. ABBYY는 가격을 공개하지 않습니다. 그러나 라이선스 비용은 일반적으로 두 비용 중 더 작은 부분입니다. 구현(문서 유형 구성, 모델 학습, 기존 시스템 통합, 직원 교육)은 일반적으로 3~12개월이 소요되며 첫 해 라이선스 비용보다 더 많이 듭니다. IDP 도입에 관한 Forrester 보고서는 구현 복잡성을 과소평가하는 구매자가 "파일럿 단계의 정확도가 유망해 보이지만 수개월의 튜닝 없이는 생산 단계로 전환되지 않는 경우가 많다"고 지적합니다.
트레이드오프: 가장 포괄적인 문서 자동화 스택을 얻을 수 있습니다. 동시에 가장 무거운 구현 부담도 얻습니다. 조직이 실제로 여러 문서 유형에 걸쳐 월 10,000건 이상의 문서를 처리하고 배포를 관리할 IT 팀이 있다면, 무거운 부담은 자동화 밀도로 보상받습니다. 단일 플랫폼이 메일룸 수집부터 ERP 전기까지 모든 것을 처리합니다. 월 300장의 인보이스를 처리하고 IT 부서가 없다면, 사용하지 않을 인프라 복잡성과 인내심보다 오래 지속될 배포 일정에 비용을 지불하는 것입니다.
엔터프라이즈 플랫폼은 또한 필기와 복잡한 테이블 구조에서 가장 강한 경향이 있습니다. 특히 Hyperscience는 정부 기관과 의료 보험사의 필기 문서 처리를 위한 평판을 구축했습니다. 문서 구성에 필기 양식의 비중이 크다면, 엔터프라이즈 등급이 이를 깔끔하게 처리할 수 있는 정확도를 가진 유일한 카테고리일 수 있습니다.
중견기업 특화 도구: 불필요한 기능 없이 핵심에 집중
중견기업용 도구는 월 $300~$1,000 범위에 있으며, 대기업용 플랫폼이 소규모 조직에 만들어내는 문제(너무 많은 기능, 너무 높은 비용, 너무 긴 구현 기간)를 해결합니다. Nanonets, Docsumo, Affinda, Docparser가 이 분야에서 가장 잘 알려진 이름입니다. 이들은 올인원 플랫폼을 지향하지 않습니다. 추출을 잘 수행하는 데 집중하고, 이후 워크플로우는 기존 도구에서 처리하도록 합니다.
엔터프라이즈와의 차이점: 템플릿 없이 다양한 레이아웃을 처리하는 AI 기반 추출 기능을 제공합니다. 이는 엔터프라이즈 등급과 동일한 기본 기술입니다. 그러나 전체 워크플로우 자동화 스택은 제공되지 않습니다. 승인 라우팅, ERP 커넥터 라이브러리, 규정 준수 감사를 위한 역할 기반 액세스 제어가 내장되어 있지 않습니다. 이러한 도구는 이미 해당 기능을 위한 시스템이 있고 데이터를 공급하기 위한 추출 기능만 필요하다고 가정합니다.
최적의 활용처: 월 2,000~5,000개 문서를 처리하는 중견 회계 법인입니다. 수동 입력이 실질적으로 비용이 많이 들 만큼의 충분한 문서량이지만, 6개월이 걸리는 엔터프라이즈 구축을 정당화할 만큼은 아닙니다. Docparser의 영역 기반 OCR 접근 방식은 일관된 문서 레이아웃(매월 동일한 공급업체, 동일한 양식)을 가진 조직에 적합합니다. Nanonets와 Docsumo는 변형을 더 잘 처리하는 딥러닝 모델을 사용합니다. 이는 50개 이상의 거래처에서 형식이 제각각인 문서가 유입될 때 유용합니다.
절충점: 반복적인 고용량 문서 유형에 대해 저가 도구보다 정확도가 높고, 엔터프라이즈 가격의 일부에 불과합니다. 그러나 맞춤 설정에는 한계가 있습니다. 추출된 데이터를 결과가 수락되기 전에 ERP와 교차 참조하는 사용자 지정 유효성 검사 규칙을 추가하려면? 이는 엔터프라이즈 영역입니다. 중견기업 등급은 추출을 철저히 처리하지만, "추출 후 작업"은 사용자의 몫으로 남깁니다.
이 등급의 많은 구매자는 API 우선 또는 노코드 방식을 선택해야 할 수도 있습니다. 일부 중견기업용 도구는 두 가지 경로를 모두 제공하며, 통합을 구축할 개발자가 있는지 아니면 브라우저 인터페이스를 통해 모든 것을 처리해야 하는지에 따라 선택이 달라집니다.
예산/노코드 도구: 셀프 서비스 계층
지난 2년 동안 이 분야에서 가장 빠르게 변화가 일어난 곳입니다. ImageToTable.ai, Airparser, Parseur, Parsio와 같은 도구는 월 $9–$59 범위에서 운영됩니다. 이 도구들은 특정 구매자를 위해 설계되었습니다: 오늘 문서에서 데이터를 추출해야 하고, 조달 주기를 기다릴 수 없으며, 통합을 구축할 개발자가 없는 사람입니다. 전체 워크플로우는 브라우저에서 실행됩니다.
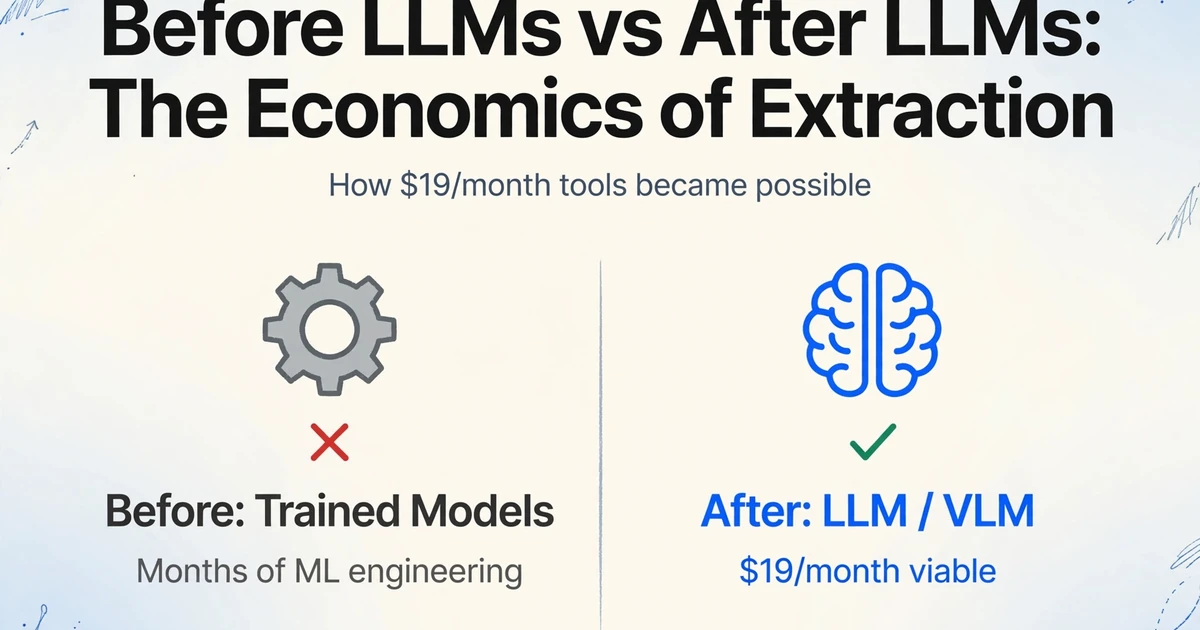
이 범주를 가능하게 만든 기술적 변화: 2년 전만 해도 월 $19짜리 추출 도구는 존재할 수 없었습니다. 적절한 정확도를 얻는 유일한 방법은 훈련된 모델을 사용하는 것이었고, 모델 훈련에는 (a) 수개월의 머신러닝 엔지니어링 또는 (b) 이미 그 작업을 수행한 엔터프라이즈 공급업체에 비용을 지불하는 방법뿐이었기 때문입니다. 대규모 언어 모델과 비전-언어 모델의 등장으로 경제성이 바뀌었습니다. 문서 유형별로 모델을 훈련하는 대신, 이러한 도구는 문서를 LLM 또는 VLM에 보내 사람이 읽는 방식처럼 문서를 읽게 합니다. 필드가 페이지에서 어디에 있는지가 아니라 필드가 의미하는 바를 이해하는 방식입니다. 이 접근 방식의 문서당 비용은 월 수백 페이지를 처리할 수 있는 월 $19 요금제를 실현할 수 있을 만큼 충분히 낮아졌습니다.
실제 작동 방식: PDF, JPG 또는 스크린샷을 업로드합니다. 원하는 필드 이름을 입력합니다 — "Invoice Number, Vendor Name, Total, Due Date." AI는 좌표가 아닌 의미를 이해하여 페이지 어디에서든 각 값을 찾습니다. ImageToTable.ai에서는 이를 맞춤 열 추출이라고 합니다: 입력한 열 이름이 출력 스프레드시트의 헤더가 됩니다. 한 번에 50개의 인보이스를 처리해야 하나요? 배치로 업로드하면 병합된 Excel 파일 하나를 얻을 수 있습니다 — 모든 인보이스가 지정한 열을 가진 하나의 행이 됩니다. 추출 중에 계산을 수행하는 계산 열을 정의할 수도 있습니다 — "Line Total (Qty × Unit Price)"와 같이 — 다운로드하는 스프레드시트에 원시 데이터가 아닌 답변이 포함되도록 할 수 있습니다.
이 계층의 대부분 도구는 수집 링크 기능도 제공합니다: 공유 가능한 URL을 생성하여 고객이나 팀원에게 보내면, 그들이 업로드한 문서가 등록 없이 바로 처리 대기열에 들어옵니다.
절충점: 이 범주는 시장에서 가장 빠른 첫 결과 도달 시간을 제공합니다 — 페이지 도착부터 스프레드시트 다운로드까지 종종 2분 미만입니다. 절충점은 추출 기능은 제공하지만 워크플로우 플랫폼은 아니라는 점입니다. 자동 ERP 전기, 승인 라우팅, 세분화된 역할 기반 권한이 있는 인간 검토 대기열이 필요하다면 상위 범주의 도구가 필요합니다. 예산 도구는 추출 단계를 매우 잘 처리합니다. 그러나 그 전후의 작업을 자동화하지는 않습니다.
예산 도구가 승리하는 경우
3인 회계 법인이 매월 200건의 고객 청구서를 처리한다고 가정해 보겠습니다. 엔터프라이즈 IDP(Intelligent Document Processing) 플랫폼의 비용은 해당 고객으로부터 발생하는 월 수익의 12배에 달합니다. 월 $19짜리 예산 도구는 동일한 AI 클래스를 사용하여 동일한 청구서에서 동일한 필드를 추출하며, 회계사는 업로드 후 45초 만에 Excel에서 작업을 시작합니다. 부족한 부분은 추출 품질이 아니라, 애초에 필요하지 않았던 워크플로 자동화입니다.
API 우선 / 클라우드 네이티브: 나만의 파이프라인 구축
Google Document AI, Amazon Textract, Azure Document Intelligence는 완전히 다른 범주에 속합니다. 이들은 도구가 아니라 인프라 구성 요소입니다. 대시보드에 로그인하여 파일을 업로드하는 방식이 아닙니다. 문서를 REST 엔드포인트로 보내고 구조화된 JSON을 돌려받는 코드를 작성하는 방식입니다. 가격은 페이지당 기준이며(프로세서에 따라 $0.0015~$0.10), 엔지니어링 팀이 추출 단계를 중심으로 전체 파이프라인을 구축할 것이라는 전제가 깔려 있습니다.
대상: 자사 제품에 문서 추출을 내장하는 SaaS 기업. 기존 클라우드 인프라를 보유한 엔터프라이즈 개발 팀으로, 자동화 체인의 한 축으로 추출이 필요한 경우. 페이지당 가격이 좌석당 SaaS 비용보다 저렴한 대용량 문서 처리 조직 — 월 50,000페이지를 처리한다면 Textract의 페이지당 $0.015(총 $750)는 월 $1,500짜리 엔터프라이즈 플랫폼보다 훨씬 저렴할 수 있습니다. 단, 주변 인프라를 구축할 엔지니어링 팀이 있다는 전제하에 말입니다.
클라우드 제공업체의 강점: Google Document AI의 사전 학습된 인보이스, 영수증, 신분증 프로세서는 실제로 품질이 우수합니다. Amazon Textract의 테이블 추출은 많은 타사 도구를 무너뜨리는 복잡한 레이아웃을 처리합니다. Azure의 Document Intelligence는 많은 기업이 이미 사용 중인 Microsoft 365 및 Power Platform 생태계와 자연스럽게 통합됩니다.
한계: 이들은 추출 API이지 문서 처리 솔루션이 아닙니다. 분류, 검증, 예외 처리, 인간 검토 — 모든 것을 직접 구축해야 합니다. Google, Amazon, Microsoft는 엔진을 제공하고, 여러분은 차체를 제공해야 합니다. Reddit에서 문서 추출 플랫폼 구축 경험을 공유한 개발자는 이렇게 단언했습니다. "문서 추출은 완벽한 모델 하나를 찾는 것이 아니라 수천 가지 문서 변형을 처리할 수 있는 시스템을 구축하는 문제입니다." API는 시스템이 아닌 첫 단계인 추출만 제공합니다.
구축할지 구매할지 평가하는 팀을 위해 전체 비용 분석 — 개발자 시간, 인프라, 유지보수, API 가격 — 은 구축 vs 구매 분석에서 자세히 다룹니다. 요약하자면, 문서 추출이 제품 자체일 때 구축이 합리적이며, 단순한 부대비용일 때는 그렇지 않습니다.
오픈소스: 강아지처럼 무료
Tesseract — 1980년대 HP에서 처음 개발되어 현재 Google이 유지 관리 — 는 여전히 전 세계에서 가장 널리 배포된 OCR 엔진입니다. Baidu의 PaddleOCR은 2023년 이후 강력한 다국어 지원(100개 이상 언어)과 표 인식 기능으로 큰 주목을 받고 있습니다. PyTorch와 TensorFlow 기반의 docTR은 종단 간 훈련 가능한 감지 및 인식 기능을 갖춘 더 현대적인 아키텍처를 제공합니다.
이러한 도구는 무료입니다. 라이선스 비용은 들지 않습니다. 그러나 오픈소스 OCR은 문서 추출이 아니라 문자 인식입니다. Tesseract는 페이지의 텍스트를 알려줄 수 있습니다. 그러나 어떤 문자열이 송장 번호이고 어떤 것이 PO 참조인지는 알려줄 수 없습니다. 해당 분류, 추출 및 구조화 로직은 직접 구축해야 하며, 실제 비용이 발생하는 부분이 바로 여기입니다.
오픈소스가 효과적인 경우: 컴퓨터 비전을 아는 개발자가 있고, 엄격하게 고정된 레이아웃(매번 동일한 양식, 동일한 좌표)의 문서를 처리하며, 처리량이 구축 비용을 정당화하는 경우입니다. 특히 PaddleOCR은 강력한 표 인식 파이프라인을 갖추고 있어, 맞춤 후처리와 결합하면 구조화된 표 문서에서 상용 도구에 필적할 수 있습니다 — Reddit의 OCR 커뮤니티에서 최신 모델과 벤치마킹한 개발자들이 프로덕션 사용에 가장 안정적인 오픈소스 옵션이라고 언급한 바 있습니다.
효과적이지 않은 경우: 거래처별로 문서 레이아웃이 다양한 경우, 텍스트 출력이 아닌 필드 수준 추출이 필요한 경우, 컴퓨터 비전 엔지니어가 없는 경우입니다. 이러한 조건에서 "무료" 도구는 저렴한 SaaS 구독료가 1년 동안 드는 비용보다 더 많은 엔지니어링 시간을 소모합니다.
2025–2026년의 변화: 시장을 재편하는 세 가지 트렌드
벤더 환경은 가만히 있지 않습니다. 세 가지 구조적 변화가 위에서 설명한 카테고리 경계를 적극적으로 다시 그리고 있습니다.
1. LLM과 VLM이 템플릿 기반 추출을 대체하고 있습니다 — 이번에는 실제로
20년 동안 문서 추출의 지배적인 접근 방식은 템플릿 매칭이었습니다. 송장 번호 필드 주위에 상자를 그리고 소프트웨어에 "값은 여기에 있습니다"라고 알려준 다음, 다음 송장이 같은 위치에 값을 배치하기를 바라는 방식이었습니다. 머신러닝은 레이블이 지정된 예제에서 패턴을 학습하여 이를 약간 개선했지만, 일관된 레이아웃에 대한 근본적인 의존성은 지속되었습니다. Forrester 부사장 겸 수석 애널리스트인 Boris Evelson은 Document Mining and Analytics Platforms Landscape Q4 2025에서 생성형 및 에이전트형 AI를 규칙 및 템플릿 기반 아키텍처에서 "벤더의 차별화 능력에 도전하는 이퀄라이저"라고 설명합니다.
이러한 변화는 점진적이 아니라 구조적입니다. 비전-언어 모델은 좌표(x: 342, y: 891)에서 필드를 찾지 않습니다. 문서를 전체적으로 읽고 "이 페이지의 총 금액은 얼마인가?"라는 질문에 "총액"이라는 레이블과 그 옆에 있는 숫자 사이의 관계를 이해함으로써 답변합니다 — 둘 중 하나가 어디에 나타나든 상관없이 말이죠. 이것은 인간 독자가 사용하는 것과 동일한 접근 방식이며, 모든 카테고리의 도구가 2025-2026년에 마케팅에 "템플릿 불필요"를 추가하고 있는 이유이기도 합니다.
실질적인 효과: 문서 형식의 80%만 처리할 수 있었던 도구가 이제 95% 이상을 처리할 수 있게 되었습니다. "레이아웃이 변경되었다"는 실패 모드가 더 이상 실패 모드가 아니기 때문입니다.
2. 에이전트형 문서 처리: 추출에서 멈추지 않는 추출
"에이전트형"이라는 용어는 크게 과장되었습니다 — 그리고 우리는 곧 무엇이 실제이고 무엇이 마케팅인지 다룰 것입니다 — 하지만 핵심 아이디어는 진정합니다. 기존 IDP(Intelligent Document Processing)는 이렇게 합니다: 문서를 입력하고 JSON을 출력합니다. 에이전트형 문서 처리는 이렇게 합니다: 문서를 입력하면 AI가 다단계 워크플로우를 계획하고, 데이터를 추출하고, 알려진 규칙에 대해 검증하고, 다른 문서의 데이터와 교차 참조하고, 행동합니다 — ERP(Enterprise Resource Planning)에 게시하거나, 승인을 트리거하거나, 이상 징후를 플래그합니다.
Kognitos는 에이전트형 데이터 추출을 "자율 AI 에이전트가 다단계 워크플로우를 계획하고, 모호한 콘텐츠에 대해 반복적으로 추론하고, 본 적 없는 형식에 적응하고, 자체 출력을 검증하고, 추출한 내용에 대해 점점 더 조치를 취하는" 시스템으로 정의합니다. 핵심 단어는 반복적으로입니다: 모호한 필드를 만난 에이전트형 시스템은 추측하지 않습니다 — 문서를 다시 읽고, 컨텍스트를 확인하고, 여전히 불확실하면 특정 필드에 대한 특정 질문을 가지고 인간에게 에스컬레이션합니다.
IDC의 병행 Worldwide IDP Software Forecast는 시장이 29.6% CAGR(Compound Annual Growth Rate)로 성장할 것으로 전망하며, "주로 문서 자동화에서 에이전트형 및 생성형 AI 기능 채택에 의해 주도된다"고 밝혔습니다. 그 궤적은 실제이지만 현재 상태는 고르지 않습니다: Deloitte의 2025 Emerging Technology Trends 연구에 따르면 조직의 38%가 에이전트형 AI를 파일럿하고 있지만, 단 11%만이 프로덕션에서 에이전트를 적극적으로 운영하고 있습니다.
3. 멀티모달 모델: 문서는 더 이상 텍스트만이 아니다
세 번째 트렌드는 가장 조용하지만 가장 영향력이 클 수 있습니다. 초기 세대의 추출 도구는 문서를 이미지 위에 존재하는 텍스트로 취급했습니다 — 먼저 OCR, 그다음 NLP. 이러한 파이프라인은 시각적 레이아웃이 중요할 때마다 한계에 부딪혔습니다: 체크박스의 체크 표시, 인쇄된 날짜 옆의 손글씨 서명, 보고서에 삽입된 사진 등이 그 예입니다.
비전-언어 모델(VLM)은 OCR→NLP 파이프라인을 단일 단계로 압축합니다. 문서를 추출된 텍스트가 아닌 픽셀이라는 시각적 입력으로 처리하고, 이를 직접 추론합니다. VLM은 주변 텍스트에서 유추하는 대신 박스를 직접 보고 "'승인' 박스에 체크되었는가?"에 답할 수 있습니다. 별도의 손글씨 인식 과정 없이 인쇄된 인보이스 여백의 손글씨 메모를 읽을 수 있습니다.
이것이 업계 지형에 중요한 이유는 카테고리 간의 경계를 흐리고 있기 때문입니다. VLM 백엔드를 사용하는 월 $19 예산형 도구가 이제 3년 전에는 전용 손글씨 모델을 갖춘 엔터프라이즈 플랫폼이 필요했던 문서 유형을 처리할 수 있습니다. 가격 등급을 구분짓던 기술이 하위 시장으로 확산되고 있습니다 — 이는 카테고리 간의 진정한 차별화가 추출 정확도에서 워크플로우, 통합, 지원으로 이동하고 있음을 의미합니다.
과대광고 vs. 현실: 신호와 노이즈 구분하기
2026년의 모든 공급업체 웹사이트는 홈페이지에 "AI 기반", "에이전틱", "템플릿 불필요"를 추가했습니다. 실제로 일어나고 있는 일과 마케팅에 불과한 것을 구분해 보겠습니다.
| 주장 | 실제 사실 | 과장된 부분 |
|---|---|---|
| "99% 정확도" | 깨끗하고 고해상도의 디지털 텍스트에 대한 문자 수준 OCR 정확도는 현대 도구에서 실제로 99% 이상입니다. | 실제 문서(스캔, 기울어짐, 도장, 다국어)에 대한 필드 수준 추출 정확도는 95%를 거의 넘지 않습니다. 대부분의 "99%" 주장은 잘못된 것을 측정한 것입니다. 송장 합계가 정확해야 할 때 문자 정확도는 무의미하며, 필드 정확도가 가장 중요합니다. |
| "템플릿 불필요 추출" | LLM 및 VLM 기반 도구는 문서 유형별 구성 없이 다양한 레이아웃을 처리합니다. 이는 2026년 현재 여러 가격대의 도구에서 사용 가능한 실제 작동 기술입니다. | "템플릿 불필요"가 "설정 불필요"를 의미하지는 않습니다. 추출할 필드를 도구에 알려줘야 합니다. 혁신은 필드를 공간적으로("x:342, y:891의 상자")가 아닌 의미론적으로("마감일") 설명한다는 점이지, 도구가 원하는 데이터를 읽어주는 것은 아닙니다. |
| "에이전트 AI" | 다단계 추론, 자체 검증, 적응형 추출은 특히 검증 규칙이 잘 정의된 송장 처리에서 통제된 배포 환경에서 작동하고 있습니다. | Deloitte 데이터에 따르면 조직의 11%만이 에이전트를 프로덕션에 배포했습니다. 2026년의 대부분의 "에이전트" 기능은 검증 확인이 포함된 단일 단계 추출로, 유용하지만 마케팅이 암시하는 자율적인 문서 운영 계층과는 거리가 있습니다. |
| "학습 불필요" | LLM 기반 도구는 레이블이 지정된 학습 데이터 없이도 일반적인 문서 유형에서 즉시 작동합니다. 이는 2018-2024년 세대의 ML 기반 도구에 비해 실질적인 개선입니다. | 특수한 테이블 구조, 다국어 혼합 문서, 도장/팩스가 많이 찍힌 페이지와 같은 엣지 케이스는 여전히 구성의 이점이 있으며, 기업 배포는 특정 문서 구성에 맞춰 튜닝하는 데 상당한 시간을 투자합니다. |
공급업체에서 얻을 수 있는 가장 정직한 신호는 홈페이지가 아닙니다. 가격 페이지에 있습니다. 숫자가 영업 상담 없이 표시된다면 셀프서비스 구매자를 위해 만들어진 도구입니다. 모든 등급에 "영업팀 문의"가 표시된다면 기업 조달 주기를 위해 만들어진 도구이며, 구현 일정, 지원 모델, 계약 복잡성의 모든 측면이 이를 반영할 것입니다.
이 랜드스케이프를 활용해 검색 범위를 좁히는 방법
다섯 가지 카테고리를 살펴봤습니다. 이를 재편하는 트렌드도 확인했습니다. 이제: 어떤 카테고리에서 시작해야 할까요? 세 가지 질문이 어떤 기능 비교 매트릭스보다 빠르게 범위를 좁혀줍니다.
월 문서 처리량은 얼마나 되나요?
500건 미만: 예산형/노코드 도구로도 무리 없이 처리할 수 있습니다. 500~5,000건: 미드마켓 도구가 대규모 처리에서 더 나은 정확도를 제공하며 기본 워크플로 기능을 포함하는 경우가 많습니다. 5,000건 이상: 엔터프라이즈 IDP 또는 API 우선 방식이 적합합니다. 예산형 도구의 건당 비용 효율이 떨어지기 시작하고, 엔터프라이즈 플랫폼의 통합 깊이가 효과를 발휘하기 시작합니다.
누가 운영하게 되나요?
개발자가 없는 경우: 노코드 또는 미드마켓 티어를 선택하세요. 이 도구들은 비기술 사용자가 브라우저에서 운영하도록 설계되었습니다. 개발자가 1~2명 있는 경우: API 우선 방식이 현실적이며, Google Document AI 또는 Textract를 중심으로 파이프라인을 구축할 수 있습니다. 전체 엔지니어링 팀이 있는 경우: 오픈소스 또는 API 우선 방식을 선택하되, "무료"가 곧 엔지니어링 시간을 의미한다는 점을 이해해야 합니다.
추출 후 데이터는 어떻게 처리되나요?
수동으로 검토하는 스프레드시트에 입력되는 경우: 예산형 티어로 충분합니다. ERP에 자동으로 게시되고 다운스트림 워크플로를 트리거해야 하는 경우: 통합 커넥터가 있는 미드마켓 또는 엔터프라이즈 도구가 필요합니다. 자체 SaaS 제품에 공급되는 경우: API 우선만이 합리적인 아키텍처입니다. 추출 기능을 임베딩하는 것이지, 단순히 사용하는 것이 아니기 때문입니다.
이 세 가지 질문에 없는 것이 무엇인지 주목하세요: 기능 수, 정확도 백분율, 벤더 데모 영상입니다. 이러한 요소들은 선택한 카테고리 내에서 중요합니다. 하지만 먼저 카테고리 질문에 답하지 않았다면, 원래 경쟁할 의도가 없었던 도구들을 비교하고 있는 것입니다.
카테고리를 파악했다면 다음 단계는 특정 도구를 평가하는 것입니다. 6차원 평가 가이드의 프레임워크는 3개월 파일럿에 등록하지 않고도 무엇을 테스트하고, 어떻게 테스트하며, 언제 충분히 테스트했는지 알 수 있는 방법을 안내합니다.
아직 완전히 초기 단계라면 — 데이터 추출 소프트웨어가 무엇인지조차 잘 모르겠다면 — 카테고리 선택에 뛰어들기 전에 초보자 가이드부터 시작하세요.
자주 묻는 질문
내가 잘못된 카테고리에 속해 있는지 어떻게 알 수 있나요?
가장 확실한 신호는 사용하지 않는 기능에 비용을 지불하고 있거나, 도구에 포함되어야 할 기능을 직접 구축하고 있는 경우입니다. 엔터프라이즈 요금제를 사용하면서 워크플로 자동화 모듈을 한 번도 사용해 본 적이 없다면, 카테고리를 초과한 것입니다. 예산 요금제를 사용하면서 매시간 도구의 API를 호출하여 ERP에 데이터를 공급하는 Python 스크립트를 직접 만들었다면, 이미 카테고리를 벗어난 것입니다. 카테고리 적합성은 사용 기능 대비 지불 기능의 비율, 그리고 누락된 기능으로 인해 발생하는 우회 작업 비용이 다음 단계 요금제의 구독료보다 더 큰지 여부에 달려 있습니다.
모든 카테고리에서 작동하는 도구가 있나요?
다섯 가지 카테고리 모두를 잘 지원하는 단일 도구는 없습니다. 일부 도구는 인접한 두 카테고리를 연결하는 여러 요금제를 제공합니다. 예를 들어 Nanonets는 중간 규모 셀프서비스 요금제와 워크플로 자동화가 포함된 엔터프라이즈 요금제를 모두 제공합니다. 그러나 동일한 기본 도구가 월 100건의 영수증을 업로드하는 개인 회계 담당자와 50,000건의 PO를 처리하는 조달 부서를 동시에 최적화할 수는 없습니다. 한 사용 사례에 적합한 아키텍처, 지원 모델, 가격 구조는 다른 사용 사례에는 오히려 방해가 됩니다.
월별 처리량이 변동이 심하면 어떻게 하나요?
예산 및 중간 규모 요금제의 여러 도구는 고정 월 페이지 할당보다 변동에 더 잘 대응하는 종량제 또는 크레딧 기반 가격을 제공합니다. ImageToTable.ai, Airparser, Parseur는 용량을 예약하는 대신 처리한 만큼 비용을 지불하는 사용량 기반 모델로 운영됩니다. 처리량이 지속적으로 예측 불가능하다면 하드 페이지 상한이 있는 도구는 피하세요. 초과 사용 요금이 빠르게 누적되며, 할인을 받기 위해 체결한 연간 계약이 오히려 제약이 됩니다.
이 도구들 중 필기 문서를 처리할 수 있는 도구가 있나요?
엔터프라이즈 플랫폼, 특히 Hyperscience와 ABBYY는 수년간 필기 보험 청구서, 의료 기록, 정부 문서를 처리하며 구축한 가장 강력한 필기 인식 기능을 갖추고 있습니다. 저가 및 중급 도구 중에서는 필기 지원 수준이 크게 다릅니다. 비전-언어 모델(ImageToTable.ai 포함)을 사용하는 도구는 문맥 속에서 또렷한 필기를 읽을 수 있습니다. 예를 들어 인쇄된 라벨 옆에 손으로 쓴 합계 금액 같은 경우입니다. 그러나 필기체로 빽빽하게 작성된 문단은 모든 카테고리에서 여전히 어려운 과제로 남아 있습니다. 문서 구성이 주로 필기 문서라면, 어떤 도구를 선택하기 전에 실제 문서로 필기 인식 정확도를 테스트하세요. 공급업체의 주장을 믿지 말고 직접 샘플로 검증하세요.
카테고리를 확정하기 전에 가장 빠르게 테스트하는 방법은 무엇인가요?
노코드 티어의 저가 및 중급 도구는 일반적으로 무료 데모나 체험판을 제공하여 자체 문서를 업로드하고 즉시 결과를 확인할 수 있습니다. 영업 상담이나 계약이 필요 없습니다. 이것이 셀프서비스 티어의 가장 큰 장점입니다. 5분 안에 도구가 내 문서에서 작동하는지 검증할 수 있습니다. 엔터프라이즈 도구는 체험판에 접근하려면 영업 상담이 필요하며, 체험판 자체에도 종종 안내된 설정 세션이 포함됩니다. 어떤 카테고리가 필요한지 확실하지 않다면, 낮은 단계부터 시작하세요. 먼저 저가 도구를 테스트해 보세요. 작업을 수행한다면 수천 달러를 절약한 것입니다. 그렇지 않다면, 발견한 격차가 다음 단계 도구에서 필요한 기능을 정확히 알려줄 것입니다.
지도는 영토가 아니다
여기에 설명된 환경은 2026년 중반 기준으로 정확하지만, 경계는 계속 이동 중입니다. 3년 전 엔터프라이즈 플랫폼을 차별화했던 기술(템플릿 불필요 추출, 필기 인식, 다국어 지원)은 이제 10분의 1 가격의 도구에서도 사용할 수 있습니다. 3년 후 이들을 차별화할 기술(인간 검토를 실질적으로 줄이는 에이전틱 워크플로, 구성 없이 모든 문서를 처리하는 멀티모달 추론)은 오늘날 모든 카테고리에서 구축되고 있습니다.
변하지 않는 것은 매칭 로직입니다. 월 200장의 인보이스를 처리하는 3인 기업을 위한 최고의 도구는 월 50,000장을 처리하는 500인 기업을 위한 최고의 도구와 결코 같을 수 없습니다. 카테고리가 존재하는 이유는 조직마다 구조적으로 다른 요구 사항이 있고, AI의 발전이 이를 바꾸지 않기 때문입니다. 팀, 볼륨, 다운스트림 워크플로에서 시작하세요. 도구는 그에 따라 결정됩니다.
자체 문서, 자체 카테고리, 자체 기준으로 테스트하세요. 가장 협조적이지 않은 공급업체의 실제 인보이스로 5분 테스트를 하는 것이 이 페이지의 모든 기능 매트릭스보다 더 많은 정보를 제공할 것입니다.