Panorama do Software de Extração de Documentos 2026
Um Mapa, Não um Ranking
Duas ferramentas podem extrair dados de fatura de um PDF. Uma custa $19 por mês. A outra exige uma conversa com uma equipe de vendas que começa em $1.500 por mês. Elas usam a mesma classe de IA internamente. A diferença de preço de 75x não é sobre qualidade de extração — é sobre o fato de que foram criadas para organizações completamente diferentes, com estruturas de equipe diferentes, perfis de volume diferentes e tolerâncias diferentes para complexidade de implementação. Se você está começando sua busca por fornecedores e comparando recursos entre faixas de preço sem antes entender qual categoria de ferramenta foi criada para sua situação, você não está avaliando — está adivinhando. Este artigo traça o mapa.
Principais Conclusões
- Mais de 100 fornecedores de extração de documentos afirmam 99% de precisão — e uma ferramenta como ImageToTable.ai a $19/mês usa a mesma classe de IA internamente que as que começam em $1.500.
- Comparar recursos entre faixas de preço é o erro mais caro que compradores cometem — uma ferramenta sem código de $19 e uma plataforma enterprise de $1.500 nunca foram feitas para serem alternativas; foram criadas para organizações diferentes com estruturas de equipe diferentes.
- Três perguntas vão posicionar você na categoria certa mais rápido do que qualquer demonstração de fornecedor: quantos documentos por mês, quem opera a ferramenta e o que acontece com os dados após a extração.
Por que a Categoria Importa Mais que os Recursos
O mercado de processamento inteligente de documentos atingiu cerca de US$ 3,2 bilhões em 2026, crescendo a uma taxa projetada de 18-30% de CAGR, dependendo de qual empresa de análise você consulta — a Mordor Intelligence estima US$ 3,17 bilhões, enquanto a Fortune Business Insights reporta US$ 14,16 bilhões sob um escopo mais amplo que inclui serviços adjacentes de gerenciamento de documentos. (A diferença entre esses números é por si só um sinal: diferentes analistas contam coisas diferentes, e "extração de documentos" como categoria tem limites imprecisos.)
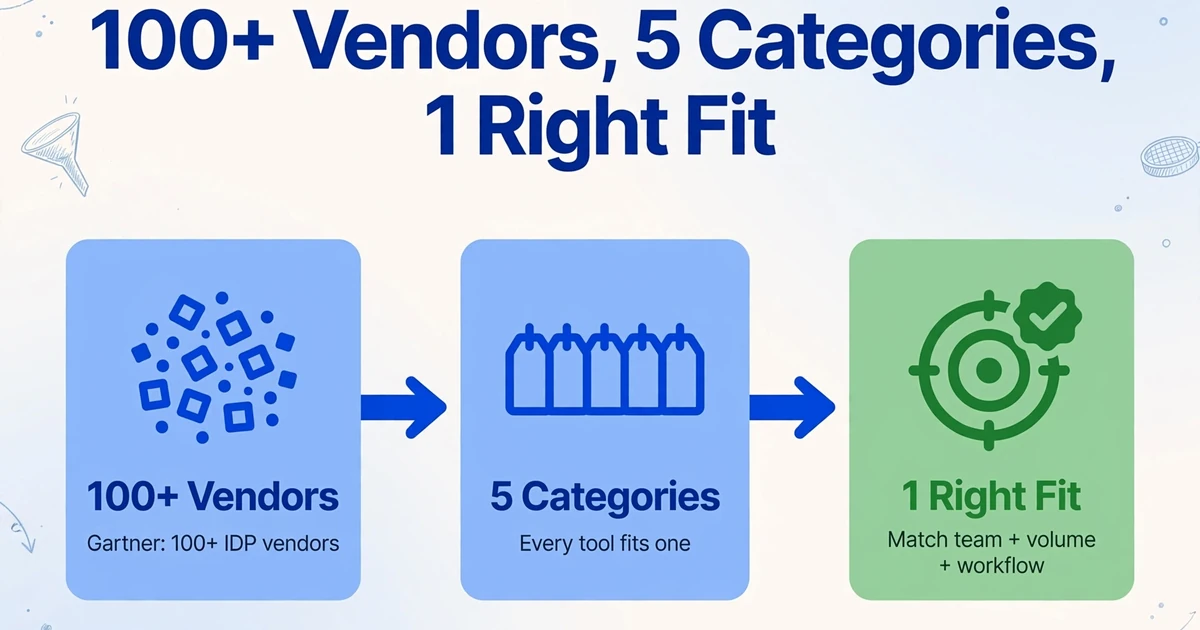
O que importa mais do que o tamanho exato do mercado é a fragmentação. O Magic Quadrant mais recente da Gartner para Processamento Inteligente de Documentos observa mais de 100 fornecedores — de hyperscalers de nuvem a startups de nicho. Para um comprador que acabou de abrir uma aba de busca, esse número é paralisante.
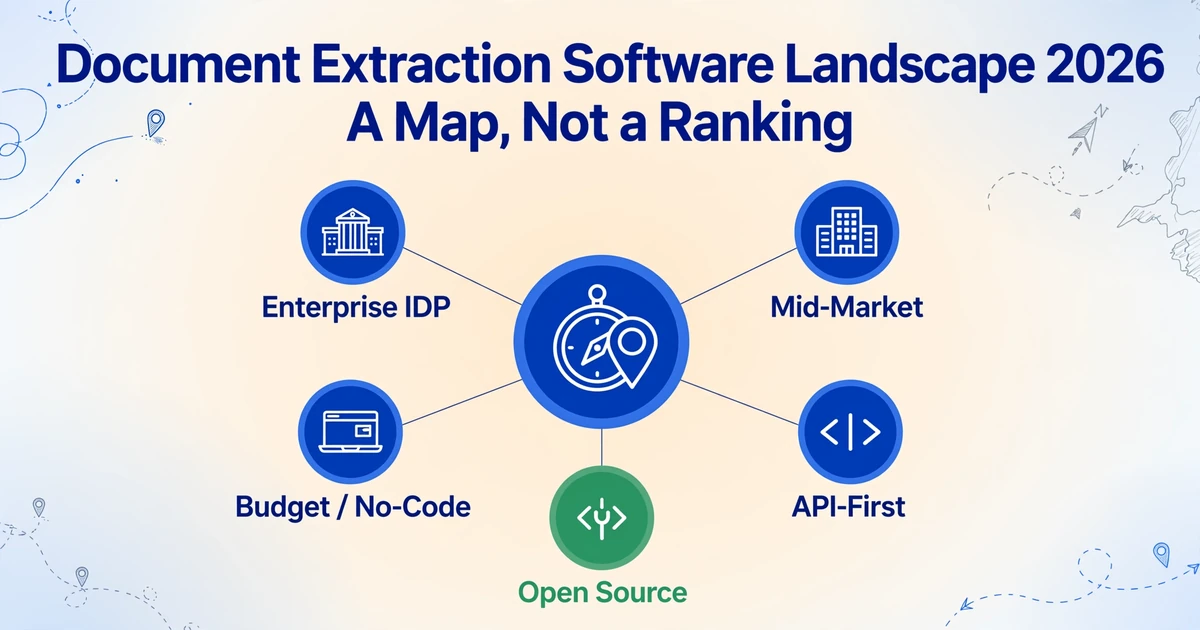
Mas a fragmentação não é aleatória. Cada ferramenta no mercado se enquadra em uma de aproximadamente cinco categorias, cada uma construída em torno de uma resposta diferente para as mesmas três perguntas: Qual é o tamanho da organização? Quantos documentos fluem por mês? Quem vai operar a ferramenta — um engenheiro, um contador ou ambos?
As categorias não são níveis de qualidade. Uma ferramenta de orçamento de US$ 19/mês não é uma versão "pior" de uma plataforma empresarial de US$ 1.500/mês — é uma arquitetura diferente otimizada para um caso de uso diferente. O erro que mais custa aos compradores não é escolher a ferramenta errada dentro de uma categoria. É escolher a categoria errada por completo — e depois passar meses tentando fazer a ferramenta se encaixar.
Antes de comparar ferramentas
Saiba qual categoria foi construída para o tamanho da sua equipe, volume mensal e habilidade técnica. O desajuste de categoria é o erro mais caro na seleção de software de extração de documentos — e é invisível em uma tabela de comparação de recursos.
As Cinco Categorias em Resumo
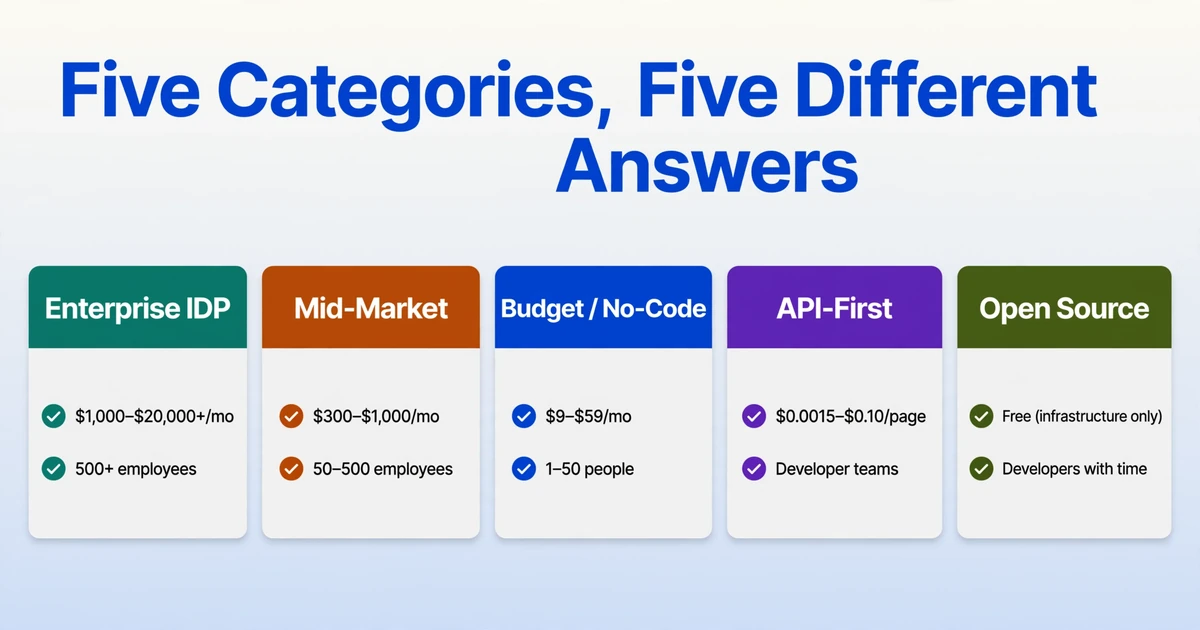
Aqui está o panorama em uma tabela. Cada categoria é uma resposta diferente para "para quem é, quanto custa e o que você está abrindo mão?" O restante deste artigo detalha cada uma.
| Categoria | Para Quem É | Faixa de Preço Típica | Compensação Principal | Exemplos |
|---|---|---|---|---|
| IDP Empresarial | Organizações com 500+ funcionários, TI dedicada, requisitos de conformidade | $1.000–$20.000+/mês | Máximo poder, máximo peso de implementação | ABBYY Vantage, Hyperscience, Rossum, UiPath IXP |
| Especializado de Médio Porte | 50–500 funcionários, equipe de finanças/operações, volume moderado | $300–$1.000/mês | Boa precisão a um custo razoável, mas menos cobertura de fluxo de trabalho | Nanonets, Docsumo, Affinda, Docparser |
| Econômico / Sem Código | 1–50 pessoas, sem suporte de TI, configuração rápida necessária | $9–$59/mês | Início mais rápido, menor custo, limitado a fluxos de trabalho apenas de extração | ImageToTable.ai, Airparser, Parseur, Parsio |
| API-Primeiro / Nativo na Nuvem | Equipes de desenvolvedores que integram extração em seu próprio produto | Por página ($0,0015–$0,10/página) | Controle total do pipeline, exige investimento em engenharia | Google Document AI, Amazon Textract, Azure Document Intelligence |
| Código Aberto | Desenvolvedores com tempo, equipes que precisam de controle total dos dados | Grátis (apenas custo de infraestrutura) | Custo zero de licença, carga máxima de engenharia | Tesseract, PaddleOCR, docTR |
Plataformas Enterprise de IDP: Quando a Escala Exige um Conjunto Completo
As plataformas enterprise de IDP são a categoria que a maioria dos compradores encontra primeiro — porque têm os maiores orçamentos de marketing e os históricos de vendas mais longos. As ferramentas neste nível — ABBYY Vantage, Hyperscience, Intelligent Document Processing da UiPath, a oferta enterprise da Rossum — foram criadas para organizações que processam dezenas de milhares de documentos por mês em vários departamentos, com equipe de TI dedicada, processos formais de aquisição e requisitos de conformidade que exigem trilhas de auditoria.
O que você está comprando: Uma plataforma completa de processamento de documentos. A extração é um módulo. A plataforma também inclui classificação de documentos (identificar automaticamente que tipo de documento acabou de chegar), regras de validação, roteamento baseado em confiança (resultados de alta confiança passam direto, resultados de baixa confiança vão para uma fila de revisão humana), conectores de integração com ERP/CRM e controle de acesso baseado em funções. Quando a ABBYY ou a Rossum vende para uma empresa, não está vendendo extração — está vendendo uma camada de operações de documentos.
O custo real: O plano inicial da Rossum começa em cerca de $18.000 por ano. O nível enterprise da Nanonets começa em $999/mês e escala com o volume. A ABBYY não publica preços. Mas o custo da licença geralmente é o menor dos dois gastos. A implementação — configurar tipos de documentos, treinar modelos, integrar com sistemas existentes, treinar a equipe — normalmente leva de 3 a 12 meses e custa mais do que a licença do primeiro ano. Um relatório da Forrester sobre adoção de IDP observa que compradores que subestimam a complexidade da implementação "muitas vezes veem taxas de precisão na fase piloto que parecem promissoras, mas não se traduzem em produção sem meses de ajustes."
A compensação: Você obtém a stack de automação de documentos mais abrangente disponível. Também obtém o esforço de implementação mais pesado. Se sua organização realmente processa 10.000+ documentos por mês em vários tipos de documento e tem uma equipe de TI para gerenciar a implantação, o esforço pesado compensa em densidade de automação — uma única plataforma cuida de tudo, desde a captura no malote até o lançamento no ERP. Se você processa 300 faturas por mês e não tem um departamento de TI, está pagando por uma complexidade de infraestrutura que nunca usará e por um cronograma de implantação que vai superar sua paciência.
As plataformas enterprise também tendem a ser mais fortes em manuscritos e estruturas de tabelas complexas — a Hyperscience em particular construiu sua reputação no processamento de documentos manuscritos para agências governamentais e pagadoras de saúde. Se sua mistura de documentos inclui uma porcentagem significativa de formulários manuscritos, o nível enterprise pode ser a única categoria com a precisão para lidar com eles de forma limpa.
Ferramentas Especializadas para Médio Porte: Potência Focada sem o Excesso
As ferramentas de médio porte custam entre US$ 300 e US$ 1.000 por mês e resolvem o problema que as plataformas empresariais criam para organizações menores: ferramenta demais, custo demais, implementação demais. Nanonets, Docsumo, Affinda e Docparser são os nomes mais visíveis aqui. Elas não tentam ser plataformas completas — focam em fazer a extração bem e deixam você lidar com o fluxo de trabalho downstream nas suas ferramentas existentes.
O que é diferente do nível empresarial: Você terá extração com IA que lida com layouts variáveis sem modelos — a mesma tecnologia subjacente do nível empresarial. O que você não terá é a pilha completa de automação de fluxo de trabalho: sem roteamento de aprovação integrado, sem biblioteca de conectores ERP, sem controle de acesso baseado em funções para auditorias de conformidade. Essas ferramentas presumem que você já tem sistemas para essas funções e só precisa da extração para alimentar os dados neles.
O ponto ideal: Uma empresa de contabilidade de médio porte processando 2.000 a 5.000 documentos por mês. Volume suficiente para que a entrada manual seja genuinamente cara, mas não o suficiente para justificar uma implantação empresarial de 6 meses. A abordagem de OCR zonal do Docparser funciona bem para organizações com layouts de documentos consistentes (mesmos fornecedores todo mês, mesmos formulários). Nanonets e Docsumo usam modelos de deep learning que lidam melhor com variações — útil quando seus documentos recebidos vêm de mais de 50 contrapartes diferentes, sem dois formatos idênticos.
A compensação: Precisão melhor do que ferramentas de baixo custo em tipos de documentos repetitivos e de alto volume, por uma fração do preço empresarial. Mas você encontrará um teto na personalização — quer adicionar uma regra de validação personalizada que cruze os dados extraídos com seu ERP antes que o resultado seja aceito? Isso é território empresarial. O nível de médio porte cobre a extração completamente; ele deixa o "o que acontece depois da extração" para você.
Muitos compradores neste nível também precisam decidir se vão seguir com API-first ou no-code — algumas ferramentas de médio porte oferecem ambos os caminhos, e a escolha depende de você ter desenvolvedores disponíveis para criar integrações ou precisar que tudo funcione por meio de uma interface de navegador.
Ferramentas de Orçamento / Sem Código: O Nível de Autoatendimento
É aqui que o cenário mudou mais rápido nos últimos dois anos. Ferramentas como ImageToTable.ai, Airparser, Parseur e Parsio operam na faixa de $9–$59/mês. Elas são feitas para um comprador específico: alguém que precisa extrair dados de documentos hoje, não pode esperar um ciclo de compras e não tem um desenvolvedor para construir uma integração. Todo o fluxo de trabalho roda no navegador.
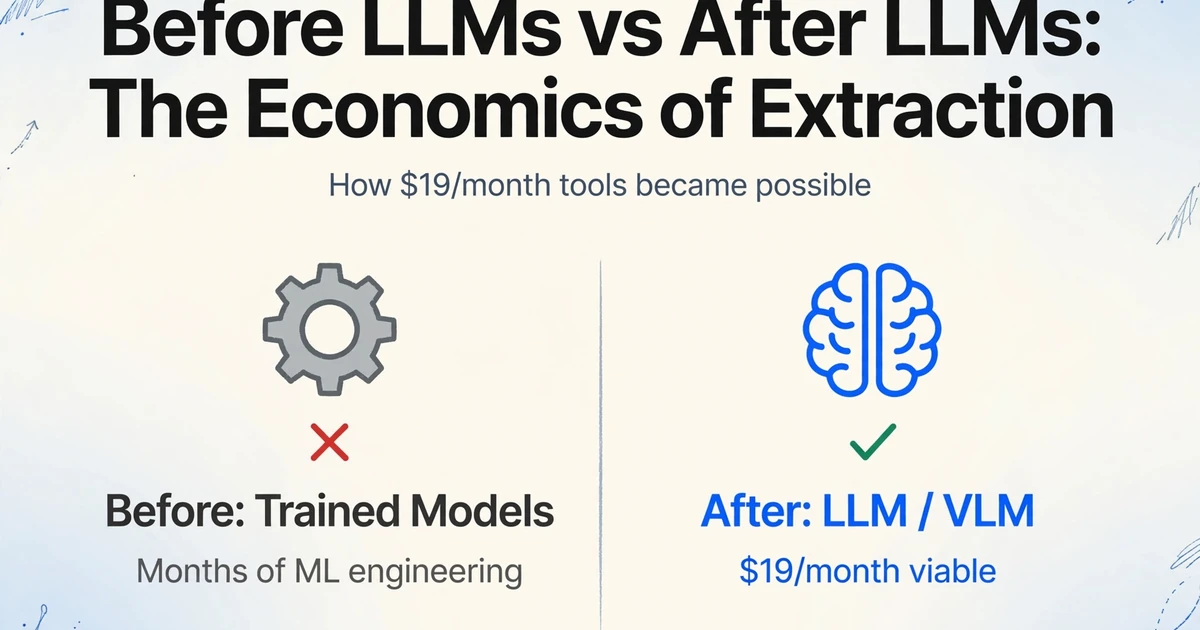
A mudança tecnológica que tornou esta categoria viável: Dois anos atrás, uma ferramenta de extração de $19/mês não poderia existir porque a única maneira de obter precisão decente era através de modelos treinados — e treinar modelos exigia (a) meses de engenharia de machine learning ou (b) pagar um fornecedor empresarial que já tivesse feito isso. A chegada dos large language models e vision-language models mudou a economia. Em vez de treinar um modelo por tipo de documento, essas ferramentas enviam seu documento para um LLM ou VLM que lê o documento da mesma forma que um humano — entendendo o que os campos significam, não onde estão na página. O custo por documento dessa abordagem caiu o suficiente para tornar planos de $19/mês viáveis com centenas de páginas por mês.
Como funciona na prática: Você envia um PDF, JPG ou captura de tela. Você digita os nomes dos campos desejados — "Número da Fatura, Nome do Fornecedor, Total, Data de Vencimento." A IA encontra cada valor em qualquer lugar da página entendendo semântica, não coordenadas. No ImageToTable.ai, isso é chamado de Extração de Colunas Personalizadas: os nomes das colunas que você digita se tornam os cabeçalhos da sua planilha de saída. Precisa lidar com 50 faturas de uma vez? Envie-as como um lote e obtenha um único arquivo Excel mesclado — cada fatura se torna uma linha com as colunas que você especificou. Você pode até definir colunas calculadas que realizam cálculos durante a extração — como "Total da Linha (Qtd × Preço Unitário)" — para que a planilha baixada contenha respostas, não apenas dados brutos.
A maioria das ferramentas neste nível também oferece um recurso de Link de Coleta: gere uma URL compartilhável, envie-a para clientes ou membros da equipe, e os documentos enviados por eles caem diretamente na sua fila de processamento — sem necessidade de registro por parte deles.
A compensação: Esta categoria oferece o tempo mais rápido até o primeiro resultado do mercado — geralmente menos de 2 minutos desde a chegada à página até o download de uma planilha. A compensação é que você está obtendo extração, não uma plataforma de fluxo de trabalho. Se você precisa de lançamento automático em ERP, roteamento de aprovação ou uma fila de revisão humana com permissões granulares baseadas em funções, você precisa de uma ferramenta de uma categoria superior. As ferramentas de orçamento lidam muito bem com a etapa de extração; elas não automatizam o que acontece antes ou depois dela.
Quando ferramentas de baixo custo vencem
Um escritório de contabilidade com 3 pessoas processa 200 faturas de clientes por mês. Uma plataforma IDP empresarial custa 12× mais do que a receita mensal desses clientes. Uma ferramenta de baixo custo por $19/mês extrai os mesmos campos das mesmas faturas usando a mesma classe de IA — e o contador está trabalhando no Excel 45 segundos após o upload. O que falta não é a qualidade da extração; é a automação de fluxo de trabalho que ele não precisava em primeiro lugar.
API-First / Cloud-Native: Construa Seu Próprio Pipeline
Google Document AI, Amazon Textract e Azure Document Intelligence pertencem a uma categoria totalmente diferente. Estas não são ferramentas — são componentes de infraestrutura. Você não faz login em um painel e envia arquivos. Você escreve código que envia documentos para um endpoint REST e recebe JSON estruturado de volta. O preço é por página (de $0,0015 a $0,10 dependendo do processador), e a premissa é que sua equipe de engenharia construirá todo o pipeline em torno da etapa de extração.
Para quem é: Empresas SaaS que incorporam extração de documentos em seu próprio produto. Equipes de desenvolvimento empresarial com infraestrutura de nuvem existente que precisam de extração como um elo em uma cadeia automatizada. Organizações que processam documentos em volumes onde o preço por página é mais barato que o SaaS por assento — se você processa 50.000 páginas por mês, os $0,015/página do Textract ($750 no total) podem ser drasticamente mais baratos do que uma plataforma empresarial de $1.500/mês, desde que você tenha a equipe de engenharia para construir a infraestrutura ao redor.
O que os provedores de nuvem acertam: Os processadores pré-treinados do Google Document AI para faturas, recibos e documentos de identidade são genuinamente bons. A extração de tabelas do Amazon Textract lida com layouts complexos que quebram muitas ferramentas de terceiros. O Document Intelligence da Azure integra-se naturalmente com o ecossistema Microsoft 365 e Power Platform no qual muitas empresas já vivem.
A lacuna: Estas são APIs de extração, não soluções de processamento de documentos. Classificação, validação, tratamento de exceções, revisão humana — tudo isso precisa ser construído. Google, Amazon e Microsoft fornecem o motor; você fornece o carro. Um desenvolvedor que descreveu a construção de uma plataforma de extração de documentos no Reddit disse claramente: "A extração de documentos trata menos de encontrar um modelo perfeito e mais de construir um sistema que possa lidar com milhares de variações diferentes de documentos." A API fornece o primeiro passo — a extração — não o sistema.
Para equipes que avaliam se devem construir ou comprar, a análise completa de custos — tempo de desenvolvedor, infraestrutura, manutenção e preços de API — é abordada em detalhes em nossa análise de construir vs. comprar. A versão resumida: construir faz sentido quando a extração de documentos é o seu produto, não a sua despesa geral.
Open Source: Grátis como Cachorro de Rua
Tesseract — originalmente desenvolvido pela HP nos anos 1980, agora mantido pelo Google — continua sendo o mecanismo de OCR mais amplamente implantado do planeta. O PaddleOCR, da Baidu, ganhou força significativa desde 2023 por seu forte suporte multilíngue (mais de 100 idiomas) e recursos de reconhecimento de tabelas. O docTR, construído sobre PyTorch e TensorFlow, oferece uma arquitetura mais moderna com detecção e reconhecimento treináveis de ponta a ponta.
Essas ferramentas são gratuitas. A licença não custa nada. Mas OCR de código aberto não é extração de documentos — é reconhecimento de caracteres. O Tesseract pode informar o texto em uma página. Ele não pode informar qual sequência de texto é o número da fatura e qual é a referência de PO. Essa classificação, extração e lógica de estruturação é o que você constrói — e é onde reside o custo real.
Quando o código aberto funciona: Você tem um desenvolvedor que entende de visão computacional, processa documentos com layouts estritamente fixos (mesmo formulário, mesmas coordenadas, sempre) e seu volume justifica o custo de construção. O PaddleOCR, em particular, tem um pipeline de reconhecimento de tabelas forte que, quando combinado com pós-processamento personalizado, pode rivalizar com ferramentas comerciais em documentos tabulares estruturados — como observado por desenvolvedores na comunidade de OCR do Reddit que o compararam com modelos mais novos e o consideraram a opção mais confiável entre as de código aberto para uso em produção.
Quando não funciona: Seus documentos variam em layout entre as contrapartes. Você precisa de extração em nível de campo, não apenas saída de texto. Você não tem um engenheiro de visão computacional na equipe. Sob essas condições, a ferramenta "gratuita" custa mais em tempo de engenharia do que uma assinatura SaaS econômica custaria em um ano.
O Que Mudou em 2025–2026: Três Tendências Redefinindo o Mercado
O cenário de fornecedores não fica parado. Três mudanças estruturais estão ativamente redesenhando os limites de categoria descritos acima.
1. LLMs e VLMs estão substituindo a extração baseada em modelos — e desta vez é para valer
Por duas décadas, a abordagem dominante para extração de documentos foi a correspondência de modelos: desenhe uma caixa ao redor do campo do número da fatura, diga ao software "o valor está aqui" e espere que a próxima fatura coloque-o no mesmo lugar. O aprendizado de máquina melhorou isso ligeiramente ao aprender padrões a partir de exemplos rotulados, mas a dependência fundamental de um layout consistente persistiu. O VP e Analista Principal da Forrester, Boris Evelson, escrevendo no Document Mining and Analytics Platforms Landscape Q4 2025, descreve a IA generativa e agêntica como um "equalizador que desafia a capacidade dos fornecedores de se diferenciarem" em arquiteturas baseadas em regras e modelos.
A mudança é arquitetural, não incremental. Um modelo de visão-linguagem não procura um campo nas coordenadas (x: 342, y: 891). Ele lê o documento holisticamente e responde à pergunta "qual é o valor total nesta página?" ao entender a relação entre o rótulo "Total" e o número ao lado — independentemente de onde cada um aparece. Essa é a mesma abordagem que um leitor humano usa, e é por isso que ferramentas de todas as categorias têm adicionado "sem modelo" ao seu marketing em 2025-2026.
O efeito prático: ferramentas que só conseguiam lidar com 80% dos formatos de documentos agora conseguem lidar com 95%+, porque o modo de falha — "o layout mudou" — não é mais um modo de falha.
2. Processamento de documentos agêntico: extração que não para na extração
O termo "agêntico" tem sido muito badalado — e abordaremos o que é real versus o que é marketing em breve — mas a ideia central é genuína. O IDP tradicional faz isso: insere um documento, gera JSON. O processamento de documentos agêntico faz isso: insere um documento, a IA planeja um fluxo de trabalho em várias etapas, extrai dados, valida-os contra regras conhecidas, cruza-os com dados de outros documentos e age — postando em um ERP, acionando uma aprovação, sinalizando uma anomalia.
A Kognitos define extração de dados agêntica como sistemas onde "agentes de IA autônomos planejam fluxos de trabalho em várias etapas, raciocinam iterativamente sobre conteúdo ambíguo, adaptam-se a formatos que nunca viram antes, validam suas próprias saídas e, cada vez mais, agem sobre o que extraem." A palavra-chave é iterativamente: um sistema agêntico que encontra um campo ambíguo não adivinha — ele relê o documento, verifica o contexto e, se ainda estiver incerto, encaminha para um humano com uma pergunta específica sobre um campo específico.
A previsão paralela da IDC, Worldwide IDP Software Forecast, projeta o mercado crescendo a 29,6% CAGR, "impulsionado principalmente pela adoção de capacidades de IA agêntica e generativa na automação de documentos." A trajetória é real, mas o estado atual é desigual: o estudo de 2025 da Deloitte, Emerging Technology Trends, descobriu que, embora 38% das organizações estejam testando IA agêntica, apenas 11% têm agentes operando ativamente em produção.
3. Modelos multimodais: os documentos não são só texto
A terceira tendência é a mais silenciosa, mas pode ser a mais consequente. As ferramentas de extração de geração anterior tratavam os documentos como texto que por acaso vivia em uma imagem — primeiro OCR, depois NLP. Este pipeline quebrava sempre que o layout visual importava: marcas de verificação em caixas, assinaturas manuscritas ao lado de datas impressas, fotos incorporadas em relatórios.
Os modelos de visão-linguagem (VLM) colapsam o pipeline OCR→NLP em uma única etapa. Eles processam o documento como entrada visual — pixels, não texto extraído — e raciocinam sobre ele diretamente. Um VLM pode responder "a caixa 'Aprovado' está marcada?" olhando a caixa, não inferindo a partir do texto próximo. Ele pode ler uma nota manuscrita na margem de uma fatura impressa sem uma etapa separada de reconhecimento de escrita manual.
Isto é importante para o panorama porque está a desfocar a linha entre categorias. Uma ferramenta econômica de $19/mês usando um backend VLM agora pode lidar com tipos de documentos que, há três anos, exigiam uma plataforma empresarial com um modelo de escrita manual dedicado. A tecnologia que costava diferenciar níveis de preço está se difundindo para baixo — o que significa que a diferenciação real entre categorias está se deslocando da precisão de extração para fluxo de trabalho, integração e suporte.
Exagerado vs. Real: Separando o Sinal do Ruido
Todos os sites de fornecedores em 2026 adicionaram "com IA", "agêntico" e "sem modelo" à sua página inicial. Aqui está o que está realmente acontecendo versus o que é marketing.
| Afirmação | O que é Real | O que é Exagerado |
|---|---|---|
| "99% de precisão" | A precisão de OCR a nível de caractere em texto digital limpo e de alta resolução é genuinamente superior a 99% nas ferramentas modernas. | A precisão de extração a nível de campo em documentos do mundo real — digitalizados, inclinados, carimbados, multilíngues — raramente supera 95%. A maioria das afirmações de "99%" mede a coisa errada. Quando você precisa que o total da fatura esteja correto, a precisão de caractere é irrelevante; a precisão de campo é tudo. |
| "Extração sem modelo" | As ferramentas baseadas em LLM e VLM realmente lidam com layouts variáveis sem configuração por tipo de documento. Esta é uma tecnologia real e funcional em 2026, disponível em ferramentas de vários níveis de preço. | "Sem modelo" não significa "zero configuração". Você ainda precisa dizer à ferramenta quais campos extrair. A inovação é que você descreve os campos semanticamente ("Data de Vencimento") em vez de espacialmente ("caixa em x:342, y:891") — não que a ferramenta lea sua mente sobre quais dados você deseja. |
| "IA Agéntica" | Razonamento multi-etapa, autovalidação e extração adaptativa estão funcionando em implementações controladas — particularmente para processamento de faturas onde as regras de validação estão bem definidas. | Apenas 11% das organizações têm agentes implementados em produção, segundo dados da Deloitte. A maioria dos recursos "agénticos" em 2026 são extração de etapa única com uma verificação de validação — útil, mas não a camada de operações documentais autónomas que o marketing implica. |
| "Nenhum treinamento necessário" | As ferramentas baseadas em LLM funcionam imediatamente em tipos de documentos comuns sem dados de treinamento rotulados — uma melhora genuina em comparação com a geração de ferramentas baseadas em ML de 2018-2024. | Casos extremos — estruturas de tabela incomuns, documentos mistos multilíngues, páginas fortemente carimbadas/por fax — ainda se beneficiam de configuração, e as implementações empresariales ainda investem tempo significativo em ajustes para sua combinação específica de documentos. |
O sinal mais honesto que você pode obter de um fornecedor não está em sua página principal. Está em sua página de precios: se os números são visíveis sem falar com vendas, a ferramenta foi construída para compradores de autoservicio. Se cada nível diz "Contactar Vendas", a ferramenta foi construída para ciclos de compra empresariales — e tudo sobre o cronograma de implementação, modelo de suporte e complexidade contratual refletirá isso.
Como Usar Este Panorama para Refinar Sua Busca
Você viu as cinco categorias. Viu as tendências que as remodelam. Agora: por qual categoria você deve começar? Três perguntas reduzem isso mais rápido do que qualquer matriz de comparação de recursos.
Quantos documentos por mês?
Abaixo de 500: ferramentas econômicas/no-code lidarão com seu volume sem esforço. 500–5.000: ferramentas de médio porte oferecem melhor precisão em escala e geralmente incluem recursos básicos de fluxo de trabalho. 5.000+: IDP empresarial ou API-first — a economia por documento das ferramentas econômicas começa a quebrar, e a profundidade de integração das plataformas empresariais começa a compensar.
Quem vai operar isso?
Sem desenvolvedores na equipe: fique no nível no-code ou médio porte — eles são feitos para operação via navegador por usuários não técnicos. Um ou dois desenvolvedores disponíveis: API-first se torna viável, e você pode considerar construir um pipeline em torno do Google Document AI ou Textract. Equipe de engenharia completa: open source ou API-first, com o entendimento de que "grátis" significa horas de engenharia.
O que acontece com os dados após a extração?
Eles vão para uma planilha que você revisa manualmente: o nível econômico é suficiente. Eles precisam ser postados automaticamente em um ERP e acionar fluxos de trabalho downstream: você precisará de uma ferramenta de médio porte ou empresarial com conectores de integração. Eles alimentam seu próprio produto SaaS: API-first é a única arquitetura que faz sentido — você está incorporando a extração, não a usando.
Observe o que está ausente nessas três perguntas: contagem de recursos, porcentagens de precisão e vídeos de demonstração de fornecedores. Isso importa dentro da sua categoria escolhida. Mas se você não respondeu à pergunta da categoria primeiro, está comparando ferramentas que nunca foram feitas para competir entre si.
Depois de identificar sua categoria, o próximo passo é avaliar ferramentas específicas. A estrutura em nosso guia de avaliação de 6 dimensões explica o que testar, como testar e como saber quando você testou o suficiente — sem se inscrever em um piloto de 3 meses.
Se você ainda está bem no começo — sem saber o que é software de extração de dados — comece com nosso guia para iniciantes antes de mergulhar na seleção de categoria.
Perguntas Frequentes
Como sei se estou na categoria errada?
O sinal mais confiável: você está pagando por recursos que não usa, ou está criando recursos que a ferramenta deveria incluir. Se você está em um plano empresarial e nunca tocou no módulo de automação de fluxo de trabalho, você está supercategorizado. Se você está em um plano econômico e criou um script Python que consulta a API da ferramenta a cada hora para alimentar seus dados no ERP, você superou a categoria. O ajuste de categoria diz respeito à proporção entre recursos usados e recursos pagos — e se os recursos ausentes estão custando mais em soluções alternativas do que o próximo nível custaria em taxas de assinatura.
Existe uma ferramenta que funcione em todas as categorias?
Nenhuma ferramenta única cobre bem todas as cinco categorias. Algumas ferramentas oferecem vários níveis que conectam duas categorias adjacentes — Nanonets, por exemplo, oferece tanto um plano self-serve de médio porte quanto um nível empresarial com automação de fluxo de trabalho. Mas a mesma ferramenta subjacente não pode ser otimizada simultaneamente para um contador autônomo que envia 100 recibos por mês e um departamento de compras que processa 50.000 POs. A arquitetura, o modelo de suporte e a estrutura de preços que atendem a um caso de uso trabalham ativamente contra o outro.
E se meu volume flutuar mês a mês?
Várias ferramentas nos níveis econômico e de médio porte oferecem preços pré-pagos ou baseados em créditos que lidam melhor com a flutuação do que alocações fixas mensais de páginas. ImageToTable.ai, Airparser e Parseur operam com modelos baseados em uso, onde você paga pelo que processa em vez de reservar capacidade. Se seu volume é consistentemente imprevisível, evite ferramentas com limites rígidos de páginas — taxas de excedente se acumulam rapidamente e o contrato anual que você assinou para obter um desconto se torna uma restrição.
Alguma dessas ferramentas lida com documentos manuscritos?
Plataformas empresariais — especialmente Hyperscience e ABBYY — têm as capacidades mais fortes de manuscritos, construídas ao longo de anos processando formulários de sinistros, registros médicos e documentos governamentais manuscritos. Entre ferramentas de baixo custo e médio porte, o suporte a manuscritos varia significativamente. Ferramentas que usam modelos de visão-linguagem (incluindo ImageToTable.ai) conseguem ler caligrafia clara em contexto — um total manuscrito ao lado de um rótulo impresso, por exemplo — mas parágrafos densos de escrita cursiva continuam desafiadores em todas as categorias. Se sua mistura de documentos é predominantemente manuscrita, teste a precisão de leitura de manuscritos em seus documentos reais antes de se comprometer com qualquer ferramenta; não confie na alegação de um fornecedor sem verificar com suas próprias amostras.
Qual é a maneira mais rápida de testar uma categoria antes de se comprometer?
Ferramentas de baixo custo e médio porte no nível sem código geralmente oferecem uma demonstração ou teste gratuito que permite enviar seus próprios documentos e ver os resultados imediatamente — sem chamada de vendas, sem contrato. Esta é a maior vantagem dos níveis de autoatendimento: você pode validar se a ferramenta funciona em seus documentos em menos de 5 minutos. Ferramentas empresariais exigem uma conversa de vendas para acessar um teste, e o próprio teste geralmente envolve uma sessão de configuração guiada. Se você não tem certeza de qual categoria precisa, comece pelo mais simples — teste uma ferramenta de baixo custo primeiro. Se ela fizer o trabalho, você economizou milhares. Se não fizer, as lacunas que você encontrar dirão exatamente quais recursos você precisa do próximo nível acima.
O Mapa Não É o Território
O cenário descrito aqui é preciso em meados de 2026, mas as fronteiras estão mudando. A tecnologia que diferenciava plataformas empresariais há três anos — extração sem modelo, reconhecimento de manuscritos, suporte a vários idiomas — agora está disponível em ferramentas por um décimo do preço. A tecnologia que as diferenciará daqui a três anos — fluxos de trabalho agênticos que realmente reduzem a revisão humana, raciocínio multimodal que lida com qualquer documento sem configuração — está sendo construída hoje em todas as categorias.
O que não muda é a lógica de correspondência. A melhor ferramenta para uma empresa de 3 pessoas processando 200 faturas por mês nunca será a mesma que a melhor ferramenta para uma empresa de 500 pessoas processando 50.000. As categorias existem porque organizações diferentes têm necessidades estruturalmente diferentes, e nenhuma quantidade de progresso em IA muda isso. Comece com sua equipe, seu volume e seu fluxo de trabalho a jusante. A ferramenta segue a partir daí.
Teste em seus próprios documentos, em sua própria categoria, contra seus próprios limites. Um teste de 5 minutos com uma fatura real do seu fornecedor menos cooperativo lhe dirá mais do que todas as matrizes de recursos nesta página.