Panorama del Software de Extracción de Documentos 2026
Un Mapa, No una Clasificación
Dos herramientas pueden extraer datos de facturas de un PDF. Una cuesta $19 al mes. La otra requiere una conversación con un equipo de ventas que comienza en $1,500 al mes. Ambas usan la misma clase de IA internamente. La diferencia de precio de 75x no se trata de la calidad de extracción — se trata de que fueron creadas para organizaciones completamente diferentes, con distintas estructuras de equipo, distintos perfiles de volumen y distinta tolerancia a la complejidad de implementación. Si estás comenzando tu búsqueda de proveedores y comparando funciones entre rangos de precios sin antes entender qué categoría de herramienta fue creada para tu situación, no estás evaluando — estás adivinando. Este artículo dibuja el mapa.
Conclusiones Clave
- Más de 100 proveedores de extracción de documentos afirman una precisión del 99% — y una herramienta como ImageToTable.ai a $19/mes usa la misma clase de IA internamente que las que comienzan en $1,500.
- Comparar funciones entre rangos de precios es el error más costoso que cometen los compradores — una herramienta sin código de $19 y una plataforma empresarial de $1,500 nunca fueron pensadas como alternativas; fueron creadas para organizaciones diferentes con distintas estructuras de equipo.
- Tres preguntas te ubicarán en la categoría correcta más rápido que cualquier demostración de proveedor: cuántos documentos al mes, quién opera la herramienta y qué sucede con los datos después de la extracción.
Por qué la categoría importa más que las funciones
El mercado de Intelligent Document Processing alcanzó aproximadamente $3.2 mil millones en 2026, con un crecimiento proyectado del 18-30% CAGR según la firma de analistas que consulte: Mordor Intelligence lo sitúa en $3.17 mil millones, mientras que Fortune Business Insights reporta $14.16 mil millones bajo un alcance más amplio que incluye servicios adyacentes de gestión de documentos. (La diferencia entre estas cifras es en sí misma una señal: distintos analistas cuentan cosas distintas, y la "extracción de documentos" como categoría tiene límites difusos).
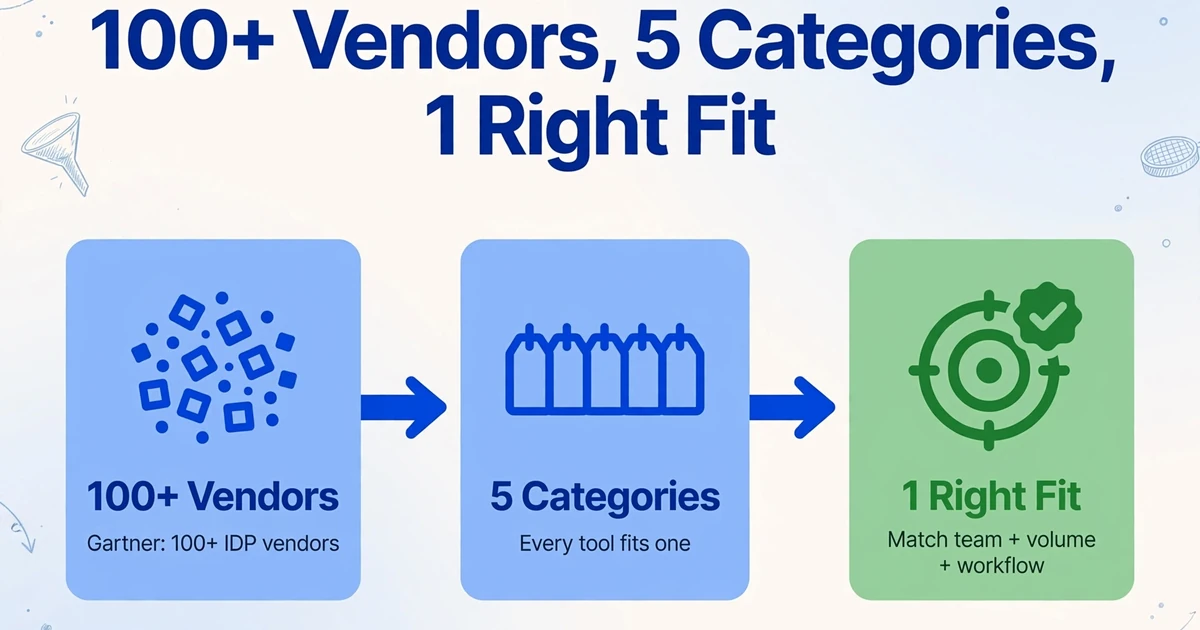
Lo que importa más que el tamaño exacto del mercado es la fragmentación. El Magic Quadrant más reciente de Gartner para Intelligent Document Processing señala más de 100 proveedores, desde hiperescaladores de nube hasta startups de nicho. Para un comprador que acaba de abrir una pestaña de búsqueda, ese número es paralizante.
Pero la fragmentación no es aleatoria. Cada herramienta del mercado se encuadra en una de aproximadamente cinco categorías, cada una construida en torno a una respuesta distinta a las mismas tres preguntas: ¿Qué tamaño tiene la organización? ¿Cuántos documentos fluyen al mes? ¿Quién va a operar la herramienta: un ingeniero, un contable o ambos?
Las categorías no son niveles de calidad. Una herramienta de presupuesto de $19/mes no es una versión "peor" de una plataforma empresarial de $1,500/mes: es una arquitectura diferente optimizada para un caso de uso distinto. El error que más caro le sale al comprador no es elegir la herramienta equivocada dentro de una categoría. Es elegir la categoría equivocada por completo y luego pasar meses intentando que la herramienta encaje.
Antes de comparar herramientas
Sepa qué categoría se creó para el tamaño de su equipo, su volumen mensual y su nivel técnico. El desajuste de categoría es el error más caro en la selección de software de extracción de documentos, y es invisible en una tabla comparativa de funciones.
Las cinco categorías de un vistazo
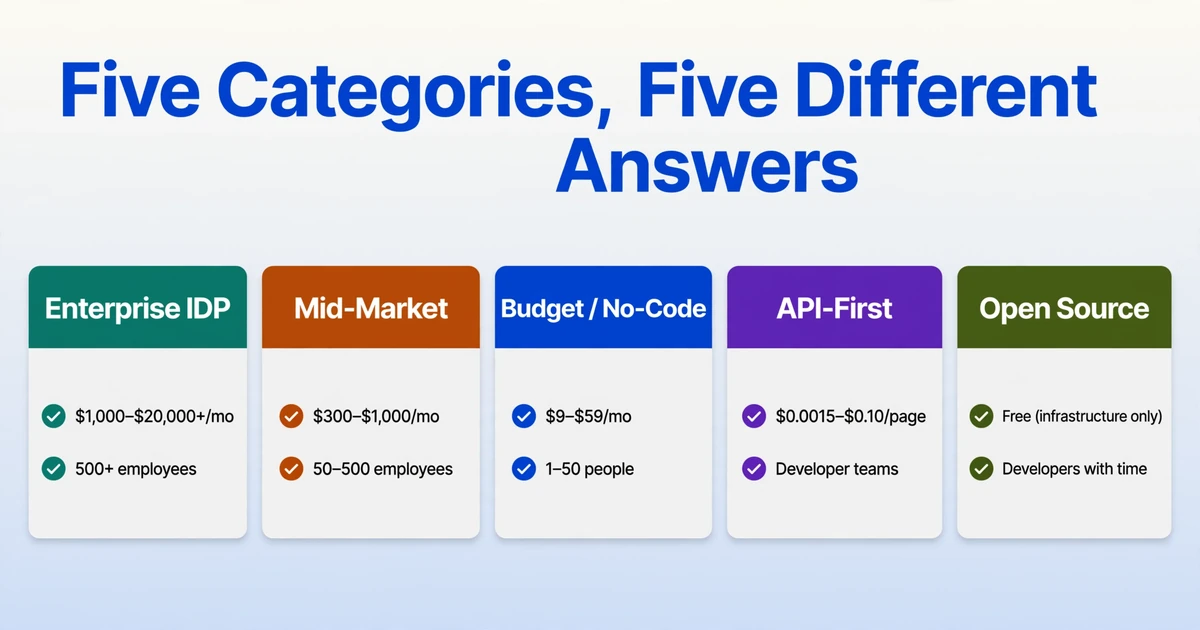
Este es el panorama en una tabla. Cada categoría es una respuesta diferente a "¿para quién es, cuánto cuesta y qué se sacrifica?". El resto de este artículo detalla cada una.
| Categoría | Para quién es | Rango de precio típico | Compensación principal | Ejemplos |
|---|---|---|---|---|
| IDP empresarial | Organizaciones de más de 500 empleados, IT dedicado, requisitos de cumplimiento | $1,000–$20,000+/mes | Máxima potencia, máximo peso de implementación | ABBYY Vantage, Hyperscience, Rossum, UiPath IXP |
| Especializado de mercado medio | 50–500 empleados, equipo de finanzas/operaciones, volumen moderado | $300–$1,000/mes | Buena precisión a un costo razonable, pero menos cobertura de flujos de trabajo | Nanonets, Docsumo, Affinda, Docparser |
| Económico / sin código | 1–50 personas, sin soporte de IT, configuración rápida necesaria | $9–$59/mes | Inicio más rápido, menor costo, limitado a flujos de trabajo de solo extracción | ImageToTable.ai, Airparser, Parseur, Parsio |
| API primero / nativo de la nube | Equipos de desarrolladores que integran la extracción en su propio producto | Por página ($0.0015–$0.10/página) | Control total del pipeline, requiere inversión en ingeniería | Google Document AI, Amazon Textract, Azure Document Intelligence |
| Código abierto | Desarrolladores con tiempo, equipos que necesitan control total de los datos | Gratis (solo costo de infraestructura) | Cero costo de licencia, máxima carga de ingeniería | Tesseract, PaddleOCR, docTR |
Plataformas IDP empresariales: cuando la escala exige una suite completa
Las plataformas IDP empresariales son la categoría que la mayoría de los compradores encuentran primero, porque tienen los mayores presupuestos de marketing y las historias de ventas más largas. Las herramientas de este nivel — ABBYY Vantage, Hyperscience, Intelligent Document Processing de UiPath, la oferta empresarial de Rossum — fueron creadas para organizaciones que procesan decenas de miles de documentos al mes en múltiples departamentos, con personal de TI dedicado, procesos formales de adquisición y requisitos de cumplimiento que exigen pistas de auditoría.
Lo que está comprando: Una plataforma integral de procesamiento de documentos. La extracción es un módulo. La plataforma también incluye clasificación de documentos (identificar automáticamente qué tipo de documento acaba de llegar), reglas de validación, enrutamiento basado en confianza (los resultados de alta confianza pasan directamente, los de baja confianza van a una cola de revisión humana), conectores de integración ERP/CRM y control de acceso basado en roles. Cuando ABBYY o Rossum venden a una empresa, no están vendiendo extracción — están vendiendo una capa de operaciones documentales.
El costo real: El plan inicial de Rossum comienza alrededor de $18,000 por año. El nivel empresarial de Nanonets comienza en $999/mes y escala con el volumen. ABBYY no publica precios en absoluto. Pero el costo de la licencia suele ser el menor de dos gastos. La implementación — configurar tipos de documentos, entrenar modelos, integrar con sistemas existentes, capacitar al personal — normalmente toma de 3 a 12 meses y cuesta más que la licencia del primer año. Un informe de Forrester sobre la adopción de IDP señala que los compradores que subestiman la complejidad de la implementación "a menudo ven tasas de precisión en la fase piloto que parecen prometedoras pero no se traducen a producción sin meses de ajuste".
La compensación: Obtiene la pila de automatización documental más completa disponible. También obtiene el esfuerzo de implementación más pesado. Si su organización realmente procesa 10,000+ documentos al mes en múltiples tipos de documentos y tiene un equipo de TI para gestionar el despliegue, el esfuerzo pesado se compensa en densidad de automatización — una sola plataforma maneja todo, desde la ingesta del correo hasta el registro en ERP. Si procesa 300 facturas al mes y no tiene un departamento de TI, está pagando por una complejidad de infraestructura que nunca usará y un cronograma de despliegue que superará su paciencia.
Las plataformas empresariales también tienden a ser las más sólidas en escritura a mano y estructuras de tablas complejas — Hyperscience en particular construyó su reputación en el procesamiento de documentos manuscritos para agencias gubernamentales y pagadores de salud. Si su combinación de documentos incluye un porcentaje significativo de formularios manuscritos, el nivel empresarial puede ser la única categoría con la precisión para manejarlos limpiamente.
Herramientas Especializadas de Mercado Medio: Potencia Enfocada Sin el Lastre
Las herramientas de mercado medio se sitúan en el rango de $300–$1,000 al mes y resuelven el problema que las plataformas empresariales crean para organizaciones más pequeñas: demasiada herramienta, demasiado costo, demasiada implementación. Nanonets, Docsumo, Affinda y Docparser son los nombres más visibles aquí. No intentan ser plataformas integrales: se centran en hacer bien la extracción y le permiten manejar el flujo de trabajo posterior en sus herramientas existentes.
Qué es diferente de las empresariales: Obtendrá una extracción impulsada por IA que maneja diseños variables sin plantillas: la misma tecnología subyacente que el nivel empresarial. Lo que no obtendrá es la pila completa de automatización de flujos de trabajo: sin enrutamiento de aprobación integrado, sin biblioteca de conectores ERP, sin control de acceso basado en roles para auditorías de cumplimiento. Estas herramientas asumen que ya tiene sistemas para esas funciones y solo necesita extracción para alimentar datos en ellos.
El punto óptimo: Una firma contable de tamaño mediano que procesa 2,000–5,000 documentos al mes. Suficiente volumen para que la entrada manual sea genuinamente costosa, pero no suficiente para justificar una implementación empresarial de 6 meses. El enfoque de OCR zonal de Docparser funciona bien para organizaciones con diseños de documentos consistentes (los mismos proveedores cada mes, los mismos formularios). Nanonets y Docsumo utilizan modelos de aprendizaje profundo que manejan mejor la variación, útil cuando sus documentos entrantes provienen de más de 50 contrapartes diferentes sin dos formatos idénticos.
La compensación: Mejor precisión que las herramientas económicas en tipos de documentos de alto volumen y repetitivos, a una fracción del precio empresarial. Pero encontrará un límite en la personalización: ¿quiere agregar una regla de validación personalizada que coteje los datos extraídos contra su ERP antes de que se acepte el resultado? Eso es territorio empresarial. El nivel de mercado medio cubre la extracción a fondo; le deja el "qué sucede después de la extracción" a usted.
Muchos compradores en este nivel también necesitan decidir si ir primero con API o sin código — algunas herramientas de mercado medio ofrecen ambos caminos, y la elección depende de si tiene desarrolladores disponibles para crear integraciones o necesita que todo funcione a través de una interfaz de navegador.
Herramientas Económicas / Sin Código: El Nivel de Autoservicio
Aquí es donde el panorama ha cambiado más rápido en los últimos dos años. Herramientas como ImageToTable.ai, Airparser, Parseur y Parsio operan en el rango de $9–$59 al mes. Están diseñadas para un comprador específico: alguien que necesita extraer datos de documentos hoy, no puede esperar un ciclo de adquisiciones y no tiene un desarrollador para crear una integración. Todo el flujo de trabajo se ejecuta en un navegador.
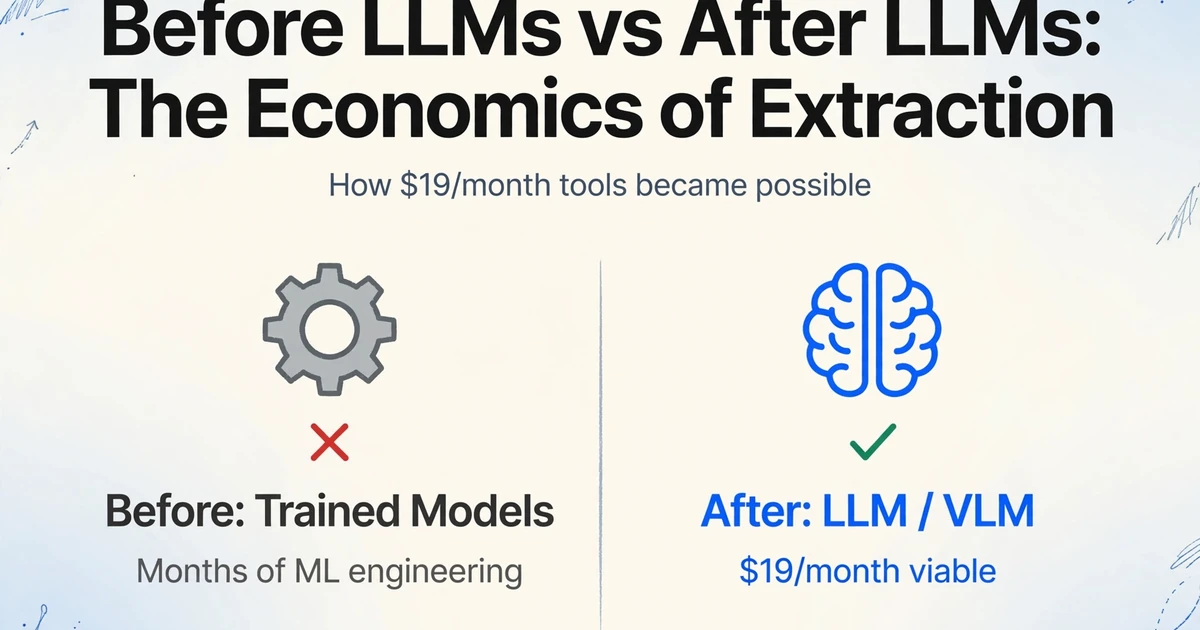
El cambio tecnológico que hizo viable esta categoría: Hace dos años, una herramienta de extracción de $19/mes no podía existir porque la única forma de obtener una precisión decente era mediante modelos entrenados — y entrenar modelos requería (a) meses de ingeniería de machine learning o (b) pagar a un proveedor empresarial que ya lo había hecho. La llegada de los large language models y los vision-language models cambió la economía. En lugar de entrenar un modelo por tipo de documento, estas herramientas envían su documento a un LLM o VLM que lo lee como lo haría un humano — comprendiendo lo que los campos significan, no dónde están en la página. El costo por documento de ese enfoque bajó lo suficiente como para hacer viables los planes de $19/mes con cientos de páginas al mes.
Cómo funciona en la práctica: Sube un PDF, JPG o captura de pantalla. Escribe los nombres de los campos que desea — "Número de Factura, Nombre del Proveedor, Total, Fecha de Vencimiento." La IA encuentra cada valor en cualquier parte de la página comprendiendo la semántica, no las coordenadas. En ImageToTable.ai, esto se llama Extracción de Columnas Personalizadas: los nombres de las columnas que escribe se convierten en los encabezados de su hoja de cálculo de salida. ¿Necesita manejar 50 facturas a la vez? Súbalas como un lote y obtenga un archivo de Excel fusionado — cada factura se convierte en una fila con las columnas que especificó. Incluso puede definir columnas calculadas que realizan cálculos durante la extracción — como "Total de Línea (Cantidad × Precio Unitario)" — para que la hoja de cálculo que descargue contenga respuestas, no solo datos sin procesar.
La mayoría de las herramientas en este nivel también ofrecen una función de Enlace de Recopilación: genere una URL compartible, envíela a clientes o miembros del equipo, y sus documentos subidos llegarán directamente a su cola de procesamiento — sin necesidad de registro por su parte.
La compensación: Esta categoría le ofrece el tiempo más rápido hasta el primer resultado del mercado — a menudo menos de 2 minutos desde que llega a la página hasta que descarga una hoja de cálculo. La compensación es que obtiene extracción, no una plataforma de flujo de trabajo. Si necesita publicación automática en ERP, enrutamiento de aprobaciones o una cola de revisión humana con permisos granulares basados en roles, necesita una herramienta de una categoría superior. Las herramientas económicas manejan el paso de extracción extremadamente bien; no automatizan lo que sucede antes o después.
Cuando las herramientas económicas ganan
Una firma contable de 3 personas procesa 200 facturas de clientes al mes. Una plataforma IDP empresarial cuesta 12× más que los ingresos mensuales de esos clientes. Una herramienta económica a $19/mes extrae los mismos campos de las mismas facturas usando la misma clase de IA — y el contador está trabajando en Excel 45 segundos después de subirlas. Lo que falta no es la calidad de extracción; es la automatización del flujo de trabajo que no necesitaban en primer lugar.
API-First / Cloud-Native: Construye Tu Propio Pipeline
Google Document AI, Amazon Textract y Azure Document Intelligence pertenecen a una categoría completamente distinta. No son herramientas — son componentes de infraestructura. No inicias sesión en un panel y subes archivos. Escribes código que envía documentos a un endpoint REST y recibe JSON estructurado de vuelta. El precio es por página (desde $0.0015 hasta $0.10 según el procesador), y la suposición es que tu equipo de ingeniería construirá todo el pipeline alrededor del paso de extracción.
Para quién es: Empresas SaaS que integran extracción de documentos en su propio producto. Equipos de desarrollo empresarial con infraestructura cloud existente que necesitan extracción como un eslabón en una cadena automatizada. Organizaciones que procesan documentos a volúmenes donde el precio por página es más barato que el SaaS por usuario — si procesas 50,000 páginas al mes, los $0.015/página de Textract ($750 en total) pueden ser drásticamente más baratos que una plataforma empresarial de $1,500/mes, asumiendo que tienes el equipo de ingeniería para construir la infraestructura circundante.
Lo que los proveedores cloud hacen bien: Los procesadores pre-entrenados de Google Document AI para facturas, recibos y documentos de identidad son genuinamente buenos. La extracción de tablas de Amazon Textract maneja diseños complejos que rompen muchas herramientas de terceros. Document Intelligence de Azure se integra naturalmente con el ecosistema de Microsoft 365 y Power Platform en el que muchas empresas ya viven.
La brecha: Estas son APIs de extracción, no soluciones de procesamiento de documentos. Clasificación, validación, manejo de excepciones, revisión humana — todo eso necesita ser construido. Google, Amazon y Microsoft proporcionan el motor; tú proporcionas el auto. Un desarrollador que describió construir una plataforma de extracción de documentos en Reddit lo dijo claramente: "La extracción de documentos se trata menos de encontrar un modelo perfecto y más de construir un sistema que pueda manejar miles de variaciones de documentos." La API te da el primer paso — la extracción — no el sistema.
Para equipos que evalúan si construir o comprar, el desglose completo de costos — tiempo de desarrollador, infraestructura, mantenimiento y precios de API — se cubre en detalle en nuestro análisis de construir vs comprar. La versión corta: construir tiene sentido cuando la extracción de documentos es tu producto, no tu gasto general.
Código abierto: gratis como un cachorro
Tesseract — desarrollado originalmente en HP en los años 80, ahora mantenido por Google — sigue siendo el motor de OCR más implementado del planeta. PaddleOCR, de Baidu, ha ganado un impulso significativo desde 2023 por su sólido soporte multilingüe (más de 100 idiomas) y sus capacidades de reconocimiento de tablas. docTR, construido sobre PyTorch y TensorFlow, ofrece una arquitectura más moderna con detección y reconocimiento entrenables de extremo a extremo.
Estas herramientas son gratuitas. La licencia no cuesta nada. Pero el OCR de código abierto no es extracción de documentos — es reconocimiento de caracteres. Tesseract puede decirte el texto en una página. No puede decirte qué cadena de texto es el número de factura y cuál es la referencia de PO. Esa lógica de clasificación, extracción y estructuración es lo que tú construyes — y ahí es donde reside el costo real.
Cuando el código abierto funciona: Tienes un desarrollador que sabe de visión por computadora, procesas documentos con diseños estrictamente fijos (mismo formulario, mismas coordenadas, cada vez), y tu volumen justifica el costo de construcción. PaddleOCR en particular tiene un sólido pipeline de reconocimiento de tablas que, combinado con post-procesamiento personalizado, puede rivalizar con herramientas comerciales en documentos tabulares estructurados — como lo señalan desarrolladores en la comunidad de OCR de Reddit que lo han comparado con modelos más nuevos y lo han encontrado como la opción más confiable entre las de código abierto para uso en producción.
Cuando no funciona: Tus documentos varían en diseño entre contrapartes. Necesitas extracción a nivel de campo, no solo salida de texto. No tienes un ingeniero de visión por computadora en tu equipo. Bajo estas condiciones, la herramienta "gratuita" cuesta más en tiempo de ingeniería de lo que costaría una suscripción SaaS económica en un año.
Qué cambió en 2025–2026: tres tendencias que reconfiguran el mercado
El panorama de proveedores no se queda quieto. Tres cambios estructurales están redibujando activamente los límites de categoría descritos anteriormente.
1. Los LLM y los VLM están reemplazando la extracción basada en plantillas — esta vez de verdad
Durante dos décadas, el enfoque dominante en la extracción de documentos fue el emparejamiento de plantillas: dibuje un cuadro alrededor del campo del número de factura, dígale al software «el valor está aquí» y espere que la próxima factura lo coloque en el mismo lugar. El aprendizaje automático mejoró esto ligeramente al aprender patrones de ejemplos etiquetados, pero la dependencia fundamental de un diseño consistente persistió. Boris Evelson, vicepresidente y analista principal de Forrester, escribiendo en el Document Mining and Analytics Platforms Landscape Q4 2025, describe la IA generativa y agéntica como un «ecualizador que desafía la capacidad de los proveedores para diferenciarse» en arquitecturas basadas en reglas y plantillas.
El cambio es arquitectónico, no incremental. Un modelo de visión y lenguaje no busca un campo en las coordenadas (x: 342, y: 891). Lee el documento de manera holística y responde la pregunta «¿cuál es el monto total en esta página?» al comprender la relación entre la etiqueta «Total» y el número que la acompaña, sin importar dónde aparezca cada uno. Este es el mismo enfoque que usa un lector humano, y es por eso que las herramientas de todas las categorías han estado añadiendo «sin plantilla» a su marketing en 2025-2026.
El efecto práctico: las herramientas que solo podían manejar el 80% de los formatos de documentos ahora pueden manejar más del 95%, porque el modo de fallo — «el diseño cambió» — ya no es un modo de fallo en absoluto.
2. Procesamiento de documentos agéntico: extracción que no se detiene en la extracción
El término «agéntico» ha sido muy promocionado — y abordaremos qué es real frente a qué es marketing en breve — pero la idea central es genuina. El IDP tradicional hace esto: ingrese un documento, obtenga JSON. El procesamiento de documentos agéntico hace esto: ingrese un documento, la IA planifica un flujo de trabajo de múltiples pasos, extrae datos, los valida contra reglas conocidas, los contrasta con datos de otros documentos y actúa — publicando en un ERP, activando una aprobación, señalando una anomalía.
Kognitos define la extracción de datos agéntica como sistemas donde «los agentes autónomos de IA planifican flujos de trabajo de múltiples pasos, razonan de manera iterativa sobre contenido ambiguo, se adaptan a formatos que nunca han visto, validan sus propias salidas y, cada vez más, toman acciones sobre lo que extraen». La palabra clave es iterativamente: un sistema agéntico que encuentra un campo ambiguo no adivina — vuelve a leer el documento, verifica el contexto y, si aún no está seguro, escala a un humano con una pregunta específica sobre un campo específico.
El pronóstico paralelo de IDC, Worldwide IDP Software Forecast, proyecta que el mercado crecerá a una CAGR del 29,6%, «impulsado principalmente por la adopción de capacidades de IA agéntica y generativa en la automatización de documentos». La trayectoria es real, pero el estado actual es desigual: el estudio de Tendencias de Tecnologías Emergentes 2025 de Deloitte encontró que, mientras el 38% de las organizaciones están probando la IA agéntica, solo el 11% tiene agentes operando activamente en producción.
3. Modelos multimodales: los documentos ya no son solo texto
La tercera tendencia es la más silenciosa, pero quizás la más trascendental. Las herramientas de extracción de generaciones anteriores trataban los documentos como texto que casualmente vivía en una imagen — primero OCR, luego NLP. Ese flujo se rompía cada vez que el diseño visual importaba: marcas de verificación en casillas, firmas manuscritas junto a fechas impresas, fotos incrustadas en informes.
Los modelos de visión-lenguaje colapsan el flujo OCR→NLP en un solo paso. Procesan el documento como entrada visual — píxeles, no texto extraído — y razonan sobre él directamente. Un VLM puede responder "¿está marcada la casilla 'Aprobado'?" mirando la casilla, no infiriendo del texto cercano. Puede leer una nota manuscrita al margen de una factura impresa sin una pasada separada de reconocimiento de escritura.
Esto importa para el panorama porque está difuminando la línea entre categorías. Una herramienta económica de $19/mes que use un backend VLM ahora puede manejar tipos de documentos que, hace tres años, requerían una plataforma empresarial con un modelo de escritura dedicado. La tecnología que solía diferenciar los niveles de precio se está difundiendo hacia abajo — lo que significa que la diferenciación real entre categorías se está desplazando de la precisión de extracción al flujo de trabajo, la integración y el soporte.
Exagerado vs. Real: Separando la Señal del Ruido
Cada sitio web de proveedores en 2026 ha añadido "impulsado por IA", "agéntico" y "sin plantilla" a su página de inicio. Esto es lo que realmente está sucediendo frente a lo que es marketing.
| Afirmación | Qué es real | Qué es exagerado |
|---|---|---|
| "99% de precisión" | La precisión de OCR a nivel de carácter en texto digital limpio y de alta resolución es genuinamente superior al 99% en las herramientas modernas. | La precisión de extracción a nivel de campo en documentos del mundo real — escaneados, torcidos, con sellos, multilingües — rara vez supera el 95%. La mayoría de las afirmaciones de "99%" miden lo incorrecto. Cuando necesitas que el total de la factura sea correcto, la precisión de caracteres es irrelevante; la precisión de campo lo es todo. |
| "Extracción sin plantilla" | Las herramientas basadas en LLM y VLM manejan genuinamente diseños variables sin configuración por tipo de documento. Esta es una tecnología real y funcional en 2026, disponible en herramientas de varios niveles de precio. | "Sin plantilla" no significa "cero configuración". Aún necesitas indicar a la herramienta qué campos extraer. La innovación es que describes los campos semánticamente ("Fecha de vencimiento") en lugar de espacialmente ("casilla en x:342, y:891") — no que la herramienta lea tu mente sobre qué datos deseas. |
| "IA agéntica" | El razonamiento de múltiples pasos, la autovalidación y la extracción adaptativa funcionan en implementaciones controladas — particularmente para el procesamiento de facturas donde las reglas de validación están bien definidas. | Solo el 11% de las organizaciones han implementado agentes en producción según los datos de Deloitte. La mayoría de las funciones "agénticas" en 2026 son extracción de un solo paso con una verificación de validación — útil, pero no la capa autónoma de operaciones documentales que implica el marketing. |
| "No se requiere entrenamiento" | Las herramientas impulsadas por LLM funcionan de inmediato en tipos de documentos comunes sin datos de entrenamiento etiquetados — una mejora genuina sobre la generación de herramientas basadas en ML de 2018-2024. | Los casos límite — estructuras de tabla inusuales, documentos mixtos multilingües, páginas muy selladas o enviadas por fax — aún se benefician de la configuración, y las implementaciones empresariales aún invierten tiempo significativo en ajustar sus herramientas para su combinación específica de documentos. |
La señal más honesta que puedes obtener de un proveedor no está en su página de inicio. Está en su página de precios: si los números son visibles sin hablar con ventas, la herramienta fue creada para compradores de autoservicio. Si cada nivel dice "Contactar con ventas", la herramienta fue creada para ciclos de adquisición empresarial — y todo sobre el cronograma de implementación, el modelo de soporte y la complejidad del contrato lo reflejará.
Cómo usar este panorama para acotar tu búsqueda
Ya has visto las cinco categorías. Ya has visto las tendencias que las están remodelando. Ahora: ¿en qué categoría deberías empezar? Tres preguntas lo acotan más rápido que cualquier matriz de comparación de funciones.
¿Cuántos documentos al mes?
Menos de 500: las herramientas económicas o sin código manejarán tu volumen sin esfuerzo. 500–5,000: las herramientas de mercado medio ofrecen mejor precisión a escala y suelen incluir funciones básicas de flujo de trabajo. 5,000 o más: IDP empresarial o API primero: la economía por documento de las herramientas económicas empieza a fallar y la profundidad de integración de las plataformas empresariales empieza a dar resultados.
¿Quién va a operarlo?
Sin desarrolladores en el equipo: quédate en el nivel sin código o de mercado medio; están diseñados para operarse desde el navegador por usuarios no técnicos. Con uno o dos desarrolladores disponibles: la opción API primero se vuelve viable y puedes considerar crear un pipeline en torno a Google Document AI o Textract. Con un equipo de ingeniería completo: código abierto o API primero, entendiendo que "gratis" significa horas de ingeniería.
¿Qué ocurre con los datos después de la extracción?
Van a una hoja de cálculo que revisas manualmente: el nivel económico es suficiente. Deben publicarse automáticamente en un ERP y activar flujos de trabajo posteriores: necesitarás una herramienta de mercado medio o empresarial con conectores de integración. Alimentan tu propio producto SaaS: la opción API primero es la única arquitectura que tiene sentido: estás integrando la extracción, no usándola.
Observa lo que falta en estas tres preguntas: cantidad de funciones, porcentajes de precisión y videos de demostración de los proveedores. Eso importa dentro de tu categoría elegida. Pero si no has respondido primero la pregunta de la categoría, estás comparando herramientas que nunca estuvieron destinadas a competir entre sí.
Una vez que hayas identificado tu categoría, el siguiente paso es evaluar herramientas específicas. El marco de nuestra guía de evaluación en 6 dimensiones explica qué probar, cómo probarlo y cómo saber cuándo has probado lo suficiente, sin inscribirte en un piloto de 3 meses.
Si todavía estás al principio, sin saber qué es siquiera el software de extracción de datos, empieza con nuestra guía para principiantes antes de sumergirte en la selección de categoría.
Preguntas Frecuentes
¿Cómo sé si estoy en la categoría equivocada?
La señal más confiable: estás pagando por funciones que no usas, o estás creando funciones que la herramienta debería haber incluido. Si tienes un plan empresarial y nunca has tocado el módulo de automatización de flujos de trabajo, estás sobrecategorizado. Si tienes un plan económico y has creado un script de Python que consulta la API de la herramienta cada hora para alimentar tu ERP, has superado la categoría. El ajuste de categoría se trata de la proporción entre funciones utilizadas y funciones pagadas, y de si las funciones faltantes te cuestan más en soluciones alternativas de lo que costaría el siguiente nivel en tarifas de suscripción.
¿Existe una herramienta que funcione en todas las categorías?
Ninguna herramienta única abarca bien las cinco categorías. Algunas herramientas ofrecen múltiples niveles que conectan dos categorías adyacentes — Nanonets, por ejemplo, ofrece tanto un plan de autoservicio para mercado medio como un nivel empresarial con automatización de flujos de trabajo. Pero la misma herramienta subyacente no puede estar optimizada simultáneamente para un contador independiente que sube 100 recibos al mes y un departamento de compras que procesa 50,000 POs. La arquitectura, el modelo de soporte y la estructura de precios que sirven a un caso de uso trabajan activamente en contra del otro.
¿Qué pasa si mi volumen fluctúa mes a mes?
Varias herramientas en los niveles económico y de mercado medio ofrecen precios de pago por uso o basados en créditos que manejan la fluctuación mejor que las asignaciones fijas mensuales de páginas. ImageToTable.ai, Airparser y Parseur operan con modelos basados en uso donde pagas por lo que procesas en lugar de reservar capacidad. Si tu volumen es constantemente impredecible, evita herramientas con límites estrictos de páginas — las tarifas por exceso se acumulan rápidamente y el contrato anual que firmaste para obtener un descuento se convierte en una restricción.
¿Alguno de estos programas maneja documentos manuscritos?
Las plataformas empresariales — en particular Hyperscience y ABBYY — tienen las capacidades de escritura a mano más sólidas, desarrolladas a lo largo de años de procesamiento de formularios de reclamaciones, registros médicos y documentos gubernamentales manuscritos. Entre las herramientas económicas y de gama media, el soporte de escritura a mano varía significativamente. Las herramientas que utilizan modelos de visión y lenguaje (incluido ImageToTable.ai) pueden leer escritura clara en contexto — por ejemplo, un total manuscrito junto a una etiqueta impresa — pero los párrafos densos de escritura cursiva siguen siendo un desafío en todas las categorías. Si su combinación de documentos es predominantemente manuscrita, pruebe la precisión de la escritura a mano en sus documentos reales antes de comprometerse con cualquier herramienta; no confíe en la afirmación de un proveedor sin verificarla con sus propias muestras.
¿Cuál es la forma más rápida de probar una categoría antes de comprometerse?
Las herramientas económicas y de gama media en el nivel sin código suelen ofrecer una demostración o prueba gratuita que le permite subir sus propios documentos y ver los resultados de inmediato — sin llamada de ventas, sin contrato. Esta es la mayor ventaja de los niveles de autoservicio: puede validar si la herramienta funciona con sus documentos en menos de 5 minutos. Las herramientas empresariales requieren una conversación de ventas para acceder a una prueba, y la prueba en sí suele implicar una sesión de configuración guiada. Si no está seguro de qué categoría necesita, comience desde abajo — pruebe primero una herramienta económica. Si hace el trabajo, se ha ahorrado miles. Si no lo hace, las deficiencias que encuentre le dirán exactamente qué funciones necesita del siguiente nivel.
El Mapa No Es el Territorio
El panorama descrito aquí es preciso a mediados de 2026, pero los límites están cambiando. La tecnología que diferenciaba a las plataformas empresariales hace tres años — extracción sin plantilla, reconocimiento de escritura a mano, soporte multilingüe — ahora está disponible en herramientas a una décima parte del precio. La tecnología que las diferenciará dentro de tres años — flujos de trabajo agénticos que realmente reduzcan la revisión humana, razonamiento multimodal que maneje cualquier documento sin configuración — se está construyendo hoy en todas las categorías.
Lo que no cambia es la lógica de coincidencia. La mejor herramienta para una empresa de 3 personas que procesa 200 facturas al mes nunca será la misma que la mejor herramienta para una empresa de 500 personas que procesa 50,000. Las categorías existen porque diferentes organizaciones tienen necesidades estructuralmente diferentes, y ninguna cantidad de progreso en IA cambia eso. Comience con su equipo, su volumen y su flujo de trabajo posterior. La herramienta se deriva de ahí.
Pruebe con sus propios documentos, en su propia categoría, contra sus propios umbrales. Una prueba de 5 minutos con una factura real de su proveedor menos cooperativo le dirá más que todas las matrices de funciones en esta página.