2026年のドキュメント抽出ソフトウェア市場
ランキングではなくマップ
2つのツールがどちらもPDFから請求書データを抽出できるとします。1つは月額$19。もう1つは月額$1,500から始まる営業チームとの商談が必要です。両者は同じクラスのAIを内部で使用しています。75倍の価格差は抽出品質の問題ではなく、まったく異なる組織、異なるチーム構成、異なるボリュームプロファイル、異なる実装複雑性への許容度を想定して構築されているという事実によるものです。価格帯をまたいで機能を比較する前に、どのカテゴリのツールが自分の状況に合っているかを理解せずにベンダー探しを始めているなら、それは評価ではなく推測です。この記事はそのマップを描きます。
重要ポイント
- 100以上のドキュメント抽出ベンダーがすべて99%の精度を主張しています。そして、ImageToTable.aiのような月額$19のツールは、月額$1,500から始まるツールと同じクラスのAIを内部で使用しています。
- 価格帯をまたいで機能を比較することは、購入者が犯す最も高くつくミスです。$19のノーコードツールと$1,500のエンタープライズプラットフォームは、そもそも代替手段として作られたのではなく、異なるチーム構成を持つ異なる組織のために構築されたものです。
- 3つの質問で、ベンダーデモよりも早く正しいカテゴリに自分を位置づけられます:月間のドキュメント数、ツールを運用する担当者、抽出後のデータの扱い方。
カテゴリが機能よりも重要な理由
インテリジェント・ドキュメント処理(IDP)市場は2026年に約32億ドルに達し、どの調査会社に聞くかによって異なりますが、予測される年平均成長率(CAGR)は18〜30%です。Mordor Intelligenceは31.7億ドルと見積もる一方、Fortune Business Insightsは、関連する文書管理サービスを含むより広い範囲で141.6億ドルと報告しています。(この数字の差自体が一つのシグナルです。アナリストによって数える対象が異なり、「文書抽出」というカテゴリ自体の境界線が曖昧なのです。)
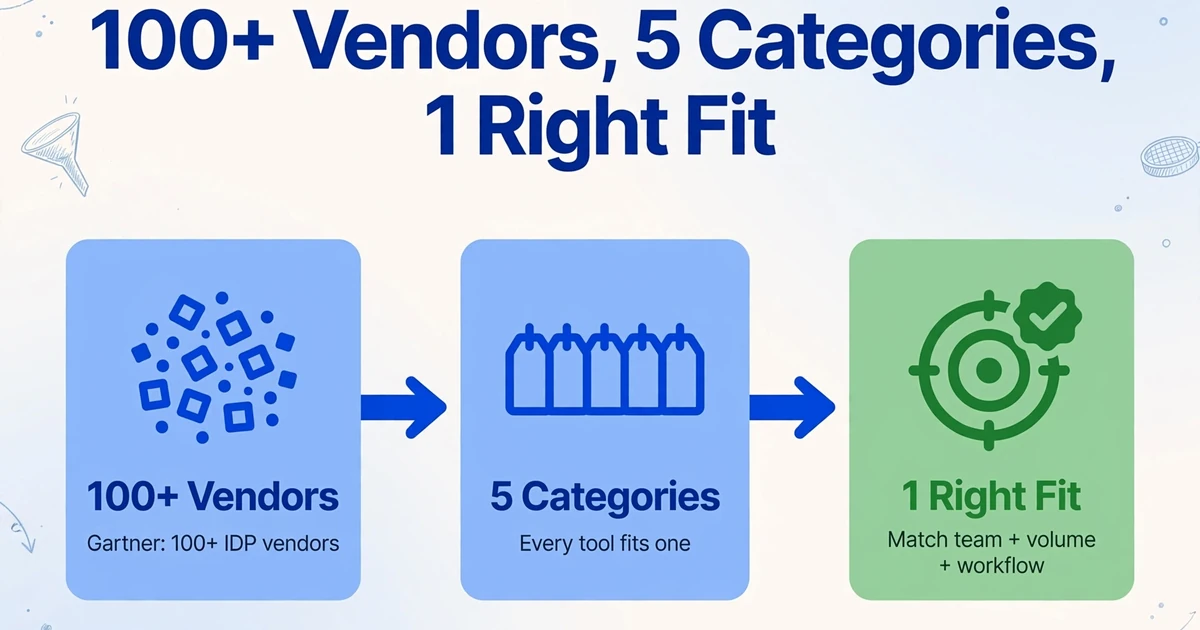
正確な市場規模よりも重要なのは、市場の断片化です。Gartnerの最新のインテリジェント・ドキュメント処理に関するMagic Quadrantでは、クラウドのハイパースケーラーからニッチなスタートアップまで、100以上のベンダーが挙げられています。検索タブを開いたばかりの購入者にとって、その数は圧倒的です。
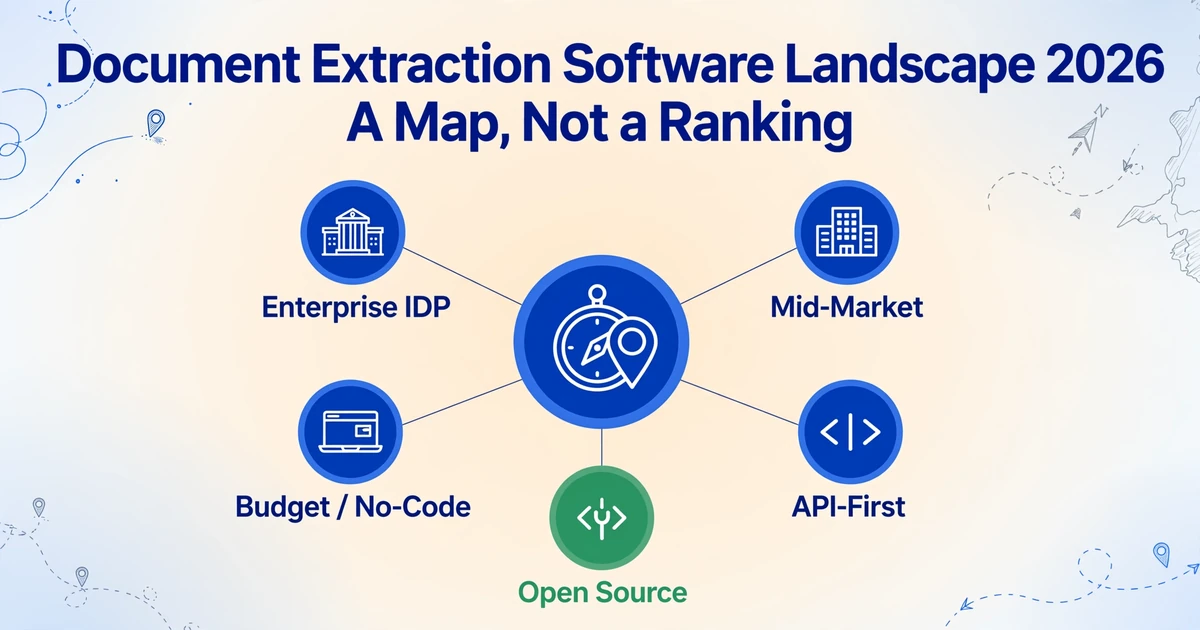
しかし、この断片化はランダムではありません。市場のあらゆるツールは、おおよそ5つのカテゴリのいずれかに分類され、それぞれが同じ3つの質問に対する異なる答えに基づいて構築されています。組織の規模は?月に何件のドキュメントが処理されるか?ツールを操作するのは誰か — エンジニア、経理担当者、それとも両方か?
これらのカテゴリは品質の階層ではありません。月額19ドルの予算向けツールは、月額1,500ドルのエンタープライズ向けプラットフォームの「劣った」バージョンではなく、異なるユースケースに最適化された異なるアーキテクチャです。購入者に最も大きなコストをもたらす間違いは、カテゴリ内で間違ったツールを選ぶことではありません。カテゴリ自体を間違えて選び、その後何ヶ月もツールを適合させようと費やすことです。
ツールを比較する前に
チームの規模、月間ボリューム、技術スキルに合わせて作られたカテゴリを把握しましょう。カテゴリの不一致は、文書抽出ソフトウェア選定において最も高くつくミスであり、機能比較表からは見えません。
5つのカテゴリーの概要
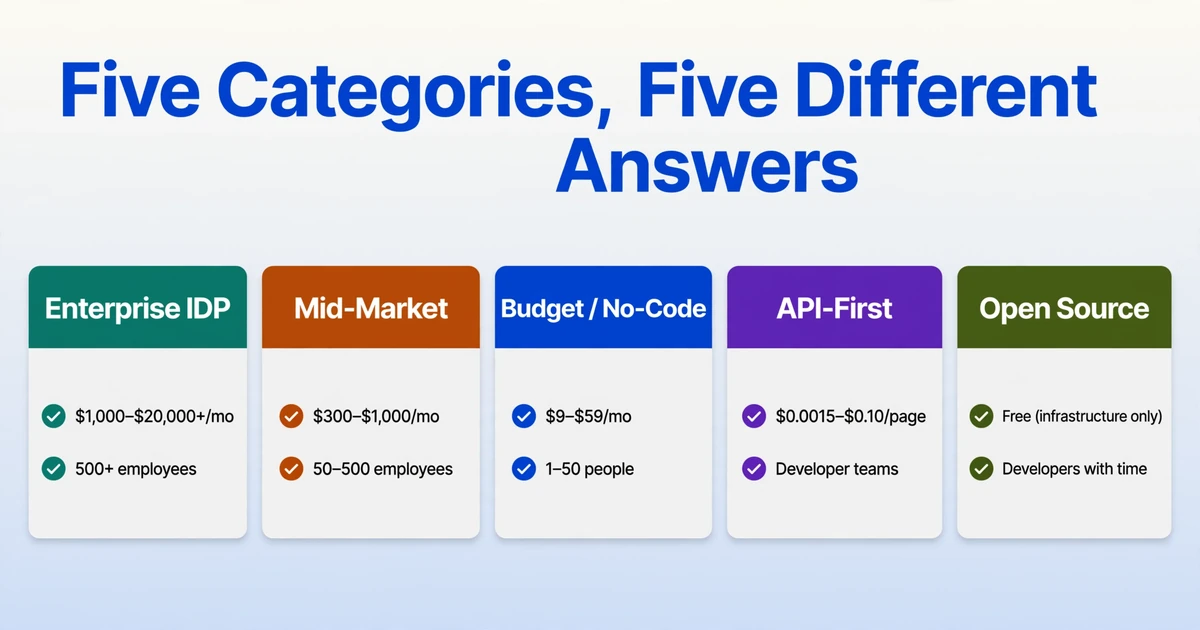
ここでは、全体像を1つの表にまとめました。各カテゴリーは「誰のためのものか、コストはいくらか、何と引き換えに何を得るのか」という問いに対する異なる答えです。この記事の残りの部分では、それぞれを詳しく説明します。
| カテゴリー | 対象者 | 一般的な価格帯 | 主なトレードオフ | 例 |
|---|---|---|---|---|
| エンタープライズIDP | 従業員500人以上の組織、専任IT部門、コンプライアンス要件 | $1,000~$20,000以上/月 | 最大の性能と、最大の導入負荷 | ABBYY Vantage、Hyperscience、Rossum、UiPath IXP |
| ミッドマーケット特化型 | 従業員50~500人、経理・業務チーム、中程度の処理量 | $300~$1,000/月 | 妥当なコストで高い精度を実現する一方、ワークフロー対応範囲は限定的 | Nanonets、Docsumo、Affinda、Docparser |
| 低価格 / ノーコード | 1~50人、ITサポートなし、迅速なセットアップが必要な場合 | $9~$59/月 | 最速の導入、最低コスト、ただし抽出専用ワークフローに限定 | ImageToTable.ai、Airparser、Parseur、Parsio |
| APIファースト / クラウドネイティブ | 自社製品に抽出機能を組み込む開発者チーム | ページ単位($0.0015~$0.10/ページ) | パイプラインを完全に制御できるが、エンジニアリング投資が必要 | Google Document AI、Amazon Textract、Azure Document Intelligence |
| オープンソース | 時間のある開発者、データを完全に管理したいチーム | 無料(インフラ費用のみ) | ライセンス費用ゼロ、最大のエンジニアリング負担 | Tesseract、PaddleOCR、docTR |
エンタープライズIDPプラットフォーム:規模が大きくなるとフルスイートが必要になる理由
エンタープライズIDPプラットフォームは、ほとんどの購入検討者が最初に目にするカテゴリです。なぜなら、最も大きなマーケティング予算と長い販売実績を持つからです。この層のツール(ABBYY Vantage、Hyperscience、UiPathのIntelligent Document Processing、Rossumのエンタープライズ向け製品)は、複数の部門にわたって毎月数万件の文書を処理し、専任のITスタッフ、正式な調達プロセス、監査証跡を必要とするコンプライアンス要件を備えた組織向けに構築されています。
購入するもの: エンドツーエンドの文書処理プラットフォームです。抽出はその1つのモジュールに過ぎません。プラットフォームには、文書分類(到着した文書の種類を自動的に識別)、検証ルール、信頼度ベースのルーティング(信頼度の高い結果はそのまま通過し、低い結果は人によるレビューキューに送られる)、ERP/CRM統合コネクタ、ロールベースのアクセス制御も含まれます。ABBYYやRossumがエンタープライズに販売するとき、彼らが売っているのは抽出ではなく、文書の運用レイヤーです。
実際のコスト: Rossumのスタータープランは年間約$18,000から始まります。Nanonetsのエンタープライズ層は月額$999からで、ボリュームに応じてスケールします。ABBYYは価格を一切公開していません。しかし、ライセンス費用は通常、2つの費用のうち小さい方です。導入(文書タイプの設定、モデルのトレーニング、既存システムとの統合、スタッフのトレーニング)は通常3〜12ヶ月かかり、初年度のライセンス費用よりも高額になります。IDP導入に関するForresterのレポートは、導入の複雑さを過小評価する購入検討者は「パイロット段階の精度率は有望に見えるが、数ヶ月の調整なしには本番環境に移行できないことが多い」と指摘しています。
トレードオフ: 最も包括的な文書自動化スタックを手に入れられます。同時に、最も重い導入負担も背負うことになります。組織が実際に複数の文書タイプにわたって毎月10,000件以上の文書を処理し、デプロイメントを管理するITチームを持っているなら、その重い負担は自動化密度という形で報われます。1つのプラットフォームがメールルームでの取り込みからERPへの転記まで、すべてを処理します。毎月300件の請求書を処理し、IT部門がない場合は、決して使うことのないインフラの複雑さと、忍耐力を超えてしまうデプロイメント期間に対して費用を払っていることになります。
エンタープライズプラットフォームはまた、手書き文字と複雑なテーブル構造に最も強い傾向があります。特にHyperscienceは、政府機関や医療保険者向けの手書き文書処理でその評判を築きました。文書構成に手書きフォームがかなりの割合を占める場合、エンタープライズ層はそれらをきれいに処理できる精度を持つ唯一のカテゴリかもしれません。
中堅市場向け特化ツール:無駄のない高機能
中堅市場向けツールは月額300〜1,000ドルの範囲に位置し、中小規模の組織にとってエンタープライズプラットフォームが生み出す問題(ツールが多すぎる、コストが高すぎる、導入が複雑すぎる)を解決します。Nanonets、Docsumo、Affinda、Docparserがこの分野で最も有名な名前です。これらはオールインワンプラットフォームを目指すのではなく、抽出をうまく行うことに注力し、ダウンストリームのワークフローは既存のツールで処理できるようにします。
エンタープライズ版との違い:テンプレート不要で可変レイアウトを処理するAI搭載の抽出機能を利用できます。これはエンタープライズ層と同じ基盤技術です。ただし、完全なワークフロー自動化スタック(承認ルーティングの組み込み、ERPコネクタライブラリ、コンプライアンス監査用のロールベースのアクセス制御)は含まれません。これらのツールは、そうした機能を処理するシステムが既に存在し、データをフィードするための抽出だけが必要であることを前提としています。
最適な用途:毎月2,000〜5,000件の文書を処理する中規模の会計事務所。手動入力が本当にコスト高になるほどの量でありながら、6ヶ月かかるエンタープライズ導入を正当化するほどではない規模です。DocparserのゾーンOCRアプローチは、文書レイアウトが一貫している組織(毎月同じサプライヤー、同じフォーム)に適しています。NanonetsとDocsumoはディープラーニングモデルを使用してバリエーションをより適切に処理します。これは、50以上の異なる取引先から、同じ形式のものが2つとない文書が届く場合に役立ちます。
トレードオフ:高頻度で反復的な文書タイプにおいて、低予算ツールよりも精度が高く、エンタープライズ価格のほんの一部で利用できます。ただし、カスタマイズには限界があります。抽出データをERPと照合するカスタム検証ルールを追加したい場合、それはエンタープライズの領域です。中堅市場層は抽出を徹底的にカバーしますが、「抽出後の処理」はユーザーに委ねられます。
この層の多くの購入者は、APIファーストかノーコードかを決定する必要もあります。一部の中堅市場向けツールは両方のパスを提供しており、統合を構築できる開発者がいるか、ブラウザインターフェースですべてを操作する必要があるかによって選択が異なります。
低予算/ノーコードツール:セルフサービス層
ここが、この2年間で最も急速に変化した分野です。ImageToTable.ai、Airparser、Parseur、Parsioなどのツールは、月額9〜59ドルの価格帯で提供されています。これらは特定の購入者を想定して作られています。つまり、今日ドキュメントからデータを抽出する必要があり、調達サイクルを待てず、統合を構築する開発者もいない人です。ワークフロー全体がブラウザ上で完結します。
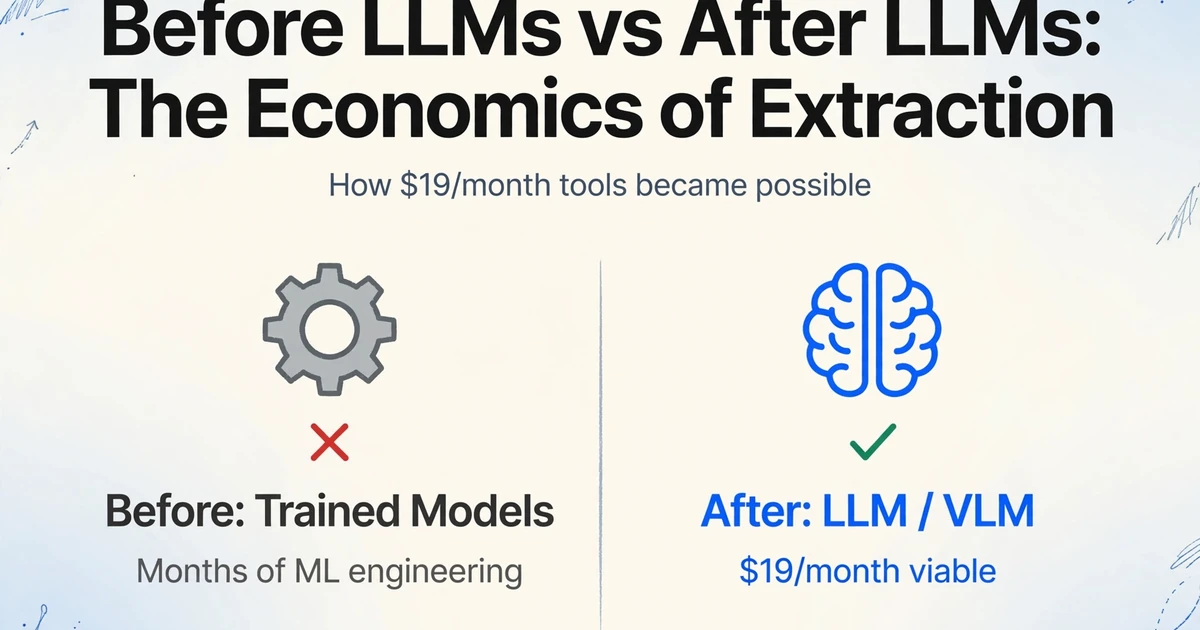
このカテゴリーを実現可能にした技術的転換:2年前には、月額19ドルの抽出ツールは存在し得ませんでした。なぜなら、まともな精度を得る唯一の方法はトレーニング済みモデルを使うことであり、モデルのトレーニングには(a)数か月にわたる機械学習エンジニアリング、または(b)それを既に実現しているエンタープライズベンダーに支払うこと、のいずれかが必要だったからです。大規模言語モデル(LLM)と視覚言語モデル(VLM)の登場が、この経済性を変えました。これらのツールは、ドキュメントタイプごとにモデルをトレーニングする代わりに、ドキュメントをLLMまたはVLMに送信し、人間が読むのと同じように、つまりフィールドがページ上のどこにあるかではなく、フィールドが何を意味するかを理解することで、ドキュメントを読み取ります。このアプローチのドキュメントあたりのコストは、月額19ドルのプランで月数百ページを処理することを可能にするほど低下しました。
実際の仕組み:PDF、JPG、またはスクリーンショットをアップロードします。取得したいフィールド名を入力します(例:「請求書番号、ベンダー名、合計、支払期日」)。AIは、座標ではなくセマンティクスを理解することで、ページ上のどこからでも各値を見つけ出します。ImageToTable.aiでは、これをカスタム列抽出と呼びます。入力した列名が、出力スプレッドシートのヘッダーになります。50件の請求書を一度に処理する必要がありますか?それらをバッチとしてアップロードすると、1つの結合されたExcelファイルが得られます。各請求書は、指定した列を持つ1行になります。さらに、抽出中に計算を実行する計算列を定義することもできます(例:「明細合計(数量×単価)」)。これにより、ダウンロードするスプレッドシートには生データだけでなく、答えが含まれます。
この層のほとんどのツールは、コレクションリンク機能も提供しています。共有可能なURLを生成し、クライアントやチームメンバーに送信すると、彼らがアップロードしたドキュメントが直接あなたの処理キューに届きます。相手側の登録は不要です。
トレードオフ:このカテゴリーは、市場で最も速い「初回結果までの時間」を提供します。ページにアクセスしてからスプレッドシートをダウンロードするまで、多くの場合2分未満です。トレードオフは、ワークフロープラットフォームではなく抽出機能を提供しているという点です。自動ERP転記、承認ルーティング、またはきめ細かいロールベースの権限を持つ人間によるレビューキューが必要な場合は、より上位のカテゴリーのツールが必要です。低予算ツールは抽出ステップを非常にうまく処理しますが、その前後で発生することを自動化するわけではありません。
予算ツールが勝つとき
3人規模の会計事務所が毎月200件のクライアント請求書を処理しています。エンタープライズ向けIDPプラットフォームのコストは、それらのクライアントからの月間収益の12倍以上になります。月額19ドルの予算ツールは、同じクラスのAIを使用して同じ請求書から同じフィールドを抽出します。そして会計士はアップロードから45秒後にはExcelで作業しています。欠けているのは抽出品質ではなく、そもそも必要なかったワークフロー自動化です。
APIファースト/クラウドネイティブ:独自パイプラインの構築
Google Document AI、Amazon Textract、Azure Document Intelligenceは、まったく異なるカテゴリに属します。これらはツールではなく、インフラストラクチャの構成要素です。ダッシュボードにログインしてファイルをアップロードするのではありません。ドキュメントをRESTエンドポイントに送信し、構造化されたJSONを受け取るコードを書くのです。価格はページ単位(プロセッサに応じて0.0015ドルから0.10ドル)で、エンジニアリングチームが抽出ステップを中心にパイプライン全体を構築することが前提です。
対象者:文書抽出を自社製品に組み込むSaaS企業。既存のクラウドインフラを持つエンタープライズ開発チームで、自動化チェーンの一部として抽出が必要な場合。ページ単位の価格がシート単位のSaaSより安いボリュームで文書を処理する組織 — 月5万ページを処理する場合、Textractの1ページあたり0.015ドル(合計750ドル)は、月額1,500ドルのエンタープライズプラットフォームより大幅に安くなります。ただし、周辺インフラを構築するエンジニアリングチームがいることが前提です。
クラウドプロバイダーの強み:Google Document AIの請求書、領収書、身分証明書向けの事前トレーニング済みプロセッサは本当に優れています。Amazon Textractのテーブル抽出は、多くのサードパーティツールを壊す複雑なレイアウトを処理します。AzureのDocument Intelligenceは、多くの企業がすでに利用しているMicrosoft 365およびPower Platformエコシステムと自然に統合されます。
ギャップ:これらは抽出APIであり、文書処理ソリューションではありません。分類、検証、例外処理、人間によるレビュー — これらはすべて構築する必要があります。Google、Amazon、Microsoftはエンジンを提供しますが、車はあなたが用意します。Redditで文書抽出プラットフォームの構築について説明した開発者は、簡潔にこう述べています。「文書抽出は、完璧なモデルを1つ見つけることよりも、何千もの異なる文書バリエーションを処理できるシステムを構築することに重点が置かれています。」APIが提供するのは最初のステップ — 抽出 — であり、システム全体ではありません。
構築か購入かを検討しているチーム向けに、開発者時間、インフラ、メンテナンス、API価格を含む完全なコスト内訳は、構築と購入の分析で詳しく説明しています。要約すると、文書抽出が製品そのものであり、オーバーヘッドではない場合に構築が理にかなっています。
オープンソース:無料だが子犬のようなもの
Tesseract — 1980年代にHPで開発され、現在はGoogleが保守している — は、地球上で最も広く導入されているOCRエンジンであり続けています。BaiduのPaddleOCRは、2023年以降、強力な多言語サポート(100以上の言語)とテーブル認識機能により、大きな注目を集めています。PyTorchとTensorFlow上に構築されたdocTRは、エンドツーエンドで学習可能な検出と認識を備えた、よりモダンなアーキテクチャを提供します。
これらのツールは無料です。ライセンス費用はかかりません。しかし、オープンソースのOCRは文書抽出ではありません — それは文字認識です。Tesseractはページ上のテキストを教えてくれます。しかし、どの文字列が請求書番号で、どの文字列がPO参照であるかを教えてくれるわけではありません。その分類、抽出、構造化のロジックはあなたが構築するものであり、そこに実際のコストがかかります。
オープンソースが機能する場合:コンピュータビジョンを理解する開発者がいて、厳密に固定されたレイアウト(毎回同じフォーム、同じ座標)の文書を処理しており、そのボリュームが構築コストを正当化する場合です。特にPaddleOCRは強力なテーブル認識パイプラインを持ち、カスタム後処理と組み合わせることで、構造化された表形式の文書において商用ツールに匹敵することができます — RedditのOCRコミュニティの開発者たちが新しいモデルとベンチマーク比較し、本番利用においてオープンソースの選択肢の中で最も信頼性が高いと評価していることからも明らかです。
機能しない場合:取引先ごとに文書のレイアウトが異なる場合。テキスト出力だけでなく、フィールドレベルの抽出が必要な場合。コンピュータビジョンエンジニアが社内にいない場合。これらの条件下では、「無料」のツールは、年間の予算SaaSサブスクリプション費用よりも多くのエンジニアリング時間を費やすことになります。
2025年から2026年に変わったこと:市場を再形成する3つのトレンド
ベンダー環境は静止していません。上記で説明したカテゴリ境界を積極的に書き換える3つの構造的変化があります。
1. LLMとVLMがテンプレートベースの抽出を置き換えつつある——今度こそ本物だ
20年にわたり、文書抽出の主流アプローチはテンプレートマッチングだった。請求書番号フィールドの周りにボックスを描き、「値はここにある」とソフトウェアに指示し、次の請求書も同じ場所に配置されることを期待する方法だ。機械学習はラベル付きの例からパターンを学習することでこれをわずかに改善したが、一貫したレイアウトへの根本的な依存は続いた。ForresterのVP兼プリンシパルアナリストであるBoris Evelson氏は、Document Mining and Analytics Platforms Landscape Q4 2025で、生成AIとエージェント型AIを、ルールベースおよびテンプレートベースのアーキテクチャにおける「ベンダーの差別化に挑戦するイコライザー」と表現している。
この変化は漸進的なものではなく、構造的なものだ。視覚言語モデル(VLM)は座標(x: 342, y: 891)でフィールドを探すわけではない。文書を全体として読み、「このページの合計金額はいくらか」という質問に、「合計」というラベルとその隣の数字の関係を理解することで答える——どちらがどこに現れるかに関係なく。これは人間の読者が使うのと同じアプローチであり、あらゆるカテゴリのツールが2025年から2026年にかけて「テンプレート不要」をマーケティングに追加してきた理由でもある。
実際の効果はこうだ。文書フォーマットの80%しか処理できなかったツールが、95%以上を処理できるようになった。「レイアウトが変わった」という失敗モードが、もはや失敗モードではなくなったからだ。
2. エージェント型文書処理:抽出で終わらない抽出
「エージェント型」という言葉は大いに誇張されてきた——そして、何が本物で何がマーケティングなのかについては後ほど取り上げる——が、核となるアイデアは本物だ。従来のインテリジェント・ドキュメント処理(IDP)はこうだ:文書を入力し、JSONを出力する。エージェント型文書処理はこうだ:文書を入力すると、AIがマルチステップのワークフローを計画し、データを抽出し、既知のルールに照らして検証し、他の文書のデータと相互参照し、そして行動する——エンタープライズ・リソース・プランニング(ERP)への投稿、承認のトリガー、異常のフラグ付けなどだ。
Kognitosは、エージェント型データ抽出を、「自律型AIエージェントがマルチステップのワークフローを計画し、曖昧なコンテンツについて反復的に推論し、これまで見たことのないフォーマットに適応し、自身の出力を検証し、抽出した内容に基づいてますます行動を起こす」システムと定義している。キーワードは反復的だ。曖昧なフィールドに遭遇したエージェント型システムは推測しない——文書を読み直し、コンテキストを確認し、それでも不確かな場合は、特定のフィールドに関する具体的な質問とともに人間にエスカレーションする。
IDCの並行するWorldwide IDP Software Forecastは、この市場が年平均成長率(CAGR)29.6%で成長すると予測しており、「主に文書自動化におけるエージェント型および生成AI機能の採用によって牽引される」としている。その軌道は本物だが、現状は一様ではない。Deloitteの2025年Emerging Technology Trends調査によると、組織の38%がエージェント型AIをパイロット導入している一方で、本番環境でエージェントを積極的に稼働させているのはわずか11%だ。
3. マルチモーダルモデル:文書はもはやテキストだけではない
3つ目のトレンドは最も静かですが、最も影響力があるかもしれません。初期世代の抽出ツールは、文書をたまたま画像上にあるテキストとして扱っていました。つまり、まずOCR、次にNLPという順序です。このパイプラインは、視覚的なレイアウトが重要となる場合(チェックボックス内のチェックマーク、印刷された日付の横にある手書きの署名、レポートに埋め込まれた写真など)に機能しなくなりました。
視覚言語モデル(VLM)は、OCRからNLPへのパイプラインを単一のステップに統合します。文書を視覚入力(抽出されたテキストではなくピクセル)として処理し、それについて直接推論します。VLMは、「承認」ボックスにチェックが入っているかどうかを、近くのテキストから推測するのではなく、ボックスを見て答えることができます。また、印刷された請求書の余白にある手書きのメモを、別途手書き認識パスを実行することなく読み取ることができます。
これは、カテゴリ間の境界線を曖昧にしているため、業界にとって重要です。VLMバックエンドを使用する月額19ドルの予算ツールが、3年前なら専用の手書きモデルを備えたエンタープライズプラットフォームを必要としていた文書タイプを処理できるようになりました。かつて価格帯を差別化していた技術が下位層に浸透しているのです。つまり、カテゴリ間の真の差別化は、抽出精度からワークフロー、統合、サポートへと移行しています。
誇張されたものと現実的なもの:シグナルとノイズを区別する
2026年のすべてのベンダーウェブサイトは、ホームページに「AI搭載」、「エージェント型」、「テンプレート不要」を追加しています。ここでは、実際に起こっていることと、マーケティング上の主張を比較します。
| 主張 | 実際のところ | 誇張されている点 |
|---|---|---|
| 「99%の精度」 | クリーンで高解像度のデジタルテキストに対する文字レベルのOCR精度は、最新のツールでは確かに99%以上です。 | スキャン、傾き、スタンプ、多言語が混在する実在のドキュメントに対するフィールドレベルの抽出精度は、95%を超えることは稀です。ほとんどの「99%」という主張は、間違ったものを測定しています。請求書の合計金額が正しい必要がある場合、文字精度は無関係であり、フィールド精度がすべてです。 |
| 「テンプレート不要の抽出」 | LLMおよびVLMベースのツールは、ドキュメントタイプごとの設定なしで可変レイアウトを実際に処理します。これは2026年において実用的な技術であり、複数の価格帯のツールで利用可能です。 | 「テンプレート不要」は「ゼロ設定」を意味しません。抽出するフィールドをツールに指示する必要は依然としてあります。革新性は、フィールドを空間的に(「x:342、y:891のボックス」)ではなく、意味的に(「支払期日」)記述できることです。ツールが、必要なデータを推測してくれるわけではありません。 |
| 「エージェント型AI」 | マルチステップ推論、自己検証、適応型抽出は、管理された環境では機能しています。特に、検証ルールが明確に定義されている請求書処理で顕著です。 | Deloitteのデータによると、エージェントを本番導入している組織はわずか11%です。2026年のほとんどの「エージェント型」機能は、検証チェックを伴う単一ステップの抽出であり、有用ではありますが、マーケティングが示唆するような自律的なドキュメント運用レイヤーではありません。 |
| 「トレーニング不要」 | LLMを搭載したツールは、ラベル付けされたトレーニングデータなしで、一般的なドキュメントタイプに対してすぐに機能します。これは、2018年から2024年にかけてのMLベースのツール世代からの真の改善です。 | エッジケース(特殊なテーブル構造、多言語混在ドキュメント、スタンプやFAXが多用されたページ)では依然として設定が有効であり、エンタープライズ導入では、特定のドキュメント構成に合わせた調整に依然としてかなりの時間を費やしています。 |
ベンダーから得られる最も正直なシグナルは、ホームページにはありません。価格ページにあります。数字が営業担当者に相談せずに表示されている場合、そのツールはセルフサービス購入者向けに作られています。すべてのプランが「営業に問い合わせ」と表示されている場合、そのツールはエンタープライズ調達サイクル向けに作られており、実装スケジュール、サポートモデル、契約の複雑さのすべてがそれを反映しています。
このランドスケープを検索絞り込みに活用する方法
5つのカテゴリーをご覧いただきました。それらを再形成するトレンドもご覧いただきました。では、あなたはどのカテゴリーから始めるべきでしょうか?3つの質問で、機能比較マトリクスよりも速く絞り込めます。
月あたりの文書数は?
500件未満:予算重視・ノーコードツールで問題なく処理できます。500〜5,000件:ミッドマーケットツールは、スケール時の精度が高く、基本的なワークフロー機能を備えていることが多いです。5,000件以上:エンタープライズIDPまたはAPIファースト—予算重視ツールの文書あたりのコスト構造は崩れ始め、エンタープライズプラットフォームの統合の深さが効果を発揮し始めます。
誰が運用しますか?
開発者がいない場合:ノーコードまたはミッドマーケット層に留まります—これらは非技術系ユーザーによるブラウザベースの運用向けに設計されています。開発者が1〜2名いる場合:APIファーストが現実的になり、Google Document AIやTextractを中心としたパイプライン構築を検討できます。完全なエンジニアチームがいる場合:オープンソースまたはAPIファースト。ただし「無料」はエンジニアリング時間を意味することを理解しておきましょう。
抽出後のデータはどうなりますか?
手動で確認するスプレッドシートに入る場合:予算重視層で十分です。ERPに自動投稿し、下流のワークフローをトリガーする必要がある場合:統合コネクタを備えたミッドマーケットまたはエンタープライズツールが必要です。自社のSaaS製品にフィードされる場合:APIファーストのみが理にかなったアーキテクチャです—抽出を埋め込むのであって、使用するのではないからです。
これら3つの質問に含まれていないものに注目してください:機能数、精度パーセンテージ、ベンダーのデモ動画です。これらは選択したカテゴリー内で重要です。しかし、先にカテゴリーの質問に答えていなければ、そもそも競合するはずのないツール同士を比較していることになります。
カテゴリーを特定したら、次のステップは具体的なツールの評価です。6次元評価ガイドのフレームワークでは、何をテストすべきか、どうテストすべきか、そしていつ十分にテストしたかを判断する方法を説明しています—3ヶ月のパイロット契約なしで。
まだ本当に初歩の段階—データ抽出ソフトウェアがそもそも何なのか分からない—という場合は、カテゴリー選択に飛び込む前に、初心者向け入門ガイドから始めてください。
よくある質問
自分が間違ったカテゴリにいるかどうかはどうすればわかりますか?
最も確実な兆候は、使っていない機能にお金を払っているか、ツールに含まれるべき機能を自分で作っているかです。エンタープライズプランなのにワークフロー自動化モジュールに一度も触れたことがなければ、カテゴリを超えています。予算プランで、データをERPに送るために毎時ツールのAPIを呼び出すPythonスクリプトを自作しているなら、そのカテゴリを超えています。カテゴリの適合性は、支払った機能に対する使用機能の比率、そして不足している機能が、次の上位プランの購読料よりも多くの回避策コストを生んでいないかどうかで決まります。
すべてのカテゴリで機能するツールはありますか?
5つのカテゴリすべてをうまくカバーする単一のツールはありません。隣接する2つのカテゴリを橋渡しする複数のプランを提供するツールもあります。例えばNanonetsは、ミッドマーケット向けセルフサービスプランと、ワークフロー自動化を備えたエンタープライズプランの両方を提供しています。しかし、同じ基盤ツールが、月に100枚のレシートをアップロードする個人の簿記担当者と、50,000件のPOを処理する調達部門の両方に同時に最適化されることはありません。一方のユースケースに適したアーキテクチャ、サポート体制、価格体系は、もう一方には積極的に不利に働きます。
月ごとに処理量が変動する場合はどうすればよいですか?
予算プランとミッドマーケットプランのいくつかのツールは、固定の月間ページ割り当てよりも変動にうまく対応できる、従量課金制またはクレジットベースの価格設定を提供しています。ImageToTable.ai、Airparser、Parseurは、容量を予約するのではなく処理した分だけ支払う使用量ベースのモデルで運営されています。処理量が常に予測できない場合は、ハードなページ上限があるツールは避けてください。超過料金はすぐに膨らみ、割引のために結んだ年間契約が制約になります。
これらのツールは手書き文書を扱えますか?
エンタープライズプラットフォーム、特にHyperscienceやABBYYは、手書きの請求書フォーム、医療記録、政府文書を長年にわたって処理してきた実績があり、最も強力な手書き認識機能を備えています。予算向けおよびミッドマーケット向けツールでは、手書きサポートは大きく異なります。視覚言語モデル(VLM)を使用するツール(ImageToTable.aiを含む)は、文脈上の明確な手書き文字(例えば、印刷されたラベルの横にある手書きの合計金額)を読むことができますが、密集した筆記体の段落は、すべてのカテゴリにわたって依然として困難です。文書の大部分が手書きである場合は、ツールを決定する前に、実際の文書で手書き認識精度をテストしてください。ベンダーの主張を、自社のサンプルで検証せずに信頼しないでください。
カテゴリを決定する前に、最速でテストする方法は?
ノーコード層の予算向けおよびミッドマーケット向けツールは、通常、無料デモまたはトライアルを提供しており、自分の文書をアップロードしてすぐに結果を確認できます。営業担当者との面談や契約は不要です。これはセルフサービス層の最大の利点であり、ツールがあなたの文書で機能するかどうかを5分以内で検証できます。エンタープライズツールは、トライアルにアクセスするために営業担当者との会話が必要であり、トライアル自体にもガイド付きセットアップセッションが含まれることがよくあります。どのカテゴリが必要かわからない場合は、まず低い層から始めてください。まず予算向けツールをテストします。それが機能すれば、数千ドルを節約できます。機能しない場合は、そのギャップが、次の上位層から必要な機能を正確に教えてくれます。
地図は領土そのものではない
ここで説明されている状況は2026年半ば時点の正確なものですが、境界線は移り変わっています。3年前にエンタープライズプラットフォームを差別化していた技術(テンプレート不要の抽出、手書き認識、多言語サポート)は、現在では10分の1の価格のツールで利用可能です。3年後にそれらを差別化するであろう技術(人間によるレビューを真に削減するエージェント型ワークフロー、設定なしで任意の文書を処理するマルチモーダル推論)は、現在、あらゆるカテゴリで構築されています。
変わらないのは、マッチングのロジックです。月200件の請求書を処理する3人規模の会社に最適なツールが、月50,000件を処理する500人規模の会社に最適なツールと同じになることは決してありません。カテゴリが存在するのは、組織によって構造的にニーズが異なるためであり、AIの進歩によってそれが変わることはありません。まず、自社のチーム、処理量、およびダウンストリームのワークフローから始めてください。ツールはそこから決まります。
自分の文書、自分のカテゴリ、自分の基準でテストしてください。最も協力的でないサプライヤーからの実際の請求書を使った5分間のテストは、このページのすべての機能比較表よりも多くのことを教えてくれます。