Landschaft der Dokumentextraktions-Software 2026
Eine Karte, kein Ranking
Zwei Tools können beide Rechnungsdaten aus einer PDF extrahieren. Das eine kostet 19 $ pro Monat. Das andere erfordert ein Gespräch mit einem Vertriebsteam, das bei 1.500 $ pro Monat beginnt. Sie verwenden dieselbe Klasse von KI im Hintergrund. Die 75-fache Preisdifferenz liegt nicht an der Extraktionsqualität – sondern daran, dass sie für völlig unterschiedliche Organisationen entwickelt wurden, mit unterschiedlichen Teamstrukturen, unterschiedlichen Volumenprofilen und unterschiedlicher Toleranz für Implementierungskomplexität. Wenn Sie Ihre Anbietersuche starten und Funktionen über Preisklassen hinweg vergleichen, ohne zuerst zu verstehen, welche Tool-Kategorie für Ihre Situation gebaut wurde, bewerten Sie nicht – Sie raten. Dieser Artikel zeichnet die Karte.
Wichtigste Erkenntnisse
- Über 100 Anbieter für Dokumentextraktion behaupten alle 99 % Genauigkeit – und ein Tool wie ImageToTable.ai für 19 $/Monat verwendet dieselbe Klasse von KI im Hintergrund wie diejenigen, die bei 1.500 $ beginnen.
- Funktionen über Preisklassen hinweg zu vergleichen ist der teuerste Fehler, den Käufer machen – ein No-Code-Tool für 19 $ und eine Enterprise-Plattform für 1.500 $ waren nie als Alternativen gedacht, sie wurden für unterschiedliche Organisationen mit unterschiedlichen Teamstrukturen entwickelt.
- Drei Fragen ordnen Sie schneller in die richtige Kategorie ein als jede Anbieter-Demo: Wie viele Dokumente pro Monat, wer bedient das Tool und was passiert mit den Daten nach der Extraktion?
Warum die Kategorie wichtiger ist als die Funktionen
Der Markt für intelligente Dokumentenverarbeitung erreichte 2026 rund 3,2 Milliarden US-Dollar, mit einem prognostizierten Wachstum von 18–30 % CAGR, je nachdem, welchen Analysten man fragt — Mordor Intelligence beziffert ihn auf 3,17 Milliarden US-Dollar, während Fortune Business Insights 14,16 Milliarden US-Dollar unter einer breiteren Abgrenzung angibt, die angrenzende Dokumentenmanagement-Dienste einschließt. (Die Spanne zwischen diesen Zahlen ist selbst ein Signal: Verschiedene Analysten zählen verschiedene Dinge, und „Dokumentenextraktion“ als Kategorie hat unscharfe Ränder.)
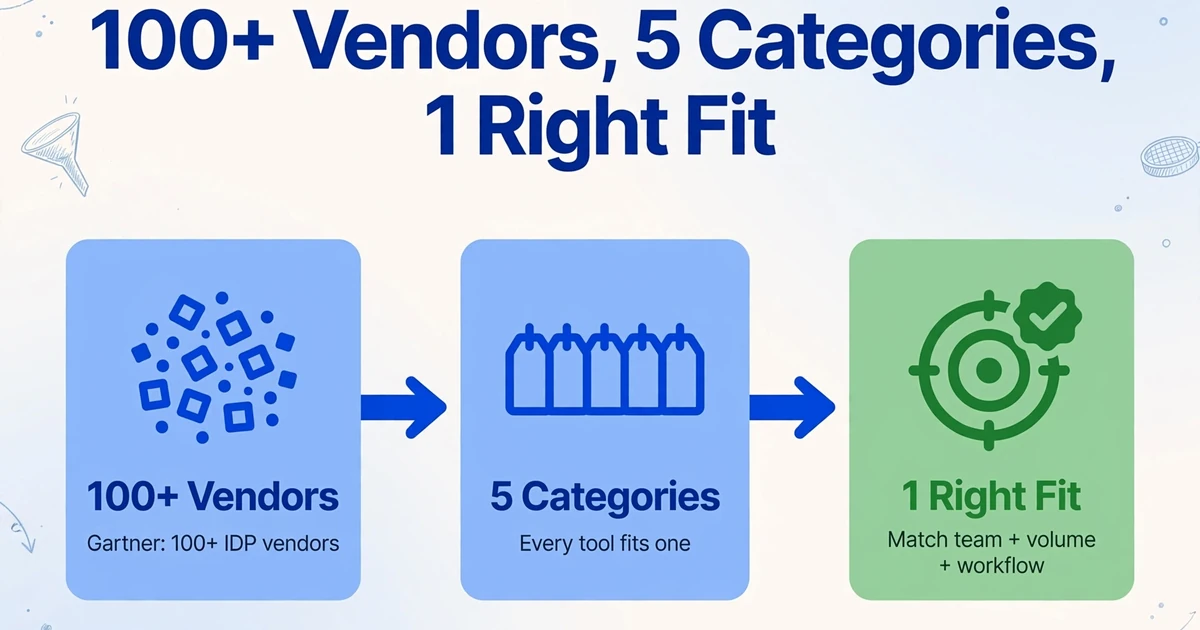
Wichtiger als die genaue Marktgröße ist die Zersplitterung. Gartners jüngster Magic Quadrant für Intelligent Document Processing nennt über 100 Anbieter — von Cloud-Hyperscalern bis zu Nischen-Startups. Für einen Käufer, der gerade einen Suchtab geöffnet hat, ist diese Zahl lähmend.
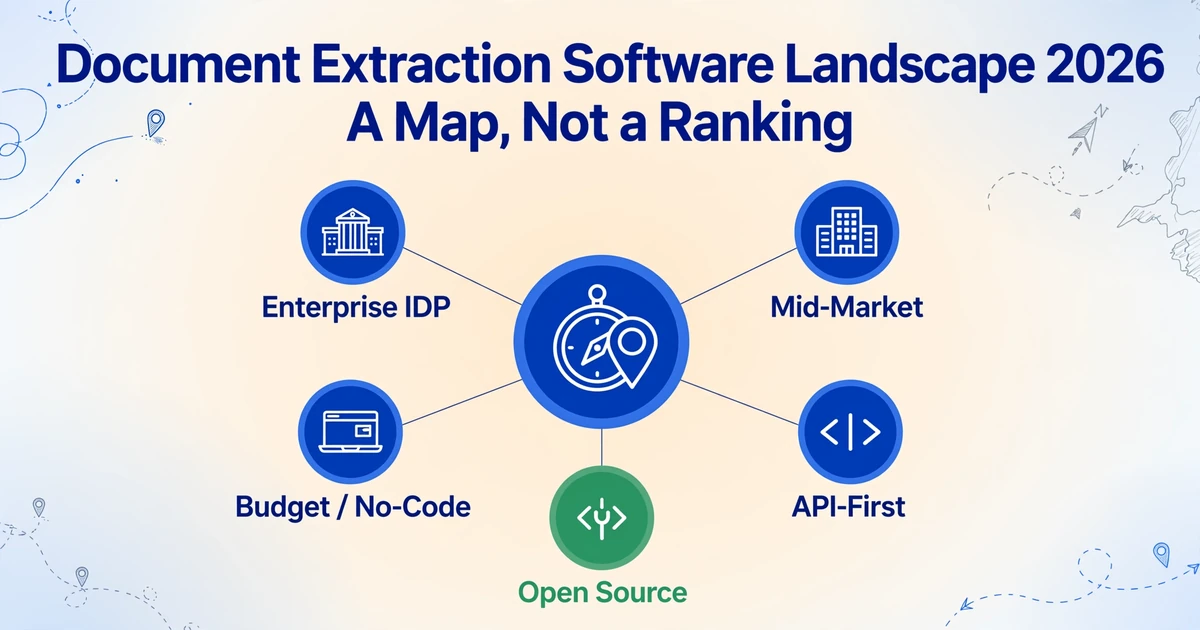
Aber die Zersplitterung ist nicht zufällig. Jedes Tool auf dem Markt fällt in eine von ungefähr fünf Kategorien, die jeweils um eine andere Antwort auf dieselben drei Fragen herum aufgebaut sind: Wie groß ist das Unternehmen? Wie viele Dokumente laufen pro Monat durch? Wer wird das Tool bedienen — ein Ingenieur, ein Buchhalter oder beide?
Die Kategorien sind keine Qualitätsstufen. Ein Budget-Tool für 19 $/Monat ist keine „schlechtere“ Version einer Enterprise-Plattform für 1.500 $/Monat — es ist eine andere Architektur, optimiert für einen anderen Anwendungsfall. Der Fehler, der Käufer am teuersten zu stehen kommt, ist nicht die Wahl des falschen Tools innerhalb einer Kategorie. Es ist die Wahl der falschen Kategorie insgesamt — und dann Monate damit zu verbringen, das Tool passend zu machen.
Bevor Sie Tools vergleichen
Wissen Sie, welche Kategorie für Ihre Teamgröße, Ihr monatliches Volumen und Ihre technischen Fähigkeiten gebaut wurde. Eine falsche Kategorie ist der mit Abstand teuerste Fehler bei der Auswahl von Dokumentenextraktionssoftware — und in einer Funktionsvergleichstabelle ist er unsichtbar.
Die fünf Kategorien im Überblick
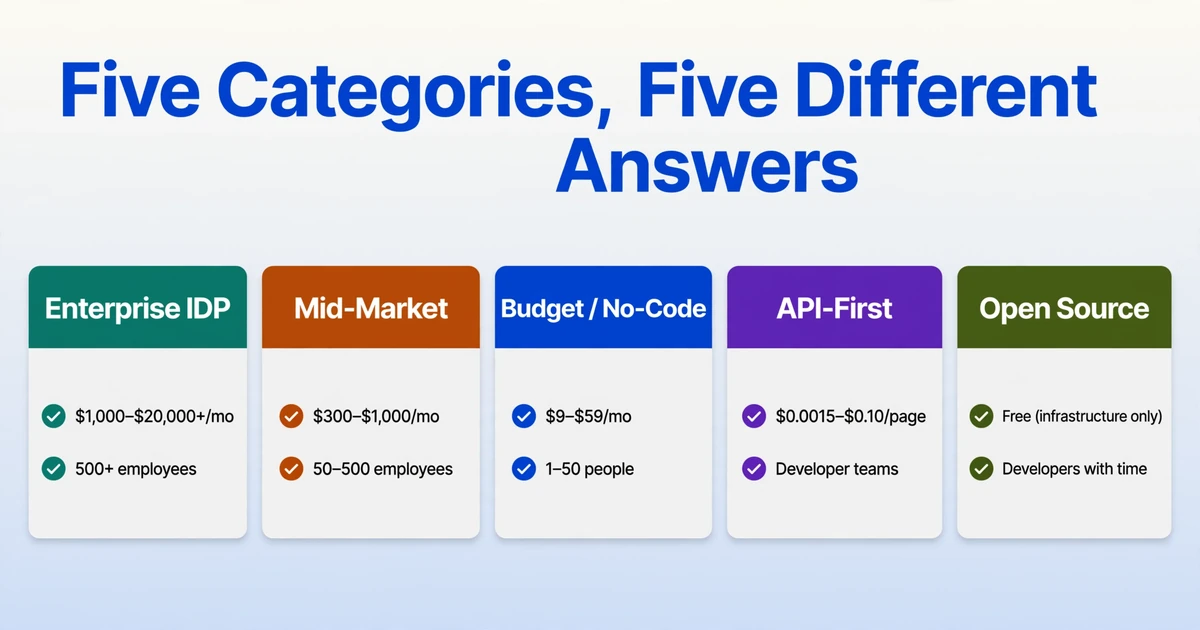
Hier ist die Übersicht in einer Tabelle. Jede Kategorie ist eine andere Antwort auf die Frage: „Für wen ist das gedacht, was kostet es und was gibt man dafür auf?“ Der Rest dieses Artikels erläutert jede einzelne.
| Kategorie | Für wen geeignet | Typische Preisspanne | Kernabwägung | Beispiele |
|---|---|---|---|---|
| Enterprise-IDP | Organisationen mit 500+ Mitarbeitern, dedizierte IT, Compliance-Anforderungen | $1.000–$20.000+/Monat | Maximale Leistung, maximaler Implementierungsaufwand | ABBYY Vantage, Hyperscience, Rossum, UiPath IXP |
| Spezialisiert für den Mittelstand | 50–500 Mitarbeiter, Finanz-/Ops-Team, moderates Volumen | $300–$1.000/Monat | Gute Genauigkeit zu angemessenen Kosten, aber geringere Workflow-Abdeckung | Nanonets, Docsumo, Affinda, Docparser |
| Budget / No-Code | 1–50 Personen, keine IT-Unterstützung, schnelle Einrichtung erforderlich | $9–$59/Monat | Schnellster Start, geringste Kosten, auf reine Extraktions-Workflows beschränkt | ImageToTable.ai, Airparser, Parseur, Parsio |
| API-First / Cloud-Native | Entwicklerteams, die Extraktion in ihr eigenes Produkt integrieren | Pro Seite ($0,0015–$0,10/Seite) | Volle Pipeline-Kontrolle, erfordert Engineering-Investitionen | Google Document AI, Amazon Textract, Azure Document Intelligence |
| Open Source | Entwickler mit Zeit, Teams, die volle Datenkontrolle benötigen | Kostenlos (nur Infrastrukturkosten) | Keine Lizenzkosten, maximaler Engineering-Aufwand | Tesseract, PaddleOCR, docTR |
Enterprise-IDP-Plattformen: Wenn der Umfang eine vollständige Suite erfordert
Enterprise-IDP-Plattformen sind die Kategorie, auf die die meisten Käufer zuerst stoßen – weil sie die größten Marketingbudgets und die längsten Verkaufshistorien haben. Tools in dieser Stufe – ABBYY Vantage, Hyperscience, UiPath's Intelligent Document Processing, Rossums Enterprise-Angebot – wurden für Organisationen entwickelt, die Zehntausende von Dokumenten pro Monat über mehrere Abteilungen hinweg verarbeiten, mit dediziertem IT-Personal, formalen Beschaffungsprozessen und Compliance-Anforderungen, die Prüfpfade verlangen.
Was Sie kaufen: Eine End-to-End-Plattform für Dokumentenverarbeitung. Die Extraktion ist ein Modul. Die Plattform umfasst auch Dokumentklassifizierung (automatische Identifizierung, welcher Dokumenttyp gerade eingegangen ist), Validierungsregeln, konfidenzbasiertes Routing (Ergebnisse mit hoher Konfidenz gehen direkt durch, Ergebnisse mit niedriger Konfidenz gehen in eine menschliche Prüfwarteschlange), ERP/CRM-Integrationskonnektoren und rollenbasierte Zugriffskontrolle. Wenn ABBYY oder Rossum an ein Unternehmen verkauft, verkaufen sie keine Extraktion – sie verkaufen eine Dokumenten-Operations-Ebene.
Die tatsächlichen Kosten: Rossums Starterplan beginnt bei etwa 18.000 $ pro Jahr. Nanonets Enterprise-Stufe startet bei 999 $/Monat und skaliert mit dem Volumen. ABBYY veröffentlicht überhaupt keine Preise. Aber die Lizenzkosten sind in der Regel die kleinere der beiden Ausgaben. Die Implementierung – Konfigurieren von Dokumenttypen, Trainieren von Modellen, Integrieren in bestehende Systeme, Schulung von Personal – dauert typischerweise 3–12 Monate und kostet mehr als die Lizenz des ersten Jahres. Ein Forrester-Bericht zur IDP-Einführung stellt fest, dass Käufer, die die Implementierungskomplexität unterschätzen, „oft Genauigkeitsraten in der Pilotphase sehen, die vielversprechend aussehen, sich aber ohne monatelanges Tuning nicht in die Produktion übertragen lassen."
Der Kompromiss: Sie erhalten den umfassendsten verfügbaren Stack für Dokumentenautomatisierung. Sie erhalten auch die schwerste Implementierungslast. Wenn Ihre Organisation tatsächlich 10.000+ Dokumente pro Monat über mehrere Dokumenttypen verarbeitet und ein IT-Team für die Verwaltung der Bereitstellung hat, zahlt sich die schwere Last in Automatisierungsdichte aus – eine einzige Plattform übernimmt alles von der Posteingangs-Erfassung bis zur ERP-Buchung. Wenn Sie 300 Rechnungen pro Monat verarbeiten und keine IT-Abteilung haben, zahlen Sie für Infrastrukturkomplexität, die Sie nie nutzen werden, und einen Bereitstellungszeitplan, der Ihre Geduld überdauern wird.
Enterprise-Plattformen sind zudem in der Regel am stärksten bei Handschrift und komplexen Tabellenstrukturen – Hyperscience hat seinen Ruf insbesondere auf der Verarbeitung handschriftlicher Dokumente für Regierungsbehörden und Gesundheitszahler aufgebaut. Wenn Ihre Dokumentmischung einen erheblichen Anteil handschriftlicher Formulare enthält, ist die Enterprise-Stufe möglicherweise die einzige Kategorie mit der Genauigkeit, um diese sauber zu verarbeiten.
Spezialisierte Tools für den Mid-Market: Fokussierte Leistung ohne Ballast
Mid-Market-Tools liegen im Bereich von 300–1.000 $ pro Monat und lösen das Problem, das Enterprise-Plattformen für kleinere Organisationen schaffen: zu viel Tool, zu viel Kosten, zu viel Implementierung. Nanonets, Docsumo, Affinda und Docparser sind hier die bekanntesten Namen. Sie versuchen nicht, All-in-One-Plattformen zu sein – sie konzentrieren sich darauf, die Extraktion gut zu machen, und überlassen Ihnen die nachgelagerte Workflow-Gestaltung in Ihren bestehenden Tools.
Der Unterschied zu Enterprise: Sie erhalten eine KI-gestützte Extraktion, die variable Layouts ohne Vorlagen verarbeitet – dieselbe zugrunde liegende Technologie wie in der Enterprise-Stufe. Was Sie nicht erhalten, ist der vollständige Workflow-Automatisierungs-Stack: kein integriertes Genehmigungs-Routing, keine ERP-Konnektor-Bibliothek, keine rollenbasierte Zugriffskontrolle für Compliance-Audits. Diese Tools setzen voraus, dass Sie bereits Systeme für diese Funktionen haben und nur die Extraktion benötigen, um Daten in diese einzuspeisen.
Der ideale Anwendungsfall: Eine mittelgroße Buchhaltungskanzlei, die 2.000–5.000 Dokumente pro Monat verarbeitet. Genug Volumen, dass die manuelle Eingabe wirklich teuer ist, aber nicht genug, um eine 6-monatige Enterprise-Einführung zu rechtfertigen. Der zonale OCR-Ansatz von Docparser eignet sich gut für Organisationen mit konsistenten Dokumentlayouts (jeden Monat dieselben Lieferanten, dieselben Formulare). Nanonets und Docsumo verwenden Deep-Learning-Modelle, die Variationen besser verarbeiten – nützlich, wenn Ihre eingehenden Dokumente von 50+ verschiedenen Geschäftspartnern stammen und keine zwei Formate identisch sind.
Der Kompromiss: Bessere Genauigkeit als Budget-Tools bei hochvolumigen, sich wiederholenden Dokumenttypen, zu einem Bruchteil der Enterprise-Preise. Aber Sie stoßen an eine Grenze bei der Anpassung – möchten Sie eine benutzerdefinierte Validierungsregel hinzufügen, die extrahierte Daten vor der Annahme des Ergebnisses gegen Ihr ERP abgleicht? Das ist Enterprise-Territorium. Die Mid-Market-Stufe deckt die Extraktion gründlich ab; sie überlässt das „Was passiert nach der Extraktion“ Ihnen.
Viele Käufer in dieser Stufe müssen auch entscheiden, ob sie API-first oder No-Code gehen möchten – einige Mid-Market-Tools bieten beide Wege an, und die Wahl hängt davon ab, ob Sie Entwickler für die Integration haben oder alles über eine Browser-Oberfläche funktionieren muss.
Budget-/No-Code-Tools: Die Self-Service-Stufe
Hier hat sich die Landschaft in den letzten zwei Jahren am schnellsten verändert. Tools wie ImageToTable.ai, Airparser, Parseur und Parsio bewegen sich in der Preisspanne von 9–59 $/Monat. Sie sind für einen bestimmten Käufer gebaut: jemanden, der heute Daten aus Dokumenten extrahieren muss, nicht auf einen Beschaffungszyklus warten kann und keinen Entwickler hat, der eine Integration baut. Der gesamte Workflow läuft im Browser ab.
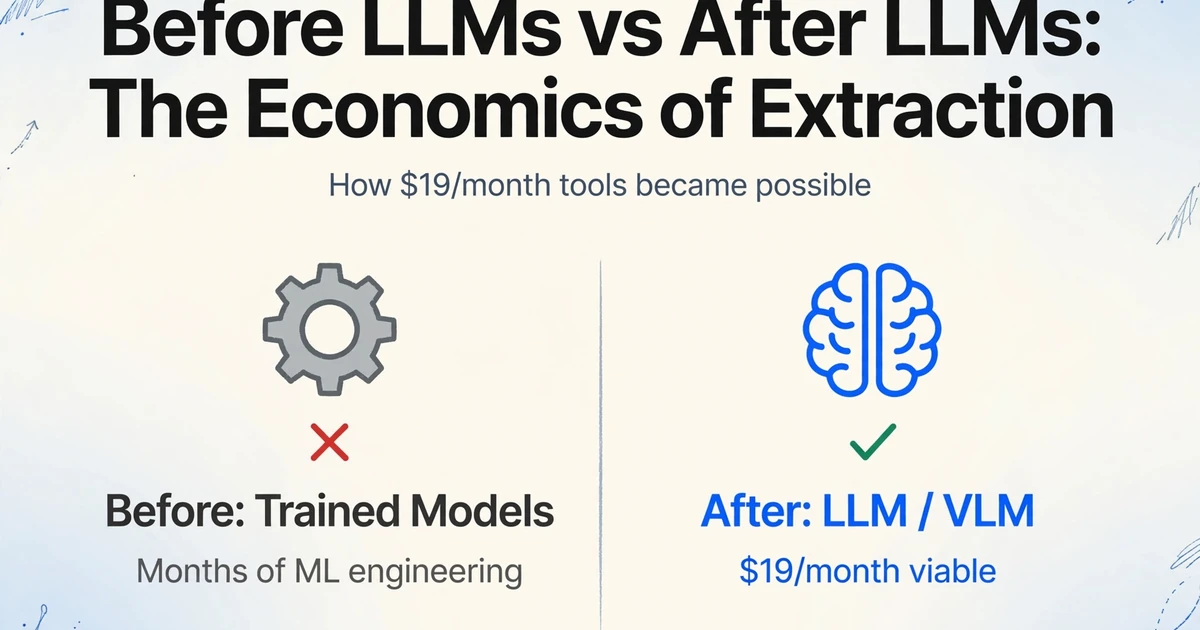
Der Technologiewandel, der diese Kategorie ermöglicht hat: Vor zwei Jahren konnte ein Extraktionstool für 19 $/Monat nicht existieren, weil der einzige Weg zu angemessener Genauigkeit über trainierte Modelle führte – und das Training von Modellen erforderte entweder (a) monatelanges Machine-Learning-Engineering oder (b) die Bezahlung eines Enterprise-Anbieters, der dies bereits getan hatte. Das Aufkommen von Large Language Models (LLMs) und Vision-Language Models (VLMs) hat die Wirtschaftlichkeit verändert. Anstatt ein Modell pro Dokumenttyp zu trainieren, senden diese Tools Ihr Dokument an ein LLM oder VLM, das das Dokument so liest, wie es ein Mensch tun würde – indem es versteht, was die Felder bedeuten, nicht wo sie auf der Seite stehen. Die Kosten pro Dokument für diesen Ansatz sind so weit gesunken, dass Pläne für 19 $/Monat bei Hunderten von Seiten pro Monat machbar wurden.
So funktioniert es in der Praxis: Sie laden ein PDF, JPG oder einen Screenshot hoch. Sie geben die gewünschten Feldnamen ein – „Rechnungsnummer, Lieferantenname, Gesamtbetrag, Fälligkeitsdatum.“ Die KI findet jeden Wert überall auf der Seite, indem sie Semantik und nicht Koordinaten versteht. In ImageToTable.ai heißt dies Benutzerdefinierte Spaltenextraktion: Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabetabelle. Müssen Sie 50 Rechnungen auf einmal verarbeiten? Laden Sie sie als Batch hoch und erhalten Sie eine zusammengeführte Excel-Datei – jede Rechnung wird zu einer Zeile mit den von Ihnen angegebenen Spalten. Sie können sogar berechnete Spalten definieren, die während der Extraktion Berechnungen durchführen – wie „Positionssumme (Menge × Einzelpreis)“ – sodass die heruntergeladene Tabelle Antworten und nicht nur Rohdaten enthält.
Die meisten Tools in dieser Stufe bieten auch eine Sammellink-Funktion: Generieren Sie eine teilbare URL, senden Sie sie an Kunden oder Teammitglieder, und deren hochgeladene Dokumente landen direkt in Ihrer Verarbeitungswarteschlange – ohne dass diese sich registrieren müssen.
Der Kompromiss: Diese Kategorie bietet die schnellste Zeit bis zum ersten Ergebnis auf dem Markt – oft unter 2 Minuten vom Aufrufen der Seite bis zum Herunterladen einer Tabelle. Der Kompromiss ist, dass Sie Extraktion erhalten, aber keine Workflow-Plattform. Wenn Sie automatische ERP-Buchungen, Genehmigungsrouting oder eine menschliche Prüfwarteschlange mit granularen rollenbasierten Berechtigungen benötigen, brauchen Sie ein Tool aus einer höheren Kategorie. Budget-Tools bewältigen den Extraktionsschritt äußerst gut; sie automatisieren nicht, was davor oder danach passiert.
Wenn Budget-Tools gewinnen
Eine Buchhaltungsfirma mit 3 Mitarbeitern verarbeitet 200 Kundenrechnungen pro Monat. Eine Enterprise-IDP-Plattform kostet das 12-fache des monatlichen Umsatzes dieser Kunden. Ein Budget-Tool für 19 $/Monat extrahiert dieselben Felder aus denselben Rechnungen mit derselben KI-Klasse – und der Buchhalter arbeitet 45 Sekunden nach dem Upload in Excel. Was fehlt, ist nicht die Extraktionsqualität, sondern die Workflow-Automatisierung, die er gar nicht brauchte.
API-First / Cloud-Native: Bauen Sie Ihre eigene Pipeline
Google Document AI, Amazon Textract und Azure Document Intelligence gehören in eine völlig andere Kategorie. Das sind keine Tools – das sind Infrastrukturkomponenten. Sie melden sich nicht in einem Dashboard an und laden Dateien hoch. Sie schreiben Code, der Dokumente an einen REST-Endpunkt sendet und strukturiertes JSON zurückerhält. Die Preisgestaltung erfolgt pro Seite (zwischen 0,0015 $ und 0,10 $ je nach Prozessor), und die Annahme ist, dass Ihr Entwicklungsteam die gesamte Pipeline rund um den Extraktionsschritt aufbaut.
Für wen das geeignet ist: SaaS-Unternehmen, die Dokumentextraktion in ihr eigenes Produkt integrieren. Enterprise-Entwicklungsteams mit bestehender Cloud-Infrastruktur, die Extraktion als ein Glied in einer automatisierten Kette benötigen. Organisationen, die Dokumente in Mengen verarbeiten, bei denen die Preisgestaltung pro Seite günstiger ist als SaaS pro Sitzplatz – wenn Sie 50.000 Seiten pro Monat verarbeiten, können die 0,015 $/Seite von Textract (insgesamt 750 $) deutlich günstiger sein als eine Enterprise-Plattform für 1.500 $/Monat, vorausgesetzt, Sie haben das Entwicklungsteam, um die umgebende Infrastruktur aufzubauen.
Was die Cloud-Anbieter richtig machen: Die vortrainierten Prozessoren von Google Document AI für Rechnungen, Belege und Ausweisdokumente sind wirklich gut. Die Tabellenextraktion von Amazon Textract verarbeitet komplexe Layouts, an denen viele Drittanbieter-Tools scheitern. Die Document Intelligence von Azure integriert sich nahtlos in das Microsoft-365- und Power-Platform-Ökosystem, in dem viele Unternehmen bereits leben.
Die Lücke: Das sind Extraktions-APIs, keine Dokumentverarbeitungslösungen. Klassifizierung, Validierung, Ausnahmebehandlung, menschliche Prüfung – all das muss aufgebaut werden. Google, Amazon und Microsoft liefern den Motor; Sie liefern das Auto. Ein Entwickler, der den Aufbau einer Dokumentextraktionsplattform auf Reddit beschrieb, brachte es auf den Punkt: „Dokumentextraktion dreht sich weniger darum, ein perfektes Modell zu finden, sondern darum, ein System zu bauen, das Tausende verschiedener Dokumentvarianten verarbeiten kann.“ Die API liefert Ihnen den ersten Schritt – die Extraktion – nicht das System.
Für Teams, die abwägen, ob sie bauen oder kaufen sollen, wird die vollständige Kostenaufschlüsselung – Entwicklerzeit, Infrastruktur, Wartung und API-Preise – in unserer Build-vs.-Buy-Analyse ausführlich behandelt. Die Kurzfassung: Bauen ist sinnvoll, wenn Dokumentextraktion Ihr Produkt ist, nicht Ihr Overhead.
Open Source: Frei wie ein junger Hund
Tesseract – ursprünglich in den 1980er-Jahren bei HP entwickelt, heute von Google gepflegt – bleibt die am weitesten verbreitete OCR-Engine der Welt. PaddleOCR von Baidu hat seit 2023 deutlich an Bedeutung gewonnen, dank starker Mehrsprachigkeit (100+ Sprachen) und Tabellenerkennung. docTR, basierend auf PyTorch und TensorFlow, bietet eine modernere Architektur mit end-to-end trainierbarer Erkennung und Klassifizierung.
Diese Werkzeuge sind kostenlos. Die Lizenz kostet nichts. Aber Open-Source-OCR ist keine Dokumentextraktion – es ist Zeichenerkennung. Tesseract kann Ihnen den Text auf einer Seite nennen. Es kann Ihnen nicht sagen, welche Textzeichenfolge die Rechnungsnummer und welche die PO-Referenz ist. Diese Klassifizierungs-, Extraktions- und Strukturierungslogik müssen Sie selbst bauen – und genau dort liegen die wahren Kosten.
Wann Open Source funktioniert: Sie haben einen Entwickler mit Computer-Vision-Kenntnissen, Sie verarbeiten Dokumente mit streng festgelegten Layouts (gleiches Formular, gleiche Koordinaten, jedes Mal), und Ihr Volumen rechtfertigt die Entwicklungskosten. Insbesondere PaddleOCR bietet eine starke Tabellenerkennungs-Pipeline, die in Kombination mit benutzerdefinierter Nachbearbeitung bei strukturierten Tabellendokumenten mit kommerziellen Tools mithalten kann – wie Entwickler in der OCR-Community auf Reddit festgestellt haben, die es mit neueren Modellen verglichen und als zuverlässigste Open-Source-Option für den Produktionseinsatz befunden haben.
Wann es nicht funktioniert: Ihre Dokumente variieren im Layout zwischen Geschäftspartnern. Sie benötigen Feldextraktion, nicht nur Textausgabe. Sie haben keinen Computer-Vision-Ingenieur im Team. Unter diesen Bedingungen kostet das „kostenlose“ Tool mehr an Entwicklungszeit, als ein günstiges SaaS-Abonnement in einem Jahr kosten würde.
Was sich 2025–2026 geändert hat: Drei Trends, die den Markt neu formen
Die Anbieterlandschaft bleibt nicht stehen. Drei strukturelle Veränderungen zeichnen die oben beschriebenen Kategoriegrenzen aktiv neu.
1. LLMs und VLMs ersetzen die Extraktion auf Vorlagenbasis – diesmal wirklich
Zwei Jahrzehnte lang war der dominierende Ansatz bei der Dokumentextraktion das Vorlagen-Matching: Zeichnen Sie ein Feld um das Rechnungsnummernfeld, sagen Sie der Software „der Wert ist hier“ und hoffen Sie, dass die nächste Rechnung ihn an derselben Stelle platziert. Maschinelles Lernen verbesserte dies leicht, indem es Muster aus beschrifteten Beispielen lernte, aber die grundlegende Abhängigkeit von einem konsistenten Layout blieb bestehen. Forrester-Vizepräsident und Principal Analyst Boris Evelson beschreibt generative und agentische KI in der Document Mining and Analytics Platforms Landscape Q4 2025 als „Gleichmacher, der die Fähigkeit der Anbieter, sich zu differenzieren“, auf Regeln- und Vorlagen-basierten Architekturen in Frage stellt.
Der Wandel ist architektonisch, nicht inkrementell. Ein Vision-Language-Modell sucht nicht nach einem Feld an den Koordinaten (x: 342, y: 891). Es liest das Dokument ganzheitlich und beantwortet die Frage „Wie hoch ist der Gesamtbetrag auf dieser Seite?“, indem es die Beziehung zwischen dem Label „Gesamt“ und der Zahl daneben versteht – unabhängig davon, wo beides erscheint. Dies ist derselbe Ansatz, den ein menschlicher Leser verwendet, und genau deshalb haben Tools in jeder Kategorie 2025–2026 „ohne Vorlage“ zu ihrem Marketing hinzugefügt.
Der praktische Effekt: Tools, die nur 80 % der Dokumentformate verarbeiten konnten, schaffen jetzt 95 %+, weil der Fehlermodus – „das Layout hat sich geändert“ – überhaupt kein Fehlermodus mehr ist.
2. Agentische Dokumentenverarbeitung: Extraktion, die nicht bei der Extraktion aufhört
Der Begriff „agentisch“ wurde stark gehypt – und wir werden gleich ansprechen, was real ist und was Marketing ist –, aber die Kernidee ist echt. Traditionelles IDP (Intelligent Document Processing) macht Folgendes: Dokument eingeben, JSON ausgeben. Agentische Dokumentenverarbeitung macht Folgendes: Dokument eingeben, die KI plant einen mehrstufigen Workflow, extrahiert Daten, validiert sie gegen bekannte Regeln, gleicht sie mit Daten aus anderen Dokumenten ab und handelt – postet in ein ERP (Enterprise Resource Planning), löst eine Genehmigung aus, markiert eine Anomalie.
Kognitos definiert agentische Datenextraktion als Systeme, in denen „autonome KI-Agenten mehrstufige Workflows planen, iterativ über mehrdeutige Inhalte nachdenken, sich an Formate anpassen, die sie noch nie gesehen haben, ihre eigenen Ausgaben validieren und zunehmend Aktionen auf das ausführen, was sie extrahieren.“ Das Schlüsselwort ist iterativ: Ein agentisches System, das auf ein mehrdeutiges Feld stößt, rät nicht – es liest das Dokument erneut, prüft den Kontext und eskaliert bei anhaltender Unsicherheit an einen Menschen mit einer konkreten Frage zu einem bestimmten Feld.
Die parallele Worldwide IDP Software Forecast von IDC prognostiziert ein Marktwachstum von 29,6 % CAGR (Compound Annual Growth Rate), „angetrieben hauptsächlich durch die Einführung agentischer und generativer KI-Fähigkeiten in der Dokumentenautomatisierung.“ Die Entwicklung ist real, aber der aktuelle Stand ist ungleichmäßig: Die Studie „Emerging Technology Trends 2025“ von Deloitte ergab, dass 38 % der Organisationen agentische KI pilotieren, aber nur 11 % Agenten aktiv in der Produktion betreiben.
3. Multimodale Modelle: Dokumente sind nicht mehr nur Text
Der dritte Trend ist der leiseste, könnte sich aber als der folgenreichste erweisen. Extraktionstools früherer Generationen behandelten Dokumente als Text, der zufällig auf einem Bild lag – zuerst OCR, dann NLP. Diese Pipeline brach immer dann zusammen, wenn das visuelle Layout eine Rolle spielte: Häkchen in Kästchen, handschriftliche Unterschriften neben gedruckten Daten, in Berichte eingebettete Fotos.
Vision-Language-Modelle fassen die OCR→NLP-Pipeline zu einem einzigen Schritt zusammen. Sie verarbeiten das Dokument als visuelle Eingabe – Pixel, nicht extrahierten Text – und analysieren es direkt. Ein VLM kann die Frage „Ist das Kästchen ‚Genehmigt‘ angekreuzt?“ beantworten, indem es das Kästchen betrachtet, statt aus umliegendem Text zu schließen. Es kann eine handschriftliche Notiz am Rand einer gedruckten Rechnung lesen, ohne einen separaten Durchgang zur Handschrifterkennung.
Das ist für die Landschaft von Bedeutung, weil es die Grenzen zwischen den Kategorien verschwimmen lässt. Ein Budget-Tool für 19 $/Monat mit VLM-Backend kann heute Dokumenttypen verarbeiten, für die vor drei Jahren eine Unternehmensplattform mit einem speziellen Handschriftmodell erforderlich war. Die Technologie, die früher Preisklassen unterschied, diffundiert nach unten – was bedeutet, dass sich die echte Differenzierung zwischen Kategorien von der Extraktionsgenauigkeit hin zu Workflow, Integration und Support verschiebt.
Übertrieben vs. Real: Signal vom Rauschen trennen
Jede Anbieter-Website hat 2026 „KI-gestützt“, „agentisch“ und „ohne Vorlage“ auf ihre Startseite gesetzt. Hier ist, was tatsächlich passiert, im Vergleich zu dem, was Marketing ist.
| Behauptung | Was realistisch ist | Was übertrieben ist |
|---|---|---|
| „99 % Genauigkeit“ | Die OCR-Genauigkeit auf Zeichenebene ist bei sauberen, hochauflösenden digitalen Texten mit modernen Tools tatsächlich 99 %+. | Die Extraktionsgenauigkeit auf Feldebene bei realen Dokumenten – gescannt, schief, gestempelt, mehrsprachig – übersteigt selten 95 %. Die meisten „99 %“-Angaben messen das Falsche. Wenn die Rechnungssumme stimmen muss, ist die Zeichengenauigkeit irrelevant; die Feldgenauigkeit ist alles. |
| „Extraktion ohne Vorlage“ | LLM- und VLM-basierte Tools bewältigen variable Layouts tatsächlich ohne Konfiguration pro Dokumenttyp. Das ist 2026 eine echte, funktionierende Technologie, verfügbar bei Tools in verschiedenen Preisklassen. | „Ohne Vorlage“ bedeutet nicht „null Einrichtung“. Sie müssen dem Tool weiterhin mitteilen, welche Felder extrahiert werden sollen. Die Innovation besteht darin, dass Sie Felder semantisch beschreiben („Fälligkeitsdatum“) statt räumlich („Feld bei x:342, y:891“) – nicht darin, dass das Tool Ihre Gedanken liest, welche Daten Sie möchten. |
| „Agentische KI“ | Mehrschrittiges Denken, Selbstvalidierung und adaptive Extraktion funktionieren in kontrollierten Bereitstellungen – insbesondere bei der Rechnungsverarbeitung, wo Validierungsregeln klar definiert sind. | Laut Deloitte haben nur 11 % der Organisationen Agenten in Produktion. Die meisten „agentischen“ Funktionen sind 2026 eine einstufige Extraktion mit Validierungsprüfung – nützlich, aber nicht die autonome Dokumentenverarbeitungsebene, die das Marketing suggeriert. |
| „Kein Training erforderlich“ | LLM-basierte Tools funktionieren bei gängigen Dokumenttypen sofort ohne gelabelte Trainingsdaten – eine echte Verbesserung gegenüber der ML-Tool-Generation von 2018–2024. | Randfälle – ungewöhnliche Tabellenstrukturen, gemischtsprachige Dokumente, stark gestempelte oder gefaxte Seiten – profitieren weiterhin von Konfiguration, und Unternehmensbereitstellungen investieren weiterhin erhebliche Zeit in die Abstimmung auf ihren spezifischen Dokumentmix. |
Das ehrlichste Signal, das Sie von einem Anbieter bekommen, steht nicht auf dessen Startseite. Es steht auf der Preisseite: Wenn die Zahlen ohne Vertriebsgespräch sichtbar sind, wurde das Tool für Selbstbedienungskäufer gebaut. Wenn jede Stufe „Vertrieb kontaktieren“ sagt, wurde das Tool für Unternehmensbeschaffungsprozesse gebaut – und alles an Implementierungszeitplan, Supportmodell und Vertragskomplexität wird das widerspiegeln.
So nutzen Sie diese Übersicht, um Ihre Suche einzugrenzen
Sie haben die fünf Kategorien gesehen. Sie haben die Trends gesehen, die sie neu formen. Nun: In welcher Kategorie sollten Sie starten? Drei Fragen grenzen es schneller ein als jede Funktionsvergleichsmatrix.
Wie viele Dokumente pro Monat?
Unter 500: Budget-/No-Code-Tools bewältigen Ihr Volumen ohne Probleme. 500–5.000: Mid-Market-Tools bieten bessere Genauigkeit bei Skalierung und enthalten oft grundlegende Workflow-Funktionen. 5.000+: Enterprise-IDP oder API-First – die Ökonomie pro Dokument von Budget-Tools beginnt zu brechen, und die Integrationstiefe von Enterprise-Plattformen beginnt sich auszuzahlen.
Wer wird es bedienen?
Keine Entwickler im Team: Bleiben Sie in der No-Code- oder Mid-Market-Stufe – diese sind für die browserbasierte Bedienung durch nicht-technische Nutzer konzipiert. Ein oder zwei Entwickler verfügbar: API-First wird machbar, und Sie können den Aufbau einer Pipeline um Google Document AI oder Textract in Betracht ziehen. Volles Engineering-Team: Open Source oder API-First, mit dem Verständnis, dass „kostenlos" Engineering-Stunden bedeutet.
Was passiert mit den Daten nach der Extraktion?
Sie gehen in eine Tabellenkalkulation, die Sie manuell prüfen: Die Budget-Stufe reicht aus. Sie müssen automatisch in ein ERP übertragen werden und nachgelagerte Workflows auslösen: Sie benötigen ein Mid-Market- oder Enterprise-Tool mit Integrationskonnektoren. Sie speisen Ihr eigenes SaaS-Produkt: API-First ist die einzige Architektur, die Sinn ergibt – Sie betten Extraktion ein, nicht nutzen sie.
Beachten Sie, was in diesen drei Fragen fehlt: Funktionsanzahl, Genauigkeitsprozente und Verkäufer-Demovideos. Diese sind innerhalb Ihrer gewählten Kategorie wichtig. Aber wenn Sie nicht zuerst die Kategoriefrage beantwortet haben, vergleichen Sie Tools, die nie dazu gedacht waren, miteinander zu konkurrieren.
Sobald Sie Ihre Kategorie identifiziert haben, besteht der nächste Schritt darin, spezifische Tools zu bewerten. Der Rahmen in unserem 6-Dimensionen-Bewertungsleitfaden führt Sie durch, was zu testen ist, wie Sie es testen und wie Sie wissen, wann Sie genug getestet haben – ohne sich für einen 3-monatigen Pilotversuch anzumelden.
Wenn Sie noch ganz am Anfang stehen – unsicher, was Datenextraktionssoftware überhaupt ist – beginnen Sie mit unserem Einsteiger-Grundlagen, bevor Sie in die Kategorienauswahl eintauchen.
Häufig gestellte Fragen
Woher weiß ich, ob ich in der falschen Kategorie bin?
Das zuverlässigste Anzeichen: Sie zahlen für Funktionen, die Sie nicht nutzen, oder Sie entwickeln Funktionen, die das Tool eigentlich enthalten sollte. Wenn Sie einen Enterprise-Tarif haben und das Workflow-Automatisierungsmodul noch nie angefasst haben, sind Sie überkategorisiert. Wenn Sie einen Budget-Tarif haben und ein Python-Skript gebaut haben, das die API des Tools stündlich abfragt, um Daten in Ihr ERP zu speisen, sind Sie aus der Kategorie herausgewachsen. Die Kategorie-Passung dreht sich um das Verhältnis von genutzten zu bezahlten Funktionen – und darum, ob die fehlenden Funktionen Sie durch Workarounds mehr kosten, als die nächste Tarifstufe an Abonnementgebühren kosten würde.
Gibt es ein Tool, das über alle Kategorien hinweg funktioniert?
Kein einzelnes Tool deckt alle fünf Kategorien gut ab. Einige Tools bieten mehrere Tarifstufen, die zwei benachbarte Kategorien überbrücken – Nanonets zum Beispiel bietet sowohl einen Self-Serve-Plan für den Mittelstand als auch eine Enterprise-Stufe mit Workflow-Automatisierung. Aber dasselbe zugrunde liegende Tool kann nicht gleichzeitig für einen Solo-Buchhalter optimiert sein, der 100 Belege pro Monat hochlädt, und für eine Beschaffungsabteilung, die 50.000 POs verarbeitet. Die Architektur, das Support-Modell und die Preisstruktur, die den einen Anwendungsfall bedienen, arbeiten aktiv gegen den anderen.
Was, wenn mein Volumen von Monat zu Monat schwankt?
Mehrere Tools in den Budget- und Mittelstands-Tarifen bieten nutzungsbasierte oder kreditbasierte Preise, die Schwankungen besser bewältigen als feste monatliche Seitenkontingente. ImageToTable.ai, Airparser und Parseur arbeiten mit nutzungsbasierten Modellen, bei denen Sie für das bezahlen, was Sie verarbeiten, statt Kapazität zu reservieren. Wenn Ihr Volumen durchweg unvorhersehbar ist, vermeiden Sie Tools mit harten Seitenobergrenzen – Überschreitungsgebühren summieren sich schnell, und der Jahresvertrag, den Sie für einen Rabatt unterschrieben haben, wird zur Einschränkung.
Können diese Tools handschriftliche Dokumente verarbeiten?
Enterprise-Plattformen – insbesondere Hyperscience und ABBYY – verfügen über die stärksten Handschriftfunktionen, die über Jahre hinweg durch die Verarbeitung handschriftlicher Antragsformulare, medizinischer Unterlagen und behördlicher Dokumente entwickelt wurden. Bei Budget- und Mid-Market-Tools variiert die Handschriftunterstützung erheblich. Tools, die Vision-Language-Modelle (VLM) verwenden (einschließlich ImageToTable.ai), können klare Handschrift im Kontext lesen – beispielsweise eine handschriftliche Summe neben einem gedruckten Etikett –, aber dichte Absätze kursiver Schrift bleiben in allen Kategorien eine Herausforderung. Wenn Ihr Dokumentmix überwiegend handschriftlich ist, testen Sie die Handschriftgenauigkeit an Ihren tatsächlichen Dokumenten, bevor Sie sich für ein Tool entscheiden; vertrauen Sie keiner Behauptung eines Anbieters, ohne sie an Ihren eigenen Stichproben zu überprüfen.
Wie testet man eine Kategorie am schnellsten, bevor man sich festlegt?
Budget- und Mid-Market-Tools in der No-Code-Stufe bieten in der Regel eine kostenlose Demo oder Testversion an, mit der Sie Ihre eigenen Dokumente hochladen und sofort Ergebnisse sehen können – ohne Vertriebsgespräch, ohne Vertrag. Dies ist der größte Vorteil der Self-Serve-Stufen: Sie können in weniger als 5 Minuten validieren, ob das Tool mit Ihren Dokumenten funktioniert. Enterprise-Tools erfordern ein Vertriebsgespräch, um Zugang zu einer Testversion zu erhalten, und die Testversion selbst beinhaltet oft eine geführte Einrichtungssitzung. Wenn Sie unsicher sind, welche Kategorie Sie benötigen, beginnen Sie niedrig – testen Sie zuerst ein Budget-Tool. Wenn es die Arbeit erledigt, haben Sie Tausende gespart. Wenn nicht, zeigen Ihnen die Lücken, die Sie finden, genau, welche Funktionen Sie von der nächsten Stufe benötigen.
Die Landkarte ist nicht das Gebiet
Die hier beschriebene Landschaft ist Stand Mitte 2026 korrekt, aber die Grenzen verschieben sich. Die Technologie, die Enterprise-Plattformen vor drei Jahren unterschied – vorlagenfreie Extraktion, Handschrifterkennung, Mehrsprachigkeit – ist heute in Tools zu einem Zehntel des Preises verfügbar. Die Technologie, die sie in drei Jahren unterscheiden wird – agentische Workflows, die die menschliche Überprüfung tatsächlich reduzieren, multimodales Denken, das jedes Dokument ohne Konfiguration verarbeitet – wird heute in jeder Kategorie entwickelt.
Was sich nicht ändert, ist die Matching-Logik. Das beste Tool für eine 3-Personen-Kanzlei, die 200 Rechnungen pro Monat verarbeitet, wird nie dasselbe sein wie das beste Tool für ein 500-Personen-Unternehmen, das 50.000 verarbeitet. Kategorien existieren, weil verschiedene Organisationen strukturell unterschiedliche Anforderungen haben, und kein noch so großer KI-Fortschritt ändert das. Beginnen Sie mit Ihrem Team, Ihrem Volumen und Ihrem nachgelagerten Workflow. Das Tool folgt daraus.
Testen Sie mit Ihren eigenen Dokumenten, in Ihrer eigenen Kategorie, anhand Ihrer eigenen Schwellenwerte. Ein 5-minütiger Test mit einer echten Rechnung von Ihrem am wenigsten kooperativen Lieferanten sagt Ihnen mehr als jede Feature-Matrix auf dieser Seite.