物流向け文書抽出:
オペレーション担当者の購入ガイド
AI文書抽出市場は成熟し、「PDFを読めるか」という質問はもはや意味をなさない——答えはほぼ常に「はい」だからだ。物流オペレーションにとって重要な質問は、ツールが6種類の異なる取引先から届く6種類のPDFを読めるかどうかだ——あるトラック運送会社からのストレートBOL、船会社からのオーダーノーティス船荷BOL、輸出者からの商業送り状、倉庫からのパッキングリスト、通関業者からのCBP 7501、運送会社の請求部門からのフレート請求書——そして、BOLの個数が請求書のライン運賃と一致するよう、データを相互参照できるかどうか。これらは越境貨物に毎回付随する物流文書だ。1種類はうまく処理できても他を処理できないツールは、ツールがないより悪い——部分的なデータセットしか作れず、結局手作業でギャップを埋めることになる。
重要ポイント
- 中規模のフォワーダーは、取引先の運送会社のBOLを読むだけで45種類の抽出テンプレートが必要になる——各社が異なるレイアウトで書類を発行するからだ。
- 運送会社が書類をリニューアルすると、それらのテンプレートはすべて静かに壊れる——最初の警告は、3日前に港を出たコンテナのデマレージ料金という形で届く。
- ImageToTable.aiは、どの運送会社のレイアウトでもコンテナ番号を意味に基づいて読み取るため、BOLと請求書のデータが同じスプレッドシートの隣接行に並び、相互参照が単一の数式で完了する。
物流書類の全体像:1つの貨物、6つの形式
1つの国際貨物は、ほとんどのオフィス環境では見かけない紙の痕跡を生み出します。荷主は船荷証券を発行しますが、どの種類でしょうか?譲渡不能で指名された受取人に宛てたストレートBOLは、トラック貨物で最も一般的です。裏書により譲渡可能なオーダーノーティスBOLは、輸送中に貨物の所有権が変わる可能性がある海上貨物に登場します。マルチモーダルBOLは、トラック、鉄道、船舶の区間を1つの書類にまとめたコンテナ輸送をカバーします — BOLの種類と検証基準の完全な内訳については、BOLデータ抽出の完全ガイドをご覧ください。各運送会社は独自のテンプレートでこれらを印刷します:Maerskの海上BOLは荷主と荷受人データを縦に配置し、積込港と揚荷港を専用ブロックに配置します;ODFLのトラックBOLは同じフィールドをページ上部3分の1に横にグループ化し、その下にハンドリングユニットの行を配置します;地域のLTL運送会社は、手書きの参照番号を付けた単一列レイアウトにすべてをまとめる場合があります。
次に、輸出者から商業送り状が届きます — HSコード、申告価格、インコタームズ、原産国が含まれます。パッキングリストは倉庫から届き、個数、カートンあたりの重量、SKUレベルの詳細を明記します。通関ブローカーはCBP Form 7501を送ってきます — 米国税関国境警備局に提出される輸入申告書 — 入港番号、港コード、HTS分類、申告価格、関税計算、保証情報など40以上のデータブロックがあります。海上貨物の場合、19 CFR Part 149に基づくISF 10+2の提出もあり、船積み24時間前までに、製造者、売主、買主、荷受人、原産国、HTS番号をカバーする12のデータ要素を提出する必要があります。そして運賃請求書が届きます — 本線運賃、燃料サーチャージ、付帯費用、滞船日数、滞留時間。
6つの書類、6つのソース、6つの形式 — そしてロングビーチ港に置かれた1つのコンテナで、滞船料の時計はすでに動いています。連邦海事委員会の規則46 CFR Part 541によると、運送会社の滞船料請求書には特定のフィールド — BOL番号、コンテナ番号、揚荷港、フリータイム日付、利用可能日、具体的な請求日、料金基準、異議申立先 — を含める必要があり、含まれない場合、請求書は無効となる可能性があります。つまり、請求書を監査する担当者は、支払期限の前に構造化された形式でBOLデータを必要とするのです。これが構造的な問題です:書類は相互依存しており、時計は刻々と進み、データはPDFに閉じ込められています。
物流書類の抽出は、1つの書類を速く読むことではありません。相互依存する6つの書類を読み、コンテナ輸送に$4,200を支払うか$8,900を支払うかを決定するフィールドの不一致を浮き彫りにすることです。
評価基準1:フォーマット多様性への対応
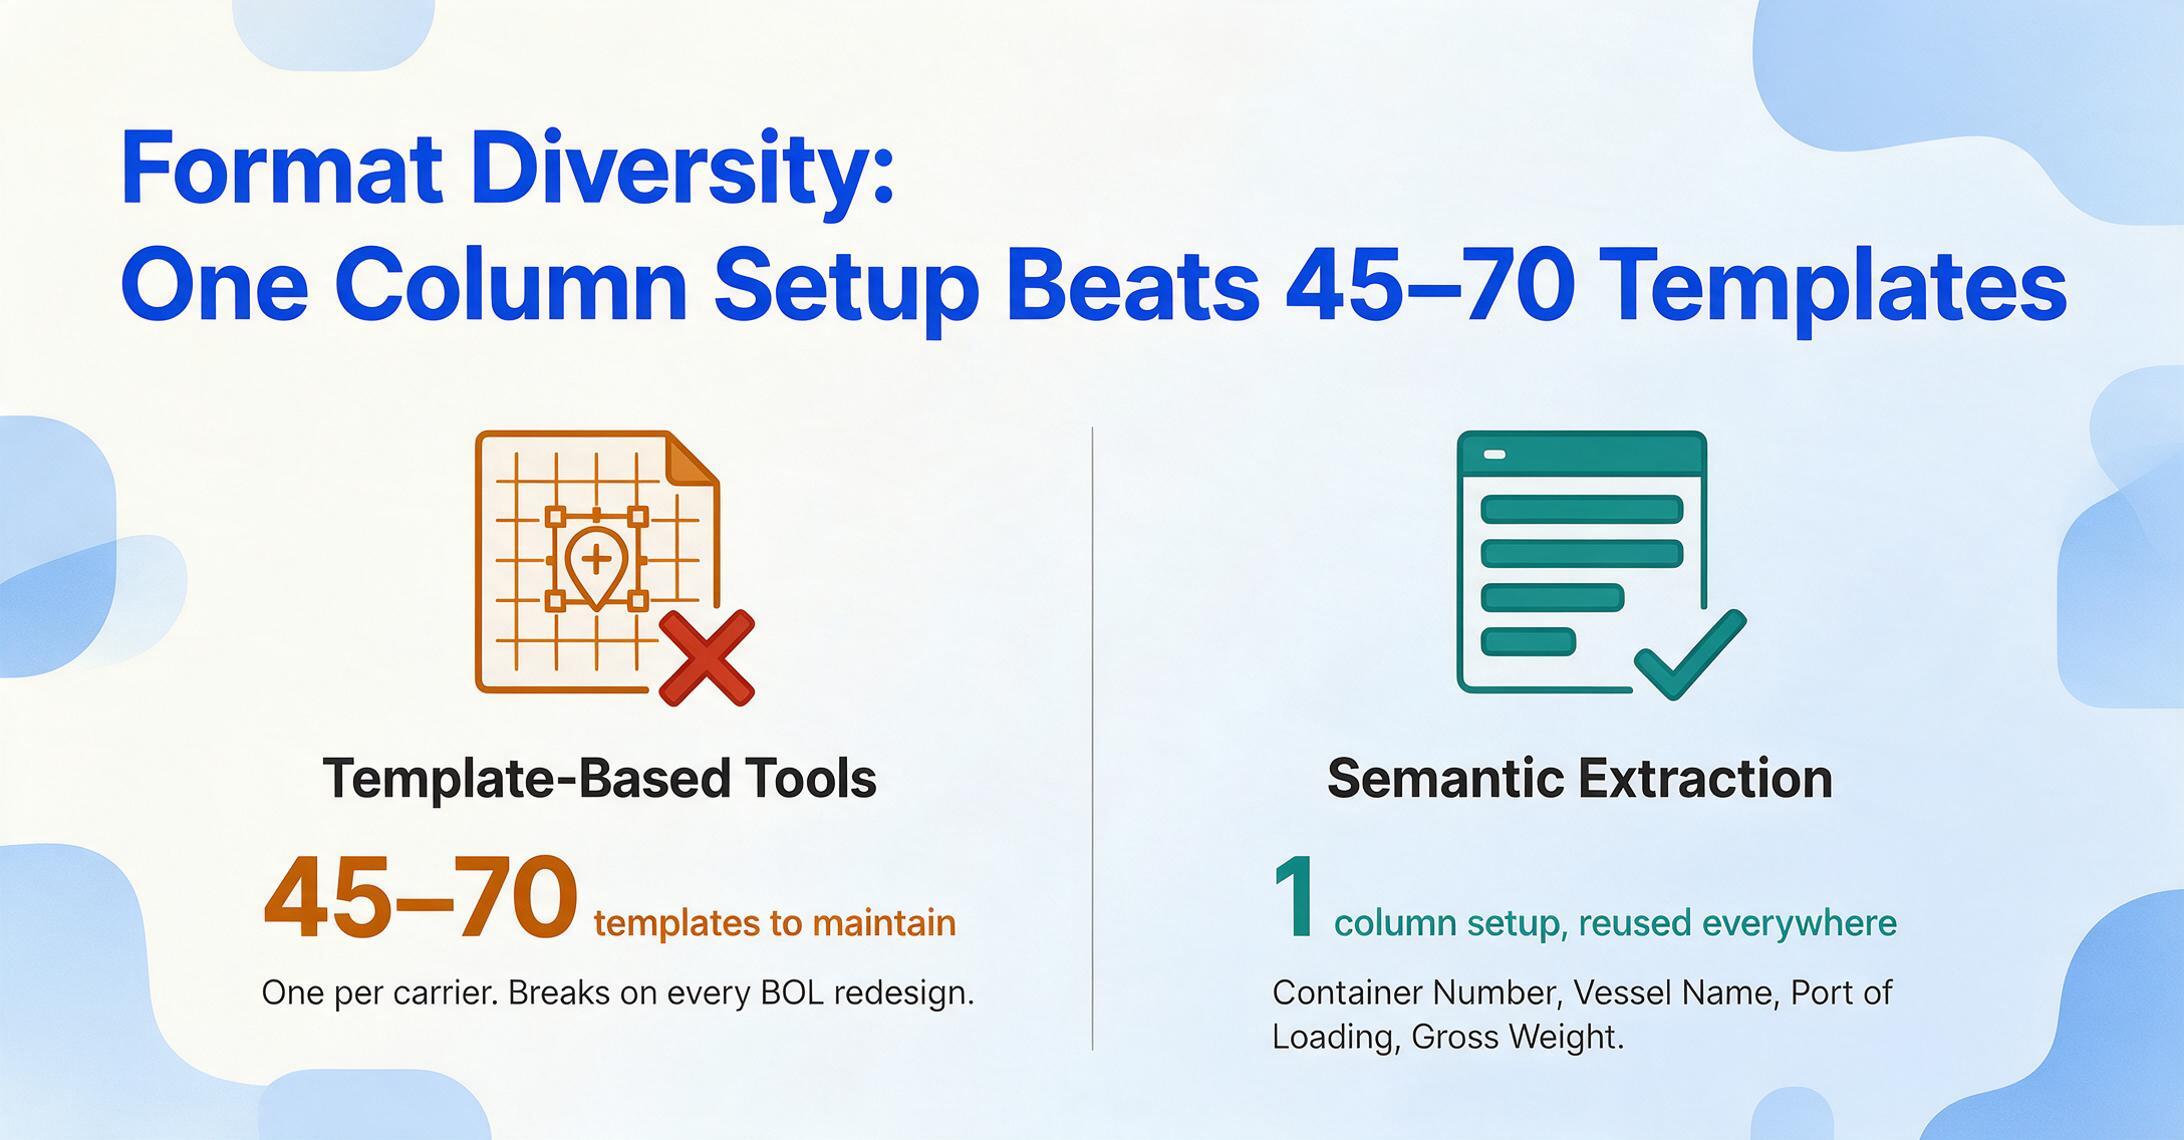
物流向け文書抽出ツールの最初の試金石はフォーマット多様性です。これは、ほとんどのベンダーデモが示すものとは意味が異なります。標準的なベンダーデモでは、鮮明なフォントの完璧にスキャンされたPDFを1枚読み込んで、数秒でフィールドを抽出します。物流オペレーターが知る必要があるのは、MaerskのBOL、MSCのBOL、COSCOのBOL、地域のトラック運送会社のBOLを同じバッチで同じ列設定で読み込んだときに何が起こるかです。そして、コンテナ番号がキャリアのフォーマットごとにページの異なる象限に配置されている場合です。
ほとんどの抽出ツールはここで2つのカテゴリのいずれかに分類されます。テンプレートベースのツールでは、各文書レイアウトの各フィールドにバウンディングボックスを描画したり、座標アンカーを定義したりする必要があります。つまり、キャリアごとに1つのテンプレートを維持する必要があります。15~20の海運キャリアとさらに30~50の地域トラック運送キャリアと取引している中規模のフォワーダーは、45~70個のテンプレートを維持することになり、キャリアがBOLを再設計するたびにそのすべてが壊れます。2番目のカテゴリ — ImageToTable.aiが使用するもの — は、ビジョンモデルによるセマンティック抽出です。抽出したい列名(コンテナ番号、船名、荷積港、総重量)を入力すると、AIが各文書上の値を、テンプレート上の位置を記憶するのではなく、それらのフィールドが意味的に何を意味するかを理解して特定します。同じ列設定 — ツールがカスタム列抽出と呼ぶもの — は、AIが人間のように読むため、すべてのキャリアフォーマットで同時に機能します。「コンテナ番号」という概念を文書全体から探し、その隣にある英数字文字列を、ページ上のどこに表示されているかに関係なく抽出します。
この違いは、物流業界において他のどの業界よりも重要です。買掛金管理では、請求書のフォーマットは異なりますが、Syscoの請求書とUS Foodsの請求書の違いは緩やかです。両方とも合計は右下にあり、明細項目は表にリストされています。物流では、Maerskの海運BOLとEstesのLTL BOLの違いは構造的なものです。文書は異なる規制枠組み、異なる輸送モード、異なる責任構造のために構築されています。AP請求書で機能するテンプレートベースのツールは、物流ワークフローで最初のキャリア切り替えで失敗します。
評価するときは、これを直接テストしてください。3つの異なるキャリア — 海運1社、全国LTL 1社、地域トラック運送1社 — のBOLを、同じ抽出列セットでツールのデモ環境に取り込みます。それぞれに個別のテンプレートを作成する必要がある場合、抽出で節約した時間をテンプレート保守に費やすことになります。9つの抽出ツールがこの種のキャリア差異に実際にどう対応するかを横並びでテストするには、物流文書抽出ツール比較を参照してください。1つのBOLをワークフローで最初から最後まで実行する仕組みについては、BOLデータをExcelに抽出する方法を参照してください。
評価基準2:文書間の相互参照ができるか?
単一文書の抽出は当然の前提です。物流対応ツールと一般的な文書リーダーを分けるのは、物流管理者が実際に実行する照合ワークフローに対応しているかどうかです — まずはBOLと運賃請求書のクロスチェックから始まります。
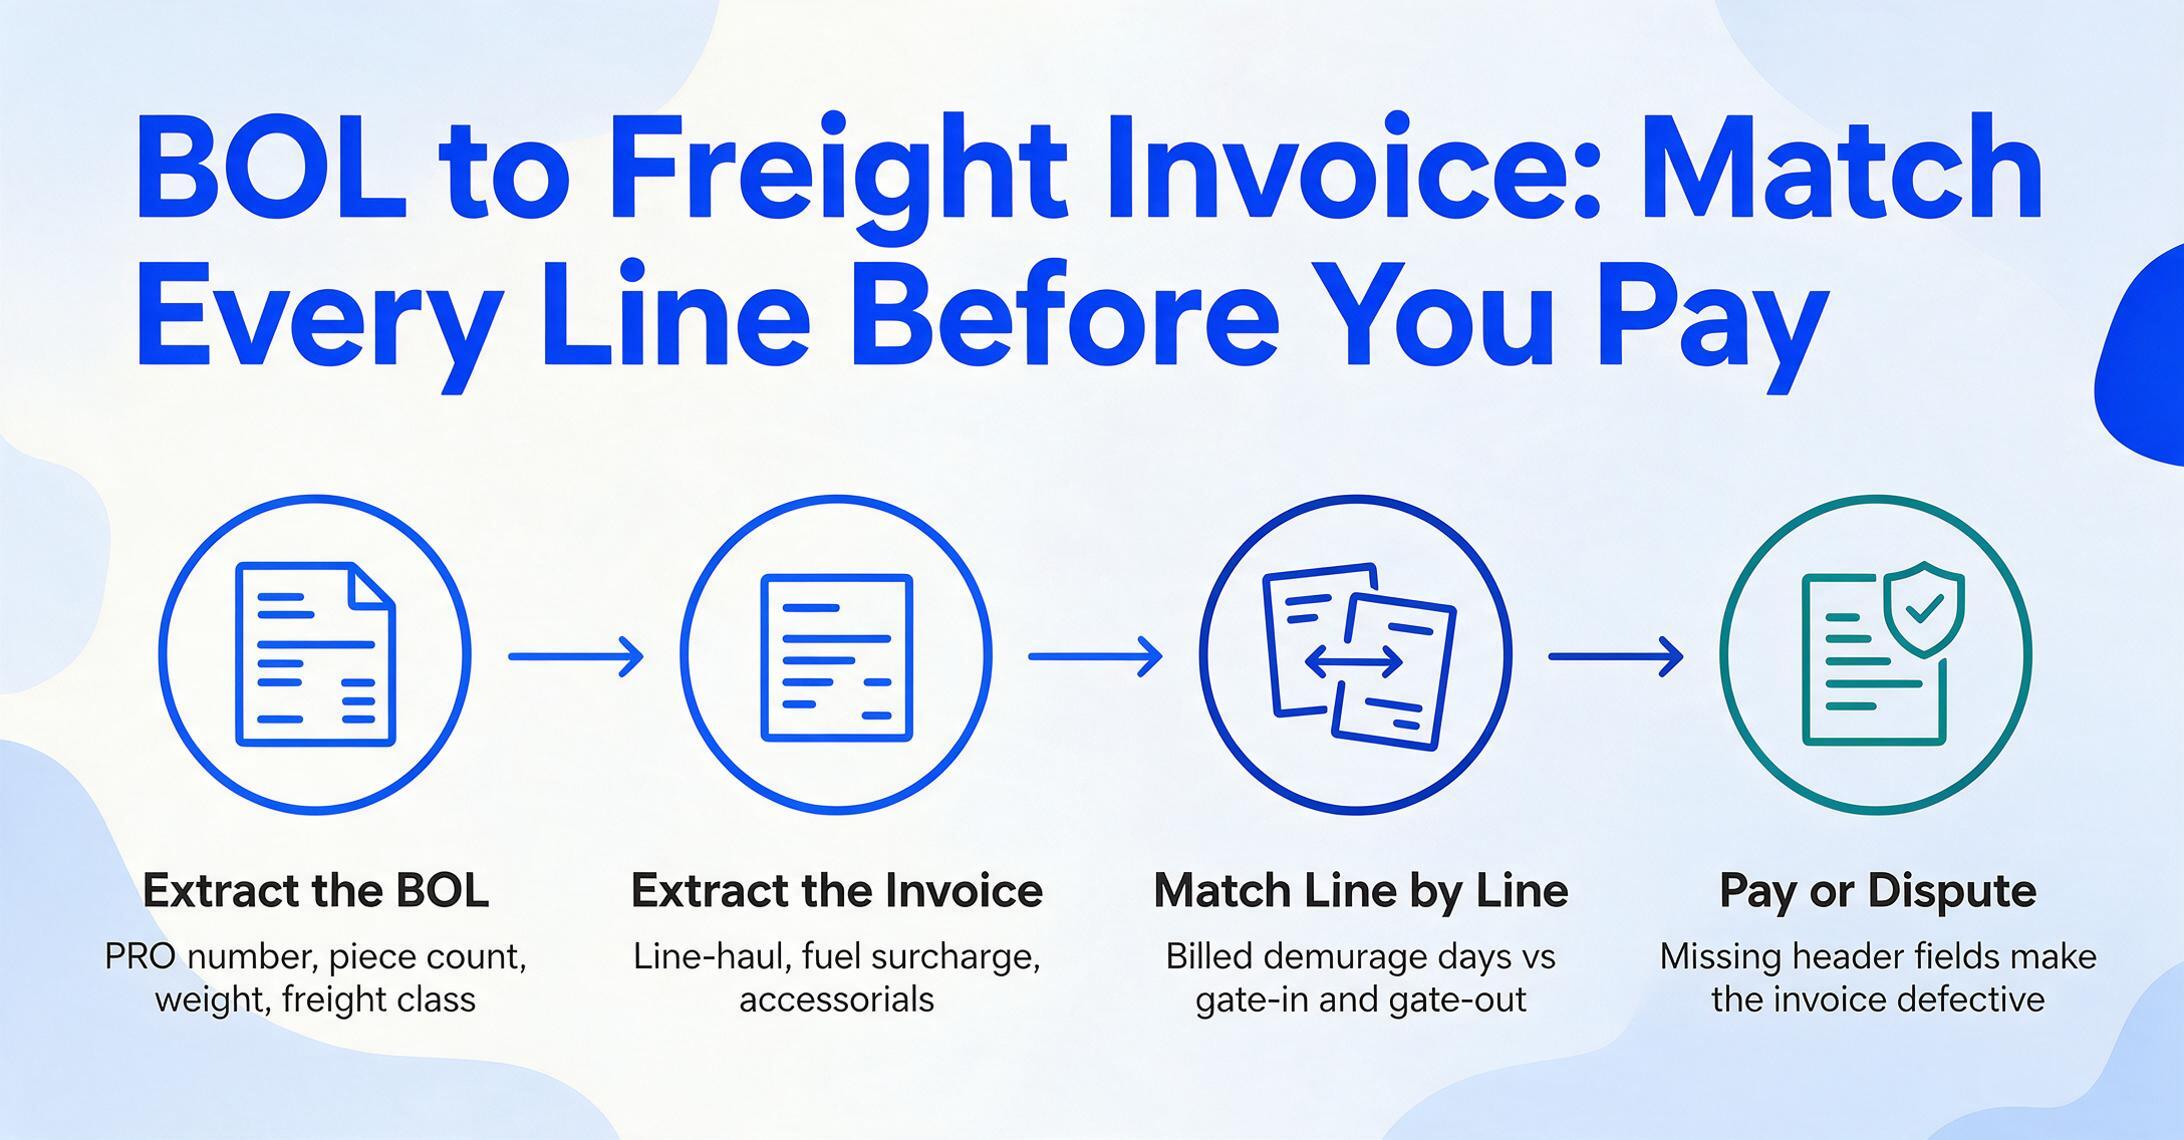
海運会社からの運賃請求書は単純な請求書ではありません。本線運賃、特定のバンカー燃料価格に連動する燃料サーチャージ、付帯費用(シャーシ使用料、滞船日数、滞留日数、書類手数料、危険物サーチャージ)、そして合計額が明細化されています。各明細項目は元文書との照合が必要です。本線運賃は予約時に合意した運賃確認書と一致する必要があります。請求書の個数と重量はBOLに記載された貨物明細と一致する必要があります。請求された滞船日数は、ターミナル料金表の無料保管期間に対するゲートイン・ゲートアウトのタイムスタンプと整合する必要があります。また、46 CFR Part 541に基づき、請求書には特定のヘッダー項目も含まれている必要があります — BOL番号、コンテナ番号、利用可能日、運賃基準が欠落している場合、その請求書は不備となり、支払い義務が生じない可能性があります。
ここで、BOLと運賃請求書の両方を同じスプレッドシートに抽出するツールが、単一文書ツールにはできないワークフローを生み出します。BOLをアップロードし、PRO番号、個数、重量、運賃クラス、運送会社の列を設定します。次に同じバッチに運賃請求書をアップロードし、本線運賃、燃料サーチャージ、付帯費用、請求個数を抽出します。2つの文書タイプが1つのスプレッドシートの隣接する行または列に入力され、相互参照 — 請求重量はBOL重量と一致するか?個数は整合するか? — が、2つの別々のPDFと電卓を使った手作業ではなく、数式チェックになります。
同じロジックが、パッキングリスト → 倉庫受入、商業送り状 → 税関申告の検証にも適用されます。出荷パケット内の6つの文書すべてのデータが同じ構造化テーブルに入れば、現在物流コーディネーターの午前中を費やしている照合作業がスプレッドシートのフィルターになります。これこそが、文書抽出ツールを物流業務にとって真に有用にする機能です — 単に速く読むだけでなく、滞船料になる前に不一致を可視化するのです。
物流幹部の57%が、過去1年間に文書エラーに直接起因する出荷遅延を経験したと報告しています。それらのエラーのほとんどはフィールドの欠落ではなく、文書間のフィールド不一致でした。6つのPDFを手作業で照合するのは出荷の無料保管期間より長くかかるため、誰もクロスチェックしなかったのです。
評価基準3:通関対応の抽出
事業で国境を越えて貨物を移動する場合、抽出ツールは通関書類を処理できる必要があります。これは聞こえる以上に厳しい要件です。通関フォームは密度が高く、政府標準化された書類であり、フィールドレベルの精度が求められます。一般的な「すべてのテキストを抽出する」アプローチでは対応できません。
CBP Form 7501(輸入申告書)は、40以上のデータブロックを持つ27ページのPDFです。ブロック1には11桁の英数字の輸入番号(3桁の申告者コード+7桁の輸入番号+1桁のチェックディジット)が入ります。ブロック2は輸入タイプコードを指定します。01は消費用、21は倉庫用です。ブロック6には港コード(ロサンゼルスは2704)が入ります。ブロック33から36にはラインレベル詳細(HTS番号、原産国、米ドルでの輸入価格、関税計算)が含まれます。これらの各フィールドには下流での影響があります。誤ったHSコード(具体的には10桁の関税分類)は異なる関税率を引き起こし、数千ドルの過払いやCBP監査につながる可能性があります。
すべての海上輸入に必要なISF 10+2申告では、さらに12のデータ要素が追加されます。売り手、買い手、輸入者記録、荷受人、製造者、送り先、原産国、HSコードなどです。これらは商業送り状およびBOLデータと一致している必要があります。一致しない場合、CBPが申告にフラグを立て、コンテナはターミナルからリリースされません。
物流グレードの抽出ツールは、通関フィールドをラベル付きで抽出する必要があります。単なる数値文字列「8471.30.0100」ではなく、「これはラインナンバー1のノートパソコンのHSコードである」という関連付けを含めて抽出します。原産国はヘッダーから一度だけではなく、ラインナンバーごとに取得する必要があります。また、BOLと送り状データがすでにある同じスプレッドシートに通関データを抽出できるようにし、通関業者の輸入申告書を商業送り状およびBOLの貨物説明と1つのビューで検証できるようにする必要があります。
実践的なテスト:評価中にベンダーに実際のCBP 7501 PDFを処理させてください。抽出されたHSコードが属するラインナンバーと一致するか、またはツールがラインナンバーとの関連なしにコードの混在リストを出力するかを確認してください。通関では、ラインナンバーのコンテキストがないコードは役に立ちません。
評価基準4:ツールへの文書の取り込み方法
文書抽出の評価フレームワークの多くは、アップロード後の処理——速度、精度、エクスポート形式——にのみ焦点を当てています。しかし、抽出前のステップ、つまり文書が実際に処理キューに入るまでの流れこそ、物流業務が想定以上に時間を失っている部分です。
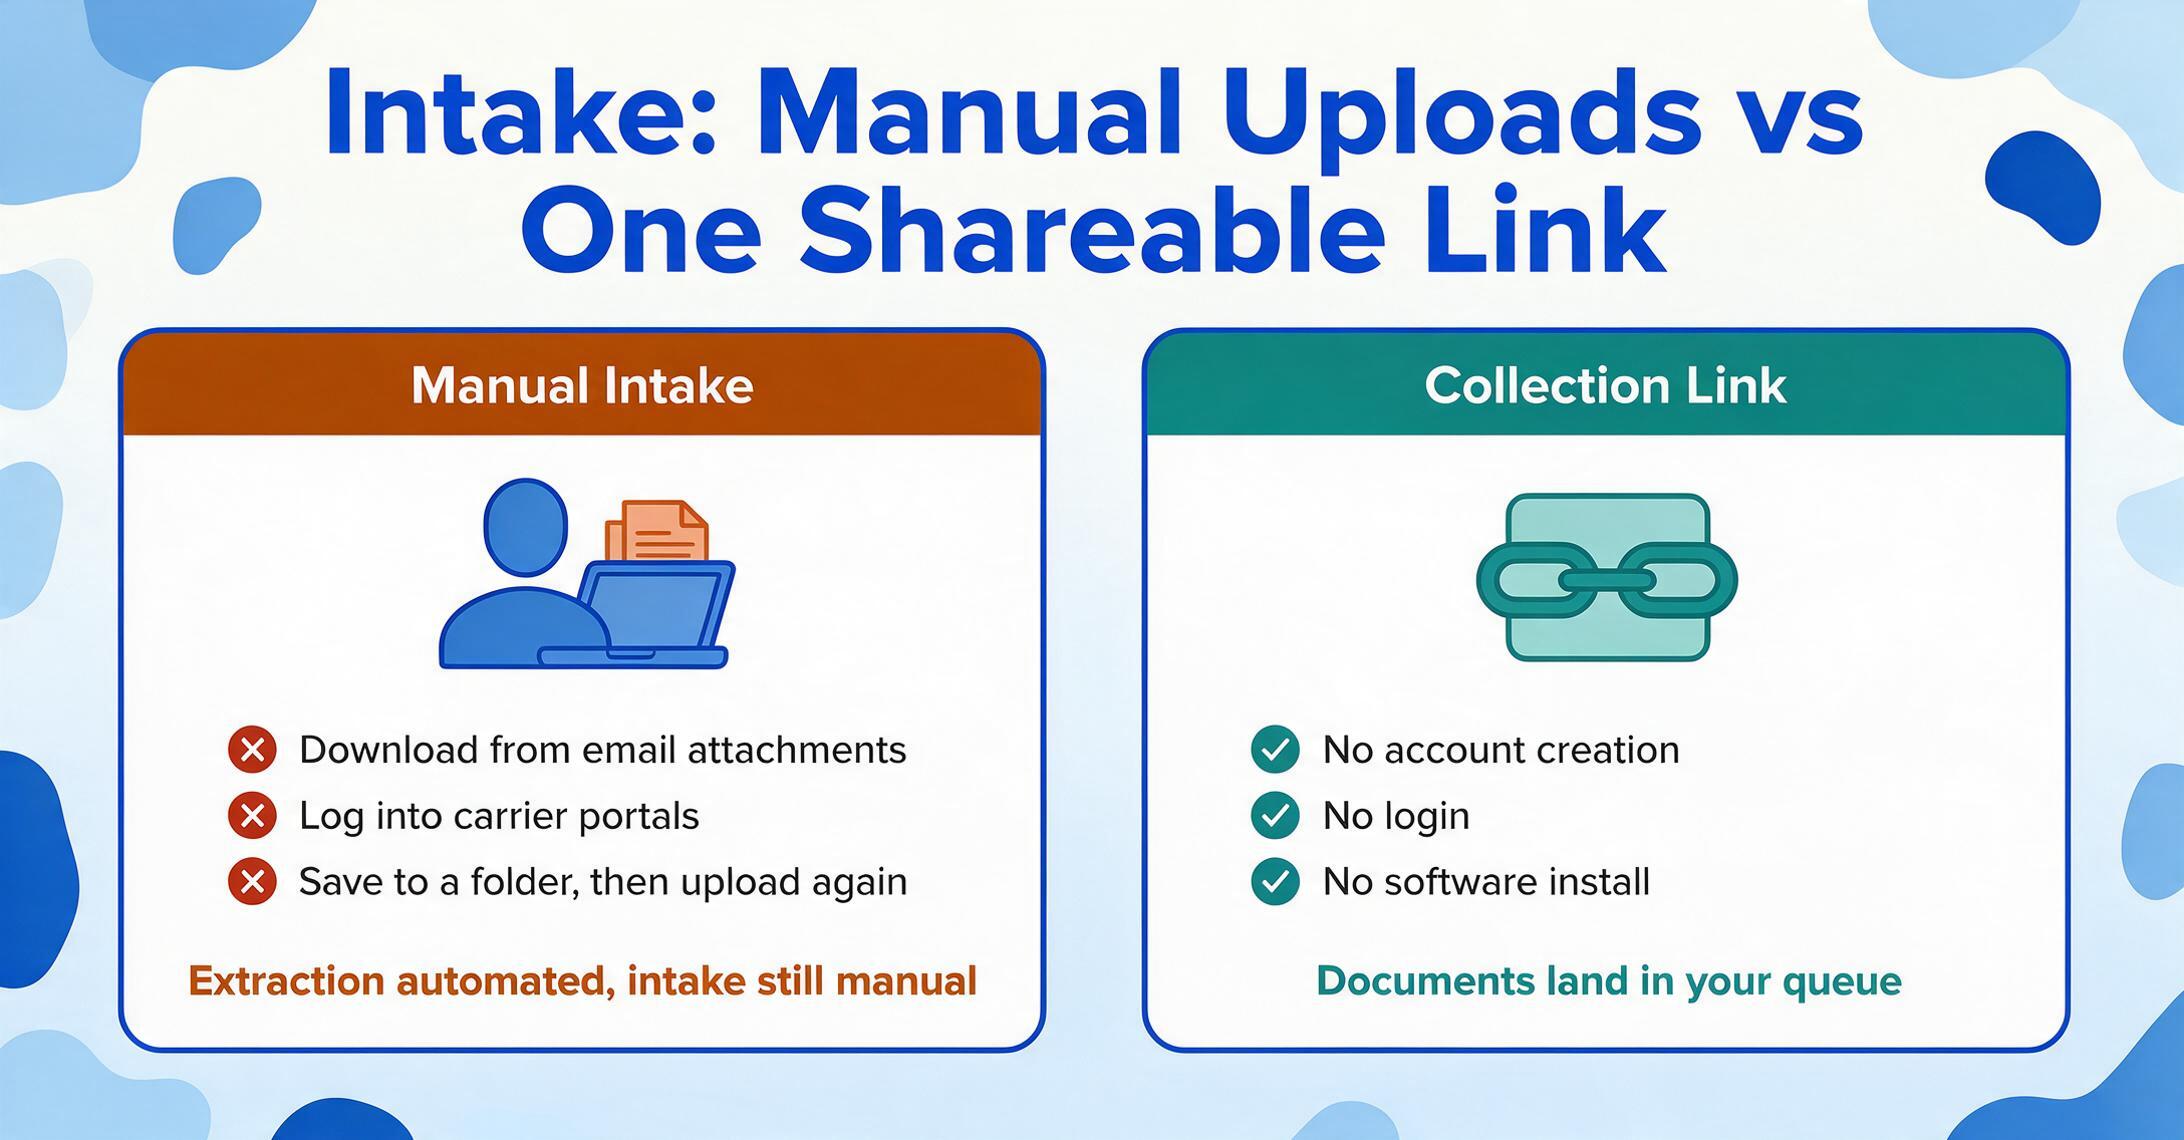
典型的な物流ワークフローでは、BOLは荷主からのメール添付で届きます。キャリア請求書はキャリアポータル経由か、請求部門からのPDF添付で届きます。税関申告書は通関業者から届きます。パッキングリストは仕出し倉庫から届きます。それぞれの送信元は異なる担当者、異なるチャネル、そして多くの場合異なるタイムゾーンです。抽出ツールがすべてのアップロードをあなたに任せる場合——メール添付のダウンロード、キャリアポータルへのログイン、ファイルのフォルダ保存、そしてツールへのアップロード——抽出ステップは自動化されても、取り込みステップは完全に手動のままです。
ここで、コレクションリンクのような機能が評価の計算を変えます。コレクションリンクは、アカウントから生成する共有可能なURLです。これをキャリアの配車デスク、荷主の倉庫、または通関業者に送信すると、相手はリンクを開き、短い確認コードを入力し、文書を直接あなたの処理キューにアップロードできます。相手側でのアカウント作成、ログイン、ソフトウェアのインストールは一切不要です。キャリアからのBOL、倉庫からのパッキングリスト、通関業者からの税関申告書はすべて自動的にキューに届き、列抽出設定がバッチで処理します。
ツールを評価する際は、取り込みについて2つの質問をしてください:ツールがあなたにアップロードを要求するのか、それとも外部の関係者が直接文書を提出できるのか?そして、外部提出が可能な場合、提出者が有料ライセンスやアカウントを必要とせずに機能するのか?物流では、文書が数十の外部取引先から流れてくるため、取り込みの自動化は抽出精度と同じくらい重要です——そして、これはほとんどの評価チェックリストが完全に見落としている基準です。
単一ツール vs. ポイントソリューション:意思決定のポイント
ここまでの流れで明らかなように、物流書類の抽出は単一書類の問題ではありません。複数の書類を照合する問題であり、各書類のデータが次の書類の検証に使われます。BOLのみを処理するツールでは、構造化されたデータセットが1つ作成される一方で、運送請求書、通関申告書、梱包明細書は元のPDFのままであり、過払いや通関遅延を防ぐための照合作業は依然として手作業で行わなければなりません。
ポイントソリューション(BOL抽出用のツール、請求書処理用の別ツール、通関申告用の専用プラットフォーム)には、それ自体のコストが伴います。データは3つの別々のシステムに分散し、あるツールのBOL抽出結果と別のツールの運送請求書抽出結果でコンテナ番号MSCU1234567を自動的に照合する手段がありません。この断片化に対する物流業界の従来の答えはTMSでした。CargoWise、Descartes、MercuryGate、Triniumなど、予約から決済までの全出荷ライフサイクルを管理するプラットフォームです。しかし、TMSプラットフォームはデータ入力がすでに完了しているワークフローを前提に構築されています。データがシステムに入った後の貨物を管理するのです。紙のBOLやスキャンしたPDFが届いた瞬間、TMSは機能せず、誰かが手入力しなければなりません。
6種類すべての物流書類を同じ列設定で処理する単一の抽出ツールがあれば、データサイロの問題は解消されます。BOLデータ、運送請求書データ、通関データ、梱包リストデータがすべて1つのスプレッドシートに集約され、かつて数時間かかっていた照合作業は、数式チェックまたは隣接する行の目視確認で数分で完了します。
これにはエンタープライズ契約は不要です。ImageToTable.aiは、BOL、商業送り状、梱包リスト、通関申告書、運送請求書、配達証明書の6種類すべての書類を、あらゆる書類に使用するのと同じカスタム列抽出設定で処理します。料金は月額19ドルからで、TMSモジュールのアップグレードにかかるユーザーあたりのコストを大幅に下回ります。抽出がより広範なデータ入力環境にどのように適合するかについては、文書抽出ソフトウェアの実際の機能の概要と、2026年のツールの現状をご覧ください。エンタープライズプラットフォームと軽量な代替案を比較検討する場合は、エンタープライズ vs. SMB抽出比較でトレードオフを確認できます。また、ツール選定の体系的なアプローチについては、文書抽出評価フレームワークが、ここで説明した物流固有の基準を補完する汎用的な方法論を提供します。
適切な物流抽出ツールは、書類の種類を選ぶ必要はありません。1つの列設定で出荷パケット全体(BOL、請求書、梱包リスト、通関申告書)を処理するため、照合作業は手作業の監査ではなく数式になります。
よくある質問
手書きのBOLや配送受領書でも文書抽出は機能しますか?
はい、ただし条件付きです。ビジョンモデルベースの抽出ツールは、BOLや配達証明書類の手書き文字(ドライバーの署名、手書きの個数、倉庫のスタンプ)を読み取れますが、印刷テキストと比べると精度は低下します。特に低解像度のスキャンや、カーボンコピーの3枚目が薄い場合に顕著です。印刷された文書内の手書きフィールド(印刷済みBOLにドライバーが個数修正を手書きする場合など)では、精度は一般的に高いです。全面手書きのフォームでは、検証なしにデータをそのまま信頼するのではなく、抽出データを確認することを想定してください。
多言語の通関書類にも対応できますか?
はい。中国のサプライヤーからの中国語の商業送り状、ドイツ語のパッキングリスト(「Packing List」ではなく「Lieferschein」)、韓国語の原産地証明書など、ビジョンモデルは言語に関係なく視覚的なテキストを処理し、抽出した値を英語の列名でラベル付けします。ツールはページ上の内容を読み取り、選択した列ヘッダーが出力ラベルになります。日本の物流業務については、ノーコードAIデータ入力ガイドをご覧ください。
既存のTMS(CargoWise、Descartes、MercuryGate)との連携はどうなりますか?
文書抽出はTMSを置き換えるものではなく、TMSにデータを供給するものです。BOL、請求書、通関書類から構造化データをExcelスプレッドシートに抽出し、そのスプレッドシートをTMSの標準データインポート機能で取り込みます。ほとんどのTMSプラットフォーム(CargoWiseはXMLアップロード、DescartesはCSVインポート、MercuryGateはデータローダー)は、一括スプレッドシートインポートに対応しています。抽出ツールはTMSがカバーしないPDFからスプレッドシートへの変換ステップを処理し、TMSは本来の目的である積載管理、追跡、決済ステップを処理します。取扱量がAPI統合の構築を正当化しない限り、API統合は不要です。
物流書類の精度は具体的にどのくらいですか?
印刷されたBOL、商業送り状、税関書類でフォントが明確な場合、印刷テーブルデータの精度は最大99%に達します。これは、100フィールド抽出するごとに約1フィールドの確認が必要で、書類8〜10件につき約1件の修正が必要という意味です。手書きフィールド、入れ子になった明細項目を含む複数行の貨物説明、低解像度スキャン(ファックス品質のPDF)では精度が低下し、フラグが付けられた抽出結果の人的確認が必要になる場合があります。実際のワークフローは次のとおりです。AIがすべてを抽出し、フラグが付けられた低信頼度フィールドをスポットチェックし、手書きまたは破損した書類を確認します。確認ステップを含めても、完全な手動入力より約18倍高速です。物流書類タイプに特化した従来のOCRと最新のAI抽出の詳細な比較については、物流向けOCRガイドをご覧ください。
書類の種類ごとに別々のツールが必要ですか?
いいえ — これが上記の評価フレームワークの核となる論点でした。セマンティック抽出(テンプレートの位置ではなく意味でフィールドを読み取る)を使用するツールは、BOL、運送請求書、パッキングリスト、税関申告書、商業送り状を同じ列設定で処理できます。列を一度定義するだけで — コンテナ番号、船名、HSコード、申告価格、陸上運賃 — 同じ設定が6種類すべての書類タイプで機能し、バッチでアップロードできます。書類タイプごとに別々のツールを使うとデータサイロが生まれ、相互参照が難しくなります。1つのツールを使えば統合データセットが作成され、相互参照はスプレッドシートの数式になります。
ご自身の書類で評価する
MaerskのBOL、Estesの運送請求書、パッキングリストをアップロードしてください。1つの列設定で3つすべてを同じスプレッドシートに抽出できるかどうか、テンプレートを1つも作成せずに確認できます。
ImageToTable.aiを無料で試すサインアップは不要です。ファイルは安全に処理され、保存されません。