Sie kennen OCR.
Hier ist der 3-Jahres-Sprung, der alles verändert.
Wenn Sie das Wort „OCR" das letzte Mal 2020 gehört haben – oder noch früher, in einem Scanner-Handbuch – dann sollten Sie erfahren, was passiert ist. Nicht die ganze 30-jährige Geschichte. Nur die letzten drei Jahre. Denn diese drei Jahre haben OCR nicht verbessert. Sie haben es durch etwas völlig anderes ersetzt.
Wichtigste Erkenntnisse
- Das OCR, das Sie kennen, kann Zeichen lesen, war aber nie in der Lage zu verstehen, dass die Zahl neben „Gesamtbetrag" das bedeutet, was Sie schulden – eine Grenze, die drei Jahrzehnte Optimierung nie durchbrochen haben.
- Was es ersetzt hat, liest Dokumente so, wie ein Mensch es tut – scannt eine ganze Seite auf einmal und erkennt eine Rechnungsnummer an ihrer Bedeutung, nicht daran, in welcher Ecke sie steht.
- Die zugrunde liegenden KI-Kosten sind in 18 Monaten um das 400-Fache gesunken – weshalb Dokumentextraktion, die 2023 einen fünfstelligen Enterprise-Vertrag erforderte, heute für 9 $ pro Monat verfügbar ist.
Die Kluft zwischen dem, was Sie erinnern, und dem, was real ist
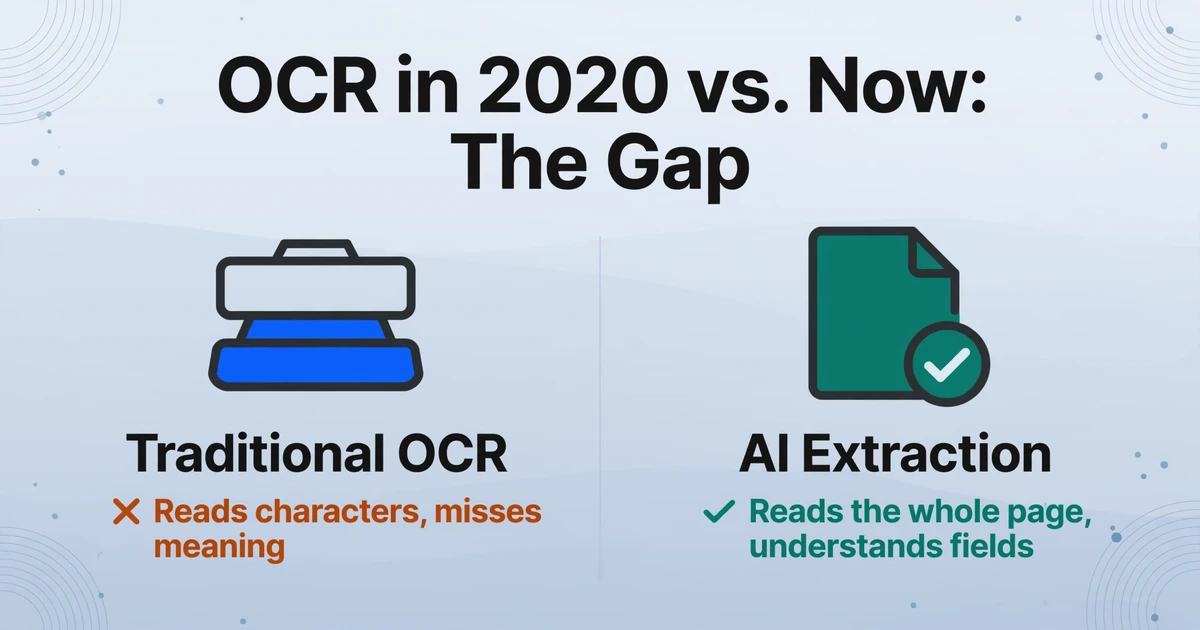
Das bedeutete OCR im Jahr 2020: Sie scannen ein Dokument, die Software liest die Zeichen, und Sie erhalten eine Textdatei. Wenn das Dokument sauber war und die Schriftart Standard, funktionierte es. Wenn das Layout ungewöhnlich war, handschriftliche Notizen vorhanden waren oder der Scan schief war – dann nicht. Sie mussten entweder eine Vorlage erstellen, um der Software mitzuteilen, wo sich jedes Feld auf der Seite befand, oder Sie akzeptierten, dass ein Mensch die Ausgabe korrigieren musste.
Das war die Obergrenze. Jahrzehntelang optimierte die gesamte Branche innerhalb dieser Grenzen – schnelleres Scannen, bessere Vorverarbeitung, ausgefeiltere Vorlagen-Engines. Doch die grundlegende Einschränkung blieb unverändert: OCR konnte Zeichen lesen. Es konnte nie ein Dokument lesen.
Ein Dokument ist nicht nur ein Haufen Zeichen. Eine Rechnung enthält einen Lieferantennamen, eine Rechnungsnummer, Positionen, ein Fälligkeitsdatum, eine Summe – und diese Felder haben eine Bedeutung, die über die Formen der Buchstaben hinausgeht, die sie buchstabieren. Die Zahl „$3.247,00" ist für eine OCR-Engine nur ein Pixelmuster. Für einen Menschen ist es der Betrag, den Sie schulden, und der Unterschied zwischen einem Fehllesen als „$324.700" oder „$3.247,00" ist der Unterschied zwischen dem Bezahlen der richtigen Rechnung und der Schaffung eines Buchhaltungschaos.
Traditionelle OCR hat diese Kluft nie überwunden. Und für die meisten Menschen, deren Arbeit mit Dokumenten zu tun hat – Buchhalter, Büroleiter, Kleinunternehmer, Freiberufler, die Ausgaben verfolgen – blieb „Dokumentenautomatisierung" gleichbedeutend mit „Scannen". Denn genau das war es.
Dann kam 2023. Und das, wofür OCR 30 Jahre gebraucht hat – zu verstehen, was ein Dokument bedeutet, nicht nur, was es sagt – wurde plötzlich von etwas gelöst, das überhaupt keine OCR war.
Drei Dinge, die sich geändert haben (und von denen Ihnen niemand ein Memo geschickt hat)
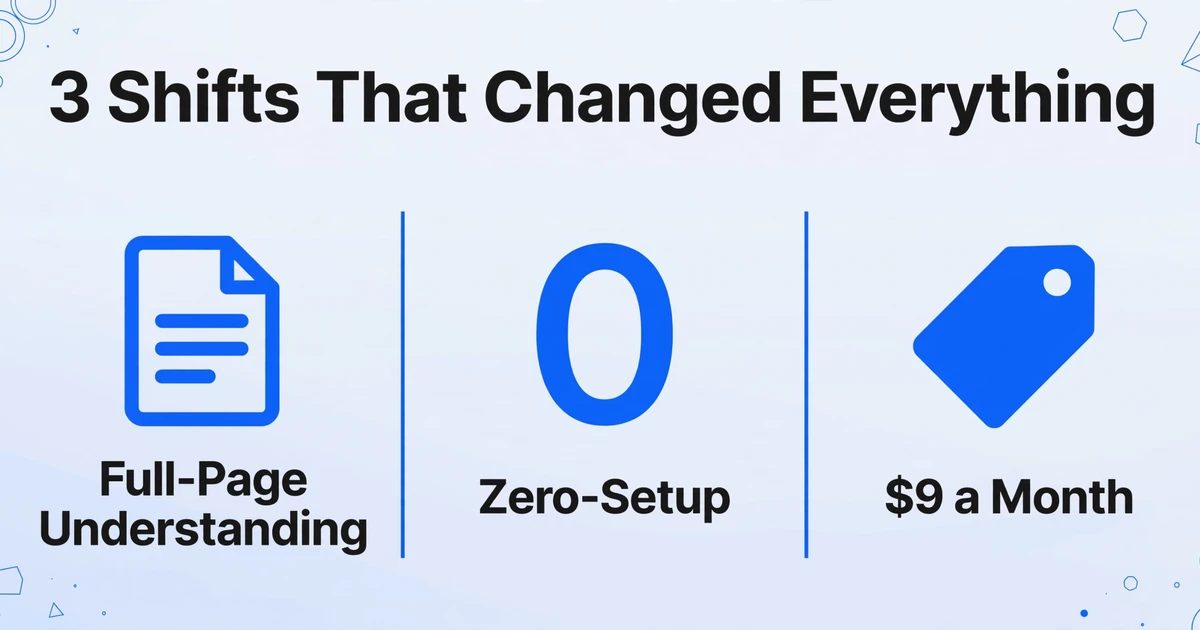
Wenn Sie sich seit 2020 nicht mehr mit diesem Thema beschäftigt haben, hier ist, was Sie verpasst haben. Nicht die vollständige 20-jährige Geschichte der Dokumentenverarbeitung — nur die drei Veränderungen, die alles auf den Kopf gestellt haben.
Veränderung 1: Vom Zeichenabgleich zum seitenweisen Verständnis
Traditionelle OCR funktionierte so: Die Seite wird Pixel für Pixel gescannt, jedes Muster wird mit einer Datenbank von Zeichenformen verglichen und die beste Übereinstimmung ausgegeben. Das Ergebnis war ein flacher Textstrom — ohne Konzept von Absätzen, Tabellen oder Feldbeziehungen. Wenn Sie „Rechnungsnummer" und „Gesamtbetrag" wollten, brauchten Sie eine Vorlage, die dem System sagte, wo auf der Seite diese Felder lagen. Layout geändert, Vorlage kaputt.
Die neue Generation — basierend auf Vision-Language-Modellen, kurz VLMs — funktioniert nicht so. Statt Bilder in Text umzuwandeln und dann in einem separaten Schritt zu versuchen, die Bedeutung des Textes zu ermitteln, liest sie die gesamte Seite auf einmal, so wie es ein Mensch tut. Sie sieht das Layout. Sie versteht, dass „$3.247,00" neben dem Label „Gesamtbetrag fällig" der Betrag ist, den Sie schulden, während „$1.499,00" neben „Zwischensumme" etwas anderes ist — selbst wenn sie dieselbe Schriftart, dieselbe Größe und dieselbe Farbe haben.
Das ist keine bessere OCR-Engine. Es ist ein grundlegend anderer Ansatz. Das Modell verarbeitet das Dokument als visuelles Ganzes — Text, Layout, räumliche Beziehungen, alles gleichzeitig — und extrahiert Bedeutung, nicht nur Zeichen. Das Label „Rechnung #" und die Nummer „INV-2026-0417" sind nicht zwei getrennte Textteile. Sie sind eine Beziehung. Und VLMs verstehen Beziehungen.
Der Wandel geht von der positionsbasierten Extraktion — „die Rechnungsnummer befindet sich an den Koordinaten (450, 320)" — hin zur semantischen Extraktion — „finde den Wert, der ‚Rechnungsnummer' bedeutet, egal wo auf dieser Seite." Das ist keine Verbesserung der OCR. Das ist ein Ersatz des Paradigmas, auf dem OCR aufgebaut war. Für einen tieferen Einblick, wie das im Hintergrund funktioniert, lesen Sie unseren Erklärartikel darüber, wie KI Dokumente tatsächlich liest.
Wandel 2: Von Trainingsbedarf zu null Training
Bis vor Kurzem folgte jedes nicht-triviale Dokumentextraktions-Setup demselben Muster: Beispieldokumente sammeln, Felder beschriften, ein Modell trainieren, testen, neu trainieren, bereitstellen. Ein neuer Anbieter mit einem anderen Rechnungslayout? Mehr Beispiele sammeln, mehr Felder beschriften, neu trainieren. Die Dokumentverarbeitungsbranche hat das als „Onboarding" normalisiert. Aber es war kein Onboarding – es war eine wiederkehrende Steuer auf jedes neue Dokumentformat, das in Ihren Workflow kam.
Vision-Language-Modelle haben diesen Schritt komplett eliminiert. Weil sie Sprache und Layout so verstehen wie ein Mensch – über die Bedeutung, nicht über das Auswendiglernen von Positionen – müssen sie nicht auf Ihren Dokumenten trainiert werden. Sie müssen ihnen nicht 50 Rechnungen desselben Anbieters zeigen, bevor sie Daten aus der 51. extrahieren können. Sie müssen ihnen nicht einmal eine zeigen. Laden Sie ein Dokument von einem Anbieter hoch, den Sie noch nie gesehen haben, und die KI findet die Felder, weil sie versteht, wie eine Rechnung aussieht – nicht, weil sie sich gemerkt hat, wo ein bestimmter Anbieter Dinge platziert.
Die praktische Bedeutung kann man kaum überschätzen. Im alten Modell bedeutete die Verarbeitung von Dokumenten von 20 verschiedenen Anbietern die Pflege von 20 verschiedenen Vorlagen, von denen jede brechen würde, sobald ein Anbieter sein Formular neu gestaltete. Im neuen Modell verarbeitet ein System alle 20 – und die 21. und die 22. – ohne zusätzlichen Einrichtungsaufwand. Formatunabhängigkeit ist kein Premium-Feature. Sie ist die Grundlage.
Wandel 3: Von Enterprise-only zu 9 $ pro Monat
Hier ist eine Zahl, die die Geschichte besser erzählt als jede technische Erklärung: Mitte 2024 veröffentlichte OpenAI GPT-4o-mini mit einem Text-Input-Preis von 0,15 $ pro Million Tokens. Zum Vergleich: Das ursprüngliche GPT-4 von 2023 kostete 60 $ pro Million Input-Tokens. Das ist kein Rabatt. Das ist ein 400-facher Preisverfall in unter 18 Monaten.
Was das für die Dokumentverarbeitung bedeutet, ist strukturell. Vor 2023 kam KI-gestützte Dokumentextraktion auf Enterprise-Art – mit ABBYY, Kofax oder Rossum – mit Anschaffungskosten im Bereich von mehreren zehntausend Dollar plus laufender Wartung. Die Alternative war vorlagenbasierte OCR, die günstiger im Start war, aber durch Vorlagenpflege Geld verbrannte. Keine der beiden Optionen war sinnvoll für einen Solo-Buchhalter, ein Drei-Personen-Bauprüfbüro oder einen Freiberufler, der 40 Rechnungen pro Monat verarbeitet.
Diese Rechnung hat sich umgekehrt. Dieselbe Vision-KI-Technologie, die Enterprise-Dokumentenintelligenz antreibt, ist jetzt zu Verbraucherpreisen verfügbar – und in Tools, die für Einzelpersonen entwickelt wurden, nicht für Einkaufsabteilungen. Sie können sich anmelden, eine Rechnung hochladen, die gewünschten Spalten eingeben und in unter 30 Sekunden eine Tabelle erhalten. Kein Verkaufsgespräch. Kein Implementierungsberater. Keine Trainingsphase. Nur das Tool, das die Arbeit erledigt, für 9 $ pro Monat. Die zugrunde liegenden KI-Kosten, die das ermöglicht haben, sind um zwei Größenordnungen gefallen – und diese Einsparungen flossen direkt in die Zugänglichkeit.
Der IDP-Markt insgesamt soll von 3,2 Milliarden $ im Jahr 2024 auf über 14 Milliarden $ bis 2030 wachsen, bei einer CAGR von 35 %. Aber die Geschichte hinter dieser Zahl dreht sich nicht nur um skalierende Unternehmen. Es geht um den adressierbaren Markt, der sich nach unten erweitert – auf Menschen, die nie im Markt für Dokumentenautomatisierung waren, weil Dokumentenautomatisierung nie für sie bepreist war.
Was das konkret für Ihre Arbeit bedeutet
Es ist verlockend, das als Technologiegeschichte abzutun und weiterzuziehen. Doch der Grund, warum diese Veränderungen wichtig sind, hat nichts mit Modellarchitekturen oder API-Preiskurven zu tun. Es geht darum, welche Arten von Arbeit plötzlich automatisierbar wurden.
Rechnungen von 30 verschiedenen Lieferanten. Nach dem alten Modell bedeutete das 30 Vorlagen – oder 30 manuelle Eingaben. Jetzt ist es ein einziger Upload. Der KI ist es egal, dass jeder Lieferant seine Formate anders gestaltet. Sie liest jede Rechnung so, wie Sie es tun würden – indem sie die Felder findet, statt sie an bestimmten Positionen zu erwarten.
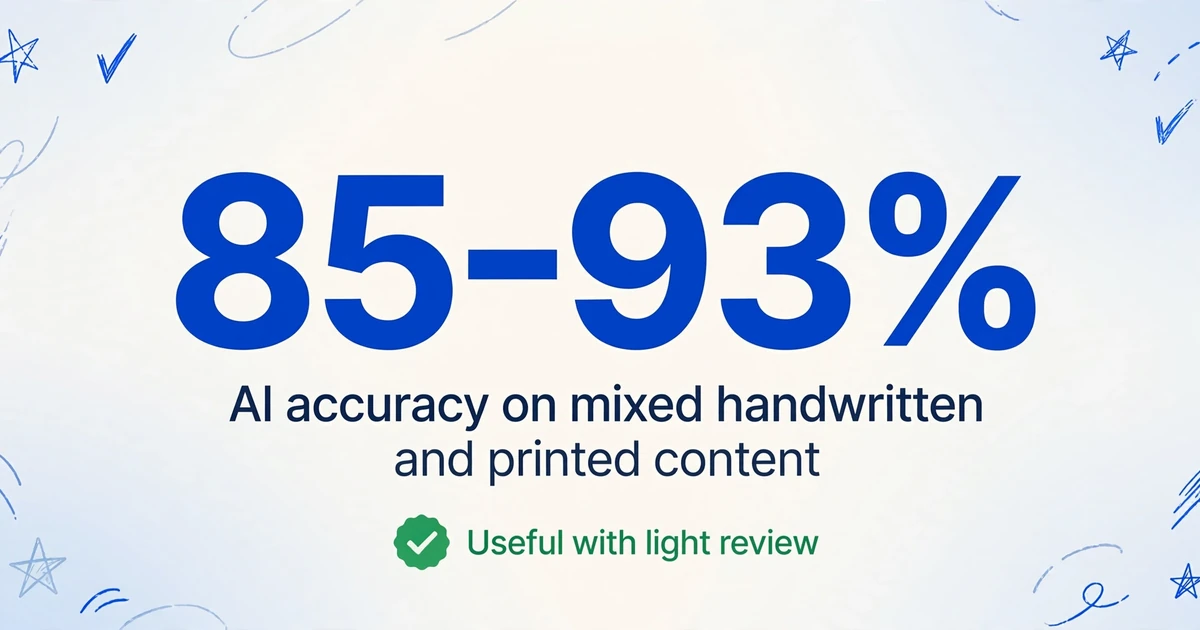
Handschriftliche Formulare. Die Genauigkeit traditioneller OCR bei Handschrift lag bei etwa 45–60%. Moderne Vision-Modelle erreichen 85–93% bei gemischten handschriftlichen und gedruckten Inhalten – immer noch nicht perfekt, aber über der Schwelle von „unbrauchbar" zu „mit kurzer Prüfung nutzbar". Der handschriftliche Inspektionsbericht eines Technikers, ein handschriftlich ausgefüllter Lieferschein, ein hingekritzeltes Quittungsstück – Dokumente, die kategorisch von der Automatisierung ausgeschlossen waren, sind jetzt mit dabei.
Dokumente, die Sie nur einmal bearbeiten. Ein Vertrag von einem neuen Kunden. Ein einmaliges Angebot eines Lieferanten. Ein medizinisches Formular eines Spezialisten, den Sie nie wiedersehen. Vorlagenbasierte Systeme scheiterten hier, weil es absurd ist, für etwas, das man nur einmal sieht, eine Vorlage zu erstellen. Extraktion ohne Training funktioniert hier, weil sie genau dafür entwickelt wurde – die Verarbeitung beliebiger Dokumente ohne Einrichtung.
Der gemeinsame Nenner ist nicht Geschwindigkeit. Es ist die Beseitigung von Reibung. Das alte Modell erzeugte an jedem Einstiegspunkt Reibung: neues Format → neue Vorlage → neue Ausnahme → menschliche Prüfung. Das neue Modell reduziert das auf: Upload → Extraktion → Prüfung. Weniger Schritte, weniger Entscheidungen, weniger Stellen, an denen sich Arbeit staut.
Sehen Sie den Unterschied in 30 Sekunden
Das nur in Absätzen zu beschreiben, hat seine Grenzen. Der echte „Aha"-Moment entsteht, wenn Sie den Unterschied direkt erleben. Unten finden Sie eine Live-Demo. Geben Sie die gewünschten Felder ein – etwa „Rechnungsnummer", „Lieferantenname", „Gesamtbetrag" – laden Sie eine Rechnung hoch und sehen Sie, was passiert. Ohne Vorlage. Ohne Training. Sie sagen der KI einfach, was Sie wollen, und sie findet es.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schnelle Antworten auf die Fragen, die Sie wahrscheinlich im Kopf haben
Ist OCR tot?
Nein — aber es wurde herabgestuft. OCR ist weiterhin das richtige Werkzeug für reine Digitalisierung: einen Scan einer gedruckten Seite in durchsuchbaren Text zu verwandeln. Aber für die Extraktion strukturierter Daten — Rechnungsfelder, Belegsummen, Vertragsklauseln nach Typ — ist OCR allein das falsche Werkzeug. Die Frage ist nicht „Soll ich OCR oder AI verwenden?“, sondern „Erfordert meine Aufgabe das Verstehen des Dokuments oder nur das Transkribieren?“ Wenn die Antwort Verstehen beinhaltet, ist OCR nicht die Lösung.
Wann ist dieser Wandel tatsächlich passiert?
Die Bausteine kamen zwischen 2023 und 2025 zusammen. GPT-4 mit Vision wurde 2023 eingeführt. GPT-4o brachte multimodale Geschwindigkeit und Genauigkeit im Mai 2024. GPT-4o-mini machte es im Juli 2024 erschwinglich — der Preisverfall, der die Tür für Tools auf Verbraucherebene öffnete. Anfang 2025 hatte sich der Markt für Dokumentenverarbeitung in zwei Lager gespalten: Legacy-OCR-Anbieter, die AI-Funktionen hinzufügten, und AI-native Tools, die auf dem neuen Paradigma aufbauten. Die Kluft setzte sich schnell fest.
Ist AI-Extraktion tatsächlich genauer als OCR?
Bei sauberen, gedruckten Dokumenten mit einheitlichem Format erreicht modernes OCR eine Zeichengenauigkeit von über 99 % — und AI ebenso; der Unterschied ist vernachlässigbar. Aber bei Dokumenten mit gemischten Layouts, Handschrift oder Formatvariabilität zieht die AI-Extraktion deutlich davon. Unabhängige Benchmarks von Anfang 2025 zeigten, dass die traditionelle OCR-Genauigkeit bei komplexen Dokumenten von mehreren Anbietern auf 60–75 % sinkt, während Vision-Language-Modelle eine Feldgenauigkeit von über 95 % beibehalten. Noch wichtiger: Die AI-Extraktion bricht nicht ein, wenn sich das Layout ändert — der Fehlermodus, der vorlagenbasierte OCR im großen Maßstab unwartbar macht.
Was ist mit Handschrift?
Ehrliche Antwort: Handschrift ist immer noch der schwierigste Fall, und kein System meistert sie perfekt. Traditionelles OCR schafft 45–60 % bei typischer Handschrift; AI-gestützte Extraktion erreicht 85–93 %. Das ist eine dramatische Verbesserung — genug, um Workflows mit leichter Prüfung praktikabel zu machen, wo sie vorher nicht waren — aber nicht genug für eine Automatisierung ohne Aufsicht. Wenn Ihre Dokumente zu 100 % handschriftlich sind, sollten Sie etwas Zeit für die Überprüfung der Ergebnisse einplanen. Wenn sie größtenteils gedruckt sind und nur gelegentlich handschriftliche Notizen enthalten, sind Sie gut aufgestellt.
Sind meine Dokumente bei der KI-Extraktion sicher?
Das hängt ganz vom gewählten Tool ab. Einige KI-Dokumenttools verarbeiten Dateien nur im Arbeitsspeicher, ohne sie nach der Extraktion zu speichern. Andere behalten Dokumente für Training oder Protokollierung. Bevor Sie vertrauliche Dokumente hochladen – Rechnungen mit Bankdaten, Verträge, medizinische Formulare – prüfen Sie die Datenverarbeitungsrichtlinie des Anbieters. Achten Sie insbesondere darauf: ob Dateien nach der Verarbeitung gespeichert werden, ob Daten für das Modelltraining verwendet werden und ob Sie hochgeladene Dateien auf Wunsch löschen können.
Ist die KI-Dokumentextraktion für Einzelpersonen erschwinglich?
Ja – das ist eine der drei Veränderungen, die die Landschaft neu gestaltet haben. Vor 2023 lautete die Antwort nein: KI-Dokumentextraktion bedeutete Unternehmensverträge und fünfstellige Jahresbudgets. Heute gibt es Verbrauchertools für 9–20 $/Monat, die für Einzelpersonen und kleine Teams entwickelt wurden. Der 400-fache Rückgang der zugrunde liegenden KI-Kosten hat dies ermöglicht. Sie brauchen keine IT-Abteilung, keinen Trainingsdatensatz und keinen Beschaffungsprozess. Sie brauchen einen Browser und ein Dokument.
Wenn Sie immer noch OCR verwenden – oder noch nie Dokumentautomatisierung genutzt haben – liegt das nicht daran, dass Sie zurückgefallen sind. Sondern daran, dass sich die letzten drei Jahre schneller bewegt haben, als Ihnen jemand gesagt hat.