OCRはご存じでしょう。
ここ3年の進化がすべてを変えました。
最後に「OCR」という言葉を聞いたのが2020年、あるいはそれ以前のスキャナーのマニュアルだったなら、その後の出来事を知る価値があります。30年の歴史全体ではなく、ここ3年だけです。この3年間はOCRを改良したのではありません。まったく別のものに置き換えたのです。
重要なポイント
- ご存じのOCRは文字を読み取れますが、「Total Due」の横の数字が支払うべき金額を意味することは理解できませんでした。これは30年にわたる最適化でも打破できなかった限界です。
- それを置き換えたものは、人間と同じようにドキュメントを読み取ります。ページ全体を一度にスキャンし、請求書番号を、どの隅にあるかではなく、その意味によって認識します。
- 基盤となるAIのコストは18か月で400分の1にまで下がりました。そのため、2023年には5桁のエンタープライズ契約が必要だったドキュメント抽出が、今では月額$9で利用できます。
記憶と現実のギャップ
2020年当時のOCRとはこういうものでした:書類をスキャンし、ソフトウェアが文字を読み取り、テキストファイルが得られる。書類がきれいでフォントが標準的なら、うまく機能しました。レイアウトが変わっていたり、手書きがあったり、スキャンが傾いていたりすると、機能しませんでした。各フィールドがページ上のどこにあるかをソフトウェアに教えるテンプレートを作るか、人間が出力を修正することを受け入れるか、どちらかでした。
それが限界でした。何十年もの間、業界全体がその範囲内で最適化を続けてきました — より高速なスキャン、より良い前処理、より洗練されたテンプレートエンジン。しかし、核心的な制限は決して変わりませんでした:OCRは文字を読むことができました。しかし、ドキュメントを読むことは決してできませんでした。
ドキュメントは単なる文字の山ではありません。請求書にはベンダー名、請求書番号、明細項目、支払期日、合計金額が含まれており、それらのフィールドには文字の形を超えた意味があります。「$3,247.00」という数字は、OCRエンジンにとっては単なるピクセルパターンです。人間にとっては、それは支払うべき金額であり、「$324.700」と「$3,247.00」を誤読する違いは、正しい請求書を支払うことと会計上の混乱を引き起こすことの違いです。
従来のOCRはそのギャップを決して越えられませんでした。そして、ドキュメントを扱う仕事に従事するほとんどの人々 — 会計士、オフィスマネージャー、中小企業の経営者、経費を追跡するフリーランサー — にとって、「ドキュメント自動化」は「スキャン」と同義のままでした。なぜなら、それが実際にそうだったからです。
そして2023年がやってきました。OCRが30年かけて達成しようとしていたこと — ドキュメントが何を言っているかだけでなく、何を意味するかを理解すること — が、OCRではない何かによって突然解決されたのです。
変わった3つのこと(誰もメモを送ってくれなかった)
2020年からこの分野から離れていたなら、これを見逃していたことになります。完全な文書処理の20年の歴史ではなく、すべてをひっくり返した3つのシフトだけをお伝えします。
シフト1:文字単位のマッチングからページ全体の理解へ
従来のOCRはこう動いていました。ページをピクセル単位でスキャンし、各パターンを文字形状のデータベースと照合し、最も近い一致を出力する。出力はフラットなテキストストリームで、段落、テーブル、フィールドの関係性という概念はありませんでした。「請求書番号」と「合計金額」が必要なら、それらのフィールドがページのどこにあるかをシステムに伝えるテンプレートが必要でした。レイアウトを変えれば、テンプレートは壊れます。
視覚言語モデル(VLM)を基盤とする新しい世代は、そうは動きません。画像をテキストに変換してから、そのテキストの意味を別のステップで解釈するのではなく、人間がするように、ページ全体を一度に読み取ります。レイアウトを見ます。「Total Due」というラベルの横にある「$3,247.00」が支払うべき金額であり、「Subtotal」の横にある「$1,499.00」が別のものであることを理解します。たとえ同じフォント、同じサイズ、同じ色であってもです。
これはより優れたOCRエンジンではありません。根本的に異なるアプローチです。モデルは文書を視覚的な全体として処理し、テキスト、レイアウト、空間的な関係性をすべて同時に扱い、文字だけでなく意味を抽出します。「Invoice #」というラベルと「INV-2026-0417」という数字は、別々のテキストではありません。それらは関係性です。そしてVLMは関係性を理解します。
このシフトは、位置ベースの抽出(「請求書番号は座標(450, 320)にある」)から、セマンティックベースの抽出(「このページのどこでも『請求書番号』を意味する値を見つける」)への移行です。これはOCRの改良ではありません。OCRが構築されたパラダイムの置き換えです。この仕組みの詳細については、AIが実際に文書を読む方法の解説をご覧ください。
シフト2:トレーニング必須からゼロトレーニングへ
つい最近まで、本格的な文書抽出の導入はすべて同じ手順を踏んでいました。サンプル文書を集め、フィールドにラベルを付け、モデルを学習させ、テストし、再学習し、デプロイする。異なる請求書レイアウトの新しいベンダーが登場したら? さらにサンプルを集め、さらにフィールドにラベルを付け、再学習する。文書処理業界はこれを「オンボーディング」として標準化しました。しかし、これはオンボーディングではありませんでした。ワークフローに加わる新しい文書フォーマットのたびに繰り返し課される税金だったのです。
VLMはこのステップを完全に排除しました。人間と同じように言語とレイアウトを理解するからです。つまり、位置を記憶するのではなく、意味で理解するのです。そのため、VLMをあなたの文書でトレーニングする必要はありません。同じベンダーの請求書を50枚見せてから51枚目のデータを抽出できるようにする必要もありません。1枚も見せる必要すらありません。見たことのないベンダーの文書をアップロードすれば、AIは請求書がどのようなものかを理解しているため、フィールドを見つけ出します。特定のベンダーがどこに何を配置するかを記憶しているからではありません。
この実務的な影響は、いくら強調してもしすぎることはありません。従来のモデルでは、20社の異なるベンダーの文書を処理するには20種類のテンプレートを維持する必要があり、そのどれもが、ベンダーがフォームを再設計した瞬間に壊れてしまいました。新しいモデルでは、1つのシステムが20社すべてを処理します。21社目も22社目も、追加設定ゼロで処理できます。フォーマット非依存はプレミアム機能ではありません。標準機能なのです。
シフト3:エンタープライズ専用から月額$9へ
どんな技術的な説明よりも、この状況を物語る数字があります。2024年半ば、OpenAIはGPT-4o-miniをリリースしました。テキスト入力価格は100万トークンあたり$0.15です。比較すると、2023年のオリジナルのGPT-4は、100万入力トークンあたり$60でした。これは割引ではありません。18か月足らずでの400倍の価格崩壊です。
これが文書処理に与える影響は構造的です。2023年以前、エンタープライズ向けのAI文書抽出、つまりABBYY、Kofax、Rossumを導入する場合、数万ドル単位の初期費用と、継続的なメンテナンス費用がかかりました。代替手段はテンプレートベースのOCRでしたが、初期費用は安いものの、テンプレートの維持で資金を消耗しました。どちらの選択肢も、個人事業の会計士、3人規模の建設事務所、月に40枚の請求書を処理するフリーランサーにとっては、現実的ではありませんでした。
その計算は逆転しました。エンタープライズの文書インテリジェンスを支えるのと同じビジョンAI技術が、今ではコンシューマー価格で利用できます。しかも、調達部門ではなく個人向けに設計されたツールでです。サインアップして、請求書をアップロードし、必要な列を入力すれば、30秒以内にスプレッドシートが得られます。営業電話も、導入コンサルタントも、トレーニング期間もありません。ただツールが仕事をするだけです。月額$9で。これを可能にした背景にあるAIコストは2桁下落し、その節約分はそのままアクセシビリティに還元されました。
IDP市場全体は、2024年の$3.2 billionから2030年までに$14 billion超へ、CAGR 35%で成長すると予測されています。しかし、その数字の背後にある物語は、単にエンタープライズが規模を拡大しているという話ではありません。対象市場が下方に拡大しているという話です。つまり、文書自動化が自分たち向けに価格設定されたことがなかったため、これまでその市場にいなかった人々にまで広がっているのです。
これが実際にあなたの仕事に意味すること
これを単なるテクノロジーの話として片付けて次に進むのは簡単です。しかし、これらの変化が重要な理由は、モデルアーキテクチャやAPI価格の推移とはまったく関係ありません。それは、どのような種類の作業が突然自動化可能になったかに関係しています。
30社の異なるサプライヤーからの請求書。 従来のモデルでは、30個のテンプレート、または30回の手動入力が必要でした。今では、アップロード1回です。AIは各サプライヤーのフォーマットが異なることを気にしません。特定の位置に項目があることを期待するのではなく、あなたが読むのと同じように、項目を探して各請求書を読み取ります。
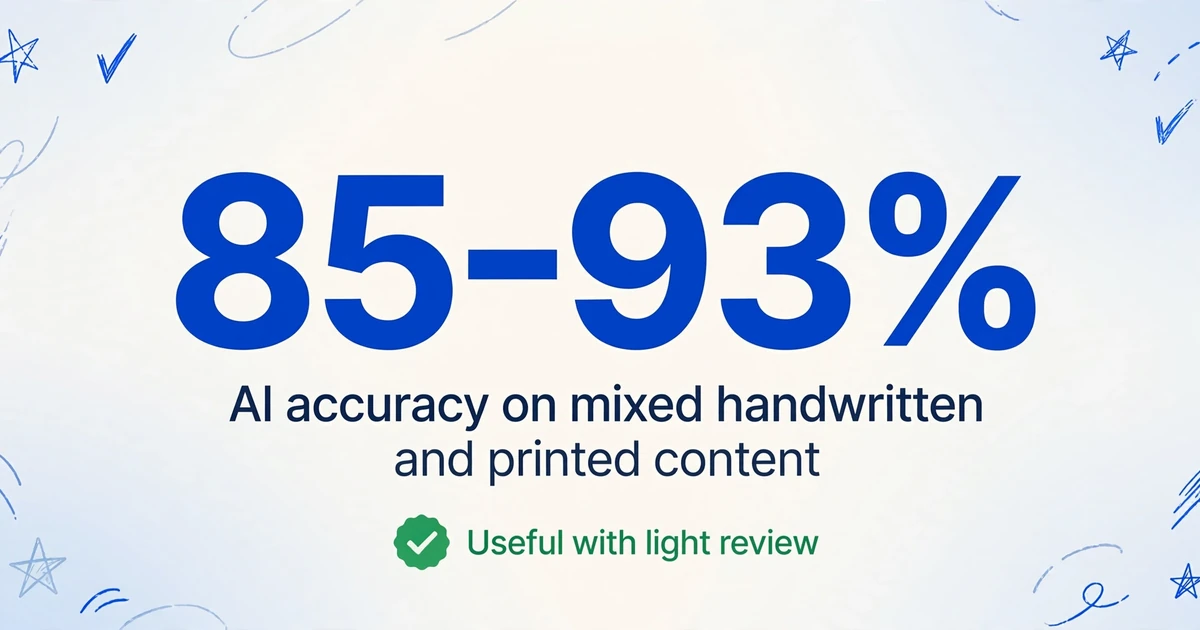
手書きのフォーム。 従来のOCRの手書き文字に対する精度は約45〜60%でした。最新のビジョンモデルは、手書きと印刷が混在するコンテンツに対して85〜93%の精度に達します。まだ完璧ではありませんが、「使えない」から「軽いレビューで実用可能」という閾値を超えています。現場技術者の手書きの点検報告書、手書きの納品書、走り書きの領収書 — これまで自動化の対象から完全に除外されていた文書が、今や対象内に入りました。
一度しか扱わない文書。 新しいクライアントからの契約書。一度きりのベンダー見積書。二度と会うことのない専門医からの医療フォーム。テンプレートベースのシステムはここで失敗しました。なぜなら、一度しか見ないもののためにテンプレートを作るのは不合理だからです。ゼロトレーニング抽出は、まさにこのために設計されているため、ここで機能します — セットアップなしで任意の文書を処理します。
共通する点はスピードではありません。それは摩擦の除去です。従来のモデルは、あらゆる入り口で摩擦を生み出しました:新しいフォーマット → 新しいテンプレート → 新しい例外 → 人間によるレビュー。新しいモデルはこれを次のように削減します:アップロード → 抽出 → レビュー。ステップが減り、判断が減り、作業が滞留する場所が減ります。
30秒で違いを実感
文章で説明するのには限界があります。本当の「なるほど」は、実際に体験してみて初めて訪れます。以下がライブデモです。抽出したいフィールド(例:「請求書番号」「ベンダー名」「合計金額」)を入力し、請求書をアップロードして、何が起こるか見てみてください。テンプレート不要、トレーニング不要。AIに欲しいものを伝えるだけで、AIがそれを見つけ出します。
ファイルは安全に処理され、保存されることはありません。
よくある質問へのクイックアンサー
OCRは死んだのか?
いいえ——しかし、その役割は格下げされました。OCRは、印刷されたページのスキャンを検索可能なテキストに変換する純粋なデジタル化には今でも適したツールです。しかし、構造化データの抽出——請求書のフィールド、レシートの合計、契約条項のタイプ別抽出——には、OCR単独では不適切です。問題は「OCRを使うべきか、AIを使うべきか」ではありません。「タスクがドキュメントの理解を必要とするのか、それとも単なる書き起こしなのか」です。答えが理解を伴うものであれば、OCRは解決策ではありません。
この変化は実際にいつ起きたのか?
その要素は2023年から2025年にかけて積み重なりました。GPT-4 with visionは2023年に登場しました。GPT-4oは2024年5月にマルチモーダルの速度と精度をもたらしました。GPT-4o-miniは2024年7月にそれを手頃な価格にしました——消費者向けツールへの扉を開いた価格崩壊です。2025年初頭までに、ドキュメント処理市場は2つの陣営に分かれました:AI機能を追加するレガシーOCRベンダーと、新しいパラダイムから構築するAIネイティブツールです。その隔たりは急速に定着しました。
AI抽出は実際にOCRよりも正確なのか?
きれいな印刷物で単一フォーマットのドキュメントでは、最新のOCRは99%以上の文字精度を達成し、AIも同様です——その差は無視できるほどです。しかし、レイアウトが混在したドキュメント、手書き、またはフォーマットのばらつきがある場合、AI抽出は劇的にリードします。2025年初頭の独立したベンチマークでは、従来のOCR精度は複雑なマルチベンダーのドキュメントでは60〜75%に低下する一方、視覚言語モデルはフィールドレベルの精度を95%以上に維持することがわかりました。さらに重要なのは、AI抽出はレイアウトが変わっても壊れないことです——テンプレートベースのOCRを大規模に維持不可能にする障害モードです。
手書きはどうか?
正直な答え:手書きは今でも最も難しいケースであり、完璧に処理できるシステムはありません。従来のOCRは一般的な手書きで45〜60%を処理しますが、AI搭載の抽出は85〜93%に達します。これは劇的な改善です——以前は実現できなかった軽いレビューワークフローを可能にするほどですが、完全な自動化には十分ではありません。ドキュメントが100%手書きの場合は、結果のレビューに時間を費やすことを想定してください。ほとんどが印刷物で、時折手書きのメモがある程度なら、問題ありません。
AI抽出で書類は安全ですか?
これは選択するツールに完全に依存します。一部のAI書類ツールはファイルをメモリ上でのみ処理し、抽出後に保存しません。他のツールはトレーニングやログ記録のために書類を保持します。機密書類(銀行口座情報を含む請求書、契約書、医療フォーム)をアップロードする前に、プロバイダーのデータ取り扱いポリシーを確認してください。具体的に確認すべき点:処理後にファイルが保存されるか、データがモデルトレーニングに使用されるか、アップロードしたファイルをオンデマンドで削除できるか。
AI書類抽出は個人でも手頃な価格ですか?
はい — これは状況を変えた3つの変化の1つです。2023年以前は答えはノーでした:AI書類抽出はエンタープライズ契約と5桁の年間コミットメントを意味していました。今日では、個人や小規模チーム向けに設計された消費者向けツールが月額$9–20で存在します。基盤となるAIコストの400倍の低下がこれを可能にしました。IT部門、トレーニングデータセット、調達プロセスは必要ありません。必要なのはブラウザと書類だけです。
まだOCRを使用している場合 — または文書自動化をまったく使用したことがない場合 — それは遅れを取ったからではありません。過去3年間が誰も教えてくれなかったほど速く進んだからです。