Conoces el OCR.
Aquí está el salto de 3 años que lo cambia todo.
Si la última vez que escuchó la palabra "OCR" fue en 2020 — o antes, en un manual de escáner — merece saber qué pasó. No toda la historia de 30 años. Solo los últimos tres años. Porque esos tres años no mejoraron el OCR. Lo reemplazaron con algo completamente diferente.
Conclusiones Clave
- El OCR que recuerda puede leer caracteres, pero nunca pudo entender que el número junto a "Total a Pagar" significa lo que usted debe — un límite que tres décadas de optimización nunca superaron.
- Lo que lo reemplazó lee documentos como lo haría un humano: escanea una página completa de una vez y reconoce un número de factura por lo que significa, no por la esquina en la que se encuentra.
- El costo subyacente de la IA se desplomó 400× en 18 meses — por eso la extracción de documentos que requería un contrato empresarial de cinco cifras en 2023 ahora está disponible por $9 al mes.
La brecha entre lo que recuerdas y lo que es real
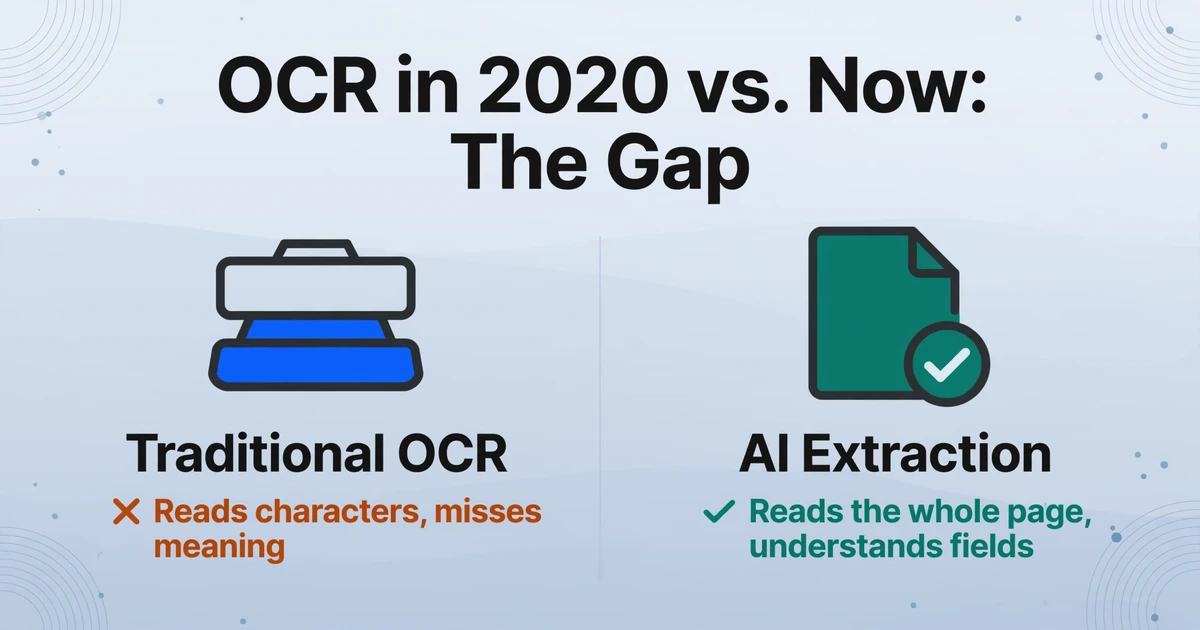
Esto es lo que significaba OCR en 2020: escaneas un documento, el software lee los caracteres y obtienes un archivo de texto. Si el documento estaba limpio y la fuente era estándar, funcionaba. Si el diseño era inusual, o había escritura a mano, o el escaneo estaba torcido — no funcionaba. O construías una plantilla para decirle al software dónde vivía cada campo en la página, o aceptabas que un humano necesitaría corregir el resultado.
Ese era el techo. Durante décadas, toda la industria optimizó dentro de él — escaneo más rápido, mejor preprocesamiento, motores de plantillas más sofisticados. Pero la limitación central nunca se movió: el OCR podía leer caracteres. Nunca podía leer un documento.
Un documento no es solo un montón de caracteres. Una factura contiene un nombre de proveedor, un número de factura, partidas, una fecha de vencimiento, un total — y esos campos tienen un significado que va más allá de las formas de las letras que los deletrean. El número "$3,247.00" es solo patrones de píxeles para un motor de OCR. Para un humano, es la cantidad que debes, y la diferencia entre leerlo mal como "$324.700" o "$3,247.00" es la diferencia entre pagar la factura correcta y crear un desastre contable.
El OCR tradicional nunca cruzó esa brecha. Y para la mayoría de las personas cuyo trabajo involucra documentos — contadores, gerentes de oficina, propietarios de pequeñas empresas, freelancers que rastrean gastos — "automatización de documentos" seguía siendo sinónimo de "escaneo". Porque eso era lo que era.
Entonces llegó 2023. Y lo que el OCR pasó 30 años tratando de hacer — entender lo que un documento significa, no solo lo que dice — fue repentinamente resuelto por algo que no era OCR en absoluto.
Tres cosas que cambiaron (y nadie le envió un memo al respecto)
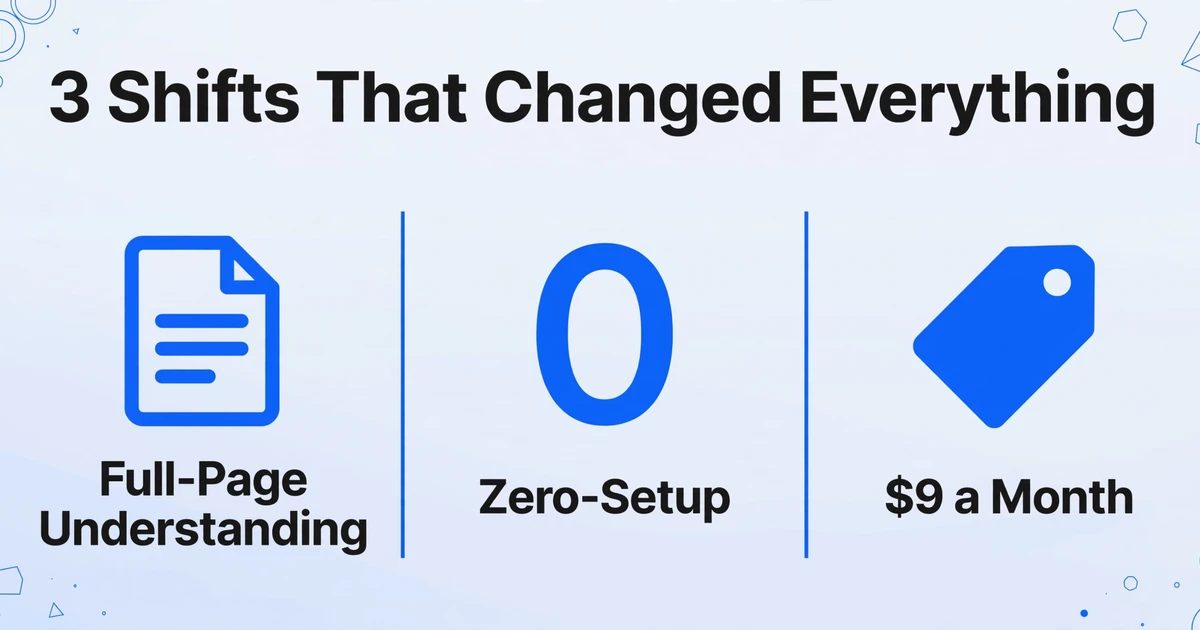
Si ha estado alejado de este espacio desde 2020, esto es lo que se perdió. No la historia completa de 20 años del procesamiento de documentos — solo los tres cambios que lo pusieron todo de cabeza.
Cambio 1: De la coincidencia por carácter a la comprensión de página completa
El OCR tradicional funcionaba así: escaneaba la página píxel por píxel, comparaba cada patrón contra una base de datos de formas de caracteres y generaba la coincidencia más cercana. El resultado era un flujo de texto plano, sin concepto de párrafos, tablas o relaciones entre campos. Si quería el "Número de factura" y el "Monto total", necesitaba una plantilla que le indicara al sistema dónde en la página vivían esos campos. Cambie el diseño y rompa la plantilla.
La nueva generación — construida sobre modelos de lenguaje de visión, o VLM — no funciona así. En lugar de convertir imágenes a texto y luego intentar descifrar qué significa el texto como un paso separado, lee la página completa de una vez, como lo haría un humano. Ve el diseño. Entiende que "$3,247.00" junto a la etiqueta "Total a pagar" es el monto que debe, mientras que "$1,499.00" junto a "Subtotal" es algo diferente — incluso si tienen la misma fuente, el mismo tamaño y el mismo color.
Esto no es un mejor motor de OCR. Es un enfoque fundamentalmente diferente. El modelo procesa el documento como un todo visual — texto, diseño, relaciones espaciales, todo a la vez — y extrae significado, no solo caracteres. La etiqueta "Factura #" y el número "INV-2026-0417" no son dos piezas de texto separadas. Son una relación. Y los VLM entienden las relaciones.
El cambio va de la extracción basada en posición — "el número de factura vive en las coordenadas (450, 320)" — a la extracción basada en semántica — "encuentre el valor que significa 'número de factura' en cualquier parte de esta página." Eso no es una mejora del OCR. Es un reemplazo del paradigma sobre el que se construyó el OCR. Para una mirada más profunda sobre cómo funciona esto internamente, lea nuestro explicador sobre cómo la IA realmente lee documentos.
Cambio 2: De Requiere Entrenamiento a Cero Entrenamiento
Hasta hace poco, toda configuración de extracción de documentos no trivial seguía el mismo guion: recopilar documentos de muestra, etiquetar campos, entrenar un modelo, probar, reentrenar, implementar. ¿Un nuevo proveedor con un diseño de factura diferente? Recopilar más muestras, etiquetar más campos, reentrenar. La industria del procesamiento de documentos normalizó esto como "incorporación". Pero no era incorporación — era un impuesto recurrente por cada nuevo formato de documento que entraba en su flujo de trabajo.
Los modelos de lenguaje visual eliminaron este paso por completo. Debido a que entienden el lenguaje y el diseño como lo hace una persona — por significado, no por memorizar posiciones — no necesitan ser entrenados en sus documentos. No necesita mostrarles 50 facturas del mismo proveedor antes de que puedan extraer datos de la 51. Ni siquiera necesita mostrarles una. Suba un documento de un proveedor que nunca haya visto, y la IA encuentra los campos porque entiende cómo se ve una factura — no porque haya memorizado dónde coloca las cosas un proveedor específico.
La implicación práctica es difícil de exagerar. En el modelo antiguo, procesar documentos de 20 proveedores diferentes significaba mantener 20 plantillas diferentes, cada una de las cuales se rompería en el momento en que un proveedor rediseñara su formulario. En el nuevo modelo, un solo sistema maneja los 20 — y el 21, y el 22 — con cero configuración adicional. La independencia del formato no es una característica premium. Es la base.
Cambio 3: De Solo Empresas a $9 al Mes
Aquí hay un número que cuenta la historia mejor que cualquier explicación técnica: a mediados de 2024, OpenAI lanzó GPT-4o-mini, con un precio de entrada de texto de $0.15 por millón de tokens. En comparación, el GPT-4 original de 2023 costaba $60 por millón de tokens de entrada. Eso no es un descuento. Es un colapso de precios de 400x en menos de 18 meses.
Lo que esto significa para el procesamiento de documentos es estructural. Antes de 2023, la extracción de documentos impulsada por IA a la manera empresarial — implementando ABBYY, Kofax o Rossum — conllevaba costos iniciales medidos en decenas de miles de dólares, más mantenimiento continuo. La alternativa era el OCR basado en plantillas, que era más barato de iniciar pero sangraba dinero a través del mantenimiento de plantillas. Ninguna opción tenía sentido para un contador independiente, una oficina de construcción de tres personas o un freelancer que procesa 40 facturas al mes.
Esa matemática se ha invertido. La misma tecnología de IA visual que impulsa la inteligencia documental empresarial ahora está disponible a precios de consumo — y en herramientas diseñadas para individuos, no para departamentos de compras. Puede registrarse, subir una factura, escribir las columnas que desea y obtener una hoja de cálculo en menos de 30 segundos. Sin llamada de ventas. Sin consultor de implementación. Sin período de entrenamiento. Solo la herramienta, haciendo el trabajo, a $9 al mes. Los costos de IA subyacentes que hicieron esto posible cayeron en dos órdenes de magnitud — y esos ahorros se transfirieron directamente a la accesibilidad.
Se proyecta que el mercado de IDP en su conjunto crezca de $3.2 mil millones en 2024 a más de $14 mil millones para 2030, a una CAGR del 35%. Pero la historia detrás de ese número no se trata solo de empresas escalando. Se trata del mercado direccionable expandiéndose hacia abajo — hacia personas que nunca estuvieron en el mercado de la automatización de documentos porque la automatización de documentos nunca tuvo un precio para ellas.
Lo que esto significa realmente para su trabajo
Es fácil tratar esto como una historia de tecnología y seguir adelante. Pero la razón por la que estos cambios importan no tiene nada que ver con las arquitecturas de modelos ni con las curvas de precios de las API. Tiene que ver con qué tipos de trabajo se volvieron repentinamente automatizables.
Facturas de 30 proveedores diferentes. Con el modelo antiguo, eso significaba 30 plantillas — o 30 entradas manuales. Ahora es una sola carga. A la IA no le importa que cada proveedor formatee las cosas de manera diferente. Lee cada factura como lo haría usted — encontrando los campos, no esperándolos en posiciones específicas.
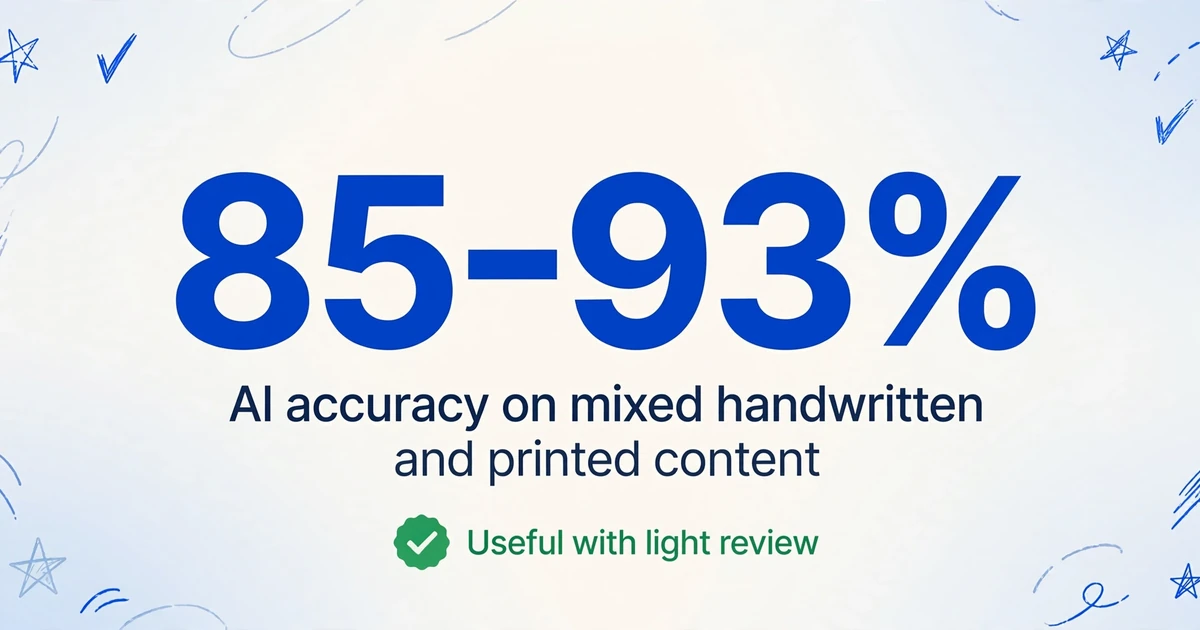
Formularios manuscritos. La precisión del OCR tradicional en escritura a mano rondaba el 45–60%. Los modelos de visión modernos alcanzan el 85–93% en contenido mixto manuscrito e impreso — aún no es perfecto, pero cruza el umbral de "inutilizable" a "útil con revisión ligera". El informe de inspección manuscrito de un técnico de campo, una nota de entrega rellenada a mano, un recibo garabateado — documentos que estaban categóricamente excluidos de la automatización ahora están dentro del juego.
Documentos que solo maneja una vez. Un contrato de un cliente nuevo. Una cotización única de un proveedor. Un formulario médico de un especialista que nunca volverá a ver. Los sistemas basados en plantillas fallaban aquí porque crear una plantilla para algo que verá una sola vez es absurdo. La extracción sin entrenamiento funciona aquí porque fue diseñada exactamente para esto — manejar documentos arbitrarios sin configuración.
El hilo común no es la velocidad. Es la eliminación de fricción. El modelo antiguo creaba fricción en cada punto de entrada: nuevo formato → nueva plantilla → nueva excepción → revisión humana. El nuevo modelo reduce eso a: cargar → extraer → revisar. Menos pasos, menos decisiones, menos lugares donde el trabajo se acumule.
Vea la diferencia en 30 segundos
Describir esto solo con párrafos tiene un límite. El momento real de "ah, ya veo" llega al experimentar la diferencia directamente. A continuación hay una demo en vivo. Escriba los campos que desee — por ejemplo, "Número de factura", "Nombre del proveedor", "Monto total" — suba una factura y observe qué sucede. Sin plantilla. Sin entrenamiento. Solo usted indicándole a la IA lo que quiere, y ella lo encuentra.
Los archivos se procesan de forma segura y no se almacenan.
Respuestas rápidas a las preguntas que probablemente tiene en mente
¿Está muerto el OCR?
No, pero ha sido degradado. El OCR sigue siendo la herramienta adecuada para la digitalización pura: convertir un escaneo de una página impresa en texto buscable. Pero para extraer datos estructurados — campos de facturas, totales de recibos, cláusulas de contratos por tipo — el OCR por sí solo es la herramienta equivocada. La pregunta no es "¿debo usar OCR o IA?" sino "¿mi tarea requiere comprender el documento o solo transcribirlo?". Si la respuesta implica comprensión, el OCR no es la solución.
¿Cuándo ocurrió realmente este cambio?
Los elementos se acumularon entre 2023 y 2025. GPT-4 con visión se lanzó en 2023. GPT-4o trajo velocidad y precisión multimodal en mayo de 2024. GPT-4o-mini lo hizo asequible en julio de 2024 — el colapso de precios que abrió la puerta a herramientas de nivel consumidor. A principios de 2025, el mercado de procesamiento de documentos se había dividido en dos bandos: los proveedores de OCR heredados que añadían funciones de IA, y las herramientas nativas de IA que construían desde el nuevo paradigma. La división se consolidó rápido.
¿La extracción con IA es realmente más precisa que el OCR?
En documentos limpios, impresos y de formato único, el OCR moderno alcanza una precisión de caracteres superior al 99% y la IA también — la diferencia es insignificante. Pero en documentos con diseños mixtos, escritura a mano o variabilidad de formato, la extracción con IA se destaca drásticamente. Pruebas independientes de principios de 2025 encontraron que, mientras la precisión del OCR tradicional cae al 60–75% en documentos complejos de múltiples proveedores, los modelos de lenguaje de visión mantienen una precisión a nivel de campo superior al 95%. Más importante aún, la extracción con IA no falla cuando cambia el diseño — el modo de fallo que hace que el OCR basado en plantillas sea insostenible a escala.
¿Y la escritura a mano?
Respuesta honesta: la escritura a mano sigue siendo el caso más difícil, y ningún sistema la maneja perfectamente. El OCR tradicional logra un 45–60% en escritura a mano típica; la extracción impulsada por IA alcanza el 85–93%. Es una mejora drástica — suficiente para hacer viables los flujos de revisión ligera donde antes no lo eran — pero no suficiente para la automatización sin supervisión. Si sus documentos son 100% manuscritos, espere dedicar tiempo a revisar los resultados. Si son mayormente impresos con notas manuscritas ocasionales, está en buena posición.
¿Están seguros mis documentos con la extracción por IA?
Esto depende completamente de la herramienta que elijas. Algunas herramientas de documentos con IA procesan archivos solo en memoria, sin almacenarlos después de la extracción. Otras retienen documentos para entrenamiento o registro. Antes de subir documentos sensibles — facturas con datos bancarios, contratos, formularios médicos — revisa la política de manejo de datos del proveedor. Busca específicamente: si los archivos se almacenan después del procesamiento, si los datos se usan para entrenar modelos, y si puedes eliminar los archivos subidos cuando lo solicites.
¿Es asequible la extracción de documentos con IA para particulares?
Sí — este es uno de los tres cambios que transformaron el panorama. Antes de 2023, la respuesta era no: la extracción de documentos con IA implicaba contratos empresariales y compromisos anuales de cinco cifras. Hoy existen herramientas de consumo a $9–20/mes, diseñadas para particulares y pequeños equipos. La caída de 400x en los costos subyacentes de IA hizo esto posible. No necesitas un departamento de TI, un conjunto de datos de entrenamiento ni un proceso de adquisición. Necesitas un navegador y un documento.
Si todavía usas OCR — o nunca usaste la automatización de documentos — no es porque te quedaste atrás. Es porque los últimos tres años avanzaron más rápido de lo que nadie te contó.