Vous connaissez l'OCR.
Voici le bond de 3 ans qui change tout.
Si la dernière fois que vous avez entendu le mot « OCR », c'était en 2020 — ou avant, dans un manuel de scanner — vous méritez de savoir ce qui s'est passé. Pas les 30 ans d'histoire. Juste les trois dernières années. Parce que ces trois années n'ont pas amélioré l'OCR. Elles l'ont remplacé par quelque chose de totalement différent.
Points clés
- L'OCR que vous connaissez peut lire les caractères mais n'a jamais pu comprendre que le nombre à côté de « Total dû » signifie ce que vous devez — un plafond que trois décennies d'optimisation n'ont jamais brisé.
- Ce qui l'a remplacé lit les documents comme un humain — en balayant une page entière d'un coup et en reconnaissant un numéro de facture par ce qu'il signifie, pas par le coin où il se trouve.
- Le coût sous-jacent de l'AI a chuté de 400× en 18 mois — c'est pourquoi l'extraction de documents qui nécessitait un contrat d'entreprise à cinq chiffres en 2023 est désormais disponible pour $9 par mois.
L'écart entre ce dont vous vous souvenez et la réalité
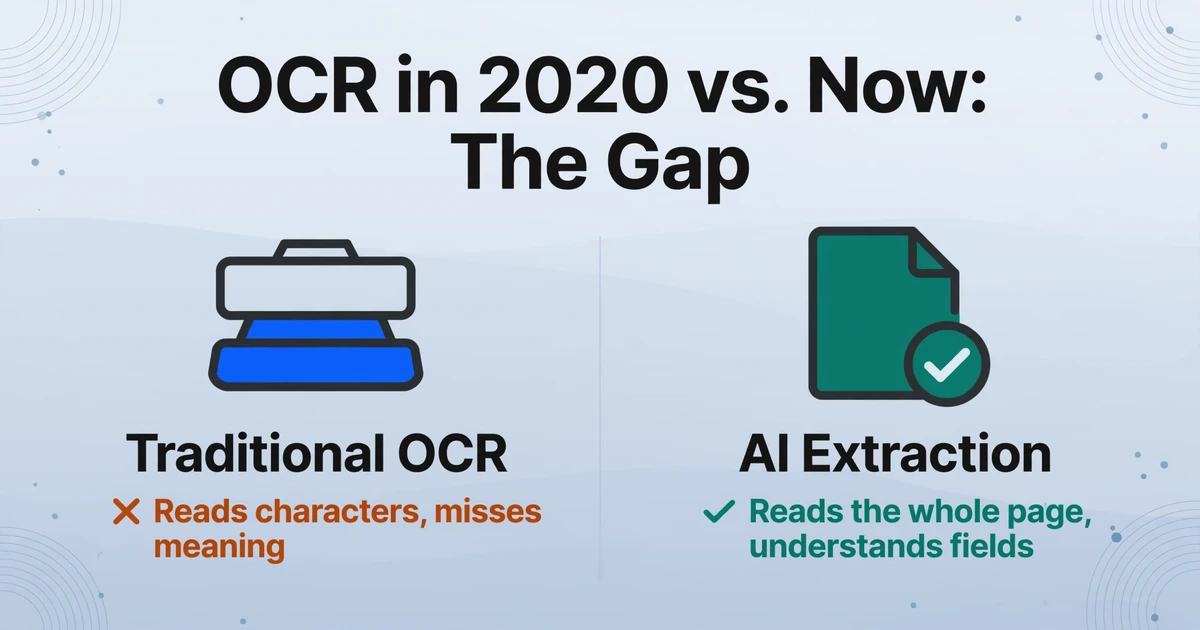
Voici ce que signifiait l'OCR en 2020 : vous scannez un document, le logiciel lit les caractères et vous obtenez un fichier texte. Si le document était propre et la police standard, ça fonctionnait. Si la mise en page était inhabituelle, s'il y avait de l'écriture manuscrite ou si le scan était de travers, ça ne fonctionnait pas. Soit vous construisiez un modèle pour indiquer au logiciel où se trouvait chaque champ sur la page, soit vous acceptiez qu'un humain doive corriger le résultat.
C'était le plafond. Pendant des décennies, toute l'industrie s'est optimisée à l'intérieur de celui-ci : scan plus rapide, meilleur prétraitement, moteurs de modèles plus sophistiqués. Mais la limitation fondamentale n'a jamais bougé : l'OCR pouvait lire des caractères. Il ne pouvait jamais lire un document.
Un document n'est pas qu'un tas de caractères. Une facture contient un nom de fournisseur, un numéro de facture, des lignes de détail, une date d'échéance, un total — et ces champs ont un sens qui dépasse la forme des lettres qui les épellent. Le nombre « $3,247.00 » n'est qu'un ensemble de motifs de pixels pour un moteur OCR. Pour un humain, c'est le montant que vous devez, et la différence entre le lire de travers comme « $324.700 » ou « $3,247.00 » est la différence entre payer la bonne facture et créer un désastre comptable.
L'OCR traditionnel n'a jamais franchi cet écart. Et pour la plupart des personnes dont le travail implique des documents — comptables, responsables de bureau, propriétaires de petites entreprises, indépendants suivant leurs dépenses — « automatisation documentaire » est resté synonyme de « numérisation ». Parce que c'était exactement cela.
Puis 2023 est arrivé. Et ce que l'OCR a passé 30 ans à essayer de faire — comprendre ce qu'un document signifie, pas seulement ce qu'il dit — a soudain été résolu par quelque chose qui n'était pas de l'OCR du tout.
Trois changements (dont personne ne vous a informé)
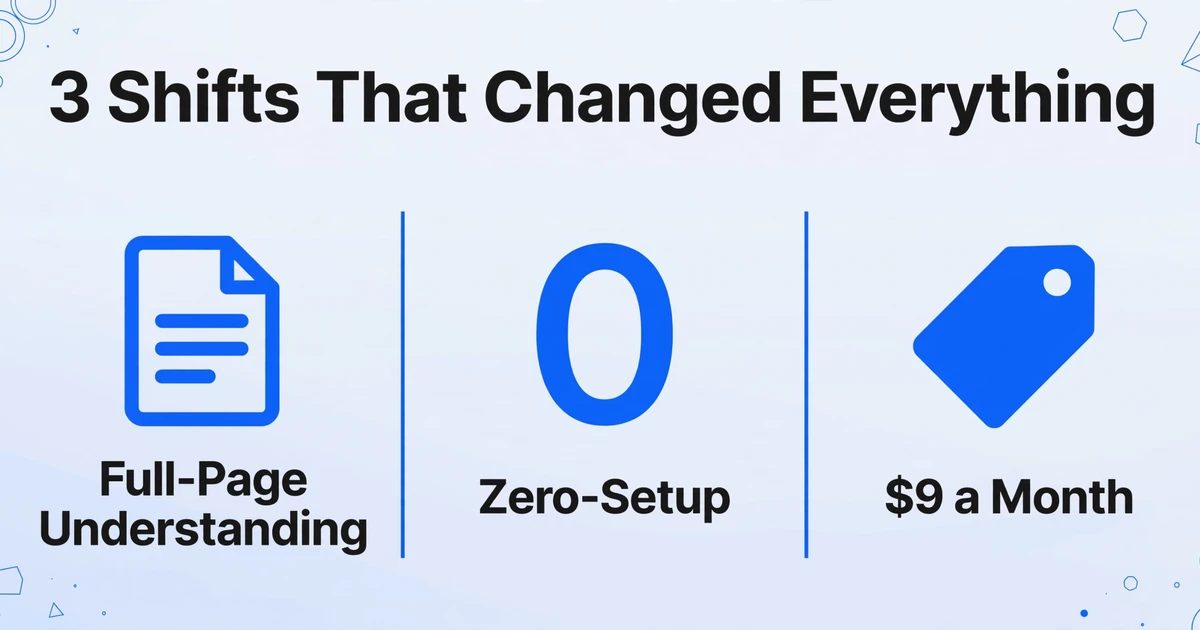
Si vous avez délaissé ce domaine depuis 2020, voici ce que vous avez manqué. Pas l'intégralité des 20 ans d'histoire du traitement documentaire — juste les trois changements qui ont tout bouleversé.
Changement 1 : de la correspondance caractère par caractère à la compréhension de la page entière
L'OCR traditionnel fonctionnait ainsi : scanner la page pixel par pixel, comparer chaque motif à une base de données de formes de caractères, produire la correspondance la plus proche. Le résultat était un flux de texte brut — sans notion de paragraphes, de tableaux ni de relations entre champs. Si vous vouliez « Numéro de facture » et « Montant total », il vous fallait un modèle indiquant au système où, sur la page, ces champs se trouvaient. Changez la mise en page, le modèle était cassé.
La nouvelle génération — fondée sur les modèles de langage visuels, ou VLM — ne fonctionne pas ainsi. Au lieu de convertir les images en texte puis d'essayer de comprendre le sens de ce texte dans une étape séparée, elle lit la page entière d'un coup, comme le ferait un humain. Elle voit la mise en page. Elle comprend que « 3 247,00 $ » à côté du libellé « Total dû » est le montant que vous devez, tandis que « 1 499,00 $ » à côté de « Sous-total » est autre chose — même s'ils ont la même police, la même taille et la même couleur.
Ce n'est pas un meilleur moteur OCR. C'est une approche fondamentalement différente. Le modèle traite le document comme un tout visuel — texte, mise en page, relations spatiales, le tout en une fois — et extrait le sens, pas seulement les caractères. Le libellé « Facture n° » et le numéro « INV-2026-0417 » ne sont pas deux éléments de texte distincts. Ils forment une relation. Et les VLM comprennent les relations.
Le changement consiste à passer d'une extraction basée sur la position — « le numéro de facture se trouve aux coordonnées (450, 320) » — à une extraction basée sur le sens — « trouvez la valeur qui signifie "numéro de facture" n'importe où sur cette page ». Ce n'est pas une amélioration de l'OCR. C'est le remplacement du paradigme sur lequel l'OCR a été bâti. Pour un examen plus approfondi de son fonctionnement interne, lisez notre explication sur la façon dont l'AI lit réellement les documents.
Changement 2 : De « nécessite un entraînement » à « zéro entraînement »
Jusqu'à récemment, toute configuration non triviale d'extraction de documents suivait le même scénario : collecter des documents d'exemple, étiqueter les champs, entraîner un modèle, tester, réentraîner, déployer. Un nouveau fournisseur avec une mise en page de facture différente ? Collectez plus d'échantillons, étiquetez plus de champs, réentraînez. L'industrie du traitement de documents a normalisé cela sous le nom d'« onboarding ». Mais ce n'était pas de l'onboarding — c'était une taxe récurrente sur chaque nouveau format de document entrant dans votre flux de travail.
Les modèles de langage visuels ont éliminé cette étape entièrement. Parce qu'ils comprennent le langage et la mise en page comme un humain — par le sens, pas en mémorisant des positions — ils n'ont pas besoin d'être entraînés sur vos documents. Vous n'avez pas besoin de leur montrer 50 factures du même fournisseur avant qu'ils puissent extraire des données de la 51e. Vous n'avez même pas besoin de leur en montrer une. Téléchargez un document d'un fournisseur que vous n'avez jamais vu auparavant, et l'AI trouve les champs parce qu'elle comprend à quoi ressemble une facture — pas parce qu'elle a mémorisé où un fournisseur spécifique place les choses.
L'implication pratique est difficile à surestimer. Dans l'ancien modèle, traiter des documents de 20 fournisseurs différents signifiait maintenir 20 modèles différents, chacun d'entre eux se brisant dès qu'un fournisseur redessinait son formulaire. Dans le nouveau modèle, un seul système gère les 20 — et le 21e, et le 22e — sans configuration supplémentaire. L'indépendance du format n'est pas une fonctionnalité premium. C'est la base.
Changement 3 : De « réservé aux entreprises » à 9 $ par mois
Voici un chiffre qui raconte l'histoire mieux que toute explication technique : à la mi-2024, OpenAI a publié GPT-4o-mini, avec un prix d'entrée de texte de 0,15 $ par million de tokens. À titre de comparaison, le GPT-4 original de 2023 coûtait 60 $ par million de tokens en entrée. Ce n'est pas une réduction. C'est un effondrement des prix de 400x en moins de 18 mois.
Ce que cela signifie pour le traitement de documents est structurel. Avant 2023, l'extraction de documents alimentée par l'AI à la manière des entreprises — déployer ABBYY, Kofax ou Rossum — s'accompagnait de coûts initiaux mesurés en dizaines de milliers de dollars, plus la maintenance continue. L'alternative était l'OCR basé sur des modèles, moins cher au départ mais qui saignait de l'argent par l'entretien des modèles. Aucune option n'avait de sens pour un comptable solo, un bureau de construction de trois personnes, ou un freelance qui traite 40 factures par mois.
Ce calcul s'est inversé. La même technologie d'AI visuelle qui alimente l'intelligence documentaire des entreprises est désormais disponible à des prix grand public — et dans des outils conçus pour les individus, pas pour les services d'approvisionnement. Vous pouvez vous inscrire, télécharger une facture, taper les colonnes que vous voulez, et obtenir un tableur en moins de 30 secondes. Pas d'appel commercial. Pas de consultant en implémentation. Pas de période d'entraînement. Juste l'outil, qui fait le travail, à 9 $ par mois. Les coûts sous-jacents de l'AI qui ont rendu cela possible ont chuté de deux ordres de grandeur — et ces économies se sont directement traduites en accessibilité.
Le marché de l'IDP dans son ensemble devrait croître de 3,2 milliards de dollars en 2024 à plus de 14 milliards de dollars d'ici 2030, avec un TCAC de 35 %. Mais l'histoire derrière ce chiffre ne concerne pas seulement les entreprises qui passent à l'échelle. Il s'agit du marché adressable qui s'étend vers le bas — vers des personnes qui n'ont jamais été sur le marché de l'automatisation documentaire parce que l'automatisation documentaire n'a jamais été tarifée pour elles.
Ce que cela signifie concrètement pour votre travail
Il est facile de considérer cela comme une histoire technologique et de passer à autre chose. Mais la raison pour laquelle ces évolutions comptent n'a rien à voir avec les architectures de modèles ou les courbes de tarification des API. Elle tient à ce qui est soudain devenu automatisable.
Des factures de 30 fournisseurs différents. Avec l'ancien modèle, cela signifiait 30 modèles — ou 30 saisies manuelles. Désormais, c'est un seul envoi. L'AI se moque que chaque fournisseur présente les choses différemment. Elle lit chaque facture comme vous le feriez — en trouvant les champs, sans attendre qu'ils soient à des positions précises.
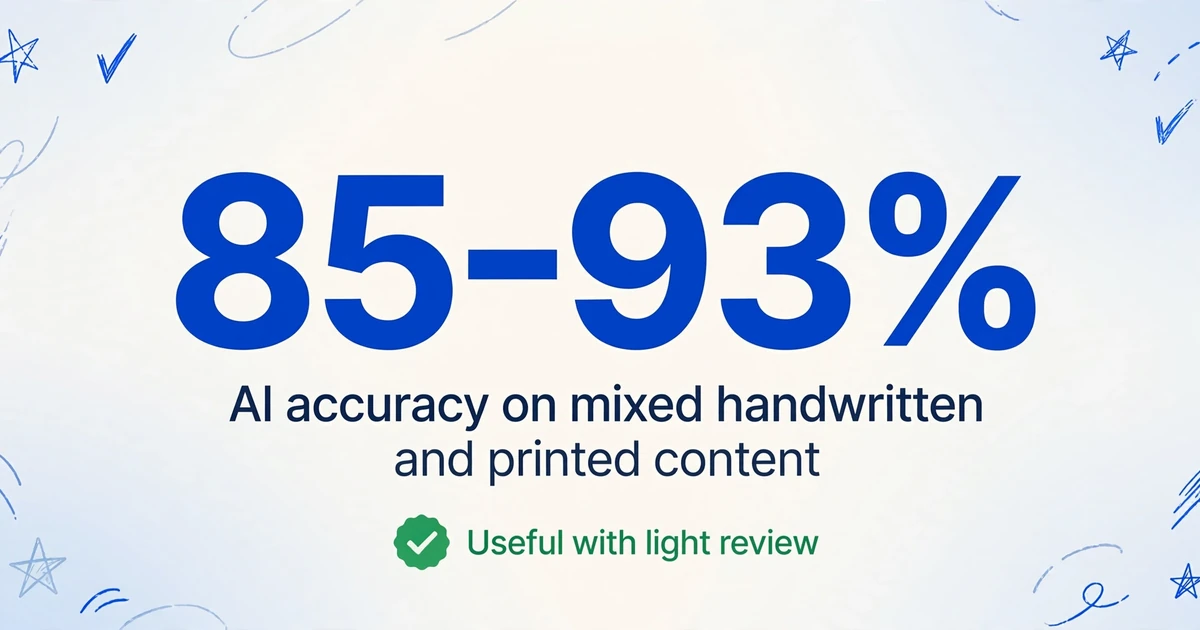
Formulaires manuscrits. La précision de l'OCR traditionnel sur l'écriture manuscrite tournait autour de 45–60%. Les modèles de vision modernes atteignent 85–93% sur du contenu mixte manuscrit et imprimé — encore imparfait, mais franchissant le seuil entre « inutilisable » et « utile avec une légère relecture ». Le rapport d'inspection manuscrit d'un technicien de terrain, un bon de livraison rempli à la main, un reçu griffonné — des documents qui étaient catégoriquement exclus de l'automatisation entrent désormais dans le champ des possibles.
Documents que vous ne traitez qu'une seule fois. Un contrat d'un nouveau client. Un devis ponctuel d'un fournisseur. Un formulaire médical d'un spécialiste que vous ne reverrez jamais. Les systèmes basés sur des modèles échouaient ici, car créer un modèle pour quelque chose que vous ne verrez qu'une fois est absurde. L'extraction sans entraînement fonctionne ici parce qu'elle a été conçue exactement pour cela — traiter des documents arbitraires sans configuration.
Le fil conducteur n'est pas la vitesse. C'est la suppression des frictions. L'ancien modèle créait des frictions à chaque point d'entrée : nouveau format → nouveau modèle → nouvelle exception → relecture humaine. Le nouveau modèle réduit cela à : envoi → extraction → relecture. Moins d'étapes, moins de décisions, moins d'endroits où le travail s'accumule.
Voyez la différence en 30 secondes
Décrire cela en paragraphes ne suffit pas. Le vrai moment « ah, je vois » vient en expérimentant la différence directement. Ci-dessous, une démo en direct. Saisissez les champs souhaités — par exemple, « Invoice Number », « Vendor Name », « Total Amount » — importez une facture et observez ce qui se passe. Pas de modèle. Pas d'entraînement. Vous dites simplement à l'AI ce que vous voulez, et elle le trouve.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Réponses rapides aux questions que vous vous posez probablement
L'OCR est-il mort ?
Non — mais il a été rétrogradé. L'OCR reste le bon outil pour la numérisation pure : transformer le scan d'une page imprimée en texte recherchable. Mais pour extraire des données structurées — champs de facture, totaux de reçu, clauses de contrat par type — l'OCR seul est le mauvais outil. La question n'est pas « dois-je utiliser l'OCR ou l'AI ? » mais « ma tâche exige-t-elle de comprendre le document, ou simplement de le transcrire ? » Si la réponse implique de comprendre, l'OCR n'est pas la solution.
Quand ce basculement a-t-il réellement eu lieu ?
Les pièces se sont accumulées entre 2023 et 2025. GPT-4 avec vision a été lancé en 2023. GPT-4o a apporté la vitesse et la précision multimodales en mai 2024. GPT-4o-mini les a rendues abordables en juillet 2024 — l'effondrement des prix qui a ouvert la voie aux outils grand public. Début 2025, le marché du traitement documentaire s'était scindé en deux camps : les fournisseurs OCR historiques ajoutant des fonctionnalités d'AI, et les outils natifs AI bâtis sur le nouveau paradigme. La fracture s'est stabilisée rapidement.
L'extraction par AI est-elle vraiment plus précise que l'OCR ?
Sur des documents propres, imprimés et d'un seul format, l'OCR moderne atteint plus de 99 % de précision au niveau des caractères, et l'AI aussi — la différence est négligeable. Mais sur des documents aux mises en page mixtes, manuscrits ou à format variable, l'extraction par AI prend largement l'avantage. Des benchmarks indépendants de début 2025 ont montré que, tandis que la précision de l'OCR traditionnel chute à 60–75 % sur des documents complexes multi-fournisseurs, les VLM maintiennent une précision au niveau des champs supérieure à 95 %. Plus important encore, l'extraction par AI ne casse pas quand la mise en page change — le mode de défaillance qui rend l'OCR basé sur des modèles ingérable à grande échelle.
Et l'écriture manuscrite ?
Réponse honnête : l'écriture manuscrite reste le cas le plus difficile, et aucun système ne la gère parfaitement. L'OCR traditionnel atteint 45–60 % sur une écriture manuscrite typique ; l'extraction par AI atteint 85–93 %. C'est une amélioration spectaculaire — suffisante pour rendre viables les flux de travail avec relecture légère là où ils ne l'étaient pas — mais pas suffisante pour une automatisation sans intervention. Si vos documents sont manuscrits à 100 %, prévoyez de passer du temps à vérifier les résultats. S'ils sont majoritairement imprimés avec quelques notes manuscrites occasionnelles, vous êtes en bonne posture.
Mes documents sont-ils sécurisés avec l'extraction par AI ?
Cela dépend entièrement de l'outil que vous choisissez. Certains outils de traitement de documents par AI traitent les fichiers uniquement en mémoire, sans les stocker après l'extraction. D'autres conservent les documents pour l'entraînement ou la journalisation. Avant de téléverser des documents sensibles — factures avec coordonnées bancaires, contrats, formulaires médicaux — vérifiez la politique de traitement des données du fournisseur. Recherchez spécifiquement : si les fichiers sont stockés après traitement, si les données sont utilisées pour l'entraînement du modèle, et si vous pouvez supprimer les fichiers téléversés à la demande.
L'extraction de documents par AI est-elle abordable pour les particuliers ?
Oui — c'est l'un des trois changements qui ont transformé le paysage. Avant 2023, la réponse était non : l'extraction de documents par AI impliquait des contrats d'entreprise et des engagements annuels à cinq chiffres. Aujourd'hui, des outils grand public existent à $9–20/mois, conçus pour les particuliers et les petites équipes. La baisse de 400x des coûts sous-jacents de l'AI a rendu cela possible. Vous n'avez pas besoin d'un service informatique, d'un jeu de données d'entraînement ni d'un processus d'achat. Vous avez besoin d'un navigateur et d'un document.
Si vous utilisez encore l'OCR — ou n'avez jamais utilisé l'automatisation documentaire — ce n'est pas parce que vous avez pris du retard. C'est parce que les trois dernières années ont évolué plus vite que ce que quiconque vous a dit.