Você conhece o OCR.
Veja o salto de 3 anos que muda tudo.
Se a última vez que você ouviu a palavra "OCR" foi em 2020 — ou antes, em um manual de scanner — você merece saber o que aconteceu. Não os 30 anos de história. Apenas os últimos três anos. Porque esses três anos não melhoraram o OCR. Eles o substituíram por algo completamente diferente.
Principais Conclusões
- O OCR que você lembra consegue ler caracteres, mas nunca foi capaz de entender que o número ao lado de "Total Due" significa o que você deve — um teto que três décadas de otimização nunca quebraram.
- O que o substituiu lê documentos como um humano — escaneando uma página inteira de uma vez e reconhecendo um número de fatura pelo que ele significa, não pelo canto onde está.
- O custo subjacente da AI caiu 400× em 18 meses — é por isso que a extração de documentos que exigia um contrato empresarial de cinco dígitos em 2023 agora está disponível por $9 por mês.
A Lacuna Entre o Que Você Lembra e o Que É Real
Eis o que o OCR significava em 2020: você escaneia um documento, o software lê os caracteres e você obtém um arquivo de texto. Se o documento estivesse limpo e a fonte fosse padrão, funcionava. Se o layout fosse incomum, ou houvesse escrita à mão, ou o escaneamento estivesse torto — não funcionava. Ou você criava um modelo para dizer ao software onde cada campo ficava na página, ou aceitava que um humano precisaria corrigir o resultado.
Esse era o teto. Durante décadas, toda a indústria otimizou dentro dele — escaneamento mais rápido, melhor pré-processamento, motores de modelo mais sofisticados. Mas a limitação central nunca mudou: o OCR conseguia ler caracteres. Nunca conseguia ler um documento.
Um documento não é apenas um monte de caracteres. Uma fatura contém o nome de um fornecedor, um número de fatura, itens de linha, uma data de vencimento, um total — e esses campos têm significado que vai além das formas das letras que os compõem. O número "$3,247.00" é apenas padrões de pixels para um motor de OCR. Para um humano, é o valor que você deve, e a diferença entre lê-lo errado como "$324.700" ou "$3,247.00" é a diferença entre pagar a conta certa e criar uma bagunça contábil.
O OCR tradicional nunca cruzou essa lacuna. E para a maioria das pessoas cujo trabalho envolve documentos — contadores, gerentes de escritório, donos de pequenos negócios, freelancers controlando despesas — "automação de documentos" permaneceu sinônimo de "escaneamento". Porque era isso que era.
Então 2023 aconteceu. E aquilo que o OCR passou 30 anos tentando fazer — entender o que um documento significa, não apenas o que ele diz — foi de repente resolvido por algo que não era OCR de forma alguma.
Três Coisas Que Mudaram (E Ninguém Te Enviou um Memorando Sobre Isso)
Se você está longe desse assunto desde 2020, aqui está o que você perdeu. Não o histórico completo de 20 anos do processamento de documentos — apenas as três mudanças que viraram tudo de cabeça para baixo.
Mudança 1: Da Correspondência por Caractere à Compreensão da Página Inteira
O OCR tradicional funcionava assim: escaneie a página pixel por pixel, compare cada padrão com um banco de dados de formas de caracteres, produza a correspondência mais próxima. A saída era um fluxo de texto plano — sem noção de parágrafos, tabelas ou relações entre campos. Se você quisesse "Número da Fatura" e "Valor Total", precisaria de um modelo que dissesse ao sistema onde na página esses campos ficavam. Mude o layout, quebre o modelo.
A nova geração — construída sobre modelos de linguagem visual, ou VLMs — não funciona assim. Em vez de converter imagens em texto e depois tentar descobrir o que o texto significa como uma etapa separada, ela lê a página inteira de uma vez, como um humano faz. Ela vê o layout. Entende que "$3,247.00" ao lado do rótulo "Total Devido" é o valor que você deve, enquanto "$1,499.00" ao lado de "Subtotal" é outra coisa — mesmo que tenham a mesma fonte, o mesmo tamanho, a mesma cor.
Este não é um motor de OCR melhor. É uma abordagem fundamentalmente diferente. O modelo processa o documento como um todo visual — texto, layout, relações espaciais, tudo de uma vez — e extrai significado, não apenas caracteres. O rótulo "Fatura #" e o número "INV-2026-0417" não são dois pedaços separados de texto. Eles são uma relação. E os VLMs entendem relações.
A mudança é da extração baseada em posição — "o número da fatura fica nas coordenadas (450, 320)" — para a extração baseada em semântica — "encontre o valor que significa 'número da fatura' em qualquer lugar desta página". Isso não é uma melhoria no OCR. É uma substituição do paradigma sobre o qual o OCR foi construído. Para uma análise mais profunda de como isso funciona por baixo do capô, leia nosso explicativo sobre como a AI realmente lê documentos.
Mudança 2: De Exige Treinamento a Zero Treinamento
Até recentemente, toda configuração de extração de documentos não trivial seguia o mesmo roteiro: coletar documentos de exemplo, rotular campos, treinar um modelo, testar, retreinar, implantar. Um novo fornecedor com um layout de fatura diferente? Coletar mais exemplos, rotular mais campos, retreinar. A indústria de processamento de documentos normalizou isso como "onboarding". Mas não era onboarding — era um imposto recorrente sobre cada novo formato de documento que entrava no seu fluxo de trabalho.
Os modelos de linguagem visual eliminaram essa etapa por completo. Como entendem a linguagem e o layout da mesma forma que um humano — pelo significado, não por memorizar posições —, eles não precisam ser treinados nos seus documentos. Você não precisa mostrar a eles 50 faturas do mesmo fornecedor antes que consigam extrair dados da 51ª. Você nem precisa mostrar uma. Faça upload de um documento de um fornecedor que nunca viu antes, e a AI encontra os campos porque entende como é uma fatura — não porque memorizou onde um fornecedor específico coloca as coisas.
A implicação prática é difícil de exagerar. No modelo antigo, processar documentos de 20 fornecedores diferentes significava manter 20 modelos diferentes, cada um dos quais quebraria no momento em que um fornecedor redesenhasse seu formulário. No novo modelo, um sistema lida com todos os 20 — e com o 21º, e o 22º — sem nenhuma configuração adicional. A independência de formato não é um recurso premium. É o básico.
Mudança 3: De Exclusivo para Empresas a $9 por Mês
Aqui está um número que conta a história melhor do que qualquer explicação técnica: em meados de 2024, a OpenAI lançou o GPT-4o-mini, com preço de entrada de texto de $0.15 por milhão de tokens. Para comparação, o GPT-4 original de 2023 custava $60 por milhão de tokens de entrada. Isso não é um desconto. É um colapso de preço de 400x em menos de 18 meses.
O que isso significa para o processamento de documentos é estrutural. Antes de 2023, a extração de documentos com AI no estilo empresarial — implantando ABBYY, Kofax ou Rossum — vinha com custos iniciais medidos em dezenas de milhares de dólares, além de manutenção contínua. A alternativa era o OCR baseado em modelo, que era mais barato para começar, mas sangrava dinheiro com a manutenção dos modelos. Nenhuma das opções fazia sentido para um contador autônomo, um escritório de construção de três pessoas ou um freelancer que processa 40 faturas por mês.
Essa matemática se inverteu. A mesma tecnologia de AI visual que alimenta a inteligência de documentos empresarial agora está disponível a preços de consumidor — e em ferramentas projetadas para indivíduos, não para departamentos de compras. Você pode se cadastrar, fazer upload de uma fatura, digitar as colunas que deseja e obter uma planilha em menos de 30 segundos. Sem ligação de vendas. Sem consultor de implementação. Sem período de treinamento. Apenas a ferramenta, fazendo o trabalho, a $9 por mês. Os custos subjacentes de AI que tornaram isso possível caíram duas ordens de magnitude — e essas economias se traduziram diretamente em acessibilidade.
O mercado de IDP como um todo deve crescer de $3.2 bilhões em 2024 para mais de $14 bilhões até 2030, a um CAGR de 35%. Mas a história por trás desse número não é apenas sobre empresas expandindo. É sobre o mercado endereçável se expandindo para baixo — para pessoas que nunca estiveram no mercado de automação de documentos porque a automação de documentos nunca teve um preço para elas.
O que isso realmente significa para o seu trabalho
É fácil tratar isso como uma história de tecnologia e seguir em frente. Mas o motivo pelo qual essas mudanças importam não tem nada a ver com arquiteturas de modelo ou curvas de preço de API. Tem a ver com que tipos de trabalho de repente se tornaram automatizáveis.
Faturas de 30 fornecedores diferentes. No modelo antigo, isso significava 30 modelos — ou 30 entradas manuais. Agora é um único upload. A AI não se importa que cada fornecedor formate as coisas de maneira diferente. Ela lê cada fatura como você faria — encontrando os campos, não esperando que estejam em posições específicas.
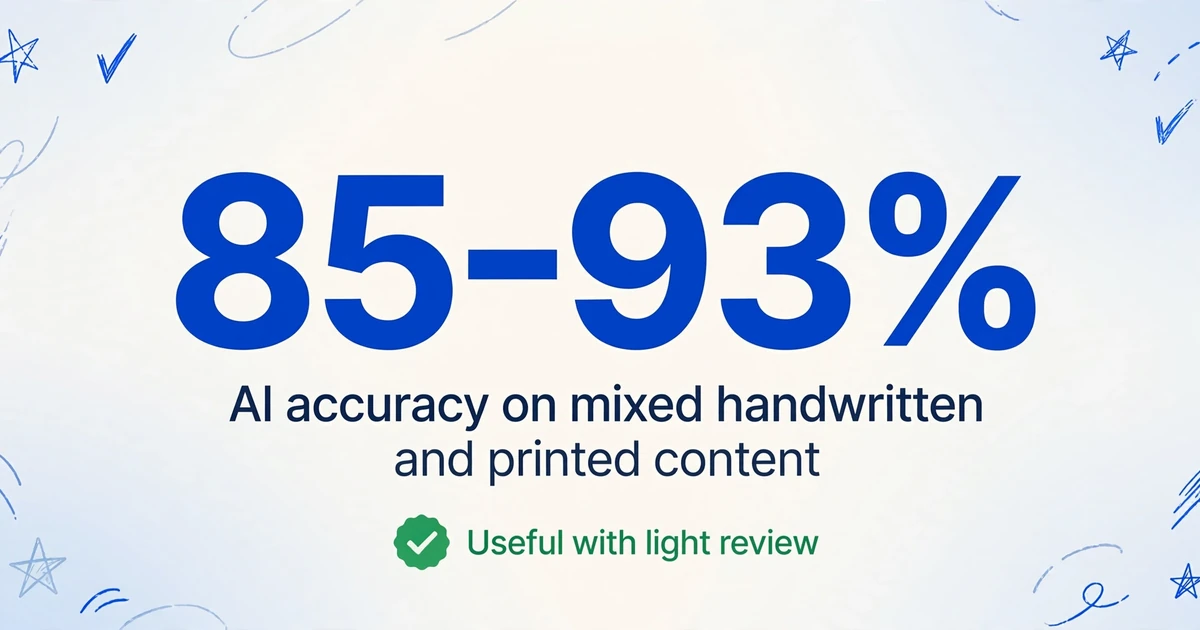
Formulários manuscritos. A precisão do OCR tradicional em manuscritos girava em torno de 45–60%. Os modelos de visão modernos alcançam 85–93% em conteúdo misto manuscrito e impresso — ainda não é perfeito, mas cruzando o limiar de "inutilizável" para "útil com revisão leve". O relatório de inspeção manuscrito de um técnico de campo, uma nota de entrega preenchida à mão, um recibo rabiscado — documentos que eram categoricamente excluídos da automação agora estão dentro do escopo.
Documentos que você só lida uma vez. Um contrato de um novo cliente. Um orçamento pontual de fornecedor. Um formulário médico de um especialista que você nunca mais verá. Sistemas baseados em modelo falhavam aqui porque criar um modelo para algo que você verá uma vez é absurdo. A extração sem treinamento funciona aqui porque foi projetada exatamente para isso — lidar com documentos arbitrários sem configuração.
O fio condutor não é a velocidade. É a remoção de atrito. O modelo antigo criava atrito em cada ponto de entrada: novo formato → novo modelo → nova exceção → revisão humana. O novo modelo reduz isso a: upload → extração → revisão. Menos etapas, menos decisões, menos lugares para o trabalho se acumular.
Veja a Diferença em 30 Segundos
Descrever isso em parágrafos só vai até certo ponto. O verdadeiro momento de "ah, entendi" vem de experimentar a diferença diretamente. Abaixo está uma demonstração ao vivo. Digite os campos que você quer — por exemplo, "Invoice Number", "Vendor Name", "Total Amount" — envie uma fatura e veja o que acontece. Sem modelo. Sem treinamento. Apenas você dizendo à AI o que quer, e ela encontrando.
Os arquivos são processados com segurança e não são armazenados.
Respostas Rápidas para as Perguntas que Você Provavelmente Tem
O OCR está morto?
Não — mas foi rebaixado. O OCR ainda é a ferramenta certa para digitalização pura: transformar a digitalização de uma página impressa em texto pesquisável. Mas para extrair dados estruturados — campos de fatura, totais de recibos, cláusulas de contrato por tipo — o OCR sozinho é a ferramenta errada. A questão não é "devo usar OCR ou AI?" É "minha tarefa exige entender o documento ou apenas transcrevê-lo?" Se a resposta envolve entender, o OCR não é a solução.
Quando essa mudança realmente aconteceu?
As peças se acumularam entre 2023 e 2025. O GPT-4 com visão foi lançado em 2023. O GPT-4o trouxe velocidade e precisão multimodais em maio de 2024. O GPT-4o-mini tornou tudo acessível em julho de 2024 — o colapso de preços que abriu a porta para ferramentas de nível consumidor. No início de 2025, o mercado de processamento de documentos havia se dividido em dois campos: fornecedores legados de OCR adicionando recursos de AI, e ferramentas nativas de AI construídas a partir do novo paradigma. A divisão se consolidou rapidamente.
A extração por AI é realmente mais precisa que o OCR?
Em documentos limpos, impressos e de formato único, o OCR moderno atinge 99%+ de precisão de caracteres e a AI também — a diferença é insignificante. Mas em documentos com layouts mistos, escrita à mão ou variabilidade de formato, a extração por AI se destaca drasticamente. Benchmarks independentes do início de 2025 descobriram que, enquanto a precisão do OCR tradicional cai para 60–75% em documentos complexos de vários fornecedores, os modelos de linguagem visual mantêm precisão em nível de campo acima de 95%. Mais importante, a extração por AI não quebra quando o layout muda — o modo de falha que torna o OCR baseado em modelo insustentável em escala.
E a escrita à mão?
Resposta honesta: a escrita à mão ainda é o caso mais difícil, e nenhum sistema lida com ela perfeitamente. O OCR tradicional alcança 45–60% em escrita à mão típica; a extração com AI chega a 85–93%. É uma melhoria dramática — suficiente para viabilizar fluxos de revisão leve onde antes não eram — mas não o suficiente para automação sem intervenção. Se seus documentos são 100% escritos à mão, espere gastar algum tempo revisando os resultados. Se são majoritariamente impressos com anotações ocasionais à mão, você está em boa forma.
Meus documentos estão seguros com a extração por AI?
Isso depende inteiramente da ferramenta que você escolher. Algumas ferramentas de documentos com AI processam os arquivos apenas na memória, sem armazená-los após a extração. Outras retêm os documentos para treinamento ou registro. Antes de enviar documentos sensíveis — faturas com dados bancários, contratos, formulários médicos — verifique a política de tratamento de dados do fornecedor. Procure especificamente por: se os arquivos são armazenados após o processamento, se os dados são usados para treinamento de modelos e se você pode excluir os arquivos enviados quando quiser.
A extração de documentos com AI é acessível para indivíduos?
Sim — esta é uma das três mudanças que transformaram o cenário. Antes de 2023, a resposta era não: a extração de documentos com AI significava contratos empresariais e compromissos anuais de cinco dígitos. Hoje, existem ferramentas de consumo por $9–20/mês, projetadas para indivíduos e pequenas equipes. A queda de 400x nos custos subjacentes de AI tornou isso possível. Você não precisa de um departamento de TI, de um conjunto de dados de treinamento nem de um processo de compras. Você precisa de um navegador e de um documento.
Se você ainda usa OCR — ou nunca usou automação de documentos — não é porque você ficou para trás. É porque os últimos três anos avançaram mais rápido do que qualquer um lhe disse.