Falschpositive Ergebnisse von LLM-Bewertungsmodellen
in Tabellen-OCR-Benchmarks
Bei OmniDocBench v1.6, einem öffentlichen Benchmark für Dokumenten-Parsing, erreichen aktuelle Tabellen-Parser über 93 TEDS, den Standardwert für Tabellenstruktur. Bei einem schwierigeren Satz realer Tabellen in derselben Studie von 2026 erreichte der stärkste Parser 85,03 (arXiv:2608.09842). Die übliche Lesart ist, dass ein Benchmark einfacher ist als der andere. Es gibt eine zweite Lesart: Zwischen einer geparsten Tabelle und der Zahl auf der Bestenliste steht ein Bewertungsinstrument, und bei vielen Tabellen-Benchmarks ist dieses Instrument ein LLM-Bewertungsmodell – ein Modell, das die Ausgabe des Parsers benoten soll und dessen eigene Fehlerrate nie neben dem Score steht.
Die wichtigsten Erkenntnisse
- Ein LLM-Bewertungsmodell – ein Modell, das die Ausgabe des Parsers benotet – erreicht bei menschlichen Tabellen-Scores r = 0,93, während TEDS 0,68 schafft.
- Bei einer Falschpositivrate des Bewertungsmodells von 8 % wird ein zu 99 % korrekter Parser mit 91,1 % Genauigkeit veröffentlicht.
- Fragen Sie nach der Falschpositivrate des Bewertungsmodells bei Tabellen, die konstruktionsbedingt korrekt sind, denn ohne sie lässt sich eine Lücke von einem Punkt nicht interpretieren.
Jede Table-OCR-Bewertung durchläuft ein Bewertungsmodell
Eine Table-OCR-Benchmark-Bewertung misst zwei Dinge gleichzeitig: den Parser und die Bewertungsfunktion, die ihn benotet.
Deterministische Metriken vergleichen die geparste Tabelle auf feste Weise mit einer Referenz. TEDS (Tree-Edit-Distance-based Similarity) verwandelt beide Tabellen in Bäume und zählt die Änderungen zwischen ihnen. Zellbasiertes F1 vergleicht Werte nach Position. CER (character error rate) zählt Zeicheneinfügungen, -ersetzungen und -löschungen. Jede ist reproduzierbar, günstig und beruht auf einer Normalisierungsentscheidung: ob Groß- und Kleinschreibung zählt, ob 1,234.00 gleich 1234 ist, ob eine leere Zelle einem leeren String entspricht.
Ein LLM judge ersetzt diese feste Regel durch eine semantische Entscheidung. Er erhält das Tabellenbild und die geparste Ausgabe und beantwortet, ob Inhalt, Struktur und Formatierung erhalten geblieben sind. Das fängt legitime Variationen ab, die String-Metriken bestrafen, und fügt eine zweite Fehlerquelle hinzu: Das Bewertungsmodell kann eine korrekte Ausgabe als falsch markieren.
Die Fehlerrate des Bewertungsmodells ist Teil des Benchmarks, unabhängig davon, ob die Arbeit sie berichtet.
Das Muster ist nicht auf LLM judges beschränkt. Ein First-Party-Vergleich von acht Receipt-Engines ergab, dass CER und feldbasiertes F1 dieselben Systeme in entgegengesetzte Richtungen einordnen (warum CER beim Dokument-Parsing irreführt). Eine Metrik ist eine Linse mit einer bestimmten Form, und die meisten Berichte beschreiben nur eine.
Wie ein LLM-Bewertungsmodell eine Tabelle zu einer einzigen Zahl macht
Ein LLM-Bewertungsmodell verdichtet Hunderte von Entscheidungen auf Zellebene zu einem einzigen Urteil – und jeder Verdichtungsschritt ist eine Stelle, an der eine korrekte Ausgabe als falsch markiert werden kann.
Zuerst das Matching. Irgendetwas muss entscheiden, welche geparste Tabelle welcher Referenztabelle entspricht. Parser teilen eine Tabelle in zwei, führen zwei zu einer zusammen und ordnen Tabellen auf einer mehrspaltigen Seite neu an. Ein Matching-Schritt, oft ein weiterer Modellaufruf, wählt eine Zuordnung. Wählt er falsch, bewertet das Bewertungsmodell eine korrekte Tabelle gegen die falsche Referenz und meldet Fehler, die es nicht gibt. Die Studie von 2026, die LLM-Bewertung validierte, baute diese Pipeline explizit auf (arXiv:2603.18652).
Dann das Bewertungsraster. Ein typisches Bewertungsmodell beantwortet pro Paar drei Fragen: Stimmen die Zellwerte, stimmt die Struktur, stimmt die Formatierung. Manche Prompts liefern drei boolesche Werte; andere verlangen eine Punktzahl von 0 bis 10. So oder so entscheidet das Bewertungsmodell, was „dieselbe Tabelle" bedeutet, und diese Entscheidung ist nirgends nachprüfbar festgehalten.
Dann die Aggregation. Drei boolesche Werte verdichten sich zu markiert oder nicht markiert. Eine Punktzahl von 0 bis 10 verdichtet sich zu einem Mittelwert über das Testset. Eine Tabelle mit 40 Zeilen und eine mit 4 Zeilen tragen je eine Zahl bei. Eine fehlende Zeile, eine vertauschte Spalte und eine Summe, die um den Faktor zehn danebenliegt, werden alle zu einer Einheit verlorener Punkte.
Wo die Falschpositive entstehen
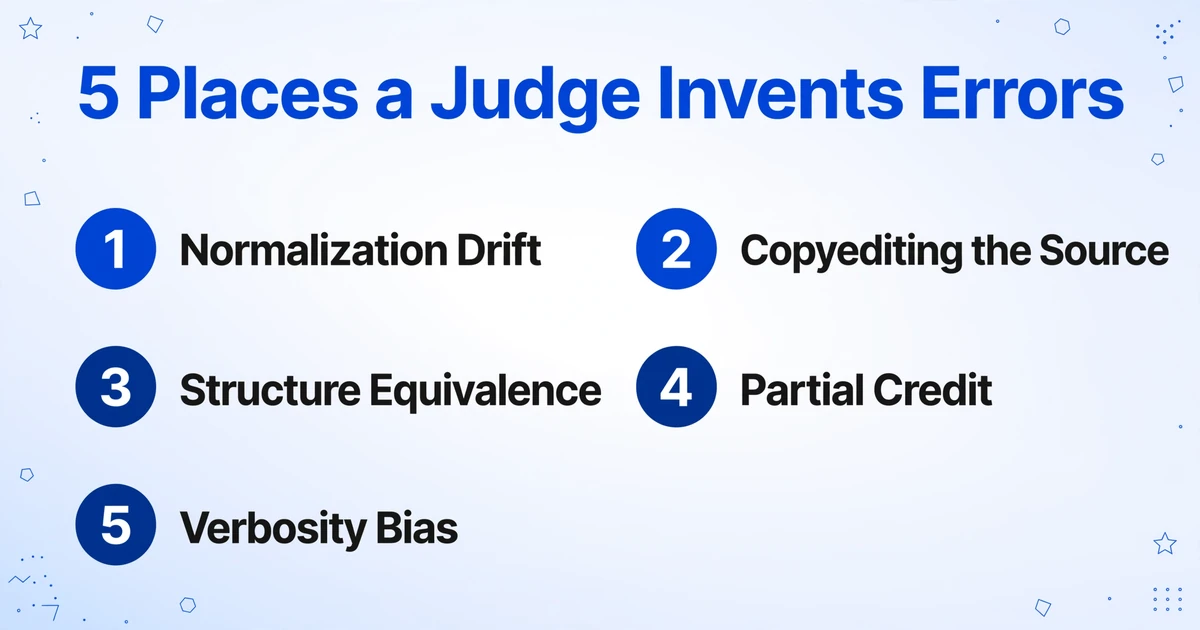
Falschpositive entstehen an fünf konkreten Stellen, und jede erzeugt eine andere Art falscher Zahl.
| Einstiegspunkt | Was das Bewertungsmodell tut | Auswirkung auf die Punktzahl |
|---|---|---|
| Normalisierung | Entscheidet, ob 1,234.00, 1234 und $1,234 derselbe Wert sind und ob Groß-/Kleinschreibung oder eine leere Zelle eine Rolle spielen | Dasselbe Paar kann in einem Durchlauf bestehen und im nächsten durchfallen, wenn die Regel implizit ist |
| Die Quelle redigieren | Liest einen offensichtlichen Tippfehler als das beabsichtigte Wort und markiert die originalgetreue Transkription dann als falsch | Eine korrekte Zelle wird als OCR-Fehler erfasst, der nie passiert ist |
| Strukturäquivalenz | Behandelt eine zusammengeführte Kopfzeile und zwei getrennte Zellen als verschieden oder eine durch einen Seitenumbruch geteilte Tabelle als zwei Tabellen | Gültige Kodierungen werden bestraft, und die Strafe wächst mit der Layoutkomplexität |
| Teilpunkte | Vergibt anteilige Punkte, sodass eine falsche Summe und eine falsche Fußnote ähnlich viel kosten | Die Schwere verschwindet aus der Punktzahl |
| Verbosität | Liest eine längere Ausgabe mit wiederholten Kopfzeilen als vollständiger | Füllmaterial kann die Punktzahl erhöhen, ohne korrekte Zellen hinzuzufügen |
Der erste Einstiegspunkt hat eine dokumentierte Lösung. OCR-D, das deutsche Koordinationsprojekt für OCR, definiert seine Bewertungsregeln vor jedem Vergleich: explizite Ground-Truth-Transkriptionsebenen, Unicode-NFC-Normalisierung und eine normalisierte CER (OCR-D-Spezifikation zur Qualitätssicherung). Die Transkriptionsrichtlinien ergänzen, dass Druckfehler nicht korrigiert werden, da die Treue sie einschließt (OCR-D-Ground-Truth-Richtlinien). Ein LLM judge trifft beide Entscheidungen innerhalb eines Prompts, pro Aufruf, ohne versioniertes Regelwerk.
Die Struktur hat dieselbe Form. TEDS bewertet den HTML-Baum, sodass zwei Kodierungen, die ein Leser als dieselbe Tabelle bezeichnen würde, unterschiedliche Bäume erzeugen können. Das GriTS-Papier (2023) merkt an, dass Teilpunkte-Maße teilweise deshalb populär wurden, weil sie weniger empfindlich auf Ground-Truth-Rauschen reagieren (arXiv:2203.12555). Eine Metrik, die Ground-Truth-Rauschen absorbiert, absorbiert auch echte Fehler – ein vertretbarer Kompromiss für die Forschung und ein gefährlicher für eine Kaufentscheidung.
Jede dieser Entscheidungen ist für sich genommen vertretbar. Zusammen machen sie den Score ebenso zu einer Funktion der Präferenzen des Bewertungsmodells wie der Ausgabe des Parsers.
Der Präzisions-Recall-Kompromiss gehört dem Bewertungsmodell
Verschärft man ein Bewertungsmodell, damit es mehr korrupte Tabellen erkennt, steigt seine Falschpositivrate, und bei niedrigen Fehlerraten wird die Falschpositivrate zur Zahl, die Sie berichten.
Ein Bewertungsmodell hat zwei relevante Eigenschaften. Seine Richtigpositivrate (TPR) ist der Anteil der tatsächlich korrupten Ausgaben, die es markiert. Seine Falschpositivrate (FPR) ist der Anteil der korrekten Ausgaben, die es trotzdem markiert. In Benchmark-Begriffen ist die Präzision der Anteil der markierten Tabellen, die tatsächlich falsch sind, und der Recall der Anteil der falschen Tabellen, die markiert wurden. Blieben beide Raten konstant, wäre die berichtete Fehlerrate:
berichtete Fehlerrate = FPR + echte Fehlerrate × (TPR − FPR)
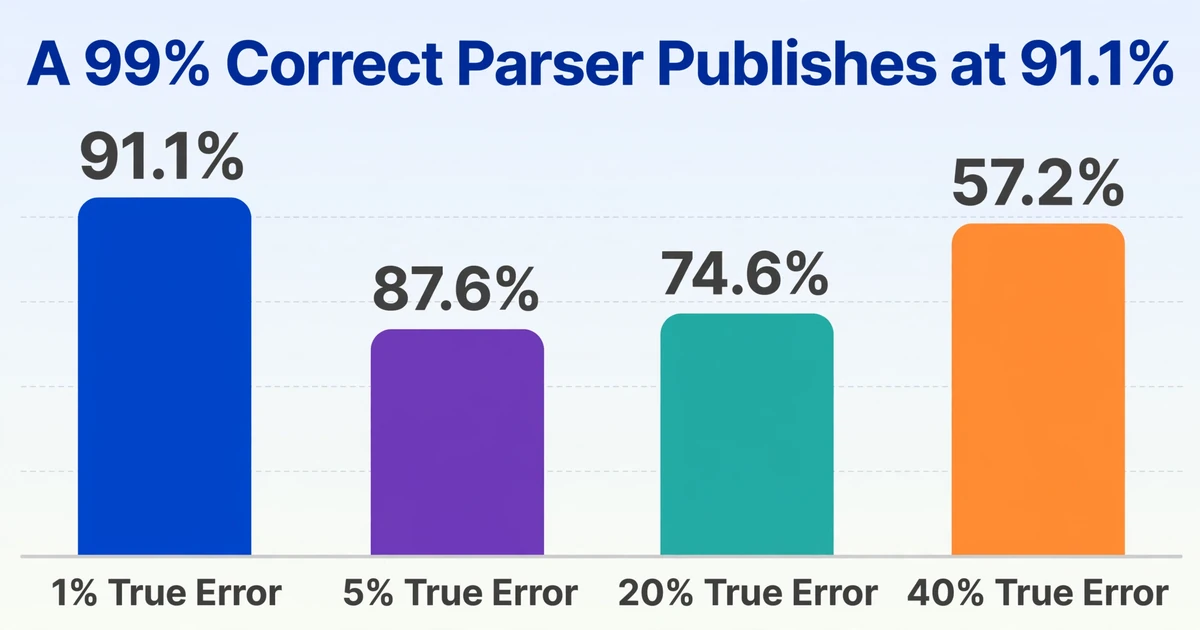
Setzen Sie ein Bewertungsmodell mit einer TPR von 95 Prozent und einer FPR von 8 Prozent ein. Diese Zahlen stammen aus der Formel, nicht aus einem bestimmten Benchmark.
| Echte Fehlerrate | Berichtete Fehlerrate | Berichtete Genauigkeit |
|---|---|---|
| 1% | 8.9% | 91.1% |
| 5% | 12.4% | 87.6% |
| 20% | 25.4% | 74.6% |
| 40% | 42.8% | 57.2% |
Unter diesen Annahmen wird ein Parser, der zu 99 Prozent korrekt ist, mit 91,1 Prozent veröffentlicht. Die Parser mit 99 und 95 Prozent rangieren weiterhin in der richtigen Reihenfolge, aber die Lücke schrumpft von 4 Punkten auf 3,5. Die absolute Zahl ist der Rauschboden des Bewertungsmodells plus eine komprimierte Version der echten Fehlerrate.
Die Reihenfolge bleibt nur erhalten, solange die FPR konstant ist, und es gibt wenig Grund, davon auszugehen. Eine dichte Tabelle bietet dem Bewertungsmodell mehr Zellen, an denen es Anstoß nehmen kann, als eine mit vier Zellen, und Layoutkonventionen variieren je nach Dokumenttyp, sodass sich die Rate mit dem Dokumentmix verschiebt. Bei 5 Prozent FPR bei einfachen Tabellen und 15 Prozent bei komplexen kann ein Parser, der bei komplexen Tabellen besser ist, gegen einen verlieren, der bei einfachen Tabellen besser ist. Die Rangfolge kehrt sich still um.
Der Tradeoff ist eine Einstellung, keine Eigenschaft des Parsers. Ein Benchmark, der darauf abgestimmt ist, jeden injizierten Fehler zu erfassen, läuft mit hohem Recall und akzeptiert Fehlalarme. Ein Produktions-Gate ist üblicherweise auf Präzision abgestimmt und akzeptiert Auslassungen. Ein Team kann seinen Benchmark-Score verbessern und in der Produktion dennoch dieselbe Ausnahmerate sehen.
Produktionsteams steuern diesen Hebel bereits. Konfidenzschwellen verschieben Präzision und Recall, und die Schwelle bestimmt die Größe der Prüfwarteschlange (Ausnahmeraten bei der Dokumentenautomatisierung). Ein Benchmark, der einen Score ohne den Betriebspunkt seines Bewertungsmodells meldet, verbirgt dieselbe Wahl.
Ein Ingenieur, der Evals durchführt, beschrieb die Schleife in einem r/mlops-Thread: Das Bewertungsmodell ist inkonsistent bei Formulierungsänderungen, „neigt zu längeren Antworten“, rationalisiert Ausgaben, die das Gold-Set als falsch markiert, und die Kalibrierung wird zu „Prompt-Regeln auf Prompt-Regeln zu stapeln in der Hoffnung, dass die Falschpositive zurückgehen“ (r/mlops).
Was die Evidenz tatsächlich zeigt
LLM-Bewertungsmodelle erfassen menschliches Urteilsvermögen besser als jede String-Metrik, und sie stimmen untereinander stärker überein als trainierte Menschen, was der Teil ist, den man mit Vorsicht behandeln sollte.
Die stärkste aktuelle Evidenz ist eine Tabellenparsing-Studie aus 2026 mit mehr als 1.500 menschlichen Bewertungen (arXiv:2603.18652). LLM-Bewertungsmodelle korrelierten mit menschlichen Scores bei r = 0,93, gegenüber 0,68 für TEDS und 0,70 für GriTS. Ohne Parser, die Tabellen vollständig verfehlen, komprimierte TEDS den Rest auf 0,66 bis 0,88, etwa 22 Prozent seiner Skala, während LLM-Scores von 5,75 bis 9,55 reichten. Semantische Bewertung brachte Unterschiede zurück, die die deterministische Metrik eingeebnet hatte.
Diese Studie berichtete auch die Warnung. Die führenden Bewertungsmodelle korrelierten untereinander bei 0,93 bis 0,95, höher als die menschlichen Annotatoren mit 0,81 bis 0,91. Die Autoren beschreiben einen gemeinsamen LLM-Prior, der als rauscharmes Konsenssignal und nicht als Ground Truth gelesen werden sollte. Übereinstimmung unter Bewertungsmodellen ist kein Beleg dafür, dass die Bewertungsmodelle recht haben. Sie kann ein Beleg dafür sein, dass sie einen blinden Fleck teilen.
Die Referenz, die ein Bewertungsmodell erhält, verändert seine Fehlerrate erheblich. Eine Analyse aus 2026 ergab, dass Bewertungsmodelle ohne korrekte Referenz hauptsächlich bei Fragen mit Experten übereinstimmen, die das Bewertungsmodell selbst beantworten kann, und dass eine von Menschen geschriebene Referenz sowohl Falschpositive als auch falsch Negative reduziert. Eine leicht falsche Referenz kann schlechter sein als keine (arXiv:2503.05061). Die MT-Bench-Studie kam 2023 zu einem kompatiblen Ergebnis: Bei ihren Mathefragen erzeugte der Standard-Prompt des Bewertungsmodells 14 falsche Urteile von 20, und ein referenzgestützter Prompt erzeugte 3 (arXiv:2306.05685). Dieselbe Studie dokumentierte Positions- und Verbositätsbias.
Ein Bewertungsmodell mit Referenz vergleicht. Ein Bewertungsmodell ohne Referenz beantwortet die Frage erneut und benotet seine eigene Antwort.
Ein strengeres Bewertungsmodell behebt selten eine kaputte Evaluation. Es verändert den Bias, nicht die Struktur. Was funktioniert, ist eine Referenz, ein schriftliches Bewertungsraster und eine gemessene Fehlerrate für das Bewertungsmodell selbst.
Wie Sie ein Bewertungsmodell prüfen, bevor Sie seiner Zahl vertrauen
Fragen Sie nach der Falschpositivrate des Bewertungsmodells bei Ausgaben, die konstruktionsbedingt korrekt sind, bevor Sie nach dem Score des Parsers fragen.
Erstellen Sie ein sauberes Set mit bekannter Antwort
Rendern Sie das Referenz-HTML oder -Markdown in ein Bild. Das Bild stammt nun aus der Antwort, jedes Paar ist also per Definition korrekt, ohne dass eine Kennzeichnungsentscheidung nötig ist.
Messen Sie die Falschpositivrate auf diesem Set
Jedes Paar, das das Bewertungsmodell ablehnt, ist ein Fehler, den das Bewertungsmodell erfunden hat. Geben Sie diese Rate neben jedem Score an. Sie ist der Rauschpegel des Benchmarks, und ohne sie lässt sich ein Unterschied von einem Punkt nicht interpretieren.
Injizieren Sie jeweils einen Fehler, nach Kategorie
Ändern Sie eine Zahl, lassen Sie eine Zeile weg, vertauschen Sie eine Spalte, lassen Sie eine Kopfzeile weg, fügen Sie Hervorhebung hinzu. Messen Sie die Erkennung pro Kategorie. Eine einzelne aggregierte Rate verbirgt blinde Flecken, einschließlich der Bewertungsraster-Kategorien, die Ihre Dokumente am stärksten beanspruchen.
Verlangen Sie, dass das Bewertungsmodell seine Belege zeigt
Lassen Sie jedes Urteil die Zellenkoordinaten und den Quelltext enthalten, die das Bewertungsmodell verglichen hat. Eine Ablehnung, die es nicht verorten kann, ist eine Präferenz, kein Befund.
Kalibrieren Sie an Menschen und versionieren Sie das Bewertungsmodell
Bewerten Sie 100 bis 200 stratifizierte Paare mit zwei Annotatoren und geben Sie dann die Übereinstimmung zwischen Bewertungsmodell und Menschen an, nicht nur zwischen Bewertungsmodellen. Halten Sie Modell, Prompt und Normalisierungsregeln fest und prüfen Sie erneut, wenn sich etwas ändert.
Wenn Sie statt Bewertungsmodelle Anbieter evaluieren, wenden Sie dieselbe Logik auf deren Testset an, mit diesem Genauigkeits-Testprotokoll (Genauigkeits-Testprotokoll).
Bei einer veröffentlichten Zahl, die Sie nicht erneut ausführen können, bringen Sie vier Fragen schon weit. Welches Bewertungsmodell, welche Modellversion und welcher Prompt haben sie erzeugt? Wie hoch ist die Falschpositivrate dieses Bewertungsmodells bei korrekten Ausgaben? Ist die Fehlerrate pro Zelle, pro Feld oder pro Tabelle, und werden alle Fehler gleich gewichtet? Stammt das Testset aus den Dokumenttypen, die Sie tatsächlich verarbeiten?
Wann ein LLM-Bewertungsmodell das richtige Instrument ist
Setzen Sie ein Bewertungsmodell dort ein, wo mehrere Ausgaben legitim korrekt sind, und eine deterministische Prüfung dort, wo nur eine Antwort richtig ist.
Gut geeignet: semantische Äquivalenz über Ausgabeformate hinweg, Lesereihenfolge, Triage eines Regressionstests und paarweiser Vergleich. Die Frage, welche von zwei Ausgaben besser ist, ist stabiler als die Frage, ob eine korrekt ist, weil das Bewertungsmodell einen konkreten Kontrast statt eines absoluten Maßstabs hat.
Schlecht geeignet: numerische Summen ohne separate arithmetische Prüfung, Score-Unterschiede, die über einen Kauf entscheiden, Längsschnittverfolgung über Bewertungsmodell-Versionen hinweg und Aussagen, die einem Auditor standhalten müssen.
Eine dritte Option liegt zwischen String-Metriken und Bewertungsmodellen. olmOCR 2 ersetzte die kontinuierliche Editierdistanz durch binäre Unit-Tests, von denen jeder eine überprüfbare Tatsache über eine Seite behauptet, weil kontinuierliche Scores nicht immer die Korrektheit abbilden (arXiv:2510.19817). Unit-Tests sind deterministisch und können mehr als eine gültige Kodierung akzeptieren. Sie prüfen nur die Fakten, die jemand geschrieben hat, sodass das Testdesign zur neuen Ermessensentscheidung wird, sichtbar in der Testdatei.
Die deterministische Seite braucht dieselbe Disziplin: Acht Beleg-Engines ranken unterschiedlich bei Kosten, CER und Feld-F1, und keine dieser Rangfolgen ist falsch (traditionelles OCR vs. dokumentenparsende VLMs). Der Fehler ist, eine Achse zu berichten und sie Genauigkeit zu nennen.
Welches Instrument Sie auch verwenden, veröffentlichen Sie zwei Zahlen: den Score und die Falschpositivrate des Bewertungsmodells. Ein Benchmark, der beides berichtet, macht eine Aussage, die Sie überprüfen können.
Derselbe Maßstab funktioniert auch bei Ihren eigenen Dateien: Vergleichen Sie eine Stichprobe von Zellen mit der Quelle, bevor Sie entscheiden, dass ein Score gut genug ist. Eine Prüfebene, die den Quellbereich hinter jeder Zelle hervorhebt, macht diese Prüfung schnell.
Häufig gestellte Fragen
Wie erkenne ich, ob ein LLM judge bei meiner Tabelle falsch liegt?
Das lässt sich am Score allein nicht erkennen. Erstellen Sie ein Set, bei dem die Antwort konstruktionsbedingt bekannt ist, messen Sie, wie oft das Bewertungsmodell diese Paare ablehnt, und verlangen Sie, dass es bei jeder Ablehnung auf die Zelle und den Quelltext dahinter verweist.
Was ist eine normale Falschpositivrate für ein LLM judge?
Es gibt keinen veröffentlichten Referenzwert. Die Rate hängt vom Modell, dem Bewertungsraster, dem Dokumenttyp und davon ab, wie viel Formatierung das Bewertungsraster abfragt. Ein Bewertungsmodell, das 5 Prozent sauberer Tabellen markiert, und eines, das 20 Prozent markiert, können für unterschiedliche Aufgaben beide richtig liegen.
Warum erzielt ein besserer Tabellen-Parser auf einem Benchmark ein niedrigeres Ergebnis?
Die Falschpositivrate des Bewertungsmodells kann bei den Dokumenten höher sein, bei denen der Parser am stärksten ist. Der Parser verwendet möglicherweise auch eine Kodierung, die die Referenz nicht nutzt, etwa geteilte Kopfzeilen oder Markdown statt HTML, oder der Abgleich hat ihn der falschen Tabelle zugeordnet.
Sollte ich TEDS oder ein LLM judge für die Tabellenextraktion verwenden?
Berichten Sie beides, wenn die Entscheidung wichtig ist. TEDS ist günstig, bestraft aber äquivalente Kodierungen. Ein LLM judge kommt dem menschlichen Urteil näher, braucht aber ein eigenes Audit. Die Abweichung zwischen beiden zeigt Ihnen, welcher Fehlermodus für Ihren Fall relevant ist.
Table-OCR-Benchmarks werden weiterhin LLM judges einsetzen, denn die Alternative ist eine String-Metrik, die korrekte Tabellen dafür bestraft, dass sie eine andere Kodierung verwenden. Die nützliche Frage ist nicht mehr, ob ein Bewertungsmodell eingesetzt werden sollte. Sie lautet, ob der Benchmark sein Bewertungsmodell gemessen hat, bevor er den Parser gemessen hat.
Genauigkeit der Extraktion an einer Stichprobe Ihrer Dokumente prüfen