Falsos positivos do juiz LLM
em benchmarks de OCR de tabelas
No OmniDocBench v1.6, um benchmark público de parsing de documentos, parsers de tabelas recentes ultrapassam 93 TEDS, a pontuação padrão de estrutura de tabela. Em um conjunto mais difícil de tabelas do mundo real no mesmo estudo de 2026, o parser mais forte alcançou 85,03 (arXiv:2608.09842). A leitura usual é que um benchmark é mais fácil que o outro. Há uma segunda leitura: entre uma tabela parseada e o número do leaderboard fica um instrumento de pontuação, e para muitos benchmarks de tabelas esse instrumento é um juiz LLM, um modelo instruído a avaliar a saída do parser, cuja própria taxa de erro nunca é impressa ao lado da pontuação.
Principais conclusões
- Um juiz LLM, um modelo que avalia a saída do parser, corresponde às pontuações humanas de tabelas em r = 0,93, enquanto o TEDS alcança 0,68.
- Com uma taxa de falsos positivos de 8% do juiz, um parser 99% correto é publicado com 91,1% de acurácia.
- Peça a taxa de falsos positivos do juiz em tabelas corretas por construção, porque sem ela uma diferença de um ponto não pode ser interpretada.
Toda pontuação de OCR de tabela passa por um juiz
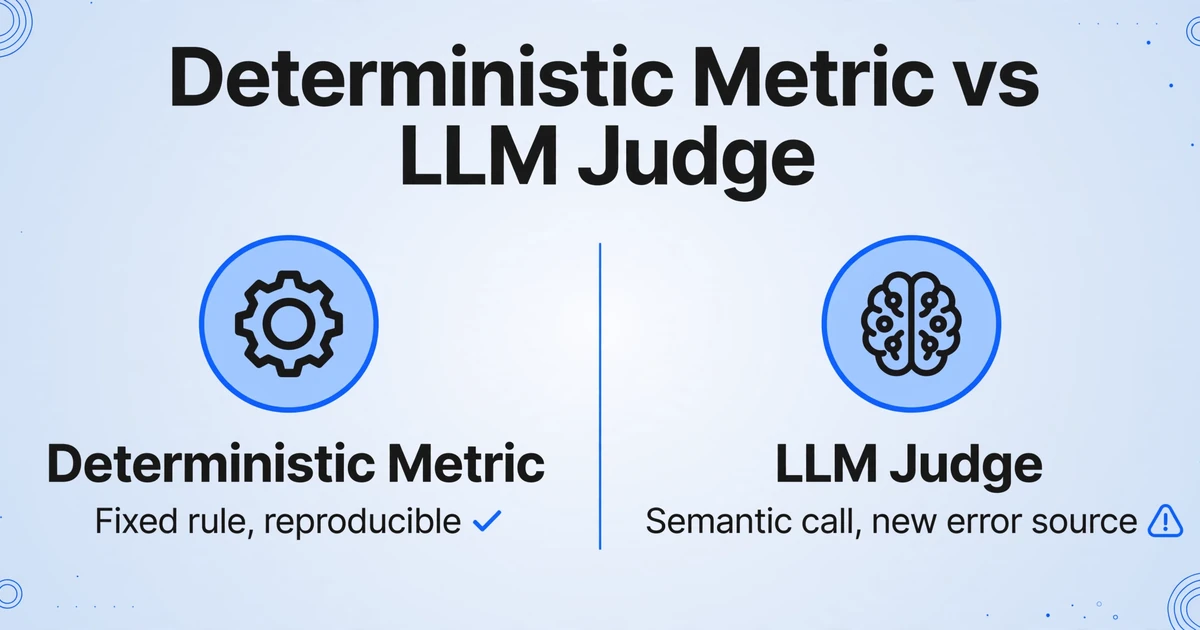
Uma pontuação de benchmark de OCR de tabela mede duas coisas ao mesmo tempo: o parser e a função de pontuação que o avalia.
Métricas determinísticas comparam a tabela analisada com uma referência de forma fixa. TEDS (Tree-Edit-Distance-based Similarity) transforma ambas as tabelas em árvores e conta as edições entre elas. O F1 em nível de célula compara valores por posição. CER (taxa de erro de caractere) conta inserções, substituições e exclusões de caracteres. Cada uma é reproduzível, barata e baseada em uma decisão de normalização: se maiúsculas e minúsculas importam, se 1,234.00 é igual a 1234, se uma célula em branco é igual a uma string vazia.
Um juiz LLM substitui essa regra fixa por uma decisão semântica. Ele recebe a imagem da tabela e a saída analisada e responde se conteúdo, estrutura e formatação foram preservados. Isso lida com variações legítimas que métricas de string punem, e adiciona uma segunda fonte de erro: o juiz pode marcar uma saída correta como errada.
A taxa de erro do juiz faz parte do benchmark, quer o artigo a reporte ou não.
O padrão não é exclusivo dos juízes LLM. Uma comparação própria de oito engines de recibos descobriu que CER e F1 em nível de campo classificaram os mesmos sistemas em direções opostas (por que o CER engana na análise de documentos). Uma métrica é uma lente com uma forma, e a maioria dos relatórios descreve apenas uma.
Como um LLM juiz transforma uma tabela em um único número
Um LLM juiz comprime centenas de decisões no nível de célula em um único veredito, e cada etapa de compressão é um ponto onde uma saída correta pode ser marcada como errada.
A correspondência vem primeiro. Algo precisa decidir qual tabela analisada corresponde a qual tabela de referência. Os parsers dividem uma tabela em duas, mesclam duas em uma e reordenam tabelas em uma página de várias colunas. Uma etapa de correspondência, muitas vezes outra chamada ao modelo, escolhe uma correspondência. Se ela escolher errado, o juiz avalia uma tabela correta contra a referência errada e reporta erros que não existem. O estudo de 2026 que validou a avaliação por LLM juiz construiu esse pipeline explicitamente (arXiv:2603.18652).
Depois, a rubrica. Um juiz típico responde a três perguntas por par: os valores das células estão certos, a estrutura está certa, a formatação está certa. Alguns prompts retornam três booleanos; outros pedem uma pontuação de 0 a 10. De qualquer forma, o juiz está decidindo o que significa "a mesma tabela", e essa decisão não está escrita em nenhum lugar inspecionável.
Depois, a agregação. Três booleanos se reduzem a sinalizado ou não sinalizado. Uma pontuação de 0 a 10 se reduz a uma média em todo o conjunto de teste. Uma tabela de 40 linhas e uma tabela de 4 linhas contribuem com um número cada. Uma linha descartada, uma coluna transposta e um total errado por um fator de dez viram todos uma unidade de crédito perdido.
Onde os falsos positivos entram
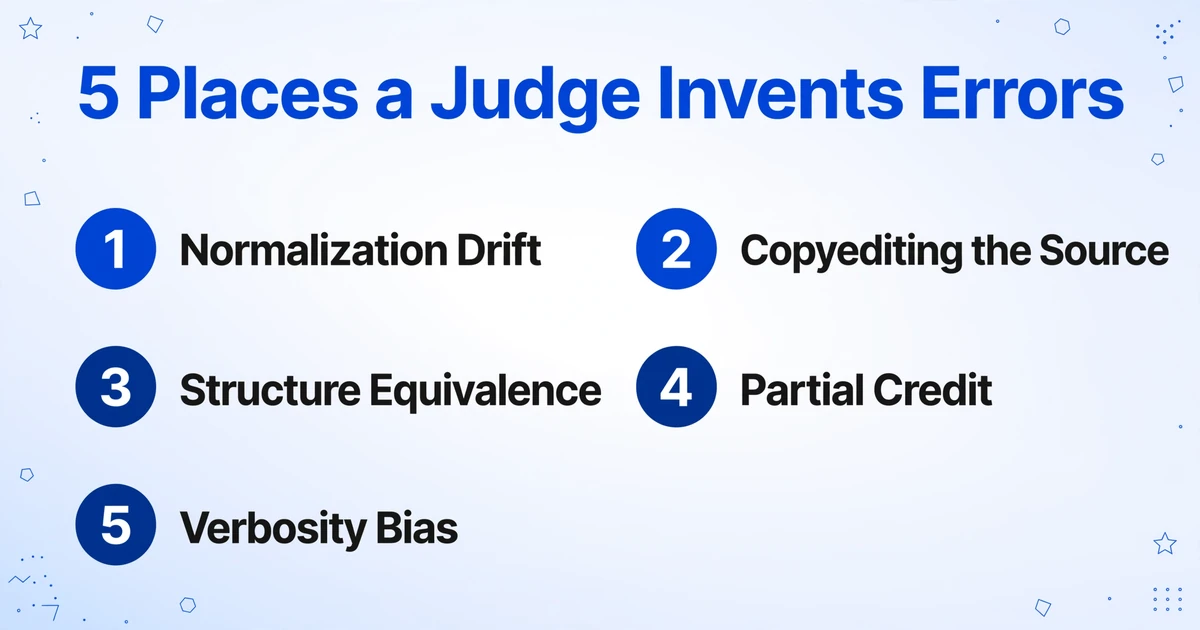
Os falsos positivos entram em cinco pontos específicos, e cada um produz um tipo diferente de número errado.
| Ponto de entrada | O que o juiz faz | Efeito na pontuação |
|---|---|---|
| Normalização | Decide se 1,234.00, 1234 e $1,234 são o mesmo valor, e se maiúsculas e minúsculas ou uma célula em branco importam | O mesmo par pode passar em uma execução e falhar na seguinte se a regra for implícita |
| Revisão da fonte | Lê um erro de digitação óbvio como a palavra pretendida e depois marca a transcrição fiel como errada | Uma célula correta é registrada como um erro de OCR que nunca aconteceu |
| Equivalência estrutural | Trata um cabeçalho mesclado e duas células divididas como diferentes, ou uma tabela dividida por uma quebra de página como duas tabelas | Codificações válidas são penalizadas, e a penalidade cresce com a complexidade do layout |
| Crédito parcial | Dá crédito fracionado, então um total errado e uma nota de rodapé errada custam quantias semelhantes | A severidade desaparece da pontuação |
| Verbosidade | Lê uma saída mais longa com cabeçalhos repetidos como mais completa | O preenchimento pode aumentar a pontuação sem adicionar células corretas |
O primeiro ponto de entrada tem uma solução documentada. O OCR-D, o projeto alemão de coordenação para OCR, define suas regras de pontuação antes de qualquer comparação: níveis explícitos de transcrição da verdade de referência, normalização Unicode NFC e um CER normalizado (especificação de garantia de qualidade do OCR-D). Suas diretrizes de transcrição acrescentam que erros de impressão não são corrigidos, porque a fidelidade os inclui (diretrizes de verdade de referência do OCR-D). Um juiz LLM toma ambas as decisões dentro de um prompt, a cada chamada, sem nenhum livro de regras versionado.
A estrutura tem o mesmo formato. O TEDS pontua a árvore HTML, então duas codificações que um leitor chamaria de mesma tabela podem produzir árvores diferentes. O artigo do GriTS (2023) observa que medidas com crédito parcial se tornaram populares em parte porque são menos sensíveis ao ruído da verdade de referência (arXiv:2203.12555). Uma métrica que absorve o ruído da verdade de referência também absorve erros reais, uma troca razoável para pesquisa e perigosa para uma decisão de compra.
Cada uma dessas decisões é defensável por si só. Juntas, elas fazem da pontuação uma função tanto das preferências do juiz quanto da saída do parser.
O Trade-off entre Precisão e Recall Pertence ao Juiz
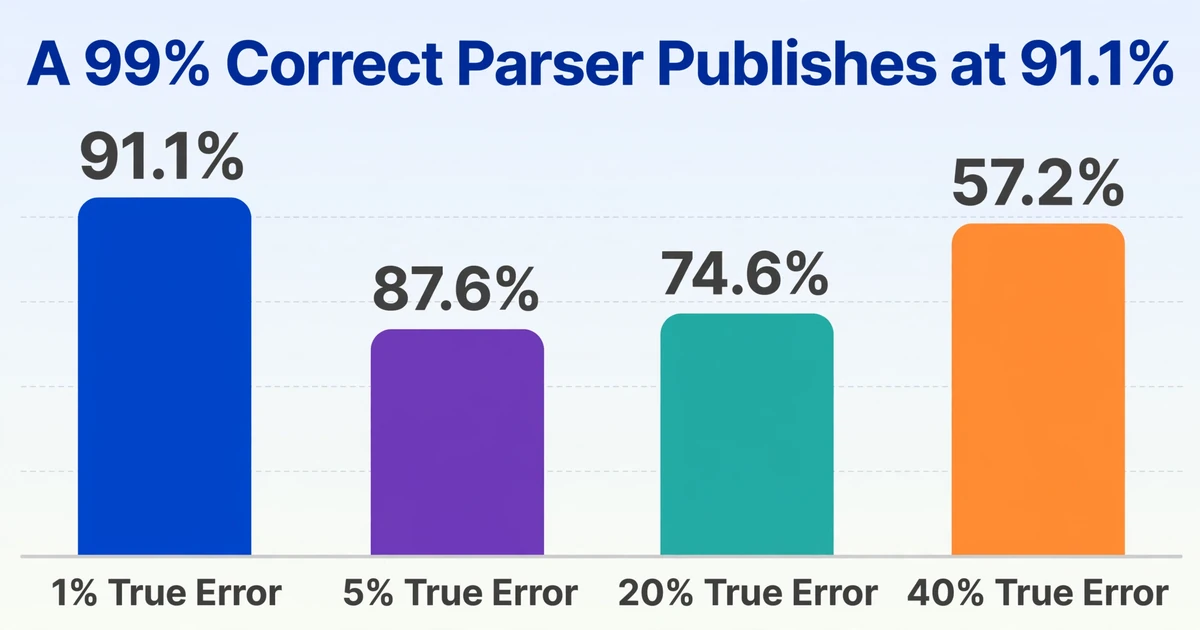
Apertar um juiz para que ele capture mais tabelas corrompidas aumenta sua taxa de falsos positivos e, em taxas de erro baixas, a taxa de falsos positivos se torna o número que você relata.
Um juiz tem duas propriedades relevantes. Sua taxa de verdadeiros positivos (TPR) é a parcela de saídas genuinamente corrompidas que ele sinaliza. Sua taxa de falsos positivos (FPR) é a parcela de saídas corretas que ele sinaliza mesmo assim. Em termos de benchmark, precisão é a parcela de tabelas sinalizadas que estão de fato erradas, e recall é a parcela de tabelas erradas que foram sinalizadas. Se ambas as taxas permanecessem constantes, a taxa de erro relatada seria:
taxa de erro relatada = FPR + taxa de erro real × (TPR − FPR)
Considere um juiz com TPR de 95 por cento e FPR de 8 por cento. Esses números vêm da fórmula, não de um benchmark específico.
| Taxa de erro real | Taxa de erro relatada | Acurácia relatada |
|---|---|---|
| 1% | 8,9% | 91,1% |
| 5% | 12,4% | 87,6% |
| 20% | 25,4% | 74,6% |
| 40% | 42,8% | 57,2% |
Sob essas premissas, um parser 99 por cento correto é publicado a 91,1 por cento. Os parsers de 99 e 95 por cento ainda se classificam em ordem, mas a diferença encolhe de 4 pontos para 3,5. O número absoluto é o piso de ruído do juiz mais uma versão comprimida da taxa de erro real.
A ordenação só se mantém enquanto a FPR for constante, e há pouca razão para presumir que seja. Uma tabela densa dá ao juiz mais células para contestar do que uma de quatro células, e as convenções de layout variam conforme o tipo de documento, então a taxa muda com a mistura de documentos. Com 5 por cento de FPR em tabelas simples e 15 por cento em complexas, um parser que é melhor em tabelas complexas pode perder para um que é melhor em tabelas simples. O ranking se inverte silenciosamente.
O tradeoff é uma configuração, não uma propriedade do parser. Um benchmark ajustado para capturar cada erro injetado opera com alto recall e aceita falsos alarmes. Um gate de produção geralmente é ajustado para precisão e aceita erros não detectados. Uma equipe pode melhorar sua pontuação no benchmark e ainda ver a mesma taxa de exceções em produção.
As equipes de produção já gerenciam essa alavanca. Os limites de confiança movem a precisão e o recall, e o limite define o tamanho da fila de revisão (taxas de exceção em automação de documentos). Um benchmark que reporta uma única pontuação sem o ponto de operação do seu juiz esconde a mesma escolha.
Um engenheiro que executa evals descreveu o ciclo em uma thread do r/mlops: o juiz é inconsistente entre mudanças de redação, "tendencioso a favor de respostas mais longas", racionaliza saídas que o conjunto de referência marca como erradas, e a calibração se torna "empilhar regras de prompt sobre regras de prompt na esperança de que os falsos positivos diminuam" (r/mlops).
O que as Evidências Realmente Mostram
Os juízes LLM acompanham o julgamento humano melhor do que qualquer métrica de string, e concordam entre si mais do que humanos treinados concordam, o que é a parte a ser tratada com cuidado.
A evidência atual mais forte é um estudo de 2026 sobre parsing de tabelas com mais de 1.500 avaliações humanas (arXiv:2603.18652). Os juízes LLM se correlacionaram com as pontuações humanas em r = 0,93, contra 0,68 para TEDS e 0,70 para GriTS. Com os parsers que perdem tabelas inteiramente excluídos, o TEDS comprimiu o restante entre 0,66 e 0,88, cerca de 22 por cento de sua escala, enquanto as pontuações dos LLM variaram de 5,75 a 9,55. O julgamento semântico recuperou diferenças que a métrica determinística achatou.
Esse estudo também reportou o alerta. Os principais juízes se correlacionaram entre si em 0,93 a 0,95, mais alto do que os anotadores humanos, em 0,81 a 0,91. Os autores descrevem um prior compartilhado dos LLM que deve ser lido como consenso de baixo ruído, e não como verdade de referência. A concordância entre juízes não é evidência de que os juízes estão certos. Pode ser evidência de que compartilham um ponto cego.
A referência fornecida a um juiz altera substancialmente sua taxa de erro. Uma análise de 2026 descobriu que, na ausência de uma referência correta, os juízes concordam com especialistas principalmente em questões que o próprio juiz consegue responder, e que uma referência escrita por humanos reduz tanto os falsos positivos quanto os falsos negativos. Uma referência ligeiramente errada pode ser pior do que nenhuma (arXiv:2503.05061). O estudo do MT-Bench chegou a um resultado compatível em 2023: em suas questões de matemática, o prompt padrão do juiz produziu 14 veredictos errados de 20, e um prompt guiado por referência produziu 3 (arXiv:2306.05685). O mesmo estudo documentou vieses de posição e de verbosidade.
Um juiz com uma referência está comparando. Um juiz sem uma está respondendo à pergunta de novo e avaliando sua própria resposta.
Um juiz mais forte raramente corrige uma avaliação quebrada. Ele muda o viés, não a estrutura. O que funciona é uma referência, uma rubrica escrita e uma taxa de erro medida para o próprio juiz.
Como auditar um juiz antes de confiar no número dele
Peça a taxa de falsos positivos do juiz em saídas corretas por construção antes de pedir a pontuação do parser.
Monte um conjunto limpo em que a resposta é conhecida
Renderize o HTML ou Markdown de referência em uma imagem. A imagem agora vem da resposta, então cada par está correto por definição, sem nenhum julgamento de rotulagem envolvido.
Meça a taxa de falsos positivos nesse conjunto
Cada par que o juiz rejeita é um erro que o juiz inventou. Relate essa taxa ao lado de cada pontuação. Ela é o piso de ruído do benchmark, e sem ela uma diferença de um ponto não pode ser interpretada.
Injete um erro por vez, por categoria
Altere um número, remova uma linha, transponha uma coluna, remova um cabeçalho, adicione ênfase. Meça a detecção por categoria. Uma única taxa agregada esconde pontos cegos, incluindo as categorias da rubrica que seus documentos mais exigem.
Exija que o juiz mostre suas evidências
Faça cada veredito incluir as coordenadas da célula e o texto de origem que o juiz comparou. Uma rejeição que ele não consegue localizar é uma preferência, não uma constatação.
Calibre com humanos e versione o juiz
Pontue de 100 a 200 pares estratificados com dois anotadores e depois relate a concordância entre juiz e humanos, não apenas entre juízes. Registre o modelo, o prompt e as regras de normalização, e reaudite quando qualquer um deles mudar.
Se você está avaliando fornecedores em vez de juízes, aplique a mesma lógica ao conjunto de testes deles usando este protocolo de teste de acurácia (protocolo de teste de acurácia).
Para um número publicado que você não pode reexecutar, quatro perguntas resolvem a maior parte do caminho. Qual juiz, versão de modelo e prompt o produziram? Qual é a taxa de falsos positivos desse juiz em saídas corretas? A taxa de erro é por célula, por campo ou por tabela, e todos os erros têm o mesmo peso? O conjunto de testes vem dos tipos de documento que você realmente processa?
Quando um Juiz LLM É o Instrumento Certo
Use um juiz quando várias saídas são legitimamente corretas, e uma verificação determinística quando apenas uma resposta é.
Bom encaixe: equivalência semântica entre formatos de saída, ordem de leitura, triagem de uma execução de regressão e comparação pareada. Perguntar qual de duas saídas é melhor é mais estável do que perguntar se uma está correta, porque o juiz tem um contraste concreto em vez de um padrão absoluto.
Mau encaixe: totais numéricos sem uma verificação aritmética separada, diferenças de pontuação que decidem uma compra, acompanhamento longitudinal entre versões de juiz e afirmações que precisam resistir a um auditor.
Uma terceira opção fica entre métricas de string e juízes. O olmOCR 2 substituiu a distância de edição contínua por testes unitários binários, cada um afirmando um fato verificável sobre uma página, porque pontuações contínuas nem sempre acompanham a correção (arXiv:2510.19817). Testes unitários são determinísticos e podem aceitar mais de uma codificação válida. Eles só verificam os fatos que alguém escreveu, então o design do teste se torna a nova decisão de julgamento, visível no arquivo de teste.
O lado determinístico precisa da mesma disciplina: oito engines de recibos se classificam de forma diferente em custo, CER e F1 de campo, e nenhuma dessas classificações está errada (OCR tradicional vs VLMs de parsing de documentos). O erro é relatar um eixo e chamá-lo de acurácia.
Qualquer que seja o instrumento que você use, publique dois números: a pontuação e a taxa de falsos positivos do juiz. Um benchmark que relata ambos faz uma afirmação que você pode verificar.
O mesmo padrão funciona nos seus próprios arquivos: compare uma amostra de células com a fonte antes de decidir que uma pontuação é boa o suficiente. Uma camada de revisão que destaca a região da fonte por trás de cada célula torna essa verificação rápida.
Perguntas Frequentes
Como sei se um juiz LLM está errado sobre minha tabela?
Você não consegue saber apenas pela pontuação. Monte um conjunto em que a resposta seja conhecida por construção, meça com que frequência o juiz rejeita esses pares e exija que ele indique a célula e o texto de origem por trás de cada rejeição.
Qual é uma taxa normal de falsos positivos para um juiz LLM?
Não existe uma linha de base publicada. A taxa depende do modelo, da rubrica, do tipo de documento e de quanta formatação a rubrica questiona. Um juiz que sinaliza 5 por cento das tabelas limpas e outro que sinaliza 20 por cento podem ambos estar certos para trabalhos diferentes.
Por que um parser de tabelas melhor pontua menos em um benchmark?
A taxa de falsos positivos do juiz pode ser maior nos documentos em que o parser é mais forte. O parser também pode usar uma codificação que a referência não usa, como células de cabeçalho divididas ou Markdown em vez de HTML, ou a etapa de correspondência pode tê-lo emparelhado com a tabela errada.
Devo usar TEDS ou um juiz LLM para extração de tabelas?
Relate ambos quando a decisão importa. TEDS é barato, mas penaliza codificações equivalentes. Um juiz LLM está mais próximo do julgamento humano, mas precisa de sua própria auditoria. A discordância entre eles indica qual modo de falha seu caso considera importante.
Os benchmarks de OCR de tabelas continuarão usando juízes LLM, porque a alternativa é uma métrica de string que penaliza tabelas corretas por usarem uma codificação diferente. A pergunta útil não é mais se deve usar um juiz. É se o benchmark mediu seu juiz antes de medir o parser.
Verifique a acurácia de extração em uma amostra dos seus documentos