LLM Judge False Positives
in Table OCR Benchmarks
公開ドキュメント解析ベンチマークであるOmniDocBench v1.6では、最近のテーブルパーサーは標準的なテーブル構造スコアであるTEDSで93を超えます。同じ2026年の研究における、より難しい実世界のテーブルセットでは、最強のパーサーは85.03に達しました(arXiv:2608.09842)。通常の解釈は、一方のベンチマークがもう一方より簡単だというものです。もう一つの解釈があります。解析されたテーブルとリーダーボードの数値の間には採点器が存在し、多くのテーブルベンチマークではその採点器はLLM judge、つまりパーサーの出力を採点するよう促されたモデルであり、そのモデル自身のエラー率がスコアの隣に表示されることはありません。
主なポイント
- パーサーの出力を採点するモデルであるLLM judgeは、人間のテーブルスコアとr = 0.93で一致しますが、TEDSは0.68にとどまります。
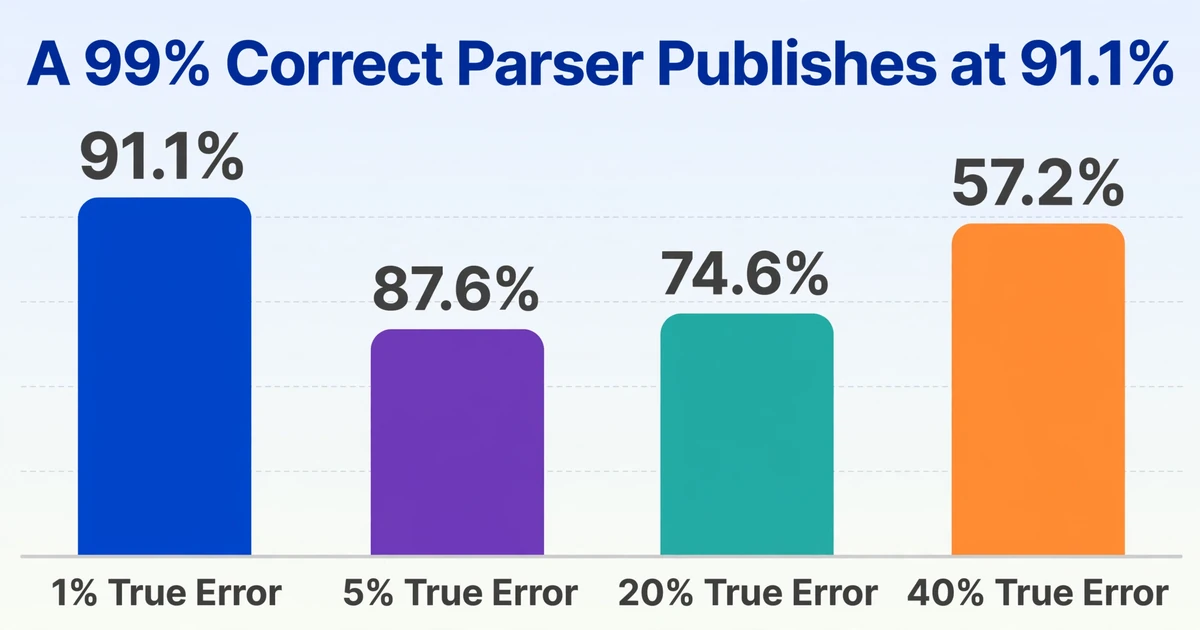
- judgeの偽陽性率が8%の場合、99%正確なパーサーは91.1%の精度として公表されます。
- 構造上正しいテーブルに対するjudgeの偽陽性率を尋ねてください。それがなければ、1ポイントの差を解釈することはできません。
テーブルOCRのスコアはすべて判定モデルを通る
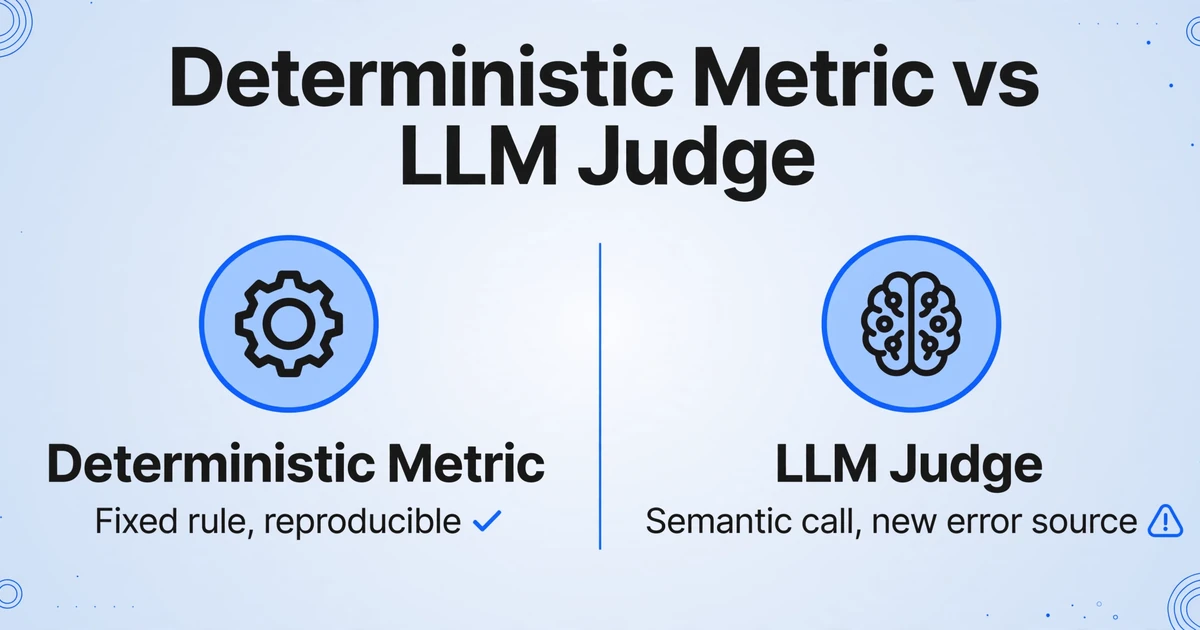
テーブルOCRのベンチマークスコアは、同時に2つのものを測っています。パーサーと、それを採点するスコアリング関数です。
決定論的指標は、解析されたテーブルを参照データと固定の方法で比較します。TEDS(Tree-Edit-Distance-based Similarity)は両方のテーブルを木構造に変換し、その間の編集回数を数えます。セルレベルのF1は位置ごとに値を比較します。CER(文字エラー率)は文字の挿入・置換・削除を数えます。いずれも再現可能で低コストであり、正規化の判断に基づいています。大文字小文字を区別するか、1,234.00 と 1234 を同一とみなすか、空白セルと空文字列を同一とみなすか、といった判断です。
LLM judge はその固定ルールを意味的判断に置き換えます。テーブル画像と解析結果を受け取り、内容・構造・書式が保持されたかを答えます。これにより文字列指標が不当に罰する正当な表記ゆれに対応できますが、新たなエラー源も加わります。判定モデルが正しい出力を誤りと判定する可能性です。
判定モデルのエラー率は、論文が報告していなくてもベンチマークの一部です。
この構図はLLM judgeに限った話ではありません。8つのレシートエンジンを自社で比較したところ、CERとフィールドレベルのF1では同じシステムの順位が逆になりました(ドキュメント解析でCERが誤解を招く理由)。指標は形を持ったレンズであり、ほとんどの報告はその一面しか語っていません。
LLM judgeがテーブルを1つの数値に変える仕組み
LLM judgeは数百のセル単位の判定を1つの結論に圧縮しますが、その圧縮の各段階は、正しい出力が誤りと判定され得る箇所です。
まずマッチングです。どのパース済みテーブルがどの参照テーブルに対応するかを決める必要があります。パーサーは1つのテーブルを2つに分割し、2つを1つに統合し、複数列のページでテーブルの順序を入れ替えます。多くの場合さらなるモデル呼び出しであるマッチング工程が、対応関係を選びます。ここで誤ると、judgeは正しいテーブルを誤った参照データと照合し、存在しないエラーを報告します。LLM judgingを検証した2026年の研究は、このパイプラインを明示的に構築しました(arXiv:2603.18652)。
次に評価基準です。典型的なjudgeは各ペアについて3つの問いに答えます。セルの値は正しいか、構造は正しいか、書式は正しいか。プロンプトによっては3つの真偽値を返し、0〜10のスコアを求めるものもあります。いずれにせよ、judgeは「同じテーブル」とは何かを判断しており、その判断はどこにも検証可能な形で書かれていません。
そして集計です。3つの真偽値はフラグあり/なしに集約されます。0〜10のスコアはテストセット全体の平均に集約されます。40行のテーブルも4行のテーブルも、それぞれ1つの数値として寄与します。行の欠落、列の転置、10倍ずれた合計は、すべて1単位の失点になります。
偽陽性はどこから入り込むか
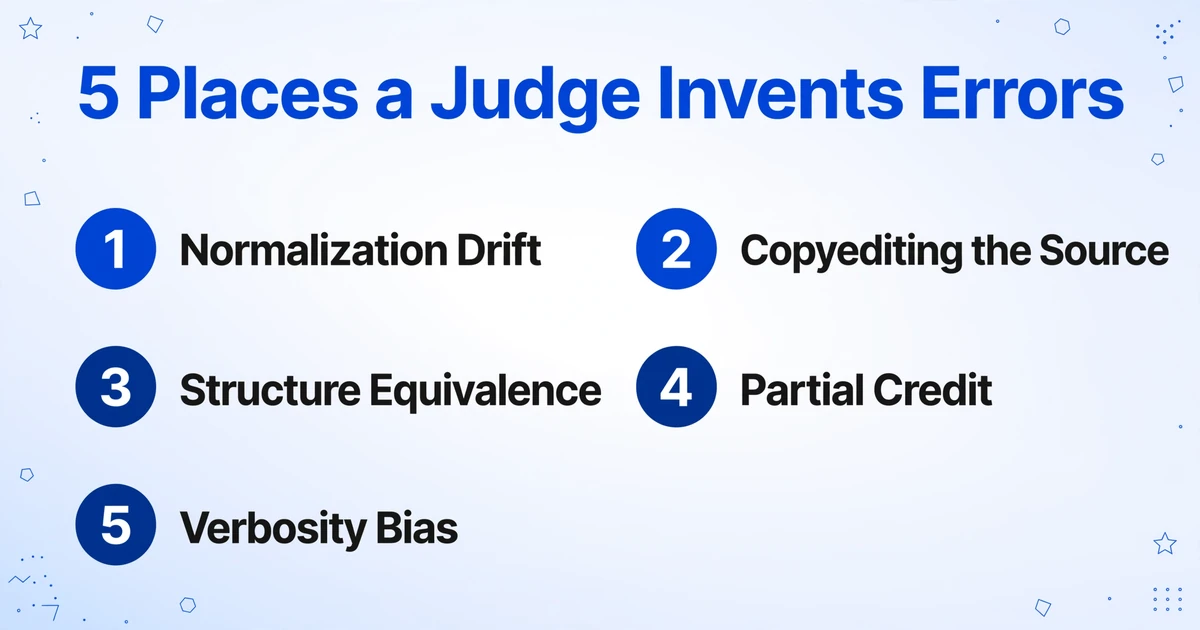
偽陽性は5つの特定の箇所で入り込み、それぞれが異なる種類の誤った数値を生み出します。
| 侵入箇所 | judgeの動作 | スコアへの影響 |
|---|---|---|
| 正規化 | 1,234.00、1234、$1,234が同じ値かどうか、また大文字小文字や空セルが問題になるかを判断する | ルールが暗黙的だと、同じペアがある実行では合格し、次の実行では不合格になり得る |
| ソースの校正 | 明らかな誤植を意図された語として読み、忠実な転記を誤りと判定する | 正しいセルが、実際には起きていないOCRエラーとして記録される |
| 構造の等価性 | 結合されたヘッダーと分割された2つのセルを別物として扱ったり、改ページで分割されたテーブルを2つのテーブルとして扱う | 有効なエンコーディングが減点され、その減点はレイアウトの複雑さとともに増大する |
| 部分点 | 端数の点数を与えるため、誤った合計と誤った脚注が同程度のコストになる | スコアから重大度が消える |
| 冗長性 | ヘッダーを繰り返す長い出力を、より完全なものとして読む | 正しいセルを追加しなくても、水増しでスコアが上がり得る |
最初のエントリーポイントには、文書化された解決策があります。OCRのためのドイツの調整プロジェクトであるOCR-Dは、比較の前にスコアリングルールを定義しています。明示的な正解データの転記レベル、Unicode NFC正規化、正規化されたCERです(OCR-D品質保証仕様)。その転記ガイドラインはさらに、印刷エラーは修正しないと述べています。忠実性にはそれらも含まれるからです(OCR-D正解データガイドライン)。LLM judgeはどちらの判断もプロンプト内で、呼び出しごとに行い、バージョン管理されたルールブックはありません。
構造も同じ形です。TEDSはHTMLツリーを採点するため、読者が同じ表と呼ぶ2つのエンコーディングが異なるツリーを生むことがあります。GriTSの論文(2023年)は、部分点方式の指標が普及した理由の一つとして、正解データのノイズに敏感でないことを挙げています(arXiv:2203.12555)。正解データのノイズを吸収する指標は実際のエラーも吸収します。研究目的では妥当なトレードオフですが、購入判断には危険です。
これらの決定はそれぞれ単独では正当化できます。しかし合わせると、スコアはパーサーの出力と同じくらい判定モデルの好みの関数になってしまいます。
適合率と再現率のトレードオフは判定モデルに属する
判定モデルを厳しくして破損した表をより多く捉えようとすると、偽陽性率が上がります。そしてエラー率が低い場合、報告される数値は偽陽性率そのものになります。
判定モデルには2つの関連する特性があります。真陽性率(TPR)は、実際に破損した出力のうちフラグを立てた割合です。偽陽性率(FPR)は、正しい出力のうちそれでもフラグを立てた割合です。ベンチマークの用語では、適合率はフラグを立てた表のうち実際に誤っている割合、再現率は誤った表のうちフラグを立てられた割合です。両方の率が一定だとすると、報告されるエラー率は次のようになります。
報告エラー率 = FPR + 真のエラー率 × (TPR − FPR)
TPR 95%、FPR 8%の判定モデルを当てはめてみます。これらの数値は公式から導いたもので、特定のベンチマークによるものではありません。
| 真のエラー率 | 報告エラー率 | 報告精度 |
|---|---|---|
| 1% | 8.9% | 91.1% |
| 5% | 12.4% | 87.6% |
| 20% | 25.4% | 74.6% |
| 40% | 42.8% | 57.2% |
これらの前提では、99%正確なパーサーが91.1%として公表されます。99%と95%のパーサーは依然として順位は保たれますが、差は4ポイントから3.5ポイントに縮まります。絶対値は判定モデルのノイズフロアに、実際のエラー率を圧縮したものを加えたものになります。
順序が保たれるのはFPRが一定である場合に限られますが、それが一定であると仮定する根拠はほとんどありません。密な表は4セルの表よりも判定モデルが異議を唱えるセルが多く、レイアウトの慣習はドキュメントの種類によって異なるため、FPRはドキュメントの構成に応じて変動します。単純な表でFPRが5パーセント、複雑な表で15パーセントの場合、複雑な表に強いパーサーが、単純な表に強いパーサーに負けることがあります。順位は静かに逆転します。
このトレードオフは設定であり、パーサーの性質ではありません。注入されたすべてのエラーを検出するように調整されたベンチマークは、高い再現率で動作し、誤検知を受け入れます。本番環境のゲートは通常、適合率を重視して調整され、見逃しを受け入れます。チームはベンチマークスコアを改善しても、本番環境で同じ例外率を目にすることがあります。
本番環境のチームはすでにこのレバーを管理しています。信頼度しきい値は適合率と再現率を動かし、そのしきい値がレビューキューのサイズを決めます(ドキュメント自動化の例外率)。判定モデルの動作点を示さずに単一のスコアだけを報告するベンチマークは、同じ選択を隠しています。
評価を実行しているあるエンジニアが、r/mlopsのスレッドでこのループについて説明していました。判定モデルは文言の変更に対して一貫性がなく、「長い回答に偏り」、正解データが誤りとする出力を正当化し、キャリブレーションは「偽陽性を減らそうとプロンプトルールの上にプロンプトルールを積み重ねる」作業になると述べています(r/mlops)。
証拠が実際に示すもの
LLM judgeはどの文字列指標よりも人間の判断をよく追跡し、訓練された人間同士よりも互いに一致します。この点は慎重に扱うべき部分です。
現在最も強力な証拠は、1,500件を超える人間による評価を含む2026年のテーブル解析研究です(arXiv:2603.18652)。LLM judgeは人間のスコアとr = 0.93で相関し、TEDSの0.68、GriTSの0.70を上回りました。表を完全に見落とすパーサーを除外すると、TEDSは残りを0.66から0.88に圧縮し、これはスケールの約22パーセントにすぎませんでしたが、LLMスコアは5.75から9.55に広がりました。意味論的な判定は、決定論的指標が平坦化した差異を回復しました。
この研究は警告も報告しています。主要な判定モデル同士の相関は0.93から0.95で、人間のアノテーターの0.81から0.91よりも高くなっていました。著者らは、これを正解データではなく低ノイズのコンセンサスとして読むべき共有LLM事前分布だと説明しています。判定モデル間の一致は、判定モデルが正しい証拠にはなりません。共有された盲点の証拠にはなり得ます。
判定モデルに与えられる参照データは、そのエラー率を大きく変えます。2026年の分析では、正しい参照データがない場合、判定モデルは主に判定モデル自身が答えられる質問について専門家と一致し、人間が書いた参照データは偽陽性と偽陰性の両方を減らすことが分かりました。わずかに誤った参照データは、参照データがない場合よりも悪くなることがあります(arXiv:2503.05061)。MT-Benchの研究は2023年に互換性のある結果に達しました。その数学の質問では、デフォルトの判定プロンプトが20件中14件の誤った判定を生み出し、参照データに導かれたプロンプトは3件でした(arXiv:2306.05685)。同じ研究は位置バイアスと冗長性バイアスも記録しています。
参照データのある判定モデルは比較しています。参照データのない判定モデルは、同じ質問にもう一度答えて自分の回答を採点しています。
優れた判定モデルに替えても、壊れた評価は直りません。変わるのはバイアスであり、構造ではありません。効果があるのは、参照データ、文書化された評価基準、そして判定モデル自体の測定済みエラー率です。
その数値を信頼する前に判定モデルを監査する方法
パーサーのスコアを尋ねる前に、構造上正しい出力に対する判定モデルの偽陽性率を尋ねてください。
答えが既知のクリーンなセットを構築する
参照HTMLまたはMarkdownを画像にレンダリングします。この画像は答えから生成されたものなので、すべてのペアは定義上正しく、ラベリングの判断は一切介在しません。
そのセットで偽陽性率を測定する
判定モデルが却下したペアはすべて、判定モデルが作り出した誤りです。その率をすべてのスコアの横に報告してください。これはベンチマークのノイズフロアであり、これがなければ1ポイントの差は解釈できません。
カテゴリ別に1つずつ誤りを注入する
数値を1つ変える、行を1つ落とす、列を1つ入れ替える、ヘッダーを落とす、強調を加える。カテゴリごとに検出率を測定します。単一の集計率では、ドキュメントが最も負荷をかける評価基準カテゴリを含め、盲点が隠れてしまいます。
判定モデルに根拠の提示を求める
各判定に、判定モデルが比較したセル座標とソーステキストを含めさせます。位置を特定できない却下は、所見ではなく好みです。
人間で校正し、判定モデルをバージョン管理する
100〜200の層化ペアを2名のアノテーターで採点し、判定モデル間だけでなく、判定モデルと人間の一致度を報告します。モデル、プロンプト、正規化ルールを記録し、いずれかが変わったら再監査します。
判定モデルではなくベンダーを評価する場合は、この精度テストプロトコル(精度テストプロトコル)を使って、同じ論理をベンダーのテストセットに適用してください。
再実行できない公表数値については、4つの質問でほぼ答えにたどり着けます。どの判定モデル、モデルバージョン、プロンプトがその数値を出したのか?その判定モデルの正しい出力に対する偽陽性率はいくつか?エラー率はセル単位、フィールド単位、テーブル単位のどれで、すべての誤りは等しく重み付けされているか?テストセットは実際に処理するドキュメント種別から抽出されているか?
LLM judgeが適切な評価手段となる場合
複数の出力が正当に正解となり得る場合はjudgeを使い、正解が1つだけの場合は決定論的チェックを使います。
適している場合: 出力フォーマット間の意味的等価性、読み取り順序、リグレッション実行のトリアージ、ペアワイズ比較。2つの出力のどちらが優れているかを尋ねる方が、1つが正しいかどうかを尋ねるよりも安定しています。judgeが絶対的な基準ではなく具体的な対比を持てるからです。
適していない場合: 別途算術チェックのない数値合計、購入判断を左右するスコア差、judgeバージョンをまたぐ経時的な追跡、監査人を通過する必要がある主張。
文字列メトリクスとjudgeの間には第3の選択肢があります。olmOCR 2は連続的な編集距離を二値のユニットテストに置き換えました。各テストはページに関する1つの検証可能な事実を主張します。連続スコアは必ずしも正しさを反映しないからです(arXiv:2510.19817)。ユニットテストは決定論的で、複数の有効なエンコーディングを受け入れられます。ただし誰かが書いた事実しかチェックしないため、テスト設計が新たな判断ポイントとなり、テストファイル上で可視化されます。
決定論的な側にも同じ規律が必要です。8つのレシートエンジンはコスト、CER、フィールドF1で順位が異なり、どの順位も間違いではありません(従来のOCRとドキュメント解析VLMの比較)。誤りは、1つの軸だけを報告してそれを精度と呼ぶことです。
どの評価手段を使うにせよ、2つの数値を公表してください。スコアとjudgeの偽陽性率です。両方を報告するベンチマークは、検証可能な主張になります。
同じ基準はご自身のファイルにも適用できます。スコアが十分かを判断する前に、セルのサンプルをソースと比較してください。各セルの背後にあるソース領域をハイライトするレビュー層があれば、そのチェックを素早く行えます。
よくある質問
LLM judgeが自分のテーブルについて誤っているかどうかを知るには?
スコアだけでは判断できません。答えが構造上明らかなデータセットを構築し、判定モデルがそうしたペアをどの程度の頻度で棄却するかを測定し、各棄却の根拠となるセルとソーステキストを指し示すことを必須にしてください。
LLM judgeの偽陽性率の標準的な値は?
公表されたベースラインはありません。この率はモデル、評価基準、ドキュメントの種類、そして評価基準がどの程度フォーマットについて問うかによって変わります。クリーンなテーブルの5パーセントを指摘する判定モデルも、20パーセントを指摘する判定モデルも、用途が異なればどちらも正しいと言えます。
優れたテーブルパーサーほどベンチマークのスコアが低くなるのはなぜ?
パーサーが最も得意とするドキュメントで、判定モデルの偽陽性率が高くなる可能性があります。また、パーサーが参照データとは異なるエンコーディング(ヘッダーセルの分割やHTMLではなくMarkdownなど)を使用していたり、マッチングの段階で誤ったテーブルとペアにされた可能性もあります。
テーブル抽出にはTEDSとLLM judgeのどちらを使うべき?
判断が重要な場合は両方を報告してください。TEDSは安価ですが、等価なエンコーディングにペナルティを与えます。LLM judgeは人間の判断に近いものの、独自の監査が必要です。両者の不一致は、あなたのケースがどの失敗モードを重視すべきかを教えてくれます。
テーブルOCRのベンチマークは今後もLLM judgeを使い続けるでしょう。代替手段は、異なるエンコーディングを使ったという理由で正しいテーブルにペナルティを与える文字列指標だからです。有用な問いはもはや、判定モデルを使うかどうかではありません。ベンチマークがパーサーを測定する前に、その判定モデルを測定したかどうかです。