LLM Judge False Positives
in Table OCR Benchmarks
En OmniDocBench v1.6, un benchmark público de análisis de documentos, los analizadores de tablas recientes superan los 93 TEDS, la puntuación estándar de estructura de tablas. En un conjunto más difícil de tablas del mundo real del mismo estudio de 2026, el analizador más potente alcanzó 85,03 (arXiv:2608.09842). La lectura habitual es que un benchmark es más fácil que el otro. Hay una segunda lectura: entre una tabla analizada y el número de la clasificación se interpone un instrumento de puntuación, y en muchos benchmarks de tablas ese instrumento es un juez LLM, un modelo al que se le pide calificar la salida del analizador, cuya propia tasa de error nunca se imprime junto a la puntuación.
Puntos clave
- Un juez LLM, un modelo que califica la salida del analizador, iguala las puntuaciones humanas de tablas con r = 0,93, mientras que TEDS logra 0,68.
- Con una tasa de falsos positivos del juez del 8%, un analizador con un 99% de acierto se publica con una exactitud del 91,1%.
- Pida la tasa de falsos positivos del juez en tablas correctas por construcción, porque sin ella no se puede interpretar una diferencia de un punto.
Toda puntuación de OCR de tablas pasa por un juez
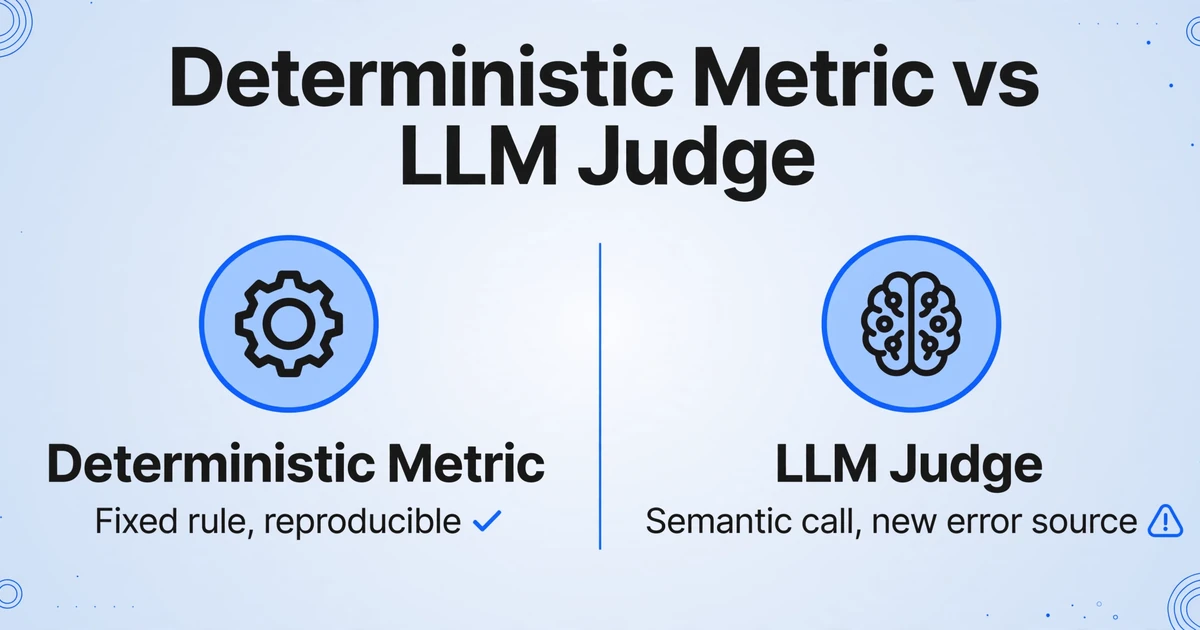
Una puntuación de benchmark de OCR de tablas mide dos cosas a la vez: el analizador y la función de puntuación que lo califica.
Las métricas deterministas comparan la tabla analizada con una referencia de forma fija. TEDS (Tree-Edit-Distance-based Similarity) convierte ambas tablas en árboles y cuenta las ediciones entre ellas. La F1 a nivel de celda compara valores por posición. CER (tasa de error de caracteres) cuenta inserciones, sustituciones y eliminaciones de caracteres. Cada una es reproducible, económica y se basa en una decisión de normalización: si las mayúsculas importan, si 1,234.00 equivale a 1234, si una celda en blanco equivale a una cadena vacía.
Un juez LLM reemplaza esa regla fija por una decisión semántica. Recibe la imagen de la tabla y la salida analizada, y responde si se preservaron el contenido, la estructura y el formato. Eso maneja la variación legítima que las métricas de cadena castigan, y añade una segunda fuente de error: el juez puede marcar una salida correcta como incorrecta.
La tasa de error del juez es parte del benchmark, independientemente de si el artículo la reporta.
El patrón no es exclusivo de los jueces LLM. Una comparación propia de ocho motores de recibos encontró que CER y la F1 a nivel de campo clasificaban los mismos sistemas en direcciones opuestas (por qué CER engaña en el análisis de documentos). Una métrica es una lente con una forma, y la mayoría de los informes describe solo una.
Cómo un juez LLM convierte una tabla en un solo número
Un juez LLM comprime cientos de decisiones a nivel de celda en un único veredicto, y cada paso de compresión es un punto donde una salida correcta puede marcarse como errónea.
El emparejamiento va primero. Algo tiene que decidir qué tabla analizada corresponde a qué tabla de referencia. Los analizadores dividen una tabla en dos, fusionan dos en una y reordenan tablas a lo largo de una página de varias columnas. Un paso de emparejamiento, a menudo otra llamada al modelo, elige una correspondencia. Si elige mal, el juez puntúa una tabla correcta contra la referencia equivocada y reporta errores que no existen. El estudio de 2026 que validó el juicio con LLM construyó este pipeline de forma explícita (arXiv:2603.18652).
Luego la rúbrica. Un juez típico responde tres preguntas por par: si los valores de las celdas son correctos, si la estructura es correcta y si el formato es correcto. Algunos prompts devuelven tres valores booleanos; otros piden una puntuación de 0 a 10. En cualquier caso, el juez decide qué significa "la misma tabla", y esa decisión no está escrita en ningún lugar inspeccionable.
Después la agregación. Tres valores booleanos se reducen a marcado o no marcado. Una puntuación de 0 a 10 se reduce a una media sobre el conjunto de prueba. Una tabla de 40 filas y una de 4 filas aportan un número cada una. Una fila omitida, una columna traspuesta y un total desviado por un factor de diez se convierten todos en una unidad de crédito perdido.
Dónde entran los falsos positivos
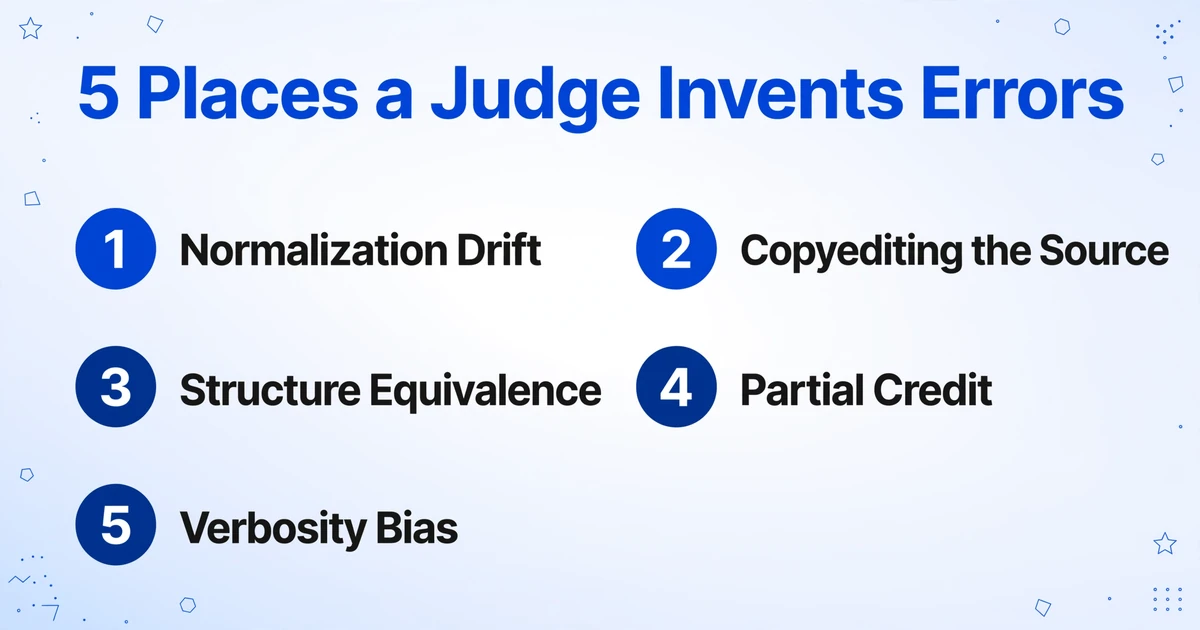
Los falsos positivos entran en cinco puntos concretos, y cada uno produce un tipo distinto de número erróneo.
| Punto de entrada | Qué hace el juez | Efecto en la puntuación |
|---|---|---|
| Normalización | Decide si 1,234.00, 1234 y $1,234 son el mismo valor, y si las mayúsculas o una celda en blanco importan | El mismo par puede pasar en una ejecución y fallar en la siguiente si la regla es implícita |
| Corrección de estilo de la fuente | Lee una errata evidente como la palabra pretendida y luego marca la transcripción fiel como errónea | Una celda correcta se registra como un error de OCR que nunca ocurrió |
| Equivalencia estructural | Trata un encabezado combinado y dos celdas divididas como diferentes, o una tabla dividida por un salto de página como dos tablas | Las codificaciones válidas se penalizan, y la penalización crece con la complejidad del diseño |
| Crédito parcial | Otorga crédito fraccionario, de modo que un total erróneo y una nota al pie errónea cuestan cantidades similares | La gravedad desaparece de la puntuación |
| Verbosidad | Lee una salida más larga con encabezados repetidos como más completa | El relleno puede elevar la puntuación sin añadir celdas correctas |
El primer punto de entrada tiene una solución documentada. OCR-D, el proyecto de coordinación alemán para OCR, define sus reglas de puntuación antes de cualquier comparación: niveles explícitos de transcripción de verdad fundamental, normalización Unicode NFC y un CER normalizado (especificación de aseguramiento de calidad de OCR-D). Sus directrices de transcripción añaden que los errores de impresión no se corrigen, porque la fidelidad los incluye (directrices de verdad fundamental de OCR-D). Un LLM judge toma ambas decisiones dentro de un prompt, por llamada, sin un reglamento versionado.
La estructura tiene la misma forma. TEDS puntúa el árbol HTML, por lo que dos codificaciones que un lector llamaría la misma tabla pueden producir árboles distintos. El artículo de GriTS (2023) señala que las medidas con crédito parcial se popularizaron en parte porque son menos sensibles al ruido de la verdad fundamental (arXiv:2203.12555). Una métrica que absorbe el ruido de la verdad fundamental también absorbe errores reales, un intercambio razonable para la investigación y peligroso para una decisión de compra.
Cada una de estas decisiones es defendible por sí sola. En conjunto, hacen que la puntuación sea tanto una función de las preferencias del juez como de la salida del analizador.
El equilibrio entre precisión y exhaustividad pertenece al juez
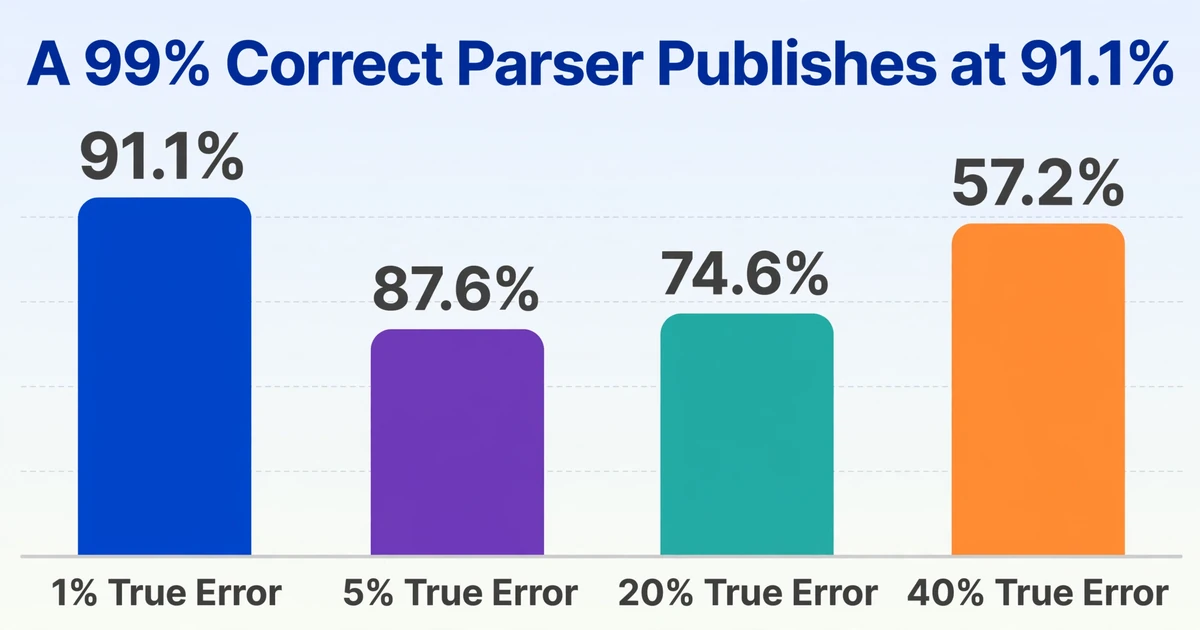
Ajustar un juez para que detecte más tablas corruptas eleva su tasa de falsos positivos, y con tasas de error bajas la tasa de falsos positivos se convierte en el número que se reporta.
Un juez tiene dos propiedades relevantes. Su tasa de verdaderos positivos (TPR) es la proporción de salidas realmente corruptas que señala. Su tasa de falsos positivos (FPR) es la proporción de salidas correctas que señala de todos modos. En términos de benchmark, la precisión es la proporción de tablas señaladas que realmente están mal, y la exhaustividad es la proporción de tablas erróneas que fueron señaladas. Si ambas tasas se mantuvieran constantes, la tasa de error reportada sería:
tasa de error reportada = FPR + tasa de error real × (TPR − FPR)
Introduzca un juez con un TPR del 95 por ciento y un FPR del 8 por ciento. Estos números provienen de la fórmula, no de un benchmark específico.
| Tasa de error real | Tasa de error reportada | Exactitud reportada |
|---|---|---|
| 1% | 8.9% | 91.1% |
| 5% | 12.4% | 87.6% |
| 20% | 25.4% | 74.6% |
| 40% | 42.8% | 57.2% |
Bajo esos supuestos, un analizador que es 99 por ciento correcto se publica al 91,1 por ciento. Los analizadores del 99 y el 95 por ciento siguen clasificándose en orden, pero la brecha se reduce de 4 puntos a 3,5. El número absoluto es el piso de ruido del juez más una versión comprimida de la tasa de error real.
El orden solo se mantiene mientras la FPR es constante, y hay pocas razones para suponer que lo sea. Una tabla densa da al juez más celdas que objetar que una de cuatro celdas, y las convenciones de diseño varían según el tipo de documento, por lo que la tasa se mueve con la mezcla de documentos. Con una FPR del 5 por ciento en tablas simples y del 15 por ciento en las complejas, un analizador que es mejor en tablas complejas puede perder frente a uno que es mejor en tablas simples. La clasificación se invierte en silencio.
La disyuntiva es una configuración, no una propiedad del analizador. Un benchmark ajustado para detectar cada error inyectado opera con alta exhaustividad y acepta falsas alarmas. Una barrera de producción suele ajustarse para la precisión y acepta omisiones. Un equipo puede mejorar su puntuación en el benchmark y seguir viendo la misma tasa de excepciones en producción.
Los equipos de producción ya gestionan esta palanca. Los umbrales de confianza mueven la precisión y la exhaustividad, y el umbral fija el tamaño de la cola de revisión (tasas de excepciones en la automatización de documentos). Un benchmark que reporta una sola puntuación sin el punto de operación de su juez oculta la misma elección.
Un ingeniero que ejecuta evaluaciones describió el bucle en un hilo de r/mlops: el juez es inconsistente ante cambios de redacción, está "sesgado hacia respuestas más largas", racionaliza salidas que el conjunto de referencia marca como erróneas, y la calibración se convierte en "apilar reglas de prompt sobre reglas de prompt esperando que bajen los falsos positivos" (r/mlops).
Lo que la evidencia muestra en realidad
Los jueces LLM siguen el juicio humano mejor que cualquier métrica de cadenas, y coinciden entre sí más de lo que coinciden los humanos entrenados, que es la parte que conviene tratar con cautela.
La evidencia actual más sólida es un estudio de 2026 sobre análisis de tablas con más de 1.500 valoraciones humanas (arXiv:2603.18652). Los jueces LLM se correlacionaron con las puntuaciones humanas en r = 0,93, frente a 0,68 de TEDS y 0,70 de GriTS. Excluyendo los analizadores que omiten tablas por completo, TEDS comprimió el resto entre 0,66 y 0,88, alrededor del 22 por ciento de su escala, mientras que las puntuaciones LLM abarcaron de 5,75 a 9,55. El juicio semántico recuperó diferencias que la métrica determinista aplanó.
Ese estudio también reportó la advertencia. Los jueces líderes se correlacionaron entre sí en 0,93 a 0,95, más alto que los anotadores humanos, que lo hicieron en 0,81 a 0,91. Los autores describen un prior LLM compartido que debe leerse como consenso de bajo ruido y no como verdad fundamental. El acuerdo entre jueces no es evidencia de que los jueces tengan razón. Puede ser evidencia de que comparten un punto ciego.
La referencia que se le da a un juez cambia sustancialmente su tasa de error. Un análisis de 2026 encontró que, a falta de una referencia correcta, los jueces coinciden con los expertos principalmente en las preguntas que el juez puede responder por sí mismo, y que una referencia escrita por humanos reduce tanto los falsos positivos como los falsos negativos. Una referencia ligeramente errónea puede ser peor que ninguna (arXiv:2503.05061). El estudio de MT-Bench llegó a un resultado compatible en 2023: en sus preguntas de matemáticas, el prompt de juez predeterminado produjo 14 veredictos erróneos de 20, y un prompt guiado por referencia produjo 3 (arXiv:2306.05685). El mismo estudio documentó sesgos de posición y de verbosidad.
Un juez con una referencia está comparando. Un juez sin ella responde de nuevo la pregunta y califica su propia respuesta.
Un juez más potente rara vez arregla una evaluación rota. Cambia el sesgo, no la estructura. Lo que funciona es una referencia, una rúbrica escrita y una tasa de error medida para el propio juez.
Cómo auditar a un juez antes de confiar en su cifra
Pida la tasa de falsos positivos del juez sobre salidas correctas por construcción antes de pedir la puntuación del analizador.
Construya un conjunto limpio donde la respuesta sea conocida
Convierta el HTML o Markdown de referencia en una imagen. La imagen ahora proviene de la respuesta, así que cada par es correcto por definición, sin ningún juicio de etiquetado.
Mida la tasa de falsos positivos en ese conjunto
Cada par que el juez rechaza es un error que el juez inventó. Comunique esa tasa junto a cada puntuación. Es el ruido de fondo del benchmark y, sin él, una diferencia de un punto no puede interpretarse.
Inyecte un error a la vez, por categoría
Cambie un número, elimine una fila, transponga una columna, quite un encabezado, añada énfasis. Mida la detección por categoría. Una única tasa agregada oculta puntos ciegos, incluidas las categorías de la rúbrica que más exigen sus documentos.
Exija que el juez muestre sus pruebas
Haga que cada veredicto incluya las coordenadas de celda y el texto de origen que el juez comparó. Un rechazo que no puede ubicar es una preferencia, no un hallazgo.
Calibre con humanos y versione el juez
Puntúe de 100 a 200 pares estratificados con dos anotadores y luego comunique la concordancia entre el juez y los humanos, no solo entre jueces. Registre el modelo, el prompt y las reglas de normalización, y vuelva a auditar cuando algo cambie.
Si evalúa proveedores en lugar de jueces, aplique la misma lógica a su conjunto de pruebas con este protocolo de pruebas de exactitud (protocolo de pruebas de exactitud).
Para una cifra publicada que no puede volver a ejecutar, cuatro preguntas le llevarán casi hasta el final. ¿Qué juez, versión de modelo y prompt la produjeron? ¿Cuál es la tasa de falsos positivos de ese juez sobre salidas correctas? ¿La tasa de error es por celda, por campo o por tabla, y todos los errores se ponderan por igual? ¿El conjunto de pruebas procede de los tipos de documento que usted procesa realmente?
Cuándo un LLM judge es el instrumento adecuado
Use un juez cuando varias salidas sean legítimamente correctas, y una comprobación determinista cuando solo lo sea una respuesta.
Encaja bien: equivalencia semántica entre formatos de salida, orden de lectura, triaje de una ejecución de regresión y comparación por pares. Preguntar cuál de dos salidas es mejor es más estable que preguntar si una es correcta, porque el juez tiene un contraste concreto en lugar de un estándar absoluto.
Encaja mal: totales numéricos sin una comprobación aritmética aparte, diferencias de puntuación que deciden una compra, seguimiento longitudinal entre versiones del juez y afirmaciones que deben superar una auditoría.
Hay una tercera opción entre las métricas de cadenas y los jueces. olmOCR 2 sustituyó la distancia de edición continua por pruebas unitarias binarias, cada una de las cuales afirma un hecho comprobable sobre una página, porque las puntuaciones continuas no siempre reflejan la exactitud (arXiv:2510.19817). Las pruebas unitarias son deterministas y pueden aceptar más de una codificación válida. Solo comprueban los hechos que alguien escribió, así que el diseño de las pruebas se convierte en el nuevo juicio, visible en el archivo de pruebas.
El lado determinista necesita la misma disciplina: ocho motores de recibos se ordenan de forma distinta según el coste, el CER y el F1 de campos, y ninguno de esos órdenes es erróneo (OCR tradicional frente a VLM de análisis de documentos). El error es informar de un solo eje y llamarlo exactitud.
Sea cual sea el instrumento que use, publique dos cifras: la puntuación y la tasa de falsos positivos del juez. Un benchmark que informa de ambas hace una afirmación que usted puede comprobar.
El mismo estándar sirve para sus propios archivos: compare una muestra de celdas con la fuente antes de decidir que una puntuación es lo bastante buena. Una capa de revisión que resalte la región de origen detrás de cada celda hace que esa comprobación sea rápida.
Preguntas frecuentes
¿Cómo sé si un juez LLM se equivoca con mi tabla?
No puede saberlo solo con la puntuación. Construya un conjunto donde la respuesta se conozca por construcción, mida con qué frecuencia el juez rechaza esos pares y exíjale que señale la celda y el texto de origen detrás de cada rechazo.
¿Cuál es una tasa normal de falsos positivos para un juez LLM?
No existe una línea base publicada. La tasa depende del modelo, la rúbrica, el tipo de documento y cuánto formato pregunta la rúbrica. Un juez que marca el 5 por ciento de las tablas limpias y otro que marca el 20 por ciento pueden ambos tener razón para trabajos distintos.
¿Por qué un mejor analizador de tablas obtiene una puntuación más baja en un benchmark?
La tasa de falsos positivos del juez puede ser mayor en los documentos donde el analizador es más fuerte. El analizador también puede usar una codificación que la referencia no usa, como celdas de encabezado divididas o Markdown en lugar de HTML, o el paso de emparejamiento lo emparejó con la tabla equivocada.
¿Debo usar TEDS o un juez LLM para la extracción de tablas?
Reporte ambos cuando la decisión importe. TEDS es económico pero penaliza codificaciones equivalentes. Un juez LLM se acerca más al juicio humano, pero necesita su propia auditoría. Su desacuerdo le indica qué modo de fallo le importa a su caso.
Los benchmarks de OCR de tablas seguirán usando jueces LLM, porque la alternativa es una métrica de cadenas que penaliza las tablas correctas por usar una codificación diferente. La pregunta útil ya no es si usar un juez. Es si el benchmark midió su juez antes de medir el analizador.
Compruebe la exactitud de extracción en una muestra de sus documentos