Faux positifs du juge LLM
dans les benchmarks d'OCR de tableaux
Sur OmniDocBench v1.6, un benchmark public d'analyse de documents, les parseurs de tableaux récents dépassent 93 TEDS, le score standard de structure de tableau. Sur un ensemble plus difficile de tableaux réels de la même étude de 2026, le parseur le plus performant atteint 85,03 (arXiv:2608.09842). La lecture habituelle est qu'un benchmark est plus facile que l'autre. Il en existe une seconde : entre un tableau analysé et le chiffre du classement se trouve un instrument de notation, et pour de nombreux benchmarks de tableaux cet instrument est un juge LLM, un modèle chargé de noter la sortie du parseur, dont le taux d'erreur n'est jamais affiché à côté du score.
Points clés
- Un juge LLM, un modèle qui note la sortie du parseur, correspond aux scores humains sur les tableaux à r = 0,93, là où TEDS atteint 0,68.
- Avec un taux de faux positifs du juge de 8 %, un parseur correct à 99 % est publié à 91,1 % d'exactitude.
- Demandez le taux de faux positifs du juge sur des tableaux corrects par construction, car sans lui, un écart d'un point ne peut pas être interprété.
Chaque score d'OCR de tableau passe par un juge
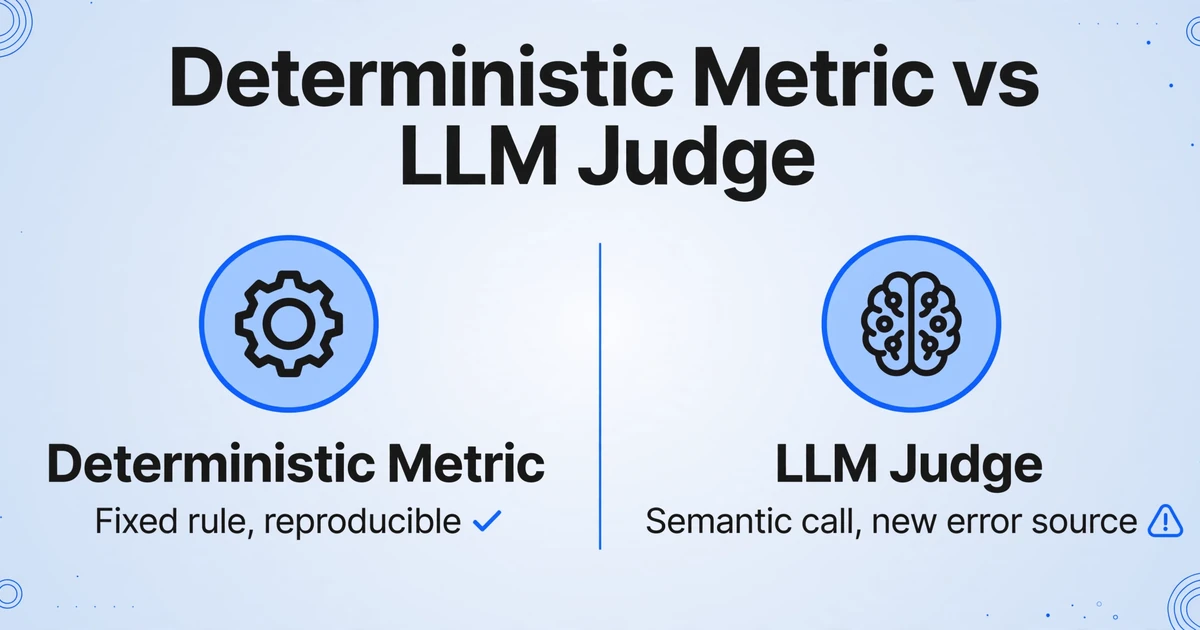
Un score de benchmark d'OCR de tableau mesure deux choses à la fois : le parseur et la fonction de notation qui l'évalue.
Les métriques déterministes comparent le tableau parsé à une référence de manière fixe. TEDS (Tree-Edit-Distance-based Similarity) transforme les deux tableaux en arbres et compte les éditions entre eux. Le F1 au niveau des cellules compare les valeurs par position. CER (taux d'erreur sur les caractères) compte les insertions, substitutions et suppressions de caractères. Chacune est reproductible, peu coûteuse et repose sur un choix de normalisation : la casse compte-t-elle, 1,234.00 équivaut-il à 1234, une cellule vide équivaut-elle à une chaîne vide.
Un LLM judge remplace cette règle fixe par une décision sémantique. Il reçoit l'image du tableau et la sortie parsée et répond si le contenu, la structure et le formatage ont été préservés. Cela gère les variations légitimes que les métriques de chaînes pénalisent, et ajoute une seconde source d'erreur : le juge peut marquer une sortie correcte comme erronée.
Le taux d'erreur du juge fait partie du benchmark, que l'article le rapporte ou non.
Le schéma n'est pas propre aux LLM judges. Une comparaison interne de huit moteurs de reçus a montré que CER et le F1 au niveau des champs classaient les mêmes systèmes dans des directions opposées (pourquoi CER induit en erreur sur le parsing de documents). Une métrique est une lentille avec une forme, et la plupart des rapports n'en décrivent qu'une.
Comment un juge LLM transforme un tableau en un seul chiffre
Un juge LLM compresse des centaines de décisions au niveau des cellules en un seul verdict, et chaque étape de compression est un endroit où une sortie correcte peut être marquée comme fausse.
La mise en correspondance vient d'abord. Il faut décider quel tableau parsé correspond à quelle table de référence. Les parseurs divisent un tableau en deux, fusionnent deux tableaux en un, et réordonnent les tableaux sur une page multi-colonnes. Une étape de mise en correspondance, souvent un autre appel au modèle, choisit une correspondance. Si elle choisit mal, le juge évalue un tableau correct contre la mauvaise référence et signale des erreurs qui n'existent pas. L'étude de 2026 qui a validé l'évaluation par LLM a construit ce pipeline explicitement (arXiv:2603.18652).
Puis la grille d'évaluation. Un juge typique répond à trois questions par paire : les valeurs des cellules sont-elles correctes, la structure est-elle correcte, le formatage est-il correct. Certains prompts renvoient trois booléens ; d'autres demandent une note de 0 à 10. Dans les deux cas, le juge décide ce que signifie « le même tableau », et cette décision n'est écrite nulle part où l'on puisse l'inspecter.
Puis l'agrégation. Trois booléens se réduisent à signalé ou non signalé. Une note de 0 à 10 se réduit à une moyenne sur l'ensemble de test. Un tableau de 40 lignes et un tableau de 4 lignes contribuent chacun pour un chiffre. Une ligne supprimée, une colonne transposée et un total erroné d'un facteur dix deviennent tous une unité de crédit perdu.
Où les faux positifs s'introduisent
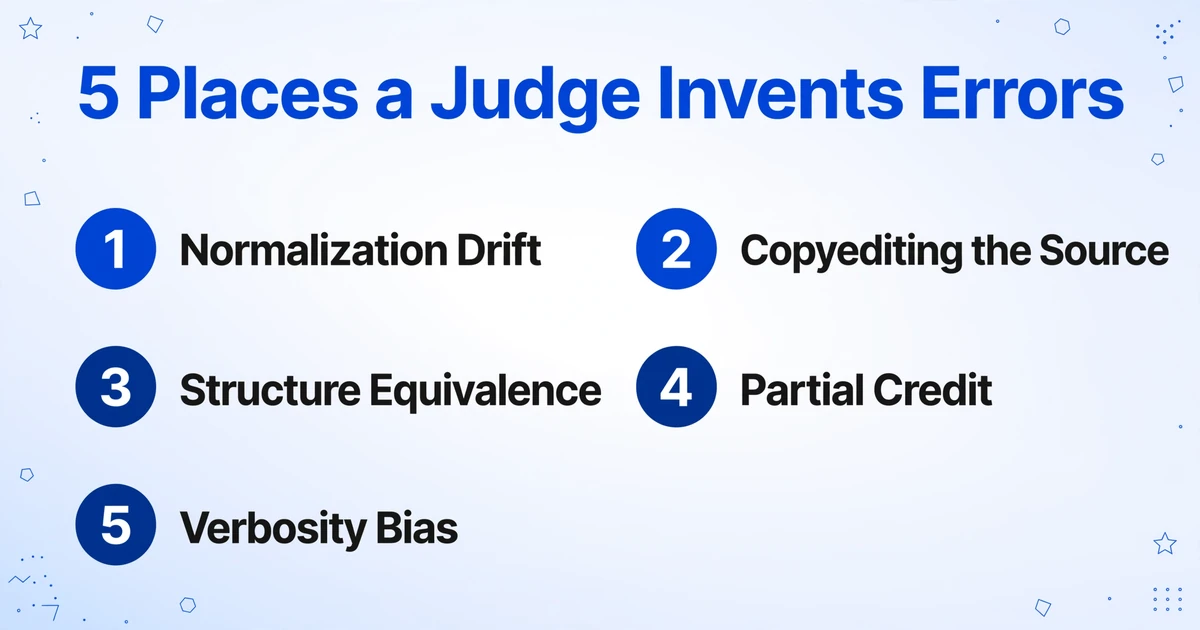
Les faux positifs s'introduisent à cinq points précis, et chacun produit un type différent de chiffre erroné.
| Point d'entrée | Ce que fait le juge | Effet sur le score |
|---|---|---|
| Normalisation | Décide si 1,234.00, 1234 et $1,234 sont la même valeur, et si la casse ou une cellule vide compte | La même paire peut réussir lors d'une exécution et échouer à la suivante si la règle est implicite |
| Réécriture de la source | Lit une faute de frappe évidente comme le mot voulu, puis marque la transcription fidèle comme fausse | Une cellule correcte est enregistrée comme une erreur OCR qui n'a jamais eu lieu |
| Équivalence de structure | Traite un en-tête fusionné et deux cellules séparées comme différents, ou un tableau coupé par un saut de page comme deux tableaux | Des encodages valides sont pénalisés, et la pénalité augmente avec la complexité de la mise en page |
| Crédit partiel | Accorde un crédit fractionnaire, si bien qu'un total erroné et une note de bas de page erronée coûtent des montants similaires | La gravité disparaît du score |
| VerbosIté | Lit une sortie plus longue avec des en-têtes répétés comme plus complète | Le remplissage peut augmenter le score sans ajouter de cellules correctes |
Le premier point d'entrée dispose d'une solution documentée. OCR-D, le projet de coordination allemand pour l'OCR, définit ses règles de notation avant toute comparaison : niveaux de transcription de vérité terrain explicites, normalisation Unicode NFC et CER normalisé (spécification d'assurance qualité OCR-D). Ses directives de transcription ajoutent que les erreurs d'impression ne sont pas corrigées, car la fidélité les inclut (directives de vérité terrain OCR-D). Un juge LLM prend ces deux décisions dans un prompt, à chaque appel, sans référentiel de règles versionné.
La structure présente la même configuration. TEDS note l'arbre HTML, de sorte que deux encodages qu'un lecteur considérerait comme le même tableau peuvent produire des arbres différents. L'article GriTS (2023) note que les mesures à crédit partiel sont devenues populaires en partie parce qu'elles sont moins sensibles au bruit de la vérité terrain (arXiv:2203.12555). Une métrique qui absorbe le bruit de la vérité terrain absorbe aussi les vraies erreurs : un compromis raisonnable pour la recherche, dangereux pour une décision d'achat.
Chacune de ces décisions est défendable isolément. Ensemble, elles font du score une fonction des préférences du juge autant que de la sortie du parseur.
Le compromis précision-rappel appartient au juge
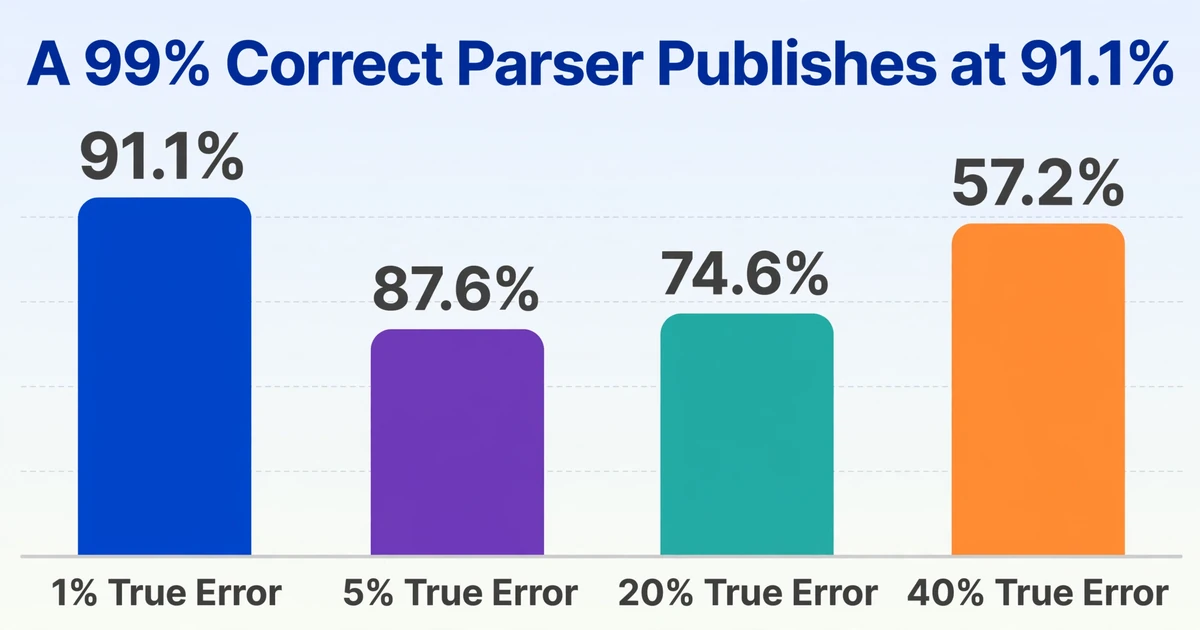
Resserrer un juge pour qu'il détecte davantage de tableaux corrompus augmente son taux de faux positifs, et à faible taux d'erreur, le taux de faux positifs devient le chiffre que vous publiez.
Un juge possède deux propriétés pertinentes. Son taux de vrais positifs (TPR) est la part des sorties réellement corrompues qu'il signale. Son taux de faux positifs (FPR) est la part des sorties correctes qu'il signale malgré tout. En termes de benchmark, la précision est la part des tableaux signalés qui sont réellement erronés, et le rappel est la part des tableaux erronés qui ont été signalés. Si ces deux taux restaient constants, le taux d'erreur rapporté serait :
taux d'erreur rapporté = FPR + taux d'erreur réel × (TPR − FPR)
Prenons un juge avec un TPR de 95 % et un FPR de 8 %. Ces chiffres proviennent de la formule, non d'un benchmark spécifique.
| Taux d'erreur réel | Taux d'erreur rapporté | Exactitude rapportée |
|---|---|---|
| 1 % | 8,9 % | 91,1 % |
| 5 % | 12,4 % | 87,6 % |
| 20 % | 25,4 % | 74,6 % |
| 40 % | 42,8 % | 57,2 % |
Sous ces hypothèses, un parseur correct à 99 % est publié à 91,1 %. Les parseurs à 99 % et 95 % restent classés dans l'ordre, mais l'écart se réduit de 4 points à 3,5. Le chiffre absolu correspond au plancher de bruit du juge plus une version compressée du taux d'erreur réel.
L'ordre ne survit que tant que le FPR est constant, et rien ne permet de supposer qu'il le soit. Un tableau dense offre au juge plus de cellules à contester qu'un tableau de quatre cellules, et les conventions de mise en page varient selon le type de document : le taux évolue donc avec le corpus. À 5 % de FPR sur les tableaux simples et 15 % sur les tableaux complexes, un parseur meilleur sur les tableaux complexes peut perdre face à un parseur meilleur sur les tableaux simples. Le classement s'inverse sans bruit.
Ce compromis est un réglage, pas une propriété du parseur. Un benchmark calibré pour détecter chaque erreur injectée tourne à haut rappel et accepte les fausses alertes. Une barrière de production est généralement réglée pour la précision et accepte les manques. Une équipe peut améliorer son score de benchmark et constater le même taux d'exceptions en production.
Les équipes de production maîtrisent déjà ce levier. Les seuils de confiance déplacent la précision et le rappel, et le seuil détermine la taille de la file de révision (taux d'exceptions de l'automatisation documentaire). Un benchmark qui publie un score unique sans le point de fonctionnement de son juge masque le même choix.
Un ingénieur qui exécute des évaluations a décrit la boucle dans un fil r/mlops : le juge est incohérent face aux changements de formulation, « biaisé en faveur des réponses longues », rationalise des sorties que l'ensemble de référence marque comme fausses, et la calibration devient « empiler des règles de prompt sur des règles de prompt en espérant que les faux positifs diminuent » (r/mlops).
Ce que les preuves montrent réellement
Les juges LLM suivent le jugement humain mieux que n'importe quelle métrique de chaîne, et ils s'accordent entre eux plus que ne le font des humains entraînés — c'est précisément ce point qu'il faut manier avec prudence.
La preuve la plus solide à ce jour est une étude de 2026 sur le parsing de tableaux, avec plus de 1 500 évaluations humaines (arXiv:2603.18652). Les juges LLM corrélaient avec les scores humains à r = 0,93, contre 0,68 pour TEDS et 0,70 pour GriTS. En excluant les parseurs qui ratent complètement les tableaux, TEDS comprimait le reste entre 0,66 et 0,88, soit environ 22 % de son échelle, tandis que les scores LLM s'étendaient de 5,75 à 9,55. Le jugement sémantique récupérait des différences que la métrique déterministe aplatissait.
Cette étude a aussi livré l'avertissement. Les principaux juges corrélaient entre eux à 0,93–0,95, plus que les annotateurs humains à 0,81–0,91. Les auteurs décrivent un a priori LLM partagé, à lire comme un consensus à faible bruit plutôt que comme une vérité terrain. L'accord entre juges ne prouve pas que les juges ont raison. Il peut prouver qu'ils partagent un angle mort.
La référence fournie à un juge modifie sensiblement son taux d'erreur. Une analyse de 2026 a constaté qu'en l'absence de référence correcte, les juges ne s'accordent avec les experts que sur les questions que le juge peut résoudre lui-même, et qu'une référence rédigée par un humain réduit à la fois les faux positifs et les faux négatifs. Une référence légèrement erronée peut être pire que pas de référence du tout (arXiv:2503.05061). L'étude MT-Bench est parvenue à un résultat compatible en 2023 : sur ses questions de mathématiques, le prompt de juge par défaut produisait 14 verdicts erronés sur 20, contre 3 avec un prompt guidé par une référence (arXiv:2306.05685). La même étude documentait les biais de position et de verbosité.
Un juge avec une référence compare. Un juge sans référence répond à nouveau à la question et note sa propre réponse.
Un juge plus puissant corrige rarement une évaluation défaillante. Il modifie le biais, pas la structure. Ce qui fonctionne, c'est une référence, une grille d'évaluation écrite et un taux d'erreur mesuré pour le juge lui-même.
Comment auditer un juge avant de faire confiance à son chiffre
Demandez le taux de faux positifs du juge sur des sorties correctes par construction avant de demander le score du parseur.
Construisez un ensemble propre dont la réponse est connue
Rendez le HTML ou le Markdown de référence sous forme d'image. L'image provient désormais de la réponse, donc chaque paire est correcte par définition, sans aucun jugement d'annotation.
Mesurez le taux de faux positifs sur cet ensemble
Chaque paire que le juge rejette est une erreur qu'il a inventée. Rapportez ce taux à côté de chaque score. C'est le plancher de bruit du benchmark, et sans lui, une différence d'un point ne peut pas être interprétée.
Injectez une erreur à la fois, par catégorie
Modifiez un chiffre, supprimez une ligne, transposez une colonne, supprimez un en-tête, ajoutez une mise en évidence. Mesurez la détection par catégorie. Un taux agrégé unique masque les angles morts, y compris les catégories de la grille d'évaluation que vos documents sollicitent le plus.
Exigez que le juge montre ses preuves
Faites en sorte que chaque verdict inclue les coordonnées de cellule et le texte source que le juge a comparés. Un rejet qu'il ne peut pas localiser est une préférence, pas une conclusion.
Calibrez sur des humains et versionnez le juge
Notez 100 à 200 paires stratifiées avec deux annotateurs, puis rapportez l'accord entre le juge et les humains, pas seulement entre juges. Consignez le modèle, le prompt et les règles de normalisation, et refaites l'audit dès que l'un d'eux change.
Si vous évaluez des fournisseurs plutôt que des juges, appliquez la même logique à leur ensemble de test à l'aide de ce protocole de test d'exactitude (protocole de test d'exactitude).
Pour un chiffre publié que vous ne pouvez pas reproduire, quatre questions vous mènent l'essentiel du chemin. Quel juge, quelle version de modèle et quel prompt l'ont produit ? Quel est le taux de faux positifs de ce juge sur des sorties correctes ? Le taux d'erreur est-il par cellule, par champ ou par tableau, et toutes les erreurs sont-elles pondérées de la même façon ? L'ensemble de test est-il tiré des types de documents que vous traitez réellement ?
Quand un juge LLM est l'instrument adapté
Utilisez un juge lorsque plusieurs sorties sont légitimement correctes, et une vérification déterministe lorsqu'une seule réponse l'est.
Bon usage : équivalence sémantique entre formats de sortie, ordre de lecture, triage d'une exécution de régression et comparaison par paires. Demander laquelle de deux sorties est la meilleure est plus stable que de demander si l'une est correcte, car le juge dispose d'un contraste concret plutôt que d'un standard absolu.
Mauvais usage : totaux numériques sans vérification arithmétique distincte, écarts de score qui décident d'un achat, suivi longitudinal entre versions de juge, et affirmations qui doivent résister à un auditeur.
Une troisième option se situe entre les métriques de chaînes et les juges. olmOCR 2 a remplacé la distance d'édition continue par des tests unitaires binaires, chacun vérifiant un fait contrôlable sur une page, car les scores continus ne suivent pas toujours l'exactitude (arXiv:2510.19817). Les tests unitaires sont déterministes et peuvent accepter plusieurs encodages valides. Ils ne vérifient que les faits que quelqu'un a écrits, si bien que la conception des tests devient le nouveau jugement à porter, visible dans le fichier de test.
Le côté déterministe exige la même discipline : huit moteurs de reçus se classent différemment selon le coût, le CER et le F1 par champ, et aucun de ces classements n'est faux (OCR traditionnel vs VLM d'analyse de documents). L'erreur consiste à rapporter un seul axe et à l'appeler exactitude.
Quel que soit l'instrument utilisé, publiez deux chiffres : le score et le taux de faux positifs du juge. Un benchmark qui rapporte les deux avance une affirmation que vous pouvez vérifier.
La même norme s'applique à vos propres fichiers : comparez un échantillon de cellules avec la source avant de décider qu'un score est suffisant. Une couche de révision qui met en évidence la région source derrière chaque cellule rend cette vérification rapide.
Questions fréquentes
Comment savoir si un juge LLM se trompe sur mon tableau ?
Le score seul ne permet pas de le savoir. Construisez un ensemble dont la réponse est connue par construction, mesurez la fréquence à laquelle le juge rejette ces paires, et exigez qu'il indique la cellule et le texte source à l'appui de chaque rejet.
Quel est un taux de faux positifs normal pour un juge LLM ?
Il n'existe aucune référence publiée. Le taux dépend du modèle, de la grille d'évaluation, du type de document et de la part de mise en forme sur laquelle porte la grille d'évaluation. Un juge qui signale 5 pour cent des tableaux propres et un autre qui en signale 20 pour cent peuvent tous deux avoir raison pour des usages différents.
Pourquoi un meilleur parseur de tableaux obtient-il un score plus faible sur un benchmark ?
Le taux de faux positifs du juge peut être plus élevé sur les documents où le parseur est le plus performant. Le parseur peut aussi utiliser un encodage que la référence n'utilise pas, comme des cellules d'en-tête scindées ou du Markdown au lieu de HTML, ou l'étape d'appariement l'a associé au mauvais tableau.
Faut-il utiliser TEDS ou un juge LLM pour l'extraction de tableaux ?
Rapportez les deux lorsque la décision compte. TEDS est peu coûteux mais pénalise les encodages équivalents. Un juge LLM est plus proche du jugement humain mais nécessite son propre audit. Leur désaccord vous indique le mode de défaillance qui importe dans votre cas.
Les benchmarks d'OCR de tableaux continueront d'utiliser des juges LLM, car l'alternative est une métrique de chaînes qui pénalise les tableaux corrects pour avoir utilisé un encodage différent. La question utile n'est plus de savoir s'il faut utiliser un juge. Elle est de savoir si le benchmark a mesuré son juge avant de mesurer le parseur.
Vérifiez l'exactitude de l'extraction sur un échantillon de vos documents