Kreditkartenabrechnung extrahieren:
Was die meisten Tools falsch machen
US-Verbraucher tätigten 2024 durchschnittlich 48 Zahlungen pro Monat — Kreditkarten machten 35 % aller Transaktionen aus, mehr als jede andere Zahlungsmethode. Jede dieser Abbuchungen erzeugt eine Zeile auf einer Abrechnung. Für einen Kleinunternehmer mit einer einzigen Firmenkarte sind das 50–150 Transaktionen pro Monat. Jede dieser Zeilen muss in einer Tabelle landen — für Abstimmung, Kategorisierung und Steuervorbereitung.
Das Problem ist nicht, ein Tool zu finden, das angeblich Kreditkartenabrechnungen extrahiert. Es ist, dass die meisten Ergebnisse liefern, die Sie trotzdem noch bereinigen müssen — verschobene Zeilen, Credit-Beträge mit Debit vermischt, Zwischensummen als Transaktionen missverstanden, abgeschnittene Händlernamen. Die Extraktionslücke liegt nicht darin, ob das Tool Text lesen kann. Sie liegt darin, ob es versteht, was es liest.
Die wichtigsten Erkenntnisse
- Die meisten Tools zur Extraktion von Kreditkartenabrechnungen hinterlassen verstümmelte Ausgaben, die Sie selbst bereinigen müssen — verschobene Zeilen, als Transaktionen gelesene Zwischensummen, über Spalten verteilte Händlernamen — und die Bereinigung kostet 30 Minuten pro Abrechnung.
- Der Engpass ist nicht die OCR-Genauigkeit — sondern dass herkömmliche Extraktion jede Seite als einen flachen Textstrom liest und kein Konzept für die Purchases-Zone, die Payments-Zone oder die Fees-Zone hat, sodass sie alles zu einer einzigen unbrauchbaren Liste zusammenfügt.
- Semantische Extraktion liest eine Kreditkartenabrechnung wie ein Mensch — sie erkennt Zonen anhand der Bedeutung, nicht anhand von Pixelkoordinaten — und mit ImageToTable.ai definieren Sie Ihre Spalten einmal und kategorisieren dann jede Transaktion automatisch mit abgeleiteten Spalten, sodass Sie in wenigen Sekunden pro Seite sauberes Excel erhalten.
Warum Ihre Kreditkartenabrechnung traditionelle OCR überfordert
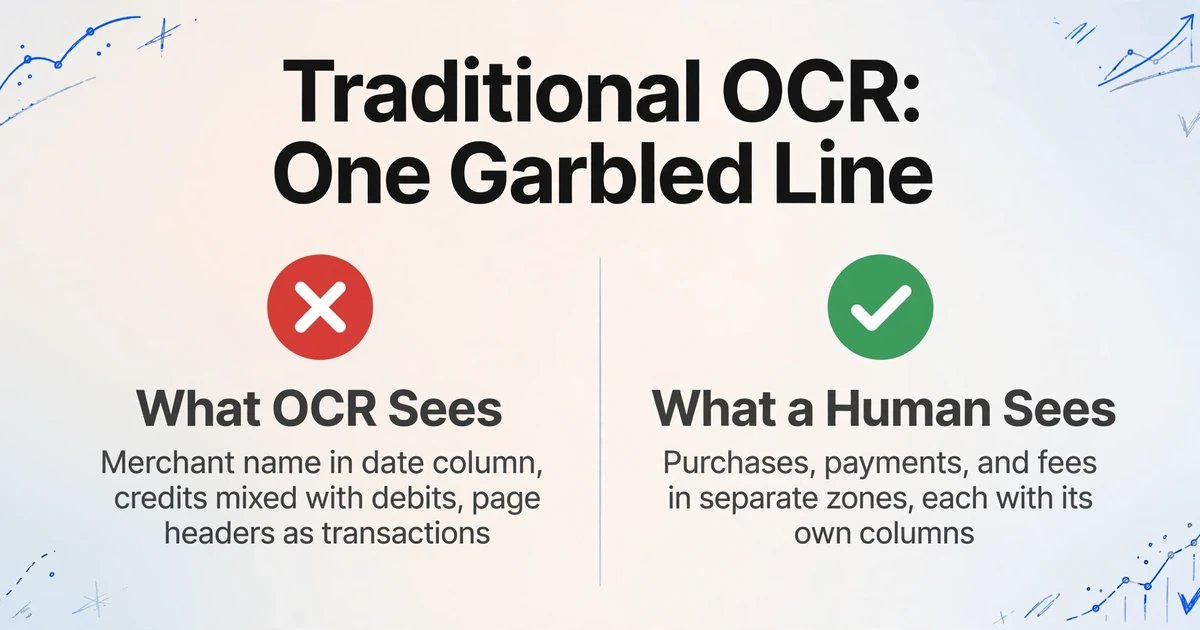
Eine Kreditkartenabrechnung ist keine flache Tabelle. Öffnen Sie eine beliebige Abrechnung von Chase, Amex oder Capital One, und Sie sehen mindestens drei verschiedene Datenbereiche auf derselben Seite: einen Bereich Purchases mit Spalten für Datum, Händler und Betrag; einen Bereich Payments & Credits mit eigener Spaltenstruktur; einen Bereich Fees & Interest, oft mit noch einem anderen Layout. Manche Herausgeber trennen Debit und Credit in nebeneinanderliegende Spalten. Andere stapeln alles in einer Spalte Amount und verwenden Vorzeichen. Manche setzen Referenznummern nach dem Händlernamen. Andere nutzen eine separate Spalte.
Traditionelle OCR erkennt keine Bereiche. Sie liest von links nach rechts, von oben nach unten und behandelt die gesamte Seite als einen durchgehenden Textstrom. Wenn eine Zahlungszeile drei Spalten hat, eine Kaufzeile aber vier, fügt OCR sie zu einer einzigen verfälschten Zeile zusammen. Die laufende Zwischensumme nach jeweils 15 Transaktionen — fett gedruckt und anders zentriert — wird als Transaktion ohne Beschreibung und mit unsinnigem Betrag gelesen. Der Kopf der Abrechnung (Kartennummer, Abrechnungszeitraum, Fälligkeitsdatum der Zahlung) fließt in die erste Transaktionszeile ein.
In einem r/Bookkeeping-Thread zum Konvertieren von Kreditkarten-PDFs nach Excel beschrieb ein Buchhalter das typische Ergebnis: „Die OCR-Ausgabe packt die Hälfte des Händlernamens in die Datumsspalte, mischt Credits und Debits durcheinander und übernimmt jede ‚continued on next page‘-Kopfzeile als Transaktion. Bis ich das bereinigt habe, hätte ich es auch gleich eintippen können.“ Das ist das OCR-Problem in der Praxis — nicht, dass es nicht lesen kann, sondern dass es nicht organisieren kann.
Es gibt eine zweite Ebene des Problems: die Kontinuität über mehrere Seiten. Eine monatliche Abrechnung mit 80 Transaktionen auf vier Seiten bedeutet, dass OCR vier separate Textblöcke erzeugt. Laufende Salden brechen über Seiten hinweg ab. Die Kopfzeile „continued from previous page“ auf Seite zwei wird als Datenzeile geparst. Die Zwischensumme im Seitenfuß auf Seite eins und der Übertrag in der Kopfzeile auf Seite zwei werden beide extrahiert, was zu doppelten Einträgen führt.
Und eine dritte Ebene: gescannte Abrechnungen. Selbst im Jahr 2026 erzeugen laut Branchen-Benchmarks, die von StatementDesk erfasst werden, etwa 15–20 % der kleineren Finanzinstitute noch bildbasierte PDFs statt textselektierbarer digitaler PDFs. Wenn Ihre Credit Union ein gescanntes PDF sendet oder Sie mit einem Foto einer Papierabrechnung arbeiten, sinkt die Genauigkeit traditioneller OCR sofort um 30–50 % — und alle drei oben genannten Probleme werden schlimmer.
Wie semantische Extraktion liest, was OCR nicht kann
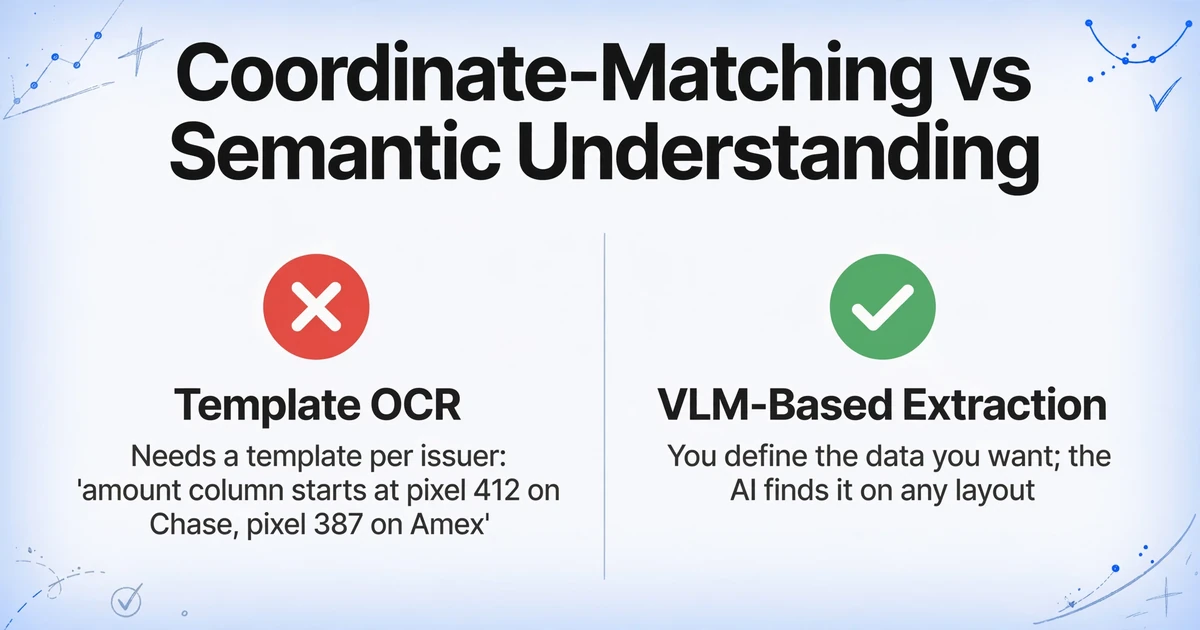
Das eigentliche Problem ist nicht die Zeichenerkennung. Es ist, dass OCR auf Zeichenebene stehen bleibt. Sie weiß, dass an Position (x,y) auf der Seite Text steht, aber sie weiß nicht, dass Position (x,y) zur Zone „Purchases" gehört, dass diese Zone vier Spalten hat, die durch ihre Kopfzeile definiert sind, und dass der Betrag in der vierten Spalte von Zeile 7 eine Debit- und keine Credit-Buchung darstellt. Genau dieses organisatorische Wissen – das einen Menschen einen Kontoauszug auf einen Blick erfassen lässt – fehlt.
Vision Large Models (VLM) schließen diese Lücke. Anders als vorlagenbasierte OCR, die Koordinaten abgleicht, liest ein VLM einen Kreditkartenauszug so, wie es ein Mensch tut: Es erkennt das Layout, versteht, dass „Payments & Credits" ein anderer Abschnitt ist als „Purchases", erkennt, dass die äußerste rechte Spalte in der Purchases-Zone der Transaktionsbetrag ist, und bewahrt die Zeilenstruktur über Seitenumbrüche hinweg. Das Modell braucht keine Vorlage für Chase vs. Amex, weil es nicht nach Koordinaten sucht – es sucht nach Bedeutung.
Dieser Wechsel vom Koordinatenabgleich zum semantischen Verständnis verändert das Machbare. Statt dem Tool zu sagen „die Betragsspalte beginnt bei Chase-Auszügen bei Pixel 412 und bei Amex-Auszügen bei Pixel 387", sagen Sie ihm, welche Daten Sie möchten. Die KI findet heraus, wo sie auf der jeweiligen Seite liegen.
Hier kommt die Benutzerdefinierte Spaltenextraktion ins Spiel – ein Mechanismus, der anders funktioniert als das, was die meisten Extraktionstools bieten. Statt für jeden Kartenherausgeber eine Vorlage vorzukonfigurieren oder manuell Rahmen um Datenfelder zu ziehen, tippen Sie einfach die Spaltennamen ein, die Sie in Ihrer fertigen Tabelle haben möchten: „Transaction Date", „Merchant Name", „Amount". Die KI liest das Dokument, versteht anhand der semantischen Bedeutung (nicht anhand der Pixelposition), welche Daten zu welchem Spaltennamen gehören, und füllt die Zeilen aus. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabetabelle – kein Vorlagentraining, keine Koordinatenzuordnung, keine Einrichtung pro Bank.
Schritt für Schritt: Transaktionen mit Benutzerdefinierter Spaltenextraktion extrahieren
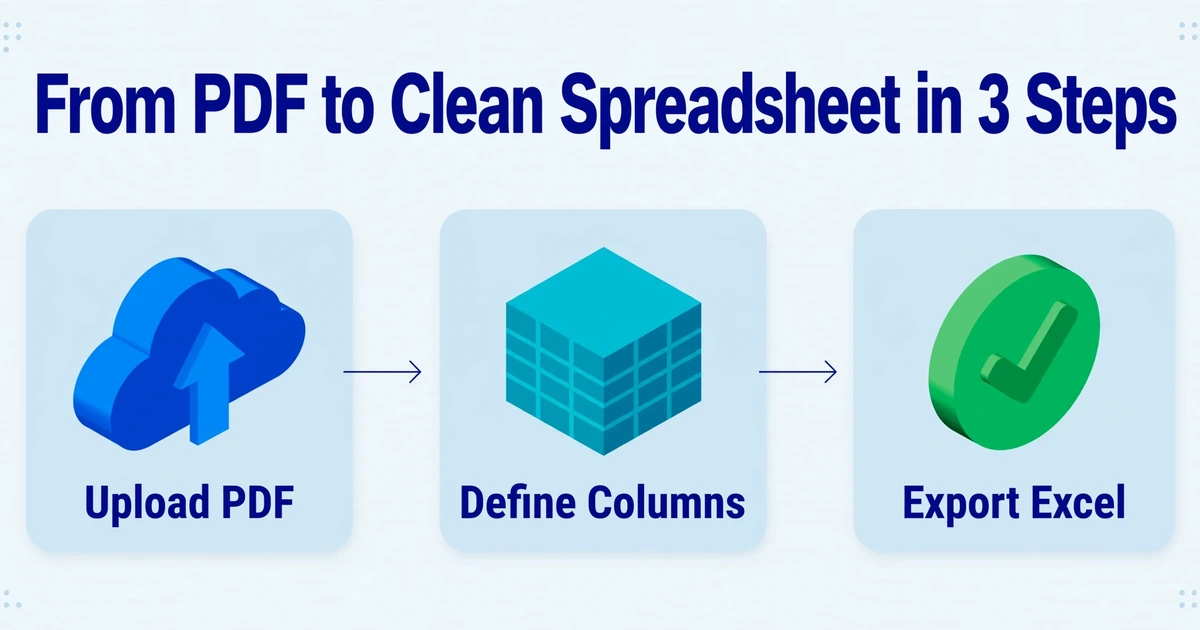
Hier ist der Workflow vom PDF-Auszug zur sauberen Excel-Tabelle – mit Benutzerdefinierter Spaltenextraktion legen Sie genau fest, welche Daten Sie möchten – nicht mehr und nicht weniger.
Schritt 1: Laden Sie Ihren Auszug hoch. Das Tool akzeptiert PDFs (digital oder gescannt), JPG, PNG und WebP. Wenn Sie einen mehrseitigen Auszug haben – etwa einen 4-seitigen Monatsauszug von Chase – können Sie die gesamte Datei auf einmal hochladen. Mehrseitige Dokumente werden als ein durchgehender Datensatz verarbeitet; Transaktionen von Seite 1, 2, 3 und 4 landen alle in derselben Ausgabetabelle, in der richtigen Reihenfolge. Wenn Sie Auszüge von mehreren Karten haben (zum Beispiel eine geschäftliche Amex und eine private Visa), laden Sie sie zusammen als Batch hoch und erhalten eine zusammengeführte Tabelle.
Schritt 2: Definieren Sie Ihre Spalten. Statt Extraktionsbereiche zu konfigurieren oder ein Modell zu trainieren, geben Sie einfach die Spaltennamen ein, die extrahiert werden sollen. Für ein vollständiges Transaktionsjournal gehören typischerweise folgende Spalten dazu:
Sie können auch Felder auf Kontoauszugsebene einbeziehen — Statement Period Start, Statement Period End, Payment Due Date, Minimum Payment Due — die die KI einmal aus dem Kopf des Kontoauszugs übernimmt und in jeder Transaktionszeile zur Referenz wiederholt. Das ist nützlich, wenn Sie mehrere Monate gleichzeitig verarbeiten und jede Zeile mit ihrem Abrechnungszeitraum kennzeichnen möchten.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schritt 3: Nach Excel exportieren. Sobald die KI die Extraktion abgeschlossen hat — in der Regel 5–10 Sekunden pro Seite — laden Sie eine strukturierte Excel-Datei (XLSX) herunter. Jede von Ihnen definierte Spalte wird zu einer Spalte in der Tabelle. Jede Transaktion wird zu einer Zeile. Die Daten sind bereits standardisiert: Datumsangaben in einheitlichem Format, Beträge als saubere Zahlen (keine Währungssymbole in der Zelle), Händlernamen bereinigt von bankinternen Codes. CSV- und JSON-Export sind ebenfalls verfügbar, wenn Sie in eine Buchhaltungssoftware importieren, die diese Formate bevorzugt. Einen tieferen Einblick in die vollständigen Extraktionsmöglichkeiten — einschließlich Fremdwährungsbehandlung, Multi-Zonen-Parsing über verschiedene Ausstellerformate hinweg und Batch-Verarbeitung über mehrere Monate — finden Sie auf der Seite zur Konvertierung von Kreditkartenabrechnungen nach Excel. Wenn Sie die Zeilen lieber direkt in Google Sheets haben möchten, ohne den Schritt des Herunterladens und Importierens, behandelt unser Artikel zum Extrahieren von Kreditkartenabrechnungen in Google Sheets den Workflow des Sidebar-Add-ons für dieselben Abrechnungen.
Transaktionen mit abgeleiteten Spalten automatisch kategorisieren
Transaktionsdaten aus einer PDF zu extrahieren löst das Extraktionsproblem. Doch für den Abgleich und die Steuervorbereitung ist die Extraktion nur der erste Schritt. Jede Transaktion benötigt weiterhin eine Kategorie – ist diese Amazon-Belastung Büromaterial, Ausrüstung oder eine private Ausgabe? Dieser Klassifizierungsschritt ist es, der den Großteil der manuellen Abgleichszeit in Anspruch nimmt.
Hier kommen abgeleitete Spalten ins Spiel. Im Gegensatz zu einer regulären Spalte, die explizit auf dem Dokument gedruckte Daten extrahiert, fordert eine abgeleitete Spalte die KI auf, etwas zu ermitteln, das das Dokument nicht direkt angibt – indem sie analysiert, was es aussagt. Sie definieren eine Spalte namens Category (options: Office Supplies/Equipment/Travel/Meals/Software/Utilities/Other), und für jede Transaktionszeile liest die KI den Händlernamen und den Transaktionskontext und wählt dann die am besten geeignete Kategorie aus.
Eine Belastung von „Staples“ mit einem Betrag von 42 $ wird „Office Supplies“ zugeordnet. „Delta Airlines“ mit 389 $ wird zu „Travel“. „Adobe Creative Cloud“ bei 59,99 $ wird zu „Software“. Die KI führt kein Keyword-Matching durch – sie nutzt dasselbe semantische Verständnis, das ihr auch das Parsen des Kontoauszuglayouts ermöglicht. Sie weiß, dass „Staples“ ein Bürobedarfshändler ist, dass „Delta“ eine Fluggesellschaft ist und dass eine Belastung von 3,50 $ von „Blue Bottle Coffee“ eine Mahlzeit ist, keine Ausrüstung.
Was dies für den Kreditkartenabgleich so leistungsstark macht, ist, dass Extraktion und Kategorisierung im selben Durchlauf erfolgen. Sie extrahieren keine Transaktionen nach Excel und verbringen dann eine weitere Stunde damit, manuell eine Kategoriespalte hinzuzufügen. Die KI füllt beide Spalten gleichzeitig. Und da abgeleitete Spalten über Batch-Uploads hinweg funktionieren – Kontoauszüge mehrerer Karten oder mehrerer Monate, die zusammen verarbeitet werden – erhalten Sie eine einzige Tabelle, in der jede Transaktion aus jeder Quelle bereits kategorisiert ist.
Kreditkartenabrechnung vs. Kontoauszug: Die Unterschiede bei der Extraktion
Es liegt nahe anzunehmen, dass eine Kreditkartenabrechnung und ein Kontoauszug dasselbe Extraktionsproblem darstellen – beide enthalten Transaktionstabellen mit Daten, Beschreibungen und Beträgen. In der Praxis stellen sie jedoch unterschiedliche Herausforderungen dar, und ein Tool, das für das eine optimiert ist, scheitert oft am anderen.
| Funktion | Kreditkartenabrechnung | Kontoauszug |
|---|---|---|
| Transaktionszonen | Mehrere Zonen pro Seite (Purchases, Payments, Fees, Interest) – jeweils mit unterschiedlichen Spaltenlayouts | In der Regel eine Transaktionstabelle pro Seite mit durchgängig konsistenten Spalten |
| Debit/Credit-Behandlung | Gemischt: eine einzelne Amount-Spalte mit Vorzeichen, separate Debit/Credit-Spalten oder zonenabhängige Konventionen | Meist separate Debit- und Credit-Spalten oder eine durchgängig konsistente Ein-Spalten-Konvention |
| Zwischensummen & Zusammenfassungszeilen | Häufig: Zwischensummen pro Zone, Seiten- und Gesamtsummen – hohes Risiko falscher Transaktionszeilen | Laufende Saldospalte dient als eingebaute Validierung; Zwischensummen sind seltener |
| Händlernamen | Inkonsistent: Derselbe Händler erscheint je nach Herausgeber als „AMZN“, „Amazon.com“, „AMAZON MKTPLACE“ | Standardisierter: Zahlungsempfängernamen folgen konsistent der internen Formatierung der Bank |
| Metadaten der Abrechnung | Payment Due Date, Minimum Payment, Kreditlimit, APR-Details – relevant für die Finanzplanung | Kontostand, Zinserträge, Überziehungsinformationen – anderer Metadatensatz |
Für die Extraktion von Kontoauszügen im Speziellen – die ihre eigenen Herausforderungen bei der Validierung des laufenden Saldos und der Prüfnummernanalyse mit sich bringt – behandelt Kontoauszug-Extraktion für kleine Unternehmen den Arbeitsablauf im Detail. Die wichtigste Erkenntnis für Kreditkartenabrechnungen ist, dass Zonenbewusstsein unerlässlich ist. Jedes Tool, das die gesamte Seite als eine flache Tabelle behandelt, vermischt Purchases, Payments und Fees zu einer unbrauchbaren einzigen Liste. Semantische Extraktion löst dies, indem sie den Kopfzeilentext erkennt – „Purchases“, „Payments and Credits“, „Interest Charged“ – und pro Zone unterschiedliche Parsing-Regeln anwendet, genau wie Ihre Augen es beim Lesen der Abrechnung tun.
Von der monatlichen Abstimmung zur Steuervorbereitung zum Jahresende
Der Grund, die Extraktion von Kreditkartenabrechnungen zu automatisieren, ist nicht nur, diesen Monat eine Stunde zu sparen. Es geht darum, was passiert, wenn Sie diese Stunde über Monate, Karten und Jahresendanforderungen multiplizieren.
Ein typischer Buchhaltungsablauf für kleine Unternehmen umfasst drei Abstimmungszyklen: monatlich (Kreditkartenabrechnungstransaktionen mit Belegen und General Ledger (GL)-Einträgen abgleichen), vierteljährlich (kategorisierte Ausgaben für geschätzte Steuerzahlungen zusammenstellen) und jährlich (Gesamtjahres-Transaktionsdaten für die CPA-Prüfung und Steuererklärung aggregieren). Auf jeder Ebene bestimmt die Qualität der zugrunde liegenden Transaktionsdaten, wie viel Arbeit die nächste Ebene erzeugt. Unordentliche Daten im monatlichen Stadium bedeuten, dass ein CPA mit 200+ USD/Stunde sie zum Jahresende entwirren muss.
Die monatliche Abstimmung ist der Bereich, in dem die automatisierte Extraktion die unmittelbarste Wirkung hat. Statt das Abrechnungs-PDF nebeneinander mit Excel zu öffnen und jede Zeile einzutippen, laden Sie die Abrechnung hoch, definieren Ihre Spalten einmal und erhalten in Sekunden eine saubere Tabelle. Wenn Sie monatlich drei Karten verarbeiten, ist das eine wiederkehrende Zeitersparnis, die sich summiert.
Für vierteljährliche geschätzte Steuerberechnungen sind kategorisierte Transaktionsdaten unerlässlich. Der IRS verlangt eine angemessene Grundlage für Betriebsausgaben gemäß Publication 535 (Business Expenses) – das bedeutet, Sie müssen nicht nur wissen, was Sie ausgegeben haben, sondern auch, unter welche Kategorie jede Ausgabe fällt. Mit abgeleiteten Spalten, die die Kategorisierung zum Zeitpunkt der Extraktion übernehmen, ist Ihre vierteljährliche Ausgabenübersicht bereits organisiert: Gesamtreisen, Gesamtbürobedarf, Gesamtsoftware-Abonnements, jeweils als Zeile in einer pivotfähigen Tabelle.
Zum Jahresende ist der Unterschied deutlicher. Die meisten kleinen Unternehmen zahlen zwischen 500 und 1.000 USD pro Monat für ausgelagerte Buchhaltung – und Nachhol- oder Aufräumbuchhaltung für unorganisierte Aufzeichnungen kann 800 bis 2.500 USD für 6–12 Monate Rückstand kosten. Wenn saubere, kategorisierte Transaktionsdaten aus jedem Monat bereits exportiert und organisiert sind, verlagert sich die Aufgabe des Buchhalters von der Dateneingabe zur Prüfung und Analyse – ein schnellerer, günstigerer Einsatz. Speziell für die Steuersaison gelten die zugehörigen Artikel zu warum manuelle Steuerdateneingabe ein Automatisierungsproblem schafft und Organisation von Steuersaisondaten dieselbe Logik für W-2- und 1099-Formulare – dasselbe Prinzip der strukturierten Extraktion im Voraus, das Nacharbeit reduziert, gilt für alle Dokumenttypen.
FAQ
Kann die KI Kreditkartenabrechnungen von beliebigen Herausgebern verarbeiten – Chase, Amex, Capital One, lokale Kreditgenossenschaften?
Ja. Da die semantische Extraktion das Layout nach Bedeutung statt nach Koordinatenabgleich liest, funktioniert sie über alle Herausgeber hinweg ohne bankspezifische Konfiguration. Eine Chase-Abrechnung mit getrennten Debit- und Credit-Spalten, eine Amex-Abrechnung mit einer einzigen Amount-Spalte und ein gescanntes PDF einer Kreditgenossenschaft werden alle mit denselben von Ihnen angegebenen Spaltendefinitionen geparst. Die KI passt sich jedem Layout an, anstatt dass Sie für jedes eine Vorlage erstellen müssen.
Was, wenn meine Abrechnung ein gescanntes Bild und kein digitales PDF ist?
Das Vision Large Model verarbeitet gescannte Dokumente und Fotos auf dieselbe Weise wie digitale PDFs – durch visuelles Verständnis des Seitenlayouts. Im Gegensatz zu herkömmlicher OCR, die bei Scans deutlich an Qualität verliert, bleibt die VLM-basierte Extraktion bei bildbasierten Eingaben hochgenau, da sie nicht von sauberem Text-Rendering abhängig ist. Ein Handyfoto einer Papierabrechnung, ein gescanntes PDF einer Kreditgenossenschaft und ein digitales Chase-PDF durchlaufen dieselbe Pipeline. Allerdings verringern extrem minderwertige Scans (stark schief, sehr dunkel oder niedrig aufgelöst) die Genauigkeit – eine flach aufliegende Abrechnung mit gleichmäßiger Beleuchtung liefert die besten Ergebnisse.
Unterscheidet die KI automatisch zwischen Käufen, Zahlungen, Rückerstattungen und Gebühren?
Ja – aber es ist wichtig, genau zu sein, wie. Die KI hat keinen magischen „Typ-Erkenner“. Was sie tut, ist, die semantische Zone zu erkennen, zu der jede Transaktion gehört (Purchases, Payments & Credits, Fees & Interest), basierend auf den Abschnittsüberschriften der Abrechnung, und entsprechend zu klassifizieren. Da die KI das Layout so liest wie ein Mensch – versteht, dass „Payments and Credits“ ein eigener Abschnitt ist – basiert die Klassifizierung auf strukturellem Kontext, nicht auf Raten. Deshalb ist zonenbewusste Extraktion wichtig: Ein Tool, das Zonen nicht unterscheiden kann, kann Transaktionstypen nicht zuverlässig klassifizieren.
Kann ich Abrechnungen von mehreren Monaten oder mehreren Karten gleichzeitig verarbeiten?
Ja. Sie können mehrere PDF-Dateien hochladen – Abrechnungen aus verschiedenen Monaten, verschiedenen Karten oder beides – in einem einzigen Batch. Die KI verarbeitet jede Datei unabhängig und führt alle extrahierten Transaktionen in einer Ausgabetabelle zusammen. Jede Zeile behält die Quelldateiinformationen, sodass Sie jede Transaktion bis zu ihrer Abrechnung zurückverfolgen können. Das ist besonders nützlich für die Jahresendkonsolidierung: Laden Sie 12 Monatsabrechnungen von zwei Karten hoch (24 Dateien), definieren Sie Ihre Spalten einmal und laden Sie eine Tabelle mit allen Transaktionen des gesamten Jahres herunter, bereits strukturiert und kategorisiert.
Was ist mit Fremdwährungstransaktionen auf meiner Abrechnung?
Viele Kreditkartenabrechnungen enthalten sowohl einen Fremdwährungsbetrag als auch einen umgerechneten USD-Betrag für internationale Transaktionen. Sie können Spalten für beides definieren: „Foreign Currency Amount“ und „USD Amount“ als separate Extraktionsziele. Die KI liest beide Werte aus der Abrechnungszeile – je nach Spaltenkonvention Ihres Herausgebers – und füllt beide Felder. Wenn Ihre Abrechnung den ursprünglichen Währungsbetrag nicht zeigt (manche Herausgeber zeigen nur den umgerechneten USD-Betrag), wird nur die verfügbaren Daten extrahiert.
Ist das dasselbe wie der Import von Bankfeeds in QuickBooks oder Xero?
Nein — es dient einem anderen Zweck. Bankfeeds importieren Transaktionen von Ihren verbundenen Konten nahezu in Echtzeit in die Buchhaltungssoftware, was für die laufende Buchhaltung nützlich ist. Bankfeeds erfordern jedoch eine Kontoverbindung (nicht alle Institute unterstützen dies), können ältere Transaktionen außerhalb des Feed-Zeitfensters übersehen und verarbeiten keine gescannten oder Papierauszüge. Die Auszugsextraktion arbeitet direkt mit der PDF-Datei — sie benötigt keinen Kontozugriff, funktioniert mit historischen Auszügen über Jahre hinweg und kann gescannte oder fotografierte Auszüge verarbeiten. Die beiden Ansätze ergänzen sich, statt zu konkurrieren: Die Extraktion übernimmt, was Feeds nicht erreichen können.
Die Stunde, die Sie diesen Monat bei der Dateneingabe sparen, ist die Stunde, die Ihr CPA Ihnen im nächsten März nicht in Rechnung stellt.
Keine Anmeldung erforderlich · Ersten Auszug kostenlos verarbeiten