Extração de extratos de cartão de crédito:
O que a maioria das ferramentas erra
Consumidores dos EUA fizeram, em média, 48 pagamentos por mês em 2024 — e os cartões de crédito responderam por 35% de todas as transações, mais do que qualquer outro meio de pagamento. Cada uma dessas cobranças gera uma linha no extrato. Para o dono de uma pequena empresa com um único cartão corporativo, isso são 50–150 transações por mês. Cada uma dessas linhas precisa acabar em uma planilha para conciliação, categorização e preparação de impostos.
O problema não é encontrar uma ferramenta que prometa extrair extratos de cartão de crédito. É que a maioria delas gera um resultado que você ainda precisa limpar — linhas desalinhadas, valores de crédito misturados com débitos, subtotais confundidos com transações, nomes de fornecedores truncados. A lacuna da extração não está em saber se a ferramenta consegue ler texto. Está em saber se ela entende o que está lendo.
Principais conclusões
- A maioria das ferramentas de extração de extratos de cartão de crédito ainda deixa você limpando resultados embaralhados — linhas desalinhadas, subtotais lidos como transações, nomes de estabelecimentos divididos entre colunas — e a limpeza consome 30 minutos por extrato.
- O gargalo não é a precisão do OCR — é que a extração tradicional lê cada página como um fluxo único e plano de texto e não tem noção da zona Purchases, da zona Payments ou da zona Fees, então costura tudo em uma única lista inutilizável.
- A extração semântica lê um extrato de cartão de crédito como um humano — reconhecendo zonas pelo significado, não por coordenadas de pixels — e o ImageToTable.ai permite definir suas colunas uma vez e depois categorizar automaticamente cada transação com colunas inferidas, para você ter um Excel limpo em poucos segundos por página.
Por que sua fatura de cartão de crédito quebra o OCR tradicional
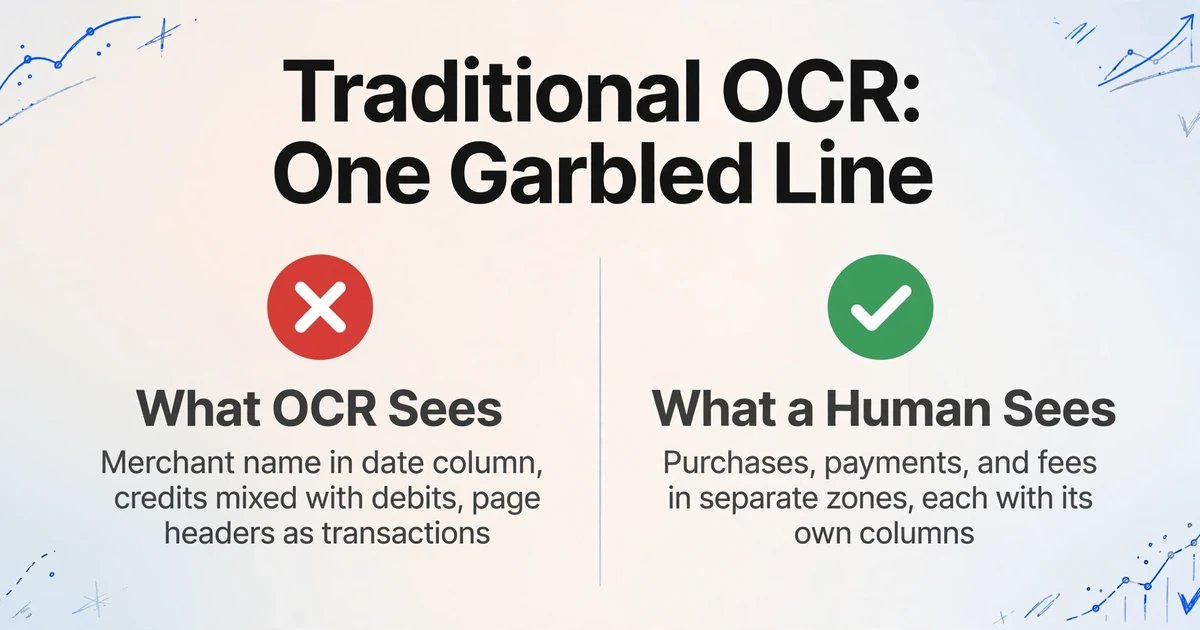
Uma fatura de cartão de crédito não é uma tabela plana. Abra qualquer fatura do Chase, Amex ou Capital One e você verá pelo menos três zonas distintas de dados na mesma página: uma seção Purchases com colunas de data, estabelecimento e valor; uma seção Payments & Credits com sua própria estrutura de colunas; uma seção Fees & Interest, muitas vezes com outro layout ainda. Alguns emissores separam debits e credits em colunas lado a lado. Outros empilham tudo em uma única coluna Amount e usam sinais. Alguns colocam números de referência depois do nome do estabelecimento. Outros usam uma coluna separada.
O OCR tradicional não enxerga zonas. Ele lê da esquerda para a direita, de cima para baixo, tratando a página inteira como um fluxo contínuo de texto. Quando uma linha de pagamento tem três colunas mas uma linha de compra tem quatro, o OCR as junta em uma única linha embaralhada. O subtotal acumulado a cada 15 transações — impresso em negrito e centralizado de forma diferente — é lido como uma transação sem descrição e com um valor sem sentido. O cabeçalho da fatura (número do cartão, período de cobrança, data de vencimento do pagamento) vaza para a primeira linha de transação.
Em um tópico do r/Bookkeeping sobre converter PDFs de cartão de crédito para Excel, um contador descreveu o resultado típico: "A saída do OCR coloca metade do nome do estabelecimento na coluna de data, mistura credits e debits e inclui todo cabeçalho de 'continua na próxima página' como uma transação. Quando termino de limpar, eu já poderia ter digitado tudo." Esse é o problema do OCR na prática — não que ele não consiga ler, mas que não consegue organizar.
Há uma segunda camada no problema: a continuidade entre várias páginas. Uma fatura mensal com 80 transações distribuídas em quatro páginas significa que o OCR produz quatro blocos de texto separados. Os saldos acumulados se quebram entre as páginas. O cabeçalho "continua da página anterior" na página dois é interpretado como uma linha de dados. O subtotal no rodapé da página um e o valor transportado no cabeçalho da página dois são ambos extraídos, criando entradas duplicadas.
E uma terceira camada: faturas digitalizadas. Mesmo em 2026, cerca de 15–20% das instituições financeiras menores ainda geram PDFs baseados em imagem em vez de PDFs digitais com texto selecionável, segundo benchmarks do setor acompanhados pela StatementDesk. Se sua cooperativa de crédito envia um PDF digitalizado ou você está trabalhando a partir de uma foto de uma fatura em papel, a precisão do OCR tradicional cai de 30–50% na hora — e todos os três problemas acima pioram.
Como a Extração Semântica Lê o Que o OCR Não Consegue
O problema central não é o reconhecimento de caracteres. É que o OCR para no nível do caractere. Ele sabe que há texto na posição (x,y) da página, mas não sabe que a posição (x,y) pertence à zona "Purchases", que essa zona tem quatro colunas definidas pela linha de cabeçalho e que o valor na quarta coluna da linha 7 representa um Debit, não um Credit. Esse conhecimento organizacional — o que permite a uma pessoa olhar uma fatura e interpretá-la instantaneamente — é o que está faltando.
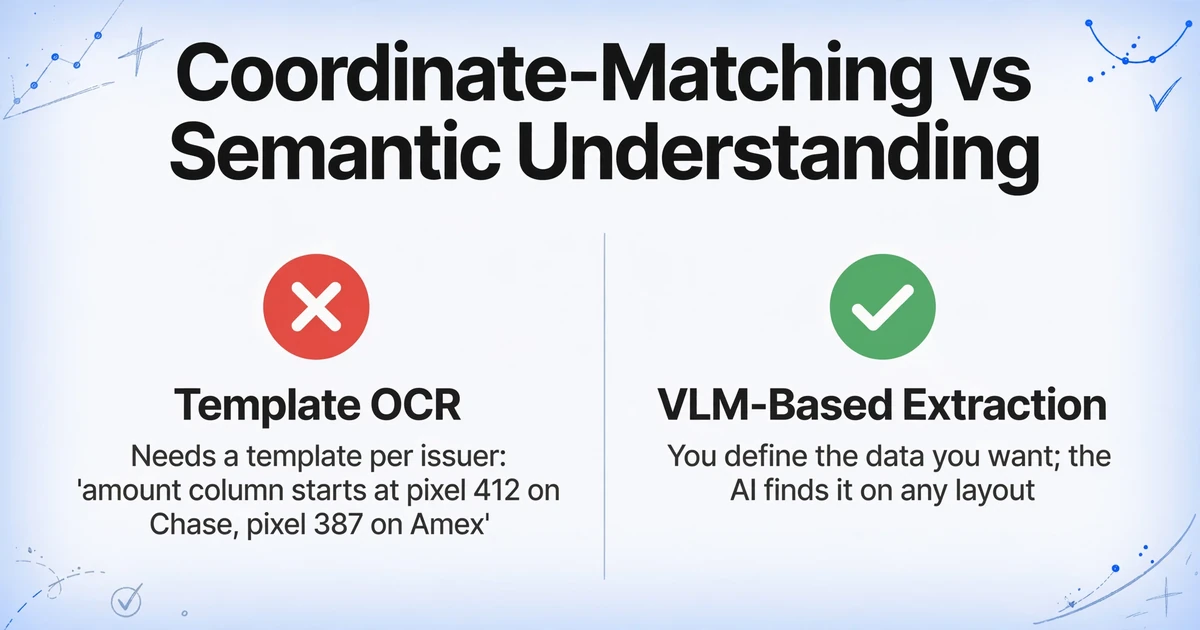
Os Vision Large Models (VLM) preenchem essa lacuna. Diferente do OCR com modelo que faz correspondência de coordenadas, um VLM lê uma fatura de cartão de crédito como uma pessoa faz: ele vê o layout, entende que "Payments & Credits" é uma seção diferente de "Purchases", reconhece que a coluna mais à direita na zona Purchases é o valor da transação e preserva a estrutura das linhas entre quebras de página. O modelo não precisa de um modelo para Chase vs. Amex porque não está procurando coordenadas — está procurando significado.
Essa mudança da correspondência de coordenadas para a compreensão semântica muda o que é possível. Em vez de dizer à ferramenta "a coluna de valor começa no pixel 412 nas faturas do Chase e no pixel 387 nas faturas do Amex", você diz quais dados quer. A IA descobre onde eles estão em cada página específica.
É aqui que entra a Extração de Colunas Personalizadas — um mecanismo que funciona de forma diferente do que a maioria das ferramentas de extração oferece. Em vez de pré-configurar um modelo para cada emissor de cartão ou desenhar caixas manualmente ao redor dos campos de dados, você simplesmente digita os nomes das colunas que quer na sua planilha final: "Transaction Date", "Merchant Name", "Amount". A IA lê o documento, entende quais dados correspondem a cada nome de coluna pelo significado semântico (não pela posição em pixels) e preenche as linhas. Os nomes de coluna que você digita se tornam os cabeçalhos da sua tabela de saída — sem treinamento de modelo, sem mapeamento de coordenadas, sem configuração por banco.
Passo a Passo: Extraia Transações com Extração de Colunas Personalizadas
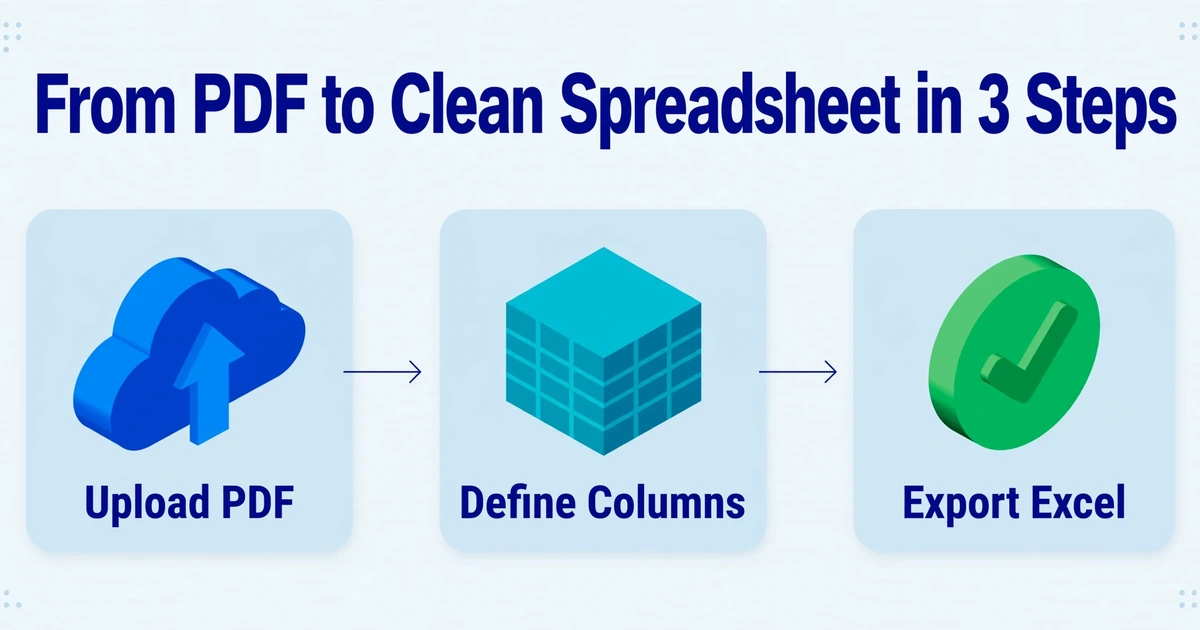
Aqui está o fluxo de trabalho, do extrato em PDF até uma planilha Excel limpa, usando Extração de Colunas Personalizadas para definir exatamente quais dados você quer — nem mais, nem menos.
Etapa 1: Faça o upload do seu extrato. A ferramenta aceita PDFs (digitais ou escaneados), JPG, PNG e WebP. Se você tem um extrato de várias páginas — digamos, um extrato mensal de 4 páginas do Chase — pode enviar o arquivo inteiro de uma vez. Documentos de várias páginas são processados como um único conjunto de dados contínuo; as transações das páginas 1, 2, 3 e 4 vão todas para a mesma tabela de saída, em ordem. Se você tem extratos de vários cartões (um Amex corporativo e um Visa pessoal, por exemplo), envie-os juntos como um lote e receba uma única planilha mesclada.
Etapa 2: Defina suas colunas. Em vez de configurar zonas de extração ou treinar um modelo, você digita os nomes das colunas que deseja extrair. Para um livro-razão completo de transações, as colunas típicas incluem:
Você também pode incluir campos do nível do extrato — Statement Period Start, Statement Period End, Payment Due Date, Minimum Payment Due — que a IA extrai uma vez do cabeçalho do extrato e repete em cada linha de transação para referência. Isso é útil quando você está processando vários meses de uma vez e precisa que cada linha seja marcada com seu período de faturamento.
Os arquivos são processados com segurança e não são armazenados.
Etapa 3: Exportar para Excel. Assim que a IA termina a extração — normalmente de 5 a 10 segundos por página — você baixa um arquivo Excel (XLSX) estruturado. Cada coluna que você definiu se torna uma coluna na planilha. Cada transação se torna uma linha. Os dados já vêm padronizados: datas em formato consistente, valores como números limpos (sem símbolos de moeda embutidos na célula), nomes de comerciantes limpos de códigos internos do banco. A exportação em CSV e JSON também está disponível se você estiver importando para um software de contabilidade que prefere esses formatos. Para um mergulho mais profundo nos recursos completos de extração — incluindo tratamento de moeda estrangeira, análise multizona em diferentes formatos de emissores e processamento em lote de vários meses — consulte a página de conversão de extrato de cartão de crédito para Excel. Se você preferir que as linhas cheguem diretamente ao Google Sheets sem a etapa de baixar e importar, nosso artigo sobre extrair extratos de cartão de crédito para o Google Sheets aborda o fluxo de trabalho do complemento de barra lateral para os mesmos extratos.
Categorize Transações Automaticamente com Colunas Inferidas
Extrair dados de transações de um PDF resolve o problema da extração. Mas para conciliação e preparação de impostos, a extração é apenas o primeiro passo. Cada transação ainda precisa de uma categoria — aquela cobrança da Amazon é material de escritório, equipamento ou despesa pessoal? Essa etapa de classificação é onde a maior parte do tempo manual de conciliação realmente é gasta.
É aqui que entram as colunas inferidas. Diferente de uma coluna regular, que extrai dados explicitamente impressos no documento, uma coluna inferida pede que a IA determine algo que o documento não declara diretamente — analisando o que ele diz. Você define uma coluna chamada Category (options: Office Supplies/Equipment/Travel/Meals/Software/Utilities/Other), e para cada linha de transação, a IA lê o nome do comerciante e o contexto da transação, então seleciona a categoria mais adequada.
Uma cobrança da "Staples" com valor de $42 recebe a categoria "Office Supplies". "Delta Airlines" a $389 vira "Travel". "Adobe Creative Cloud" a $59,99 vira "Software". A IA não está fazendo correspondência de palavras-chave — ela usa o mesmo entendimento semântico que permite interpretar o layout do extrato. Ela sabe que "Staples" é uma loja de materiais de escritório, que "Delta" é uma companhia aérea, e que uma cobrança de $3,50 da "Blue Bottle Coffee" é uma refeição, não equipamento.
O que torna isso poderoso para a conciliação de cartão de crédito é que a extração e a categorização acontecem na mesma etapa. Você não extrai transações para o Excel e depois gasta mais uma hora adicionando uma coluna de Categoria manualmente. A IA preenche ambas as colunas simultaneamente. E como as colunas inferidas funcionam em uploads em lote — extratos de vários cartões ou vários meses processados juntos — você obtém uma única planilha onde cada transação, de qualquer fonte, já vem categorizada.
Extrato de Cartão de Crédito vs. Extrato Bancário: As Diferenças na Extração
É fácil supor que um extrato de cartão de crédito e um extrato bancário sejam o mesmo problema de extração — ambos contêm tabelas de transações com datas, descrições e valores. Na prática, eles apresentam desafios diferentes, e uma ferramenta otimizada para um muitas vezes falha no outro.
| Recurso | Extrato de Cartão de Crédito | Extrato Bancário |
|---|---|---|
| Zonas de transação | Múltiplas zonas por página (Purchases, Payments, Fees, Interest) — cada uma com layouts de colunas diferentes | Normalmente uma tabela de transações por página, com colunas consistentes em todo o extrato |
| Tratamento de Debit/Credit | Misto: uma única coluna de Amount com sinais, ou colunas separadas de Debit/Credit, ou convenções que variam por zona | Geralmente colunas separadas de Debit e Credit, ou uma convenção consistente de coluna única |
| Subtotais e linhas de resumo | Frequentes: subtotais por zona, totais por página, totais do resumo do extrato — alto risco de linhas de transação falsas | A coluna de saldo acumulado funciona como validação integrada; subtotais são menos comuns |
| Nomes de comerciantes | Inconsistentes: o mesmo comerciante aparece como "AMZN," "Amazon.com," "AMAZON MKTPLACE" entre diferentes emissores | Mais padronizados: os nomes dos beneficiários seguem a formatação interna do banco de forma consistente |
| Metadados do extrato | Payment Due Date, Minimum Payment, limite de crédito, detalhes de APR — relevantes para o planejamento financeiro | Saldo da conta, juros ganhos, informações de cheque especial — um conjunto de metadados diferente |
Para a extração de extratos bancários especificamente — que enfrenta seu próprio conjunto de desafios em torno da validação do saldo acumulado e da interpretação de números de cheques — extração de extratos bancários para pequenas empresas aborda o fluxo de trabalho em detalhes. O ponto-chave para extratos de cartão de crédito é que a consciência de zonas é inegociável. Qualquer ferramenta que trate a página inteira como uma única tabela plana vai misturar compras, pagamentos e taxas em uma lista única inutilizável. A extração semântica resolve isso reconhecendo o texto do cabeçalho — "Purchases," "Payments and Credits," "Interest Charged" — e aplicando regras de interpretação diferentes por zona, da mesma forma que seus olhos fazem ao ler o extrato.
Da Conciliação Mensal à Preparação do Imposto de Fim de Ano
O motivo para automatizar a extração de extratos de cartão de crédito não é apenas economizar uma hora neste mês. É sobre o que acontece quando você multiplica essa hora ao longo dos meses, cartões e demandas de fim de ano.
Um fluxo de trabalho típico de contabilidade para pequenas empresas envolve três ciclos de conciliação: mensal (conciliar transações do extrato do cartão de crédito com recibos e lançamentos no General Ledger (GL)), trimestral (compilar gastos categorizados para pagamentos de impostos estimados) e anual (agregar dados de transações do ano inteiro para revisão do CPA e declaração de impostos). Em cada nível, a qualidade dos dados de transação subjacentes determina quanto trabalho o próximo nível cria. Dados bagunçados na etapa mensal significam um CPA cobrando $200+/hora para desembaraçar tudo no fim do ano.
A conciliação mensal é onde a extração automatizada tem o impacto mais imediato. Em vez de abrir o PDF do extrato lado a lado com o Excel e digitar cada linha, você envia o extrato, define suas colunas uma vez e obtém uma planilha limpa em segundos. Se você processa três cartões por mês, isso é uma economia de tempo recorrente que se acumula.
Para cálculos de impostos estimados trimestrais, dados de transações categorizados são essenciais. O IRS exige uma base razoável para deduções de despesas de acordo com a Publication 535 (Despesas Empresariais) — ou seja, você precisa saber não apenas o que gastou, mas em qual categoria cada despesa se enquadra. Com a coluna inferida lidando com a categorização no momento da extração, seu resumo de gastos trimestrais já está organizado: total em viagens, total em material de escritório, total em assinaturas de software, cada um como uma linha em uma planilha pronta para tabela dinâmica.
No fim do ano, a diferença é mais evidente. A maioria das pequenas empresas paga entre $500 e $1.000 por mês por contabilidade terceirizada — e a contabilidade de recuperação ou limpeza para registros desorganizados pode custar de $800 a $2.500 para 6–12 meses de atraso. Se os dados de transação limpos e categorizados de cada mês já estiverem exportados e organizados, o trabalho do contador passa de entrada de dados para revisão e análise — um serviço mais rápido e barato. Para a temporada de impostos especificamente, a cobertura de artigos relacionados sobre por que a entrada manual de dados fiscais cria um problema de automação e organizando dados da temporada de impostos aplica a mesma lógica aos formulários W-2 e 1099 — o mesmo princípio de extração estruturada antecipada reduzindo retrabalho posterior se aplica a todos os tipos de documentos.
FAQ
A IA consegue lidar com extratos de cartão de crédito de qualquer emissor — Chase, Amex, Capital One, cooperativas de crédito locais?
Sim. Como a extração semântica lê o layout pelo significado, e não pela correspondência de coordenadas, ela funciona entre emissores sem configuração por banco. Um extrato da Chase com colunas separadas de Debit e Credit, um extrato da Amex com uma única coluna de Amount e um PDF escaneado de uma cooperativa de crédito são todos processados usando as mesmas definições de coluna que você fornece. A IA se adapta a cada layout, em vez de exigir que você crie um modelo para cada um.
E se meu extrato for uma imagem escaneada, e não um PDF digital?
O Vision Large Model processa documentos escaneados e fotos da mesma forma que processa PDFs digitais — entendendo visualmente o layout da página. Diferente do OCR tradicional, que degrada significativamente em escaneamentos, a extração baseada em VLM mantém alta precisão em entradas baseadas em imagem, pois não depende de renderização limpa de texto. Uma foto de um extrato em papel tirada com o celular, um PDF escaneado de uma cooperativa de crédito e um PDF digital da Chase passam pelo mesmo fluxo. Dito isso, escaneamentos de qualidade extremamente baixa (muito inclinados, muito escuros ou de baixa resolução) reduzem a precisão — colocar o extrato plano com iluminação uniforme produz os melhores resultados.
A IA distingue automaticamente entre compras, pagamentos, reembolsos e taxas?
Sim — mas é importante ser preciso sobre como. A IA não tem um "detector de tipo" mágico. O que ela faz é reconhecer a zona semântica à qual cada transação pertence (Purchases, Payments & Credits, Fees & Interest) com base nos cabeçalhos de seção do extrato, e classificar de acordo. Como a IA lê o layout da mesma forma que uma pessoa — entendendo que "Payments and Credits" é uma seção distinta — a classificação é baseada em contexto estrutural, não em suposição. É por isso que a extração ciente de zonas importa: uma ferramenta que não consegue distinguir zonas não consegue classificar tipos de transação de forma confiável.
Posso processar extratos de vários meses ou vários cartões de uma vez?
Sim. Você pode enviar vários arquivos PDF — extratos de meses diferentes, cartões diferentes, ou ambos — em um único lote. A IA processa cada arquivo de forma independente e combina todas as transações extraídas em uma única planilha de saída. Cada linha mantém as informações do arquivo de origem, para que você possa rastrear qualquer transação até seu extrato. Isso é particularmente útil para consolidação de fim de ano: envie 12 extratos mensais de dois cartões (24 arquivos), defina suas colunas uma vez e baixe uma planilha com todas as transações do ano inteiro, já estruturadas e categorizadas.
E quanto a transações em moeda estrangeira no meu extrato?
Muitos extratos de cartão de crédito incluem tanto o valor em moeda estrangeira quanto o valor convertido em USD para transações internacionais. Você pode definir colunas para ambos: "Foreign Currency Amount" e "USD Amount" como alvos de extração separados. A IA lê os dois valores da linha do extrato — independentemente da convenção de coluna que seu emissor usa — e preenche ambos os campos. Se o seu extrato não mostrar o valor original em moeda estrangeira (alguns emissores mostram apenas o valor convertido em USD), apenas os dados disponíveis são extraídos.
Isso é o mesmo que importar feeds bancários no QuickBooks ou Xero?
Não — serve a um propósito diferente. Os feeds bancários importam automaticamente transações das suas contas conectadas para o software de contabilidade em tempo quase real, o que é útil para a escrituração contínua. Mas os feeds bancários exigem conectividade com a conta (nem todas as instituições suportam), podem perder transações mais antigas fora da janela do feed e não lidam com extratos digitalizados ou em papel. A extração de extratos trabalha no próprio PDF — não precisa de acesso à conta, funciona com extratos históricos de anos anteriores e pode processar extratos digitalizados ou fotografados. As duas abordagens são complementares, não concorrentes: a extração lida com o que os feeds não alcançam.
A hora que você economiza no lançamento de dados este mês é a hora que seu CPA não cobra em março.
Sem cadastro · Processe o primeiro extrato gratuitamente