クレジットカード明細の抽出:
ほとんどのツールが間違えるポイント
米国の消費者は2024年、平均して月48回の支払いを行いました。クレジットカードは全取引の35%を占め、他のどの支払い方法よりも多くなっています。こうした利用の一つひとつが明細に1行として記録されます。法人カードを1枚持つ中小企業のオーナーなら、月に50〜150件の取引になります。その1行1行を、照合・分類・確定申告のためにスプレッドシートにまとめる必要があります。
問題は、クレジットカード明細を抽出すると謳うツールを見つけることではありません。ほとんどのツールが、その後も手作業で修正が必要な出力を返すことです。行のずれ、Credit金額とDebitの混在、小計を取引と誤認、取引先名の欠落などです。抽出の課題は、ツールがテキストを読めるかどうかではなく、読んでいる内容を理解できるかどうかにあります。
主なポイント
- ほとんどのクレジットカード明細抽出ツールは、文字化けした出力の修正をあなたに押し付けます。行のずれ、小計を取引として読み取り、取引先名が列をまたいで分割されるなど、その修正に明細1件あたり30分もかかります。
- ボトルネックはOCRの精度ではありません。従来の抽出はすべてのページを1つの平坦なテキストストリームとして読み取り、Purchasesゾーン、Paymentsゾーン、Feesゾーンの概念がないため、それらを1つの使えないリストに繋ぎ合わせてしまいます。
- セマンティック抽出は、人間と同じようにクレジットカード明細を読み取ります。ピクセル座標ではなく意味によってゾーンを認識し、ImageToTable.aiでは列を一度定義すれば、Inferred Columnsで全取引を自動分類し、1ページあたり数秒でクリーンなExcelが得られます。
クレジットカード明細が従来のOCRで処理できない理由
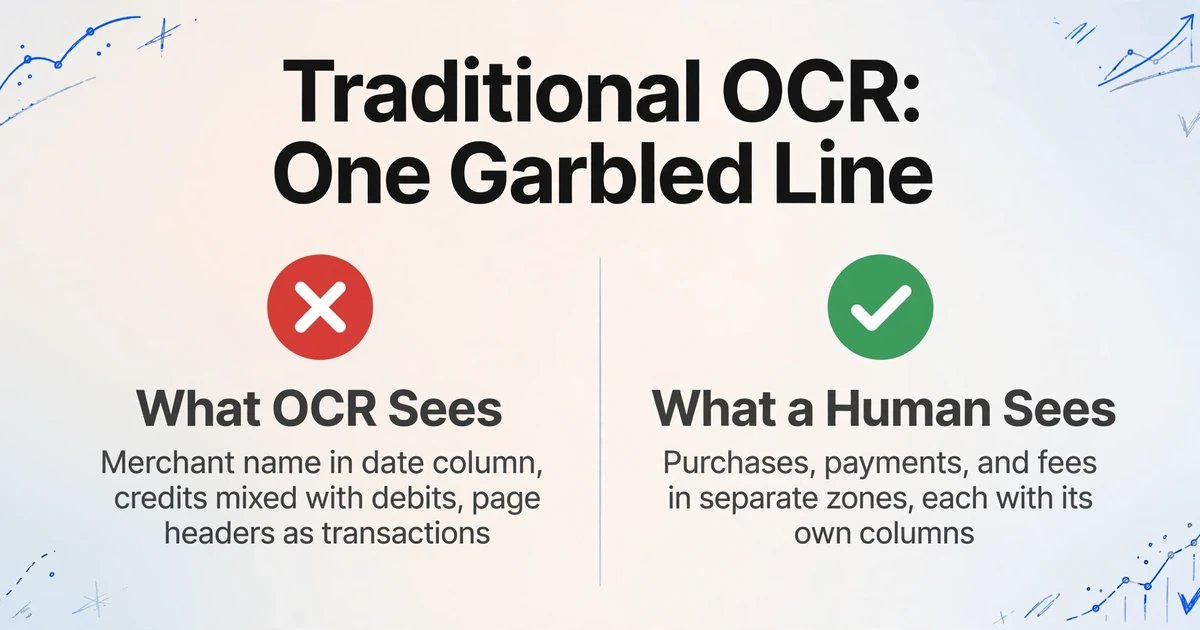
クレジットカード明細は平坦な表ではありません。Chase、Amex、Capital Oneの明細を開くと、同じページに少なくとも3つの異なるデータゾーンがあります。日付・加盟店名・金額の列を持つPurchasesセクション、独自の列構造を持つPayments & Creditsセクション、そして多くの場合さらに別のレイアウトを持つFees & Interestセクションです。発行会社によっては、DebitとCreditを左右に並べた列に分けています。あるいはすべてを1つのAmount列にまとめ、符号で区別する場合もあります。加盟店名の後に参照番号を置く会社もあれば、別の列を使う会社もあります。
従来のOCRはゾーンを認識しません。ページ全体を1つの連続したテキストストリームとして、左から右へ、上から下へと読み取ります。支払い行が3列なのに購入行が4列だと、OCRはそれらをつなぎ合わせて1つの文字化けした行にしてしまいます。15件の取引ごとに表示される途中集計(太字で、中央揃えも異なる)は、説明のない取引として、意味不明な金額とともに読み取られます。明細のヘッダー(カード番号、請求期間、支払期日)が最初の取引行に混ざり込みます。
クレジットカードPDFをExcelに変換する方法に関するr/Bookkeepingのスレッドで、ある経理担当者が典型的な結果をこう説明しています。「OCRの出力は加盟店名の半分を日付列に入れ、CreditとDebitを混ぜ合わせ、『continued on next page』というヘッダーまで取引として含めてしまう。これを整理するくらいなら、最初から手入力したほうがましだ」。これが実際のOCR問題です。読み取れないのではなく、整理できないのです。
問題には第2の層があります。複数ページにわたる連続性です。80件の取引が4ページにまたがる月次明細では、OCRは4つの別々のテキストブロックを生成します。途中残高はページをまたいで分断されます。2ページ目の「continued from previous page」ヘッダーはデータ行として解析されます。1ページ目のフッターにある小計と2ページ目のヘッダーにある繰越額の両方が抽出され、重複したエントリが生まれます。
そして第3の層はスキャンされた明細です。StatementDeskが追跡する業界ベンチマークによると、2026年になっても小規模金融機関のおよそ15~20%は、テキスト選択可能なデジタルPDFではなく画像ベースのPDFを依然として生成しています。あなたの信用組合がスキャンされたPDFを送ってくる場合や、紙の明細を撮影した写真から作業する場合、従来のOCRの精度はその場で30~50%低下し、上記の3つの問題はすべて悪化します。
セマンティック抽出がOCRに読めないものを読み取る仕組み
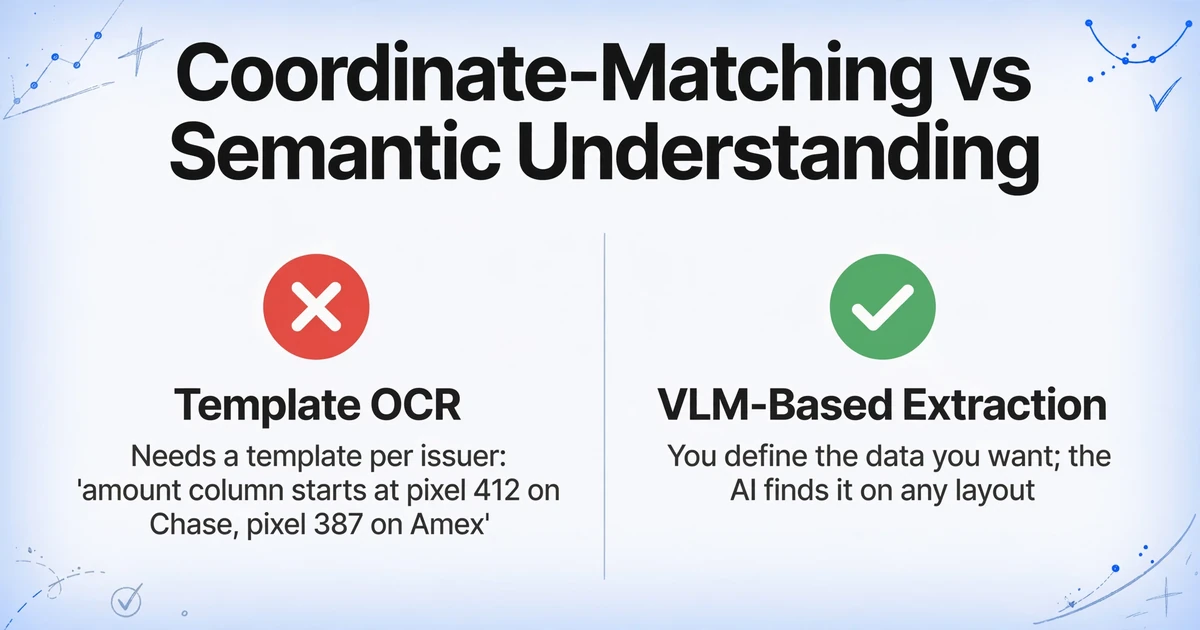
根本的な問題は文字認識ではありません。OCRは文字レベルで止まってしまうことです。ページ上の位置(x,y)にテキストがあることは分かっても、その位置(x,y)が「Purchases」ゾーンに属すること、このゾーンがヘッダー行で定義された4つの列を持つこと、7行目の4列目の金額がCreditではなくDebitを表すことまでは分かりません。人間が明細書をひと目見て瞬時に解析できる、その組織的な知識が欠けているのです。
Vision Large Model(VLM)がそのギャップを埋めます。座標を照合するテンプレートベースのOCRとは異なり、VLMは人間と同じようにクレジットカード明細書を読み取ります。レイアウトを見て、「Payments & Credits」が「Purchases」とは別のセクションであることを理解し、Purchasesゾーンの右端の列が取引金額であることを認識し、ページをまたいでも行構造を保持します。ChaseとAmexでテンプレートを必要としないのは、座標ではなく意味を探しているからです。
座標マッチングからセマンティック理解へのこの転換が、可能なことを変えます。「Chaseの明細書では金額列がピクセル412から始まり、Amexの明細書ではピクセル387から始まる」とツールに伝えるのではなく、欲しいデータを伝えるだけです。AIが各ページのどこにあるかを判断します。
ここで登場するのがカスタム列抽出です。ほとんどの抽出ツールが提供するものとは異なる仕組みで動作します。カード発行会社ごとにテンプレートを事前設定したり、データフィールドの周りに手動でボックスを描いたりする代わりに、最終的なスプレッドシートに欲しい列名を入力するだけです。「Transaction Date」「Merchant Name」「Amount」。AIがドキュメントを読み、各列名に対応するデータを(ピクセル位置ではなく)セマンティックな意味で理解し、行を埋めます。入力した列名が出力テーブルのヘッダーになります。テンプレートのトレーニングも、座標マッピングも、銀行ごとの設定も不要です。
ステップバイステップ:カスタム列抽出で取引を抽出する
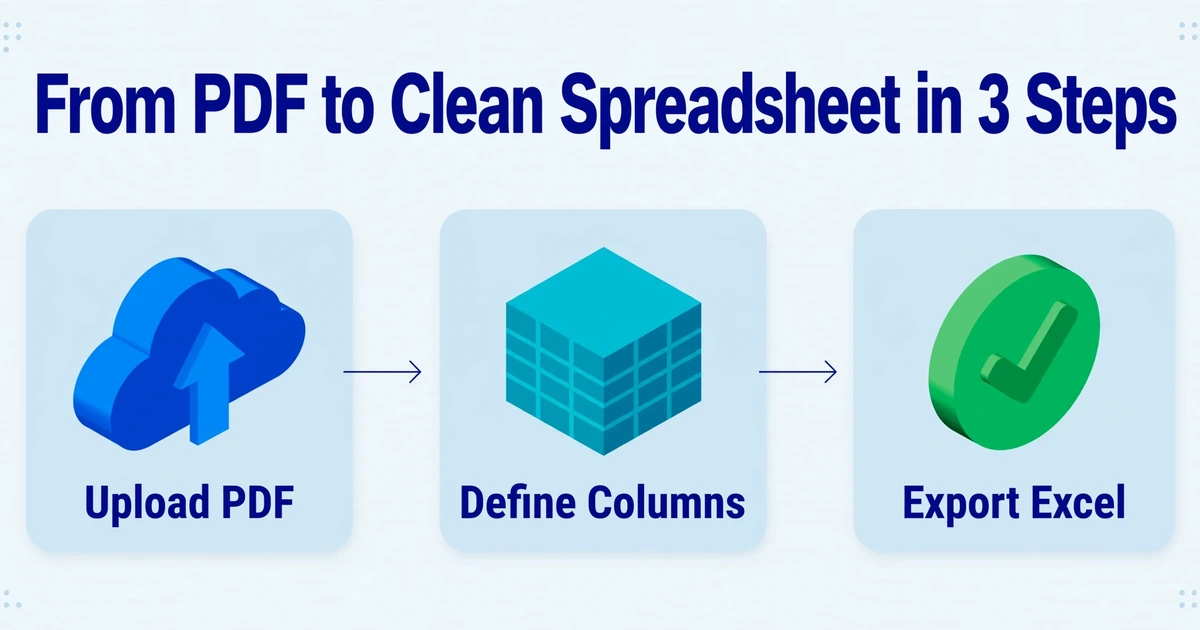
PDF明細書からクリーンなExcelスプレッドシートまでのワークフローを、カスタム列抽出を使って必要なデータだけを定義しながらご紹介します。
ステップ1:明細書をアップロードします。 このツールはPDF(デジタルまたはスキャン)、JPG、PNG、WebPに対応しています。複数ページの明細書(例えばChaseの4ページの月次明細書)は、ファイル全体を一度にアップロードできます。複数ページのドキュメントは1つの連続したデータセットとして処理され、1、2、3、4ページ目の取引がすべて同じ出力テーブルに順番に格納されます。複数のカードの明細書(例えばビジネス用のAmexと個人用のVisa)がある場合は、まとめてバッチとしてアップロードすると、1つの統合されたスプレッドシートが得られます。
ステップ2:列を定義します。 抽出ゾーンを設定したりモデルをトレーニングしたりする代わりに、抽出したい列名を入力するだけです。完全な取引台帳の場合、一般的な列は次のとおりです:
ステートメントレベルのフィールド — Statement Period Start、Statement Period End、Payment Due Date、Minimum Payment Due — を含めることもできます。AIがステートメントのヘッダーから一度取得し、参照用としてすべての取引行に繰り返し反映します。これは、複数月を一度に処理する際に、各行に請求期間をタグ付けしたい場合に便利です。
ファイルは安全に処理され、保存されません。
ステップ3:Excelにエクスポート。 AIが抽出を完了すると — 通常1ページあたり5~10秒 — 構造化されたExcel(XLSX)ファイルをダウンロードできます。定義したすべての列がスプレッドシートの列になります。すべての取引が行になります。データはすでに標準化されています:日付は一貫した形式、金額はクリーンな数値(セルに通貨記号が埋め込まれていない)、加盟店名は銀行の内部コードが除去されています。会計ソフトへのインポートに適した形式を好む場合は、CSVおよびJSONエクスポートも利用できます。外国通貨の処理、異なる発行会社フォーマット間のマルチゾーンパース、複数月のバッチ処理など、抽出機能の詳細については、クレジットカード明細のExcel変換ページをご覧ください。ダウンロードとインポートの手順を省いて行を直接Google Sheetsに取り込みたい場合は、クレジットカード明細をGoogle Sheetsに抽出する方法の記事で、同じ明細に対するサイドバーアドオンのワークフローを解説しています。
推論列で取引を自動カテゴリ分類
PDFから取引データを取得できれば、抽出の問題は解決します。しかし、照合や税務申告の準備において、抽出は最初のステップにすぎません。すべての取引にはカテゴリが必要です。このAmazonの請求は事務用品か、備品か、それとも個人的な支出か。この分類のステップこそ、手動での照合作業の時間の大半を占める部分です。
ここで活躍するのが推論列です。文書に明示的に印刷されたデータを抽出する通常の列とは異なり、推論列は、文書が直接述べていないことを、述べている内容を分析してAIに判断させます。Category (options: Office Supplies/Equipment/Travel/Meals/Software/Utilities/Other)という列を定義すると、AIは各取引行について、加盟店名と取引の文脈を読み取り、最も適切なカテゴリを選択します。
「Staples」での42ドルの請求は「Office Supplies」に分類されます。「Delta Airlines」の389ドルは「Travel」に。「Adobe Creative Cloud」の59.99ドルは「Software」になります。AIはキーワードマッチングをしているのではなく、明細書のレイアウトを解析するのと同じ意味理解を使用しています。「Staples」が事務用品店であること、「Delta」が航空会社であること、「Blue Bottle Coffee」での3.50ドルの請求が備品ではなく食事であることを理解しているのです。
クレジットカードの照合においてこれが強力なのは、抽出と分類が同じパスで行われるからです。取引をExcelに抽出してから、手動でCategory列を追加するのにさらに1時間費やす必要はありません。AIは両方の列を同時に埋めます。また、推論列はバッチアップロード全体で機能するため、複数のカードや複数月の明細書をまとめて処理でき、すべてのソースからのすべての取引がすでにカテゴリ分類された単一のスプレッドシートが得られます。
クレジットカード明細と銀行明細:抽出の違い
クレジットカード明細と銀行明細は同じ抽出課題だと思いがちです。どちらも日付、説明、金額を含む取引テーブルがあるからです。しかし実際には、それぞれ異なる課題があり、一方に最適化されたツールはもう一方でつまずくことがよくあります。
| 機能 | クレジットカード明細 | 銀行明細 |
|---|---|---|
| 取引ゾーン | 1ページに複数のゾーン(Purchases、Payments、Fees、Interest)があり、それぞれ列レイアウトが異なる | 通常、1ページに取引テーブルが1つあり、列は一貫している |
| Debit/Creditの扱い | 混在:符号付きの単一のAmount列、または別々のDebit/Credit列、またはゾーンごとに異なる規則 | 通常はDebitとCreditの列が分かれているか、一貫した単一列の規則を使用 |
| 小計・集計行 | 頻出:ゾーンごとの小計、ページごとの合計、明細の総合計 — 誤った取引行が発生するリスクが高い | 残高の累計列が組み込みの検証として機能し、小計はあまり見られない |
| 加盟店名 | 不統一:同じ加盟店が発行会社によって「AMZN」「Amazon.com」「AMAZON MKTPLACE」と表示される | より標準化されている:支払先名は銀行の内部フォーマットに一貫して従う |
| 明細のメタデータ | 支払期日、最低支払額、与信限度額、APRの詳細 — 財務計画に関連 | 口座残高、受取利息、当座貸越情報 — 異なるメタデータセット |
銀行明細の抽出に特化した場合 — 残高の累積検証や小切手番号の解析など独自の課題があります — 中小企業向けの銀行明細抽出 でそのワークフローを詳しく説明しています。クレジットカード明細の重要なポイントは、ゾーン認識が必須であることです。ページ全体を1つのフラットなテーブルとして扱うツールは、Purchases、Payments、Feesを混ぜ合わせた使い物にならない単一リストにしてしまいます。セマンティック抽出は、「Purchases」「Payments and Credits」「Interest Charged」などのヘッダーテキストを認識し、ゾーンごとに異なる解析ルールを適用することで、明細を読むときの目と同じようにこの問題を解決します。
月次照合から年末の税務準備まで
クレジットカード明細の抽出を自動化する理由は、今月の1時間を節約するためだけではありません。その1時間を何ヶ月分、何枚のカード分、年末の要求に掛け合わせたときに何が起こるかが重要です。
一般的な小規模事業者の簿記ワークフローには、3つの照合サイクルがあります。月次(クレジットカード明細の取引を領収書やGeneral Ledger(GL)の仕訳と照合)、四半期(予定納税額の計算のためにカテゴリ別の支出を集計)、年次(CPAのレビューと税務申告のために年間の取引データを集計)です。各段階において、基盤となる取引データの品質が、次の段階で発生する作業量を左右します。月次の段階でデータが乱れていると、年末に時給200ドル以上のCPAがそれを解きほぐすことになります。
月次の照合は、自動抽出が最も即効性を発揮する場面です。明細PDFをExcelと並べて開き、各行を手入力する代わりに、明細をアップロードして列を一度定義すれば、数秒でクリーンなスプレッドシートが得られます。毎月3枚のカードを処理する場合、これは複利的に積み上がる定期的な時間節約になります。
四半期の予定納税額の計算には、カテゴリ別の取引データが不可欠です。IRSはPublication 535(事業経費)に基づき、経費控除の合理的な根拠を要求します。つまり、何に使ったかだけでなく、各経費がどのカテゴリに該当するかを把握する必要があるのです。抽出時にInferred Columnsがカテゴリ分類を処理するため、四半期の支出サマリーはすでに整理されています。旅行費合計、事務用品費合計、ソフトウェア購読費合計が、それぞれピボット対応スプレッドシートの1行として並びます。
年末になると、その差はさらに顕著になります。多くの小規模事業者は、外部委託の簿記サービスに月額500〜1,000ドルを支払っています。また、整理されていない記録のキャッチアップ簿記やクリーンアップ簿記は、6〜12ヶ月分の滞貨に対して800〜2,500ドルかかることもあります。毎月のクリーンでカテゴリ別の取引データがすでにエクスポート・整理されていれば、簿記担当者の仕事はデータ入力からレビューと分析へと変わり、より迅速で低コストな業務になります。税務シーズンに特化して言えば、手動の税務データ入力が自動化の問題を生む理由や税務シーズンのデータ整理に関する関連記事は、W-2や1099フォームにも同じロジックを適用しています。事前の構造化抽出が後工程の手戻りを減らすという同じ原則が、文書タイプを問わず当てはまります。
よくある質問
AIはChase、Amex、Capital One、地元の信用組合など、あらゆる発行会社のクレジットカード明細を処理できますか?
はい。セマンティック抽出は座標の一致ではなく意味によってレイアウトを読み取るため、銀行ごとの設定なしで様々な発行会社に対応できます。Debit列とCredit列が分かれているChaseの明細、単一のAmount列のAmexの明細、信用組合のスキャン済みPDFも、すべて同じ列定義で解析されます。AIが各レイアウトに適応するため、明細ごとにテンプレートを作成する必要はありません。
明細がデジタルPDFではなくスキャン画像の場合はどうなりますか?
Vision Large Model(VLM)は、スキャン文書や写真もデジタルPDFと同様に、ページレイアウトを視覚的に理解して処理します。スキャンで精度が大幅に低下する従来のOCRとは異なり、VLMベースの抽出はクリーンなテキスト描画に依存しないため、画像ベースの入力でも高い精度を維持します。紙の明細のスマホ写真、信用組合のスキャンPDF、ChaseのデジタルPDFはすべて同じパイプラインで処理されます。ただし、極端に品質の低いスキャン(大きく傾いている、非常に暗い、低解像度)では精度が低下します。明細を平らに置き、均一な照明で撮影すると最良の結果が得られます。
AIは購入、支払い、返金、手数料を自動的に区別しますか?
はい。ただし、その仕組みについて正確に説明することが重要です。AIには魔法のような「タイプ検出器」があるわけではありません。AIが行うのは、明細のセクションヘッダーに基づいて各取引が属するセマンティックゾーン(Purchases、Payments & Credits、Fees & Interest)を認識し、それに応じて分類することです。AIは人間と同じようにレイアウトを読み取るため(「Payments and Credits」が独立したセクションであることを理解する)、分類は推測ではなく構造的な文脈に基づいています。これがゾーン認識抽出が重要な理由です。ゾーンを区別できないツールは、取引タイプを確実に分類できません。
複数月分や複数カードの明細を一度に処理できますか?
はい。複数のPDFファイル(異なる月、異なるカード、またはその両方)を一度のバッチでアップロードできます。AIは各ファイルを個別に処理し、抽出したすべての取引を1つの出力スプレッドシートに統合します。各行にはソースファイル情報が保持されるため、取引を元の明細まで遡って確認できます。これは年末の集計に特に便利です。2枚のカードの月次明細12枚(計24ファイル)をアップロードし、列を一度定義すれば、年間の全取引が構造化・分類された1つのスプレッドシートをダウンロードできます。
明細に外国通貨取引がある場合はどうなりますか?
多くのクレジットカード明細には、国際取引について外国通貨額と換算後のUSD額の両方が記載されています。「Foreign Currency Amount」と「USD Amount」を別々の抽出ターゲットとして列を定義できます。AIは発行会社が使用する列の形式に関係なく、明細行から両方の値を読み取り、両方のフィールドに入力します。明細に元の通貨額が表示されていない場合(一部の発行会社は換算後のUSD額のみを表示)、利用可能なデータのみが抽出されます。
これはQuickBooksやXeroへの銀行フィードのインポートと同じですか?
いいえ — 目的が異なります。銀行フィードは、接続した口座から取引をほぼリアルタイムで会計ソフトに自動インポートするもので、継続的な簿記に役立ちます。ただし、銀行フィードには口座接続が必要であり(すべての金融機関が対応しているわけではありません)、フィード期間外の古い取引を見逃す可能性があり、スキャン済みや紙の明細書には対応していません。明細書抽出はPDF自体に対して機能するため、口座アクセスは不要で、数年前までの履歴明細書に対応し、スキャン済みや撮影された明細書も処理できます。この2つのアプローチは競合ではなく補完関係にあります。抽出はフィードが届かない部分を処理します。
今月データ入力で節約した1時間は、来年3月にCPAが請求しない1時間です。
登録不要 · 最初の明細書は無料で処理